
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.9K
Mô hình Ngôn ngữ Lớn (LLM) tạo văn bản bằng kỹ thuật gọi là tự hồi quy, tức là dự đoán từ có khả năng xuất hiện tiếp theo nhất trong chuỗi dựa trên các từ trước đó. Các tác nhân vận hành bằng LLM như ChatGPT cũng được tinh chỉnh để làm theo ý định của người dùng. Do đó, chúng không chỉ hoàn tất chuỗi đầu vào mà còn nắm bắt ý định của người dùng trong đầu vào và tạo phản hồi tương ứng.
Nếu bạn đã dùng ChatGPT một thời gian, hẳn bạn nhận ra rằng chất lượng của một câu trả lời phụ thuộc vào chất lượng đầu vào của người dùng, ví dụ, tác nhân đưa ra phản hồi “tốt hơn” cho một số truy vấn nhất định so với các truy vấn khác.
Bí quyết để nhận được câu trả lời tốt nhất có thể là hiểu cách LLM tạo đầu ra và xây dựng lời nhắc đầu vào cho phù hợp. Tập hợp các kỹ thuật áp dụng lên đầu vào của người dùng để khai thác tối đa tiềm năng của mô hình được gọi là Kỹ thuật Nhắc lệnh.
Trong bài viết này, chúng ta sẽ khám phá một trong những kỹ thuật Nhắc lệnh mạnh mẽ nhất: nhắc chuỗi suy nghĩ (CoT). Kỹ thuật này liên quan đến việc cấu trúc lời nhắc theo cách giúp mô hình dễ dàng hoàn thành các nhiệm vụ phức tạp đòi hỏi suy luận hoặc giải quyết vấn đề. Đã có minh chứng rằng, nếu không có CoT, cùng một mô hình có thể thất bại trong việc đưa ra câu trả lời đúng.
Mặc dù LLM nổi tiếng với khả năng khái quát hóa, khả năng của mô hình phụ thuộc vào nhiệm vụ. Khi sử dụng LLM, cần lưu ý rằng mỗi mô hình được huấn luyện trên một cơ sở dữ liệu khổng lồ nhưng hữu hạn, và được tối ưu cho những nhiệm vụ nhất định. Vì vậy, trong khi mô hình có thể hoạt động rất tốt trong một số lĩnh vực, nó có thể thất bại ở những lĩnh vực khác.
Khả năng của mô hình cũng phụ thuộc vào thời điểm. Tương tự con người, nếu bạn đưa tôi một phép cộng 5 chữ số, tôi sẽ cần thời gian suy nghĩ để trả lời đúng. Nếu làm vội, bạn có thể dễ tính sai và trả lời sai.
Tương tự, nếu ta giao cho một mô hình ngôn ngữ một nhiệm vụ quá phức tạp so với thời gian tính toán token tiếp theo, nó có thể không đưa ra được câu trả lời chính xác.
Tuy nhiên, giống như con người, điều đó không nhất thiết có nghĩa là mô hình không có khả năng thực hiện nhiệm vụ. Với thêm thời gian hoặc được định hướng để suy luận, mô hình vẫn có thể trả lời một cách đáng tin cậy.
Phản hồi của mô hình và thời gian cần để tạo ra phản hồi đó cũng có thể bị ảnh hưởng bởi nhiều yếu tố, chẳng hạn như cách diễn đạt cụ thể của câu hỏi:
Nhắc chuỗi suy nghĩ giúp định hướng LLM giải quyết thành công các nhiệm vụ phức tạp, vừa bằng cách lựa chọn cách diễn đạt lời nhắc, vừa bằng cách cung cấp cho mô hình thời gian hoặc các bước cần thiết để tạo câu trả lời đúng.
Nhắc chuỗi suy nghĩ là một kỹ thuật cải thiện hiệu năng của mô hình ngôn ngữ bằng cách yêu cầu rõ ràng mô hình tạo ra lời giải thích hoặc quá trình suy luận từng bước trước khi đi đến câu trả lời cuối cùng. Phương pháp này giúp mô hình phân rã vấn đề và không bỏ qua các nhiệm vụ trung gian để tránh lỗi suy luận.
CoT hiệu quả vì nó giúp tập trung cơ chế chú ý của LLM. Việc phân rã quá trình suy luận khiến mô hình tập trung chú ý vào từng phần của vấn đề tại một thời điểm, giảm thiểu nguy cơ sai sót do xử lý quá nhiều thông tin cùng lúc.
Các nhà nghiên cứu tại Google đã giới thiệu nhắc chuỗi suy nghĩ trong bài báo “Chain of Thought Prompting Elicits Reasoning in Large Language Models” năm 2022. Nghiên cứu này nhấn mạnh rằng việc dẫn dắt mô hình qua một loạt các bước suy luận trung gian giúp cải thiện đáng kể hiệu năng trên các tác vụ như giải toán, suy luận logic và trả lời câu hỏi nhiều bước.
Hãy xem một ví dụ được đề xuất:
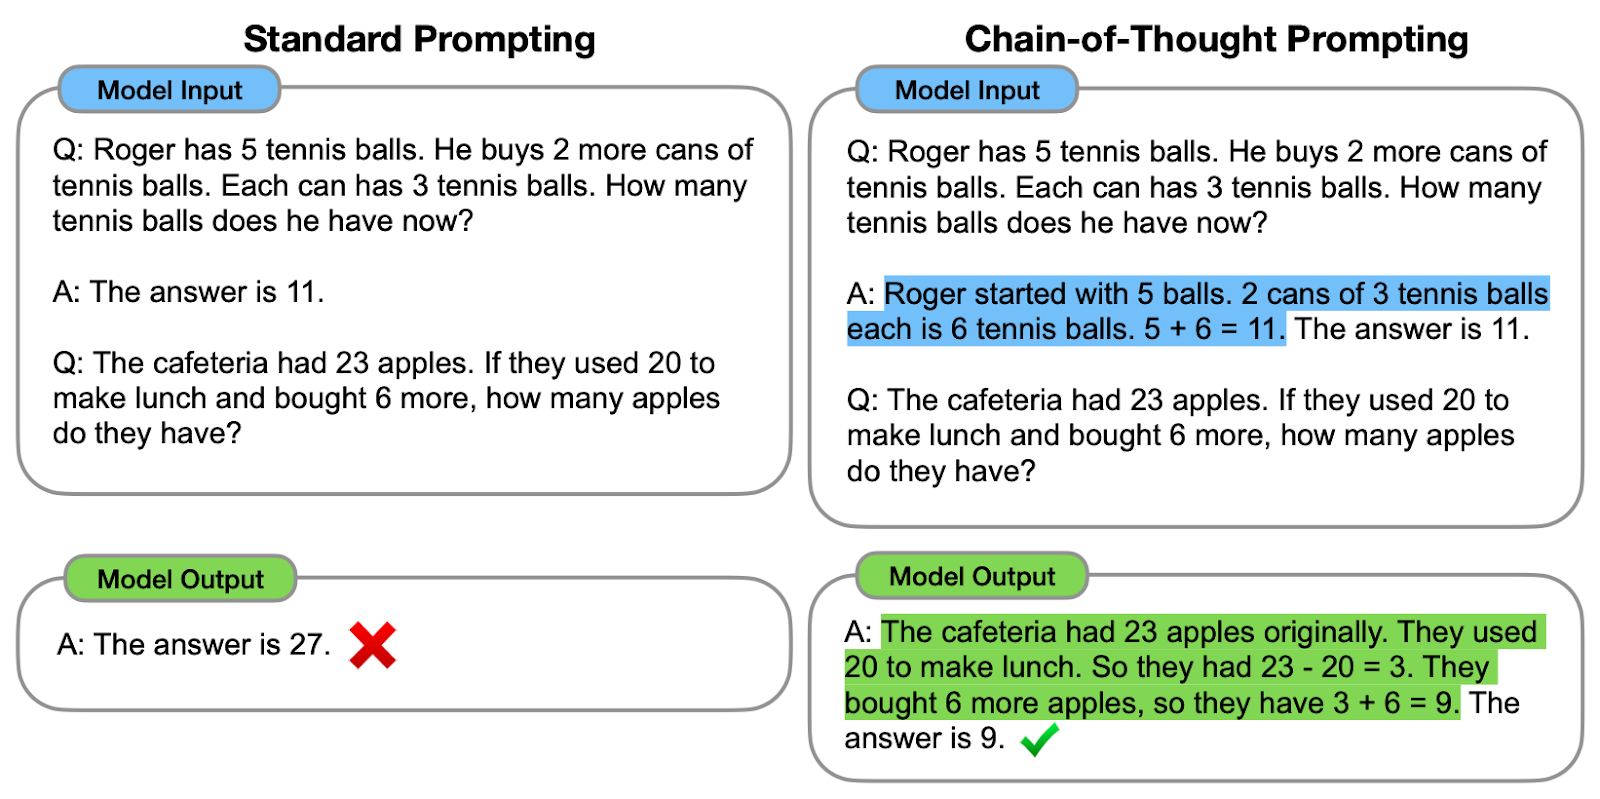
So sánh giữa nhắc lệnh tiêu chuẩn và nhắc CoT. Bên trái, mô hình được yêu cầu đưa ra trực tiếp câu trả lời cuối cùng (nhắc lệnh tiêu chuẩn). Bên phải, mô hình được yêu cầu thể hiện quá trình suy luận để đi tới câu trả lời cuối cùng (nhắc CoT).
Như ta có thể thấy, việc tạo ra một chuỗi suy nghĩ — một loạt các bước suy luận trung gian — giúp mô hình đưa ra câu trả lời chính xác.
Các tác giả ban đầu gọi chuỗi suy nghĩ là chuỗi các bước suy luận bằng ngôn ngữ tự nhiên dẫn đến đầu ra cuối cùng, và gọi phương pháp này là nhắc chuỗi suy nghĩ.
Quy trình bắt đầu bằng việc soạn các lời nhắc khuyến khích mô hình tư duy qua vấn đề theo cách từng bước, từ đó tạo ra các bước trung gian thay vì nhảy thẳng đến câu trả lời cuối cùng. Điều này có thể được thực hiện bằng nhiều chiến lược:
Đưa ra hướng dẫn tường minh nghĩa là phân rã vấn đề ngay trong lời nhắc của người dùng. Ví dụ, sử dụng các câu như “Trước tiên, chúng ta cần xem xét…” để nhắc mô hình trình bày chi tiết quá trình suy nghĩ.
Hãy xem thực tế!
Hãy tưởng tượng mẹ người Tây Ban Nha của tôi đã gửi cho tôi công thức gia đình để pha Cold Brew:
input_text = """
¡Preparar café Cold Brew es un proceso sencillo y refrescante!
Todo lo que necesitas son granos de café molido grueso y agua fría.
Comienza añadiendo el café molido a un recipiente o jarra grande.
Luego, vierte agua fría, asegurándote de que todos los granos de café
estén completamente sumergidos.
Remueve la mezcla suavemente para garantizar una saturación uniforme.
Cubre el recipiente y déjalo en remojo en el refrigerador durante al
menos 12 a 24 horas, dependiendo de la fuerza deseada.
"""
Giả sử chúng ta muốn dịch tất cả các từ liên quan đến cà phê sang tiếng Anh và muốn dùng ChatGPT cho nhiệm vụ này:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
Đây là phản hồi cho lời nhắc này:
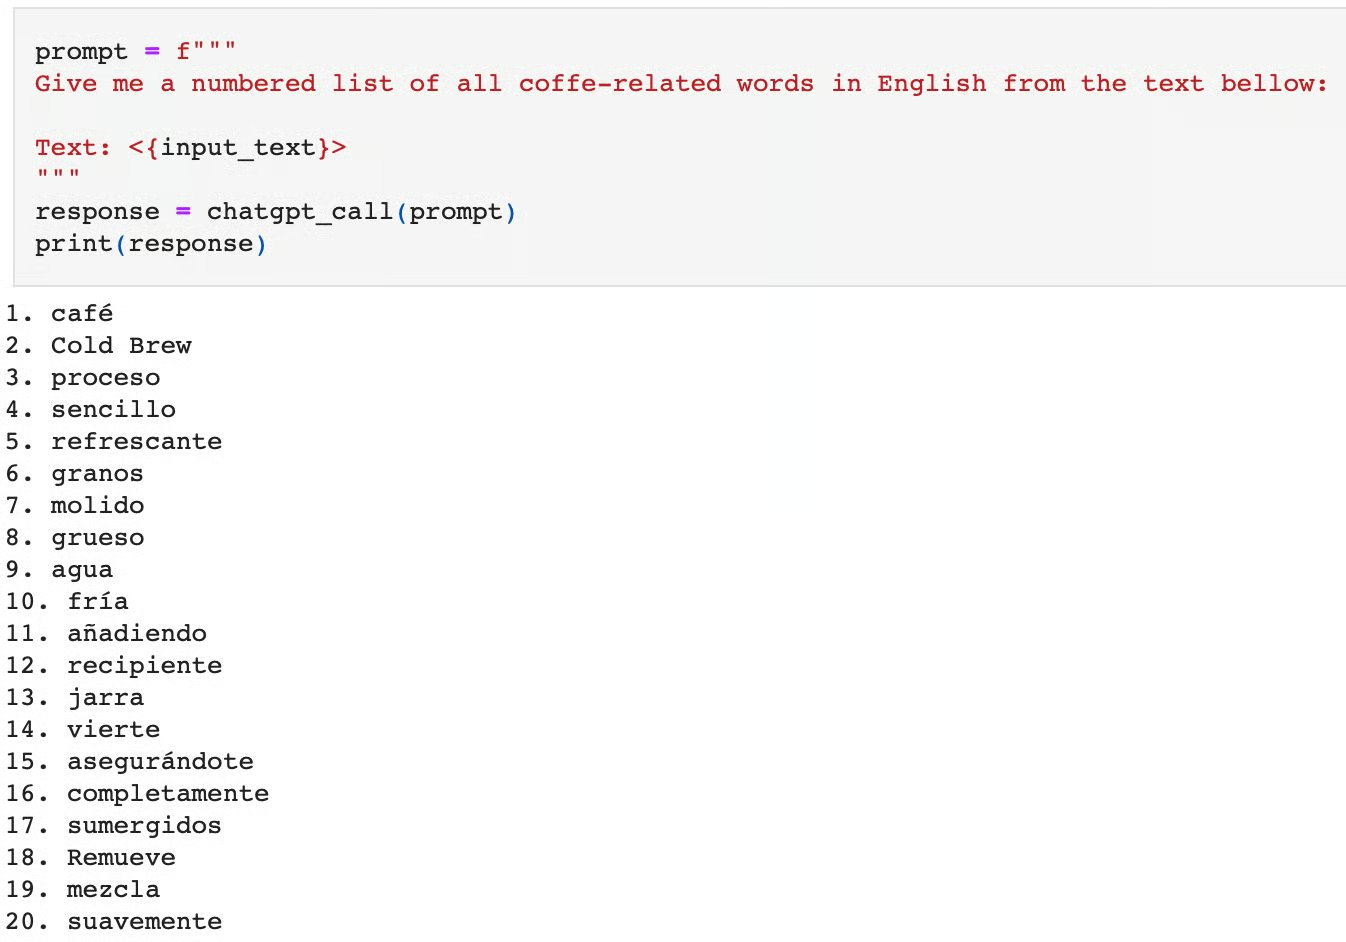
Nếu chúng ta yêu cầu mô hình thực hiện ngay nhiệm vụ này, có thể thấy nó làm sai. Nó không chỉ xuất ra các từ không liên quan đến cà phê mà còn giữ nguyên tiếng Tây Ban Nha, không phải tiếng Anh.
Ta có thể coi đây là nhiệm vụ phức tạp vì cần hai bước:
Thay vào đó, mô hình nhảy thẳng đến nhiệm vụ cuối là xác định các từ liên quan đến cà phê, bỏ qua bước dịch. Bằng cách chỉ rõ dịch thuật như một nhiệm vụ trung gian hoặc phân rã nhiệm vụ thành hai bước chính, chúng ta có thể dẫn dắt mô hình đi đến đầu ra đúng:
prompt = f"""
Give me a numbered list of all coffee-related words in English from the text below:
The task requires the following actions:
1 - Translate the given text into English.
2 - List each coffee-related word from the English text.
Text: <{input_text}>
"""
response = chatgpt_call(prompt)
print(response)
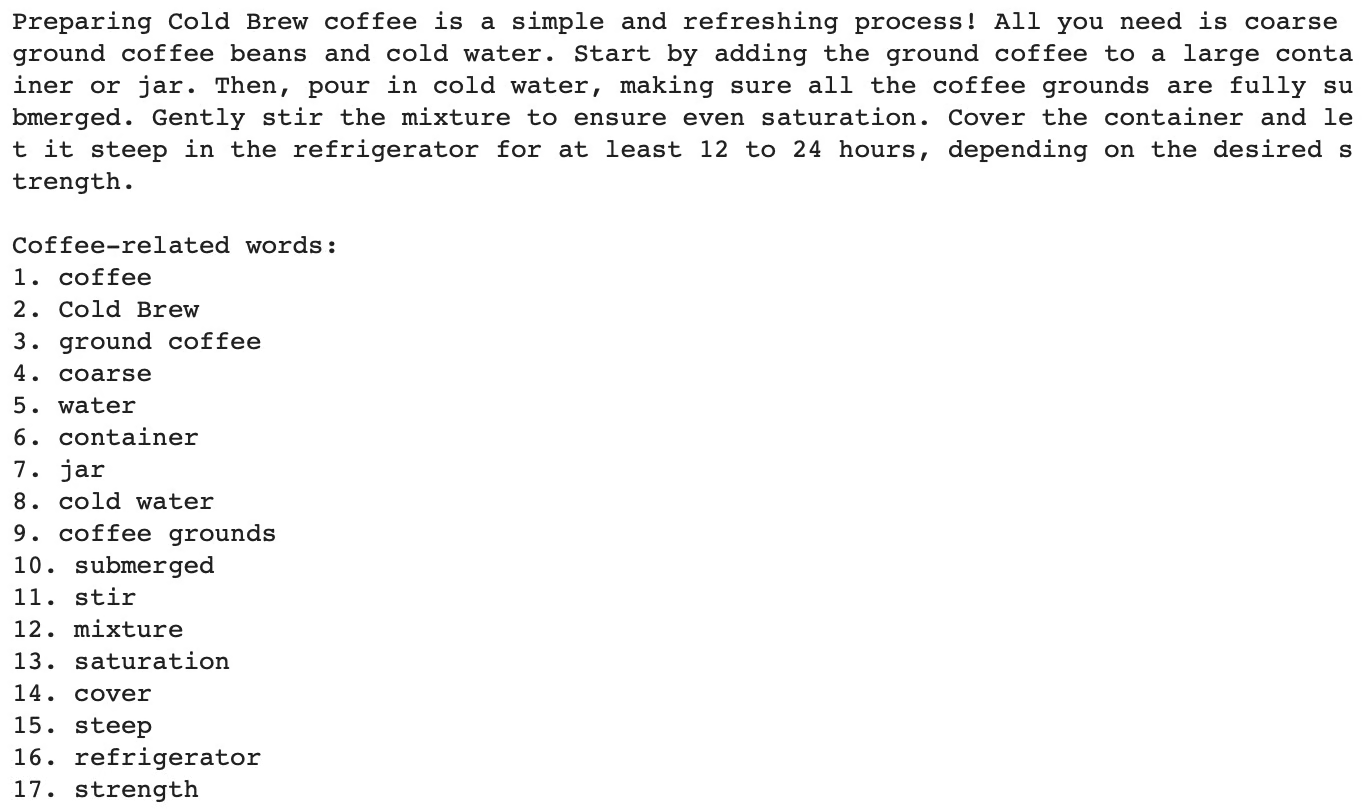
Bao gồm Chuỗi Suy nghĩ như trên dẫn đến câu trả lời đúng:
Nếu bạn muốn thử kỹ thuật này với các LLM khác thay vì ChatGPT hay OpenAI API như trong bài viết, khóa học “Developing Large Language Models” sẽ phù hợp với bạn!
Đôi khi, không cần tự chúng ta phân rã vấn đề trong lời nhắc. Đại học Tokyo cùng Google Research đã đề xuất một phương pháp hay để cải thiện phản hồi của LLM chỉ bằng cách thêm “Hãy suy nghĩ từng bước một” vào cuối lời nhắc gốc.
Câu đơn giản này nhắc mô hình suy luận thành tiếng và đi qua tất cả các bước cần thiết để thực hiện nhiệm vụ.
Hãy phân tích một ví dụ mà các tác giả đã nêu trong bài báo gốc “Large Language Models are Zero-Shot Reasoners”:
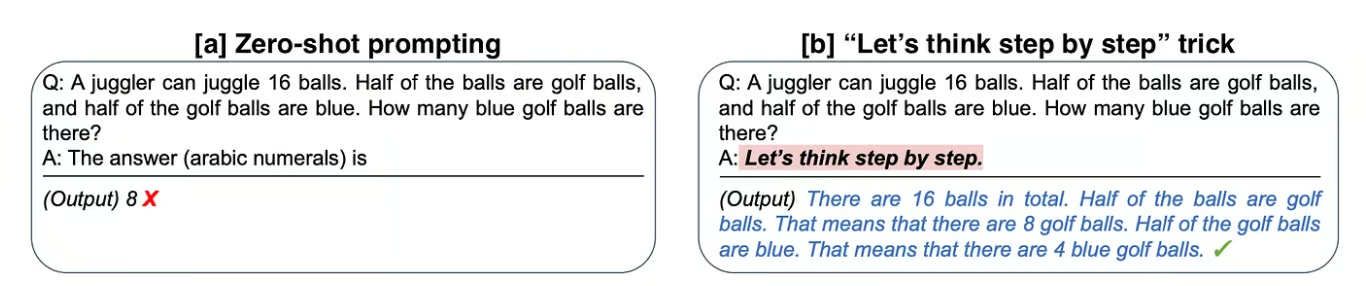
So sánh giữa nhắc lệnh tiêu chuẩn và sử dụng hướng dẫn CoT ngầm. Bên trái, mô hình đưa ra ngay câu trả lời cuối (nhắc lệnh zero-shot) và thất bại. Bên phải, mô hình được hướng dẫn bằng câu CoT ngầm (nhắc CoT) và đi đến câu trả lời đúng.
[a] Ở ví dụ đầu, các tác giả yêu cầu mô hình giải một bài toán số học, nhưng mô hình thất bại.
[b] Sau đó, bằng cách thêm “Hãy suy nghĩ từng bước một” vào câu hỏi gốc, mô hình suy luận thành tiếng và thành công.
Áp dụng mẹo đơn giản này lên bộ dữ liệu toán MultiArith, các tác giả thấy rằng hướng dẫn ngầm này đã tăng độ chính xác gấp bốn lần, từ 18% lên 79%!
Nếu bạn quan tâm, có thể đọc thêm về kỹ thuật này tại “Use This Short Prompt to Boost ChatGPT’s Outcome.”
Chúng ta đã dùng thuật ngữ “zero-shot” vài lần ở phần trên. Zero-shot đề cập đến khả năng của mô hình thực hiện một nhiệm vụ mà không được huấn luyện tường minh bằng các ví dụ cho chính nhiệm vụ đó.
Nó dựa trên khả năng khái quát hóa của mô hình và tạo ra phản hồi phù hợp cho các nhiệm vụ mới, chưa từng thấy. Điều đó có nghĩa là khi ta mở giao diện ChatGPT và hỏi ngay một câu hỏi, ta đang thực hiện nhắc lệnh zero-shot.
Tuy nhiên, có cách để cho mô hình xem một số ví dụ về các nhiệm vụ tương tự mà ta muốn giải. Cung cấp một loạt ví dụ minh họa được gọi là nhắc one-shot và few-shot, tùy theo số lượng ví dụ được đưa ra.
Nhắc one-shot liên quan đến việc đưa cho mô hình một ví dụ tương tự với nhiệm vụ mục tiêu để định hướng.
Ví dụ, nếu ta quay lại Hình đầu tiên của bài viết, có thể thấy mô hình tạo Chuỗi Suy nghĩ nhờ ví dụ minh họa được đưa trong lời nhắc.
Học few-shot hoạt động tương tự one-shot, nhưng số lượng ví dụ nhiều hơn, thường khoảng hàng trăm. Hiệu năng của mô hình tăng tuyến tính theo số lượng ví dụ.
Nhắc few-shot đã được Jason Wei và Denny Zhou cùng cộng sự tại Google nghiên cứu. Cách tiếp cận này đặc biệt hữu ích cho các nhiệm vụ đòi hỏi kiến thức chuyên biệt hoặc theo lĩnh vực, nơi mô hình có thể không có đủ kiến thức nền để thực hiện bằng zero-shot hoặc one-shot. Nhắc few-shot đôi khi được xem như một sự tinh chỉnh nhỏ cho mô hình trên một tập dữ liệu mới hoặc đặc thù.
Xem thêm ví dụ về nhắc one-shot và few-shot tại “Improve ChatGPT Performance with Prompt Engineering.”
One-shot và few-shot không phải là CoT. Tuy nhiên, các nhà nghiên cứu đã khám phá cách kết hợp học few-shot với nhắc CoT, gọi là “Few-shot CoT prompting.” Trong few-shot CoT, mô hình được cung cấp một vài ví dụ về bài toán kèm lời giải từng bước để dẫn dắt quá trình suy luận.
Kết hợp nhắc CoT few-shot với các kỹ thuật khác như tạo sinh tăng cường truy xuất (RAG) hoặc truy vấn tương tác có thể nâng cao hơn nữa hiệu năng và độ tin cậy của mô hình. Việc tích hợp các cơ sở tri thức, cơ sở dữ liệu, hoặc hệ thống truy xuất thông tin bên ngoài cho phép mô hình củng cố suy luận bằng thông tin thực tế và cập nhật.
Mê cung các bài toán toán học minh họa cách CoT có thể giúp các mô hình điều hướng trong không gian tri thức và giải quyết các nhiệm vụ phức tạp. Ảnh tự tạo bằng tính năng tạo ảnh của ChatGPT 4o với lời nhắc “Imagine a Language Model agent through a maze of mathematical problems”.
Có nhiều cách để đưa CoT vào lời nhắc của chúng ta:
Có nhiều framework có thể giúp bạn triển khai CoT và các kỹ thuật Nhắc lệnh khác, nhưng LangChain là lựa chọn tôi yêu thích. Nếu bạn muốn sử dụng LangChain trong các dự án vận hành bằng LLM, khóa học “Developing LLM Applications with LangChain” là điểm khởi đầu lý tưởng.
Nhắc chuỗi suy nghĩ mang lại nhiều lợi ích, đặc biệt trong việc nâng cao hiệu năng và độ tin cậy của mô hình ngôn ngữ ở các nhiệm vụ phức tạp.
Bằng cách chia nhỏ một vấn đề thành các bước nhỏ, dễ quản lý, mô hình có thể xử lý các nhiệm vụ phức tạp chính xác hơn. Các bước trung gian cung cấp các điểm kiểm tra nơi có thể phát hiện và sửa lỗi, dẫn đến câu trả lời cuối chính xác hơn.
Lý do các nhiệm vụ như bài toán toán học, câu đố logic, hay trả lời câu hỏi nhiều bước hưởng lợi từ cách tiếp cận này là vì chúng vốn dĩ đòi hỏi nhiều bước suy luận.
Quy trình suy luận từng bước là minh bạch, cho phép người dùng hiểu cách mô hình đi đến kết luận. Tính minh bạch này tạo dựng niềm tin vào đầu ra của mô hình.
Nó cũng có thể giúp gỡ lỗi vì người dùng có thể dễ dàng phát hiện nơi mô hình có thể đã sai trong suy luận.
Tất nhiên, như mọi kỹ thuật, luôn có một số điểm bất lợi đáng cân nhắc:
Cần lưu ý rằng CoT là một kỹ thuật phụ thuộc vào mô hình. Do đó, hiệu quả của nhắc CoT phần lớn phụ thuộc vào năng lực của mô hình ngôn ngữ nền tảng.
Việc soạn các lời nhắc CoT hiệu quả cũng có thể là thách thức. Nó đòi hỏi thiết kế cẩn thận để đảm bảo lời nhắc dẫn dắt đúng quy trình suy luận của mô hình. Cập nhật và duy trì lời nhắc cho các loại nhiệm vụ và lĩnh vực khác nhau có thể tốn thời gian và cần tinh chỉnh liên tục.
Nhắc CoT có thể không hiệu quả bằng cho các nhiệm vụ không có quy trình suy luận tuần tự rõ ràng. Hơn nữa, nó có thể không khái quát tốt cho các loại vấn đề hoàn toàn mới hoặc bất ngờ nếu không có huấn luyện hay thích ứng bổ sung, vì vậy việc duy trì cơ sở tri thức cập nhật và lời nhắc phù hợp là rất quan trọng.
Trong khi nhắc CoT tăng tính diễn giải bằng cách cung cấp lời giải thích từng bước, nó cũng có thể dẫn đến đầu ra dài và rườm rà hơn, điều này không phải lúc nào cũng mong muốn cho mọi ứng dụng.
Trong bài viết này, chúng ta đã thấy nhắc chuỗi suy nghĩ đại diện cho một bước tiến quan trọng trong việc nâng cao năng lực suy luận của các Mô hình Ngôn ngữ Lớn, kèm theo một số ví dụ thực tiễn về cách triển khai.
Dù sử dụng mẫu nhắc, nhắc tương tác hay vòng phản hồi, ý tưởng đằng sau các cách tiếp cận này là dẫn dắt mô hình qua quá trình suy luận và khai thác năng lực của nó.
Ngoài ra, chúng ta đã khám phá các kỹ thuật mạnh mẽ như nhắc one-shot và few-shot giúp tăng hiệu năng của mô hình và có thể kết hợp với CoT, cùng với những lợi ích và một số hạn chế không thể bỏ qua.
Hãy cân nhắc thử các kỹ thuật được thảo luận trong bài để xây dựng những lời nhắc đáng tin cậy và hiệu năng cao hơn, và hãy nhớ: Kỹ thuật Nhắc lệnh có thể tác động lớn đến đầu ra của bạn!
Bạn có thể tìm hiểu thêm về kỹ thuật nhắc lệnh qua các khóa học của DataCamp, Understanding Prompt Engineering và ChatGPT Prompt Engineering for Developers. Bạn cũng có thể xem hướng dẫn riêng về chứng chỉ kỹ thuật nhắc lệnh và tìm lộ trình học phù hợp nhất với bạn.
Các khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
