Kursus
Unsupervised Learning in Python
4 jam
184.3K
Singkatnya, klasterisasi adalah tugas mengelompokkan sekumpulan objek sedemikian rupa sehingga objek dalam klaster yang sama lebih mirip satu sama lain dibandingkan dengan objek di klaster lain. Kemiripan adalah ukuran yang mencerminkan kekuatan hubungan antara dua objek data. Klasterisasi terutama digunakan untuk penambangan data eksploratif. Klasterisasi memiliki banyak penggunaan di berbagai bidang seperti machine learning, pengenalan pola, analisis citra, temu kembali informasi, bioinformatika, kompresi data, dan grafika komputer.
Ada banyak keluarga teknik klasterisasi, dan Anda mungkin sudah akrab dengan yang paling populer: K-Means (yang termasuk dalam keluarga klasterisasi berbasis sentroid). Sebagai penyegar singkat, K-Means menentukan k sentroid dalam data dan mengklaster titik dengan menugaskannya ke sentroid terdekat.
Walaupun K-Means mudah dipahami dan diimplementasikan dalam praktik, algoritme ini tidak menangani pencilan, sehingga semua titik ditetapkan ke sebuah klaster meskipun sebenarnya tidak termasuk dalam klaster mana pun. Dalam ranah deteksi anomali, hal ini menimbulkan masalah karena titik-titik anomali akan ditempatkan dalam klaster yang sama dengan titik data yang “normal”. Titik-titik anomali menarik sentroid klaster ke arah mereka, membuatnya lebih sulit untuk mengklasifikasikan titik-titik tersebut sebagai anomali.
Tutorial ini akan membahas jenis teknik klasterisasi lain yang dikenal sebagai klasterisasi berbasis kerapatan, khususnya DBSCAN (sebuah teknik klasterisasi berbasis kerapatan). Dibandingkan dengan klasterisasi berbasis sentroid seperti K-Means, klasterisasi berbasis kerapatan bekerja dengan mengidentifikasi klaster titik yang “padat”, sehingga dapat mempelajari klaster dengan bentuk sewenang-wenang dan mengidentifikasi pencilan dalam data.
Sebelum membahas kerugiannya, berikut pengantar singkat tentang klasterisasi berbasis sentroid. Sentroid adalah titik data (imajiner atau nyata) di pusat sebuah klaster. Dalam klasterisasi berbasis sentroid, klaster direpresentasikan oleh sebuah vektor pusat atau sentroid. Sentroid ini belum tentu merupakan anggota dari himpunan data. Klasterisasi berbasis sentroid adalah algoritme klasterisasi iteratif di mana konsep kemiripan diturunkan dari seberapa dekat sebuah titik data dengan sentroid klaster.
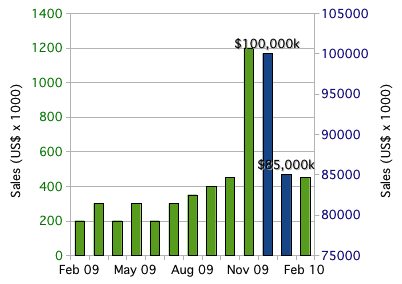
Terkadang suatu dataset dapat berisi nilai ekstrem yang berada di luar rentang yang diharapkan dan tidak seperti data lainnya. Ini disebut pencilan. Secara lebih formal, pencilan adalah pengamatan yang berada pada jarak abnormal dari nilai-nilai lain dalam sampel acak dari suatu populasi.
Dasar utama teknik klasterisasi berbasis sentroid digerakkan oleh pengukuran jarak antara titik data dan sentroid. Oleh karena itu, teknik ini umumnya gagal mengidentifikasi titik data yang sangat menyimpang dari distribusi normal data. Bahkan sebelum model prediktif disiapkan pada data, pencilan dapat menghasilkan representasi yang menyesatkan dan pada gilirannya interpretasi data yang menyesatkan. Ini jelas tidak diinginkan untuk membangun model prediktif dan analitis yang efisien dari data.
Anda dapat menganggap dua batang yang lebih tinggi berikut ini (dibandingkan batang lainnya) sebagai pencilan dalam data tersebut:
Sebelum membahas klasterisasi berbasis kerapatan, Anda terlebih dahulu perlu membahas satu topik: lingkungan ɛ.
Gagasan umum di balik lingkungan ɛ adalah, diberi sebuah titik data, Anda ingin dapat menalar tentang titik-titik data di ruang di sekitarnya. Secara formal, untuk suatu nilai riil ɛ > 0 dan suatu titik p, lingkungan ɛ dari p didefinisikan sebagai himpunan titik-titik yang berjarak paling jauh ɛ dari p.
Jika Anda mengingat kembali geometri, bentuk di mana semua titik berjarak sama dari pusat adalah lingkaran. Di ruang 2D, lingkungan ɛ dari sebuah titik p adalah himpunan titik yang berada dalam lingkaran berjari-jari ɛ, berpusat di p. Di ruang 3D, lingkungan ɛ adalah bola berjari-jari ɛ, berpusat di p, dan di ruang berdimensi lebih tinggi, lingkungan ɛ adalah N-sphere berjari-jari ɛ, berpusat di p.
Mari pertimbangkan sebuah contoh untuk memperjelas gagasan ini. Pada gambar di bawah, 100 titik data tersebar pada interval [1,3]X[2,4]. Mari pilih titik (3,2) sebagai titik p kita.

Pertama, mari pertimbangkan lingkungan p dengan jari-jari 0,5 (ɛ = 0,5), yaitu himpunan titik yang berjarak 0,5 dari p.

Oval hijau buram merepresentasikan lingkungan kita, dan ada 31 titik data di lingkungan ini. Karena 100 titik data tersebar dan 31 berada di lingkungan, ini berarti sedikit di bawah sepertiga titik data berada dalam lingkungan p dengan jari-jari 0,5.
Sekarang, mari ubah jari-jari kita menjadi 0,15 (ɛ = 0,15) dan pertimbangkan lingkungan yang lebih kecil yang dihasilkan.

Sekarang lingkungannya menyusut, sehingga hanya 3 titik data yang berada di dalamnya. Dengan menurunkan ɛ dari 0,5 menjadi 0,15 (pengurangan 70%), jumlah titik dalam lingkungan kita turun dari 31 menjadi 3 (pengurangan 90%).
Sekarang setelah Anda cukup memahami “lingkungan”, saya akan memperkenalkan konsep penting berikutnya: gagasan tentang “kerapatan” untuk sebuah lingkungan (Anda sedang menuju mempelajari “klasterisasi berbasis kerapatan”).
Dalam pelajaran sains tingkat sekolah dasar, anak-anak diajarkan bahwa kerapatan = massa/volume. Mari gunakan gagasan massa dibagi volume ini untuk mendefinisikan kerapatan pada suatu titik p. Jika Anda mempertimbangkan suatu titik p dan lingkungannya dengan jari-jari ɛ, Anda dapat mendefinisikan massa lingkungan sebagai jumlah titik data (atau alternatifnya, fraksi titik data) yang terdapat dalam lingkungan, dan volume lingkungan adalah volume bentuk hasil lingkungan tersebut. Dalam kasus 2D, lingkungannya adalah lingkaran, jadi volumenya adalah luas lingkaran tersebut. Dalam kasus 3D dan dimensi lebih tinggi, lingkungannya adalah bola atau n-sphere, sehingga Anda dapat menghitung volumenya.
Misalnya, mari pertimbangkan kembali lingkungan p = (3,2) dengan jari-jari 0,5.
Massa adalah jumlah titik data dalam lingkungan, jadi massa = 31. Volume adalah luas lingkaran, jadi volume = π0,52 = π/4. Oleh karena itu, pendekatan kerapatan lokal kita di * p = (3,2) dihitung sebagai kerapatan = massa/volume = 31/(π/4) = 124/π ~= 39,5.
Nilai ini tidak bermakna dengan sendirinya, tetapi jika Anda menghitung pendekatan kerapatan lokal untuk semua titik dalam dataset kita, Anda dapat mengklaster titik-titik kita dengan mengatakan bahwa titik-titik yang berdekatan (terkandung dalam lingkungan yang sama) dan memiliki pendekatan kerapatan lokal yang serupa termasuk dalam klaster yang sama. Jika Anda menurunkan nilai ɛ, Anda dapat membangun lingkungan yang lebih kecil (volume lebih sedikit) yang juga akan berisi lebih sedikit titik data. Idealnya, Anda ingin mengidentifikasi lingkungan yang sangat padat di mana sebagian besar titik data berada di lingkungan tersebut, tetapi volume masing-masing lingkungan ini relatif kecil.
Walaupun ini bukan persis seperti yang dilakukan DBSCAN atau algoritme Level Set Tree (teknik klasterisasi lain yang termasuk dalam keluarga klasterisasi berbasis kerapatan), inilah intuisi umum di balik klasterisasi berbasis kerapatan.
Meninjau kembali, Anda telah membahas lingkungan ɛ dan bagaimana itu memungkinkan penalaran tentang ruang di sekitar titik tertentu. Kemudian Anda mempelajari gagasan kerapatan pada titik tertentu untuk lingkungan tertentu. Pada bagian berikutnya, Anda akan mengenal algoritme DBSCAN di mana bola ɛ adalah alat fundamental untuk mendefinisikan klaster.
DBSCAN adalah singkatan dari Density-Based Spatial Clustering of Applications with Noise dan jelas merupakan algoritme klasterisasi berbasis kerapatan yang paling dikenal. Algoritme ini pertama kali diperkenalkan pada tahun 1996 oleh Ester dkk.. Karena pentingnya dalam teori dan aplikasi, algoritme ini adalah salah satu dari tiga algoritme yang dianugerahi Test of Time Award di SIGKDD 2014.
Tidak seperti K-Means, DBSCAN tidak memerlukan jumlah klaster sebagai parameter. Sebaliknya, ia menyimpulkan jumlah klaster berdasarkan data, dan dapat menemukan klaster dengan bentuk sewenang-wenang (sebagai perbandingan, K-Means biasanya menemukan klaster berbentuk bola). Seperti yang Anda lihat sebelumnya, lingkungan ɛ adalah hal mendasar bagi DBSCAN untuk memperkirakan kerapatan lokal, sehingga algoritme memiliki dua parameter:
Menggunakan dua parameter ini, DBSCAN mengategorikan titik data menjadi tiga kategori:
Definisi ini mungkin terlihat abstrak, jadi mari kita bahas arti masing-masing secara lebih rinci.
Titik Inti:
Titik inti adalah fondasi bagi klaster kita dan didasarkan pada pendekatan kerapatan yang saya bahas pada bagian sebelumnya. Anda menggunakan ɛ yang sama untuk menghitung lingkungan bagi setiap titik, sehingga volume semua lingkungan sama. Namun, jumlah titik lain dalam setiap lingkungan yang berbeda. Ingat bahwa saya katakan Anda dapat menganggap jumlah titik data dalam lingkungan sebagai massanya. Volume setiap lingkungan konstan, dan massa lingkungan bervariasi, sehingga dengan menetapkan ambang batas pada jumlah massa minimum yang diperlukan untuk menjadi titik inti, Anda pada dasarnya menetapkan ambang kerapatan minimum. Oleh karena itu, titik inti adalah titik data yang memenuhi persyaratan kerapatan minimum. Klaster kita dibangun di sekitar titik inti (karena itu disebut inti), jadi dengan menyesuaikan parameter minPts, Anda dapat menyempurnakan seberapa padat inti klaster kita harusnya.
Titik Batas:
Titik batas adalah titik dalam klaster kita yang bukan titik inti. Dalam definisi di atas untuk titik batas, saya menggunakan istilah density-reachable (dapat dijangkau melalui kerapatan). Saya belum mendefinisikan istilah ini, tetapi konsepnya sederhana. Untuk menjelaskannya, mari kembali ke contoh lingkungan kita dengan epsilon = 0,15. Pertimbangkan titik r (titik hitam) yang berada di luar lingkungan titik p.

Semua titik di dalam lingkungan titik p dikatakan dapat dijangkau langsung dari p. Sekarang, mari jelajahi lingkungan titik q, sebuah titik yang dapat dijangkau langsung dari p. Lingkaran kuning merepresentasikan lingkungan q.

Sekarang meskipun titik target Anda r tidak berada dalam lingkungan titik awal Anda p, titik tersebut berada dalam lingkungan titik q. Inilah gagasan di balik density-reachable: Jika Anda dapat mencapai titik r dengan melompat dari lingkungan ke lingkungan, dimulai dari titik p, maka titik r dapat dijangkau melalui kerapatan dari titik p.

Sebagai analogi, Anda dapat menganggap titik yang dapat dijangkau melalui kerapatan sebagai “temannya teman”. Jika titik yang dapat dijangkau langsung dari titik inti p adalah “temannya”, maka titik yang dapat dijangkau melalui kerapatan, yaitu titik dalam lingkungan “teman-teman” p, adalah “temannya teman”. Satu hal yang mungkin tidak jelas adalah titik yang dapat dijangkau melalui kerapatan tidak terbatas pada dua lompatan lingkungan yang berdekatan saja. Selama Anda dapat mencapai suatu titik dengan melakukan “lompatan lingkungan”, dimulai dari titik inti p, titik tersebut dapat dijangkau melalui kerapatan dari p, sehingga “temannya teman dari teman … dari teman” juga termasuk.
Penting untuk diingat bahwa gagasan density-reachable ini bergantung pada nilai ɛ kita. Dengan memilih nilai ɛ yang lebih besar, lebih banyak titik menjadi dapat dijangkau melalui kerapatan, dan dengan memilih nilai ɛ yang lebih kecil, lebih sedikit titik yang dapat dijangkau melalui kerapatan.
Pencilan:
Akhirnya, kita sampai pada kelas “lainnya”. Pencilan adalah titik yang bukan merupakan titik inti dan juga tidak cukup dekat dengan sebuah klaster untuk dapat dijangkau melalui kerapatan dari titik inti. Pencilan tidak ditugaskan ke klaster mana pun dan, tergantung konteks, dapat dianggap sebagai titik anomali.
DBSCAN sudah diimplementasikan dengan sangat baik dalam library machine learning Python Scikit-Learn yang populer, dan karena implementasi ini skalabel serta teruji, Anda akan menggunakannya untuk melihat bagaimana DBSCAN bekerja dalam praktik.
Langkah-langkah algoritme DBSCAN adalah:
Untuk keperluan studi kasus ini Anda akan menggunakan dataset yang terdiri dari data tahunan pelanggan untuk sebuah distributor grosir.
Jadi, mari kita mulai.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
Dataset ini terdiri dari 440 pelanggan dan memiliki 8 atribut untuk masing-masing pelanggan. Anda akan menggunakan pustaka Pandas untuk mengimpor file .csv dan mengonversinya menjadi objek DataFrame.
Sekarang saat mengimpor file .csv Anda ke , pastikan Anda memberikan path file yang akurat.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Sekarang sebelum melangkah lebih jauh menerapkan DBSCAN, sangat penting Anda memahami data dengan baik untuk mengetahui jenis data dalam dataset, distribusi data, dan fitur mana yang numerik atau tidak.
Menurut deskripsi yang diberikan di repositori machine learning UCI resmi untuk dataset ini, informasi tentang fitur-fiturnya adalah sebagai berikut:
Sekarang setelah Anda mengetahui fitur-fitur dalam dataset, mari tampilkan beberapa statistik data.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Seperti yang dapat Anda lihat dari keluaran di atas, tidak ada nilai hilang dalam dataset dan semua data bertipe integer. Ini mengurangi beban prapemrosesan data lebih lanjut. Mari telusuri sedikit lagi.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Dari keluaran di atas, Anda dapat memperoleh semua ukuran statistik yang diperlukan seperti simpangan baku, rata-rata, nilai maksimum dari setiap fitur dalam dataset. Anda dapat melihat sebagian besar data dalam dataset ini bersifat kontinu kecuali dua fitur: Channel dan Region. Jadi untuk memudahkan perhitungan, Anda akan menghapus keduanya:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Agar Anda dapat memvisualisasikan data, untuk itu Anda akan menggunakan dua fitur berikut:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
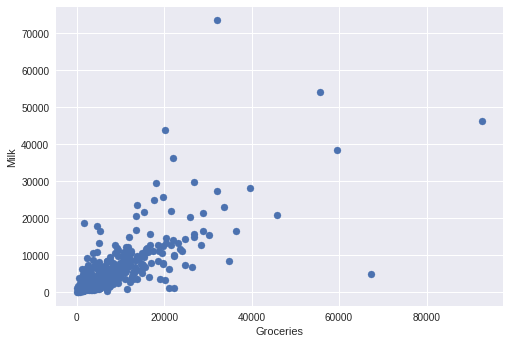
Mari ringkas fungsi-fungsi yang Anda gunakan untuk plotting: plt.scatter(): Fungsi ini membuat scatter plot berdasarkan data (sebagai parameter yang Anda berikan [x dan y]). plt.xlabel(): Membantu Anda memberi label di sepanjang sumbu-X. (Groceries dalam kasus ini) plt.ylabel(): Membantu Anda memberi label di sepanjang sumbu-Y. (Milk dalam kasus ini) plt.show(): Setelah plot dibuat, fungsi ini menampilkannya sebagai keluaran.
Anda seharusnya dapat dengan mudah melihat titik data yang sangat menyimpang. Bukan? Nah, itulah pencilan Anda.
Dengan DBSCAN, kita ingin mengidentifikasi klaster utama pelanggan ini, tetapi kita juga ingin menandai pelanggan dengan kebiasaan pembelian tahunan yang lebih tidak biasa sebagai pencilan.
Karena nilai data berada dalam ribuan, Anda akan menormalkan setiap atribut dengan menskalakannya ke rata-rata 0 dan ragam satuan. Pada dasarnya ini membantu menjaga keterkaitan antarfitur tetap utuh sehingga perubahan kecil pada satu fitur akan tercermin pada fitur lain.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Anda akan membuat objek DBSCAN yang memerlukan minimal 15 titik data dalam lingkungan berjari-jari 0,5 untuk dianggap sebagai titik inti.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Selanjutnya, kita dapat mengekstrak label klaster dan pencilan untuk memplot hasil.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Sesuai dengan intuisi, algoritme DBSCAN dapat mengidentifikasi satu klaster pelanggan yang berada di sekitar rata-rata pembelian produk kebutuhan sehari-hari dan produk susu. Selain itu, algoritme ini dapat menandai pelanggan yang perilaku pembelian tahunannya terlalu menyimpang dari pelanggan lain.
Karena pencilan berkaitan dengan pelanggan dengan perilaku pembelian yang lebih ekstrem, distributor grosir dapat secara khusus menargetkan pelanggan ini dengan diskon eksklusif untuk mendorong pembelian yang lebih besar.
Misalkan kita memiliki bisnis e-commerce dan ingin meningkatkan penjualan dengan merekomendasikan produk yang relevan kepada pelanggan. Kita tidak tahu persis apa yang dicari pelanggan, tetapi berdasarkan dataset kita dapat memprediksi dan merekomendasikan produk yang relevan kepada pelanggan tertentu. Kita dapat menerapkan DBSCAN pada dataset kita (berdasarkan database e-commerce) dan menemukan klaster berdasarkan produk yang dibeli pengguna. Menggunakan klaster ini kita dapat menemukan kemiripan antar pelanggan, misalnya, jika pelanggan A membeli sebuah pena, sebuah buku, dan sepasang gunting, sementara pelanggan B membeli sebuah buku dan sepasang gunting, maka Anda dapat merekomendasikan pena kepada pelanggan B.
Sebelum munculnya metodologi canggih berbasis deep learning, peneliti menggunakan DBSCAN untuk mengelompokkan gen dari dataset gen yang berpotensi berperan dalam memediasi kanker.
Ilmuwan telah menggunakan DBSCAN untuk mendeteksi pemberhentian dalam data trajektori yang dihasilkan dari perangkat GPS seluler. Pemberhentian merepresentasikan bagian paling bermakna dan paling penting dari sebuah trajektori.
Jadi, dalam artikel ini Anda mengetahui kelemahan utama klasterisasi berbasis sentroid dan mengenal keluarga teknik klasterisasi lain yaitu klasterisasi berbasis kerapatan. Anda juga melihat bagaimana teknik ini mengatasi kekurangan klasterisasi berbasis sentroid.
Anda mempelajari bagaimana DBSCAN bekerja dan juga melakukan studi kasusnya. Selain itu, Anda mendapat gambaran yang cukup tentang masalah dunia nyata di mana DBSCAN diterapkan untuk menyelesaikannya. Untuk bacaan lebih lanjut, saya sangat menyarankan Anda menelusuri metode klasterisasi berbasis kerapatan lainnya seperti Level Set Tree clustering dan bagaimana bedanya dengan DBSCAN.
Jika Anda ingin mempelajari lebih lanjut tentang klasterisasi di Python, ikuti kursus Unsupervised Learning in Python kami.
Martin Ester, Hans-Peter Kriegel, Jörg Sander, dan Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. Dalam Prosiding Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han, dan Usama Fayyad (Ed.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Pelajari lebih lanjut tentang Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



