Kurs
Python'da Unsupervised Learning
4 sa
184.4K
Kısaca, kümeleme, aynı kümedeki nesnelerin birbirine diğer kümelerdeki nesnelerden daha çok benzediği şekilde bir dizi nesneyi gruplama işidir. Benzerlik, iki veri nesnesi arasındaki ilişkinin gücünü yansıtan bir ölçüdür. Kümeleme ağırlıklı olarak keşif amaçlı veri madenciliğinde kullanılır. Makine öğrenimi, örüntü tanıma, görüntü analizi, bilgi erişimi, biyoinformatik, veri sıkıştırma ve bilgisayar grafikleri gibi pek çok alanda geniş kullanım alanına sahiptir.
Birçok kümeleme tekniği ailesi vardır ve en popüler olanına aşina olabilirsiniz: K-Means (merkez nokta tabanlı kümeleme ailesine aittir). Kısaca hatırlatmak gerekirse, K-Means veride k adet merkez belirler ve noktaları en yakın merkeze atayarak kümeler.
K-Means pratikte anlaşılması ve uygulanması kolay olsa da uç değerlere dikkat etmez; bu nedenle herhangi bir kümeye ait olmayan noktalar bile bir kümeye atanır. Anomali tespitinde bu, sorun yaratır çünkü anormal noktalar “normal” veri noktalarıyla aynı kümeye atanır. Anormal noktalar küme merkezini kendilerine doğru çeker ve bu da onları anormal olarak sınıflandırmayı zorlaştırır.
Bu eğitim, özellikle DBSCAN (yoğunluk temelli bir kümeleme tekniği) olmak üzere yoğunluk temelli başka bir kümeleme tekniğini ele alacaktır. K-Means gibi merkez tabanlı kümelemenin aksine, yoğunluk temelli kümeleme “yoğun” nokta kümelerini belirleyerek çalışır; böylece rastgele şekilli kümeleri öğrenmesine ve verideki aykırı değerleri belirlemesine olanak tanır.
Merkez tabanlı kümelemenin dezavantajlarını tartışmadan önce kısaca bir giriş yapayım. Bir merkez (centroid), bir kümenin ortasında (hayali ya da gerçek) bir veri noktasıdır. Merkez tabanlı kümelemede kümeler bir merkez vektörle ya da bir merkezle temsil edilir. Bu merkez veri kümesinin bir üyesi olmak zorunda değildir. Merkez tabanlı kümeleme yinelemeli bir algoritmadır ve benzerlik kavramı, bir veri noktasının kümenin merkezine ne kadar yakın olduğuna göre türetilir.
Bazen bir veri kümesi, beklenen aralığın dışında kalan ve diğer verilerden farklı olan aşırı değerlere sahip olabilir. Bunlara aykırı değerler denir. Daha resmî olarak, bir aykırı değer, bir popülasyondan rastgele bir örnekteki diğer değerlere anormal derecede uzak olan gözlemdir.
Merkez tabanlı kümeleme tekniklerinin temelinde, veri noktaları ile merkezler arasındaki uzaklık ölçümleri yatar. Bu nedenle, merkez tabanlı kümeleme teknikleri genellikle verinin normal dağılımından büyük ölçüde sapan veri noktalarını belirlemede başarısız olur. Öngörücü modeller hazırlanmandan önce bile, aykırı değerler yanıltıcı gösterimlere ve dolayısıyla toplanan verinin yanıltıcı yorumlarına yol açabilir. Bu da veriden verimli öngörücü ve analitik modeller kurmak için arzu edilen bir durum değildir.
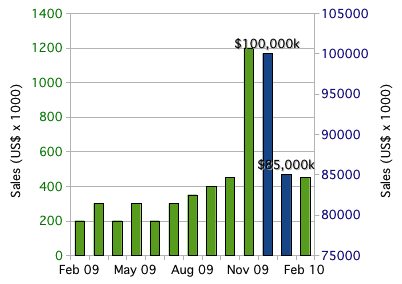
Aşağıdaki iki daha uzun çubuğu (diğerlerinden daha yüksek olanları) o verideki aykırı değerler olarak düşünebilirsiniz:
Yoğunluk tabanlı kümelemeyi tartışmadan önce, önce bir konuyu ele almanız gerekir: ɛ-komşulukları.
ɛ-komşuluklarının arkasındaki genel fikir şudur: Verilen bir veri noktası için, etrafındaki uzaydaki veri noktaları hakkında akıl yürütebilmek istersiniz. Resmî olarak, ɛ > 0 gerçek değerli bir sayı ve p noktası için, p’nin ɛ-komşuluğu p’den en fazla ɛ uzaklıkta olan noktalar kümesi olarak tanımlanır.
Geometriyi düşünürseniz, merkezden eşit uzaklıktaki tüm noktaların oluşturduğu şekil çemberdir. 2B uzayda, p noktasının ɛ-komşuluğu, merkezi p olan, yarıçapı ɛ olan bir çember içinde yer alan noktalar kümesidir. 3B uzayda, ɛ-komşuluğu, merkezi p olan, yarıçapı ɛ olan bir küredir ve daha yüksek boyutlu uzaylarda ɛ-komşuluğu, merkezi p olan yarıçapı ɛ olan N-küredir.
Bu fikri daha somutlaştırmak için bir örnek düşünelim. Aşağıdaki görselde 100 veri noktası [1,3]X[2,4] aralığına dağılmıştır. p noktamız olarak (3,2)’yi seçelim.

Önce, yarıçapı 0,5 olan (ɛ = 0,5) p’nin komşuluğunu, yani p’ye 0,5 uzaklıkta olan noktalar kümesini ele alalım.

Opak yeşil oval komşuluğumuzu temsil ediyor ve bu komşulukta 31 veri noktası var. 100 veri noktası dağıtıldığına ve 31’i komşulukta bulunduğuna göre, bu, 0,5 yarıçaplı p komşuluğunun, veri noktalarının üçte birinden biraz daha azını içerdiği anlamına gelir.
Şimdi yarıçapımızı 0,15’e (ɛ = 0,15) düşürelim ve ortaya çıkan daha küçük komşuluğu inceleyelim.

Artık komşuluk biraz küçüldü; bu nedenle içinde yalnızca 3 veri noktası bulunuyor. ɛ’yi 0,5’ten 0,15’e düşürerek (%70 azalma), komşuluğumuzdaki nokta sayısını 31’den 3’e indirdik (%90 azalma).
Artık “komşuluk” kavramını yeterince anladığınıza göre, sıradaki önemli kavramı tanıtacağım: bir komşuluk için “yoğunluk” kavramı (sonuçta “yoğunluk temelli kümeleme”yi öğrenmeye doğru ilerliyorsunuz).
İlkokul fen bilgisinde, çocuklara yoğunluk = kütle/hacim olarak öğretilir. Bu kütle bölü hacim fikrini, p noktasındaki yoğunluğu tanımlamak için kullanalım. Bir p noktasını ve ɛ yarıçaplı komşuluğunu ele alırsanız, komşuluğun kütlesini, komşulukta yer alan veri noktalarının sayısı (ya da alternatif olarak veri noktalarının payı) olarak tanımlayabilirsiniz; komşuluğun hacmi ise komşuluğun oluşturduğu şeklin hacmidir. 2B durumda, komşuluk bir çemberdir; dolayısıyla komşuluğun hacmi, ortaya çıkan çemberin alanıdır. 3B ve daha yüksek boyutlu durumda komşuluk bir küre ya da n-küredir; bu şeklin hacmi hesaplanabilir.
Örneğin, yeniden p = (3,2) noktasının 0,5 yarıçaplı komşuluğunu ele alalım.
Kütle, komşuluktaki veri noktalarının sayısıdır; dolayısıyla kütle = 31. Hacim, çemberin alanıdır; dolayısıyla hacim = π0,52 = π/4. Buna göre, p = (3,2) noktasındaki yerel yoğunluk yaklaşımımız yoğunluk = kütle/hacim = 31/(π/4) = 124/π ~= 39,5 olarak hesaplanır.
Bu değer tek başına anlamsızdır; ancak veri kümesindeki tüm noktalar için yerel yoğunluk yaklaşımını hesaplarsanız, noktaların yakın (aynı komşuluk içinde) olduğu ve benzer yerel yoğunluk yaklaşımlarına sahip olduğu noktaların aynı kümeye ait olduğunu söyleyerek kümeler oluşturabilirsiniz. ɛ değerini azaltırsanız, daha az hacimli ve daha az veri noktası içeren daha küçük komşuluklar inşa edebilirsiniz. İdeal olarak, veri noktalarının çoğunun bu komşuluklarda yer aldığı; ancak her bir komşuluğun hacminin görece küçük olduğu, yüksek yoğunluklu komşulukları belirlemek istersiniz.
Bu, ne DBSCAN’in ne de (yoğunluk temelli kümeleme ailesine ait başka bir teknik olan) Level Set Tree algoritmasının tam olarak yaptığı şey olmasa da, yoğunluk temelli kümelemenin arkasındaki genel sezgiyi oluşturur.
Özetlemek gerekirse, ɛ-komşuluklarını ve bunların belirli bir noktanın etrafındaki uzay hakkında nasıl akıl yürütmeyi sağladığını ele aldınız. Ardından belirli bir komşuluk için belirli bir noktadaki yoğunluk kavramını öğrendiniz. Bir sonraki bölümde, kümeleri tanımlamak için ɛ-kürenin temel bir araç olduğu DBSCAN algoritmasını öğreneceksiniz.
DBSCAN, Noise içeren Uygulamaların Yoğunluk Tabanlı Uzamsal Kümelenmesi (Density-Based Spatial Clustering of Applications with Noise) ifadesinin kısaltmasıdır ve açık ara en bilinen yoğunluk temelli kümeleme algoritmasıdır. İlk kez 1996’da Ester ve diğ. tarafından tanıtılmıştır. Teoride ve uygulamada taşıdığı önem nedeniyle, bu algoritma SIGKDD 2014’te Test of Time ödülüne layık görülen üç algoritmadan biridir.
K-Means’in aksine, DBSCAN küme sayısını bir parametre olarak gerektirmez. Bunun yerine, kümelerin sayısını veriden çıkarır ve rastgele şekillerde kümeleri keşfedebilir (karşılaştırma için, K-Means genellikle küresel kümeler bulur). Daha önce gördüğünüz gibi, ɛ-komşuluğu, yerel yoğunluğu yaklaştırmak için DBSCAN’in temelidir; bu nedenle algoritmanın iki parametresi vardır:
Bu iki parametreyi kullanarak DBSCAN veri noktalarını üç kategoriye ayırır:
Bu tanımlar soyut görünebilir; o hâlde her birinin ne anlama geldiğini daha ayrıntılı ele alalım.
Çekirdek Noktalar:
Çekirdek noktalar, önceki bölümde tartıştığım yoğunluk yaklaşımına dayalı olarak kümelerimizin temelini oluşturur. Her nokta için komşuluğu aynı ɛ ile hesaplarsınız; dolayısıyla tüm komşulukların hacmi aynıdır. Ancak her komşuluktaki diğer nokta sayısı farklıdır. Komşuluktaki veri noktası sayısını kütle olarak düşünebileceğinizi hatırlayın. Her komşuluğun hacmi sabittir; komşuluğun kütlesi değişkendir; dolayısıyla bir noktanın çekirdek nokta olabilmesi için gereken asgari kütleye bir eşik koyarak aslında bir asgari yoğunluk eşiği belirlersiniz. Bu nedenle çekirdek noktalar, asgari bir yoğunluk gereksinimini karşılayan veri noktalarıdır. Kümelerimiz çekirdek noktalar etrafında inşa edilir (bu yüzden “çekirdek”); bu nedenle minPts parametremizi ayarlayarak küme çekirdeklerimizin ne kadar yoğun olması gerektiğini ince ayarlayabilirsiniz.
Sınır Noktalar:
Sınır noktalar, kümelerimizde yer alan ancak çekirdek olmayan noktalardır. Sınır noktaların tanımında yoğunlukça erişilebilir terimini kullandım. Bu terimi henüz tanımlamadım; ancak kavram basittir. Bu kavramı açıklamak için, epsilon = 0,15 olan komşuluk örneğimize geri dönelim. p noktasının komşuluğunun dışında kalan r noktasını (siyah nokta) ele alın.

p noktasının komşuluğundaki tüm noktaların p’den doğrudan erişilebilir olduğu söylenir. Şimdi p’den doğrudan erişilebilen q noktasının komşuluğunu inceleyelim. Sarı çember q’nun komşuluğunu temsil eder.

Artık hedef noktanız r, başlangıç noktanız p’nin komşuluğunda olmasa da q noktasının komşuluğunda yer alır. Yoğunlukça erişilebilirlik fikri budur: Bir p noktasından başlayıp komşuluktan komşuluğa atlayarak r noktasına ulaşabiliyorsanız, r noktası p noktasından yoğunlukça erişilebilirdir.

Bir benzetme olarak, yoğunlukça erişilebilir noktaları “arkadaşın arkadaşı” gibi düşünebilirsiniz. Bir çekirdek nokta p’nin doğrudan erişilebilir olanları onun “arkadaşları”ysa, p’nin “arkadaşlarının” komşuluğundaki noktalar, yani yoğunlukça erişilebilir noktalar “arkadaşının arkadaşı”dır. Açık olmayabilecek bir şey: yoğunlukça erişilebilirlik yalnızca iki bitişik komşuluk atlamasıyla sınırlı değildir. Bir çekirdek nokta p’den başlayarak “komşuluk atlamaları”yla bir noktaya ulaşabildiğiniz sürece, o nokta p’den yoğunlukça erişilebilirdir; dolayısıyla “arkadaşın arkadaşının arkadaşının … arkadaşı” da dâhildir.
Bu yoğunlukça erişilebilirlik fikrinin ɛ değerimize bağlı olduğunu akılda tutmak önemlidir. Daha büyük ɛ değerleri seçerek daha çok nokta yoğunlukça erişilebilir hâle gelir; daha küçük ɛ değerleriyle daha az nokta yoğunlukça erişilebilir olur.
Aykırılar:
Son olarak “diğer” sınıfa geldik. Aykırı noktalar ne çekirdek noktadır ne de bir çekirdek noktadan yoğunlukça erişilebilecek kadar bir kümeye yakındır. Aykırı noktalar herhangi bir kümeye atanmaz ve bağlama bağlı olarak anormal noktalar olarak değerlendirilebilir.
DBSCAN, popüler Python makine öğrenimi kütüphanesi Scikit-Learn’de zaten çok güzel bir şekilde uygulanmıştır ve bu uygulama ölçeklenebilir ve iyi test edildiği için, DBSCAN’in pratikte nasıl çalıştığını görmek üzere bunu kullanacaksınız.
DBSCAN algoritmasının adımları şunlardır:
Bu vaka çalışmasında bir toptancı dağıtıcıya ait yıllık müşteri verilerinden oluşan bir veri kümesini kullanacaksınız.
Hadi başlayalım.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
Veri kümesi 440 müşteriden oluşur ve her biri için 8 öznitelik içerir. .csv dosyasını içe aktarmak ve bir DataFrame nesnesine dönüştürmek için Pandas kütüphanesini kullanacaksınız.
.csv dosyanızı içe aktarırken, dosyanın doğru yolunu sağladığınızdan emin olun.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
DBSCAN uygulamasına daha ileri gitmeden önce, veri kümesini iyi tanımanız; veri kümesinde ne tür veriler olduğu, verinin hangi dağılımı izlediği ve hangi özniteliklerin sayısal olup olmadığı gibi noktaları bilmeniz çok önemlidir.
Bu veri kümesinin resmî UCI makine öğrenimi deposunda verilen açıklamasına göre, özniteliklere ilişkin bilgiler şöyledir:
Artık veri kümesindeki öznitelikler hakkında bilgi sahibi olduğunuza göre, bazı istatistikleri gösterelim.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Yukarıdaki çıktıda görüldüğü gibi, veri kümesinde eksik değer yok ve tüm veriler tamsayı türünde. Bu da ek ön işleme yükünü azaltır. Biraz daha derine inelim.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Yukarıdaki çıktıya bakarak, veri kümesindeki her bir öznitelik için standart sapma, ortalama, maksimum gibi gerekli istatistiksel ölçüleri elde edebilirsiniz. Veri kümesindeki verilerin çoğunun sürekli yapıda olduğunu; ancak iki özniteliğin (Channel ve Region) bu kapsama girmediğini görüyorsunuz. Hesaplamalarınızı kolaylaştırmak için bu ikisini düşüreceksiniz:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Veriyi görselleştirebilmek için iki özniteliği kullanacaksınız:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
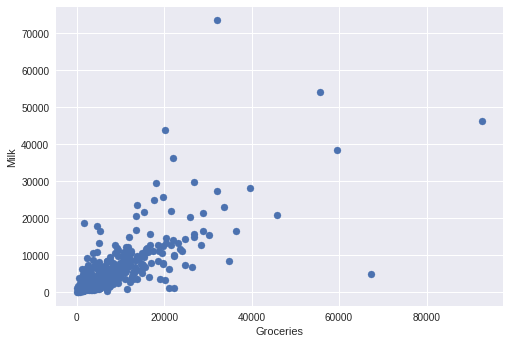
Çizim için kullandığınız işlevleri kısaca özetleyelim: plt.scatter(): Bu işlev, (parametre olarak verdiğiniz [x ve y]) verilere dayalı olarak dağılım grafiğini oluşturur. plt.xlabel(): X eksenine bir etiket koymanıza yardımcı olur (bu durumda Groceries). plt.ylabel(): Y eksenine bir etiket koymanıza yardımcı olur (bu durumda Milk). plt.show(): Grafik oluşturulduktan sonra çıktıda gösterilmesini sağlar.
Tüm görselleştirme ihtiyaçlarınız için Matplotlib’in güzel dünyasını mutlaka keşfetmelisiniz. Dokümantasyonu gerçekten harika.
Uzakta kalan veri noktalarını kolayca fark edebilirsiniz. Değil mi? İşte bunlar aykırı değerleriniz.
DBSCAN ile, bu ana müşteri kümesini belirlemek istiyoruz; ancak daha sıra dışı yıllık satın alma alışkanlıklarına sahip müşterileri de aykırı olarak işaretlemek istiyoruz.
Verideki değerler binler düzeyinde olduğundan, her özniteliği ortalaması 0 ve varyansı 1 olacak şekilde ölçekleyerek normalize edeceksiniz. Bunun yaptığı şey, öznitelikler arasındaki ilişkilerin korunmasına yardımcı olmaktır; böylece bir öznitelikteki küçük bir değişim diğerine de yansır.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Bir komşuluğun çekirdek nokta sayılabilmesi için yarıçapı 0,5 olan bir komşulukta en az 15 veri noktası gerektiren bir DBSCAN nesnesi oluşturacaksınız.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Sonraki adımda, sonuçlarımızı çizmek için küme etiketlerimizi ve aykırıları çıkarabiliriz.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Sezgiyle uyumlu olarak, DBSCAN algoritması ortalama market ve ortalama süt ürünü alışlarına yakın müşterilerden oluşan bir kümeyi tanımlayabildi. Ayrıca, yıllık satın alma davranışı diğer müşterilerden çok sapan müşterileri aykırı olarak işaretleyebildi.
Aykırı değerler daha uç satın alma davranışlarına sahip müşterilere karşılık geldiğinden, toptancı dağıtıcı bu müşterileri daha büyük alışverişleri teşvik etmek için özel indirimlerle özellikle hedefleyebilir.
Bir e-ticaretimiz olduğunu ve müşterilerimize ilgili ürünleri önererek satışlarımızı artırmak istediğimizi varsayalım. Müşterilerimizin tam olarak ne aradığını bilmiyoruz; ancak bir veri kümesine dayanarak belirli bir müşteriye ilgili bir ürün tahmin edip önerebiliriz. DBSCAN’i veri kümemize (e-ticaret veritabanına dayalı) uygulayarak kullanıcıların satın aldığı ürünlere göre kümeler bulabiliriz. Bu kümeleri kullanarak müşteriler arasında benzerlikler bulabiliriz; örneğin, müşteri A bir kalem, bir kitap ve bir makas aldıysa; müşteri B bir kitap ve bir makas aldıysa, müşteriye bir kalem önerebilirsiniz.
Derin öğrenme tabanlı gelişmiş yöntemlerin yükselişinden önce, araştırmacılar, kanseri tetikleme olasılığı taşıyan genleri içeren bir gen veri kümesinden genleri ayırmak için DBSCAN’i kullanıyordu.
Bilim insanları, mobil GPS cihazlarından üretilen yörünge verilerinde durakları tespit etmek için DBSCAN’i kullandılar. Duraklar, bir yörüngenin en anlamlı ve en önemli parçasını temsil eder.
Bu blog yazısında merkez tabanlı kümelemenin temel dezavantajlarını öğrendiniz ve yoğunluk temelli başka bir kümeleme teknikleri ailesine aşina oldunuz. Ayrıca, bunların merkez tabanlı kümelemenin eksiklerini nasıl giderdiğini gördünüz.
DBSCAN’in nasıl çalıştığını öğrendiniz ve bir vaka çalışması gerçekleştirdiniz. Ayrıca, DBSCAN’in çözüme kavuşturmak için kullanıldığı gerçek hayat problemlerine dair genel bir bakış edindiniz. Ek okuma olarak, Level Set Tree kümeleme gibi diğer yoğunluk temelli kümeleme yöntemlerine ve DBSCAN’den nasıl farklı olduklarına göz atmanızı öneririm.
Python’da kümeleme hakkında daha fazla bilgi edinmek isterseniz, Python’da Denetimsiz Öğrenme kursumuzu alın.
Martin Ester, Hans-Peter Kriegel, Jörg Sander ve Xiaowei Xu. 1996. Gürültülü büyük uzamsal veritabanlarında kümeler keşfetmek için yoğunluk temelli bir algoritma. Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96) içinde, Evangelos Simoudis, Jiawei Han ve Usama Fayyad (Ed.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Python hakkında daha fazlasını öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




