课程
Python 中的无监督学习
4 小时
184.3K
简而言之,聚类是一项将一组对象进行分组的任务,使同一簇内的对象彼此之间比与其他簇中的对象更为相似。相似性是一种度量,用于反映两个数据对象之间关系的强度。聚类主要用于探索性数据挖掘,且在诸多领域有广泛应用,例如机器学习、模式识别、图像分析、信息检索、生物信息学、数据压缩和计算机图形学。
聚类技术有许多家族,您可能最熟悉的是最流行的一种:K-Means(属于基于质心的聚类家族)。快速回顾一下,K-Means 会在数据中确定 k 个质心,并将各点分配给最近的质心以形成簇。
尽管 K-Means 容易理解且便于实践实现,但该算法不处理离群点,因此即使某些点不属于任何簇,它们也会被强行分配到某个簇中。在异常检测领域,这会导致问题,因为异常点会与“正常”数据点分到同一簇。异常点会把簇的质心拉向它们,从而更难将其识别为异常点。
本教程将介绍另一种称为基于密度的聚类技术,具体为 DBSCAN(一种基于密度的聚类方法)。与 K-Means 等基于质心的聚类相比,基于密度的聚类通过识别点的“稠密”区域来工作,使其能够学习任意形状的簇并识别数据中的离群点。
在讨论基于质心聚类的劣势之前,先做个简要介绍。质心是位于簇中心的一个数据点(可为假想点或真实点)。在基于质心的聚类中,簇由一个中心向量或质心表示。该质心不一定是数据集的成员。基于质心的聚类是一种迭代的聚类算法,其中相似性的概念来自数据点与簇的质心之间的距离有多近。
有时数据集会包含超出预期范围、与其他数据不同的极端值。这些称为离群点。更正式地说,离群点是在来自某总体的随机样本中,距其他值存在异常远距离的观测。
基于质心的聚类技术的根本出发点是数据点与质心之间的距离度量。因此,这类技术通常难以识别那些大幅偏离数据正态分布的数据点。即便在构建预测模型之前,离群点也会导致误导性的可视化表示,从而对采集数据的解读产生误导。这对于从数据中构建高效的预测与分析模型而言是不可取的。
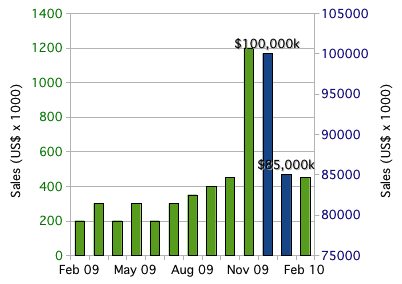
您可以将下面这两个比其余柱子更高的柱形视为该特定数据中的离群点:
在讨论基于密度的聚类之前,您需要先了解一个主题:ɛ-邻域。
ɛ-邻域的总体思想是:给定一个数据点,您希望能够推断其周围空间内的数据点。形式化地,对于某个实数 ɛ > 0 和某个点 p,p 的 ɛ-邻域定义为距 p 的距离至多为 ɛ 的点的集合。
回想几何学,所有点到中心等距的形状是圆。在二维空间中,点 p 的 ɛ-邻域是以 p 为圆心、半径为 ɛ 的圆内包含的点集合。在三维空间中,ɛ-邻域是以 p 为球心、半径为 ɛ 的球体;在更高维空间中,ɛ-邻域就是以 p 为中心、半径为 ɛ 的N 维球。
让我们通过一个例子来使这一概念更具体。下图中有 100 个数据点,分布在区间 [1,3]X[2,4] 内。我们选取点 (3,2) 作为点 p。

首先,考虑半径为 0.5(ɛ = 0.5)的 p 的邻域,即距离 p 不超过 0.5 的点的集合。

不透明的绿色椭圆表示我们的邻域,该邻域内有 31 个数据点。由于一共散布了 100 个数据点,其中 31 个位于此邻域内,这意味着半径为 0.5 的 p 的邻域中包含的数据点略低于三分之一。
现在将半径改为 0.15(ɛ = 0.15),考虑得到的更小的邻域。

邻域缩小后,其中仅包含 3 个数据点。将 ɛ 从 0.5 减小到 0.15(减少 70%),邻域内的点数从 31 个减少到 3 个(减少 90%)。
既然您已经对“邻域”有了较好的理解,我将介绍下一个重要概念:邻域的“密度”概念(毕竟,您正要学习“基于密度的聚类”)。
在小学科学课中,孩子们会学到密度 = 质量/体积。让我们用“质量除以体积”的思路来定义某点 p 的密度。若考虑某点 p 及其半径为 ɛ 的邻域,可以将邻域的质量定义为邻域内包含的数据点数量(或等价地,包含的数据点所占的比例),邻域的体积则是该邻域所对应形状的体积。在二维情况下,邻域是圆,因此体积就是该圆的面积;在三维及更高维情况下,邻域是球或 n 维球,其体积可据此计算。
例如,再次考虑半径为 0.5 的 p = (3,2) 的邻域。
质量是邻域内数据点的数量,因此质量 = 31。体积是圆的面积,因此体积 = π0.52 = π/4。因此,我们在 p = (3,2) 处的局部密度近似为 density = 质量/体积 = 31/(π/4) = 124/π ~= 39.5。
该值本身没有意义,但如果您为数据集中所有点都计算局部密度近似,则可以用如下方式进行聚类:将彼此接近(处于同一邻域)且局部密度近似值相似的点归为同一簇。如果您减小 ɛ 的取值,就能构造更小的邻域(更小体积),其中包含更少的数据点。理想情况下,您希望识别高度稠密的邻域,即大多数数据点位于这些邻域中,同时每个邻域的体积相对较小。
虽然这并非 DBSCAN 或 Level Set Tree 算法(另一种属于基于密度聚类家族的技术)的精确做法,但它构成了基于密度聚类的一般直觉。
回顾一下,您已经了解了 ɛ-邻域,以及它们如何帮助我们推断特定点周围的空间。接着,您学习了某个特定点在特定邻域下的密度概念。在下一节中,您将认识 DBSCAN 算法,其中 ɛ-球是定义簇的基本工具。
DBSCAN 是 Density-Based Spatial Clustering of Applications with Noise(带噪声的基于密度的应用空间聚类)的缩写,它无疑是最知名的基于密度的聚类算法。该算法最早由 Ester 等人于 1996 年首次提出。由于其在理论与应用中的重要性,该算法在 2014 年 SIGKDD 上获得“Test of Time Award”三大奖项之一。
与 K-Means 不同,DBSCAN 不需要将簇的数量作为参数输入。相反,它会基于数据推断簇的数量,并可发现任意形状的簇(相比之下,K-Means 通常发现的是近似球形的簇)。如前所述,ɛ-邻域对于 DBSCAN 近似局部密度至关重要,因此该算法有两个参数:
利用这两个参数,DBSCAN 将数据点分为三类:
这些定义可能比较抽象,让我们更详细地说明各类含义。
核心点:
核心点是我们构建簇的基础,基于上一节讨论的密度近似。您使用相同的 ɛ 来计算每个点的邻域,因此所有邻域的体积相同。但每个邻域中包含的其他点数量不同。回想我提到过,您可以将邻域中的数据点数视为其质量。每个邻域的体积是常数,而邻域的质量是变量,因此通过对成为核心点所需的最小质量设置阈值,实际上就是设置了最小密度阈值。因此,核心点是满足最小密度要求的数据点。我们的簇围绕核心点构建(因此称为“核心”),通过调整 minPts 参数,您可以微调簇核心需要达到的稠密程度。
边界点:
边界点是簇中不是核心点的那些点。在上面对边界点的定义中,我使用了“密度可达(density-reachable)”一词。我尚未定义该术语,但概念很简单。为解释它,让我们回到 ɛ = 0.15 的邻域示例。考虑点 r(黑点),它位于点 p 的邻域之外。

点 p 的邻域内的所有点都称为可从 p 直接到达。现在,让我们考察点 q(可从 p 直接到达的一个点)的邻域。黄色圆圈表示 q 的邻域。

虽然目标点 r 不在起点 p 的邻域中,但它包含在点 q 的邻域内。这就是密度可达的思想:如果您可以从点 p 出发,通过在邻域之间“跳跃”到达点 r,则 r 对于 p 是密度可达的。

打个比方,您可以把密度可达的点看作“朋友的朋友”。如果核心点 p 的可直接到达点是它的“朋友”,那么密度可达点(位于这些“朋友”的邻域中的点)就是“朋友的朋友”。需要强调的一点是,密度可达并不限于两次相邻邻域跳跃。只要您能从某个核心点 p 出发,靠“邻域跳跃”到达目标点,该点就是从 p 密度可达的,因此“朋友的朋友的朋友……的朋友”也包括在内。
务必牢记,密度可达的概念依赖于 ɛ 的取值。选择更大的 ɛ,会有更多点变为密度可达;选择更小的 ɛ,则可达的点会更少。
离群点:
最后来说“其他”类别。离群点既不是核心点,也不足以接近某个簇以至于可从核心点密度可达。离群点不会分配到任何簇,并且在某些情境下可能被视为异常点。
DBSCAN 已在流行的Python 机器学习库 Scikit-Learn中有出色实现。由于该实现具备可扩展性且经过良好测试,您将使用它来了解 DBSCAN 在实践中的工作方式。
DBSCAN 算法的步骤如下:
在本案例中,您将使用一个包含某批发分销商年度客户数据的数据集。
那么,我们开始吧。
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
该数据集包含 440 位客户,每位客户有 8 个属性。您将使用 Pandas 库导入 .csv 文件并将其转换为 DataFrame 对象。
在将 .csv 文件导入时,请确保提供该文件的准确路径。
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
在进一步应用 DBSCAN 之前,了解数据非常重要,例如数据集中包含何种数据、数据服从何种分布、哪些特征是数值型等。
根据该数据集在官方 UCI 机器学习库中的描述,数据集各特征的信息如下:
既然您已经了解了数据集的特征,让我们展示一些数据的统计信息。
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
从上面的输出可以看到,数据集中没有缺失值,且所有数据的类型都是整数。这在一定程度上减少了后续预处理的负担。我们再深入一点。
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
从上述输出中,您可以获得所有必要的统计量,例如每个特征的标准差、均值和最大值。可以看到,该数据集中的大多数数据都是连续型,除了两个特征:Channel 和 Region。为便于计算,您将删除这两个特征:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
为了可视化数据,您将使用两个特征:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
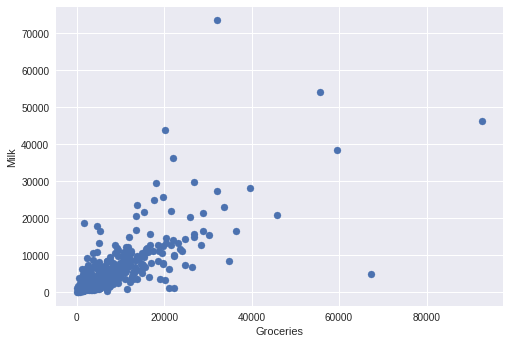
简要说明一下用于绘图的函数:plt.scatter():根据您提供的数据参数(x 和 y)创建散点图。plt.xlabel():为X 轴添加标签(此处为 Groceries)。plt.ylabel():为Y 轴添加标签(此处为 Milk)。plt.show():图形创建后,用于将其显示为输出。
在可视化中,您很容易发现远离主体的数据点,对吧?这些就是离群点。
借助 DBSCAN,我们希望识别出主要的客户簇,同时也要将年度购买习惯更为异常的客户标记为离群点。
由于数据取值以千为量级,您将对每个属性进行标准化,使其具有 0 均值和单位方差。其基本作用是保持特征之间的相互关系,使某个特征的细微变化能够在其他特征上有所反映。
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
您将构建一个 DBSCAN 对象,要求半径为 0.5 的邻域内至少有 15 个数据点才被视为核心点。
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
接下来,提取聚类标签和离群点,以绘制结果。
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

与直觉一致,DBSCAN 算法能够识别出围绕杂货和牛奶产品购买均值附近的一类客户簇。此外,它还能标记那些年度购买行为与其他客户差异过大的客户。
由于离群点对应于购买行为更为极端的客户,批发分销商可以有针对性地向这些客户提供专属折扣,以鼓励更大额的购买。
假设我们有一个电商平台,希望通过向客户推荐相关产品来提升销售额。我们并不确切知道客户在寻找什么,但可以基于数据集进行预测,并向特定客户推荐相关产品。我们可以将 DBSCAN 应用于(基于电商数据库的)数据集,并根据用户购买的产品找到聚类。借助这些聚类,我们可以发现客户之间的相似性。例如,如果客户 A 购买了钢笔、书籍和一把剪刀,而客户 B 购买了书籍和一把剪刀,那么就可以向客户 B 推荐一支钢笔。
在深度学习的先进方法兴起之前,研究人员曾使用 DBSCAN 从基因数据集中分离出可能介导癌症的基因。
科学家使用 DBSCAN 来检测由移动 GPS 设备生成的轨迹数据中的停留点。停留点代表轨迹中最有意义、最重要的部分。
在这篇博文中,您了解了基于质心聚类的主要劣势,并熟悉了另一类聚类技术,即基于密度的聚类。您也看到了它们如何克服基于质心聚类的不足之处。
您学习了 DBSCAN 的工作原理,并对其进行了一个案例研究。此外,您对 DBSCAN 在现实问题中的应用也有了较为全面的了解。作为延伸阅读,强烈建议您了解其他基于密度的聚类方法,比如Level Set Tree 聚类,并了解它与 DBSCAN 的区别。
如果您想进一步学习在 Python 中的聚类,请参加我们的 Python 无监督学习课程。
Martin Ester, Hans-Peter Kriegel, Jörg Sander, and Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han, and Usama Fayyad (Eds.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
进一步了解 Python
课程
课程
课程