कोर्स
Python में Unsupervised Learning
4 घंटा
184.3K
संक्षेप में, क्लस्टरिंग वह कार्य है जिसमें वस्तुओं के एक समूह को इस तरह बांटा जाता है कि एक ही क्लस्टर में शामिल वस्तुएं एक-दूसरे से अन्य क्लस्टर की वस्तुओं की तुलना में अधिक समान हों। समानता वह मात्रा है जो दो डेटा ऑब्जेक्ट्स के बीच संबंध की मजबूती को दर्शाती है। क्लस्टरिंग का मुख्य उपयोग अन्वेषणात्मक डेटा माइनिंग में होता है। क्लस्टरिंग के मशीन लर्निंग, पैटर्न रिकग्निशन, इमेज विश्लेषण, सूचना पुनर्प्राप्ति, बायो-इन्फॉर्मेटिक्स, डेटा कंप्रेशन और कंप्यूटर ग्राफिक्स जैसे कई क्षेत्रों में व्यापक उपयोग हैं।
क्लस्टरिंग तकनीकों के कई परिवार हैं, और आप शायद सबसे लोकप्रिय तकनीक K-Means से परिचित होंगे (जो centroid-आधारित क्लस्टरिंग परिवार में आती है)। एक त्वरित रिमाइंडर के रूप में, K-Means डेटा में k सेन्ट्रॉइड्स निर्धारित करता है और बिंदुओं को उनके निकटतम सेन्ट्रॉइड को असाइन करके क्लस्टर बनाता है।
हालांकि K-Means समझने और व्यवहार में लागू करने में आसान है, यह एल्गोरिदम आउट्लायर्स का ध्यान नहीं रखता, इसलिए सभी बिंदु किसी-न-किसी क्लस्टर में असाइन हो जाते हैं, चाहे वे वास्तव में किसी में न आते हों। विसंगति (anomaly) पहचान के क्षेत्र में यह समस्या पैदा करता है क्योंकि असामान्य बिंदु भी “सामान्य” डेटा बिंदुओं वाले क्लस्टर में शामिल हो जाते हैं। ये असामान्य बिंदु क्लस्टर के सेन्ट्रॉइड को अपनी ओर खींच लेते हैं, जिससे उन्हें असामान्य के रूप में वर्गीकृत करना कठिन हो जाता है।
इस ट्यूटोरियल में हम क्लस्टरिंग की एक अन्य किस्म, डेंसिटी-आधारित क्लस्टरिंग, खासकर DBSCAN (एक डेंसिटी-आधारित क्लस्टरिंग तकनीक) को कवर करेंगे। K-Means जैसी सेन्ट्रॉइड-आधारित क्लस्टरिंग की तुलना में, डेंसिटी-आधारित क्लस्टरिंग “घने” बिंदु-समूहों की पहचान करके काम करती है, जिससे यह मनचाहे आकार के क्लस्टर सीख सकती है और डेटा में आउट्लायर्स को पहचान सकती है।
Centroid-आधारित क्लस्टरिंग की कमियों पर चर्चा करने से पहले, इसका संक्षिप्त परिचय लें। सेन्ट्रॉइड किसी क्लस्टर के केंद्र में स्थित एक डेटा बिंदु (काल्पनिक या वास्तविक) होता है। सेन्ट्रॉइड-आधारित क्लस्टरिंग में, क्लस्टर को एक केंद्रीय वेक्टर या सेन्ट्रॉइड द्वारा दर्शाया जाता है। यह सेन्ट्रॉइड जरूरी नहीं कि डेटासेट का सदस्य हो। सेन्ट्रॉइड-आधारित क्लस्टरिंग एक आवर्ती (iterative) एल्गोरिदम है जिसमें समानता की धारणा क्लस्टर के सेन्ट्रॉइड से किसी डेटा बिंदु की निकटता पर आधारित होती है।
कभी-कभी किसी डेटासेट में ऐसे चरम मान हो सकते हैं जो अपेक्षित सीमा से बाहर हों और बाकी डेटा से अलग दिखें। इन्हें आउट्लायर्स कहते हैं। औपचारिक रूप से, आउट्लायर वह प्रेक्षण है जो जनसंख्या से लिए गए एक यादृच्छिक नमूने में अन्य मानों से असामान्य दूरी पर होता है।
सेन्ट्रॉइड-आधारित क्लस्टरिंग तकनीकों का मूल डेटा बिंदुओं और सेन्ट्रॉइड्स के बीच दूरी के माप पर आधारित होता है। इसलिए, ये तकनीकें सामान्य वितरण से बहुत अधिक विचलित होने वाले बिंदुओं की पहचान करने में प्रायः विफल रहती हैं। भविष्यवाणीय (predictive) मॉडल तैयार करने से पहले भी, आउट्लायर्स भ्रामक प्रतिनिधित्व और फलस्वरूप एकत्रित डेटा की भ्रामक व्याख्या का कारण बन सकते हैं। यह कुशल भविष्यवाणीय और विश्लेषणात्मक मॉडल बनाने के लिए वांछनीय नहीं है।
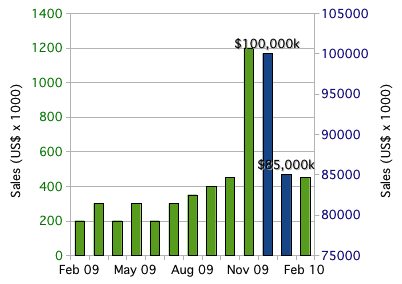
आप निम्न ग्राफ में बाकी बार्स से ऊंची दो बार्स को उस विशेष डेटा में आउट्लायर्स मान सकते हैं:
डेंसिटी-आधारित क्लस्टरिंग पर बात करने से पहले, आपको एक विषय कवर करना होगा: ɛ-नेबरहुड्स।
ɛ-नेबरहुड्स के पीछे सामान्य विचार यह है कि किसी दिए गए डेटा बिंदु के लिए, आप उसके आसपास के स्पेस में मौजूद बिंदुओं के बारे में तर्क कर सकें। औपचारिक रूप से, किसी वास्तविक मान वाले ɛ > 0 और किसी बिंदु p के लिए, p का ɛ-नेबरहुड उन बिंदुओं का समुच्चय है जो p से अधिकतम दूरी ɛ पर हैं।
ज्यामिति में, वह आकृति जिसमें सभी बिंदु केंद्र से समान दूरी पर होते हैं, वृत्त है। 2D स्पेस में, बिंदु p का ɛ-नेबरहुड उस वृत्त के भीतर के बिंदुओं का समूह है जिसका त्रिज्या ɛ है और जिसका केंद्र p है। 3D स्पेस में, ɛ-नेबरहुड त्रिज्या ɛ का गोला है जिसका केंद्र p है, और उच्च-आयामी स्पेस में, ɛ-नेबरहुड त्रिज्या ɛ वाला N-sphere होता है जिसका केंद्र p है।
इस विचार को ठोस बनाने के लिए एक उदाहरण लें। नीचे दी गई छवि में 100 डेटा बिंदु [1,3]X[2,4] अंतराल में बिखरे हुए हैं। हम (3,2) बिंदु को p मानते हैं।

पहले, 0.5 त्रिज्या (ɛ = 0.5) वाले p के नेबरहुड पर विचार करें, यानी p से 0.5 दूरी के भीतर आने वाले बिंदु।

अस्पष्ट हरे रंग का अंडाकार हमारा नेबरहुड दर्शाता है, और इस नेबरहुड में 31 डेटा बिंदु हैं। चूंकि कुल 100 बिंदु बिखरे गए थे और 31 नेबरहुड में हैं, इसका मतलब है कि 0.5 त्रिज्या वाले p के नेबरहुड में कुल डेटा बिंदुओं का लगभग एक-तिहाई से कम भाग आता है।
अब, अपनी त्रिज्या 0.15 (ɛ = 0.15) कर देते हैं और परिणामी छोटे नेबरहुड पर विचार करते हैं।

अब नेबरहुड कुछ सिकुड़ गया है, इसलिए इसमें केवल 3 डेटा बिंदु शामिल हैं। ɛ को 0.5 से 0.15 तक घटाने (70% की कमी) से हमारे नेबरहुड में बिंदुओं की संख्या 31 से घटकर 3 (90% की कमी) रह गई।
अब जब आपको “नेबरहुड” की अच्छी समझ हो गई है, तो मैं अगला महत्वपूर्ण कॉन्सेप्ट प्रस्तुत करूंगा: किसी नेबरहुड की “घनत्व” की धारणा (आखिरकार, आप “डेंसिटी-आधारित क्लस्टरिंग” सीखने की ओर बढ़ रहे हैं)।
स्कूल-स्तरीय विज्ञान में बच्चों को सिखाया जाता है कि घनत्व = द्रव्यमान/आयतन। चलिए द्रव्यमान को आयतन से भाग देकर किसी बिंदु p पर घनत्व परिभाषित करने का यही विचार अपनाते हैं। यदि आप किसी बिंदु p और त्रिज्या ɛ वाले उसके नेबरहुड पर विचार करें, तो नेबरहुड का द्रव्यमान उस नेबरहुड में निहित डेटा बिंदुओं की संख्या (या वैकल्पिक रूप से, डेटा बिंदुओं के अंश) के रूप में परिभाषित किया जा सकता है, और नेबरहुड का आयतन उस नेबरहुड के परिणामी आकार का आयतन होता है। 2D मामले में, नेबरहुड एक वृत्त है, इसलिए नेबरहुड का आयतन उस वृत्त का क्षेत्रफल होता है। 3D और उच्च-आयामी मामलों में, नेबरहुड एक गोला या n-स्फीयर होता है, इसलिए आप इस आकार का आयतन निकाल सकते हैं।
उदाहरण के लिए, p = (3,2) और त्रिज्या 0.5 वाले हमारे नेबरहुड पर फिर से विचार करें।
द्रव्यमान नेबरहुड में मौजूद डेटा बिंदुओं की संख्या है, इसलिए mass = 31। आयतन वृत्त का क्षेत्रफल है, अतः volume = π0.52 = π/4। इसलिए, * p = (3,2) पर हमारा स्थानीय घनत्व सन्निकटन है: density = mass/volume = 31/(π/4) = 124/π ~= 39.5।
यह मान अपने आप में निरर्थक है, लेकिन यदि आप हमारे डेटासेट के सभी बिंदुओं के लिए स्थानीय घनत्व सन्निकटन की गणना करें, तो आप यह कहकर बिंदुओं का क्लस्टर बना सकते हैं कि जो बिंदु पास-पास हैं (एक ही नेबरहुड में आते हैं) और जिनके स्थानीय घनत्व सन्निकटन समान हैं, वे एक ही क्लस्टर में आते हैं। यदि आप ɛ का मान घटाते हैं, तो आप छोटे नेबरहुड (कम आयतन) बना सकते हैं जिनमें कम डेटा बिंदु भी होंगे। आदर्श रूप से, आप अत्यधिक घने नेबरहुड्स की पहचान करना चाहेंगे जहाँ अधिकांश डेटा बिंदु इन्हीं नेबरहुड्स में हों, लेकिन प्रत्येक नेबरहुड का आयतन अपेक्षाकृत छोटा हो।
यद्यपि DBSCAN या Level Set Tree एल्गोरिदम (डेंसिटी-आधारित क्लस्टरिंग परिवार की एक अन्य तकनीक) ठीक-ठीक ऐसा नहीं करते, यही डेंसिटी-आधारित क्लस्टरिंग के पीछे की सामान्य अंतर्दृष्टि बनाता है।
पुनरावलोकन के लिए, आपने ɛ-नेबरहुड्स को कवर किया और देखा कि वे किसी विशेष बिंदु के आसपास के स्पेस के बारे में तर्क करने देते हैं। फिर आपने किसी विशेष नेबरहुड के लिए किसी बिंदु पर घनत्व की धारणा सीखी। अगला खंड DBSCAN एल्गोरिदम पर है जहाँ क्लस्टर्स परिभाषित करने के लिए ɛ-बॉल एक बुनियादी उपकरण है।
DBSCAN का अर्थ है Density-Based Spatial Clustering of Applications with Noise और यह निस्संदेह सबसे प्रसिद्ध डेंसिटी-आधारित क्लस्टरिंग एल्गोरिदम है। इसे पहली बार 1996 में Ester et. al द्वारा पेश किया गया था। सिद्धांत और अनुप्रयोगों दोनों में इसके महत्व के कारण, इस एल्गोरिदम को SIGKDD 2014 में Test of Time Award से सम्मानित तीन एल्गोरिदम में से एक चुना गया था।
K-Means के विपरीत, DBSCAN को पैरामीटर के रूप में क्लस्टर्स की संख्या की आवश्यकता नहीं होती। यह डेटा के आधार पर क्लस्टर्स की संख्या का अनुमान लगाता है और मनचाहे आकार के क्लस्टर्स खोज सकता है (तुलना के लिए, K-Means आमतौर पर गोलाकार क्लस्टर्स खोजता है)। जैसा कि आपने पहले देखा, स्थानीय घनत्व का अनुमान लगाने के लिए ɛ-नेबरहुड DBSCAN में मौलिक है, इसलिए एल्गोरिदम के दो पैरामीटर्स होते हैं:
इन दो पैरामीटर्स का उपयोग करके, DBSCAN डेटा बिंदुओं को तीन श्रेणियों में बाँटता है:
ये परिभाषाएँ अमूर्त लग सकती हैं, तो चलिए प्रत्येक का मतलब थोड़ी विस्तार से समझते हैं।
Core Points:
कोर पॉइंट्स हमारे क्लस्टर्स की नींव होते हैं और ये पिछले खंड में चर्चा किए गए घनत्व सन्निकटन पर आधारित होते हैं। आप प्रत्येक बिंदु के लिए वही ɛ इस्तेमाल करते हैं ताकि सभी नेबरहुड्स का आयतन समान रहे। हालांकि, प्रत्येक नेबरहुड में अन्य बिंदुओं की संख्या भिन्न होती है। याद रखें, नेबरहुड में डेटा बिंदुओं की संख्या को आप उसका द्रव्यमान मान सकते हैं। प्रत्येक नेबरहुड का आयतन स्थिर है और द्रव्यमान परिवर्तनीय, इसलिए किसी बिंदु को कोर पॉइंट मानने के लिए आवश्यक न्यूनतम द्रव्यमान की सीमा तय करके आप असल में न्यूनतम घनत्व सीमा निर्धारित कर रहे होते हैं। इसलिए, कोर पॉइंट वे डेटा बिंदु हैं जो न्यूनतम घनत्व की शर्त पूरी करते हैं। हमारे क्लस्टर्स इन्हीं कोर पॉइंट्स के इर्द-गिर्द बनते हैं (इसीलिए इन्हें “कोर” कहा जाता है), इसलिए minPts पैरामीटर समायोजित करके आप तय कर सकते हैं कि हमारे क्लस्टर कोर्स कितने घने होने चाहिए।
Border Points:
बॉर्डर पॉइंट्स हमारे क्लस्टर्स में वे बिंदु होते हैं जो कोर पॉइंट नहीं हैं। ऊपर दी गई परिभाषा में, मैंने density-reachable शब्द का उपयोग किया है। मैंने अभी इस शब्द को परिभाषित नहीं किया है, लेकिन अवधारणा सरल है। इस विचार को समझाने के लिए, ɛ = 0.15 वाले हमारे नेबरहुड उदाहरण पर लौटते हैं। बिंदु r (काला डॉट) पर विचार करें जो बिंदु p के नेबरहुड के बाहर है।

बिंदु p के नेबरहुड के अंदर के सभी बिंदु p से सीधे reachable कहलाते हैं। अब, बिंदु q के नेबरहुड की पड़ताल करें, जो p से सीधे reachable एक बिंदु है। पीला वृत्त q के नेबरहुड को दर्शाता है।

अब जबकि आपका लक्षित बिंदु r शुरुआती बिंदु p के नेबरहुड में नहीं है, वह बिंदु q के नेबरहुड में शामिल है। यही density-reachable के पीछे का विचार है: यदि आप नेबरहुड से नेबरहुड पर “कूदते” हुए, बिंदु p से शुरू करके बिंदु r तक पहुँच सकते हैं, तो r बिंदु p से density-reachable है।

एक उपमा के रूप में, आप density-reachable बिंदुओं को “दोस्त के दोस्त” मान सकते हैं। यदि किसी कोर पॉइंट p के सीधे reachable बिंदु उसके “दोस्त” हैं, तो density-reachable बिंदु, यानी p के “दोस्तों” के नेबरहुड के बिंदु, “दोस्तों के दोस्त” हैं। एक बात ध्यान देने योग्य है कि density-reachable केवल दो आसन्न नेबरहुड कूदों तक सीमित नहीं है। जब तक आप किसी कोर पॉइंट p से शुरू करके “नेबरहुड जंप्स” करते हुए उस बिंदु तक पहुँच सकते हैं, वह बिंदु p से density-reachable है, इसलिए “दोस्त के दोस्त के दोस्त … के दोस्त” भी शामिल हैं।
ध्यान रखना महत्वपूर्ण है कि density-reachable का यह विचार हमारे ɛ के मान पर निर्भर है। बड़े ɛ चुनने पर अधिक बिंदु density-reachable हो जाते हैं, और छोटे ɛ चुनने पर कम।
Outliers:
अंततः, “अन्य” श्रेणी पर आते हैं। आउट्लायर्स वे बिंदु हैं जो न तो कोर पॉइंट हैं और न ही किसी क्लस्टर के इतने पास हैं कि वे किसी कोर पॉइंट से density-reachable हों। आउट्लायर्स किसी भी क्लस्टर में असाइन नहीं होते और संदर्भ के अनुसार, उन्हें असामान्य बिंदु माना जा सकता है।
DBSCAN पहले से ही लोकप्रिय Python मशीन लर्निंग लाइब्रेरी Scikit-Learn में खूबसूरती से इम्प्लिमेंटेड है, और चूंकि यह इम्प्लिमेंटेशन स्केलेबल और अच्छी तरह परीक्षणित है, आप इसे उपयोग करके व्यावहारिक रूप से DBSCAN कैसे काम करता है, देखेंगे।
DBSCAN एल्गोरिदम के चरण ये हैं:
इस केस स्टडी के लिए आप एक होलसेल डिस्ट्रीब्यूटर के वार्षिक ग्राहक डेटा वाले डेटासेट का उपयोग करेंगे।
तो, शुरू करते हैं।
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
डेटासेट में 440 ग्राहक हैं और प्रत्येक के लिए 8 एट्रिब्यूट्स हैं। आप Pandas लाइब्रेरी का उपयोग .csv फ़ाइल आयात करने और उसे DataFrame ऑब्जेक्ट में बदलने के लिए करेंगे।
अब अपनी .csv फ़ाइल को आयात करते समय, सुनिश्चित करें कि आप उस फ़ाइल का सही पथ दें।
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
अब DBSCAN लागू करने से पहले, डेटा को अच्छी तरह समझना बहुत महत्वपूर्ण है ताकि पता चले कि डेटासेट में किस तरह का डेटा है, डेटा का वितरण कैसा है, और कौन-से फीचर्स संख्यात्मक हैं या नहीं।
इस डेटासेट के आधिकारिक UCI मशीन लर्निंग रिपॉज़िटरी में दी गई विवरणिका के अनुसार, फीचर्स की जानकारी इस प्रकार है:
अब जब आपको डेटासेट के फीचर्स के बारे में पता चल गया है, तो डेटा के कुछ आँकड़े प्रदर्शित करते हैं।
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
जैसा कि ऊपर के आउटपुट से दिखता है, डेटासेट में कोई missing value नहीं है और सारा डेटा integer प्रकार का है। इससे आगे के प्रीप्रोसेसिंग का बोझ कम हो जाता है। थोड़ा और गहराई में देखते हैं।
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
ऊपर के आउटपुट से आप प्रत्येक फीचर के लिए मानक विचलन, औसत, अधिकतम आदि जैसे सभी आवश्यक सांख्यिकीय माप निकाल सकते हैं। आप देख सकते हैं कि इस डेटासेट के अधिकतर डेटा सतत (continuous) प्रकृति के हैं, सिवाय दो फीचर्स के: Channel और Region। इसलिए गणनाएँ सरल रखने के लिए, आप इन्हें हटा देंगे:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
अब डेटा को विज़ुअलाइज़ करने के लिए, आप दो फीचर्स का उपयोग करेंगे:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
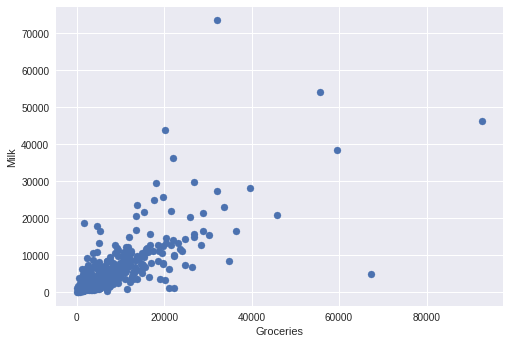
प्लॉटिंग के लिए आपने जिन फ़ंक्शंस का उपयोग किया, उन पर संक्षिप्त नज़र: plt.scatter(): यह आपके द्वारा दिए गए डेटा ([x और y]) के आधार पर स्कैटर प्लॉट बनाता है। plt.xlabel(): यह X-अक्ष पर लेबल लगाने में मदद करता है (यहाँ Groceries)। plt.ylabel(): यह Y-अक्ष पर लेबल लगाने में मदद करता है (यहाँ Milk)। plt.show(): प्लॉट बनने के बाद यह फ़ंक्शन उसे आउटपुट के रूप में प्रदर्शित करता है।
विज़ुअलाइज़ेशन के लिए आप Matplotlib की सुंदर दुनिया ज़रूर देखें। इसका डॉक्यूमेंटेशन बेहतरीन है।
आप आसानी से बहुत दूर छिटके हुए डेटा बिंदु देख सकते हैं, है न? वही आपके आउट्लायर्स हैं।
DBSCAN के साथ, हम ग्राहकों के मुख्य क्लस्टर की पहचान करना चाहते हैं, लेकिन साथ ही ऐसे ग्राहकों को आउट्लायर के रूप में फ़्लैग करना चाहते हैं जिनकी वार्षिक खरीदारी की आदतें असामान्य हैं।
क्योंकि डेटा के मान हजारों में हैं, आप प्रत्येक एट्रिब्यूट को 0 औसत और इकाई वैरिएंस पर स्केल करके सामान्यीकृत करेंगे। इसका मूल उद्देश्य यह है कि फीचर्स के बीच अंतर्संबंध सुरक्षित रहें ताकि एक फीचर में छोटा बदलाव दूसरे में भी झलके।
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
आप एक DBSCAN ऑब्जेक्ट बनाएँगे जो किसी नेबरहुड की त्रिज्या 0.5 में कम से कम 15 डेटा बिंदुओं की आवश्यकता रखता है ताकि उसे कोर पॉइंट माना जा सके।
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
अगले चरण में, हम अपने क्लस्टर लेबल्स और आउट्लायर्स निकालकर परिणाम प्लॉट करेंगे।
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

हमारी अंतर्दृष्टि के अनुरूप, DBSCAN एल्गोरिदम औसत किराना और औसत दूध खरीद के आसपास वाले ग्राहकों का एक क्लस्टर पहचानने में सक्षम रहा। इसके अलावा, यह ऐसे ग्राहकों को भी फ़्लैग कर सका जिनका वार्षिक खरीद व्यवहार अन्य ग्राहकों से काफी अलग था।
क्योंकि आउट्लायर्स वे ग्राहक थे जिनका खरीद व्यवहार अधिक चरम था, होलसेल डिस्ट्रीब्यूटर विशेष छूट देकर बड़े ऑर्डर के लिए खास तौर पर इन ग्राहकों को टार्गेट कर सकता है।
मान लीजिए हमारे पास एक ई-कॉमर्स है और हम अपने ग्राहकों को प्रासंगिक उत्पाद सुझाकर बिक्री बढ़ाना चाहते हैं। हमें ठीक-ठीक नहीं पता कि हमारे ग्राहक क्या ढूंढ रहे हैं, लेकिन किसी डेटासेट के आधार पर हम किसी विशेष ग्राहक को प्रासंगिक उत्पाद की सिफारिश कर सकते हैं। हम अपने डेटा (ई-कॉमर्स डेटाबेस पर आधारित) पर DBSCAN लागू कर सकते हैं और उपयोगकर्ताओं द्वारा खरीदे गए उत्पादों के आधार पर क्लस्टर खोज सकते हैं। इन क्लस्टर्स का उपयोग करके हम ग्राहकों के बीच समानताएँ ढूंढ सकते हैं; उदाहरण के लिए, यदि ग्राहक A ने एक पेन, एक किताब और एक जोड़ी कैंची खरीदी है, जबकि ग्राहक B ने एक किताब और एक जोड़ी कैंची खरीदी है, तो आप ग्राहक B को पेन की सिफारिश कर सकते हैं।
डीप लर्निंग आधारित उन्नत विधियों के आने से पहले, शोधकर्ताओं ने कैंसर से संबंधित होने की संभावना वाले जीनों को किसी जीन डेटासेट से अलग करने के लिए DBSCAN का उपयोग किया।
वैज्ञानिकों ने मोबाइल GPS डिवाइसेज़ से उत्पन्न ट्राजेक्टरी डेटा में रुकावटों (stops) का पता लगाने के लिए DBSCAN का उपयोग किया है। स्टॉप्स किसी ट्राजेक्टरी के सबसे अर्थपूर्ण और सबसे महत्वपूर्ण हिस्से का प्रतिनिधित्व करते हैं।
तो, इस ब्लॉगपोस्ट में आपने सेन्ट्रॉइड-आधारित क्लस्टरिंग की प्रमुख कमियों के बारे में जाना और डेंसिटी-आधारित क्लस्टरिंग नामक क्लस्टरिंग तकनीकों के एक अन्य परिवार से परिचित हुए। आपने यह भी देखा कि वे सेन्ट्रॉइड-आधारित क्लस्टरिंग की कमियों को कैसे दूर करते हैं।
आपने DBSCAN कैसे काम करता है यह सीखा और उसका एक केस स्टडी भी किया। इसके अलावा, आपको वास्तविक जीवन की उन समस्याओं का अच्छा अवलोकन मिला जहाँ DBSCAN का उपयोग किया गया है। आगे पढ़ने के लिए, मैं सुझाव दूँगा कि आप Level Set Tree क्लस्टरिंग जैसी अन्य डेंसिटी-आधारित क्लस्टरिंग विधियों और उनके DBSCAN से अंतर को भी देखें।
यदि आप Python में क्लस्टरिंग के बारे में और सीखना चाहते हैं, तो हमारा Unsupervised Learning in Python कोर्स लें।
Martin Ester, Hans-Peter Kriegel, Jörg Sander, और Xiaowei Xu. 1996. बड़े शोरयुक्त स्थानिक डेटाबेस में क्लस्टर्स खोजने के लिए एक डेंसिटी-आधारित एल्गोरिदम। Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96) में। AAAI Press 226-231।
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Python के बारे में और जानें
कोर्स
कोर्स
कोर्स