
Last chance! 50% off DataCamp Premium
Sale ends in
Kort gezegd is clusteren de taak om een set objecten zo te groeperen dat objecten in hetzelfde cluster meer op elkaar lijken dan op objecten in andere clusters. Gelijkenis is een maat die de sterkte van de relatie tussen twee data-objecten weergeeft. Clustering wordt vooral gebruikt voor verkennende data-analyse. Clustering heeft talloze toepassingen in velden zoals machine learning, patroonherkenning, beeldanalyse, information retrieval, bio-informatica, datacompressie en computer graphics.
Er zijn veel families van clustermethoden, en je kent waarschijnlijk de populairste: K-Means (dat behoort tot de familie van centroid-gebaseerde clustering). Ter opfrissing: K-Means bepaalt k centroiden in de data en groepeert punten door ze toe te wijzen aan het dichtstbijzijnde centroid.
Hoewel K-Means in de praktijk makkelijk te begrijpen en te implementeren is, houdt het algoritme geen rekening met uitschieters, waardoor alle punten aan een cluster worden toegewezen, zelfs als ze nergens echt bij horen. In het domein van anomaliedetectie veroorzaakt dit problemen, omdat afwijkende punten aan hetzelfde cluster worden toegewezen als “normale” datapunten. De afwijkende punten trekken het clustercentroid naar zich toe, waardoor ze lastiger als anomalieën te classificeren zijn.
Deze tutorial behandelt een ander type clustermethode, namelijk density-based clustering, specifiek DBSCAN (een density-based clustermethode). In vergelijking met centroid-gebaseerde clustering zoals K-Means werkt density-based clustering door “dichte” clusters van punten te identificeren, zodat het clusters met willekeurige vormen kan leren en uitschieters in de data kan herkennen.
Voor we het nadeel van centroid-gebaseerde clustering bespreken, eerst kort een introductie. Een centroid is een datapunt (denkbeeldig of echt) in het midden van een cluster. In centroid-gebaseerde clustering worden clusters weergegeven door een centrale vector of centroid. Dit centroid is niet per se een lid van de dataset. Centroid-gebaseerde clustering is een iteratief clusteringalgoritme waarin de notie van gelijkenis is afgeleid van hoe dicht een datapunt bij het centroid van het cluster ligt.
Soms bevat een dataset extreme waarden die buiten het verwachte bereik liggen en niet lijken op de overige data. Dit zijn uitschieters. Formeler: een uitschieter is een observatie die op een abnormale afstand van andere waarden ligt in een aselecte steekproef uit een populatie.
De belangrijkste basis van centroid-gebaseerde clustermethoden wordt gedreven door afstandsmetingen tussen datapunten en centroiden. Daarom falen centroid-gebaseerde methoden doorgaans in het identificeren van datapunten die sterk afwijken van de normale verdeling van de data. Zelfs nog vóórdat voorspellende modellen op data worden gebouwd, kunnen uitschieters leiden tot misleidende weergaven en daarmee misleidende interpretaties van verzamelde data. Dat is onwenselijk bij het bouwen van efficiënte voorspellende en analytische modellen.
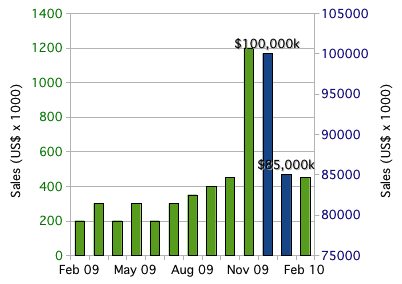
Je kunt de volgende twee hogere balken (dan de rest) als uitschieters in die specifieke data beschouwen:
Voordat we density-based clustering bespreken, moeten we eerst een onderwerp behandelen: ɛ-buurt.
Het algemene idee achter ɛ-buurten is dat je, gegeven een datapunt, wilt kunnen redeneren over de datapunten in de ruimte eromheen. Formeel: voor een reële waarde ɛ > 0 en een punt p, is de ɛ-buurt van p de set punten die op hoogstens afstand ɛ van p liggen.
Denk terug aan meetkunde: de vorm waarin alle punten even ver van het middelpunt liggen, is de cirkel. In 2D-ruimte is de ɛ-buurt van een punt p de set punten die in een cirkel met straal ɛ liggen, gecentreerd op p. In 3D-ruimte is de ɛ-buurt een bol met straal ɛ, gecentreerd op p, en in hogere dimensies is de ɛ-buurt gewoon de N-sfeer met straal ɛ, gecentreerd op p.
Laten we een voorbeeld bekijken om dit idee concreter te maken. In de onderstaande afbeelding zijn 100 datapunten verspreid over het interval [1,3]X[2,4]. Kies het punt (3,2) als ons punt p.

Beschouw eerst de buurt van p met straal 0,5 (ɛ = 0,5), de set punten die op afstand 0,5 van p liggen.

De ondoorzichtige groene ovaal stelt onze buurt voor, en er zijn 31 datapunten in deze buurt. Aangezien er 100 datapunten zijn uitgezet en 31 in de buurt liggen, betekent dit dat iets minder dan een derde van de datapunten binnen de buurt van p met straal 0,5 valt.
Laten we nu onze straal veranderen naar 0,15 (ɛ = 0,15) en de resulterende kleinere buurt bekijken.

Nu is de buurt wat gekrompen, dus er vallen nog maar 3 datapunten binnen. Door ɛ te verlagen van 0,5 naar 0,15 (een daling van 70%), is het aantal punten in onze buurt verminderd van 31 naar 3 (een daling van 90%).
Nu je een goed beeld hebt van “buurt”, introduceer ik het volgende belangrijke concept: het idee van een “dichtheid” voor een buurt (je bent tenslotte op weg om “density-based clustering” te leren).
Op de basisschool leren kinderen dat dichtheid = massa/volume. Laten we dit idee van massa gedeeld door volume gebruiken om de dichtheid op een punt p te definiëren. Als je een punt p en zijn buurt met straal ɛ bekijkt, kun je de massa van de buurt definiëren als het aantal datapunten (of eventueel het aandeel datapunten) binnen die buurt, en het volume van de buurt is het volume van de resulterende vorm van de buurt. In het 2D-geval is de buurt een cirkel, dus het volume van de buurt is gewoon de oppervlakte van de cirkel. In het 3D- en hoger-dimensionale geval is de buurt een bol of n-sfeer, dus kun je het volume van deze vorm berekenen.
Neem bijvoorbeeld opnieuw onze buurt van p = (3,2) met straal 0,5.
De massa is het aantal datapunten in de buurt, dus massa = 31. Het volume is de oppervlakte van de cirkel, dus volume = π0,52 = π/4. Daarom wordt onze lokale dichtheidsbenadering bij * p = (3,2) berekend als dichtheid = massa/volume = 31/(π/4) = 124/π ~= 39,5.
Deze waarde is op zichzelf betekenisloos, maar als je de lokale dichtheidsbenadering voor alle punten in onze dataset berekent, kun je onze punten clusteren door te zeggen dat punten die dichtbij zijn (in dezelfde buurt liggen) en vergelijkbare lokale dichtheidsbenaderingen hebben, tot hetzelfde cluster behoren. Als je de waarde van ɛ verlaagt, kun je kleinere buurten (minder volume) construeren die ook minder datapunten bevatten. Idealiter wil je zeer dichte buurten identificeren waarin de meeste datapunten zijn opgenomen, terwijl het volume van elk van deze buurten relatief klein is.
Hoewel dit niet exact is wat DBSCAN of het Level Set Tree-algoritme (een andere clustermethode uit de familie van density-based clustering) doet, vormt het wel de algemene intuïtie achter density-based clustering.
Samengevat: je hebt de ɛ-buurten behandeld en hoe ze het mogelijk maken te redeneren over de ruimte rond een bepaald punt. Vervolgens leerde je een notie van dichtheid op een bepaald punt voor een bepaalde buurt. In de volgende sectie maak je kennis met het DBSCAN-algoritme, waarbij de ɛ-bal een fundamenteel hulpmiddel is voor het definiëren van clusters.
DBSCAN staat voor Density-Based Spatial Clustering of Applications with Noise en het is met afstand het bekendste density-based clusteringalgoritme. Het werd voor het eerst geïntroduceerd in 1996 door Ester et al.. Vanwege het belang in zowel theorie als toepassingen is dit algoritme een van de drie algoritmen die de Test of Time Award kregen op SIGKDD 2014.
In tegenstelling tot K-Means vereist DBSCAN het aantal clusters niet als parameter. Het leidt het aantal clusters af op basis van de data, en het kan clusters met willekeurige vormen ontdekken (ter vergelijking: K-Means ontdekt meestal bolvormige clusters). Zoals je eerder zag, is de ɛ-buurt fundamenteel voor DBSCAN om de lokale dichtheid te benaderen, dus het algoritme heeft twee parameters:
Met deze twee parameters deelt DBSCAN de datapunten in drie categorieën in:
Deze definities lijken misschien abstract, dus laten we elk ervan in meer detail bespreken.
Kernelpunten:
Kernelpunten vormen de basis voor onze clusters en zijn gebaseerd op de dichtheidsbenadering die ik in de vorige sectie besprak. Je gebruikt dezelfde ɛ om de buurt voor elk punt te berekenen, dus het volume van alle buurten is hetzelfde. Het aantal andere punten in elke buurt verschilt echter. Onthoud dat ik zei dat je het aantal datapunten in de buurt kunt zien als de massa ervan. Het volume van elke buurt is constant, en de massa van de buurt is variabel, dus door een drempel te leggen op de minimale hoeveelheid massa die nodig is om een kernelpunt te zijn, stel je in feite een minimale dichtheidsdrempel in. Kernelpunten zijn dus datapunten die voldoen aan een minimale dichtheidseis. Onze clusters worden rond onze kernelpunten opgebouwd (vandaar het “core”), dus door onze minPts-parameter aan te passen, kun je fijnafstellen hoe dicht onze clusterkernen moeten zijn.
Randpunten:
Randpunten zijn de punten in onze clusters die geen kernelpunt zijn. In de bovenstaande definitie voor randpunten gebruikte ik de term dichtheids-bereikbaar (density-reachable). Ik heb deze term nog niet gedefinieerd, maar het concept is eenvoudig. Om dit te verduidelijken, bekijken we opnieuw ons buurtexample met epsilon = 0,15. Beschouw het punt r (de zwarte stip) dat buiten de buurt van punt p ligt.

Alle punten binnen de buurt van punt p zijn direct bereikbaar vanaf p. Laten we nu de buurt van punt q verkennen, een punt dat direct bereikbaar is vanaf p. De gele cirkel stelt q’s buurt voor.

Hoewel je doelpunt r niet in de buurt van je startpunt p ligt, valt het wel binnen de buurt van punt q. Dit is het idee achter dichtheids-bereikbaar: als je punt r kunt bereiken door van buurt naar buurt te “springen”, beginnend bij een punt p, dan is punt r dichtheids-bereikbaar vanaf punt p.

Als analogie kun je dichtheids-bereikbare punten zien als “vrienden van een vriend”. Als de direct-bereikbaren van een kernelpunt p zijn “vrienden”, dan zijn de dichtheids-bereikbare punten, de punten in de buurt van de “vrienden” van p, de “vrienden van zijn vrienden”. Eén ding dat niet meteen duidelijk is: dichtheids-bereikbare punten zijn niet beperkt tot slechts twee aangrenzende buurtsprongen. Zolang je het punt kunt bereiken via “buurtsprongen”, beginnend bij een kernelpunt p, is dat punt dichtheids-bereikbaar vanaf p, dus ook “vrienden van een vriend van een vriend … van een vriend” zijn inbegrepen.
Het is belangrijk te onthouden dat dit idee van dichtheids-bereikbaar afhankelijk is van onze waarde van ɛ. Door grotere waarden van ɛ te kiezen, worden meer punten dichtheids-bereikbaar, en door kleinere waarden te kiezen, minder.
Uitschieters:
Tot slot kom je bij de “overige”-klasse. Uitschieters zijn punten die geen kernelpunten zijn en ook niet dicht genoeg bij een cluster liggen om dichtheids-bereikbaar te zijn vanaf een kernelpunt. Uitschieters worden niet aan een cluster toegewezen en kunnen, afhankelijk van de context, als anomalieën worden beschouwd.
DBSCAN is al prachtig geïmplementeerd in de populaire Python-machine learning bibliotheek Scikit-Learn, en omdat deze implementatie schaalbaar en goed getest is, ga je die gebruiken om te zien hoe DBSCAN in de praktijk werkt.
De stappen van het DBSCAN-algoritme zijn:
Voor deze case study gebruik je een dataset met jaarlijkse klantgegevens van een groothandelsdistributeur.
Laten we beginnen.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
De dataset bestaat uit 440 klanten en heeft 8 attributen voor elk van deze klanten. Je gebruikt de Pandas-bibliotheek om het .csv-bestand te importeren en om te zetten naar een DataFrame-object.
Bij het importeren van je .csv-bestand in de , zorg ervoor dat je het juiste pad naar dat bestand opgeeft.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Voordat je verdergaat met het toepassen van DBSCAN, is het heel belangrijk dat je de data goed kent: wat voor soort data in de dataset zit, welke verdeling de data volgt en welke features numeriek zijn of niet.
Volgens de beschrijving in de officiële UCI machine learning repository van deze dataset is de informatie over de features als volgt:
Nu je de features van de dataset kent, laten we wat statistieken van de data tonen.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Zoals je in de bovenstaande output kunt zien, zijn er geen missende waarden in de dataset en is alle data van het type integer. Dit vermindert de noodzaak voor verdere preprocessing. Laten we nog wat dieper graven.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Uit de bovenstaande output kun je alle benodigde statistische maten afleiden, zoals standaardafwijking, gemiddelde, minimum en maximum van elke feature in de dataset. Je ziet dat de meeste data in deze dataset van continue aard is, behalve twee features: Channel en Region. Om de berekeningen te vereenvoudigen, laat je deze twee vallen:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Om de data te visualiseren ga je twee features gebruiken:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
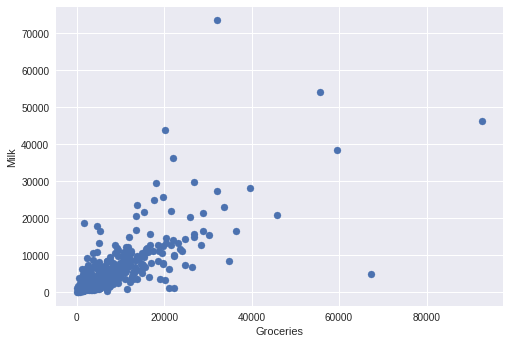
Kort over de functies die je gebruikte om te plotten: plt.scatter(): maakt het spreidingsdiagram op basis van de data (die je als parameters opgeeft [x en y]). plt.xlabel(): hiermee plaats je een label langs de X-as. (Groceries in dit geval) plt.ylabel(): hiermee plaats je een label langs de Y-as. (Milk in dit geval) plt.show(): nadat de plot is gemaakt, toont deze functie de output.
Je zou de datapunten die ver af liggen goed moeten kunnen zien. Toch? Dat zijn je uitschieters.
Met DBSCAN willen we dit hoofdcluster van klanten identificeren, maar we willen ook klanten met meer ongewoon jaarlijks koopgedrag als uitschieters markeren.
Omdat de waarden van de data in de duizenden lopen, ga je elk attribuut normaliseren door het te schalen naar gemiddelde 0 en variantie 1. Wat dit in feite doet, is de onderlinge verhoudingen tussen features intact houden, zodat een kleine verandering in de ene feature doorwerkt in de andere.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Je construeert een DBSCAN-object dat een minimum van 15 datapunten in een buurt met straal 0,5 vereist om als kernelpunt te worden beschouwd.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Vervolgens kunnen we onze clusterlabels en uitschieters extraheren om onze resultaten te plotten.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Conform de intuïtie kon het DBSCAN-algoritme één cluster identificeren van klanten die rond de gemiddelde uitgaven aan kruidenierswaren en melkproducten zitten. Daarnaast kon het klanten markeren wier jaarlijkse koopgedrag te sterk afweek van andere klanten.
Omdat de uitschieters overeenkwamen met klanten met extremer koopgedrag, zou de groothandelsdistributeur deze klanten specifiek kunnen benaderen met exclusieve kortingen om grotere aankopen te stimuleren.
Stel, we hebben een e-commerceplatform en we willen onze verkoop verbeteren door relevante producten aan onze klanten aan te bevelen. We weten niet precies waar onze klanten naar zoeken, maar op basis van een dataset kunnen we een relevant product voorspellen en aanbevelen aan een specifieke klant. We kunnen DBSCAN toepassen op onze dataset (gebaseerd op de e-commercedatabase) en clusters vinden op basis van de producten die gebruikers hebben gekocht. Met deze clusters kunnen we overeenkomsten tussen klanten vinden. Als klant A bijvoorbeeld een pen, een boek en een schaar heeft gekocht, terwijl klant B een boek en een schaar kocht, dan kun je klant B een pen aanbevelen.
Voor de opkomst van geavanceerde deep learning-methoden gebruikten onderzoekers DBSCAN om genen te scheiden uit een genendataset die mogelijk kanker mediëren.
Wetenschappers hebben DBSCAN gebruikt om haltes te detecteren in trajectdata die gegenereerd is door mobiele gps-apparaten. Haltes vertegenwoordigen het meest betekenisvolle en belangrijkste deel van een traject.
In deze blogpost maakte je kennis met de belangrijkste nadelen van centroid-gebaseerde clustering en met een andere familie van clustermethoden, namelijk density-based clustering. Je zag ook hoe die de tekortkomingen van centroid-gebaseerde clustering ondervangen.
Je leerde hoe DBSCAN werkt en deed er een case study mee. Daarnaast kreeg je een goed overzicht van praktijkproblemen waarbij DBSCAN is ingezet om ze op te lossen. Als vervolglectuur raad ik je aan om ook andere density-based clustermethoden te bekijken, zoals Level Set Tree clustering, en hoe die verschilt van DBSCAN.
Wil je meer leren over clusteren in Python? Volg dan onze cursus Unsupervised Learning in Python.
Martin Ester, Hans-Peter Kriegel, Jörg Sander en Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han en Usama Fayyad (Eds.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Leer meer over Python
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

