{count, plural, one {Corso} other {Corsi}}
Apprendimento non supervisionato in Python
{hours} ore
184.7K
In breve, il clustering è il compito di raggruppare un insieme di oggetti in modo che gli oggetti nello stesso cluster siano più simili tra loro che a quelli in altri cluster. La similarità è una quantità che riflette la forza della relazione tra due oggetti di dati. Il clustering è usato principalmente per l’esplorazione nei data mining. Ha molteplici applicazioni in campi come machine learning, riconoscimento di pattern, analisi di immagini, information retrieval, bioinformatica, compressione dei dati e computer grafica.
Esistono molte famiglie di tecniche di clustering, e probabilmente conosci la più popolare: K-Means (che appartiene alla famiglia del clustering basato sui centroidi). In breve, K-Means determina k centroidi nei dati e assegna i punti al centroide più vicino.
Pur essendo facile da capire e implementare, K-Means non gestisce gli outlier, quindi tutti i punti vengono assegnati a un cluster anche se non appartengono a nessuno. Nell’ambito dell’anomaly detection, questo causa problemi perché i punti anomali verranno assegnati allo stesso cluster dei punti “normali”. I punti anomali spostano il centroide del cluster verso di loro, rendendo più difficile classificarli come anomali.
Questo tutorial tratterà un altro tipo di tecnica di clustering nota come clustering basato sulla densità, in particolare DBSCAN (una tecnica di clustering basata sulla densità). Rispetto al clustering basato sui centroidi come K-Means, il clustering basato sulla densità individua cluster “densi” di punti, permettendogli di apprendere cluster di forma arbitraria e di identificare outlier nei dati.
Prima di parlarne gli svantaggi, ecco un breve richiamo. Un centroide è un punto dati (immaginario o reale) al centro di un cluster. Nel clustering basato sui centroidi, i cluster sono rappresentati da un vettore centrale o centroide. Questo centroide potrebbe non essere necessariamente un membro del dataset. Il clustering basato sui centroidi è un algoritmo iterativo in cui la nozione di similarità deriva dalla distanza di un punto dati dal centroide del cluster.
A volte un dataset può contenere valori estremi al di fuori dell’intervallo atteso e diversi dagli altri dati. Questi sono chiamati outlier. Più formalmente, un outlier è un’osservazione che si trova a una distanza anomala dagli altri valori in un campione casuale di una popolazione.
Il principio fondamentale delle tecniche basate sui centroidi è guidato dalle misure di distanza tra i punti dati e i centroidi. Pertanto, in genere falliscono nell’identificare i punti che deviano in misura rilevante dalla distribuzione normale dei dati. Anche prima di costruire modelli predittivi, gli outlier possono portare a rappresentazioni fuorvianti e, a loro volta, a interpretazioni errate dei dati raccolti. Questo non è auspicabile per costruire modelli predittivi e analitici efficienti.
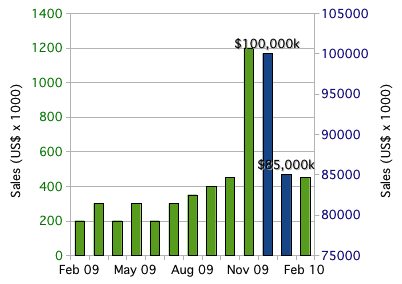
Puoi considerare le seguenti due barre più alte (rispetto alle altre) come outlier in quel particolare set di dati:
Prima di discutere del clustering basato sulla densità, bisogna introdurre un argomento: i vicinati-ɛ.
L’idea generale dei vicinati-ɛ è che, dato un punto dati, vuoi poter ragionare sui punti nello spazio attorno ad esso. Formalmente, per un certo ɛ reale positivo e un punto p, il vicinato-ɛ di p è definito come l’insieme dei punti a distanza al massimo ɛ da p.
Se ripensi alla geometria, la figura in cui tutti i punti sono equidistanti dal centro è il cerchio. In 2D, il vicinato-ɛ di un punto p è l’insieme dei punti contenuti in un cerchio di raggio ɛ, centrato in p. In 3D, il vicinato-ɛ è una sfera di raggio ɛ, centrata in p, e in spazi di dimensione superiore è semplicemente la N-sfera di raggio ɛ, centrata in p.
Consideriamo un esempio per rendere più concreto il concetto. Nell’immagine seguente 100 punti dati sono dispersi nell’intervallo [1,3]X[2,4]. Scegliamo il punto (3,2) come punto p.

Per prima cosa, consideriamo il vicinato di p con raggio 0,5 (ɛ = 0,5), l’insieme di punti a distanza 0,5 da p.

L’ovale verde opaco rappresenta il nostro vicinato, e ci sono 31 punti dati al suo interno. Dato che sono stati dispersi 100 punti e 31 sono nel vicinato, significa che poco meno di un terzo dei punti è contenuto nel vicinato di p con raggio 0,5.
Ora cambiamo il raggio a 0,15 (ɛ = 0,15) e consideriamo il vicinato più piccolo risultante.

Ora il vicinato si è ristretto e contiene solo 3 punti dati. Riducendo ɛ da 0,5 a 0,15 (una riduzione del 70%), il numero di punti nel vicinato è passato da 31 a 3 (una riduzione del 90%).
Ora che hai una buona comprensione di “vicinato”, introduco il concetto successivo: la nozione di “densità” per un vicinato (stai andando verso il “clustering basato sulla densità”, dopotutto).
A scuola si impara che densità = massa/volume. Usiamo questa idea di massa divisa per volume per definire la densità in un punto p. Se consideri un punto p e il suo vicinato di raggio ɛ, puoi definire la massa del vicinato come il numero di punti (o, in alternativa, la frazione di punti) contenuti nel vicinato, e il volume del vicinato come il volume della forma risultante. Nel caso 2D il vicinato è un cerchio, quindi il volume è semplicemente l’area del cerchio. Nel caso 3D e in dimensioni superiori, il vicinato è una sfera o n-sfera, quindi puoi calcolarne il volume.
Per esempio, consideriamo di nuovo il vicinato di p = (3,2) di raggio 0,5.
La massa è il numero di punti nel vicinato, quindi massa = 31. Il volume è l’area del cerchio, quindi volume = π0,52 = π/4. Pertanto, la nostra approssimazione della densità locale in * p = (3,2) è calcolata come densità = massa/volume = 31/(π/4) = 124/π ~= 39,5.
Questo valore, preso da solo, è privo di significato, ma se calcoli l’approssimazione della densità locale per tutti i punti del dataset, potresti raggruppare i punti dicendo che quelli vicini (contenuti nello stesso vicinato) e con densità locali simili appartengono allo stesso cluster. Se diminuisci il valore di ɛ, puoi costruire vicinati più piccoli (meno volume) che contengono anche meno punti. Idealmente, vuoi identificare vicinati ad alta densità in cui la maggior parte dei punti è contenuta in questi vicinati, ma il volume di ciascuno è relativamente piccolo.
Anche se non è esattamente ciò che fanno DBSCAN o l’algoritmo Level Set Tree (un’altra tecnica della famiglia basata sulla densità), questa è l’intuizione generale dietro il clustering basato sulla densità.
Ricapitolando, hai visto i vicinati-ɛ e come permettono di ragionare sullo spazio attorno a un punto. Poi hai imparato una nozione di densità in un punto per un dato vicinato. Nella prossima sezione, conoscerai l’algoritmo DBSCAN, dove la palla-ɛ è uno strumento fondamentale per definire i cluster.
DBSCAN sta per Density-Based Spatial Clustering of Applications with Noise ed è senza dubbio l’algoritmo di clustering basato sulla densità più noto. È stato presentato per la prima volta nel 1996 da Ester et al.. Per la sua importanza sia teorica che applicativa, questo algoritmo è stato uno dei tre a ricevere il Test of Time Award al SIGKDD 2014.
A differenza di K-Means, DBSCAN non richiede il numero di cluster come parametro. Piuttosto lo inferisce dai dati, e può scoprire cluster di forma arbitraria (mentre K-Means in genere trova cluster sferici). Come visto prima, il vicinato-ɛ è fondamentale in DBSCAN per approssimare la densità locale, quindi l’algoritmo ha due parametri:
Usando questi due parametri, DBSCAN classifica i punti dati in tre categorie:
Queste definizioni possono sembrare astratte, quindi vediamo più nel dettaglio cosa significano.
Punti core:
I punti core sono le fondamenta dei nostri cluster e si basano sull’approssimazione della densità discussa nella sezione precedente. Usi lo stesso ɛ per calcolare il vicinato di ogni punto, quindi il volume di tutti i vicinati è lo stesso. Tuttavia, il numero di altri punti in ciascun vicinato è ciò che cambia. Ricorda che puoi pensare al numero di punti nel vicinato come alla sua massa. Il volume di ogni vicinato è costante, e la massa è variabile: ponendo una soglia sulla massa minima necessaria per essere un punto core, stai sostanzialmente impostando una soglia minima di densità. Pertanto, i punti core sono punti che soddisfano un requisito minimo di densità. I nostri cluster si costruiscono attorno ai punti core (da qui “core”), quindi regolando il parametro minPts puoi affinare quanto devono essere densi i nuclei dei cluster.
Punti di bordo:
I punti di bordo sono i punti nei nostri cluster che non sono core. Nella definizione sopra ho usato il termine “density-reachable” (raggiungibile per densità). Non l’ho ancora definito, ma il concetto è semplice. Per spiegarlo, torniamo all’esempio del vicinato con epsilon = 0,15. Considera il punto r (il punto nero) che è fuori dal vicinato di p.

Tutti i punti dentro il vicinato di p si dicono direttamente raggiungibili da p. Ora esploriamo il vicinato del punto q, un punto direttamente raggiungibile da p. Il cerchio giallo rappresenta il vicinato di q.

Ora, sebbene il tuo punto r non sia nel vicinato del punto di partenza p, è contenuto nel vicinato del punto q. Questa è l’idea di density-reachable: se puoi raggiungere il punto r saltando da un vicinato all’altro, partendo da un punto p, allora r è raggiungibile per densità da p.

Per analogia, puoi pensare ai punti raggiungibili per densità come ai “gli amici di un amico”. Se i punti direttamente raggiungibili da un punto core p sono i suoi “amici”, allora i punti raggiungibili per densità, ossia i punti nel vicinato degli “amici” di p, sono “gli amici dei suoi amici”. Una cosa importante: la raggiungibilità per densità non è limitata a due salti tra vicinati adiacenti. Finché puoi raggiungere il punto facendo “salti di vicinato” a partire da un punto core p, quel punto è raggiungibile per densità da p, quindi sono inclusi anche gli “amici di un amico di un amico … di un amico”.
È importante tenere a mente che questa idea di raggiungibilità per densità dipende dal valore di ɛ. Scegliendo valori maggiori di ɛ, più punti diventano raggiungibili per densità; scegliendo valori minori, ne diventano raggiungibili meno.
Outlier:
Infine, arriviamo alla classe “altro”. Gli outlier sono punti che non sono punti core e non sono abbastanza vicini a un cluster da essere raggiungibili per densità da un punto core. Gli outlier non sono assegnati ad alcun cluster e, a seconda del contesto, possono essere considerati punti anomali.
DBSCAN è già implementato in modo eccellente nella popolare libreria di machine learning per Python Scikit-Learn e, poiché questa implementazione è scalabile e ben testata, la userai per vedere come DBSCAN funziona in pratica.
I passaggi dell’algoritmo DBSCAN sono:
Per questo case study userai un dataset costituito da dati annuali dei clienti di un distributore all’ingrosso.
Allora, iniziamo.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
Il dataset consiste di 440 clienti e ha 8 attributi per ciascuno. Userai la libreria Pandas per importare il file .csv e convertirlo in un oggetto DataFrame.
Durante l’import del file .csv nel , assicurati di fornire il percorso corretto del file.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Prima di procedere con l’applicazione di DBSCAN, è molto importante conoscere bene i dati: che tipo di dati contiene il dataset, che distribuzione seguono, e quali feature sono numeriche o meno.
Secondo la descrizione fornita nell’archivio UCI di machine learning per questo dataset, le informazioni sulle feature sono le seguenti:
Ora che conosci le feature del dataset, visualizziamo alcune statistiche dei dati.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Come puoi vedere dall’output, non ci sono valori mancanti e tutti i dati sono di tipo integer. Questo riduce l’onere di ulteriore preprocessing. Approfondiamo ancora un po’.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Dall’output puoi ricavare tutte le misure statistiche necessarie come deviazione standard, media, massimo di ogni feature presente. Si vede che la maggior parte dei dati è di natura continua tranne due feature: Channel e Region. Per semplificare i calcoli, le rimuoverai:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Per visualizzare i dati, userai due feature:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
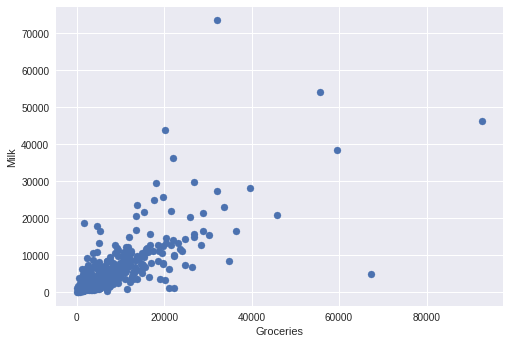
Un breve riepilogo delle funzioni usate per il grafico: plt.scatter(): crea lo scatter plot in base ai dati (forniti come parametri [x e y]). plt.xlabel(): ti permette di inserire un’etichetta sull’asse X. (Groceries in questo caso) plt.ylabel(): ti permette di inserire un’etichetta sull’asse Y. (Milk in questo caso) plt.show(): dopo aver creato il grafico, lo visualizza in output.
Dovresti davvero esplorare il mondo di Matplotlib per tutte le tue visualizzazioni. La sua documentazione è davvero fantastica.
Si individuano facilmente i punti lontani dalla nube principale, giusto? Quelli sono gli outlier.
Con DBSCAN, vogliamo identificare il cluster principale di clienti, ma anche segnalare come outlier i clienti con abitudini di acquisto annuali più insolite.
Poiché i valori dei dati sono nell’ordine delle migliaia, normalizzerai ogni attributo scalando a media 0 e varianza unitaria. In sostanza, questo aiuta a mantenere intatte le interrelazioni tra le feature, così che una piccola variazione in una si rifletta nell’altra.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Costruirai un oggetto DBSCAN che richiede un minimo di 15 punti dati in un vicinato di raggio 0,5 per essere considerato un punto core.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Successivamente, possiamo estrarre le etichette dei cluster e gli outlier per tracciare i risultati.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

In linea con l’intuizione, l’algoritmo DBSCAN è riuscito a identificare un cluster di clienti intorno alla spesa media in generi alimentari e latte. Inoltre, ha segnalato i clienti il cui comportamento di acquisto annuale devìa troppo rispetto agli altri.
Poiché gli outlier corrispondono a clienti con comportamenti di acquisto più estremi, il distributore all’ingrosso potrebbe mirare specificamente a questi clienti con sconti esclusivi per incoraggiare acquisti più grandi.
Supponiamo di avere un e-commerce e di voler migliorare le vendite raccomandando prodotti pertinenti ai clienti. Non sappiamo esattamente cosa cercano, ma in base a un dataset possiamo prevedere e suggerire un prodotto rilevante a uno specifico cliente. Possiamo applicare DBSCAN al nostro dataset (basato sul database dell’e-commerce) e trovare cluster in base ai prodotti acquistati dagli utenti. Usando questi cluster possiamo trovare somiglianze tra clienti: per esempio, se il cliente A ha comprato una penna, un libro e un paio di forbici, mentre il cliente B ha acquistato un libro e un paio di forbici, allora potresti raccomandare una penna al cliente B.
Prima dell’ascesa di metodologie avanzate basate sul deep learning, i ricercatori usavano DBSCAN per separare geni da un dataset di geni che avevano probabilità di mediare il cancro.
Gli scienziati hanno usato DBSCAN per rilevare le soste nei dati di traiettoria generati dai dispositivi GPS mobili. Le soste rappresentano la parte più significativa e importante di una traiettoria.
In questo post hai conosciuto i principali svantaggi del clustering basato sui centroidi e ti sei familiarizzato con un’altra famiglia di tecniche di clustering, ovvero il clustering basato sulla densità. Hai anche visto come queste tecniche superino i limiti del clustering basato sui centroidi.
Hai imparato come funziona DBSCAN e ne hai svolto un case study. Inoltre, hai avuto una panoramica dei problemi reali in cui DBSCAN è stato impiegato per risolverli. Per approfondire, ti consiglierei di esplorare anche altri metodi di clustering basati sulla densità come il Level Set Tree clustering e come differisce da DBSCAN.
Se vuoi imparare di più sul clustering in Python, segui il nostro corso Unsupervised Learning in Python.
Martin Ester, Hans-Peter Kriegel, Jörg Sander e Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han e Usama Fayyad (a cura di). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Approfondisci Python
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min



