
Kursus
Konsep Keamanan dan Manajemen Biaya AWS
3 jam
11.2K
Solusi cloud-native semakin populer di berbagai industri karena keamanannya, fleksibilitasnya, dan skalabilitasnya. Salah satu solusinya adalah AWS Glue, yang menyederhanakan pemrosesan data—komponen inti dalam pengambilan keputusan yang tepat dan pengoptimalan operasi bisnis.
Dalam tutorial ini, kita akan menggunakan AWS Glue untuk mendemonstrasikan tugas ETL (Extract, Transform, Load) yang umum: mengonversi file CSV yang disimpan di bucket S3 menjadi format Parquet. Menggunakan Parquet meningkatkan efisiensi pemrosesan data dan kinerja kueri.
Kami akan memperkenalkan AWS Glue, fitur utamanya, dan manfaat otomatisasi penyiapan data. Selanjutnya, kami akan memandu Anda menyiapkan akun AWS, membuat peran IAM, dan mengonfigurasi akses ke bucket S3 Anda. Terakhir, kami akan membimbing Anda membuat Glue crawler untuk memindai dataset dan menghasilkan file Parquet.
Sebelum melanjutkan ke langkah praktis, mari pahami terlebih dahulu apa itu AWS Glue dan mengapa layanan ini bermanfaat untuk tugas pemrosesan data.
AWS Glue adalah layanan ETL terkelola penuh yang memudahkan penyiapan dan pemuatan data untuk analitik. Layanan ini menyediakan lingkungan tanpa server untuk membuat, menjalankan, dan memantau job ETL. AWS Glue secara otomatis menemukan dan memprofilkan data Anda melalui AWS Glue Data Catalog, merekomendasikan dan menghasilkan kode ETL, serta menyediakan penjadwal fleksibel untuk menangani resolusi dependensi, pemantauan job, dan upaya ulang.
Memahami manfaat AWS Glue akan membantu Anda menghargai nilainya dalam alur kerja pemrosesan data. Ada beberapa alasan kuat untuk menggunakan AWS Glue dan sebagian di antaranya digambarkan di bawah ini:
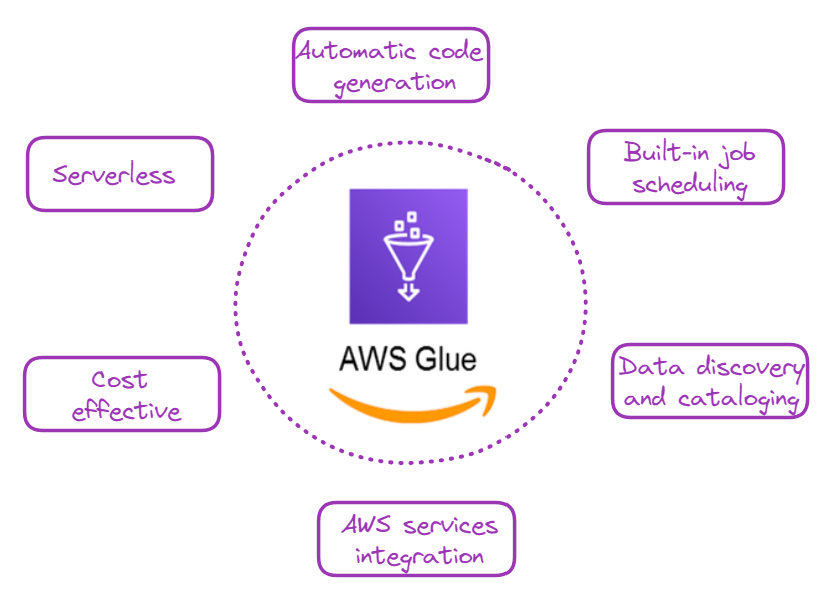
Mengapa memilih AWS Glue? Gambar oleh penulis
Ini bagian yang menarik: mari pelajari cara menggunakan Glue untuk tugas pemrosesan data yang sangat umum: mengonversi file CSV ke Parquet.
Bagi yang baru menggunakan AWS, langkah pertama adalah membuat akun dan kemudian masuk ke konsol manajemen.
AWS Identity and Access Management (IAM) memungkinkan pengguna mengelola akses ke layanan dan sumber daya AWS secara aman.
Kita perlu membuat peran IAM untuk memungkinkan Glue mengakses layanan terkait. Dalam kasus kita, layanan utama yang diakses adalah S3, yang menampung file CSV kita.
The AWS Storage Tutorial adalah cara yang bagus bagi pengguna AWS baru untuk mempelajari lebih lanjut tentang sistem seperti S3.
Langkah utama untuk membuat peran IAM tersebut dijelaskan di bawah, dimulai dari Management Console:
AWSGlueServiceRoleAmazonS3FullAccess (Catatan: Di lingkungan produksi, Anda sebaiknya membuat kebijakan yang lebih ketat).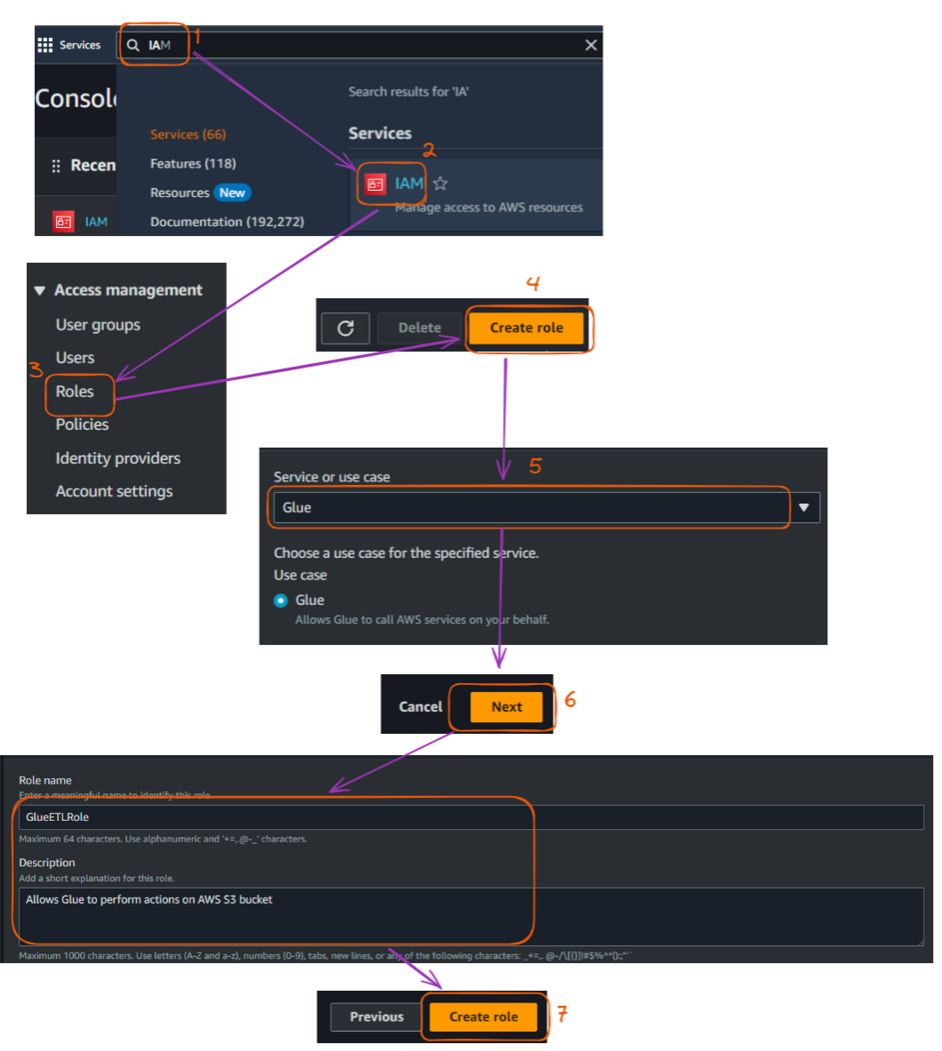
Langkah membuat peran IAM di konsol AWS. Gambar oleh penulis
The Complete Guide to AWS IAM membahas langkah-langkah menggunakan IAM untuk mengamankan lingkungan AWS, mengelola akses dengan pengguna, grup, dan peran, serta menguraikan praktik terbaik untuk keamanan yang tangguh.
Kita akan menyimpan file CSV input dan file Parquet output di Amazon S3.
Data input untuk contoh ini dibuat untuk tujuan ilustrasi dan dapat ditemukan di repositori GitHub penulis:
athletes.csv: Berisi informasi tentang atlet, termasuk ID, nama, negara, cabang olahraga, dan usia.events.csv: Mencantumkan berbagai event, termasuk ID event, cabang olahraga, nama event, tanggal, dan lokasi.medals.csv: Mencatat informasi medali, menghubungkan event dan atlet dengan medali yang mereka menangkan.Sekarang, kita dapat menyiapkan bucket S3 sebagai berikut:
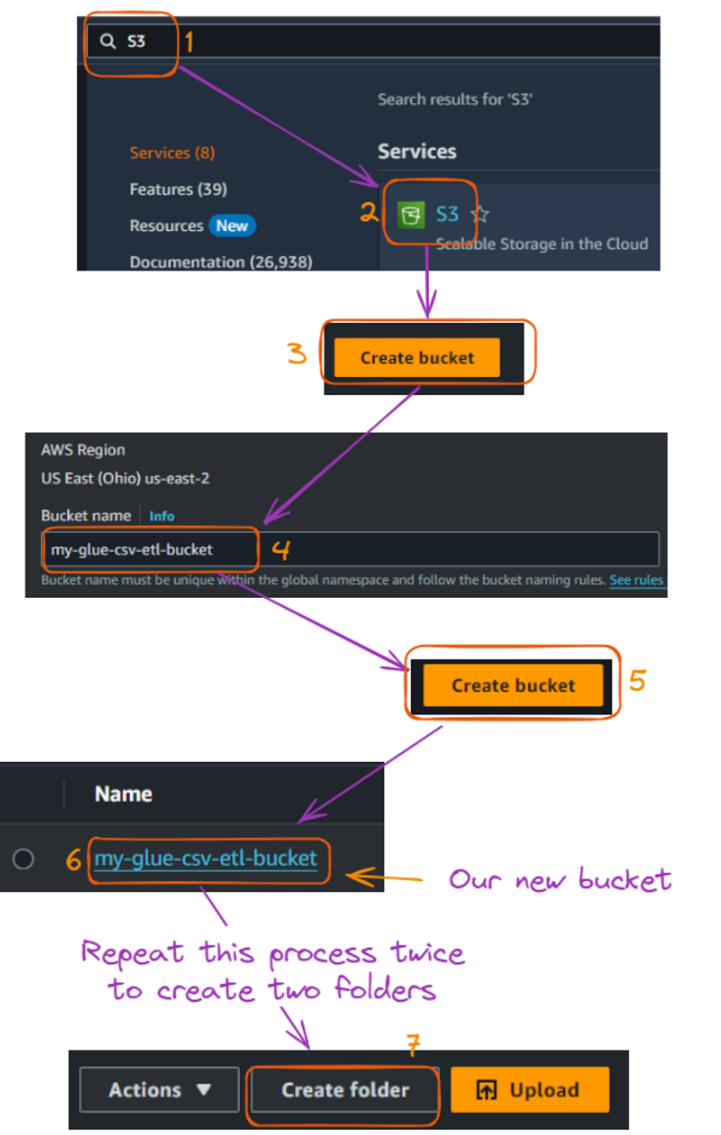
Alur pembuatan bucket dan folder S3. Gambar oleh penulis
Setelah membuat dua folder, konten bucket Anda seharusnya terlihat seperti ini:
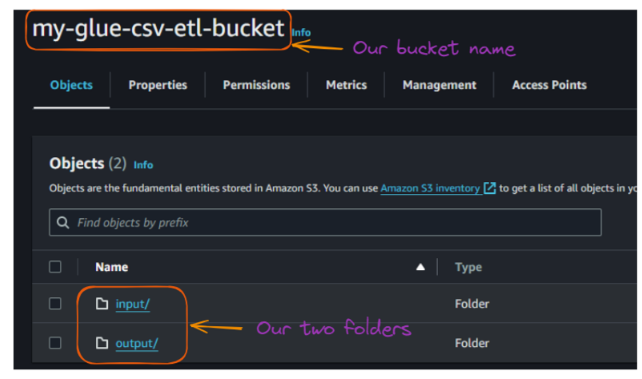
Tampilan folder di dalam bucket S3. Gambar oleh penulis
Sekarang, kita dapat mengunggah file CSV input ini ke folder "input".
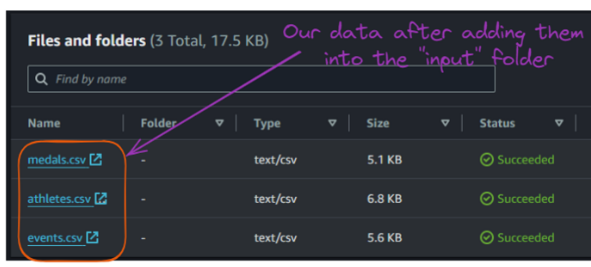
Isi folder "input" pada bucket S3. Gambar oleh penulis
Glue crawler digunakan untuk menemukan dan mengkatalogkan data kita secara otomatis. Bagian ini menjelaskan cara membuat crawler yang memindai semua file CSV input.
Langkah-langkah utamanya dijelaskan di bawah ini:
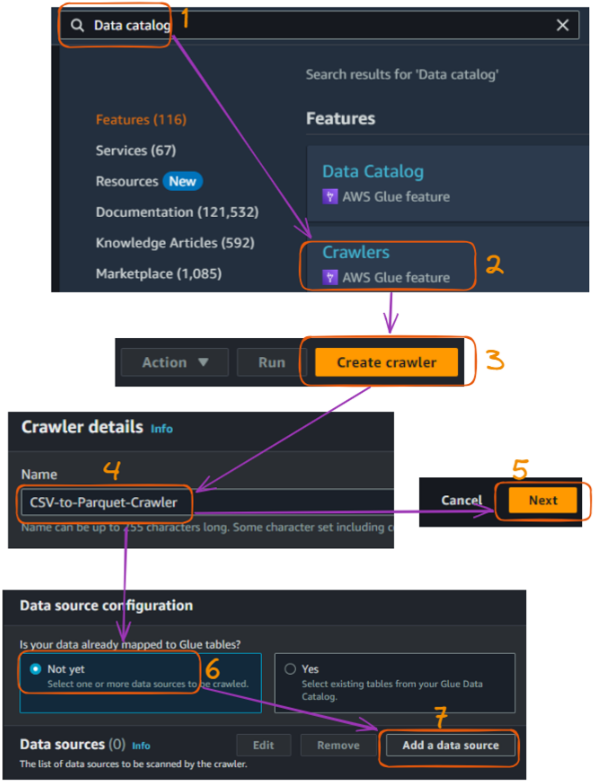
Alur pembuatan AWS Glue crawler di konsol - bagian 1. Gambar oleh penulis
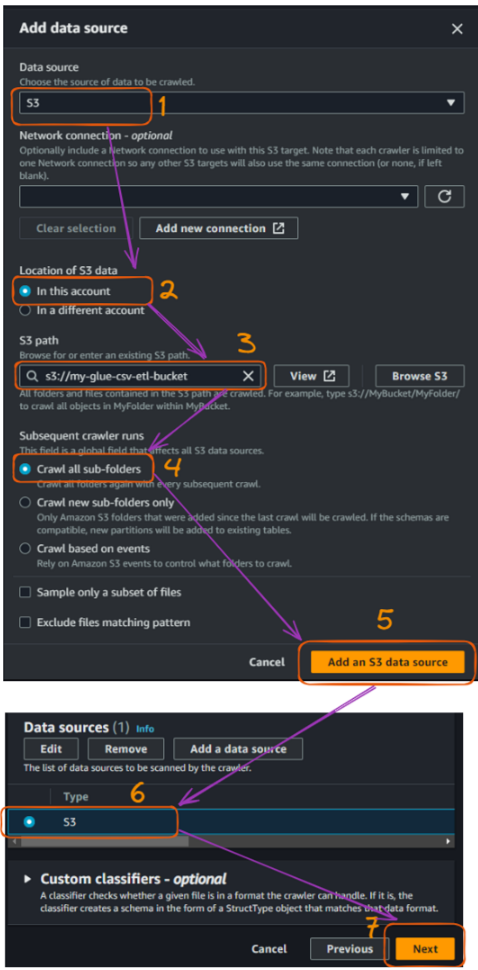
Alur pembuatan AWS Glue crawler di konsol - bagian 2. Gambar oleh penulis
Setelah kita menghubungkan bucket S3, kita perlu menghubungkan peran IAM yang sebelumnya dibuat untuk memungkinkan Glue mengakses bucket S3. Nama peran kita adalah "GlueETLRole."
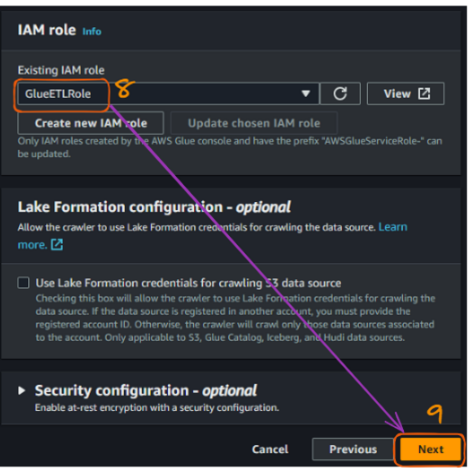
Alur pembuatan AWS Glue crawler di konsol - bagian 3. Gambar oleh penulis
Langkah berikutnya adalah membuat database. Database "paris_olympics_db" yang akan kita buat berfungsi sebagai repositori pusat di AWS Glue Data Catalog untuk menyimpan dan mengatur metadata tentang file CSV kita.
Katalog tersebut akan memungkinkan penemuan data yang efisien dan menyederhanakan proses ETL kita untuk menggabungkan dan mengonversi data atlet, event, dan medali ke dalam format Parquet.
Saat ini, kita belum memiliki database, dan langkah pembuatannya digambarkan di bawah ini:
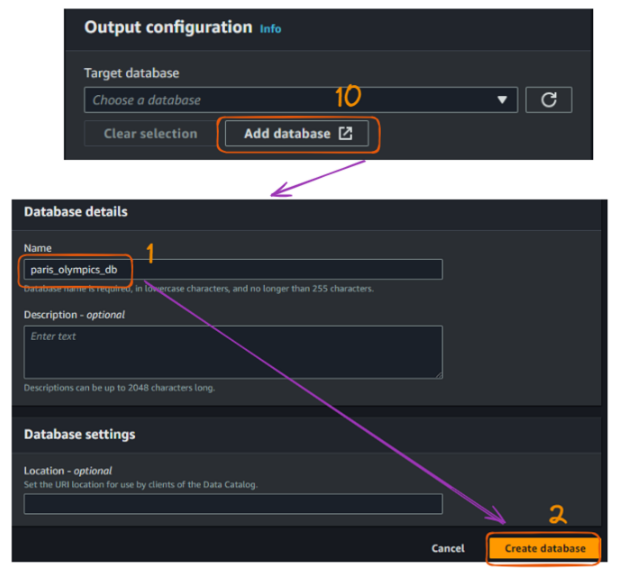
Alur pembuatan AWS Glue crawler di konsol - bagian 4. Gambar oleh penulis
Dari tab asli tempat kita menghubungkan database, segarkan bagian "Target database" dan pilih database yang baru dibuat. Lalu klik "Next."
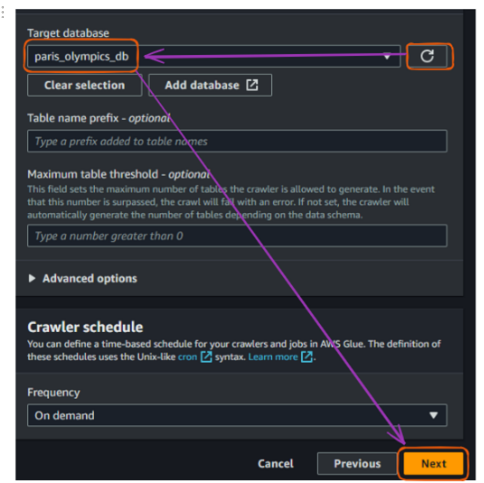
Alur pembuatan AWS Glue crawler di konsol - bagian 5. Gambar oleh penulis
Terakhir, tinjau semuanya dan klik "Create crawler."
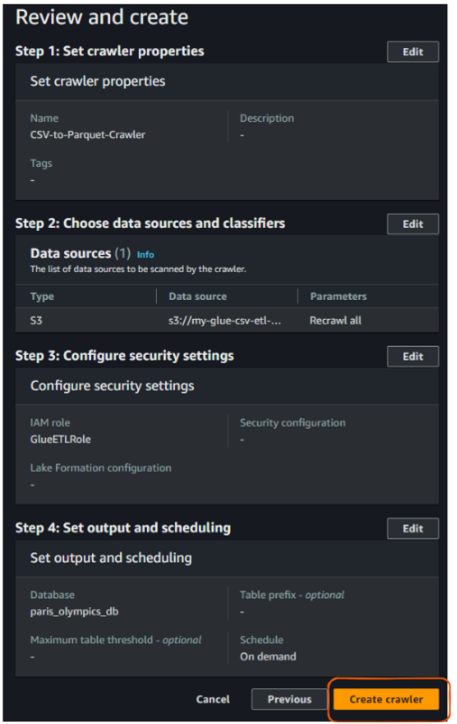
Tampilan "Review and create" AWS Glue crawler. Gambar oleh penulis
Setelah tindakan sebelumnya untuk membuat crawler, kita akan melihat hasil berikut yang mengonfirmasi pembuatannya:
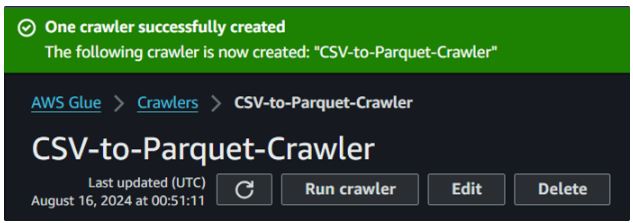
Pembuatan Glue crawler berhasil. Gambar oleh penulis
Sekarang kita telah membuat crawler, saatnya menjalankannya dan melihat bagaimana crawler mengatalogkan data kita.
Tombol "Run crawler" Glue. Gambar oleh penulis
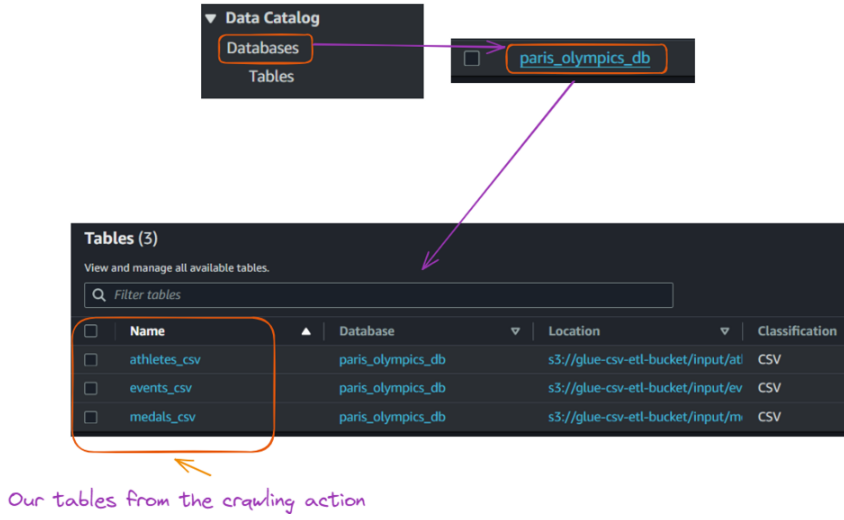
Tampilan tabel yang dibuat di database dari eksekusi Glue crawler. Gambar oleh penulis
Dengan katalog data yang telah dibuat, kini kita dapat membuat Glue job untuk menggabungkan file CSV dan mengonversinya ke format Parquet. Bagian ini memandu Anda membuat Glue job dan menyediakan kode Python yang diperlukan.
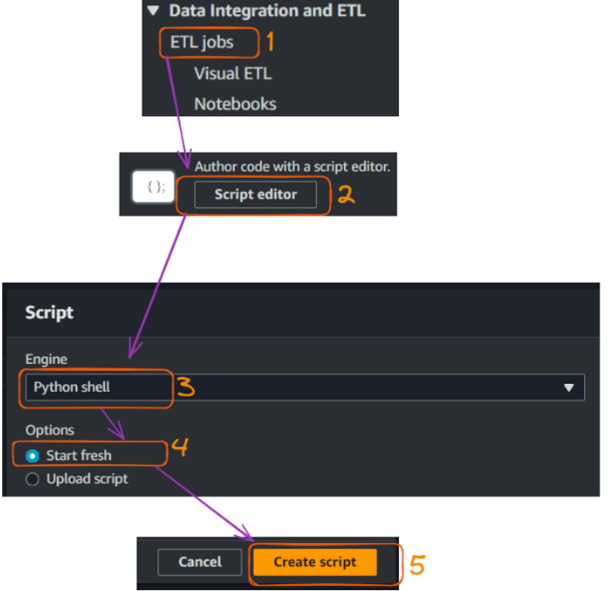
Membuat dan menjalankan Glue job - bagian 1. Gambar oleh penulis
Tindakan membuat skrip membuka tab skrip berikut tempat kita dapat memberi nama job, yaitu "CS" dalam kasus kita.
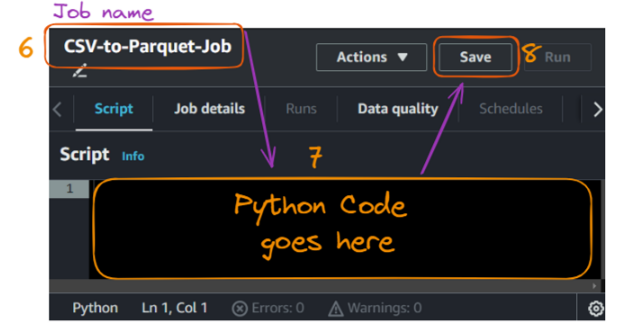
Membuat dan menjalankan Glue job - bagian 2. Gambar oleh penulis
Kode Python terkait diberikan di bawah ini:
import sys
from awsglue.transforms import *
from awsglue.utils import getResolvedOptions
from pyspark.context import SparkContext
from awsglue.context import GlueContext
from awsglue.job import Job
from pyspark.sql.functions import col, to_date

# Initialize the Spark and Glue contexts
sc = SparkContext()
glueContext = GlueContext(sc)
spark = glueContext.spark_session
job = Job(glueContext)

# Set Spark configurations for optimization
spark.conf.set("spark.sql.adaptive.enabled", "true")
spark.conf.set("spark.sql.adaptive.coalescePartitions.enabled", "true")

# Get job parameters
args = getResolvedOptions(sys.argv, ['JOB_NAME'])

# Set the input and output paths
input_path = "s3://glue-csv-etl-bucket/input/"
output_path = "s3://glue-csv-etl-bucket/output/"

# Function to read CSV and write Parquet
def csv_to_parquet(input_file, output_file):
    try:
        # Read CSV
        df = spark.read.option("header", "true") \
                       .option("inferSchema", "true") \
                       .option("mode", "PERMISSIVE") \
                       .option("columnNameOfCorruptRecord", "_corrupt_record") \
                       .csv(input_file)

        # Print schema for debugging
        print(f"Schema for {input_file}:")
        df.printSchema()

        # Convert date column if it exists (assuming it's in the format M/d/yyyy)
        if "date" in df.columns:
            df = df.withColumn("date", to_date(col("date"), "M/d/yyyy"))

        # Write Parquet
        df.write.mode("overwrite").parquet(output_file)

        print(f"Successfully converted {input_file} to Parquet at {output_file}")
        print(f"Number of rows processed: {df.count()}")
    except Exception as e:
        print(f"Error processing {input_file}: {str(e)}")

# List of files to process
files = ["athletes", "events", "medals"]

# Process each file
for file in files:
    input_file = f"{input_path}{file}.csv"
    output_file = f"{output_path}{file}_parquet"
    csv_to_parquet(input_file, output_file)

job.commit()
print("Job completed.")
Mari kita pahami secara singkat apa yang terjadi dalam kode:
csv_to_parquet() untuk membaca file CSV, mencetak skemanya, mengonversi kolom tanggal jika ada, dan menulis data sebagai file Parquet. Menangani pengecualian selama pemrosesan.athletes, events, medals) dengan memanggil fungsi csv_to_parquet() pada setiap file.Sebelum menjalankan job, kita perlu mengisi konfigurasi tambahan berikut di bagian "Job details":
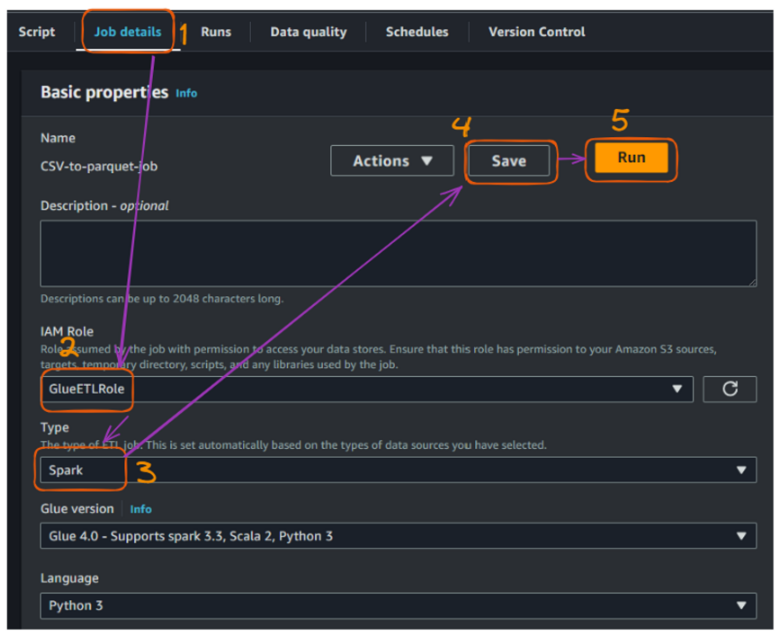
Membuat dan menjalankan Glue job - bagian 3. Gambar oleh penulis
Setelah berhasil menjalankan job, kita dapat melihat lebih banyak detail tentang status eksekusi:
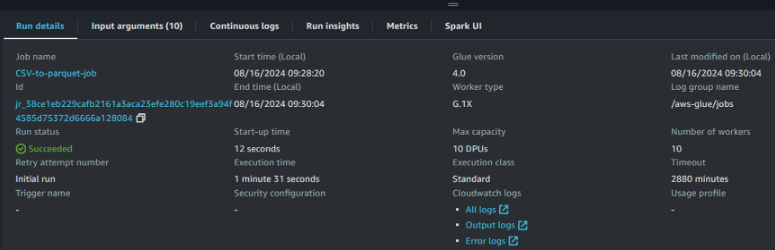
Tampilan detail run AWS Glue job. Gambar oleh penulis
Akses dan pemantauan detail run penting untuk mempertahankan pipeline data yang efisien dan andal. Metrik ini memberikan wawasan berharga dan membantu kita dalam hal berikut:
Eksekusi job yang berhasil ini mengonversi setiap file CSV menjadi file Parquet yang sesuai dan menyimpannya di folder "output" seperti ditunjukkan di bawah:
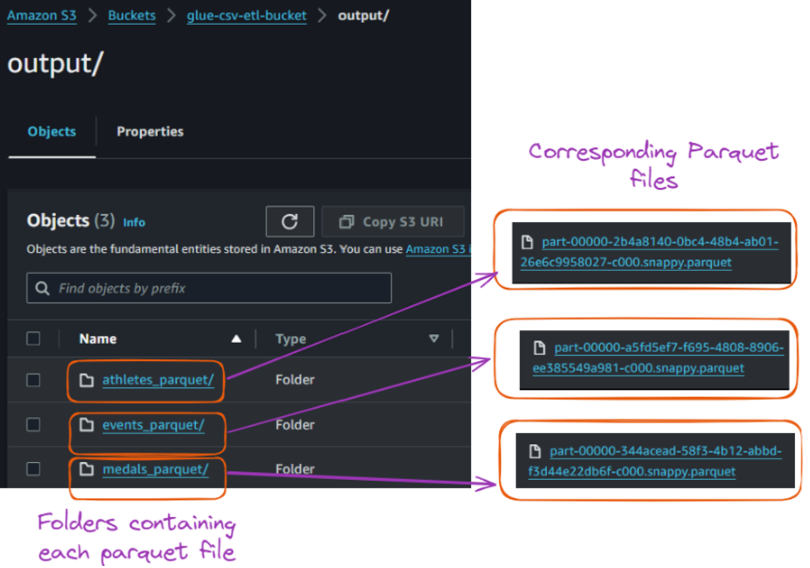
Isi folder output di dalam bucket S3. Gambar oleh penulis
Tutorial ini membahas AWS Glue dan fitur-fiturnya. Tutorial ini memandu Anda menyiapkan lingkungan AWS dan mengeksplorasi antarmuka AWS Glue. Tutorial ini juga menunjukkan cara membangun dan menjalankan Glue crawler untuk mengatalogkan data, membuat Glue job untuk mentransformasikannya, dan berhasil mengonversi file CSV ke format Parquet.
Anda dapat mengembangkan apa yang telah dipelajari dengan menyiapkan trigger untuk mengotomatiskan alur kerja, menerapkan penanganan error dan logging, serta mengoptimalkan file Parquet untuk kinerja yang lebih baik lagi. Anda juga dapat mengeksplorasi kueri data Anda dengan AWS Athena atau Amazon Redshift Spectrum.
Selain itu, pantau penggunaan dan biaya AWS Anda serta bersihkan sumber daya saat tidak lagi diperlukan untuk menghindari biaya yang tidak perlu.
Kursus Introduction to AWS dan AWS Cloud Technology and Services dapat menjadi langkah lanjutan yang sangat baik untuk belajar lebih jauh!
Yang pertama menawarkan dasar-dasar AWS dan komputasi awan yang solid, ideal bagi pemula atau mereka yang ingin menyegarkan konsep kunci. Yang kedua berfokus pada pembelajaran praktis, membantu Anda memperdalam pengetahuan praktis tentang layanan AWS.
Pelajari lebih lanjut tentang AWS dan data engineering dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



