Kursus
Pengurangan Dimensi dengan Python
4 jam
37.1K
Ekstraksi fitur dalam machine learning mengubah data mentah menjadi sekumpulan karakteristik bermakna, menangkap informasi esensial sambil mengurangi redundansi. Ini dapat melibatkan teknik reduksi dimensi dan metode yang membuat fitur baru dari data yang ada.
Bayangkan Anda mencoba mengidentifikasi buah-buahan di pasar. Meskipun Anda bisa mempertimbangkan tak terhitung atribut (berat, warna, tekstur, bentuk, bau, dll.), Anda mungkin menyadari bahwa hanya beberapa fitur kunci seperti warna dan ukuran sudah cukup untuk membedakan apel dan jeruk. Inilah yang dilakukan ekstraksi fitur. Ini membantu Anda fokus pada karakteristik data yang paling informatif.
Saat melakukan ekstraksi fitur, data asli ditransformasikan secara matematis menjadi kumpulan fitur baru. Fitur baru ini dirancang untuk menangkap aspek terpenting dari data sekaligus berpotensi mengurangi kompleksitasnya. Fitur yang diekstraksi sering kali merepresentasikan pola atau struktur yang mendasari yang mungkin tidak langsung terlihat pada data asli.
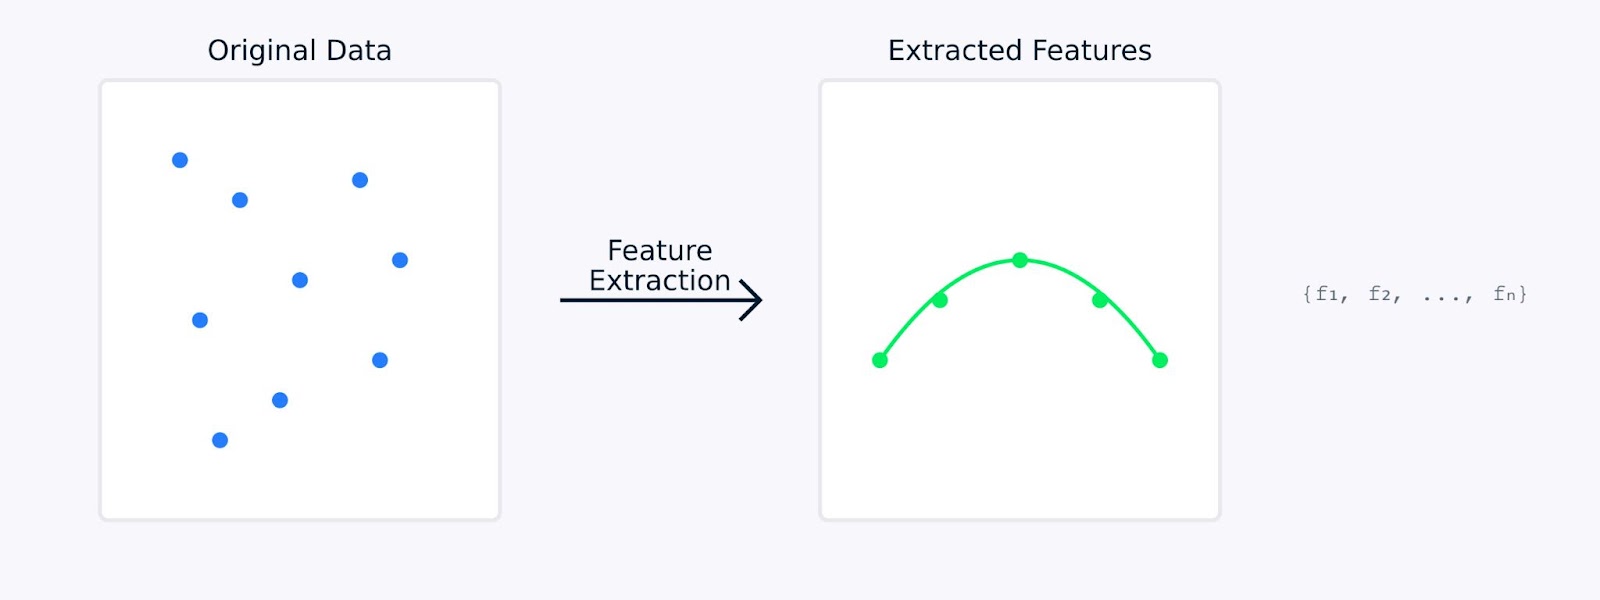
Ekstraksi Fitur
Pada bagian berikutnya, kita akan mengeksplorasi mengapa ekstraksi fitur begitu penting dalam machine learning dan meninjau berbagai metode untuk mengekstrak fitur dari beragam jenis data beserta kodenya. Jika Anda ingin contoh langsung, lihat kursus Dimensionality Reduction in Python kami, yang memiliki satu bab khusus tentang ekstraksi fitur.
Ekstraksi fitur memainkan peran penting dalam machine learning. Ini bisa menjadi pembeda antara model yang gagal dan yang berhasil. Mari kita lihat mengapa hal ini sangat fundamental untuk membangun model machine learning yang efektif.
Saat bekerja dengan data mentah, model machine learning sering kesulitan membedakan antara pola bermakna dan noise. Ekstraksi fitur berfungsi sebagai langkah prapemrosesan data yang dapat meningkatkan kemampuan model Anda untuk belajar dan berkinerja.
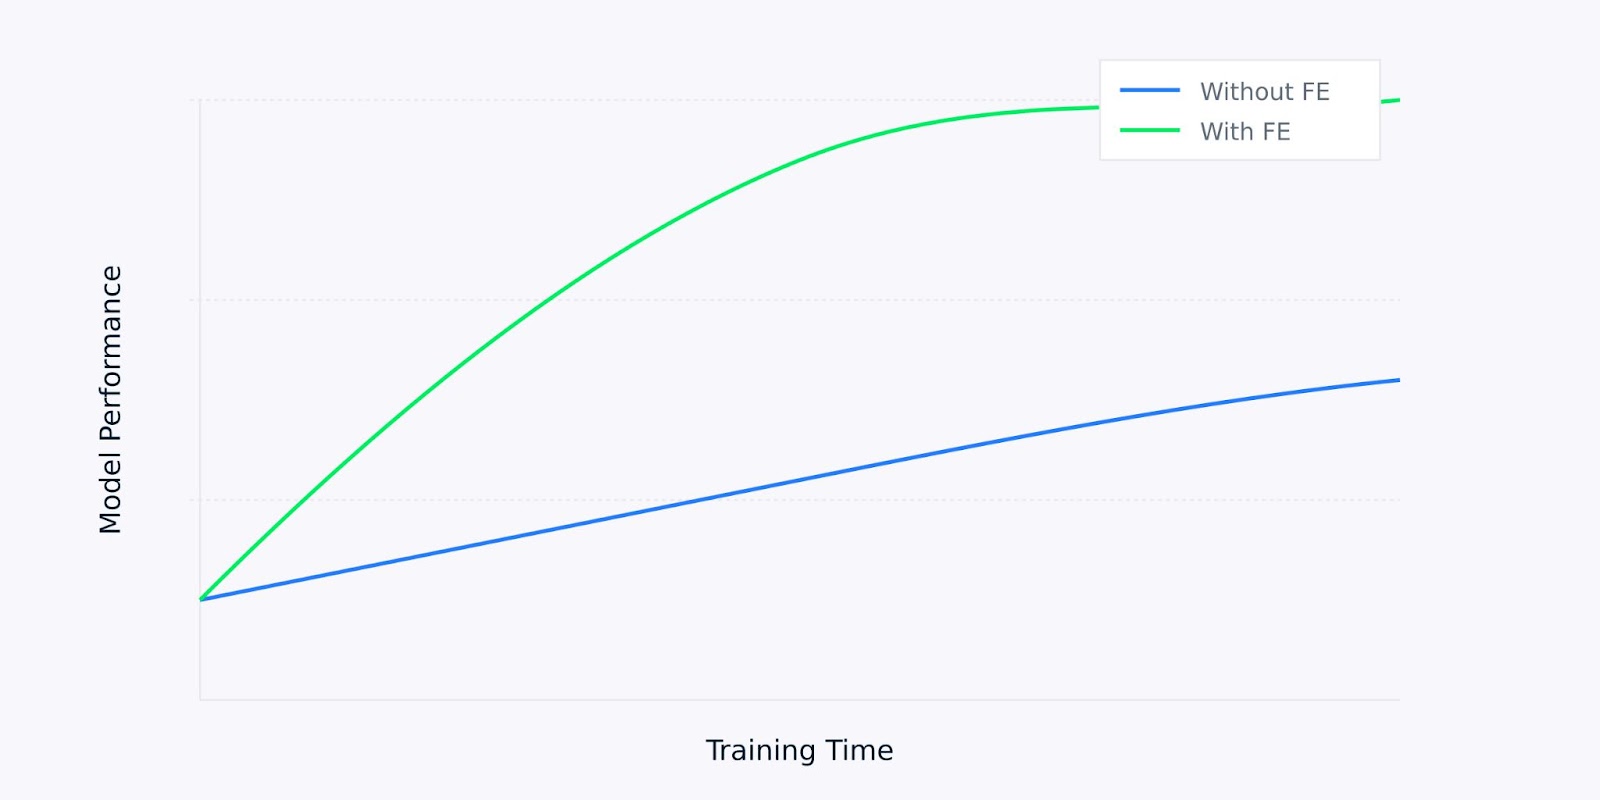
Kinerja Model versus Waktu Pelatihan
Sebagai contoh, ketika sebuah model mencapai akurasi 85% dengan data mentah, model yang sama mungkin mencapai 95% akurasi saat dilatih pada fitur yang diekstraksi secara cermat. Peningkatan ini bukan berasal dari perubahan model, melainkan dari pemberian data masukan berkualitas lebih baik untuk dipelajari.
Dataset modern sering kali memiliki ratusan atau ribuan fitur. Ini menimbulkan beberapa tantangan yang dibantu diatasi oleh ekstraksi fitur.
Ekstraksi fitur mengatasi tantangan ini dengan mengurangi dimensi sambil mempertahankan informasi esensial. Pengurangan ini mengubah data yang luas dan berdimensi tinggi menjadi bentuk yang lebih ringkas dan mudah dikelola, sehingga meningkatkan kinerja model.
Ekstraksi fitur memberikan dua manfaat penting bagi model machine learning:
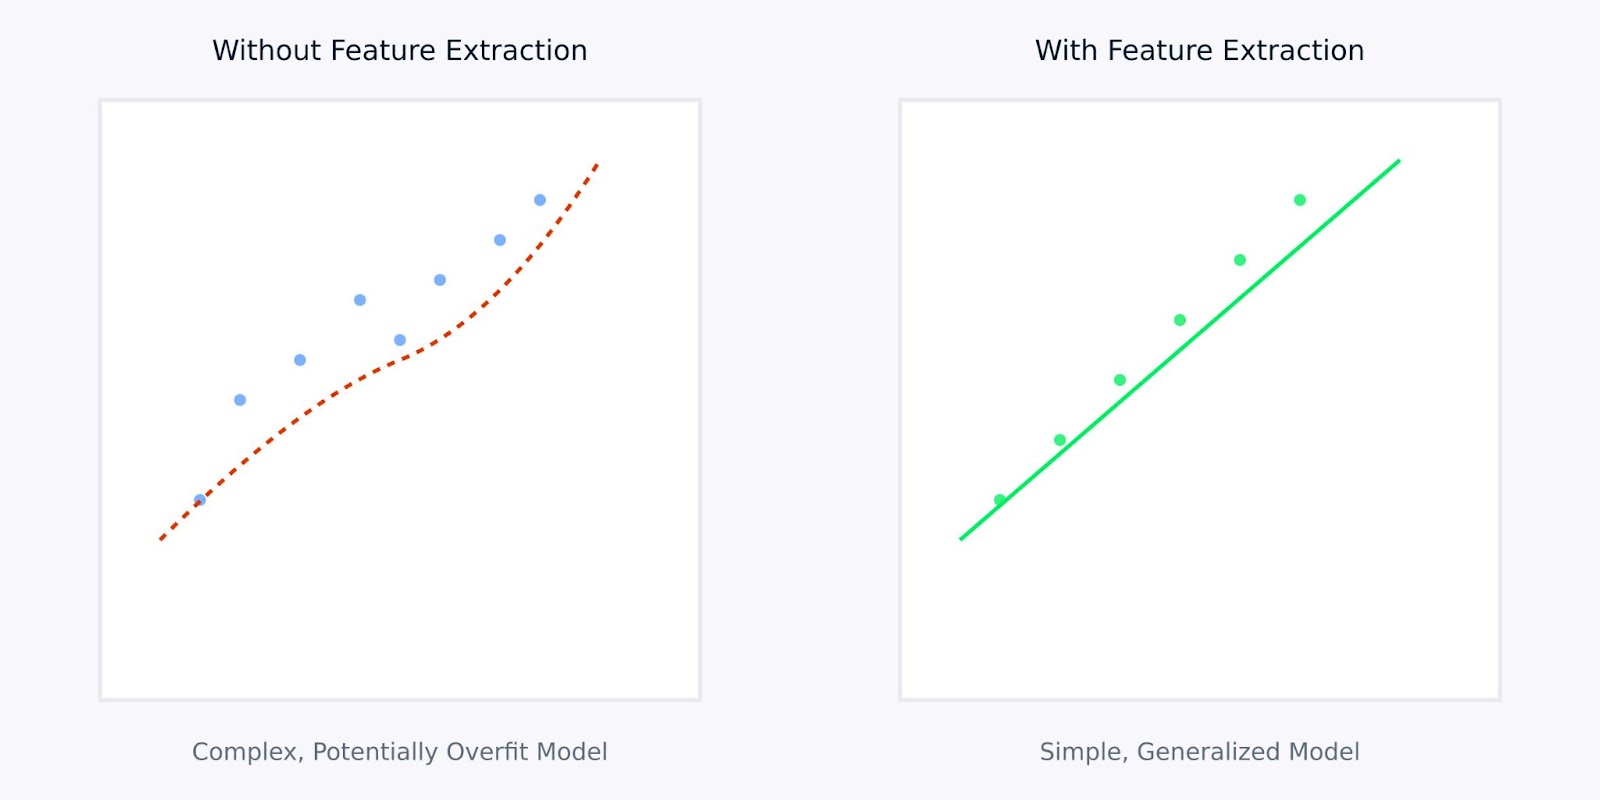
Dengan Ekstraksi Fitur versus Tanpa Ekstraksi Fitur
Visualisasi di atas mengilustrasikan bagaimana ekstraksi fitur dapat menghasilkan model yang lebih sederhana dan lebih tangguh. Plot kiri menunjukkan model kompleks yang mencoba menyesuaikan data berdimensi tinggi yang bising, sedangkan plot kanan menunjukkan bagaimana ekstraksi fitur dapat mengungkap pola yang lebih jelas dan lebih mudah digeneralisasi.
Bekerja dengan fitur yang diekstraksi alih-alih data mentah ibarat memberikan model Anda versi informasi yang lebih jernih dan tersarikan untuk dipelajari. Ini tidak hanya membuat proses pembelajaran lebih efisien, tetapi juga menghasilkan model yang lebih mungkin berkinerja baik dalam aplikasi dunia nyata.
Selanjutnya, mari kita lihat berbagai metode ekstraksi fitur.
Metode ekstraksi fitur secara umum dapat dikategorikan ke dalam dua pendekatan utama: rekayasa fitur manual dan ekstraksi fitur otomatis. Mari kita tinjau keduanya untuk memahami bagaimana keduanya membantu mengubah data mentah menjadi fitur bermakna.
Rekayasa fitur manual melibatkan penggunaan keahlian domain untuk mengidentifikasi dan membuat fitur relevan dari data mentah. Pendekatan hands-on ini bergantung pada pemahaman kita tentang masalah dan data untuk merancang fitur yang bermakna.
Dalam pengolahan citra, rekayasa fitur manual dapat melibatkan teknik seperti deteksi tepi untuk mengidentifikasi batas objek, histogram warna untuk menangkap distribusi warna, analisis tekstur untuk mengkuantifikasi pola, dan deskriptor bentuk untuk mencirikan geometri objek.
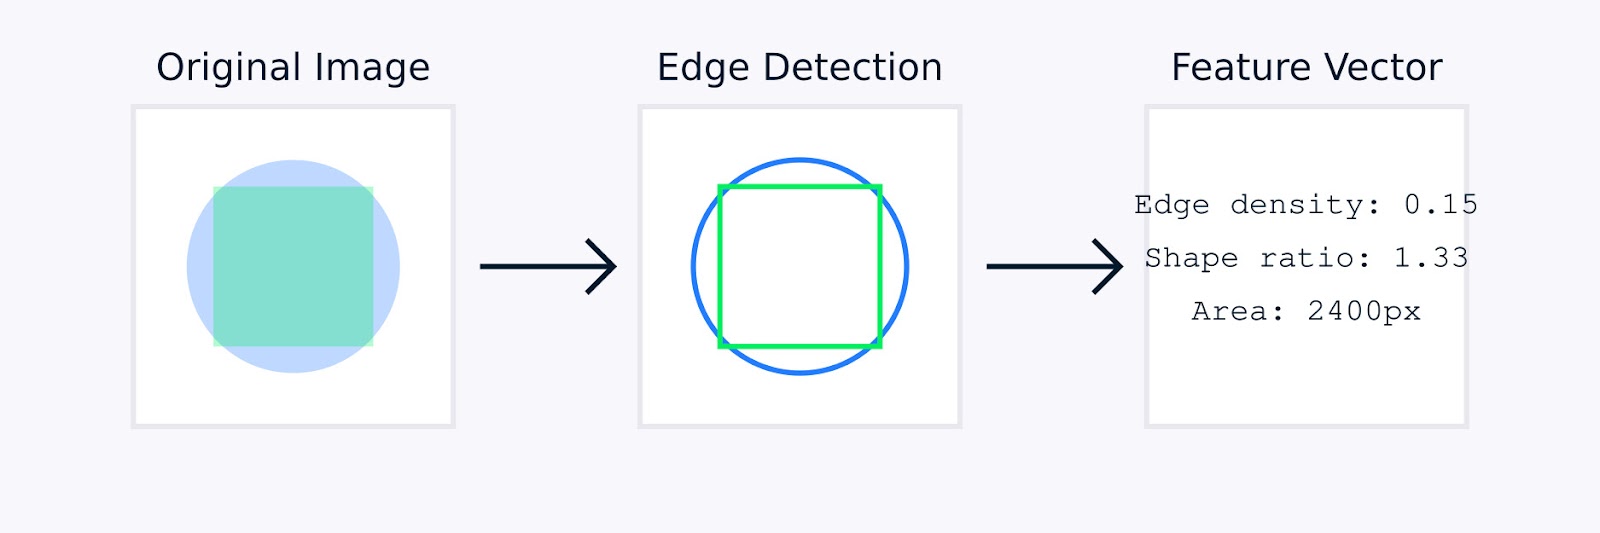
Ekstraksi Fitur Citra
Untuk data tabular, rekayasa fitur manual melibatkan pembuatan istilah interaksi antar fitur yang ada, mentransformasikan variabel menggunakan fungsi logaritmik atau polinomial, mengagregasi titik data menjadi statistik bermakna, dan mengodekan variabel kategorikal.
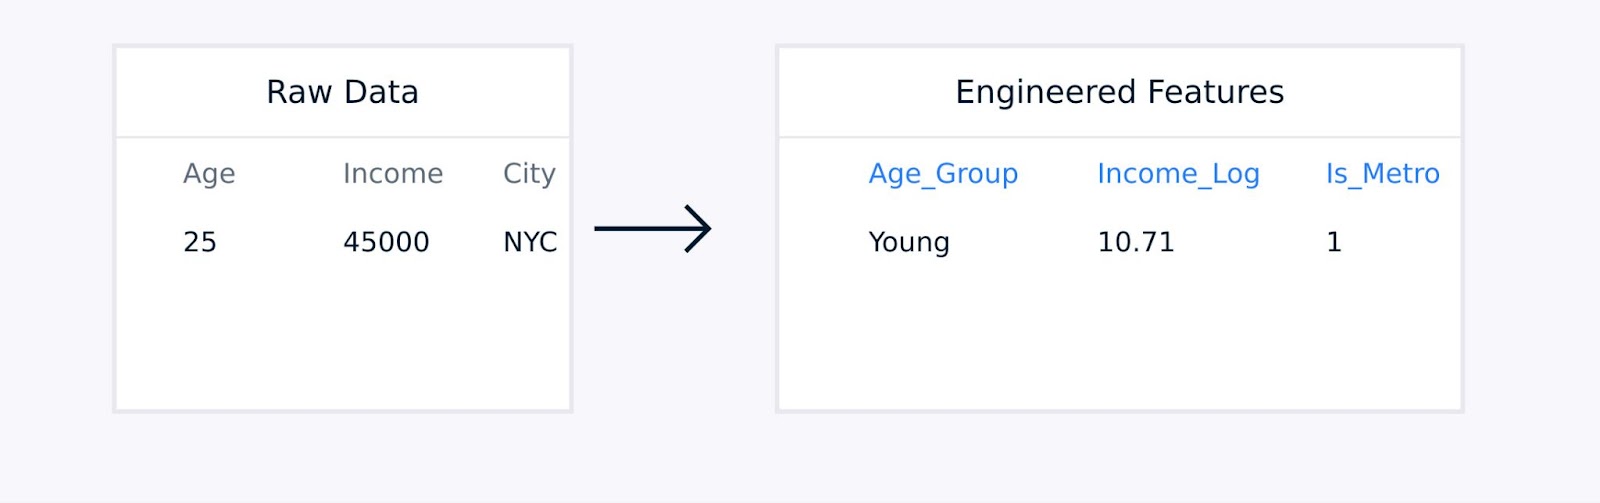
Ekstraksi fitur data tabular
Teknik-teknik ini, dipandu oleh keahlian domain, meningkatkan kualitas representasi data dan dapat secara signifikan meningkatkan kinerja model.
Ekstraksi fitur otomatis menggunakan algoritma untuk menemukan dan membuat fitur tanpa bimbingan manusia secara eksplisit. Metode ini sangat berguna saat menangani dataset kompleks di mana rekayasa fitur manual mungkin tidak praktis atau tidak efisien.
Pendekatan otomatis yang umum meliputi:
Principal Component Analysis (PCA): Mentransformasikan data menjadi sekumpulan komponen yang tidak berkorelasi, dengan setiap komponen menangkap varians tersisa maksimum. Pendekatan ini sangat berguna untuk reduksi dimensi, karena mempertahankan informasi esensial dalam data sambil menyederhanakan strukturnya.
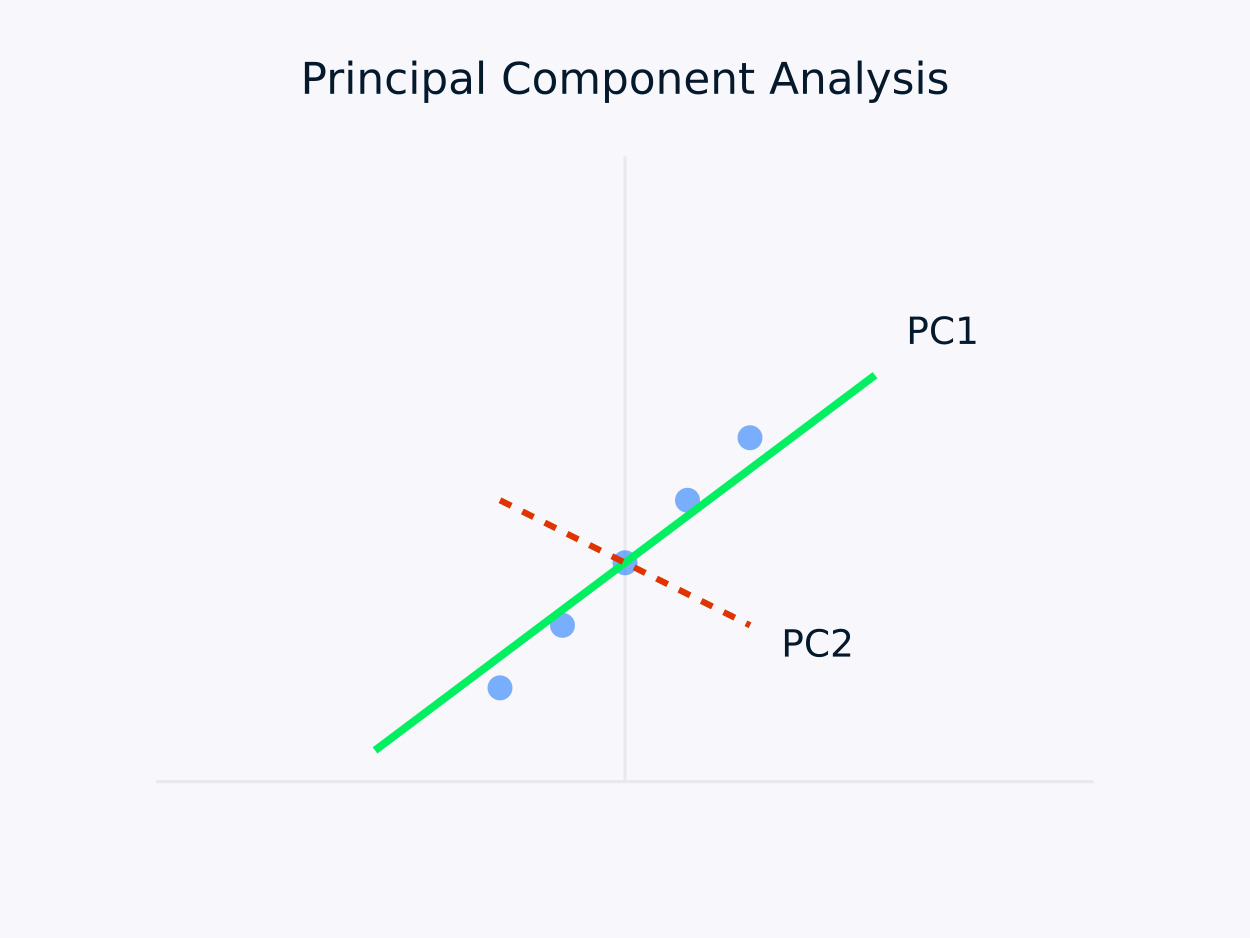
Principal Component Analysis (PCA)
Autoencoder: Ini adalah jaringan saraf yang mempelajari representasi terkompresi dari data, menangkap hubungan non-linear. Mereka sangat efektif untuk dataset berdimensi tinggi, di mana metode linear tradisional mungkin kurang memadai.
Berbagai alat dan pustaka telah muncul untuk menyederhanakan tugas rekayasa fitur. Misalnya, modul decomposition Scikit-learn menawarkan beragam metode untuk reduksi dimensi, dan PyCaret menyediakan kapabilitas pemilihan fitur otomatis.
Baik pendekatan manual maupun otomatis memiliki keunggulannya. Mari kita lihat kekuatan masing-masing pendekatan.
|
Rekayasa Manual |
Ekstraksi Otomatis |
|
Integrasi pengetahuan domain |
Skalabilitas |
|
Fitur yang mudah diinterpretasikan |
Menangani pola kompleks |
|
Kendali terperinci |
Mengurangi bias manusia |
|
Disesuaikan dengan kebutuhan spesifik |
Menemukan hubungan tersembunyi |
Pilihan antara metode manual dan otomatis sering bergantung pada faktor seperti kompleksitas dataset, ketersediaan keahlian domain, kebutuhan interpretabilitas, sumber daya komputasi, dan kendala waktu.
Untuk dataset yang sangat kompleks atau ketika waktu dan sumber daya terbatas, metode otomatis dapat dengan cepat menghasilkan fitur yang berguna. Sebaliknya, metode manual mungkin lebih disukai saat keahlian domain tersedia dan interpretabilitas menjadi prioritas, memungkinkan rekayasa fitur yang disesuaikan dengan masalah yang dihadapi.
Dalam praktiknya, banyak proyek machine learning yang sukses menggabungkan kedua pendekatan, memanfaatkan keahlian domain untuk memandu rekayasa fitur sambil menggunakan metode otomatis untuk menemukan pola tambahan yang mungkin tidak langsung terlihat oleh pakar manusia.
Pada bagian berikutnya, kita akan melihat beberapa teknik ekstraksi fitur di berbagai domain.
Setiap jenis data memerlukan teknik ekstraksi fitur khusus yang dioptimalkan untuk karakteristik uniknya. Mari kita lihat teknik paling umum untuk berbagai jenis data.
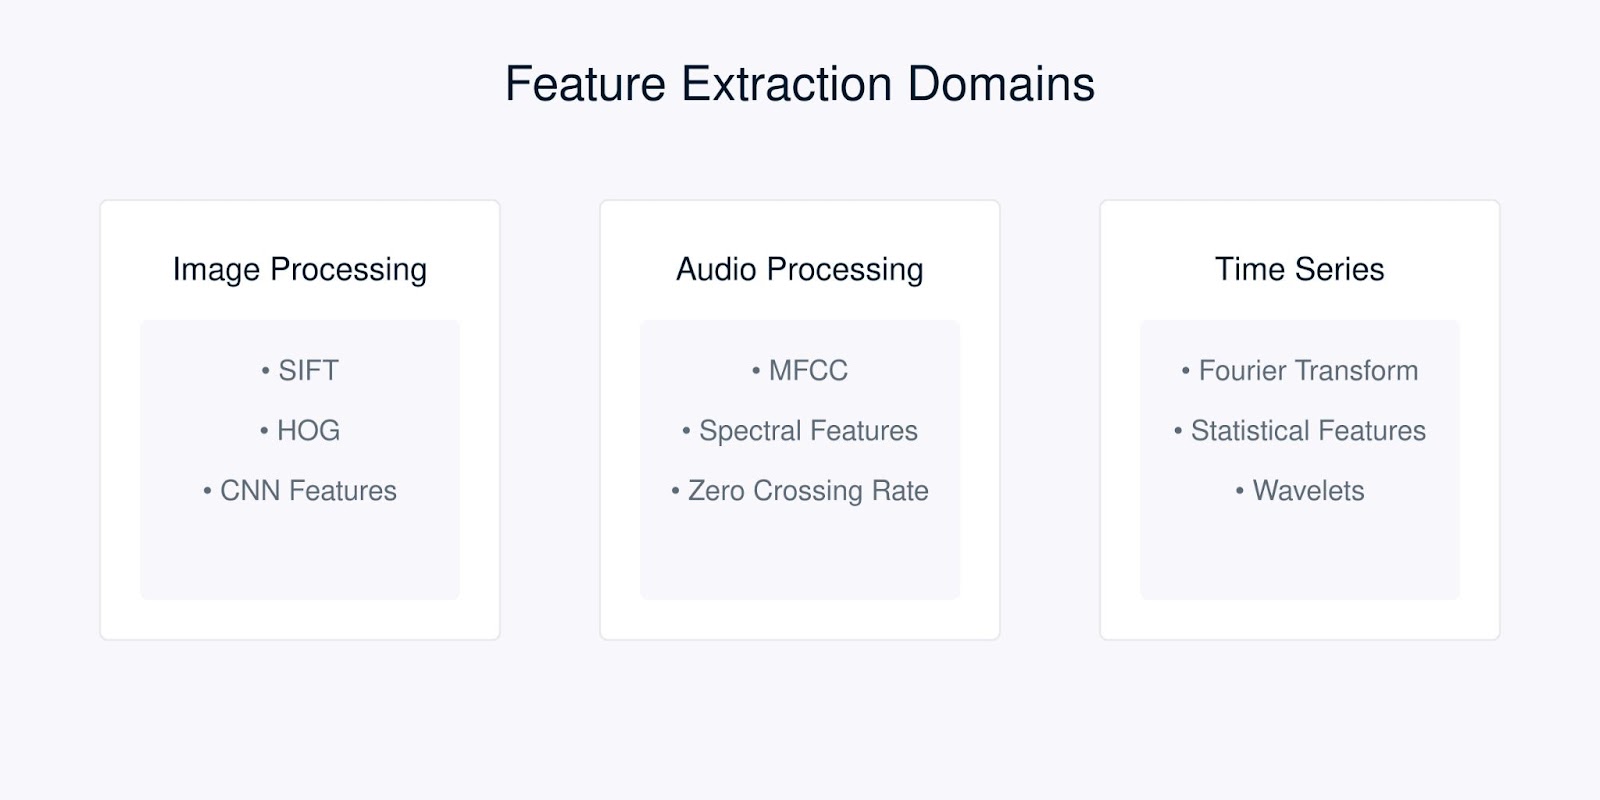
Teknik Ekstraksi Fitur
Ekstraksi fitur citra mengubah data piksel mentah menjadi representasi bermakna yang menangkap informasi visual esensial. Ada tiga kategori utama teknik yang digunakan dalam computer vision modern: metode tradisional, metode berbasis deep learning, dan metode statistik.
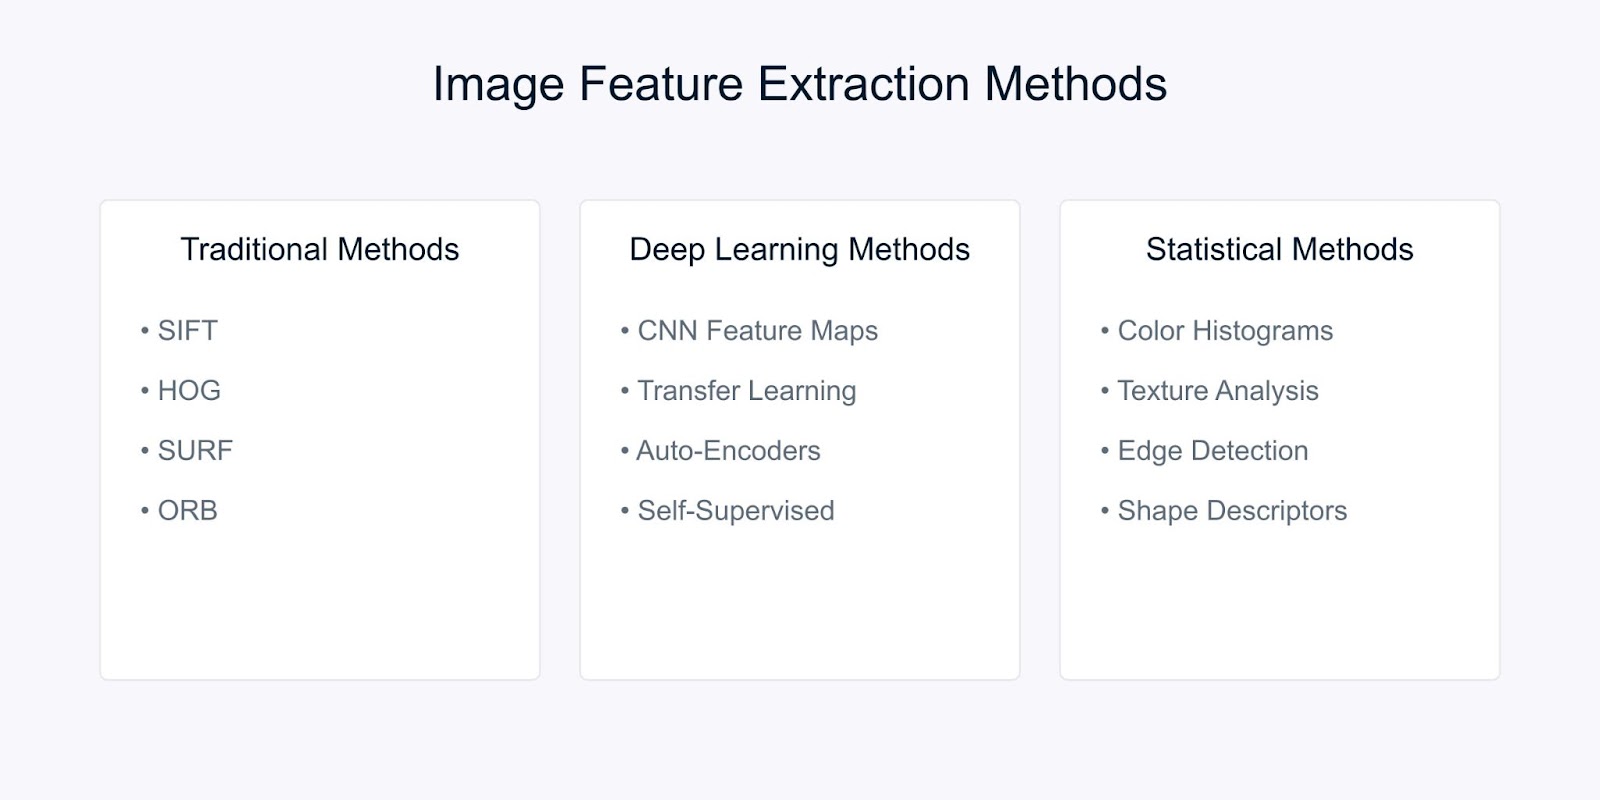
Metode Ekstraksi Fitur Citra
Mari kita lihat masing-masing metode.
Scale-Invariant Feature Transform (SIFT) adalah metode tangguh yang mendeteksi fitur lokal khas pada gambar. Ia bekerja dengan mengidentifikasi titik kunci dan menghasilkan deskriptor yang:
Algoritme SIFT memproses gambar melalui beberapa tahap. Ia dimulai dengan deteksi ekstrem skala-ruang untuk mengidentifikasi potensi titik kunci yang invarian terhadap skala. Berikutnya, lokalisasi titik kunci menyaring kandidat ini dengan menentukan lokasi tepatnya dan membuang titik yang tidak stabil.
Setelah itu, penetapan orientasi menentukan orientasi yang konsisten untuk setiap titik kunci, memastikan invariansi rotasi. Terakhir, pembuatan deskriptor titik kunci menciptakan deskriptor khas berdasarkan gradien citra lokal, memfasilitasi pencocokan yang tangguh antar gambar.
Metode lain adalah Histogram of Oriented Gradients (HOG). Ini menangkap informasi bentuk lokal dengan menganalisis pola gradien di seluruh gambar. Prosesnya dimulai dengan menghitung gradien di seluruh gambar untuk menonjolkan detail tepi.
Gambar kemudian dibagi menjadi sel-sel kecil, dan untuk setiap sel, histogram orientasi gradien dibuat untuk merangkum struktur lokal. Terakhir, histogram ini dinormalisasi di seluruh blok yang lebih besar untuk memastikan ketangguhan terhadap variasi pencahayaan dan kontras, menghasilkan deskriptor fitur yang andal untuk tugas seperti deteksi dan pengenalan objek.
Convolutional Neural Networks (CNN) telah mengubah cara kita melakukan ekstraksi fitur dengan secara otomatis mempelajari representasi hierarkis.
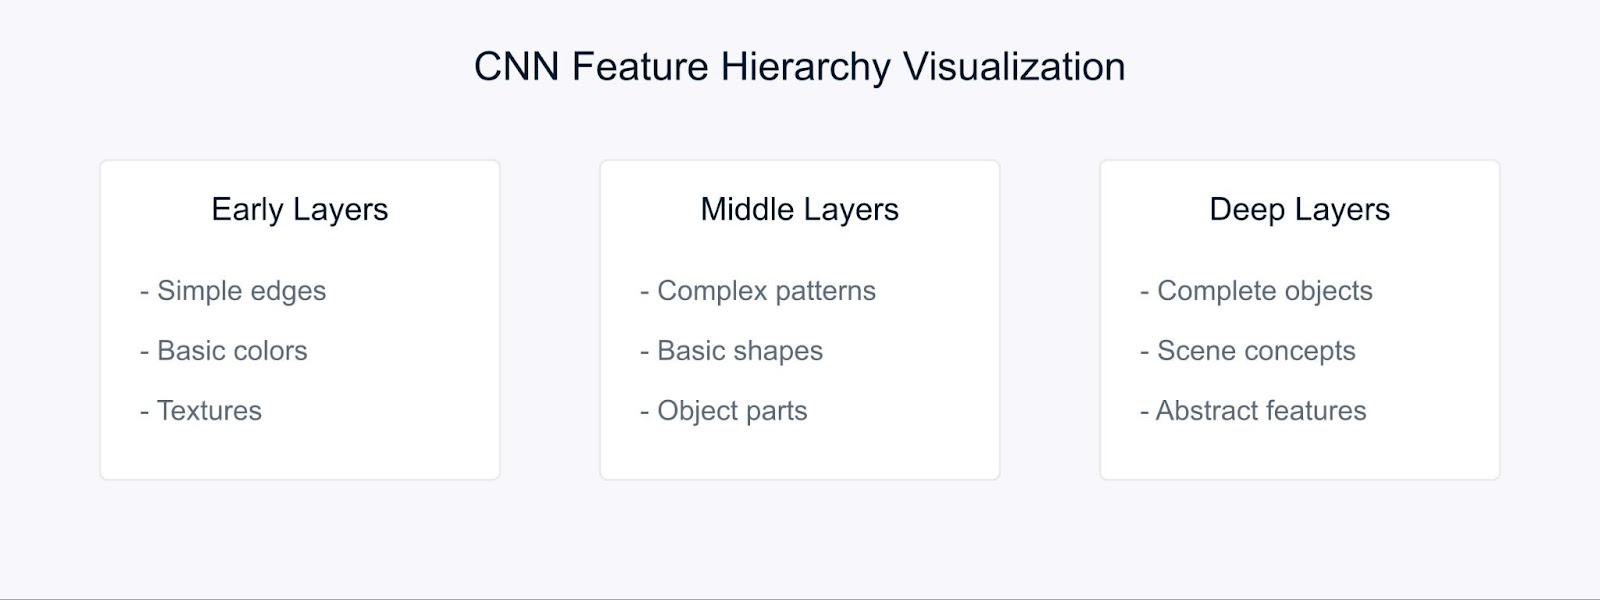
Ekstraksi Fitur dengan CNN
CNN mempelajari fitur melalui struktur hierarkisnya. Pada lapisan awal, mereka mendeteksi elemen visual dasar seperti tepi dan warna. Lapisan tengah kemudian menggabungkan elemen ini untuk mengenali pola dan bentuk, sementara lapisan yang lebih dalam menangkap objek kompleks dan memungkinkan pemahaman adegan.
Transfer learning memungkinkan kita menggunakan fitur yang telah dipelajari sebelumnya dari model yang dilatih pada dataset besar, sehingga sangat berguna saat bekerja dengan data terbatas.
Metode statistik mengekstrak pola global dan lokal dari gambar, memfasilitasi analisis dan interpretasi citra yang tangguh.
Sebagai contoh, histogram warna merepresentasikan distribusi warna dalam sebuah gambar dan memberikan fitur yang invarian terhadap rotasi dan skala, sehingga sangat berguna untuk tugas seperti klasifikasi dan penelusuran gambar.
Analisis tekstur menangkap pola berulang dan karakteristik permukaan menggunakan teknik seperti Gray Level Co-occurrence Matrices (GLCM), yang efektif untuk aplikasi termasuk pengenalan material dan klasifikasi adegan.
Selain itu, deteksi tepi mengidentifikasi batas dan perubahan intensitas signifikan melalui metode seperti operator Sobel, Canny, dan Laplacian, yang berperan penting dalam deteksi objek dan analisis bentuk.
Pilihan metode ekstraksi fitur bergantung pada beberapa faktor. Ini harus selaras dengan kebutuhan spesifik tugas Anda, mempertimbangkan sumber daya komputasi yang tersedia, dan memperhitungkan kebutuhan interpretabilitas.
Selain itu, karakteristik dataset Anda—seperti ukuran, tingkat noise, dan kompleksitas—sangat berperan, begitu pula dengan properti invariansi yang dibutuhkan seperti skala, rotasi, dan pencahayaan.
Bayangkan mencoba mengajarkan komputer memahami ucapan seperti manusia. Di sinilah Mel-Frequency Cepstral Coefficients (MFCC) berperan.
MFCC adalah fitur audio khusus yang menguraikan suara dengan cara yang mirip dengan proses pendengaran manusia. Fitur ini sangat efektif karena fokus pada frekuensi yang paling sensitif bagi manusia. Anggap saja sebagai menerjemahkan suara ke format yang bermakna bagi komputer dan pendengaran manusia.
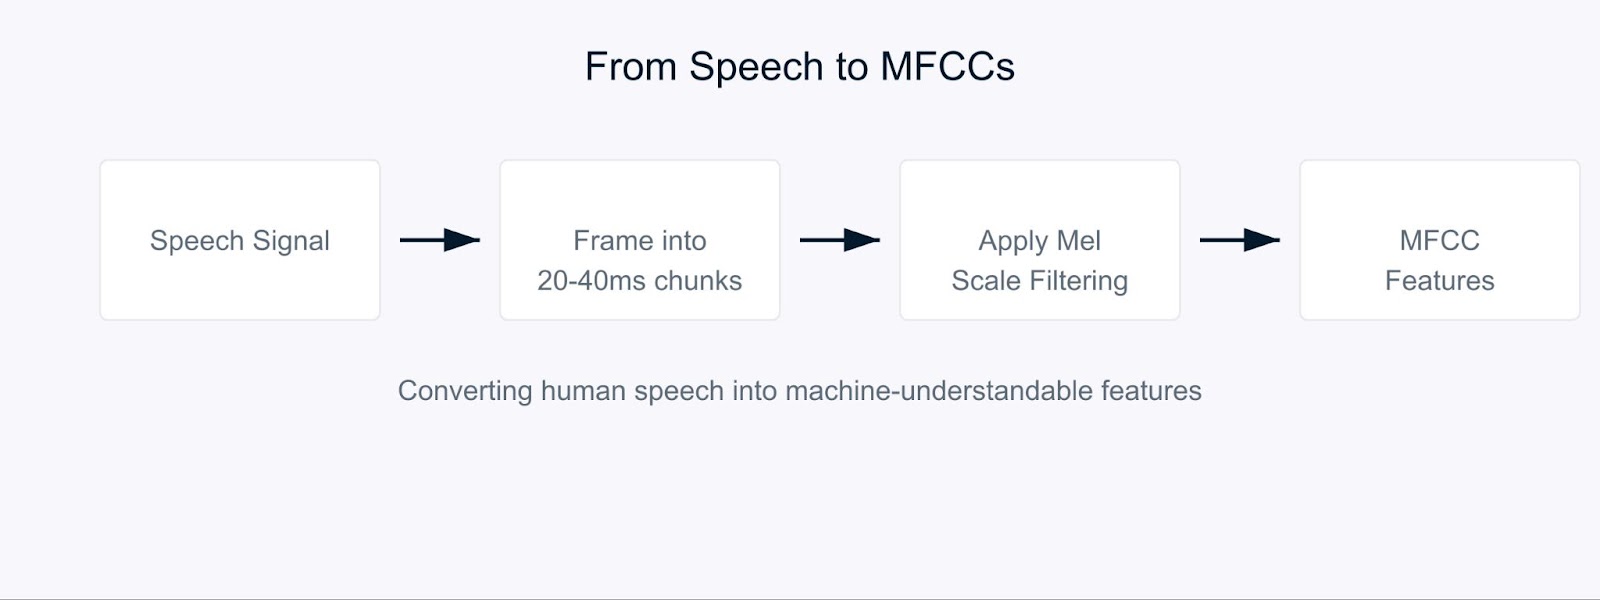
Mel-Frequency Cepstral Coefficients
Prosesnya dimulai dengan memecah sinyal audio menjadi potongan pendek, biasanya 20–40 milidetik. Untuk setiap potongan, kita menerapkan serangkaian transformasi matematis yang mengonversi gelombang suara mentah menjadi komponen frekuensi. Di sinilah menariknya. Alih-alih memperlakukan semua frekuensi secara setara, kita menggunakan sesuatu yang disebut skala Mel.
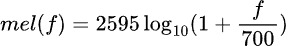
Formula ini mungkin tampak kompleks, tetapi ini hanya memetakan frekuensi agar sesuai dengan cara manusia mempersepsikan suara. Telinga kita lebih baik dalam mendeteksi perbedaan pada frekuensi rendah daripada frekuensi tinggi, dan skala Mel memperhitungkan bias alami ini.
Dalam pengenalan suara, MFCC menjadi fondasi untuk memahami siapa yang berbicara dan apa yang dikatakan. Saat Anda berbicara dengan asisten virtual di ponsel, kemungkinan besar ia menggunakan MFCC untuk memproses suara Anda. Koefisien ini membantu menangkap karakteristik unik dari suara setiap orang, sehingga sangat berharga untuk sistem identifikasi pembicara.
Untuk analisis sentimen dalam ucapan, MFCC membantu mendeteksi variasi halus dalam suara yang menunjukkan emosi. Mereka dapat menangkap perubahan nada, intonasi, dan kecepatan bicara yang mungkin mengindikasikan apakah seseorang bahagia, sedih, marah, atau netral. Misalnya, saat menganalisis panggilan layanan pelanggan, MFCC dapat membantu mengidentifikasi tingkat kepuasan pelanggan berdasarkan cara mereka berbicara, bukan hanya apa yang mereka ucapkan.
Saat bekerja dengan data deret waktu, mengekstraksi fitur bermakna membantu kita menangkap pola dan tren yang berkembang seiring waktu. Mari kita lihat beberapa teknik kunci yang digunakan untuk mengubah data deret waktu mentah menjadi fitur yang berguna.
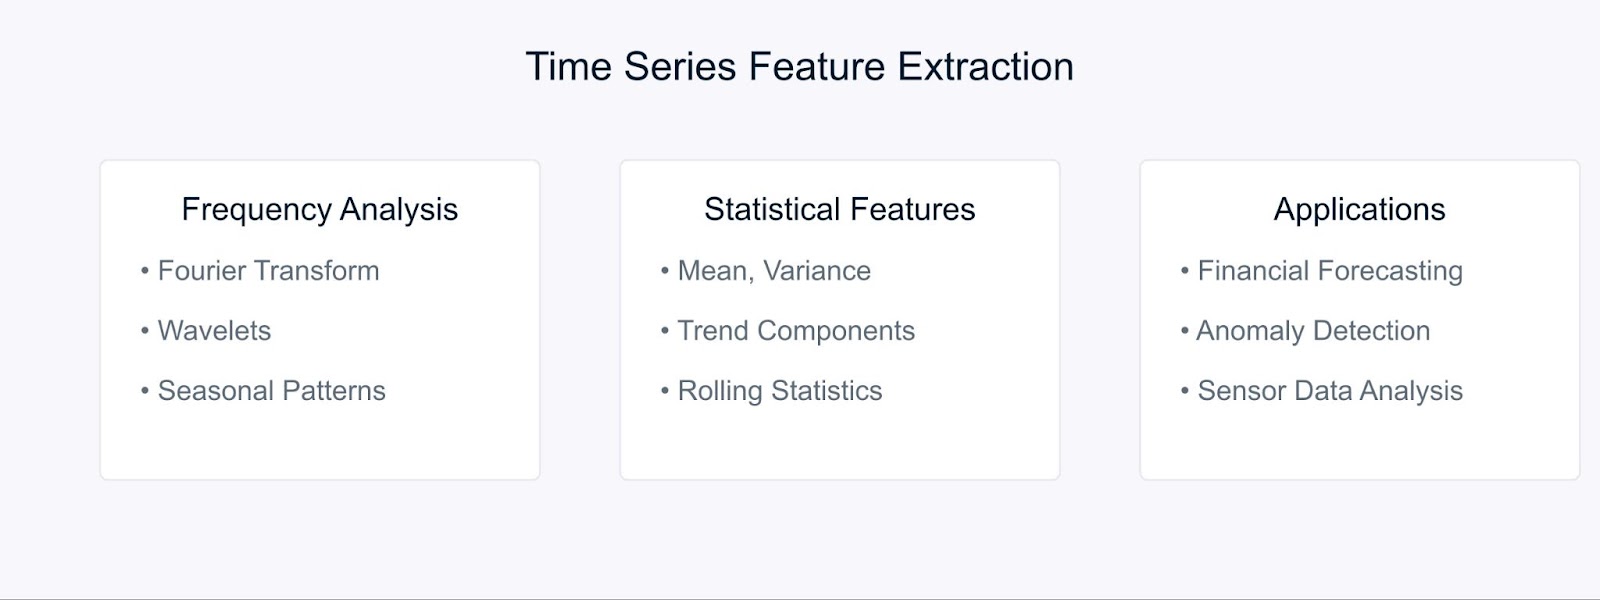
Metode Ekstraksi Fitur Deret Waktu
Transformasi Fourier menguraikan data deret waktu menjadi komponen frekuensinya, mengungkap pola periodik tersembunyi. Formulanya adalah:
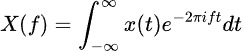
Metode statistik melengkapi analisis frekuensi dengan menangkap karakteristik temporal. Fitur umum mencakup rata-rata bergerak, deviasi standar, dan komponen tren. Teknik-teknik ini sangat kuat dalam peramalan keuangan, di mana teknik ini membantu mengidentifikasi tren pasar dan anomali.
Sebagai contoh, dalam analisis pasar saham, menggabungkan fitur Fourier dengan ukuran statistik dapat mengungkap tren jangka panjang dan pola siklikal. Demikian pula, dalam lingkungan industri, metode ini membantu mendeteksi anomali peralatan dengan menganalisis pola data sensor dari waktu ke waktu.
Mari kita lihat beberapa alat esensial yang membuat penerapan metode ekstraksi fitur ini menjadi mudah dan efisien.
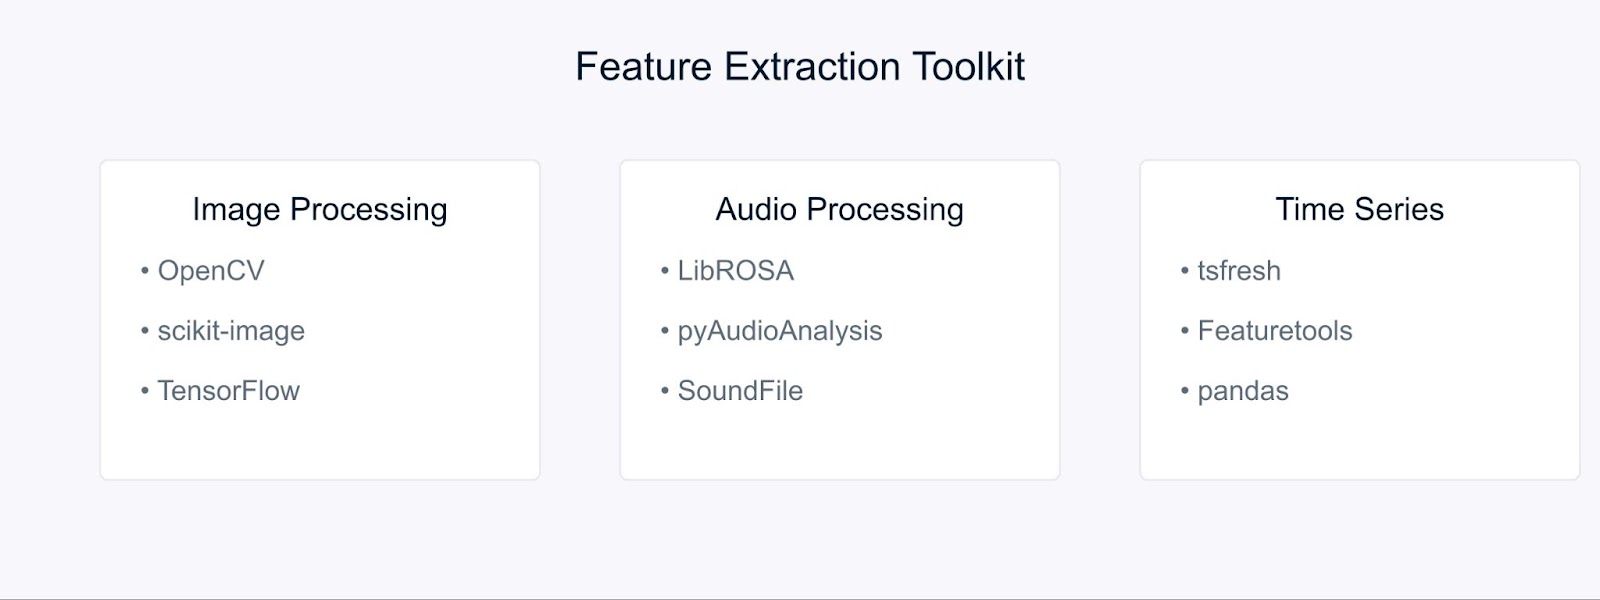
Alat dan Pustaka untuk Ekstraksi Fitur
Untuk pengolahan citra, OpenCV dan scikit-image menyediakan alat komprehensif untuk menerapkan berbagai teknik ekstraksi fitur. Pustaka ini menawarkan implementasi efisien dari SIFT, HOG, dan algoritme lain yang kita bahas sebelumnya. Saat bekerja dengan pendekatan deep learning, kerangka kerja seperti TensorFlow dan PyTorch menjadi sangat berharga. Anda dapat memulai dengan tutorial OpenCV kami untuk mempelajari lebih lanjut.
Tugas pemrosesan audio menjadi lebih mudah dengan pustaka seperti LibROSA, yang unggul dalam mengekstraksi MFCC dan fitur akustik lainnya. PyAudioAnalysis memperluas kapabilitas ini dengan antarmuka tingkat tinggi untuk tugas analisis audio.
Untuk data deret waktu, tsfresh dan Featuretools mengotomatiskan proses ekstraksi fitur. Pustaka ini dapat secara otomatis menghasilkan dan memilih fitur relevan dari data temporal Anda, sehingga Anda lebih mudah fokus pada pengembangan model daripada rekayasa fitur.
Mari kita praktikkan pengetahuan kita dengan beberapa contoh langsung. Kita akan mulai dengan ekstraksi fitur citra, salah satu aplikasi paling umum dalam computer vision.
Pertama, mari impor pustaka yang diperlukan
# Import required libraries
import cv2
import numpy as np
import matplotlib.pyplot as plt
Sekarang, mari memuat sebuah gambar untuk mengekstrak fitur yang relevan. Untuk contoh ini, kita akan menggunakan gambar Godzilla yang diunduh dari internet.
# Load the image
image = cv2.imread('godzilla.jpg')

# Convert BGR to RGB (OpenCV loads in BGR format)
image_rgb = cv2.cvtColor(image, cv2.COLOR_BGR2RGB)

# Display the original image
plt.imshow(image_rgb)
plt.title('Original Image')
plt.axis('off')
plt.show()
Keluaran:
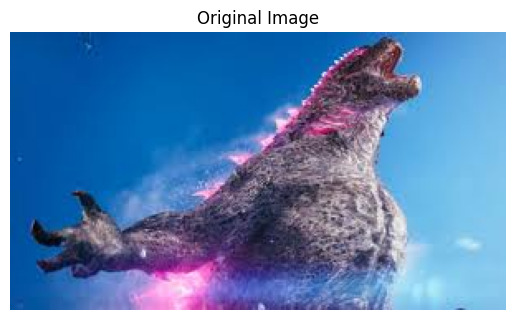
Sebelum menerapkan deteksi tepi, kita perlu melakukan prapemrosesan pada gambar. Kita lakukan sebagai berikut:
# Convert the image to grayscale
gray_image = cv2.cvtColor(image, cv2.COLOR_BGR2GRAY)

# Apply Gaussian blur to reduce noise
blurred = cv2.GaussianBlur(gray_image, (5, 5), 0)
Terakhir, mari terapkan algoritme deteksi tepi Canny dan visualisasikan hasilnya:
# Apply Canny edge detection
edges = cv2.Canny(blurred, threshold1=100, threshold2=200)

# Display the results
plt.figure(figsize=(10, 5))
plt.subplot(1, 2, 1)
plt.imshow(image_rgb)
plt.title('Original Image')
plt.axis('off')

plt.subplot(1, 2, 2)
plt.imshow(edges, cmap='gray')
plt.title('Edge Detection')
plt.axis('off')

plt.tight_layout()
plt.show()
Keluaran:
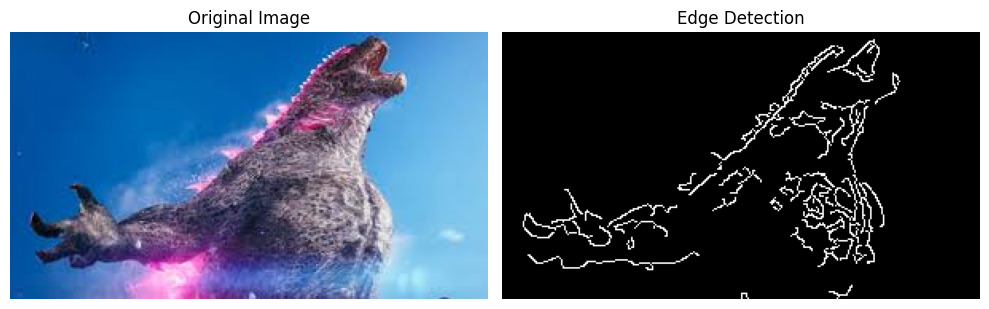
Detektor tepi Canny membantu kita mengidentifikasi batas dan fitur penting dalam gambar, yang dapat digunakan untuk analisis lanjutan atau sebagai masukan ke model machine learning.
Sebelum kita dapat mulai memproses berkas audio, kita perlu menginstal pustaka yang diperlukan. Karena LibROSA tidak termasuk dalam pustaka standar Python, kita akan menggunakan pip untuk memasangnya:
# Install required libraries
# Run these commands in your terminal or command prompt
pip install librosa
pip install numpy
pip install matplotlib
LibROSA adalah pustaka andal yang dirancang untuk analisis musik dan audio, jadi mari mulai dengan mengimpornya bersama pustaka lain yang diperlukan:
# Import required libraries
import librosa
import librosa.display
import numpy as np
import matplotlib.pyplot as plt
Berkas suara berisi banyak informasi dalam format gelombang. Untuk bekerja dengan data ini, pertama-tama kita perlu memuatnya ke dalam program. LibROSA membantu kita melakukan ini dengan mengonversi berkas audio ke format yang dapat kita analisis:
# Load the audio file
# Duration is limited to 10 seconds for this example
audio_path = 'audio_sample.wav'
y, sr = librosa.load(audio_path, duration=10)

# Display the waveform
plt.figure(figsize=(10, 4))
plt.plot(y)
plt.title('Audio Waveform')
plt.show()
Keluaran:
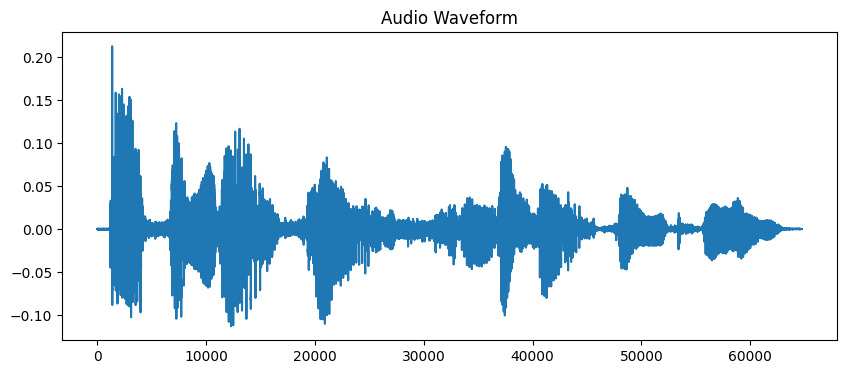
Sekarang setelah audio kita dimuat, kita perlu mengekstraksi fitur bermakna darinya. Telinga kita secara alami menguraikan suara menjadi berbagai komponen frekuensi, dan MFCC meniru proses ini. Kita menggunakan fungsi ekstraksi fitur librosa untuk menghitung koefisien ini:
# Extract MFCC features
mfccs = librosa.feature.mfcc(y=y, sr=sr, n_mfcc=13)

# Display the MFCC
plt.figure(figsize=(10, 4))
librosa.display.specshow(mfccs, x_axis='time')
plt.colorbar(format='%+2.0f dB')
plt.title('MFCC')
plt.show()
Keluaran:
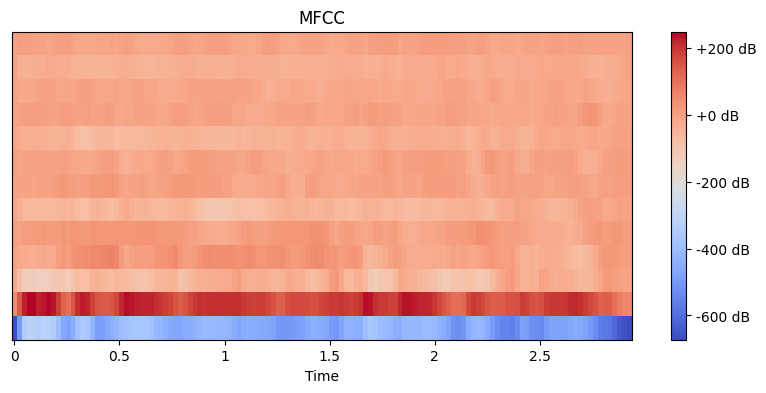
Di sini, kami menetapkan n_mfcc=13 karena 13 koefisien pertama biasanya menangkap aspek suara yang paling penting yang membantu dalam tugas seperti pengenalan ucapan. Visualisasi yang dihasilkan menunjukkan bagaimana fitur-fitur ini berubah seiring waktu, di mana warna yang lebih cerah merepresentasikan nilai yang lebih tinggi.
Pertama, mari pasang pustaka yang diperlukan. Kita akan menggunakan yfinance untuk mendapatkan data keuangan, bersama tsfresh untuk ekstraksi fitur:
# Install required libraries
# Run these commands in your terminal or command prompt
pip install tsfresh
pip install pandas
pip install numpy
pip install matplotlib
pip install yfinance
Sekarang mari impor pustaka kita dan ambil beberapa data keuangan nyata:
# Import required libraries
import pandas as pd
import numpy as np
from tsfresh import extract_features
from tsfresh.feature_extraction import MinimalFCParameters
import matplotlib.pyplot as plt
import yfinance as yf
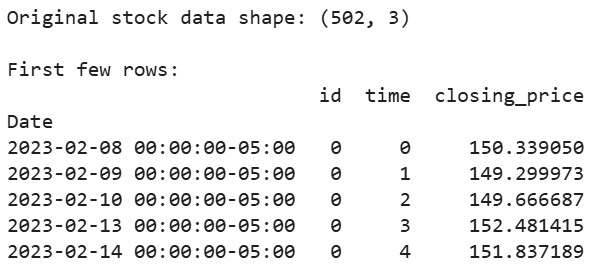
Mari ambil beberapa data pasar saham nyata. Kita akan menggunakan data saham Apple sebagai contoh:
# Download Apple's stock data for the last 2 years
aapl = yf.Ticker("AAPL")
df = aapl.history(period="2y")

# Prepare the data in the format tsfresh expects
df_tsfresh = pd.DataFrame({
    'id': [0] * len(df),  # Each time series needs an ID
    'time': range(len(df)),
    'closing_price': df['Close']  # We'll use closing prices
})

# Display first few rows of our data
print("Original stock data shape:", df_tsfresh.shape)
print("\nFirst few rows:")
print(df_tsfresh.head())
Keluaran:
Sekarang mari ekstrak fitur dari data deret waktu keuangan kita:
# Set up the feature extraction parameters
extraction_settings = MinimalFCParameters()

# Extract features automatically
extracted_features = extract_features(df_tsfresh,
                                   column_id='id',
                                   column_sort='time',
                                   column_value='values',
                                   default_fc_parameters=extraction_settings)

# Display the extracted features
print("\nExtracted features shape:", extracted_features.shape)
print("\nExtracted features:")
print(extracted_features.head())
Keluaran:
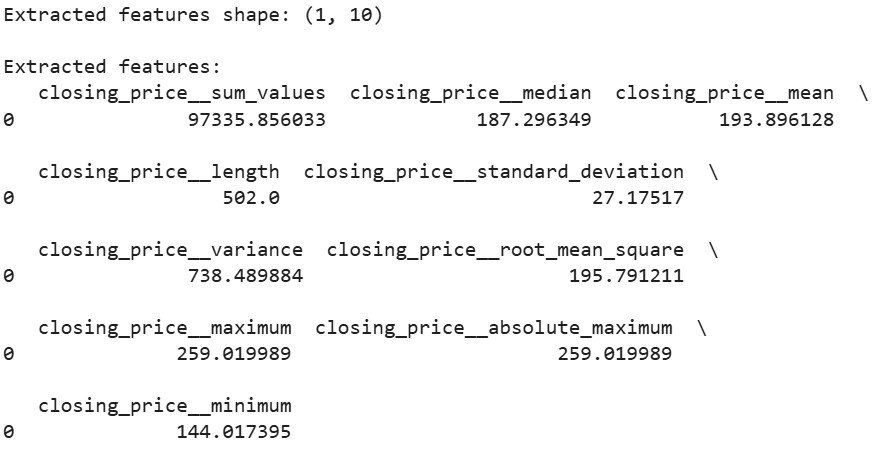
Di sini, kami menggunakan MinimalFCParameters() untuk menentukan fitur mana yang akan diekstraksi. Ini memberi kita sekumpulan dasar fitur deret waktu yang bermakna seperti mean, varians, dan karakteristik tren, yang esensial untuk memahami pola dalam data kita.
Saat bekerja dengan ekstraksi fitur, kita sering menemui tantangan.
Dimensi tinggi dan kendala komputasi sering muncul saat menangani dataset besar. Misalnya, mengekstraksi fitur dari gambar beresolusi tinggi atau berkas audio panjang dapat mengonsumsi memori dan daya pemrosesan yang signifikan.
Overfitting akibat fitur yang tidak relevan atau redundan adalah tantangan umum lainnya. Ketika terlalu banyak fitur diekstraksi, model mungkin mempelajari noise alih-alih pola bermakna. Ini terutama umum dalam pemrosesan citra dan audio di mana ribuan fitur dapat dihasilkan.
Untuk mengatasi tantangan ini, pertimbangkan strategi berikut:
Tantangan-tantangan ini memerlukan pertimbangan cermat dan keseimbangan antara kekayaan fitur dan efisiensi komputasi.
Ekstraksi fitur adalah keterampilan fundamental dalam machine learning yang mengubah data mentah menjadi representasi bermakna. Melalui contoh praktis dengan OpenCV, LibROSA, dan tsfresh, kita telah melihat cara mengekstraksi fitur dari berbagai jenis data. Dengan memahami teknik-teknik ini dan tantangannya, kita dapat membangun model machine learning yang efektif.
Siap melangkah lebih jauh? Lihat sumber berikut:
Kursus Teratas di DataCamp
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



