
Kursus
Pengurangan Dimensi dengan Python
4 jam
37.2K
Reduksi dimensi adalah teknik yang kuat dalam pembelajaran mesin dan analisis data yang melibatkan transformasi data berdimensi tinggi ke ruang berdimensi lebih rendah sambil mempertahankan sebanyak mungkin informasi penting. Data berdimensi tinggi mengacu pada dataset dengan banyak fitur atau variabel, yang dapat menimbulkan tantangan signifikan bagi model pembelajaran mesin.
Dalam tutorial ini, kita akan mempelajari mengapa kita perlu menggunakan reduksi dimensi, jenis-jenis teknik reduksi dimensi, dan cara menerapkan teknik-teknik tersebut pada dataset gambar sederhana. Kita juga akan memvisualisasikan data dalam ruang 2D dan membandingkan gambar di ruang berdimensi lebih rendah.
Jika Anda baru di bidang pembelajaran mesin dan ingin menguasai konsep-konsepnya, ikuti Jadilah Machine Learning Scientist dengan Python dan mulai meniti karier sebagai ilmuwan pembelajaran mesin.
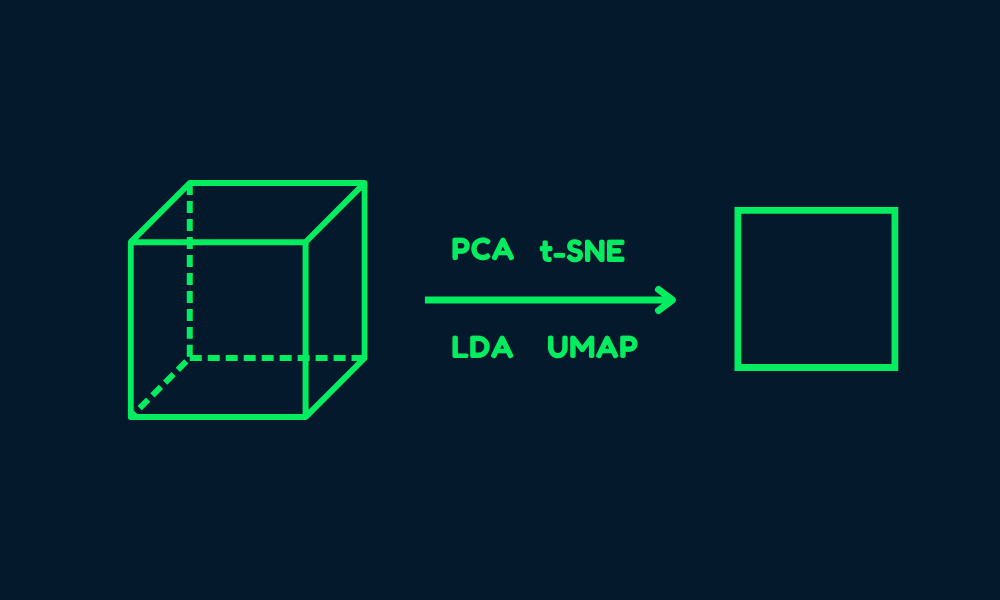
Gambar oleh Penulis
Data berdimensi tinggi, meskipun kaya informasi, sering kali mengandung fitur yang berlebihan atau tidak relevan. Ini dapat menimbulkan beberapa masalah:
Reduksi dimensi mengatasi masalah-masalah ini dengan menyederhanakan data sambil mempertahankan fitur terpentingnya. Ini tidak hanya meningkatkan kinerja model tetapi juga membuat data lebih mudah ditafsirkan dan divisualisasikan.
Teknik reduksi dimensi juga dapat diklasifikasikan berdasarkan apakah mereka mengasumsikan struktur linier atau nonlinier pada data.
Metode linier mengasumsikan bahwa data berada pada subruang linier. Teknik-teknik ini efisien secara komputasi dan bekerja baik ketika struktur data memang linier.
Berikut beberapa contohnya:
Ikuti tutorial Principal Component Analysis (PCA) di Python untuk mempelajari cara mengekstrak informasi dari data tanpa supervisi menggunakan dataset Breast Cancer dan CIFAR-10.
Metode nonlinier digunakan ketika data berada pada manifold nonlinier. Teknik-teknik ini lebih cocok untuk menangkap struktur kompleks dalam data.
Berikut beberapa contohnya:
Teknik reduksi dimensi secara garis besar dapat dikategorikan menjadi dua jenis: Pemilihan fitur dan Ekstraksi fitur.
Pemilihan fitur melibatkan identifikasi dan mempertahankan hanya fitur yang paling relevan dari dataset. Proses ini tidak mentransformasi data, melainkan memilih subset dari fitur asli.
Metode umum meliputi:
Ekstraksi fitur, juga dikenal sebagai proyeksi fitur, mentransformasi data ke ruang berdimensi lebih rendah dengan membuat fitur baru yang merupakan kombinasi dari fitur-fitur asli. Pendekatan ini sangat berguna ketika fitur asli sangat berkorelasi atau redundan.
Metode ekstraksi fitur yang populer meliputi:
Dalam panduan ini, kita akan mempelajari cara menerapkan teknik reduksi dimensi di Python.
Kita akan mulai dengan mengimpor paket Python yang diperlukan dan memuat dataset digits dari sklearn.datasets.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_digits
from sklearn.manifold import TSNE
from sklearn.preprocessing import StandardScaler


# Load the digits dataset
digits = load_digits()
X = digits.data   # shape (1797, 64)
y = digits.target # labels for digits (0 through 9)

print("Data shape:", X.shape)
print("Labels shape:", y.shape)
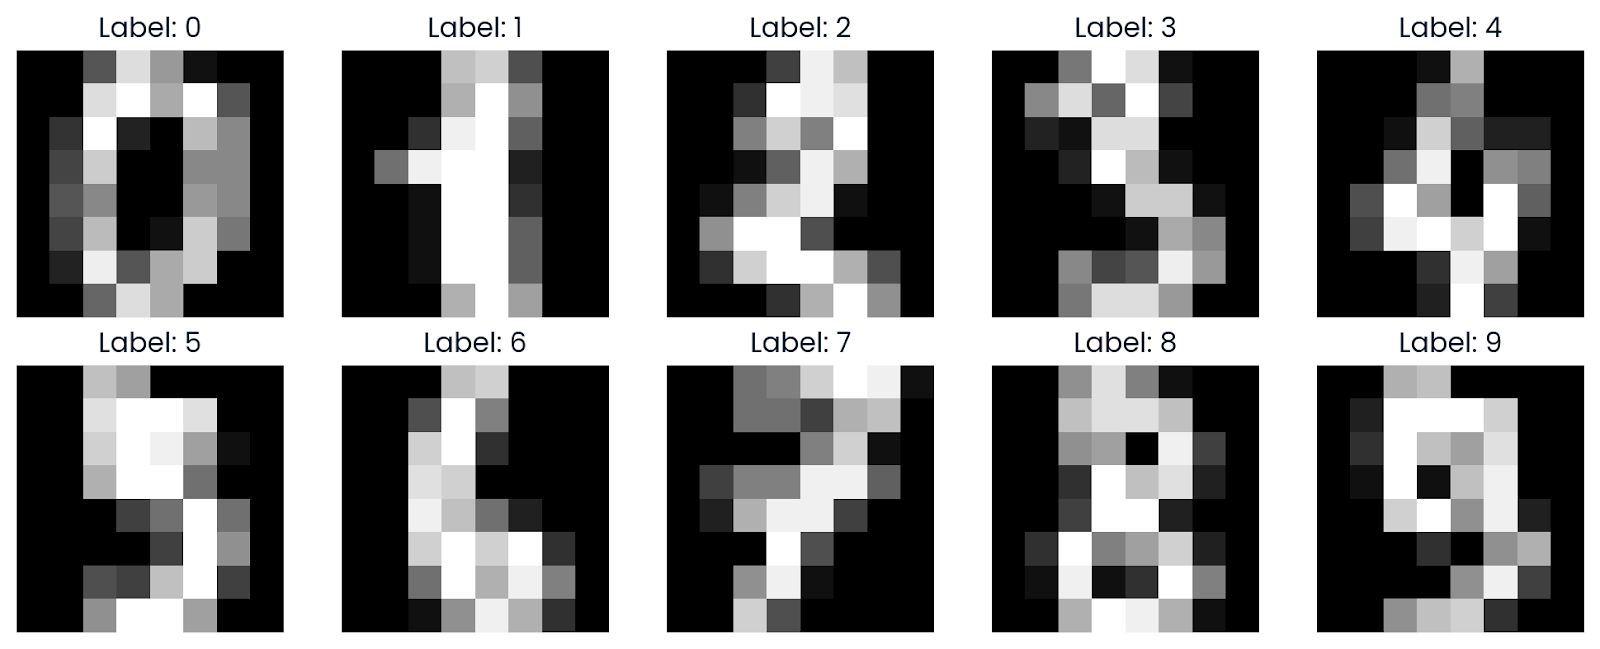
Dataset ini berisi 1.797 gambar skala abu-abu dari digit tulisan tangan (0–9), masing-masing direpresentasikan sebagai gambar 8x8 (64 piksel). Data diratakan menjadi vektor fitur berdimensi 64 untuk setiap gambar.
Data shape: (1797, 64)
Labels shape: (1797,)Sekarang kita akan memvisualisasikan beberapa sampel dari dataset untuk mendapatkan pemahaman yang lebih baik. Dengan Matplotlib, kita akan menampilkan gambar yang telah dibentuk kembali ke format kisi 8x8 aslinya.
def plot_digits(images, labels, n_rows=2, n_cols=5):
    fig, axes = plt.subplots(n_rows, n_cols, figsize=(10, 4))
    axes = axes.ravel()
    for i in range(n_rows * n_cols):
        axes[i].imshow(images[i].reshape(8, 8), cmap='gray')
        axes[i].set_title(f"Label: {labels[i]}")
        axes[i].axis('off')
    plt.tight_layout()
    plt.show()

plot_digits(X, y)
Seperti yang terlihat, ini menampilkan kisi gambar, menunjukkan bagaimana digit tampak dalam skala abu-abu dari 0 hingga 9.
t-SNE adalah teknik reduksi dimensi populer untuk memvisualisasikan data berdimensi tinggi dalam 2D atau 3D. Teknik ini sangat efektif dalam mempertahankan struktur lokal pada data.
Baca blog Pengantar t-SNE: Reduksi Dimensi Nonlinier dan Visualisasi Data untuk mempelajari cara memvisualisasikan data berdimensi tinggi di ruang berdimensi rendah menggunakan teknik reduksi dimensi nonlinier.
Sebelum menerapkan t-SNE, kita menskalakan data menggunakan StandardScaler untuk menormalkan nilai fitur.
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)
Kemudian, kita memilih subset 500 sampel agar komputasi lebih cepat dan menjalankan algoritma t-SNE pada subset tersebut.
Berikut argumen fungsi TSNE beserta penjelasannya:
n_samples = 500
X_sub = X_scaled[:n_samples]
y_sub = y[:n_samples]

tsne = TSNE(n_components=2,
            perplexity=30,
            n_iter=1000,
            random_state=42)
X_tsne = tsne.fit_transform(X_sub)

print("t-SNE result shape:", X_tsne.shape)
Reduksi dimensi berhasil, karena sekarang kita memiliki 500 sampel yang masing-masing direpresentasikan dalam 2 dimensi.
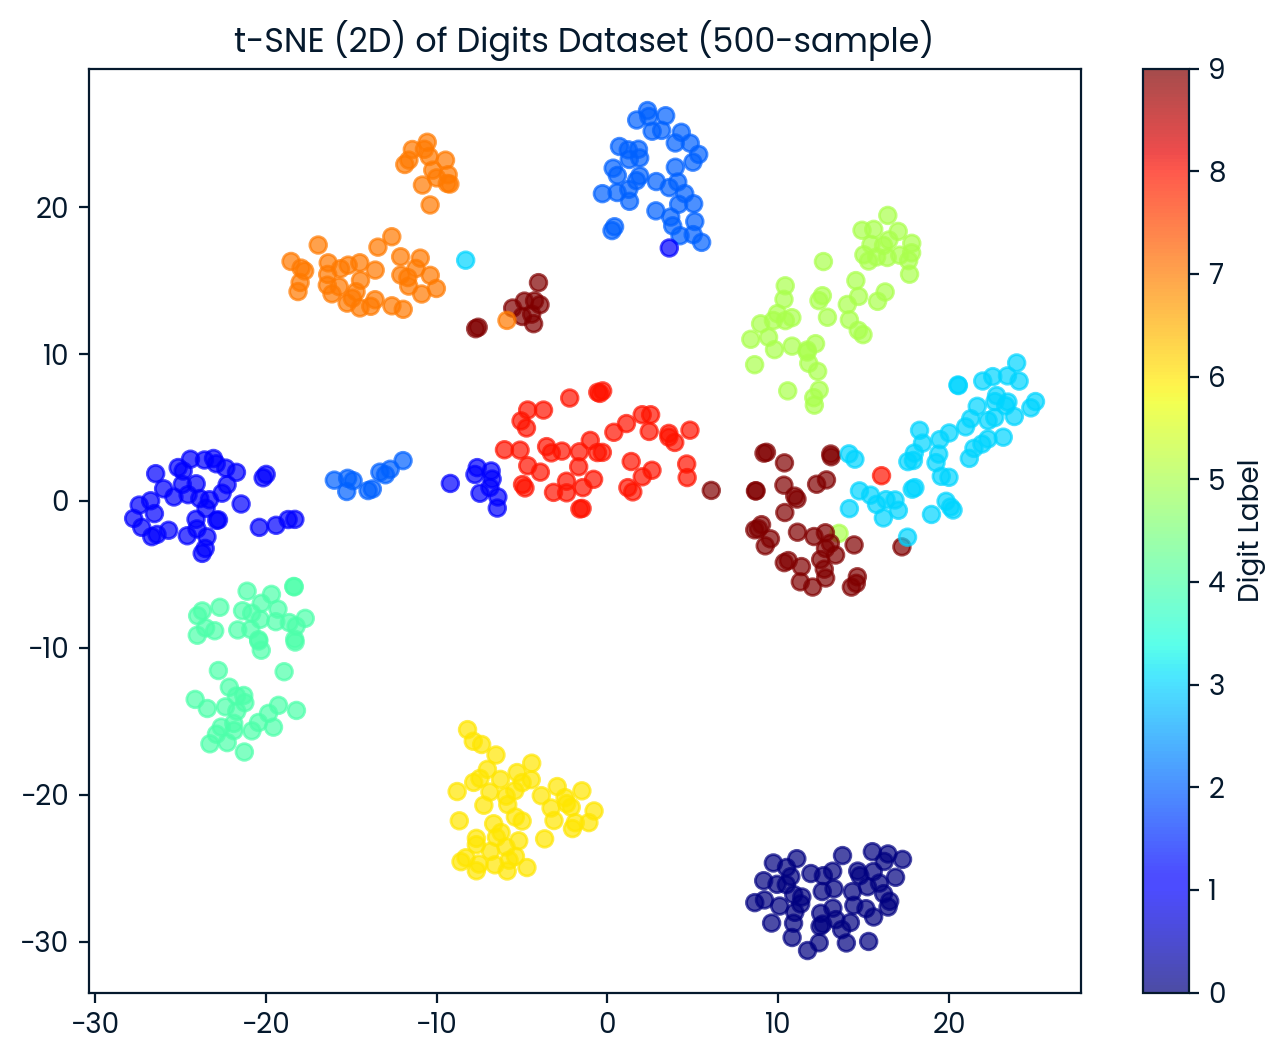
t-SNE result shape: (500, 2)Sekarang kita memvisualisasikan dataset t-SNE 2D. Setiap titik diberi warna berdasarkan label digitnya, memungkinkan kita mengamati seberapa baik t-SNE memisahkan berbagai kelas digit.
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_tsne[:, 0], X_tsne[:, 1],
                      c=y_sub, cmap='jet', alpha=0.7)
plt.colorbar(scatter, label='Digit Label')
plt.title('t-SNE (2D) of Digits Dataset (500-sample)')
plt.show()
t-SNE secara efektif memisahkan digit menjadi 10 kelompok berbeda, dengan beberapa tumpang tindih antar kelompok.
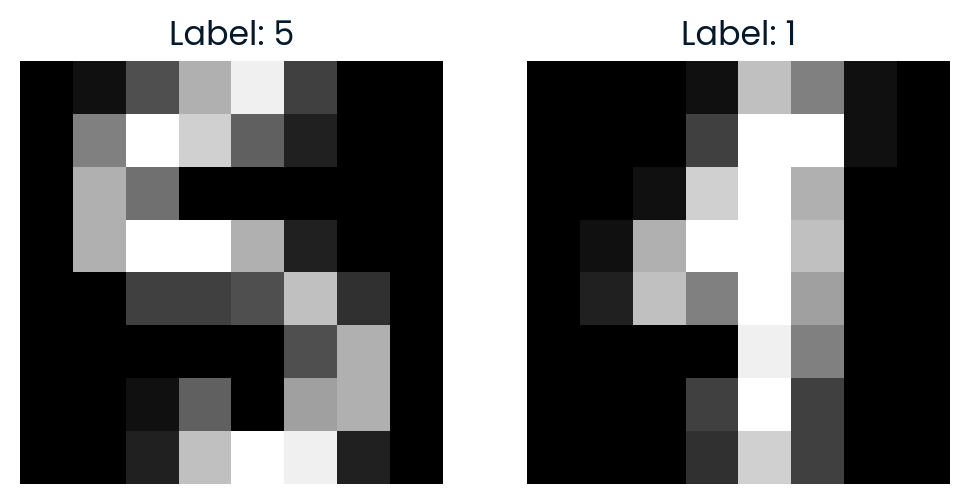
Untuk mengeksplorasi ruang t-SNE lebih jauh, kita memilih dua titik secara acak dan menghitung jarak Euclidean di antara keduanya dalam ruang t-SNE 2D. Kita juga akan memvisualisasikan gambarnya untuk melihat seberapa mirip keduanya.
import random

idx1, idx2 = random.sample(range(X_tsne.shape[0]), 2)

point1, point2 = X_tsne[idx1], X_tsne[idx2]
dist_tsne = np.linalg.norm(point1 - point2)

print(f"Comparing images #{idx1} and #{idx2}")
print(f"Distance in t-SNE space: {dist_tsne:.4f}")
print(f"Label of image #{idx1}: {y_sub[idx1]}")
print(f"Label of image #{idx2}: {y_sub[idx2]}")

# Plot the original images
fig, axes = plt.subplots(1, 2, figsize=(6, 3))
axes[0].imshow(X[idx1].reshape(8, 8), cmap='gray')
axes[0].set_title(f"Label: {y_sub[idx1]}")
axes[0].axis('off')

axes[1].imshow(X[idx2].reshape(8, 8), cmap='gray')
axes[1].set_title(f"Label: {y_sub[idx2]}")
axes[1].axis('off')

plt.show()
Jarak dalam ruang t-SNE mencerminkan seberapa tidak mirip dua gambar tersebut dalam representasi 2D yang direduksi.
Comparing images #291 and #90
Distance in t-SNE space: 35.7666
Label of image #291: 5
Label of image #90: 1
Jika Anda mengalami kesulitan menjalankan kode di atas, silakan cek ruang kerja DataLab untuk bantuan lebih lanjut.
Reduksi dimensi memainkan peran penting dalam aplikasi dunia nyata dengan meningkatkan efisiensi, akurasi, dan keterjelasan model pembelajaran mesin, sekaligus memungkinkan visualisasi dan analisis yang lebih baik terhadap dataset yang kompleks.
Dalam tutorial ini, kita telah membahas konsep reduksi dimensi, tujuannya, metodenya, dan jenis-jenisnya. Terakhir, kita telah mempelajari cara menggunakan teknik t-SNE untuk mentransformasikan data gambar ke ruang berdimensi lebih rendah untuk visualisasi dan analisis.
Ikuti kursus Reduksi Dimensi di Python untuk Memahami konsep mengurangi dimensi pada data Anda dan kuasai teknik-tekniknya di Python.
Kursus Teratas DataCamp
Kursus
Program
Program
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



