
Kursus
Bekerja dengan Llama 3
2 jam
15.7K
Sebelum kita mulai, sebuah catatan: saat membahas use case AI di layanan kesehatan, sangat penting untuk mewaspadai potensi dampak yang berbahaya bagi pasien. Contoh di bawah ini, meskipun komprehensif, semata-mata dimaksudkan untuk mengilustrasikan fine-tuning pada dataset dunia nyata. Jika Anda mengejar use case AI di layanan kesehatan atau domain sensitif lainnya, kami sangat merekomendasikan membaca panduan kami tentang Etika AI.
Dalam tutorial ini, kita akan mempelajari model Llama 3.1 dan melakukan fine-tune pada model Llama-3.1-8b-It untuk analisis sentimen pada dataset kesehatan mental. Tujuan kita adalah menyesuaikan model agar dapat memprediksi status kesehatan mental pasien berdasarkan teks. Kita juga akan menggabungkan adapter dengan model dasar dan menyimpan model lengkap di Hugging Face Hub.
Kita akan mempelajari model Llama 3.1, cara mengaksesnya di Kaggle, dan cara menggunakan pustaka Transformer untuk menjalankan inferensi model. Kita juga akan melakukan fine-tune pada model Llama-3.1-8b-It pada dataset klasifikasi kesehatan mental. Terakhir, kita akan menggabungkan adapter yang disimpan dengan model dasar dan mendorong model lengkap ke Hugging Face Hub.
Jika Anda baru dalam topik ini, Anda dapat mempelajari teori di balik fine-tuning dengan membaca artikel kami, Panduan Pengantar Fine-Tuning LLM.

Gambar oleh Penulis
Llama 3.1 adalah seri terbaru model bahasa besar multibahasa (LLM) yang dikembangkan oleh Meta AI, yang mendorong batas pemahaman dan generasi bahasa. Model ini hadir dalam tiga ukuran: 8B, 70B, dan 405B parameter.
Model Llama 3.1 dibangun di atas arsitektur model bahasa auto-regresif dengan transformer yang dioptimalkan dan dapat di-fine-tune untuk berbagai tugas dan dataset pemrosesan bahasa alami. Model ini dilatih pada beragam dataset data daring yang tersedia untuk umum, mendukung delapan bahasa (Inggris, Jerman, Prancis, Italia, Portugis, Hindi, Spanyol, dan Thai), dan hadir dengan panjang konteks 128k.
Model Llama 3.1 tersedia untuk semua orang di bawah lisensi komersial kustom dan memerlukan informasi minimal tentang individu untuk mengunduh bobot model.
Llama 3.1 dioptimalkan untuk dialog multibahasa dan melampaui Gemma 2, GPT 3.5 turbo, dan GPT-4o pada berbagai tolok ukur, termasuk obrolan umum, pengkodean, matematika, penalaran, dan lainnya. Ini adalah model open source tercepat dan paling akurat yang tersedia sejauh ini.
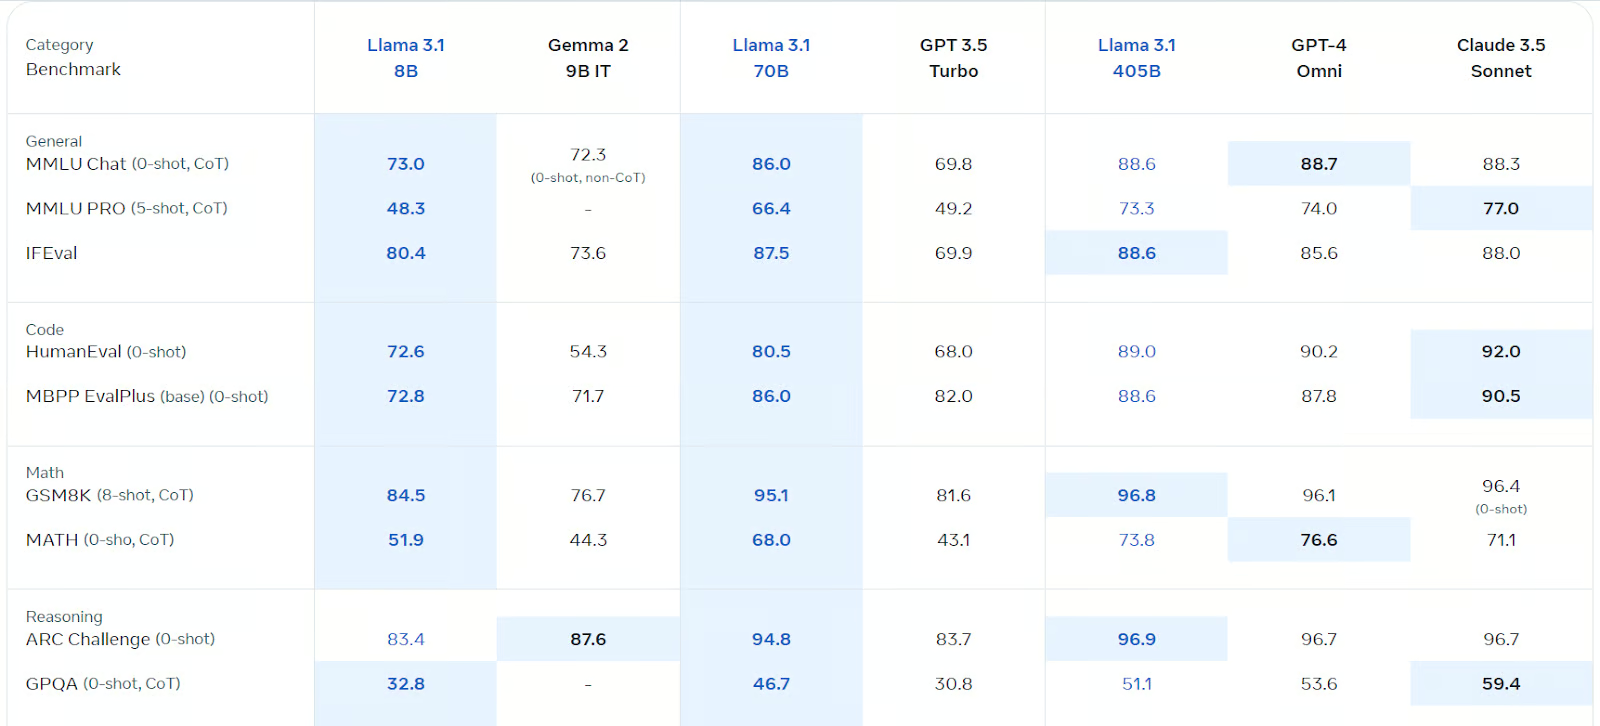
Sumber: Llama 3.1 (meta.com)
Anda dapat mempelajari lebih lanjut tentang model Llama 3.1 dengan membaca Apa Itu Llama 3.1 405B dari Meta? Cara Kerja, Use Case, dan Lainnya.
Untuk tutorial ini, kita akan menggunakan Kaggle Notebook sebagai lingkungan pengembangan karena menyediakan GPU dan TPU gratis. Untuk menggunakan model Llama 3.1 di Kaggle notebook, ikuti langkah-langkah berikut:
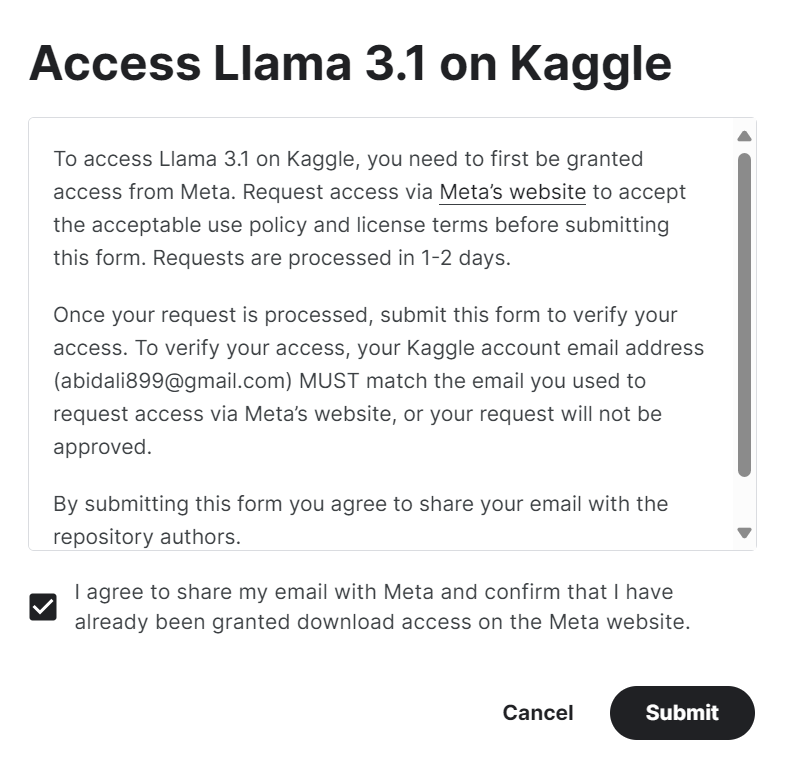
1. Isi formulir di meta.com dengan alamat email yang sama dengan akun Kaggle Anda.
2. Akses repositori model Meta | Llama 3.1 di Kaggle dan klik tombol "access the model". Terima semua syarat, dan setelah beberapa detik, Anda akan mendapat akses ke model.
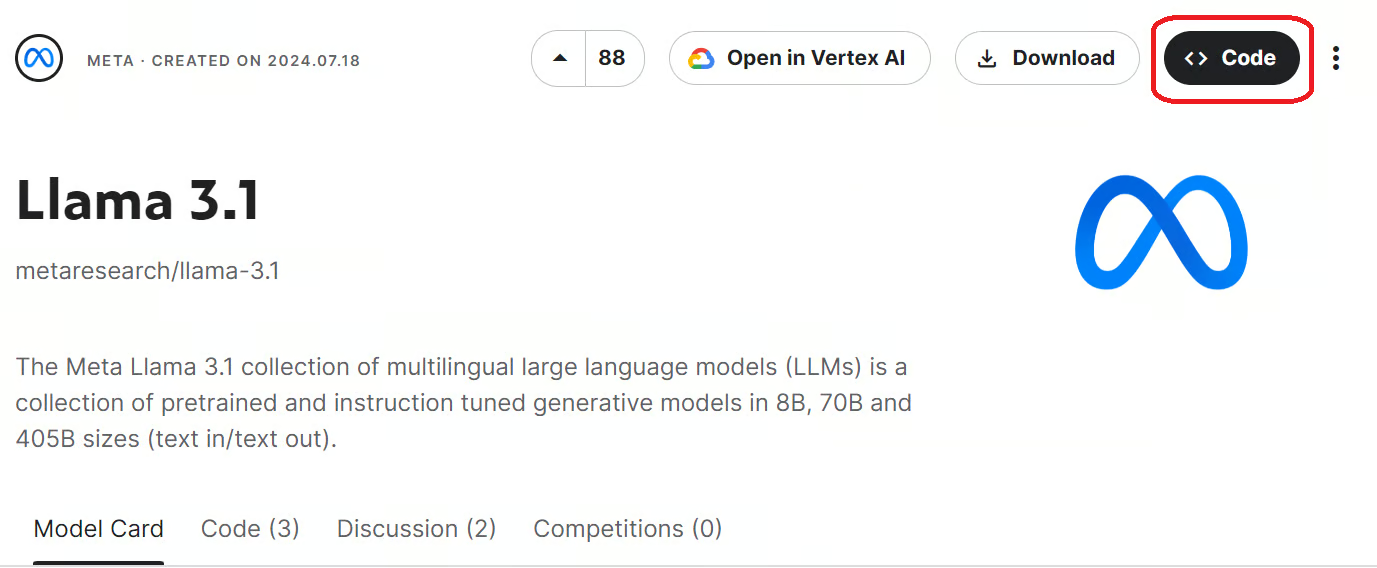
3. Mulai Kaggle notebook dengan model Llama 3.1 dengan mengklik tombol "Code" di kanan atas halaman model.
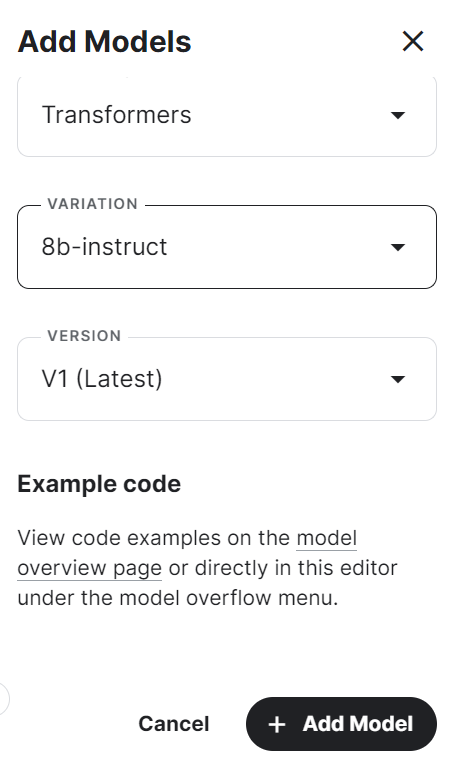
4. Pilih framework, variasi, dan versi, lalu tekan tombol "Add Model".
5. Instal paket Python yang diperlukan di Kaggle notebook menggunakan perintah berikut:
%pip install -U transformers accelerate6. Muat model dan tokenizer menggunakan pustaka Transformers dari direktori lokal.
7. Buat pipeline generasi teks dengan model, tokenizer, tipe torch, dan peta perangkat.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)
8. Tulis pesan dan ubah menjadi prompt yang sesuai menggunakan templat chat.
9. Jalankan pipeline menggunakan prompt dan cetak keluaran yang dihasilkan.
messages = [{"role": "user", "content": "What is the tallest building in the world?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Jawabannya akurat dan mendetail.
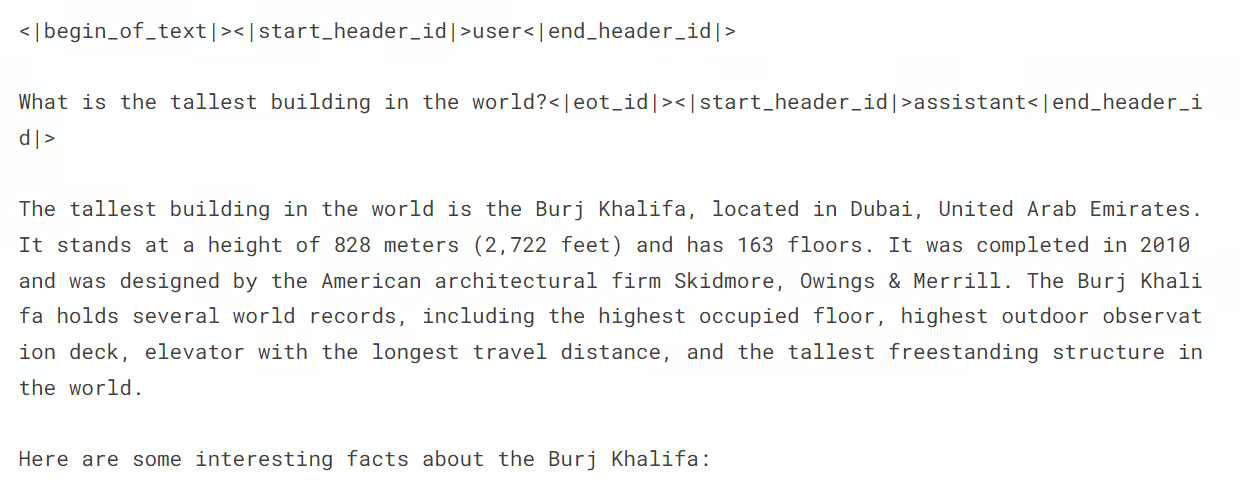
Jika Anda menemui kesulitan dalam menjalankan inferensi model, silakan merujuk ke Kaggle Notebook di Llama 3.1 Simple Model Inference.
Sekarang, kita harus memuat dataset, memprosesnya, dan melakukan fine-tune pada model Llama 3.1. Kita juga akan membandingkan kinerja model sebelum dan sesudah fine-tuning.
Jika Anda baru mengenal LLM, saya menyarankan Anda mengambil kursus Master Large Language Models (LLMs) Concepts sebelum masuk ke bagian fine-tuning pada tutorial ini.
Pertama, kita akan memulai Kaggle notebook baru dan model Llama 3.1 seperti pada bagian sebelumnya.
Kemudian kita akan memasang paket Python yang diperlukan seperti di bawah ini:
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
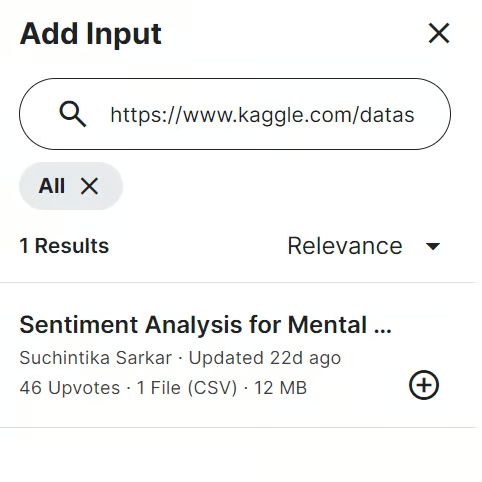
Selanjutnya, kita menambahkan data Sentiment Analysis for Mental Health ke Kaggle notebook. Untuk melakukannya, klik tombol “Add Input” di kanan atas dan tempel tautan model ke bilah pencarian. Lalu, untuk menambahkan model, cukup klik tombol plus (+).
Kita akan melacak kinerja model menggunakan API Weights and Biases. Untuk mengakses API, kita memerlukan kunci API. Atur kunci API di Kaggle menggunakan Secrets dan aktifkan, seperti di bawah ini.
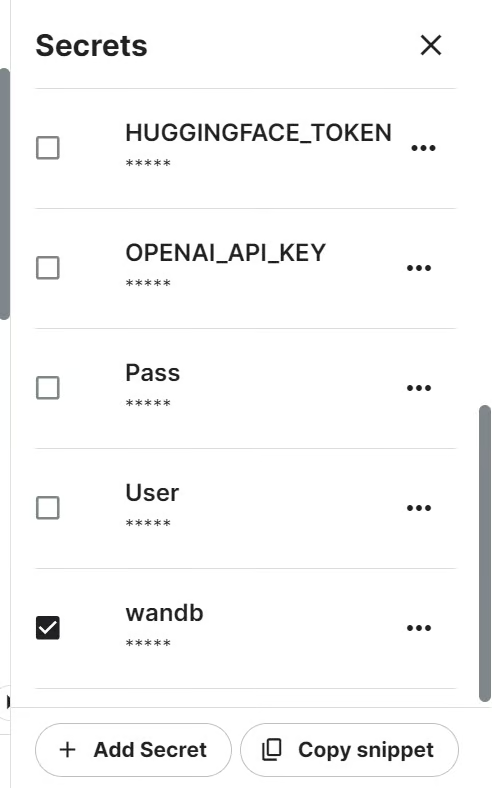
Kita kemudian dapat memulai proyek Weights and Biases menggunakan kunci API.
import wandb

from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

wb_token = user_secrets.get_secret("wandb")

wandb.login(key=wb_token)
run = wandb.init(
    project='Fine-tune llama-3.1-8b-it on Sentiment Analysis Dataset',
    job_type="training",
    anonymous="allow"
)
Berikutnya, kita perlu mengimpor semua paket dan fungsi Python yang diperlukan.
import numpy as np
import pandas as pd
import os
from tqdm import tqdm
import bitsandbytes as bnb
import torch
import torch.nn as nn
import transformers
from datasets import Dataset
from peft import LoraConfig, PeftConfig
from trl import SFTTrainer
from trl import setup_chat_format
from transformers import (AutoModelForCausalLM,
                          AutoTokenizer,
                          BitsAndBytesConfig,
                          TrainingArguments,
                          pipeline,
                          logging)
from sklearn.metrics import (accuracy_score,
                             classification_report,
                             confusion_matrix)
from sklearn.model_selection import train_test_splitSekarang saatnya kita memuat dataset, melakukan pembersihan data, dan menghapus tiga kategori yang ambigu.
Untuk menyederhanakan, kita akan menghapus kategori "Suicidal" karena Llama 3.1 memiliki mekanisme keamanan untuk mencegah kata-kata tertentu yang memicu. "Stress" tidak dianggap sebagai gangguan mental, dan "Personality Disorder" memiliki banyak tumpang tindih dengan "Bipolar Disorder."
Akibatnya, kita hanya akan menyisakan empat kategori: "Normal," "Depression," "Anxiety," dan "Bipolar."
df = pd.read_csv("/kaggle/input/sentiment-analysis-for-mental-health/Combined Data.csv",index_col = "Unnamed: 0")
df.loc[:,'status'] = df.loc[:,'status'].str.replace('Bi-Polar','Bipolar')
df = df[(df.status != "Personality disorder") & (df.status != "Stress") & (df.status != "Suicidal")]
df.head()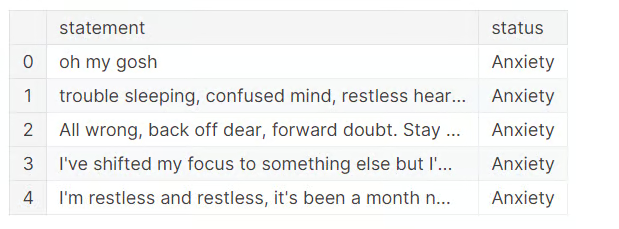
Untuk menghemat waktu pelatihan, kita akan melakukan fine-tune model hanya pada 3000 sampel. Untuk itu, kita akan mengacak dataset dan memilih 3000 baris.
Kemudian kita akan membagi dataset menjadi set train, eval, dan test untuk pelatihan dan pengujian model.
Kita juga ingin membuat kolom “text” di set train dan eval menggunakan fungsi generate_prompt, yang menggabungkan data dari kolom “statement” dan “status”.
Terakhir, kita akan membuat kolom “text” di set test menggunakan fungsi generate_test_prompt dan y_true menggunakan kolom “status”. Kita akan menggunakannya untuk menghasilkan laporan evaluasi model, seperti di bawah ini.
# Shuffle the DataFrame and select only 3000 rows
df = df.sample(frac=1, random_state=85).reset_index(drop=True).head(3000)

# Split the DataFrame
train_size = 0.8
eval_size = 0.1

# Calculate sizes
train_end = int(train_size * len(df))
eval_end = train_end + int(eval_size * len(df))

# Split the data
X_train = df[:train_end]
X_eval = df[train_end:eval_end]
X_test = df[eval_end:]

# Define the prompt generation functions
def generate_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: {data_point["status"]}""".strip()

def generate_test_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: """.strip()

# Generate prompts for training and evaluation data
X_train.loc[:,'text'] = X_train.apply(generate_prompt, axis=1)
X_eval.loc[:,'text'] = X_eval.apply(generate_prompt, axis=1)

# Generate test prompts and extract true labels
y_true = X_test.loc[:,'status']
X_test = pd.DataFrame(X_test.apply(generate_test_prompt, axis=1), columns=["text"])
Pada titik ini, kita ingin memeriksa distribusi kategori di set train.
X_train.status.value_counts()Anda dapat melihat di bawah bahwa kita memiliki distribusi yang hampir seimbang untuk kategori "Normal" dan "Depression". Sisanya adalah label minoritas. Ini berarti dataset kita tidak seimbang, dan model akan lebih baik dalam memprediksi label mayoritas dibandingkan label minoritas.
Kita bisa menyeimbangkan dataset, tetapi itu bukan tujuan tutorial ini.
status
Normal        1028
Depression     938
Anxiety        258
Bipolar        176
Name: count, dtype: int64
Selanjutnya, kita ingin mengonversi set train dan eval menjadi dataset Hugging Face.
# Convert to datasets
train_data = Dataset.from_pandas(X_train[["text"]])
eval_data = Dataset.from_pandas(X_eval[["text"]])
Lalu, kita tampilkan sampel ke-4 dari kolom “text”.
train_data['text'][3]Kita melihat bahwa kolom “text” memiliki system prompt, pernyataan, dan status sebagai label.
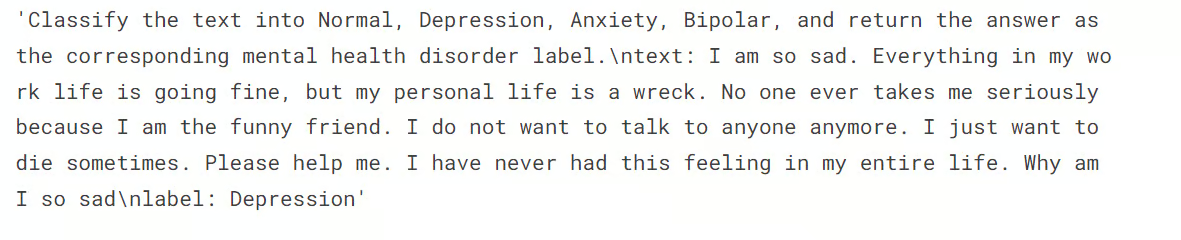
Berikutnya, kita ingin memuat model Llama-3.1-8b-instruct dalam kuantisasi 4-bit untuk menghemat memori GPU.
Kemudian kita akan memuat tokenizer dan menetapkan pad token id.
base_model_name = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype="float16",
)

model = AutoModelForCausalLM.from_pretrained(
    base_model_name,
    device_map="auto",
    torch_dtype="float16",
    quantization_config=bnb_config,
)

model.config.use_cache = False
model.config.pretraining_tp = 1

tokenizer = AutoTokenizer.from_pretrained(base_model_name)

tokenizer.pad_token_id = tokenizer.eos_token_idDi sini, kita membuat fungsi predict yang akan menggunakan pipeline generasi teks untuk memprediksi label dari kolom “text”. Menjalankan fungsi akan mengembalikan daftar kategori gangguan mental berdasarkan berbagai sampel di set pengujian.
def predict(test, model, tokenizer):
    y_pred = []
    categories = ["Normal", "Depression", "Anxiety", "Bipolar"]

    for i in tqdm(range(len(test))):
        prompt = test.iloc[i]["text"]
        pipe = pipeline(task="text-generation",
                        model=model,
                        tokenizer=tokenizer,
                        max_new_tokens=2,
                        temperature=0.1)

        result = pipe(prompt)
        answer = result[0]['generated_text'].split("label:")[-1].strip()

        # Determine the predicted category
        for category in categories:
            if category.lower() in answer.lower():
                y_pred.append(category)
                break
        else:
            y_pred.append("none")

    return y_pred

y_pred = predict(X_test, model, tokenizer)
100%|██████████| 300/300 [02:54<00:00, 1.72it/s]Setelah itu, kita membuat fungsi evaluate yang akan menggunakan label prediksi dan label sebenarnya untuk menghitung akurasi keseluruhan model dan akurasi per kategori, menghasilkan laporan klasifikasi, dan mencetak matriks kebingungan. Menjalankan fungsi akan memberikan ringkasan evaluasi model secara mendetail.
def evaluate(y_true, y_pred):
    labels = ["Normal", "Depression", "Anxiety", "Bipolar"]
    mapping = {label: idx for idx, label in enumerate(labels)}

    def map_func(x):
        return mapping.get(x, -1)  # Map to -1 if not found, but should not occur with correct data

    y_true_mapped = np.vectorize(map_func)(y_true)
    y_pred_mapped = np.vectorize(map_func)(y_pred)

    # Calculate accuracy
    accuracy = accuracy_score(y_true=y_true_mapped, y_pred=y_pred_mapped)
    print(f'Accuracy: {accuracy:.3f}')

    # Generate accuracy report
    unique_labels = set(y_true_mapped)  # Get unique labels

    for label in unique_labels:
        label_indices = [i for i in range(len(y_true_mapped)) if y_true_mapped[i] == label]
        label_y_true = [y_true_mapped[i] for i in label_indices]
        label_y_pred = [y_pred_mapped[i] for i in label_indices]
        label_accuracy = accuracy_score(label_y_true, label_y_pred)
        print(f'Accuracy for label {labels[label]}: {label_accuracy:.3f}')

    # Generate classification report
    class_report = classification_report(y_true=y_true_mapped, y_pred=y_pred_mapped, target_names=labels, labels=list(range(len(labels))))
    print('\nClassification Report:')
    print(class_report)

    # Generate confusion matrix
    conf_matrix = confusion_matrix(y_true=y_true_mapped, y_pred=y_pred_mapped, labels=list(range(len(labels))))
    print('\nConfusion Matrix:')
    print(conf_matrix)

evaluate(y_true, y_pred)
Llama 3.1 berkinerja sangat baik, bahkan tanpa fine-tuning. Akurasi 79% sudah cukup baik. Mari kita lihat bagaimana model kita meningkat saat kita melakukan fine-tune pada dataset.
Accuracy: 0.790
Accuracy for label Normal: 0.741
Accuracy for label Depression: 0.939
Accuracy for label Anxiety: 0.556
Accuracy for label Bipolar: 0.533

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.74      0.82       143
  Depression       0.70      0.94      0.80       115
     Anxiety       0.68      0.56      0.61        27
     Bipolar       0.89      0.53      0.67        15

    accuracy                           0.79       300
   macro avg       0.80      0.69      0.73       300
weighted avg       0.81      0.79      0.79       300


Confusion Matrix:
[[106  33   4   0]
 [  3 108   3   1]
 [  4   8  15   0]
[ 2 5 0 8]]Saat membangun model, kita mulai dengan mengekstrak nama modul linear dari model menggunakan pustaka bits and bytes.
Kemudian kita mengonfigurasi LoRA menggunakan modul target, jenis tugas, dan argumen lainnya sebelum menyiapkan argumen pelatihan. Argumen pelatihan ini dioptimalkan untuk Kaggle notebook. Anda mungkin perlu mengubahnya jika menggunakannya secara lokal.
Lalu kita akan membuat pelatih model menggunakan argumen pelatihan, model, tokenizer, konfigurasi LoRA, dan dataset.
import bitsandbytes as bnb

def find_all_linear_names(model):
    cls = bnb.nn.Linear4bit
    lora_module_names = set()
    for name, module in model.named_modules():
        if isinstance(module, cls):
            names = name.split('.')
            lora_module_names.add(names[0] if len(names) == 1 else names[-1])
    if 'lm_head' in lora_module_names:  # needed for 16 bit
        lora_module_names.remove('lm_head')
    return list(lora_module_names)
modules = find_all_linear_names(model)
modules
['down_proj', 'gate_proj', 'o_proj', 'v_proj', 'up_proj', 'q_proj', 'k_proj']output_dir="llama-3.1-fine-tuned-model"
peft_config = LoraConfig(
lora_alpha=16,
lora_dropout=0,
r=64,
bias="none",
task_type="CAUSAL_LM",
target_modules=modules,
)
training_arguments = TrainingArguments(
output_dir=output_dir, # directory to save and repository id
num_train_epochs=1, # number of training epochs
per_device_train_batch_size=1, # batch size per device during training
gradient_accumulation_steps=8, # number of steps before performing a backward/update pass
gradient_checkpointing=True, # use gradient checkpointing to save memory
optim="paged_adamw_32bit",
logging_steps=1,
learning_rate=2e-4, # learning rate, based on QLoRA paper
weight_decay=0.001,
fp16=True,
bf16=False,
max_grad_norm=0.3, # max gradient norm based on QLoRA paper
max_steps=-1,
warmup_ratio=0.03, # warmup ratio based on QLoRA paper
group_by_length=False,
lr_scheduler_type="cosine", # use cosine learning rate scheduler
report_to="wandb", # report metrics to w&b
eval_strategy="steps", # save checkpoint every epoch
eval_steps = 0.2
)
trainer = SFTTrainer(
model=model,
args=training_arguments,
train_dataset=train_data,
eval_dataset=eval_data,
peft_config=peft_config,
dataset_text_field="text",
tokenizer=tokenizer,
max_seq_length=512,
packing=False,
dataset_kwargs={
"add_special_tokens": False,
"append_concat_token": False,
}
)Sekarang saatnya memulai pelatihan model:
trainer.train()Diperlukan 1,5 jam untuk melakukan fine-tune model, dan validation loss kita menurun secara bertahap. Untuk kinerja yang lebih baik, coba latih model pada seluruh dataset setidaknya selama lima epoch.
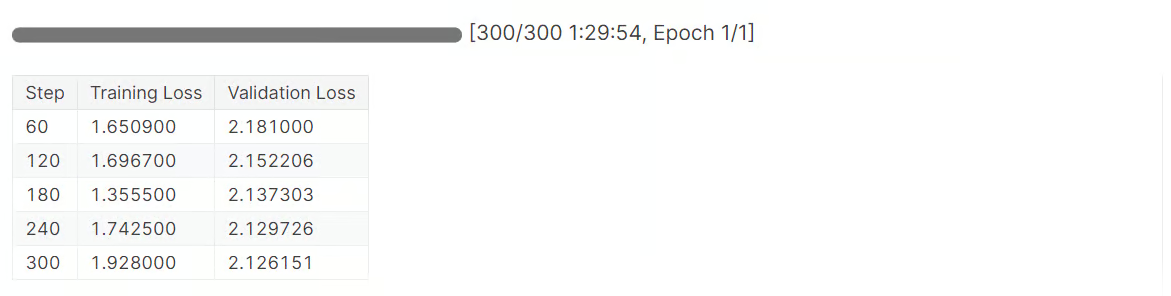
Selanjutnya, kita akhiri run weights and biases.
wandb.finish()
model.config.use_cache = True
Kita akan dapat melihat ringkasan run, termasuk semua metrik yang diperlukan untuk kinerja model.
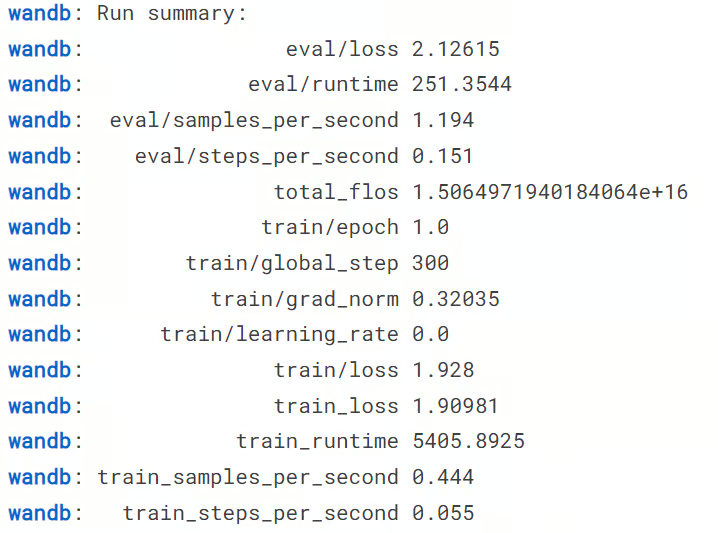
Untuk melihat ringkasan mendetail, buka akun Weights and Biases Anda dan lihat run di browser. Tersedia visualisasi interaktif.
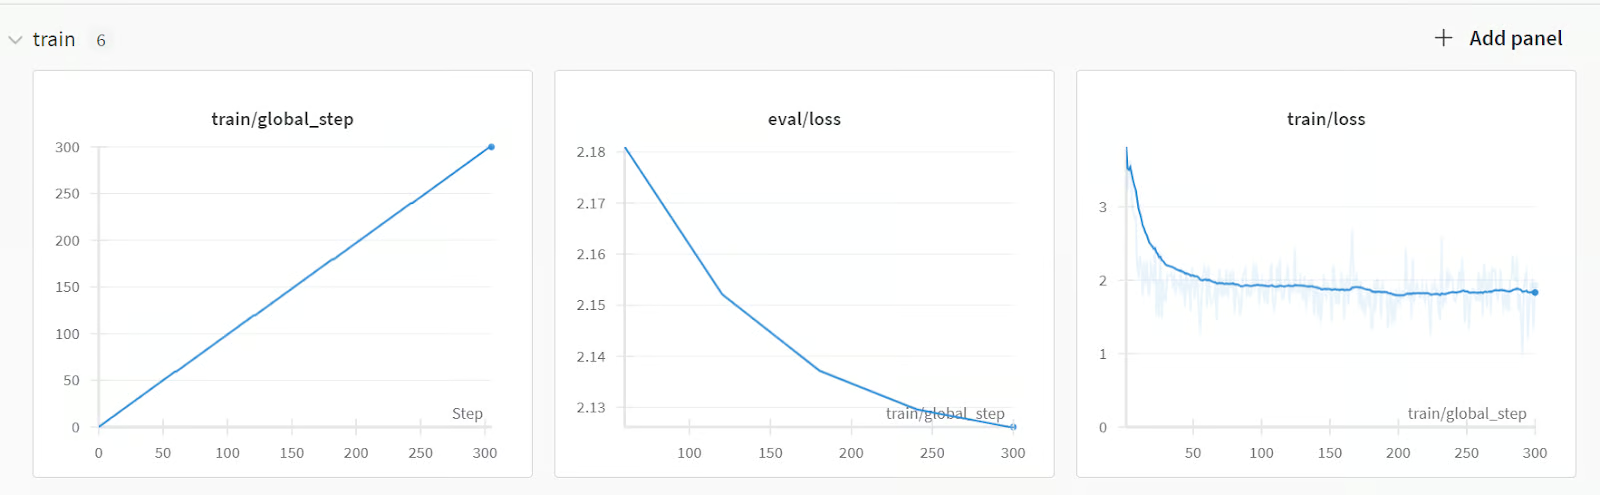
Kita kemudian dapat menyimpan adapter model dan tokenizer secara lokal. Pada bagian berikutnya, kita akan menggunakannya untuk menggabungkan adopter dengan model dasar.
# Save trained model and tokenizer
trainer.save_model(output_dir)
tokenizer.save_pretrained(output_dir)Sekarang tiba bagian yang paling krusial. Apakah model kita akan berkinerja lebih baik setelah di-fine-tune, atau malah menurun? Untuk mengetahuinya, kita harus menjalankan fungsi 'predict' pada set test dan kemudian fungsi 'evaluate' untuk menghasilkan laporan evaluasi model.
y_pred = predict(X_test, model, tokenizer)
evaluate(y_true, y_pred)
Seperti yang terlihat dari hasil di bawah, ini adalah peningkatan besar dalam kinerja model, dari 79% menjadi 91,3% akurasi. Bahkan skor F1 juga terlihat bagus.
100%|██████████| 300/300 [03:24<00:00,  1.47it/s]
Accuracy: 0.913
Accuracy for label Normal: 0.972
Accuracy for label Depression: 0.913
Accuracy for label Anxiety: 0.667
Accuracy for label Bipolar: 0.800

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.97      0.95       143
  Depression       0.93      0.91      0.92       115
     Anxiety       0.75      0.67      0.71        27
     Bipolar       1.00      0.80      0.89        15

    accuracy                           0.91       300
   macro avg       0.90      0.84      0.87       300
weighted avg       0.91      0.91      0.91       300


Confusion Matrix:
[[139   3   1   0]
 [  5 105   5   0]
 [  6   3  18   0]
 [  1   2   0  12]]
Sekarang kita dapat menyimpan Kaggle notebook untuk menyimpan hasil dan file model. Untuk itu, klik tombol “Save Version” di kanan atas, pilih tipe versi “Quick Save,” dan pilih tipe penyimpanan output “Always save output when creating a Quick Save.”
Jika Anda mengalami kendala saat melakukan fine-tuning model, silakan merujuk ke notebook Kaggle untuk bantuan lebih lanjut.
Anda juga dapat mempelajari cara melakukan fine-tune model Llama 3.0 dengan mengikuti panduan kami, Fine-Tuning Llama 3 dan Menggunakannya Secara Lokal.
Pada bagian ini, kita akan menggabungkan adapter dengan model dasar dan menyimpan versi lengkapnya di Hugging Face hub.
Pertama, kita meluncurkan Kaggle notebook baru dengan akselerasi GPU dan menambahkan notebook yang disimpan untuk mengakses file model. Kita juga dapat menyertakan Kaggle notebook lainnya sebagai input, mirip seperti menambahkan dataset.
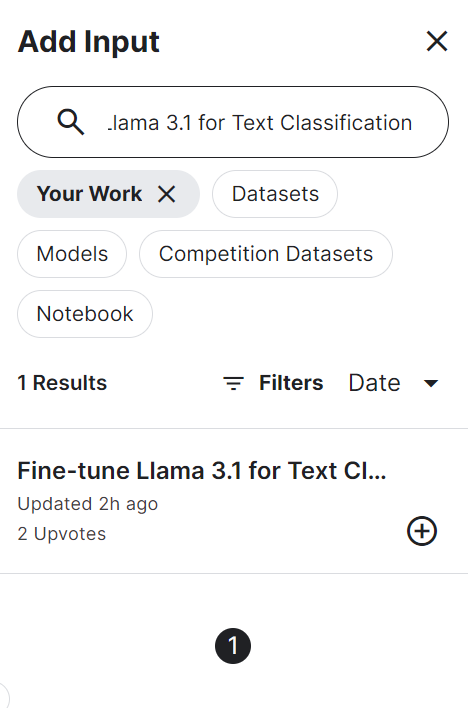
Kemudian kita dapat memasang paket Python yang diperlukan.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
Selanjutnya, kita masuk ke API Hugging Face hub menggunakan kunci API untuk mendorong file model kita ke repositori model Hugging Face.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
Kemudian kita tetapkan direktori model dasar dan model yang telah di-fine-tune.
base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"
fine_tuned_model = "/kaggle/input/fine-tune-llama-3-1-for-text-classification/llama-3.1-fine-tuned-model/"
Lalu, muat tokenizer dan model dasar.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)

base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
Kita menggabungkan model dasar dengan adapter yang di-fine-tune, seperti di bawah ini.
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, fine_tuned_model)
model = model.merge_and_unload()
Sebelum menyimpan model, mari periksa apakah model berfungsi dengan benar. Buat pipeline generasi teks dengan model dan tokenizer lalu berikan prompt contoh.
text = "I'm trapped in a storm of emotions that I can't control, and it feels like no one understands the chaos inside me"
prompt = f"""Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {text}
label: """.strip()

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=2, do_sample=True, temperature=0.1)
print(outputs[0]["generated_text"].split("label: ")[-1].strip())
Model kita berfungsi dengan sangat baik.
DepressionSekarang kita dapat menyimpan model dan tokenizer secara lokal.
model_dir = "Llama-3.1-8B-Instruct-Mental-Health-Classification"
model.save_pretrained(model_dir)
tokenizer.save_pretrained(model_dir)
Dan kemudian mendorong model dan tokenizer ke Hugging Face Hub.
model.push_to_hub(model_dir, use_temp_dir=False)
tokenizer.push_to_hub(model_dir, use_temp_dir=False)
Ini akan membuat repositori di Hugging Face dan mendorong semua file model dan tokenizer.
CommitInfo(commit_url='https://huggingface.co/kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification/commit/e1244abeaac159e0a48439095200a4190c2b493c', commit_message='Upload tokenizer', commit_description='', oid='e1244abeaac159e0a48439095200a4190c2b493c', pr_url=None, pr_revision=None, pr_num=None)Kita dapat melihat semua file model dengan mengunjungi situs web Hugging Face.
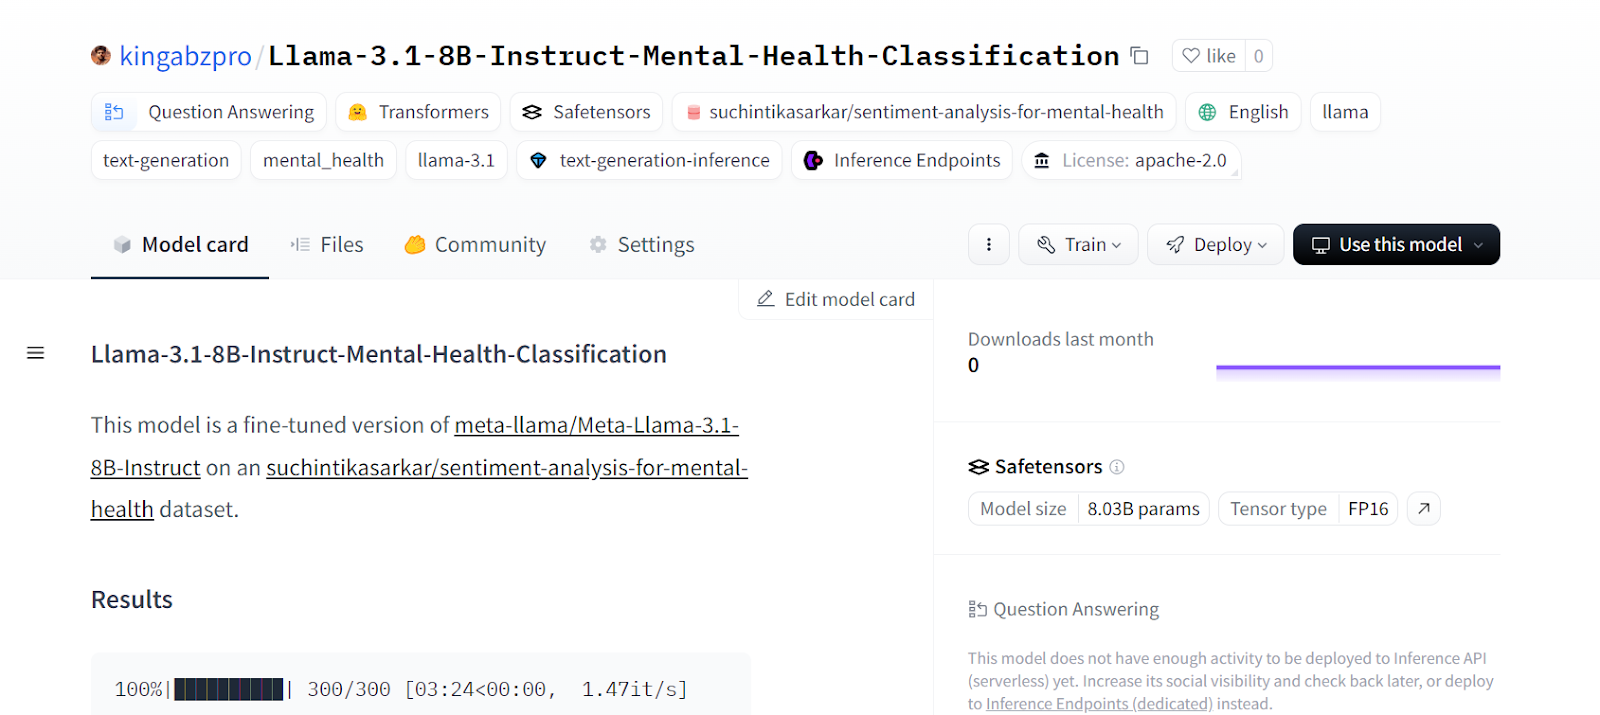
Sumber: kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification · Hugging Face
Jika Anda mengalami masalah saat menggabungkan adapter dengan model dasar, silakan merujuk ke Kaggle notebook.
Jika Anda merasa fine-tuning LLM itu sulit, Anda dapat mengikuti tutorial Fine-Tuning OpenAI's GPT-4: A Step-by-Step Guide untuk mempelajari cara yang lebih mudah menggunakan OpenAI API untuk melakukan fine-tune model pada dataset apa pun hanya dengan beberapa baris kode.
Fine-tuning model tidak terbatas pada kustomisasi berdasarkan dataset. Kita dapat melakukan fine-tune model bahasa besar pada berbagai tugas bahasa alami seperti penerjemahan mesin, pengelompokan, klasifikasi, tanya jawab, embedding, dan lainnya.
Dalam tutorial ini, kita telah mempelajari cara melakukan fine-tune model Llama 3.1 pada dataset klasifikasi kesehatan mental. Model ini dapat digunakan untuk mengidentifikasi pasien bahkan karyawan yang menghadapi tantangan dalam kehidupan sehari-hari mereka.
Jika Anda bertanya-tanya bagaimana cara memulai dengan LLM dan mulai melakukan fine-tune model sendiri, maka Anda harus mempertimbangkan untuk mengambil jalur keterampilan Developing Large Language Models. Dengan rangkaian kursus ini, Anda akan membangun fondasi yang kuat dalam LLM, mendorong Anda memasuki lanskap baru yang didukung AI.
Kursus LLM Terbaik di DataCamp
Kursus
Program
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt



