
Kurs
Llama 3 ile Çalışmak
2 sa
15.7K
Başlamadan önce kısa bir not: sağlık alanındaki yapay zeka kullanım senaryolarına yaklaşırken, hastalar için potansiyel olarak zararlı sonuçların farkında olmak son derece önemlidir. Aşağıdaki örnek, kapsamlı olsa da, yalnızca gerçek dünya veri kümesi üzerinde ince ayarlamayı göstermeyi amaçlamaktadır. Sağlık veya diğer hassas alanlarda yapay zekâ kullanım senaryoları peşindeyseniz, Yapay Zekâ Etiği rehberimizi okumanızı şiddetle tavsiye ederiz.
Bu eğitimde, Llama 3.1 modellerini tanıyacak ve Llama-3.1-8b-It modelini ruh sağlığı veri kümesi için duygu analizi üzerinde ince ayarlayacağız. Amacımız, metne dayanarak hastanın ruh sağlığı durumunu tahmin edebilecek şekilde modeli özelleştirmektir. Ayrıca adaptörü temel modelle birleştirip tam modeli Hugging Face hub’ına kaydedeceğiz.
Llama 3.1 modellerini, bunlara Kaggle üzerinden nasıl erişileceğini ve Transformer kütüphanesiyle model çıkarımının nasıl çalıştırılacağını öğreneceğiz. Ayrıca Llama-3.1-8b-It modelini ruh sağlığı sınıflandırma veri kümesi üzerinde ince ayarlayacağız. Son olarak, kaydedilen adaptörü temel modelle birleştirip tam modeli Hugging Face Hub’a göndereceğiz.
Konuya yeniyseniz, ince ayarlamanın arkasındaki teoriyi anlatan makalemizi okuyarak bilgi edinebilirsiniz: LLM’leri İnce Ayarlamaya Giriş Rehberi.

Görsel: Yazar
Llama 3.1, Meta AI tarafından geliştirilen çok dilli büyük dil modeli (LLM) serisinin en son sürümüdür ve dil anlama ile üretimi alanında sınırları zorlamaktadır. Üç boyutta sunulur: 8B, 70B ve 405B parametre.
Llama 3.1 modelleri, optimize edilmiş transformer’lara sahip otoregresif dil modeli mimarisi üzerine kuruludur ve çeşitli doğal dil işleme görevleri ile veri kümeleri için ince ayar yapılabilir. Kamusal olarak erişilebilir çevrimiçi verilerden oluşan çeşitli bir veri kümesi üzerinde eğitilmişlerdir, sekiz dili (İngilizce, Almanca, Fransızca, İtalyanca, Portekizce, Hintçe, İspanyolca ve Tayca) desteklerler ve 128k bağlam uzunluğuna sahiptirler.
Llama 3.1 modelleri, özel ticari lisanslar kapsamında herkesin kullanımına sunulmuştur ve model ağırlıklarını indirmek için birey hakkında asgari bilgi gerektirir.
Llama 3.1, çok dilli diyalog için optimize edilmiştir ve genel sohbet, kodlama, matematik, akıl yürütme ve daha fazlasını içeren çeşitli kıyaslamalarda Gemma 2, GPT 3.5 turbo ve GPT-4o’yu geride bırakmıştır. Şu anda açık kaynak dünyasında en hızlı ve en doğru modeldir.
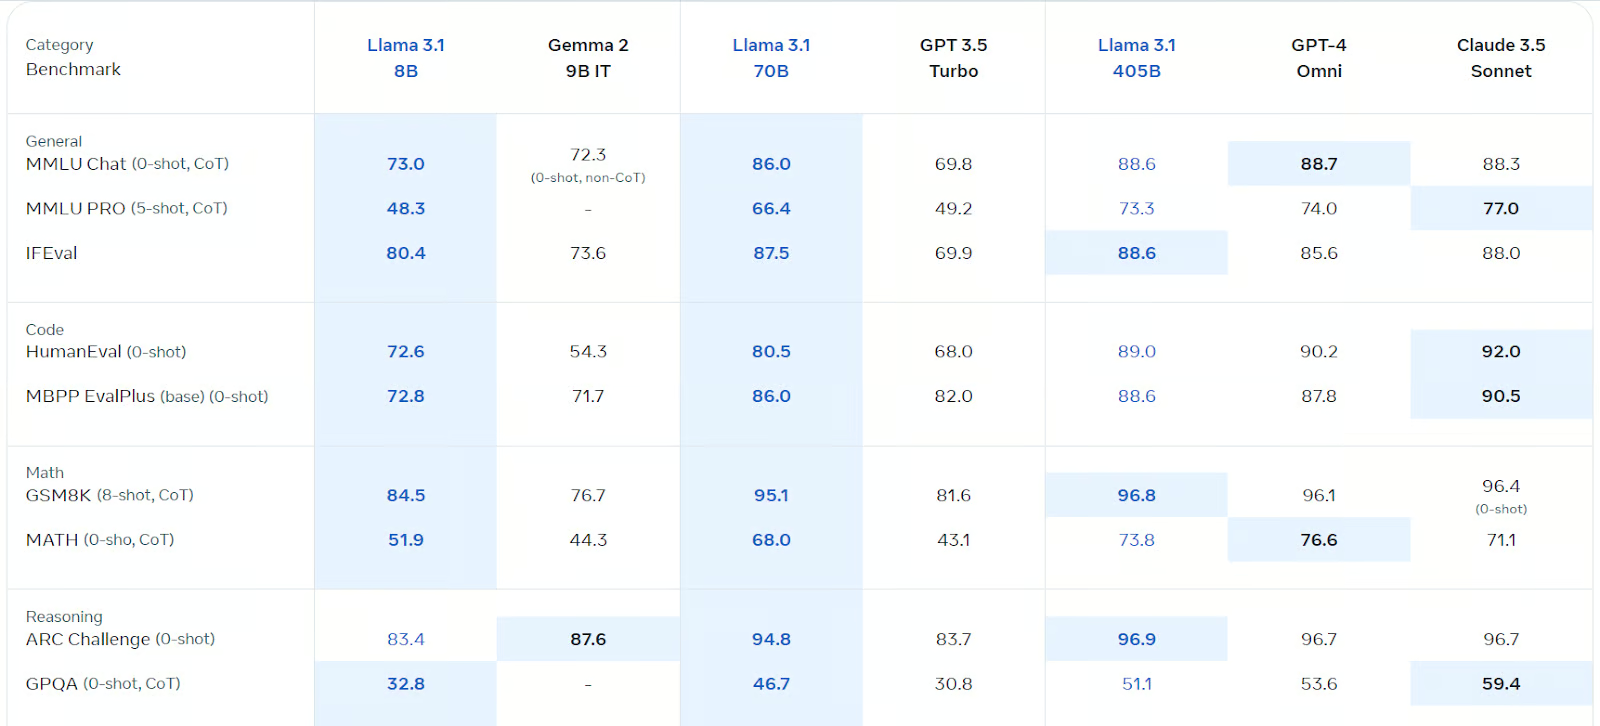
Kaynak: Llama 3.1 (meta.com)
Llama 3.1 modeli hakkında daha fazla bilgiyi şu yazımızdan edinebilirsiniz: Meta’nın Llama 3.1 405B’si Nedir? Nasıl Çalışır, Kullanım Alanları ve Daha Fazlası.
Bu eğitim için geliştirici ortamı olarak Kaggle Notebook kullanacağız; çünkü ücretsiz GPU ve TPU sunuyor. Kaggle notebook’ta Llama 3.1 modelini kullanmak için şu adımları izleyin:
1. meta.com üzerindeki formu Kaggle hesabınızla aynı e-posta adresini kullanarak doldurun.
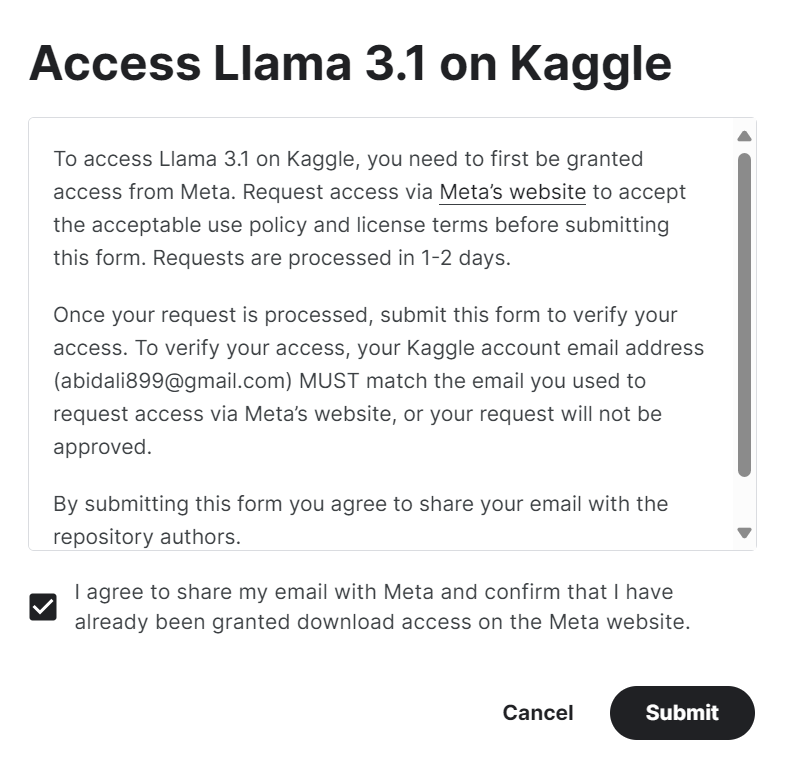
2. Kaggle’da Meta | Llama 3.1 model deposuna erişin ve "access the model" düğmesine tıklayın. Tüm koşulları kabul edin; birkaç saniye sonra modele erişim kazanacaksınız.
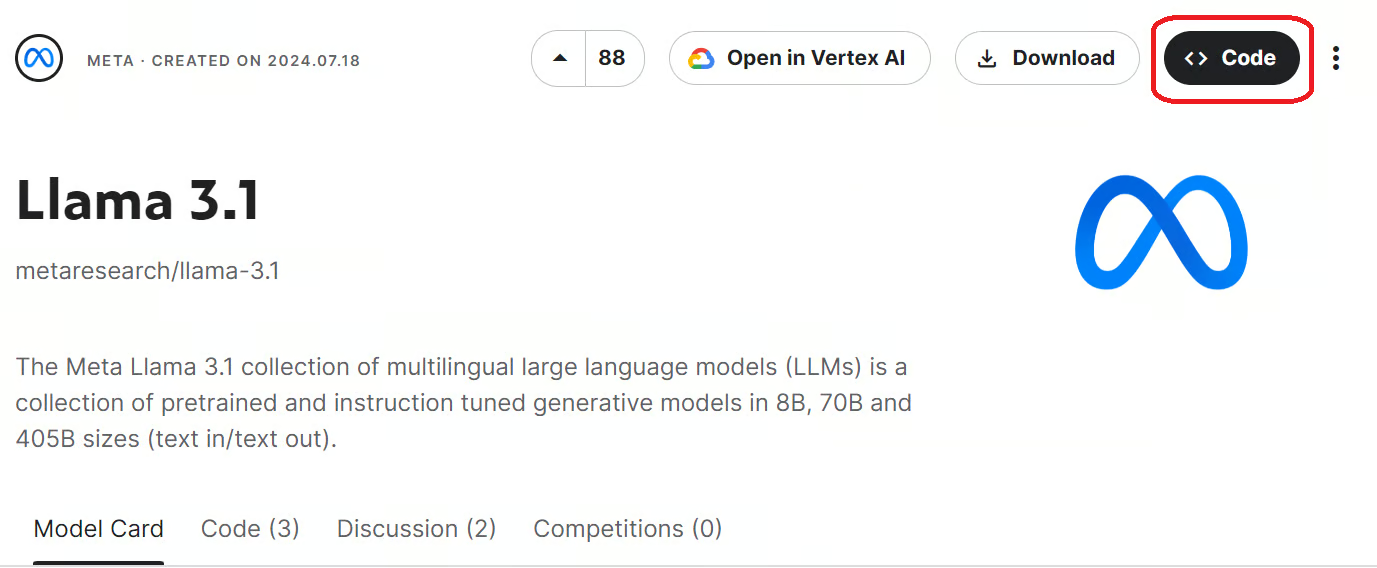
3. Model sayfasının sağ üst kısmındaki "Code" düğmesine tıklayarak Llama 3.1 modelleriyle Kaggle notebook’unu başlatın.
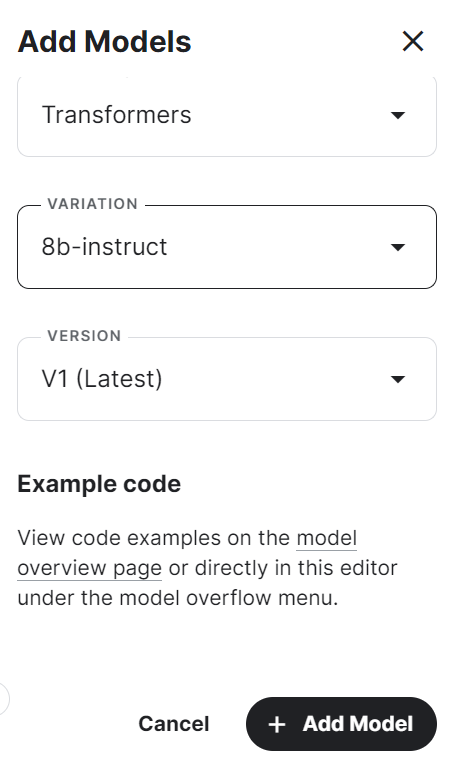
4. Çatıyı, varyantı ve sürümü seçin ve "Add Model" düğmesine basın.
5. Kaggle notebook’ta gerekli Python paketlerini aşağıdaki komutla kurun:
%pip install -U transformers accelerate6. Transformers kütüphanesini kullanarak modeli ve belirteçleyiciyi yerel dizinden yükleyin.
7. Model, belirteçleyici, torch türü ve aygıt eşlemesiyle metin üretim hattını oluşturun.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)
8. Mesajı yazın ve sohbet şablonunu kullanarak uygun bir isteme dönüştürün.
9. İstemi kullanarak hattı çalıştırın ve üretilen çıktıyı yazdırın.
messages = [{"role": "user", "content": "What is the tallest building in the world?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Yanıt doğru ve ayrıntılı.
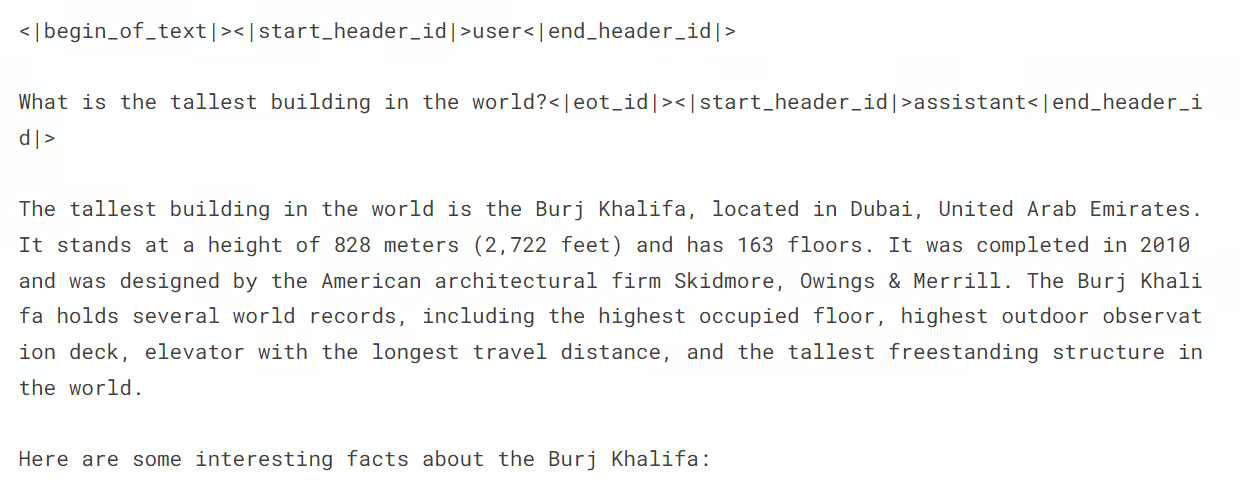
Model çıkarımını çalıştırırken zorluk yaşarsanız, Llama 3.1 Basit Model Çıkarımı başlıklı Kaggle Notebook’a bakın.
Şimdi veri kümesini yüklememiz, işlemesi ve Llama 3.1 modelini ince ayarlamamız gerekiyor. Ayrıca modelin ince ayarlama öncesi ve sonrası performansını karşılaştıracağız.
LLM’lere yeniyseniz, öğreticinin ince ayar kısmına geçmeden önce LLM Kavramlarında Ustalaşın kursunu almanızı öneririm.
Önce, önceki bölümde yaptığımız gibi yeni bir Kaggle notebook’u ve Llama 3.1 modelini başlatacağız.
Ardından gerekli Python paketlerini aşağıda belirtildiği gibi kuracağız:
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
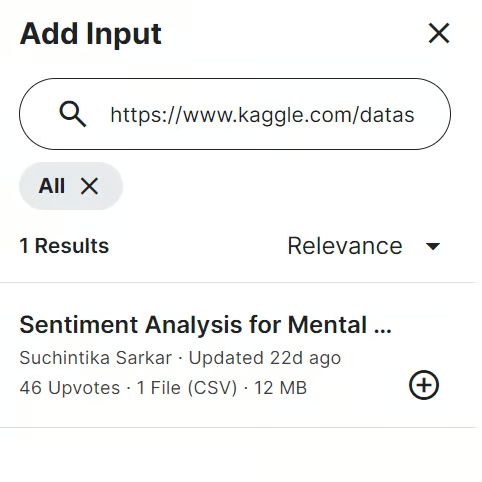
Sonraki adımda Ruh Sağlığı için Duygu Analizi verisini Kaggle notebook’una ekliyoruz. Bunu yapmak için sağ üstteki “Add Input” düğmesine tıklayın ve model bağlantısını arama çubuğuna yapıştırın. Ardından modeli eklemek için artı (+) düğmesine tıklamanız yeterlidir.
Modelin performansını Weights and Biases API’siyle takip edeceğiz. API’ye erişmek için API anahtarına ihtiyacımız var. Kaggle’da Secrets kullanarak API anahtarını ayarlayın ve aşağıda gösterildiği gibi etkinleştirin.
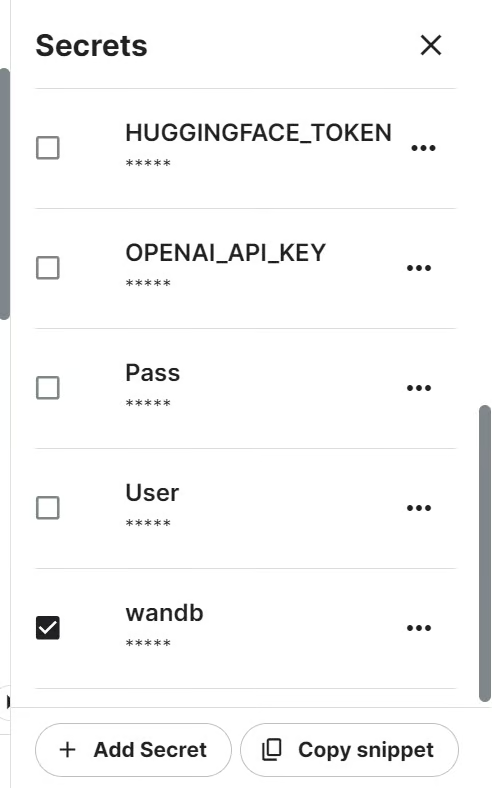
Ardından API anahtarını kullanarak Weights and Biases projesini başlatabiliriz.
import wandb

from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

wb_token = user_secrets.get_secret("wandb")

wandb.login(key=wb_token)
run = wandb.init(
    project='Fine-tune llama-3.1-8b-it on Sentiment Analysis Dataset',
    job_type="training",
    anonymous="allow"
)
Sonraki adımda gerekli tüm Python paket ve fonksiyonlarını içe aktarmamız gerekiyor.
import numpy as np
import pandas as pd
import os
from tqdm import tqdm
import bitsandbytes as bnb
import torch
import torch.nn as nn
import transformers
from datasets import Dataset
from peft import LoraConfig, PeftConfig
from trl import SFTTrainer
from trl import setup_chat_format
from transformers import (AutoModelForCausalLM,
                          AutoTokenizer,
                          BitsAndBytesConfig,
                          TrainingArguments,
                          pipeline,
                          logging)
from sklearn.metrics import (accuracy_score,
                             classification_report,
                             confusion_matrix)
from sklearn.model_selection import train_test_splitŞimdi veri kümesini yükleme, veri temizliği yapma ve üç belirsiz kategoriyi kaldırma zamanı.
İşleri basitleştirmek için "Suicidal" kategorisini kaldıracağız; çünkü Llama 3.1 belirli tetikleyici kelimeleri engelleyen güvenlik mekanizmalarına sahiptir. "Stress" bir ruh sağlığı bozukluğu olarak kabul edilmez ve "Personality Disorder" ile "Bipolar Disorder" arasında ciddi örtüşmeler vardır.
Sonuç olarak elimizde yalnızca dört kategori kalacak: "Normal", "Depression", "Anxiety" ve "Bipolar".
df = pd.read_csv("/kaggle/input/sentiment-analysis-for-mental-health/Combined Data.csv",index_col = "Unnamed: 0")
df.loc[:,'status'] = df.loc[:,'status'].str.replace('Bi-Polar','Bipolar')
df = df[(df.status != "Personality disorder") & (df.status != "Stress") & (df.status != "Suicidal")]
df.head()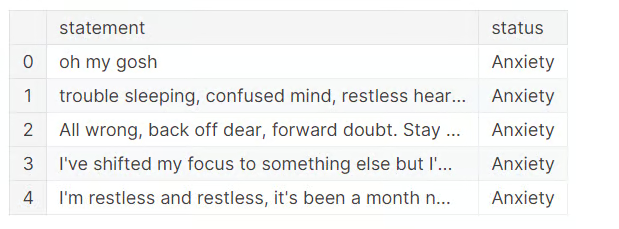
Eğitim süresini kısaltmak için modeli yalnızca 3000 örnek üzerinde ince ayarlayacağız. Bunun için veri kümesini karıştırıp 3000 satır seçeceğiz.
Ardından veri kümesini model eğitimi ve testleri için train, eval ve test kümelerine böleceğiz.
Ayrıca train ve eval kümelerinde "statement" ve "status" sütunlarındaki verileri birleştiren generate_prompt fonksiyonunu kullanarak "text" sütunu oluşturmak istiyoruz.
Son olarak test kümesinde generate_test_prompt fonksiyonunu kullanarak "text" sütununu ve "status" sütunundan y_true değerini oluşturacağız. Bunu aşağıda gösterildiği gibi model değerlendirme raporunu üretmek için kullanacağız.
# Shuffle the DataFrame and select only 3000 rows
df = df.sample(frac=1, random_state=85).reset_index(drop=True).head(3000)

# Split the DataFrame
train_size = 0.8
eval_size = 0.1

# Calculate sizes
train_end = int(train_size * len(df))
eval_end = train_end + int(eval_size * len(df))

# Split the data
X_train = df[:train_end]
X_eval = df[train_end:eval_end]
X_test = df[eval_end:]

# Define the prompt generation functions
def generate_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: {data_point["status"]}""".strip()

def generate_test_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: """.strip()

# Generate prompts for training and evaluation data
X_train.loc[:,'text'] = X_train.apply(generate_prompt, axis=1)
X_eval.loc[:,'text'] = X_eval.apply(generate_prompt, axis=1)

# Generate test prompts and extract true labels
y_true = X_test.loc[:,'status']
X_test = pd.DataFrame(X_test.apply(generate_test_prompt, axis=1), columns=["text"])
Bu noktada, train kümesindeki kategorilerin dağılımını kontrol etmek istiyoruz.
X_train.status.value_counts()Aşağıda görebileceğiniz gibi, "Normal" ve "Depression" kategorileri neredeyse eşit dağılmış. Diğer etiketler azınlıkta. Bu, veri kümemizin dengesiz olduğu ve modelin azınlık etiketlere kıyasla çoğunluk etiketleri daha iyi tahmin edeceği anlamına gelir.
Veri kümesini dengeleyebiliriz; ancak bu, bu eğitimin hedefi değildir.
status
Normal        1028
Depression     938
Anxiety        258
Bipolar        176
Name: count, dtype: int64
Sırada train ve eval kümelerini Hugging Face veri kümelerine dönüştürmek var.
# Convert to datasets
train_data = Dataset.from_pandas(X_train[["text"]])
eval_data = Dataset.from_pandas(X_eval[["text"]])
Ardından “text” sütunundan 4. örneği görüntülüyoruz.
train_data['text'][3]“text” sütununun bir sistem istemi, ifade ve etiket olarak durumları içerdiğini görüyoruz.
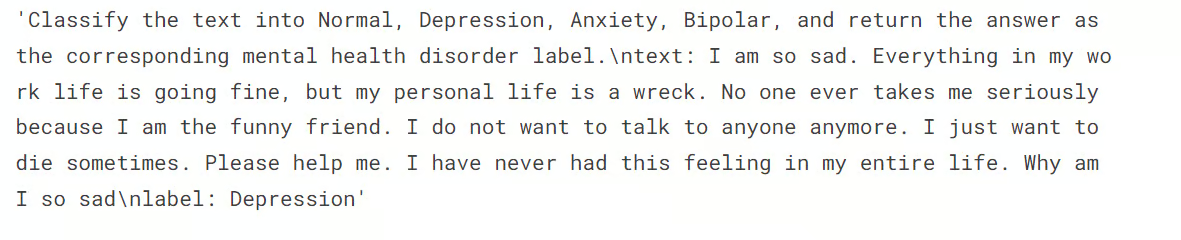
Sonraki adımda, GPU belleğinden tasarruf etmek için Llama-3.1-8b-instruct modelini 4 bit kuantizasyon ile yüklemek istiyoruz.
Ardından belirteçleyiciyi yükleyip pad token kimliğini ayarlayacağız.
base_model_name = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype="float16",
)

model = AutoModelForCausalLM.from_pretrained(
    base_model_name,
    device_map="auto",
    torch_dtype="float16",
    quantization_config=bnb_config,
)

model.config.use_cache = False
model.config.pretraining_tp = 1

tokenizer = AutoTokenizer.from_pretrained(base_model_name)

tokenizer.pad_token_id = tokenizer.eos_token_idpredict fonksiyonunu oluşturuyoruz; bu fonksiyon metin üretim hattını kullanarak “text” sütunundan etiketleri tahmin edecek. Fonksiyonu çalıştırmak, test kümesindeki çeşitli örnekler için ruh sağlığı kategorilerinin bir listesini döndürecektir.
def predict(test, model, tokenizer):
    y_pred = []
    categories = ["Normal", "Depression", "Anxiety", "Bipolar"]

    for i in tqdm(range(len(test))):
        prompt = test.iloc[i]["text"]
        pipe = pipeline(task="text-generation",
                        model=model,
                        tokenizer=tokenizer,
                        max_new_tokens=2,
                        temperature=0.1)

        result = pipe(prompt)
        answer = result[0]['generated_text'].split("label:")[-1].strip()

        # Determine the predicted category
        for category in categories:
            if category.lower() in answer.lower():
                y_pred.append(category)
                break
        else:
            y_pred.append("none")

    return y_pred

y_pred = predict(X_test, model, tokenizer)
100%|██████████| 300/300 [02:54<00:00, 1.72it/s]Ardından, tahmin edilen etiketler ile gerçek etiketleri kullanarak modelin genel doğruluğunu ve kategori başına doğruluğu hesaplayacak, bir sınıflandırma raporu üretecek ve bir karışıklık matrisi yazdıracak evaluate fonksiyonunu oluşturuyoruz. Fonksiyonu çalıştırmak, ayrıntılı bir model değerlendirme özeti verecektir.
def evaluate(y_true, y_pred):
    labels = ["Normal", "Depression", "Anxiety", "Bipolar"]
    mapping = {label: idx for idx, label in enumerate(labels)}

    def map_func(x):
        return mapping.get(x, -1)  # Map to -1 if not found, but should not occur with correct data

    y_true_mapped = np.vectorize(map_func)(y_true)
    y_pred_mapped = np.vectorize(map_func)(y_pred)

    # Calculate accuracy
    accuracy = accuracy_score(y_true=y_true_mapped, y_pred=y_pred_mapped)
    print(f'Accuracy: {accuracy:.3f}')

    # Generate accuracy report
    unique_labels = set(y_true_mapped)  # Get unique labels

    for label in unique_labels:
        label_indices = [i for i in range(len(y_true_mapped)) if y_true_mapped[i] == label]
        label_y_true = [y_true_mapped[i] for i in label_indices]
        label_y_pred = [y_pred_mapped[i] for i in label_indices]
        label_accuracy = accuracy_score(label_y_true, label_y_pred)
        print(f'Accuracy for label {labels[label]}: {label_accuracy:.3f}')

    # Generate classification report
    class_report = classification_report(y_true=y_true_mapped, y_pred=y_pred_mapped, target_names=labels, labels=list(range(len(labels))))
    print('\nClassification Report:')
    print(class_report)

    # Generate confusion matrix
    conf_matrix = confusion_matrix(y_true=y_true_mapped, y_pred=y_pred_mapped, labels=list(range(len(labels))))
    print('\nConfusion Matrix:')
    print(conf_matrix)

evaluate(y_true, y_pred)
Llama 3.1, ince ayar yapılmadan da olağanüstü bir performans gösterdi. %79 doğruluk oldukça iyi. Modeli veri kümesi üzerinde ince ayarladığımızda nasıl iyileştiğine bakalım.
Accuracy: 0.790
Accuracy for label Normal: 0.741
Accuracy for label Depression: 0.939
Accuracy for label Anxiety: 0.556
Accuracy for label Bipolar: 0.533

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.74      0.82       143
  Depression       0.70      0.94      0.80       115
     Anxiety       0.68      0.56      0.61        27
     Bipolar       0.89      0.53      0.67        15

    accuracy                           0.79       300
   macro avg       0.80      0.69      0.73       300
weighted avg       0.81      0.79      0.79       300


Confusion Matrix:
[[106  33   4   0]
 [  3 108   3   1]
 [  4   8  15   0]
[ 2 5 0 8]]Modeli oluştururken, bits and bytes kütüphanesini kullanarak modelden doğrusal modül adlarını çıkarmakla başlıyoruz.
Ardından hedef modüller, görev türü ve diğer argümanlarla LoRA’yı yapılandırıp eğitim argümanlarını ayarlıyoruz. Bu eğitim argümanları Kaggle notebook’u için optimize edilmiştir. Yerelde kullanıyorsanız değiştirmeniz gerekebilir.
Daha sonra eğitim argümanları, bir model, belirteçleyici, LoRA yapılandırması ve veri kümesiyle model eğiticisini oluşturacağız.
import bitsandbytes as bnb

def find_all_linear_names(model):
    cls = bnb.nn.Linear4bit
    lora_module_names = set()
    for name, module in model.named_modules():
        if isinstance(module, cls):
            names = name.split('.')
            lora_module_names.add(names[0] if len(names) == 1 else names[-1])
    if 'lm_head' in lora_module_names:  # needed for 16 bit
        lora_module_names.remove('lm_head')
    return list(lora_module_names)
modules = find_all_linear_names(model)
modules
['down_proj', 'gate_proj', 'o_proj', 'v_proj', 'up_proj', 'q_proj', 'k_proj']output_dir="llama-3.1-fine-tuned-model"
peft_config = LoraConfig(
lora_alpha=16,
lora_dropout=0,
r=64,
bias="none",
task_type="CAUSAL_LM",
target_modules=modules,
)
training_arguments = TrainingArguments(
output_dir=output_dir, # directory to save and repository id
num_train_epochs=1, # number of training epochs
per_device_train_batch_size=1, # batch size per device during training
gradient_accumulation_steps=8, # number of steps before performing a backward/update pass
gradient_checkpointing=True, # use gradient checkpointing to save memory
optim="paged_adamw_32bit",
logging_steps=1,
learning_rate=2e-4, # learning rate, based on QLoRA paper
weight_decay=0.001,
fp16=True,
bf16=False,
max_grad_norm=0.3, # max gradient norm based on QLoRA paper
max_steps=-1,
warmup_ratio=0.03, # warmup ratio based on QLoRA paper
group_by_length=False,
lr_scheduler_type="cosine", # use cosine learning rate scheduler
report_to="wandb", # report metrics to w&b
eval_strategy="steps", # save checkpoint every epoch
eval_steps = 0.2
)
trainer = SFTTrainer(
model=model,
args=training_arguments,
train_dataset=train_data,
eval_dataset=eval_data,
peft_config=peft_config,
dataset_text_field="text",
tokenizer=tokenizer,
max_seq_length=512,
packing=False,
dataset_kwargs={
"add_special_tokens": False,
"append_concat_token": False,
}
)Şimdi model eğitimini başlatma zamanı:
trainer.train()Modeli ince ayarlamak 1,5 saat sürdü ve doğrulama kaybımız kademeli olarak azaldı. Daha iyi performans için modeli tam veri kümesi üzerinde en az beş dönem eğitmeyi deneyin.
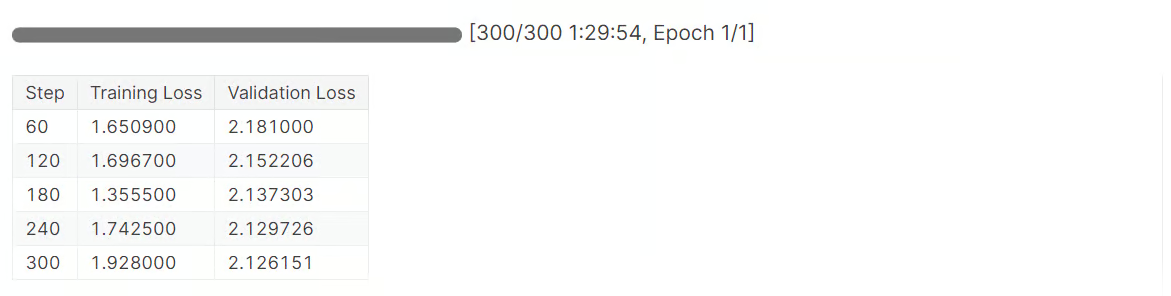
Sonraki adımda Weights and Biases oturumunu bitiriyoruz.
wandb.finish()
model.config.use_cache = True
Model performansına ilişkin gerekli tüm metrikleri içeren oturum özetini görüntüleyebileceğiz.
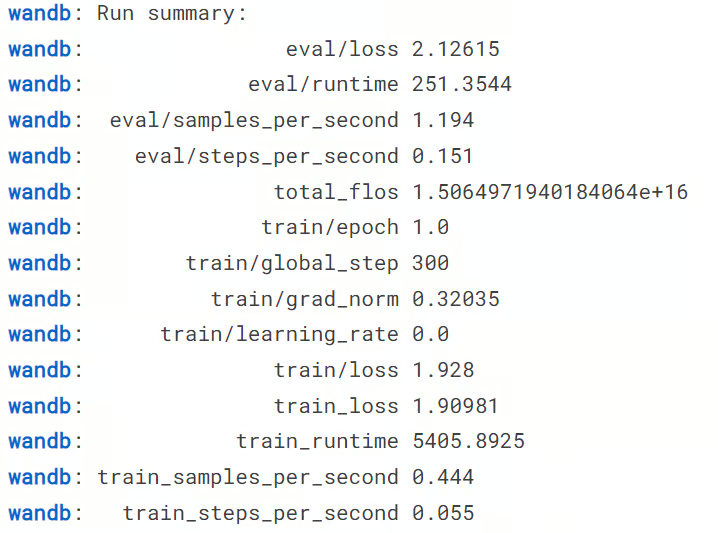
Ayrıntılı bir özet görmek için Weights and Biases hesabınıza gidin ve oturumu tarayıcınızda görüntüleyin. Etkileşimli görselleştirmelerle gelir.
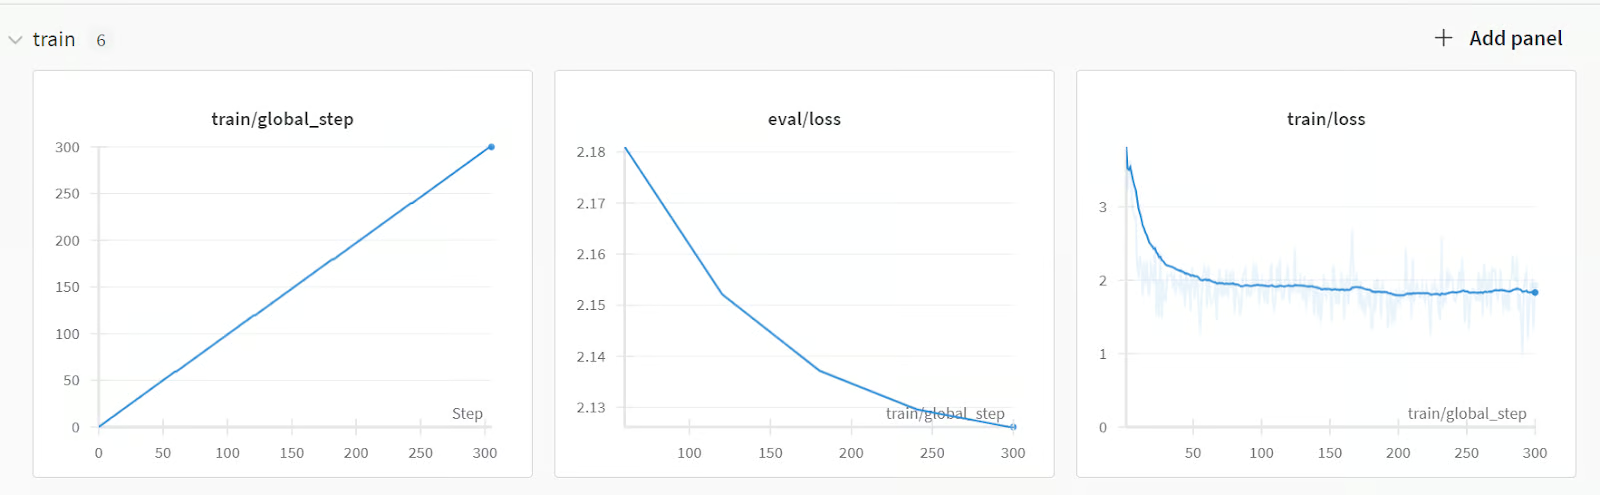
Ardından hem model adaptörünü hem de belirteçleyiciyi yerel olarak kaydedebiliriz. Bir sonraki bölümde bunu adaptörü temel modelle birleştirmek için kullanacağız.
# Save trained model and tokenizer
trainer.save_model(output_dir)
tokenizer.save_pretrained(output_dir)Şimdi en kritik kısım geliyor. Modelimiz ince ayardan sonra daha iyi mi performans gösterecek, yoksa kötüleşecek mi? Bunu öğrenmek için test kümesi üzerinde 'predict' fonksiyonunu, ardından model değerlendirme raporu üretmek için 'evaluate' fonksiyonunu çalıştırmalıyız.
y_pred = predict(X_test, model, tokenizer)
evaluate(y_true, y_pred)
Aşağıdaki sonuçlardan görebileceğiniz gibi, model performansında büyük bir iyileşme var: doğruluk %79’dan %91,3’e çıktı. F1 skorları da gayet iyi görünüyor.
100%|██████████| 300/300 [03:24<00:00,  1.47it/s]
Accuracy: 0.913
Accuracy for label Normal: 0.972
Accuracy for label Depression: 0.913
Accuracy for label Anxiety: 0.667
Accuracy for label Bipolar: 0.800

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.97      0.95       143
  Depression       0.93      0.91      0.92       115
     Anxiety       0.75      0.67      0.71        27
     Bipolar       1.00      0.80      0.89        15

    accuracy                           0.91       300
   macro avg       0.90      0.84      0.87       300
weighted avg       0.91      0.91      0.91       300


Confusion Matrix:
[[139   3   1   0]
 [  5 105   5   0]
 [  6   3  18   0]
 [  1   2   0  12]]
Sonuçları ve model dosyalarını kaydetmek için şimdi Kaggle notebook’unu kaydedebiliriz. Bunun için sağ üstteki “Save Version” düğmesine tıklayıp sürüm türü olarak “Quick Save”i seçin ve çıktı kaydetme türü olarak “Quick Save oluştururken çıktıyı her zaman kaydet” seçeneğini işaretleyin.
Modeli ince ayarlamada sorun yaşıyorsanız, daha fazla yardım için lütfen Kaggle notebook’una bakın.
Ayrıca Llama 3.0 modellerini nasıl ince ayarlayacağınızı anlatan şu rehberimizi de takip edebilirsiniz: Llama 3’ü İnce Ayarlama ve Yerelde Kullanma.
Bu bölümde, adaptörü temel modelle birleştirip tam sürümü Hugging Face hub’ında kaydedeceğiz.
Önce GPU ivmelendirmeli yeni bir Kaggle notebook’u başlatıp model dosyalarına erişmek için kaydedilen notebook’u ekleyin. Bir veri kümesi ekler gibi diğer Kaggle notebook’larını da girdi olarak dahil edebilirsiniz.
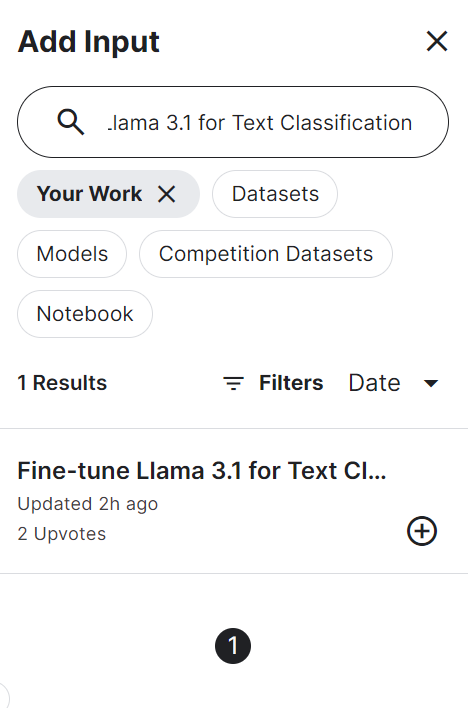
Ardından gerekli Python paketlerini kurabiliriz.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
Sonraki adımda, model dosyalarımızı Hugging Face model deposuna göndermek için API anahtarıyla Hugging Face hub API’sine giriş yapıyoruz.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
Ardından temel modelin ve ince ayarlı modelin dizinini ayarlayabiliriz.
base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"
fine_tuned_model = "/kaggle/input/fine-tune-llama-3-1-for-text-classification/llama-3.1-fine-tuned-model/"
Sonra belirteçleyiciyi ve temel modeli yükleyin.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)

base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
Temel modeli ince ayarlı adaptörle aşağıda görüldüğü gibi birleştiriyoruz.
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, fine_tuned_model)
model = model.merge_and_unload()
Modelimizi kaydetmeden önce doğru çalışıp çalışmadığını kontrol edelim. Model ve belirteçleyiciyle bir metin üretim hattı oluşturun ve örnek istem sağlayın.
text = "I'm trapped in a storm of emotions that I can't control, and it feels like no one understands the chaos inside me"
prompt = f"""Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {text}
label: """.strip()

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=2, do_sample=True, temperature=0.1)
print(outputs[0]["generated_text"].split("label: ")[-1].strip())
Modelimiz kusursuz çalışıyor.
DepressionArtık modeli ve belirteçleyiciyi yerel olarak kaydedebiliriz.
model_dir = "Llama-3.1-8B-Instruct-Mental-Health-Classification"
model.save_pretrained(model_dir)
tokenizer.save_pretrained(model_dir)
Ve ardından modeli ve belirteçleyiciyi Hugging Face Hub’a gönderin.
model.push_to_hub(model_dir, use_temp_dir=False)
tokenizer.push_to_hub(model_dir, use_temp_dir=False)
Bu işlem Hugging Face üzerinde bir depo oluşturacak ve tüm model ile belirteçleyici dosyalarını gönderecektir.
CommitInfo(commit_url='https://huggingface.co/kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification/commit/e1244abeaac159e0a48439095200a4190c2b493c', commit_message='Upload tokenizer', commit_description='', oid='e1244abeaac159e0a48439095200a4190c2b493c', pr_url=None, pr_revision=None, pr_num=None)Hugging Face web sitesini ziyaret ederek tüm model dosyalarını görüntüleyebiliriz.
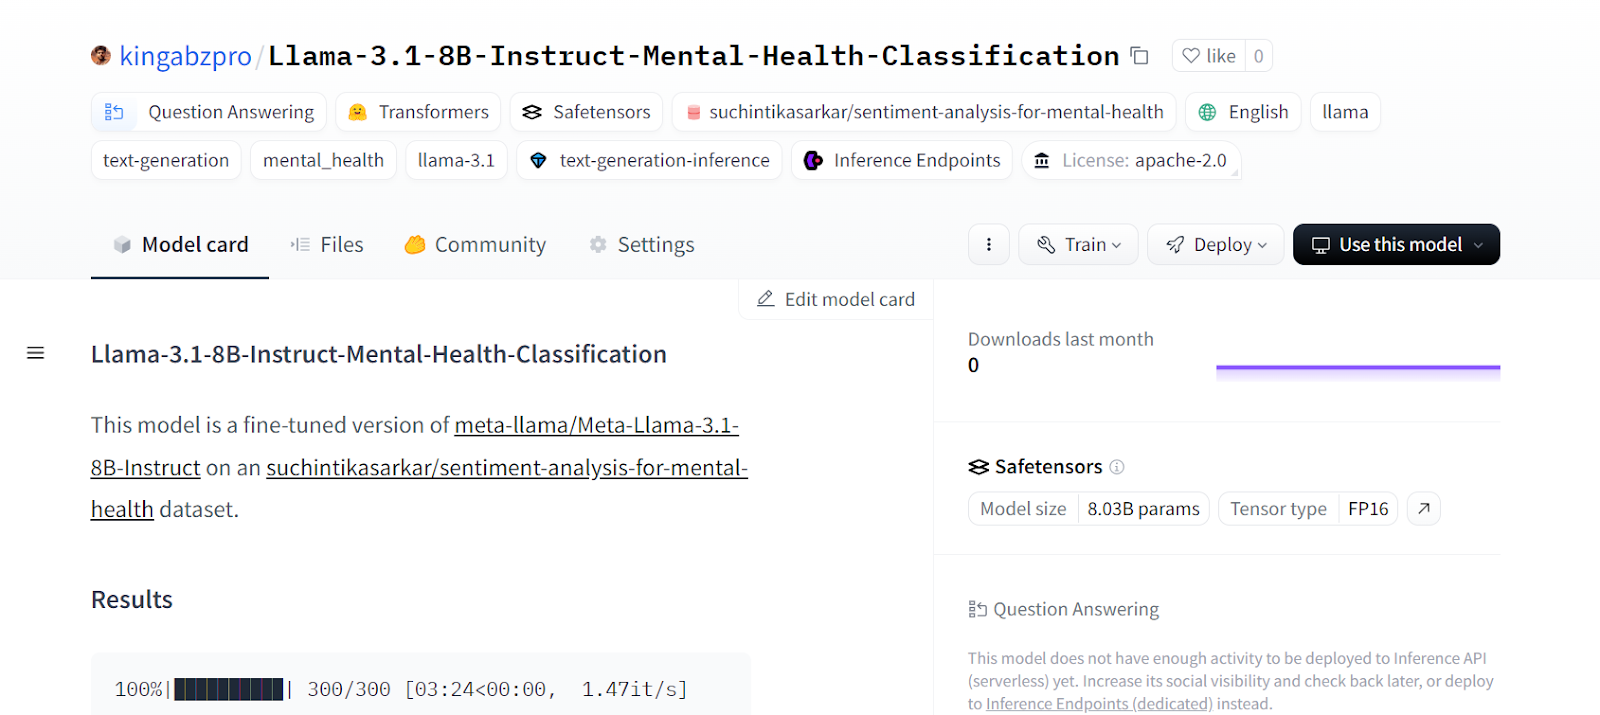
Kaynak: kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification · Hugging Face
Adaptörü temel modelle birleştirirken sorun yaşıyorsanız, lütfen Kaggle notebook’una bakın.
LLM’leri ince ayarlamayı zor buluyorsanız, OpenAI API’sini kullanarak yalnızca birkaç satır kodla herhangi bir veri kümesinde modeli ince ayarlamanın daha kolay bir yolunu öğrenmek için OpenAI’nin GPT-4’ünü İnce Ayarlama: Adım Adım Rehber öğreticisini takip edebilirsiniz.
Modeli ince ayarlamak, yalnızca veri kümesine göre özelleştirmeyle sınırlı değildir. Büyük dil modellerini makine çevirisi, kümeleme, sınıflandırma, soru-cevap, gömme ve daha birçok doğal dil görevi için ince ayarlayabiliriz.
Bu eğitimde Llama 3.1 modelini bir ruh sağlığı sınıflandırma veri kümesi üzerinde ince ayarlamayı öğrendik. Bu model, günlük hayatlarında zorluk yaşayan hastaları ve hatta çalışanları belirlemek için kullanılabilir.
LLM’lerle nasıl başlayabileceğinizi ve modelleri kendi başınıza ince ayarlamaya nasıl başlayabileceğinizi merak ediyorsanız, Büyük Dil Modelleri Geliştirme beceri yolunu düşünmelisiniz. Bu dizi dersle LLM’lerde sağlam bir temel oluşturacak ve sizi yeni yapay zekâ odaklı dünyaya taşıyacaktır.
En İyi DataCamp LLM Kursları
Kurs
Program
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




