
Khóa học
Làm việc với Llama 3
2 giờ
15.7K
Trước khi bắt đầu, xin lưu ý: khi tiếp cận các bài toán AI trong chăm sóc sức khỏe, điều tối quan trọng là phải cân nhắc kỹ các hệ quả có thể gây hại cho bệnh nhân. Ví dụ dưới đây, dù toàn diện, chỉ nhằm minh họa việc tinh chỉnh trên một tập dữ liệu thực tế. Nếu bạn đang theo đuổi các trường hợp sử dụng AI trong y tế hoặc các lĩnh vực nhạy cảm khác, chúng tôi khuyến nghị mạnh mẽ bạn đọc hướng dẫn về Đạo đức AI.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu về các mô hình Llama 3.1 và tinh chỉnh mô hình Llama-3.1-8b-It cho phân tích cảm xúc trên tập dữ liệu sức khỏe tâm thần. Mục tiêu là tùy biến mô hình để dự đoán trạng thái sức khỏe tâm thần của bệnh nhân dựa trên văn bản. Chúng ta cũng sẽ gộp adapter với mô hình gốc và lưu toàn bộ mô hình lên Hugging Face Hub.
Chúng ta sẽ tìm hiểu về các mô hình Llama 3.1, cách truy cập chúng trên Kaggle và cách dùng thư viện Transformer để chạy suy luận. Chúng ta cũng sẽ tinh chỉnh mô hình Llama-3.1-8b-It trên tập dữ liệu phân loại sức khỏe tâm thần. Cuối cùng, chúng ta sẽ gộp adapter đã lưu với mô hình gốc và đẩy toàn bộ mô hình lên Hugging Face Hub.
Nếu bạn mới bắt đầu với chủ đề này, bạn có thể tìm hiểu phần lý thuyết phía sau tinh chỉnh bằng cách đọc bài viết Hướng dẫn nhập môn về tinh chỉnh LLM.

Ảnh: Tác giả
Llama 3.1 là dòng mô hình ngôn ngữ lớn (LLM) đa ngôn ngữ mới nhất do Meta AI phát triển, đang mở rộng giới hạn về hiểu và sinh ngôn ngữ. Dòng này có ba kích cỡ: 8B, 70B và 405B tham số.
Các mô hình Llama 3.1 được xây dựng trên kiến trúc mô hình ngôn ngữ tự hồi quy với transformer tối ưu hóa và có thể tinh chỉnh cho nhiều tác vụ và tập dữ liệu xử lý ngôn ngữ tự nhiên khác nhau. Chúng được huấn luyện trên tập dữ liệu đa dạng từ dữ liệu trực tuyến công khai, hỗ trợ tám ngôn ngữ (Tiếng Anh, Đức, Pháp, Ý, Bồ Đào Nha, Hindi, Tây Ban Nha và Thái) và có độ dài ngữ cảnh 128k.
Các mô hình Llama 3.1 khả dụng cho mọi người theo giấy phép thương mại tùy chỉnh và chỉ yêu cầu tối thiểu thông tin cá nhân để tải trọng số mô hình.
Llama 3.1 được tối ưu cho đối thoại đa ngôn ngữ và vượt trội hơn Gemma 2, GPT 3.5 turbo và GPT-4o trên nhiều thang đo, bao gồm trò chuyện tổng quát, lập trình, toán học, suy luận và hơn thế nữa. Đây là mô hình mã nguồn mở nhanh nhất và chính xác nhất hiện có.
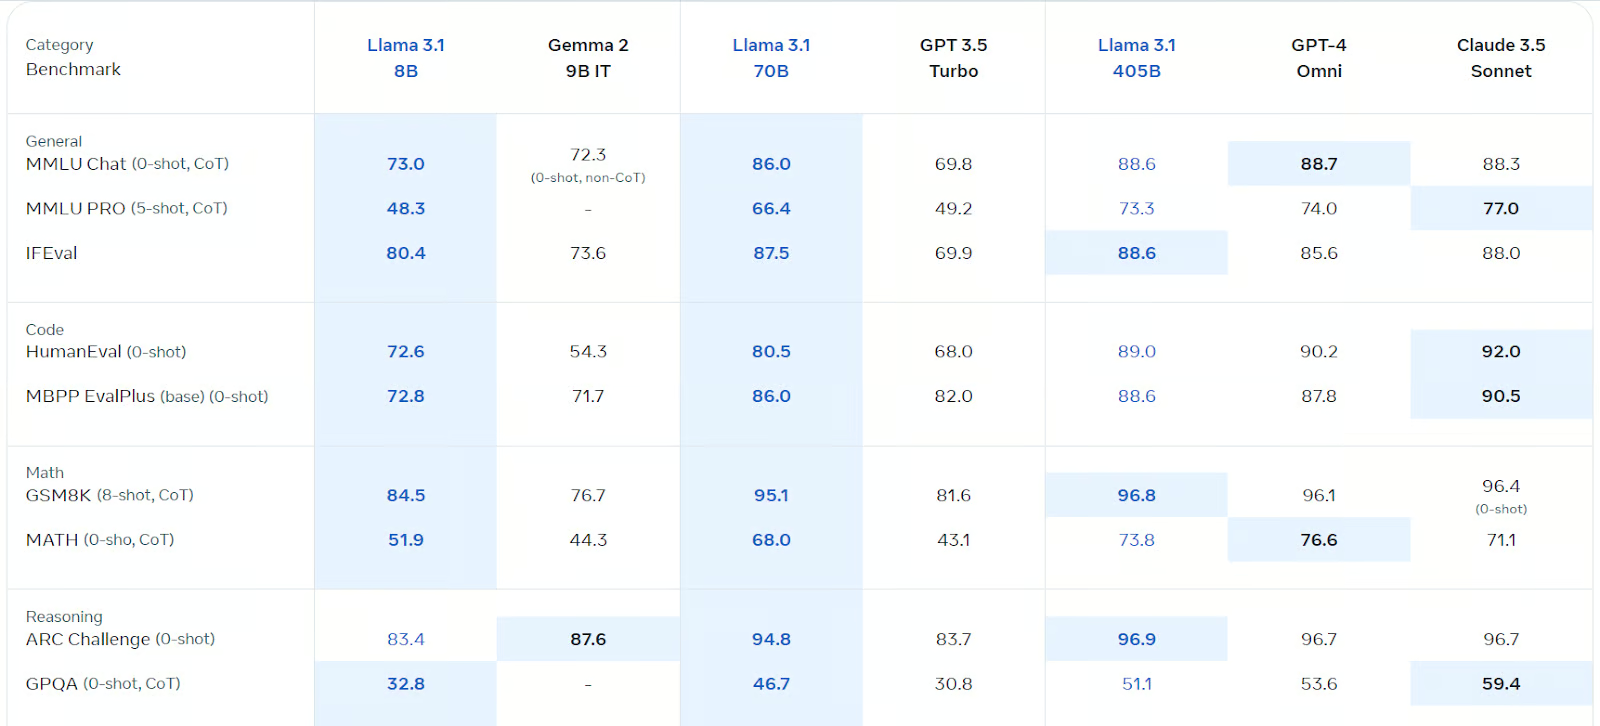
Nguồn: Llama 3.1 (meta.com)
Bạn có thể tìm hiểu thêm về mô hình Llama 3.1 qua bài viết Llama 3.1 405B của Meta là gì? Cách hoạt động, trường hợp sử dụng & hơn thế nữa.
Trong hướng dẫn này, chúng ta sẽ dùng Kaggle Notebook làm môi trường phát triển vì cung cấp GPU và TPU miễn phí. Để dùng mô hình Llama 3.1 trên Kaggle notebook, hãy làm theo các bước sau:
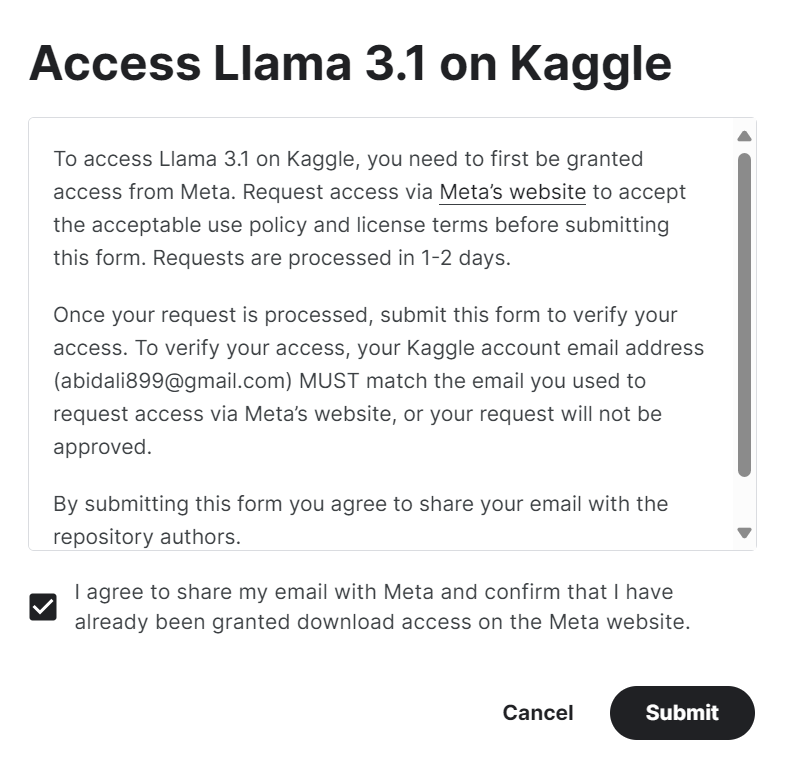
1. Điền biểu mẫu trên meta.com với cùng địa chỉ email như tài khoản Kaggle của bạn.
2. Truy cập kho mô hình Meta | Llama 3.1 trên Kaggle và nhấp nút "access the model". Chấp nhận mọi điều khoản, và sau vài giây bạn sẽ được cấp quyền truy cập mô hình.
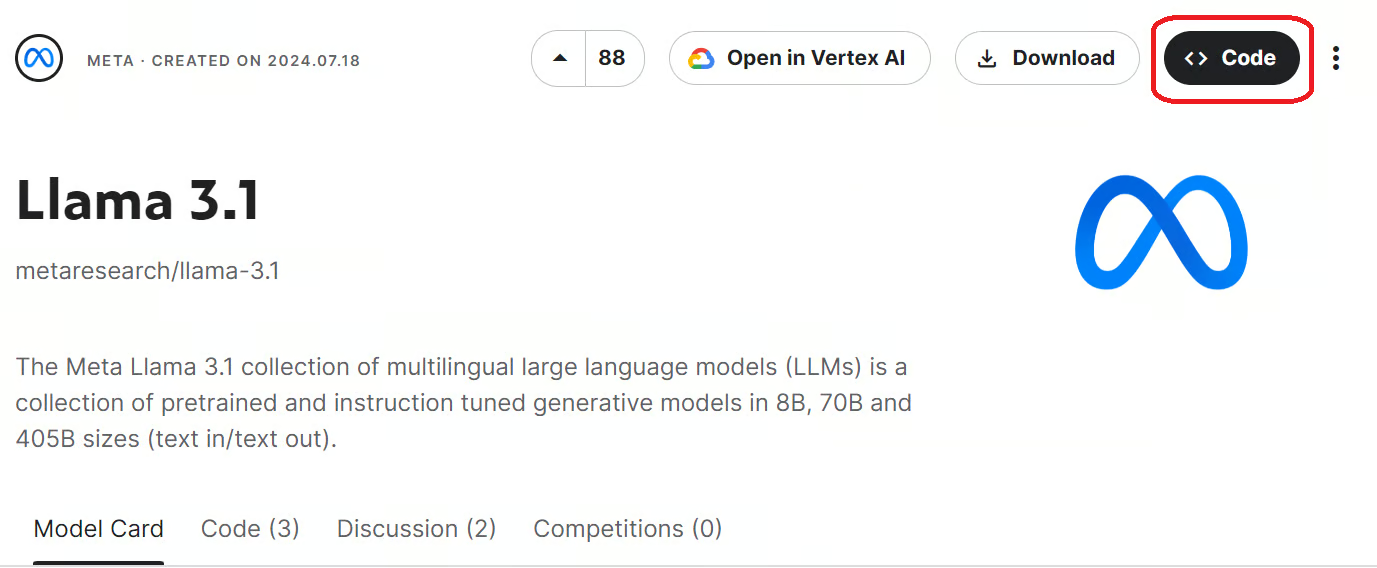
3. Khởi tạo Kaggle notebook với các mô hình Llama 3.1 bằng cách nhấp nút "Code" ở góc trên bên phải trang mô hình.
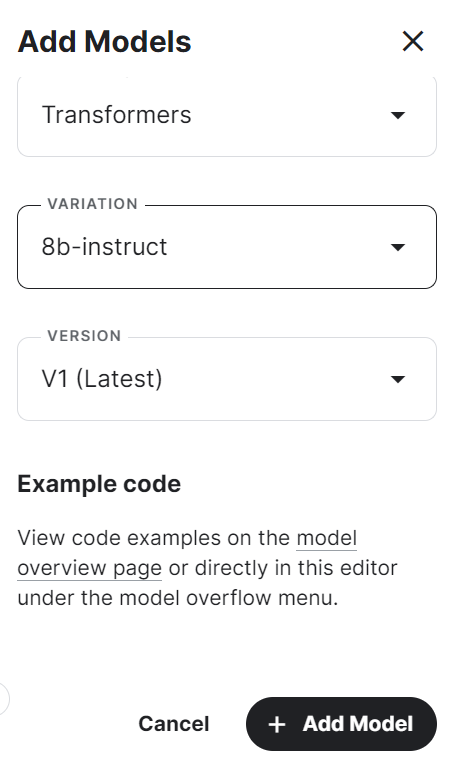
4. Chọn framework, biến thể và phiên bản, rồi nhấn nút "Add Model".
5. Cài đặt các gói Python cần thiết trong Kaggle notebook bằng lệnh sau:
%pip install -U transformers accelerate6. Tải mô hình và tokenizer bằng thư viện Transformers từ thư mục cục bộ.
7. Tạo pipeline sinh văn bản với mô hình, tokenizer, kiểu torch và sơ đồ thiết bị.
from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch

base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

tokenizer = AutoTokenizer.from_pretrained(base_model)

model = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)
8. Viết thông điệp và chuyển thành prompt phù hợp bằng chat template.
9. Chạy pipeline với prompt và in ra kết quả sinh.
messages = [{"role": "user", "content": "What is the tallest building in the world?"}]

prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])
Câu trả lời chính xác và chi tiết.
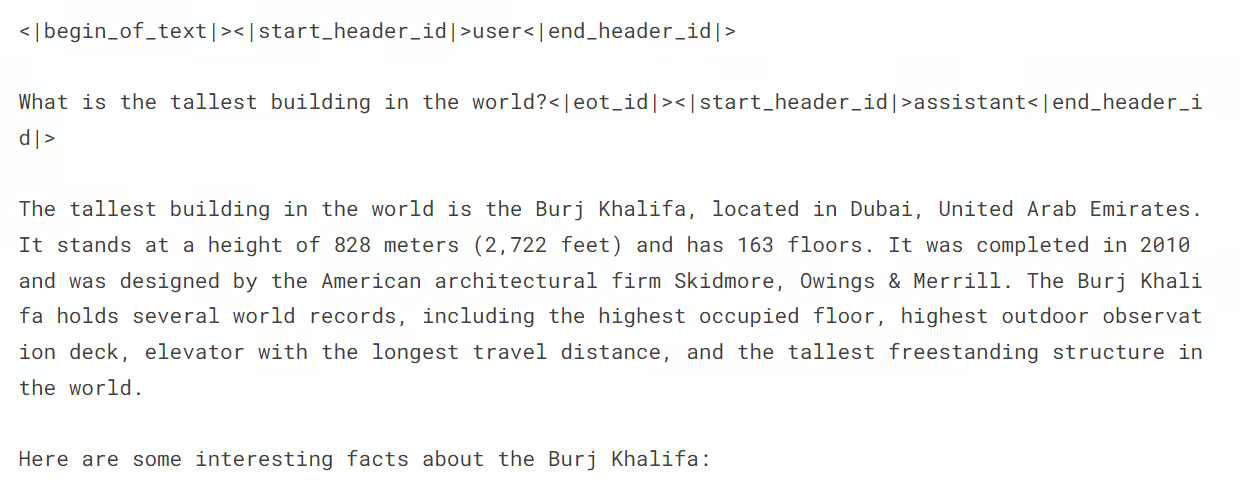
Nếu bạn gặp khó khăn khi chạy suy luận mô hình, vui lòng tham khảo Kaggle Notebook tại Llama 3.1 Simple Model Inference.
Giờ chúng ta cần tải, xử lý tập dữ liệu và tinh chỉnh mô hình Llama 3.1. Chúng ta cũng sẽ so sánh hiệu năng mô hình trước và sau khi tinh chỉnh.
Nếu bạn mới với LLM, tôi khuyến nghị bạn học khóa Nắm vững các khái niệm về Mô hình Ngôn ngữ Lớn (LLMs) trước khi đi sâu vào phần tinh chỉnh của hướng dẫn.
Đầu tiên, chúng ta sẽ mở notebook Kaggle mới và mô hình Llama 3.1 giống như ở phần trước.
Sau đó, cài đặt các gói Python cần thiết như dưới đây:
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
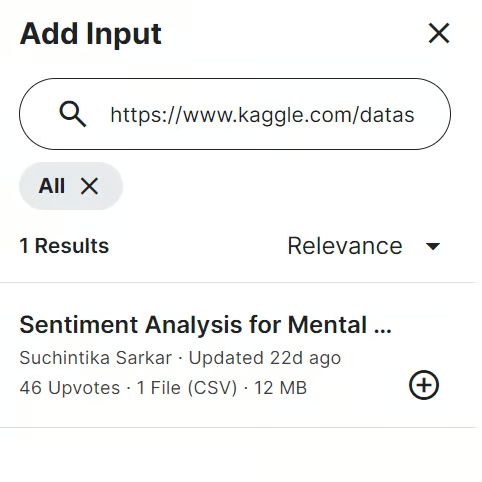
Tiếp theo, chúng ta thêm dữ liệu Sentiment Analysis for Mental Health vào Kaggle notebook. Để làm điều này, nhấp nút “Add Input” ở góc trên bên phải và dán liên kết mô hình vào thanh tìm kiếm. Sau đó nhấp nút dấu cộng (+) để thêm mô hình.
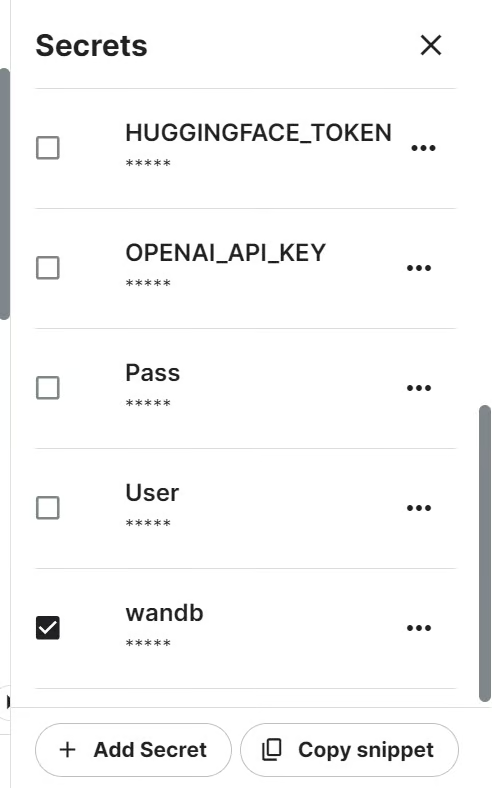
Chúng ta sẽ theo dõi hiệu năng mô hình bằng API Weights and Biases. Để truy cập API, cần có khóa API. Thiết lập khóa API trong Kaggle bằng Secrets và kích hoạt, như minh họa bên dưới.
Sau đó, chúng ta khởi tạo dự án Weights and Biases bằng khóa API.
import wandb

from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

wb_token = user_secrets.get_secret("wandb")

wandb.login(key=wb_token)
run = wandb.init(
    project='Fine-tune llama-3.1-8b-it on Sentiment Analysis Dataset',
    job_type="training",
    anonymous="allow"
)
Tiếp theo, chúng ta cần import tất cả gói và hàm Python cần thiết.
import numpy as np
import pandas as pd
import os
from tqdm import tqdm
import bitsandbytes as bnb
import torch
import torch.nn as nn
import transformers
from datasets import Dataset
from peft import LoraConfig, PeftConfig
from trl import SFTTrainer
from trl import setup_chat_format
from transformers import (AutoModelForCausalLM,
                          AutoTokenizer,
                          BitsAndBytesConfig,
                          TrainingArguments,
                          pipeline,
                          logging)
from sklearn.metrics import (accuracy_score,
                             classification_report,
                             confusion_matrix)
from sklearn.model_selection import train_test_splitGiờ là lúc tải dữ liệu, làm sạch và loại bỏ ba hạng mục mơ hồ.
Để đơn giản, chúng ta sẽ loại "Suicidal" vì Llama 3.1 có cơ chế an toàn ngăn một số từ nhạy cảm. "Stress" không được coi là rối loạn tâm thần, và "Personality Disorder" trùng lắp nhiều với "Bipolar".
Kết quả là chúng ta còn lại bốn hạng mục: "Normal", "Depression", "Anxiety" và "Bipolar".
df = pd.read_csv("/kaggle/input/sentiment-analysis-for-mental-health/Combined Data.csv",index_col = "Unnamed: 0")
df.loc[:,'status'] = df.loc[:,'status'].str.replace('Bi-Polar','Bipolar')
df = df[(df.status != "Personality disorder") & (df.status != "Stress") & (df.status != "Suicidal")]
df.head()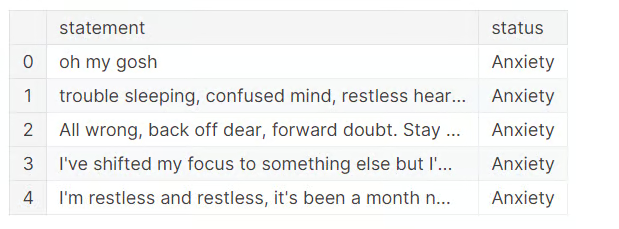
Để tiết kiệm thời gian huấn luyện, chúng ta sẽ tinh chỉnh mô hình trên 3000 mẫu. Để làm vậy, xáo trộn tập dữ liệu và chọn 3000 dòng.
Sau đó, chia dữ liệu thành các tập train, eval và test để huấn luyện và kiểm thử mô hình.
Chúng ta cũng muốn tạo cột “text” trong các tập train và eval bằng hàm generate_prompt, kết hợp dữ liệu từ các cột “statement” và “status”.
Cuối cùng, tạo cột “text” trong tập test bằng hàm generate_test_prompt và y_true từ cột “status”. Chúng ta sẽ dùng để tạo báo cáo đánh giá mô hình như dưới đây.
# Shuffle the DataFrame and select only 3000 rows
df = df.sample(frac=1, random_state=85).reset_index(drop=True).head(3000)

# Split the DataFrame
train_size = 0.8
eval_size = 0.1

# Calculate sizes
train_end = int(train_size * len(df))
eval_end = train_end + int(eval_size * len(df))

# Split the data
X_train = df[:train_end]
X_eval = df[train_end:eval_end]
X_test = df[eval_end:]

# Define the prompt generation functions
def generate_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: {data_point["status"]}""".strip()

def generate_test_prompt(data_point):
    return f"""
            Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {data_point["statement"]}
label: """.strip()

# Generate prompts for training and evaluation data
X_train.loc[:,'text'] = X_train.apply(generate_prompt, axis=1)
X_eval.loc[:,'text'] = X_eval.apply(generate_prompt, axis=1)

# Generate test prompts and extract true labels
y_true = X_test.loc[:,'status']
X_test = pd.DataFrame(X_test.apply(generate_test_prompt, axis=1), columns=["text"])
Tại thời điểm này, ta muốn kiểm tra phân bố hạng mục trong tập train.
X_train.status.value_counts()Bạn có thể thấy bên dưới chúng ta có phân bố gần như đồng đều của các hạng mục "Normal" và "Depression". Các nhãn còn lại là thiểu số. Điều này nghĩa là tập dữ liệu mất cân bằng và mô hình sẽ dự đoán tốt hơn cho nhãn đa số so với nhãn thiểu số.
Chúng ta có thể cân bằng dữ liệu, nhưng đó không phải mục tiêu của hướng dẫn này.
status
Normal        1028
Depression     938
Anxiety        258
Bipolar        176
Name: count, dtype: int64
Tiếp theo, chúng ta muốn chuyển tập train và eval thành datasets của Hugging Face.
# Convert to datasets
train_data = Dataset.from_pandas(X_train[["text"]])
eval_data = Dataset.from_pandas(X_eval[["text"]])
Sau đó, hiển thị mẫu thứ 4 từ cột “text”.
train_data['text'][3]Ta thấy cột “text” có prompt hệ thống, câu phát biểu và trạng thái làm nhãn.
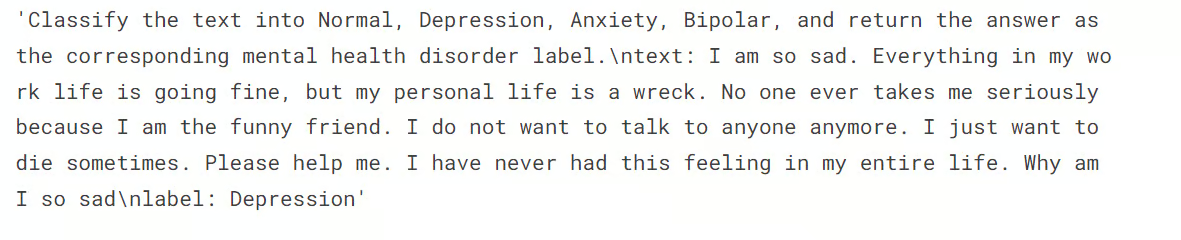
Tiếp theo, chúng ta sẽ tải mô hình Llama-3.1-8b-instruct ở mức lượng tử hóa 4-bit quantization để tiết kiệm bộ nhớ GPU.
Sau đó tải tokenizer và đặt pad token id.
base_model_name = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype="float16",
)

model = AutoModelForCausalLM.from_pretrained(
    base_model_name,
    device_map="auto",
    torch_dtype="float16",
    quantization_config=bnb_config,
)

model.config.use_cache = False
model.config.pretraining_tp = 1

tokenizer = AutoTokenizer.from_pretrained(base_model_name)

tokenizer.pad_token_id = tokenizer.eos_token_idỞ đây, chúng ta tạo hàm predict, dùng pipeline sinh văn bản để dự đoán nhãn từ cột “text”. Chạy hàm sẽ trả về danh sách các hạng mục rối loạn tâm thần dựa trên các mẫu trong tập kiểm thử.
def predict(test, model, tokenizer):
    y_pred = []
    categories = ["Normal", "Depression", "Anxiety", "Bipolar"]

    for i in tqdm(range(len(test))):
        prompt = test.iloc[i]["text"]
        pipe = pipeline(task="text-generation",
                        model=model,
                        tokenizer=tokenizer,
                        max_new_tokens=2,
                        temperature=0.1)

        result = pipe(prompt)
        answer = result[0]['generated_text'].split("label:")[-1].strip()

        # Determine the predicted category
        for category in categories:
            if category.lower() in answer.lower():
                y_pred.append(category)
                break
        else:
            y_pred.append("none")

    return y_pred

y_pred = predict(X_test, model, tokenizer)
100%|██████████| 300/300 [02:54<00:00, 1.72it/s]Tiếp đó, chúng ta tạo hàm evaluate dùng nhãn dự đoán và nhãn thật để tính độ chính xác tổng thể và theo hạng mục, tạo báo cáo phân loại và in ma trận nhầm lẫn. Chạy hàm sẽ cho ta bản tóm tắt đánh giá chi tiết.
def evaluate(y_true, y_pred):
    labels = ["Normal", "Depression", "Anxiety", "Bipolar"]
    mapping = {label: idx for idx, label in enumerate(labels)}

    def map_func(x):
        return mapping.get(x, -1)  # Map to -1 if not found, but should not occur with correct data

    y_true_mapped = np.vectorize(map_func)(y_true)
    y_pred_mapped = np.vectorize(map_func)(y_pred)

    # Calculate accuracy
    accuracy = accuracy_score(y_true=y_true_mapped, y_pred=y_pred_mapped)
    print(f'Accuracy: {accuracy:.3f}')

    # Generate accuracy report
    unique_labels = set(y_true_mapped)  # Get unique labels

    for label in unique_labels:
        label_indices = [i for i in range(len(y_true_mapped)) if y_true_mapped[i] == label]
        label_y_true = [y_true_mapped[i] for i in label_indices]
        label_y_pred = [y_pred_mapped[i] for i in label_indices]
        label_accuracy = accuracy_score(label_y_true, label_y_pred)
        print(f'Accuracy for label {labels[label]}: {label_accuracy:.3f}')

    # Generate classification report
    class_report = classification_report(y_true=y_true_mapped, y_pred=y_pred_mapped, target_names=labels, labels=list(range(len(labels))))
    print('\nClassification Report:')
    print(class_report)

    # Generate confusion matrix
    conf_matrix = confusion_matrix(y_true=y_true_mapped, y_pred=y_pred_mapped, labels=list(range(len(labels))))
    print('\nConfusion Matrix:')
    print(conf_matrix)

evaluate(y_true, y_pred)
Llama 3.1 thể hiện rất tốt ngay cả khi chưa tinh chỉnh. Độ chính xác 79% là đủ tốt. Hãy xem mô hình cải thiện ra sao khi được tinh chỉnh trên tập dữ liệu.
Accuracy: 0.790
Accuracy for label Normal: 0.741
Accuracy for label Depression: 0.939
Accuracy for label Anxiety: 0.556
Accuracy for label Bipolar: 0.533

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.74      0.82       143
  Depression       0.70      0.94      0.80       115
     Anxiety       0.68      0.56      0.61        27
     Bipolar       0.89      0.53      0.67        15

    accuracy                           0.79       300
   macro avg       0.80      0.69      0.73       300
weighted avg       0.81      0.79      0.79       300


Confusion Matrix:
[[106  33   4   0]
 [  3 108   3   1]
 [  4   8  15   0]
[ 2 5 0 8]]Khi xây dựng mô hình, chúng ta bắt đầu bằng cách trích xuất tên các mô-đun tuyến tính từ mô hình bằng thư viện bits and bytes.
Sau đó cấu hình LoRA với các mô-đun mục tiêu, loại tác vụ và các tham số khác trước khi thiết lập tham số huấn luyện. Các tham số này được tối ưu cho Kaggle notebook. Bạn có thể cần thay đổi nếu chạy cục bộ.
Tiếp theo, tạo trainer với tham số huấn luyện, mô hình, tokenizer, cấu hình LoRA và tập dữ liệu.
import bitsandbytes as bnb

def find_all_linear_names(model):
    cls = bnb.nn.Linear4bit
    lora_module_names = set()
    for name, module in model.named_modules():
        if isinstance(module, cls):
            names = name.split('.')
            lora_module_names.add(names[0] if len(names) == 1 else names[-1])
    if 'lm_head' in lora_module_names:  # needed for 16 bit
        lora_module_names.remove('lm_head')
    return list(lora_module_names)
modules = find_all_linear_names(model)
modules
['down_proj', 'gate_proj', 'o_proj', 'v_proj', 'up_proj', 'q_proj', 'k_proj']output_dir="llama-3.1-fine-tuned-model"
peft_config = LoraConfig(
lora_alpha=16,
lora_dropout=0,
r=64,
bias="none",
task_type="CAUSAL_LM",
target_modules=modules,
)
training_arguments = TrainingArguments(
output_dir=output_dir, # directory to save and repository id
num_train_epochs=1, # number of training epochs
per_device_train_batch_size=1, # batch size per device during training
gradient_accumulation_steps=8, # number of steps before performing a backward/update pass
gradient_checkpointing=True, # use gradient checkpointing to save memory
optim="paged_adamw_32bit",
logging_steps=1,
learning_rate=2e-4, # learning rate, based on QLoRA paper
weight_decay=0.001,
fp16=True,
bf16=False,
max_grad_norm=0.3, # max gradient norm based on QLoRA paper
max_steps=-1,
warmup_ratio=0.03, # warmup ratio based on QLoRA paper
group_by_length=False,
lr_scheduler_type="cosine", # use cosine learning rate scheduler
report_to="wandb", # report metrics to w&b
eval_strategy="steps", # save checkpoint every epoch
eval_steps = 0.2
)
trainer = SFTTrainer(
model=model,
args=training_arguments,
train_dataset=train_data,
eval_dataset=eval_data,
peft_config=peft_config,
dataset_text_field="text",
tokenizer=tokenizer,
max_seq_length=512,
packing=False,
dataset_kwargs={
"add_special_tokens": False,
"append_concat_token": False,
}
)Giờ là lúc bắt đầu huấn luyện mô hình:
trainer.train()Mất 1,5 giờ để tinh chỉnh mô hình, và loss trên tập xác thực giảm dần. Để có hiệu năng tốt hơn, hãy thử huấn luyện trên toàn bộ tập dữ liệu ít nhất năm epoch.
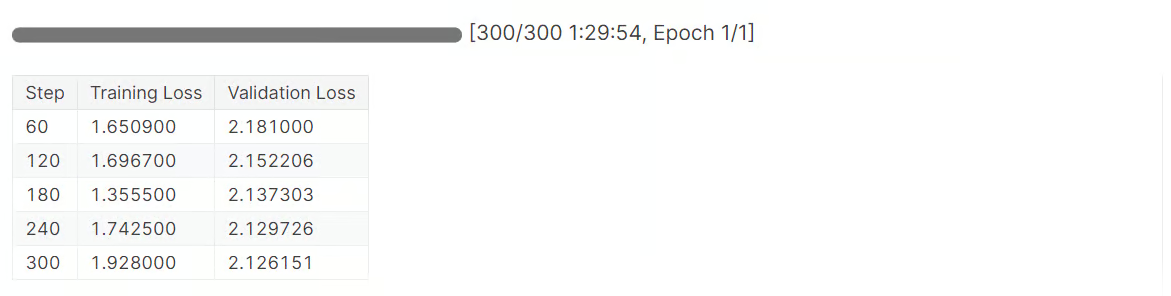
Tiếp theo, kết thúc phiên chạy Weights and Biases.
wandb.finish()
model.config.use_cache = True
Chúng ta sẽ có thể xem tóm tắt phiên chạy, bao gồm tất cả chỉ số cần thiết về hiệu năng mô hình.
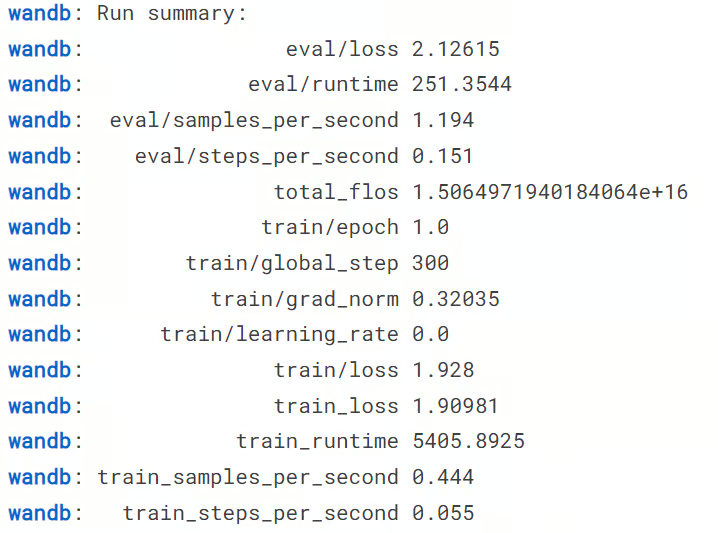
Để xem bản tóm tắt chi tiết, hãy vào tài khoản Weights and Biases của bạn và xem phiên chạy trong trình duyệt. Có các trực quan hóa tương tác đi kèm.
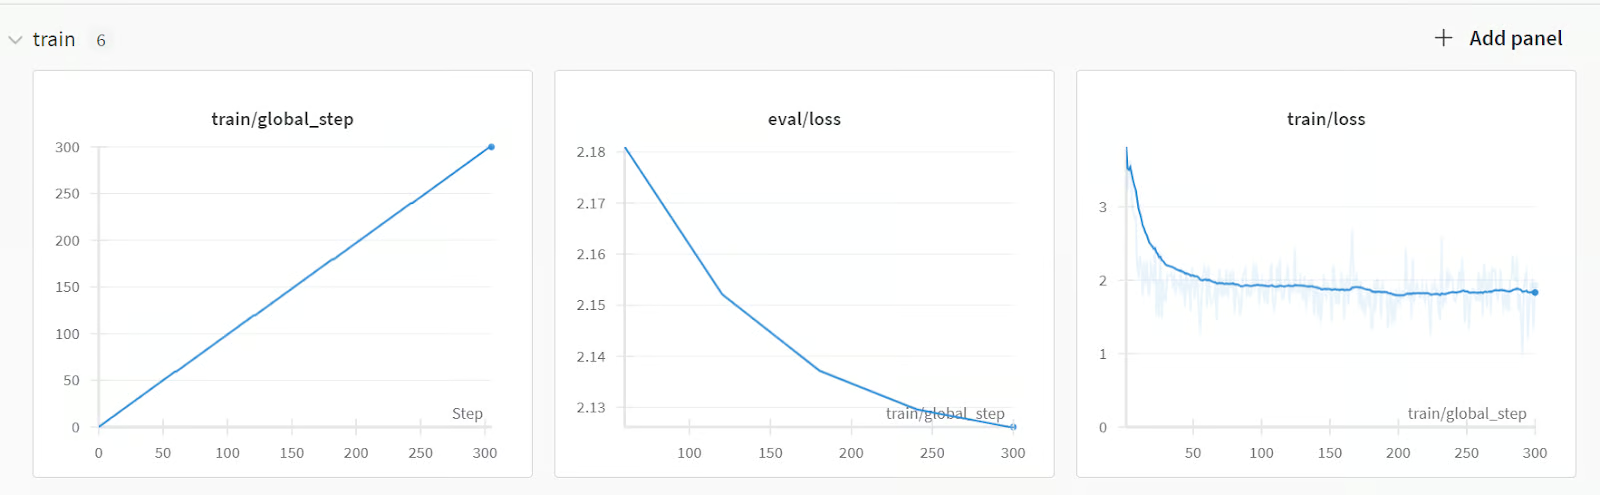
Sau đó, chúng ta có thể lưu adapter của mô hình và tokenizer cục bộ. Ở phần tiếp theo, chúng ta sẽ dùng để gộp adopter với mô hình gốc.
# Save trained model and tokenizer
trainer.save_model(output_dir)
tokenizer.save_pretrained(output_dir)Giờ đến phần quan trọng nhất. Mô hình của chúng ta sẽ hoạt động tốt hơn sau khi tinh chỉnh, hay tệ đi? Để biết, chúng ta phải chạy hàm 'predict' trên tập test rồi chạy hàm 'evaluate' để tạo báo cáo đánh giá mô hình.
y_pred = predict(X_test, model, tokenizer)
evaluate(y_true, y_pred)
Như bạn thấy từ kết quả dưới đây, đây là một cải thiện lớn về hiệu năng mô hình, từ 79% lên 91,3% độ chính xác. Ngay cả điểm F1 cũng rất tốt.
100%|██████████| 300/300 [03:24<00:00,  1.47it/s]
Accuracy: 0.913
Accuracy for label Normal: 0.972
Accuracy for label Depression: 0.913
Accuracy for label Anxiety: 0.667
Accuracy for label Bipolar: 0.800

Classification Report:
              precision    recall  f1-score   support

      Normal       0.92      0.97      0.95       143
  Depression       0.93      0.91      0.92       115
     Anxiety       0.75      0.67      0.71        27
     Bipolar       1.00      0.80      0.89        15

    accuracy                           0.91       300
   macro avg       0.90      0.84      0.87       300
weighted avg       0.91      0.91      0.91       300


Confusion Matrix:
[[139   3   1   0]
 [  5 105   5   0]
 [  6   3  18   0]
 [  1   2   0  12]]
Giờ chúng ta có thể lưu Kaggle notebook để lưu kết quả và tệp mô hình. Để làm vậy, nhấp nút “Save Version” ở góc trên bên phải, chọn loại phiên bản “Quick Save” và chọn kiểu lưu đầu ra “Always save output when creating a Quick Save.”
Nếu bạn gặp khó khăn khi tinh chỉnh mô hình, vui lòng tham khảo notebook trên Kaggle để được hỗ trợ thêm.
Bạn cũng có thể học cách tinh chỉnh các mô hình Llama 3.0 bằng cách theo dõi hướng dẫn Tinh chỉnh Llama 3 và sử dụng cục bộ.
Trong phần này, chúng ta sẽ gộp adapter với mô hình gốc và lưu phiên bản đầy đủ lên Hugging Face hub.
Đầu tiên, mở một Kaggle notebook mới có tăng tốc GPU và thêm notebook đã lưu để truy cập các tệp mô hình. Chúng ta cũng có thể thêm các Kaggle notebook khác làm đầu vào, tương tự như thêm tập dữ liệu.
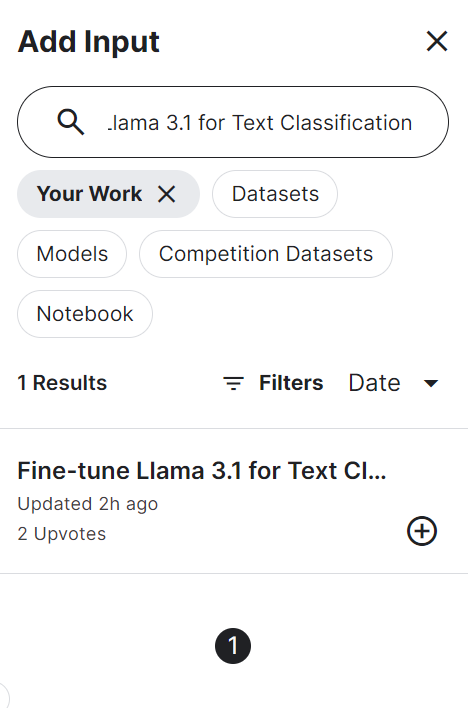
Sau đó, cài đặt các gói Python cần thiết.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
Tiếp theo, đăng nhập API Hugging Face hub bằng khóa API để đẩy các tệp mô hình vào kho mô hình trên Hugging Face.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)
Sau đó, đặt thư mục của mô hình gốc và mô hình đã tinh chỉnh.
base_model = "/kaggle/input/llama-3.1/transformers/8b-instruct/1"
fine_tuned_model = "/kaggle/input/fine-tune-llama-3-1-for-text-classification/llama-3.1-fine-tuned-model/"
Tiếp đó, tải tokenizer và mô hình gốc.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch


# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)

base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
Chúng ta gộp mô hình gốc với adapter đã tinh chỉnh như dưới đây.
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, fine_tuned_model)
model = model.merge_and_unload()
Trước khi lưu mô hình, hãy kiểm tra xem mô hình hoạt động đúng không. Tạo pipeline sinh văn bản với mô hình và tokenizer và đưa vào prompt mẫu.
text = "I'm trapped in a storm of emotions that I can't control, and it feels like no one understands the chaos inside me"
prompt = f"""Classify the text into Normal, Depression, Anxiety, Bipolar, and return the answer as the corresponding mental health disorder label.
text: {text}
label: """.strip()

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=2, do_sample=True, temperature=0.1)
print(outputs[0]["generated_text"].split("label: ")[-1].strip())
Mô hình của chúng ta hoạt động hoàn hảo.
DepressionGiờ chúng ta có thể lưu mô hình và tokenizer cục bộ.
model_dir = "Llama-3.1-8B-Instruct-Mental-Health-Classification"
model.save_pretrained(model_dir)
tokenizer.save_pretrained(model_dir)
Và sau đó đẩy mô hình và tokenizer lên Hugging Face Hub.
model.push_to_hub(model_dir, use_temp_dir=False)
tokenizer.push_to_hub(model_dir, use_temp_dir=False)
Thao tác này sẽ tạo kho trên Hugging Face và đẩy tất cả các tệp mô hình và tokenizer.
CommitInfo(commit_url='https://huggingface.co/kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification/commit/e1244abeaac159e0a48439095200a4190c2b493c', commit_message='Upload tokenizer', commit_description='', oid='e1244abeaac159e0a48439095200a4190c2b493c', pr_url=None, pr_revision=None, pr_num=None)Chúng ta có thể xem tất cả tệp mô hình bằng cách truy cập website Hugging Face.
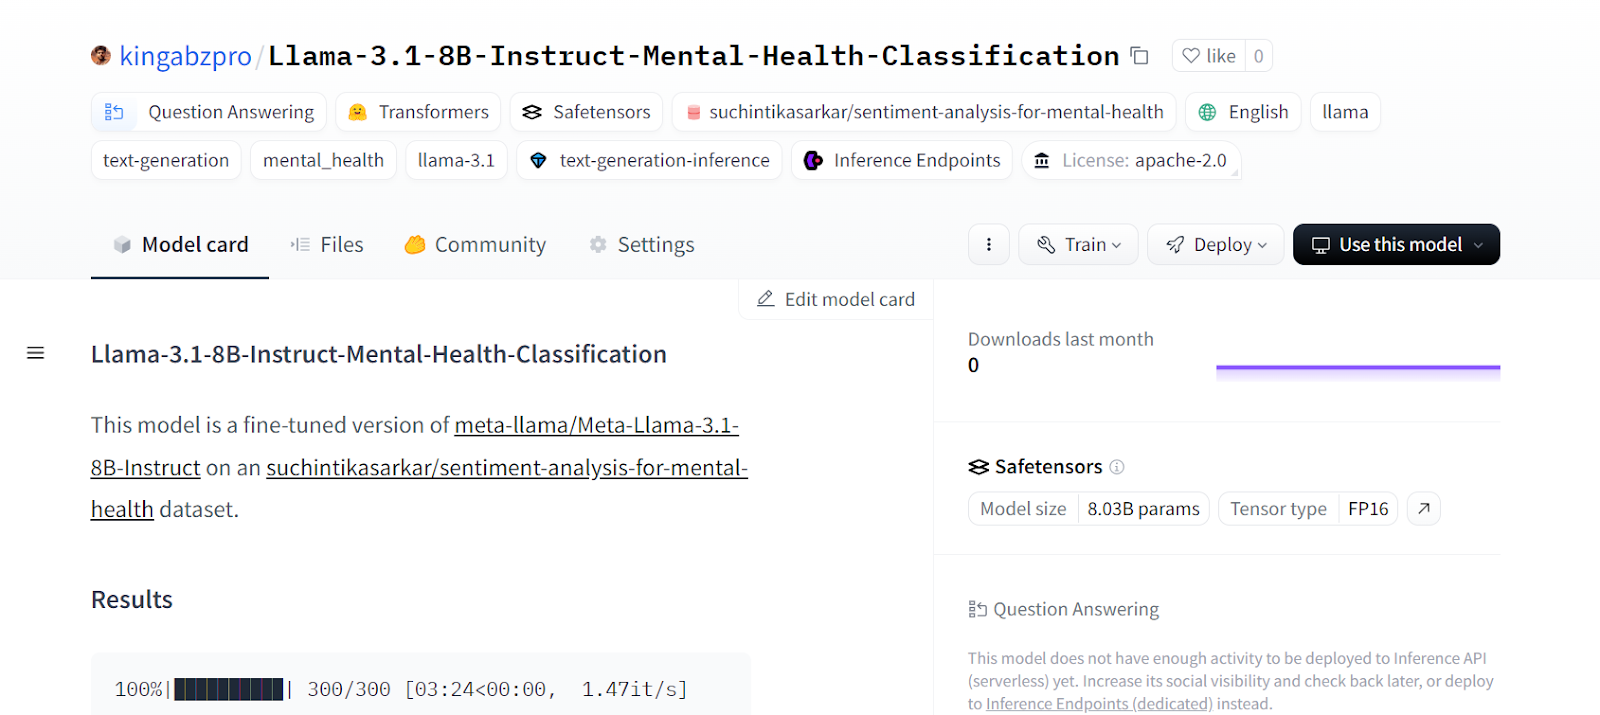
Nguồn: kingabzpro/Llama-3.1-8B-Instruct-Mental-Health-Classification · Hugging Face
Nếu bạn gặp vấn đề khi gộp adapter với mô hình gốc, vui lòng tham khảo Kaggle notebook.
Nếu bạn thấy việc tinh chỉnh LLM khó khăn, bạn có thể theo dõi hướng dẫn Tinh chỉnh GPT-4 của OpenAI: Hướng dẫn từng bước để học cách dễ dàng hơn khi dùng OpenAI API để tinh chỉnh mô hình trên bất kỳ tập dữ liệu nào chỉ với vài dòng mã.
Tinh chỉnh mô hình không chỉ giới hạn ở việc tùy biến theo tập dữ liệu. Chúng ta có thể tinh chỉnh các mô hình ngôn ngữ lớn cho nhiều tác vụ NLP như dịch máy, gom cụm, phân loại, hỏi đáp, embedding và nhiều hơn nữa.
Trong hướng dẫn này, chúng ta đã học cách tinh chỉnh mô hình Llama 3.1 trên tập dữ liệu phân loại sức khỏe tâm thần. Mô hình này có thể được dùng để nhận diện bệnh nhân và thậm chí cả nhân viên đang đối mặt với những thách thức trong cuộc sống hằng ngày.
Nếu bạn đang băn khoăn cách bắt đầu với LLM và tự tinh chỉnh mô hình, bạn nên cân nhắc tham gia lộ trình kỹ năng Phát triển Mô hình Ngôn ngữ Lớn. Với chuỗi khóa học này, bạn sẽ xây dựng nền tảng vững chắc về LLM, đưa bạn tiến vào kỷ nguyên AI mới.
Các khóa học LLM hàng đầu trên DataCamp
Khóa học
Lộ trình
Khóa học