Curso
Ajuste Fino com Llama 3
2 h
4.1K
O Qwen3.5 Small é um modelo prático para fine-tuning leve, pois foi projetado para prototipagem, adaptação a tarefas específicas e fluxos de trabalho de pesquisa. Com o QLoRA, podemos fazer fine-tuning em cima de um modelo base quantizado em 4 bits e congelado, deixando o processo muito mais eficiente em memória e acessível em hardwares limitados.
Neste tutorial, vamos configurar o ambiente, carregar o modelo e o dataset AG News, avaliar o modelo base e, em seguida, ajustar o Qwen3.5 small para classificação de notícias. Vamos encerrar comparando os resultados antes e depois do treinamento e, por fim, salvar e publicar o adaptador LoRA no Hugging Face para reutilização.
Eu recomendo fazer a trilha de habilidades Hugging Face Fundamentals se você ainda não está familiarizado com a plataforma.
Antes de irmos para o código, vale entender o modelo com o qual vamos trabalhar. Qwen3.5 é uma família de modelos base, e a série "Small" se refere à linha leve, especificamente modelos com menos de 10 bilhões de parâmetros. Para este tutorial, vamos usar a versão 0.8B.
Apesar de ter apenas 800 milhões de parâmetros, o Qwen3.5-0.8B é muito capaz e extremamente eficiente. Quando carregado em precisão de 4 bits, ele requer menos de 2 GB de VRAM. Isso o torna uma ótima opção para notebooks de consumo, ambientes em nuvem gratuitos como o Kaggle e implantações leves na borda.
Além disso, a arquitetura do Qwen3.5 suporta uma janela de contexto enorme de 262K e multimodalidade nativa. Embora aqui foquemos estritamente em classificação de texto, os conceitos básicos que cobrimos podem ser facilmente estendidos para tarefas de visão depois. O modelo também possui um modo de raciocínio híbrido, mas vamos mantê-lo desativado para maximizar a velocidade de inferência na nossa tarefa simples de rotulagem.
No geral, o Qwen3.5-0.8B é uma opção altamente prática para prototipagem. Ele nos dá uma forma rápida e de baixo custo de testar fluxos de trabalho de fine-tuning e, ainda assim, entregar bons resultados a jusante.
Neste tutorial, vamos usar um notebook do Kaggle como ambiente de treinamento. O Kaggle nos dá acesso a GPUs, tornando-o uma plataforma conveniente para treinar, ajustar e avaliar nosso modelo. Antes de rodar o notebook, crie um novo notebook no Kaggle, abra as configurações de Session e selecione GPU P100 como acelerador.
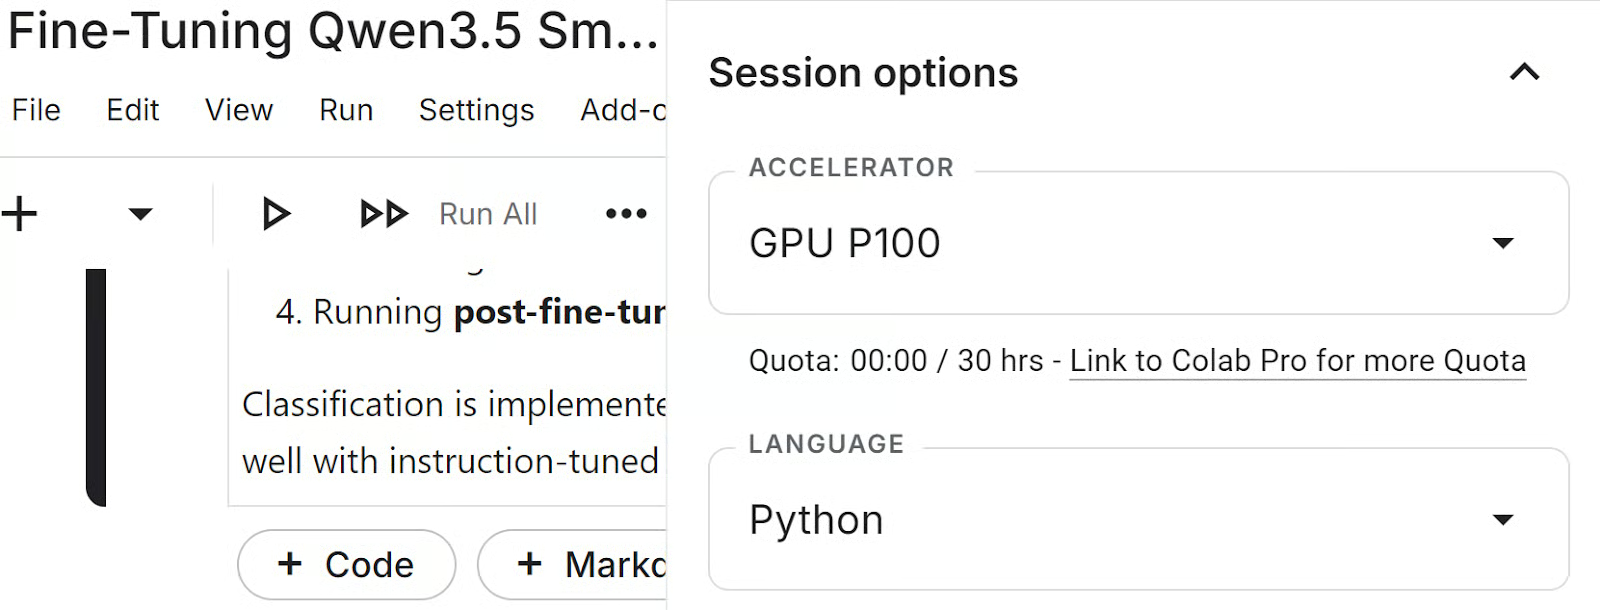
Em seguida, vamos preparar o ambiente, adicionar um token do Hugging Face ao Kaggle e importar as bibliotecas Python usadas ao longo do tutorial.
Antes de executar o notebook, crie um token de acesso do Hugging Face nas suas configurações da conta. Vá em Settings, abra Access Tokens e gere um novo token. Se quiser publicar o adaptador LoRA ajustado no Hugging Face Hub ao final do tutorial, garanta que o token tenha permissão de escrita.
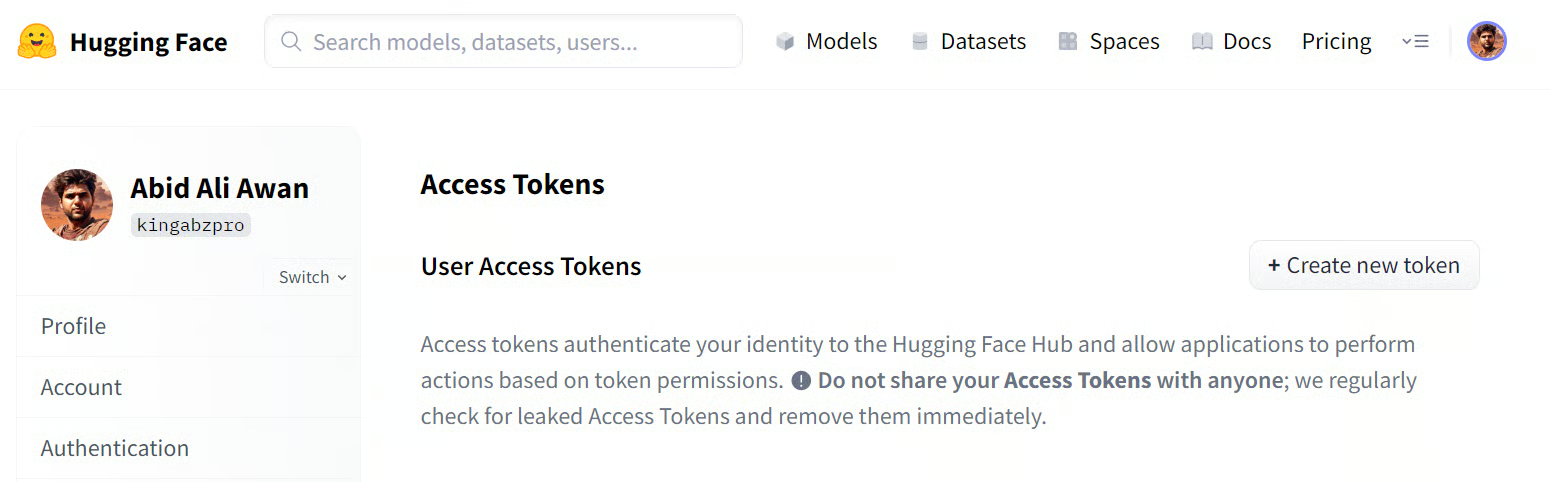
Depois de gerar o token, abra seu notebook no Kaggle e adicione-o como um segredo. No editor do notebook, vá em Add-ons, depois em Secrets e crie um novo segredo chamado HUGGINGFACE_TOKEN. Cole o valor do seu token ali para que o notebook consiga acessá-lo com segurança sem expor no código.
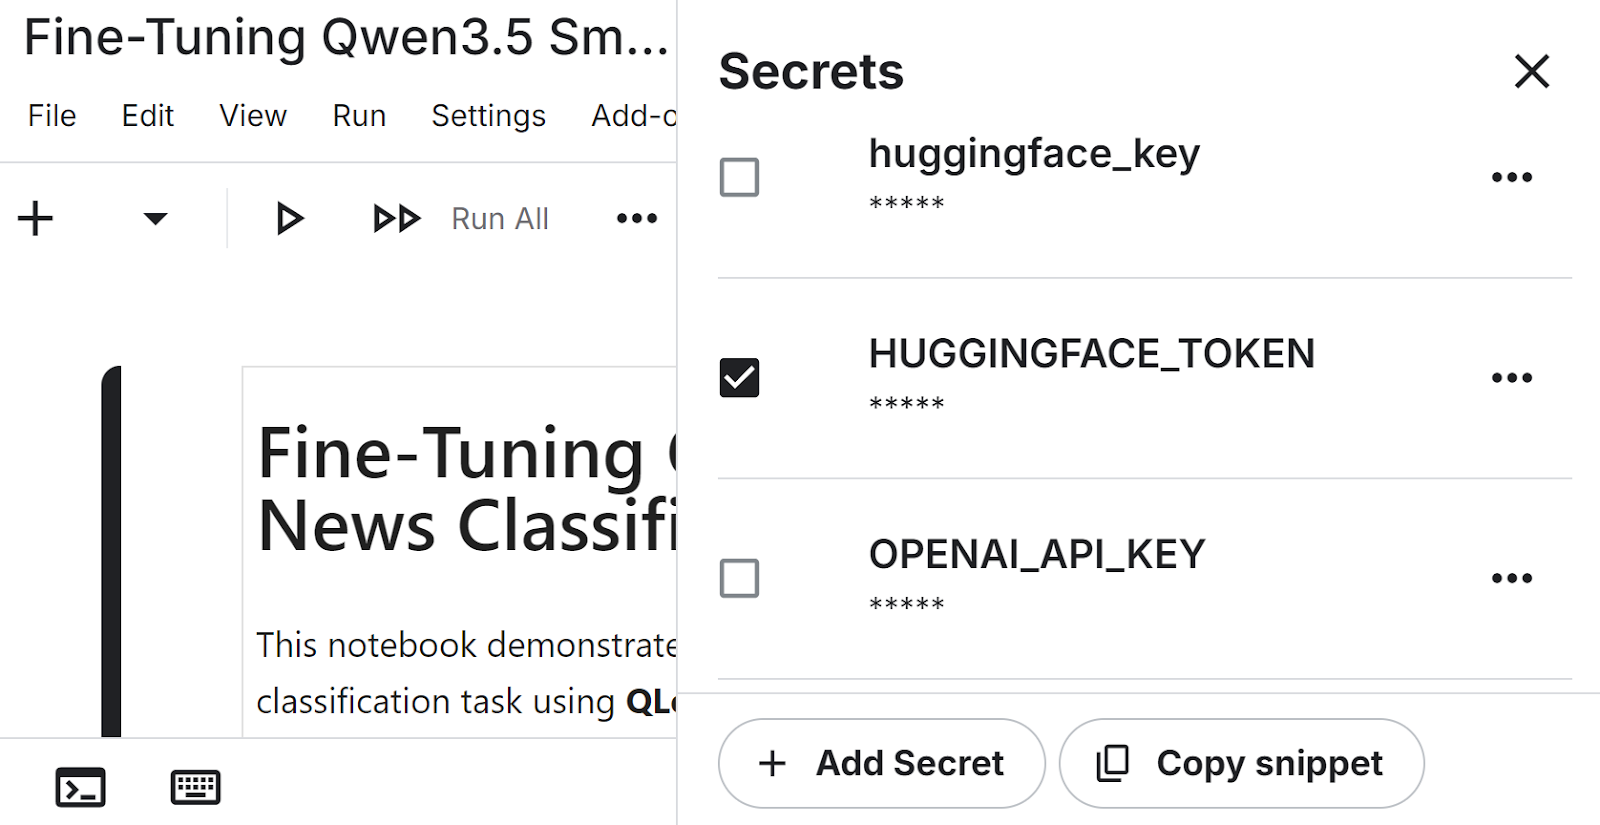
Agora podemos instalar as principais bibliotecas necessárias para este fluxo. Esses pacotes cobrem carregamento de modelo, quantização, fine-tuning eficiente em parâmetros, manipulação de datasets e avaliação.
!pip install -q -U transformers accelerate
!pip install -q peft trl bitsandbytes datasets scikit-learnEm seguida, carregamos o token do Hugging Face a partir dos segredos do Kaggle e o usamos para autenticar. Isso dá ao notebook acesso ao modelo e permite enviar o adaptador treinado depois.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient

user_secrets = UserSecretsClient()
login(token=user_secrets.get_secret("HUGGINGFACE_TOKEN"))Por fim, importamos as bibliotecas Python usadas ao longo do tutorial para carregar o modelo, treinar, processar o dataset e avaliar.
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig
from transformers import TrainingArguments
from sklearn.metrics import accuracy_score, f1_score
from tqdm.notebook import tqdmCom o ambiente pronto, podemos carregar o modelo base e preparar o dataset para fine-tuning.
Nesta seção, vamos carregar o Qwen3.5-0.8B em precisão de 4 bits para deixar o treinamento mais eficiente em memória, configurar o tokenizer e carregar um subconjunto pequeno do AG News para treino e avaliação.
Começamos carregando o Qwen3.5-0.8B com quantização em 4 bits usando o BitsAndBytes. Isso reduz o uso de memória e torna o modelo mais prático para trabalhar em um notebook do Kaggle.
model_id = "Qwen/Qwen3.5-0.8B"

bnb_config = BitsAndBytesConfig(
  load_in_4bit=True,
  bnb_4bit_quant_type="nf4",
  bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  quantization_config=bnb_config,
  device_map="auto",
  dtype=torch.bfloat16
)Agora, carregamos o tokenizer do mesmo modelo. Também definimos o token de padding como o token de fim de sequência para que o modelo lide corretamente com entradas com padding durante o treino e a geração.
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model.config.pad_token_id = tokenizer.eos_token_id
model.generation_config.pad_token_id = tokenizer.eos_token_idPor fim, carregamos o dataset AG News e criamos divisões menores de treino e teste para este tutorial. Usar um subconjunto deixa o fluxo de trabalho mais rápido, mas ainda com dados suficientes para avaliar o efeito do fine-tuning.
dataset = load_dataset("ag_news")

train_dataset = dataset["train"].select(range(2500))
test_dataset = dataset["test"].select(range(200))Antes do fine-tuning, precisamos definir como o modelo vai enxergar a tarefa e medir seu desempenho na forma original.
Nesta seção, vamos criar um prompt no estilo de instrução para classificação de notícias, extrair previsões da saída do modelo, rodar uma inferência de exemplo e avaliar o modelo base no conjunto de teste antes do treinamento.
Começamos definindo os nomes dos rótulos e construindo um prompt que pede ao modelo para classificar uma matéria. O prompt foi escrito para o modelo retornar apenas o rótulo numérico, o que facilita o parsing da saída durante a avaliação.
labels = ['World','Sports','Business','Sci/Tech']

def build_prompt(text):

    return f"""
Classify the news article.

Article:
{text}

Return ONLY the number of the correct label.

0 = World
1 = Sports
2 = Business
3 = Sci/Tech

Answer:
"""Agora criamos uma pequena função auxiliar para extrair o rótulo previsto do texto gerado. Ela remove quaisquer tokens extras de raciocínio e retorna o rótulo final como um inteiro.
import re

def extract_label(text):

   text = re.sub(r"<think>.*?</think>", "", text, flags=re.DOTALL)
   matches = re.findall(r"[0-3]", text)

   if matches:
       return int(matches[-1])

return -1Antes de avaliar o modelo no conjunto de teste completo, vamos testá-lo em um único exemplo. Isso ajuda a inspecionar a matéria, checar o rótulo correto e ver o que o modelo prevê antes do fine-tuning.
sample = train_dataset[10]

sample_text = sample["text"]
sample_label = sample["label"]

print("Ground truth label:", sample_label)
print("Sample text:")
print(sample_text[:300])
A saída mostra que o rótulo verdadeiro é 2, que corresponde a Business.
Ground truth label: 2
Sample text:
Oil and Economy Cloud Stocks' Outlook  NEW YORK (Reuters) - Soaring crude prices plus worries  about the economy
and the outlook for earnings are expected to  hang over the stock market next week during the depth of the  summer doldrums.
Em seguida, formatamos o prompt, passamos para o modelo e geramos uma previsão.
prompt = build_prompt(sample_text)

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

with torch.inference_mode():
    outputs = model.generate(
        **inputs,
        max_new_tokens=5,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id
    )

prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

print("Model prediction (before training):")
print(extract_label(prediction))
O modelo também prevê 2, então ele classifica corretamente este exemplo. Isso confirma rapidamente que o formato do prompt e o pipeline de previsão estão funcionando como esperado.
Model prediction (before training):
2Agora avaliamos o modelo base no conjunto de teste para estabelecer um baseline. Isso nos dá um ponto de referência para comparar o desempenho antes e depois do fine-tuning.
def evaluate_model(dataset):

    preds = []
    refs = []

    model.eval()

    for example in tqdm(dataset):

        text = example["text"]
        label = example["label"]

        prompt = build_prompt(text)

        inputs = tokenizer(prompt, return_tensors="pt", truncation=True)
        inputs = {k: v.to("cuda") for k, v in inputs.items()}

        with torch.inference_mode():

            outputs = model.generate(
                **inputs,
                max_new_tokens=5,
                do_sample=False,
                pad_token_id=tokenizer.eos_token_id
            )

        prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

        pred_label = extract_label(prediction)

        preds.append(pred_label)
        refs.append(label)

    acc = accuracy_score(refs, preds)
    f1 = f1_score(refs, preds, average="weighted")

    print("Accuracy:", acc)
    print("F1:", f1)


print('Pre-fine-tuning evaluation')
evaluate_model(test_dataset)
A saída reporta uma acurácia de 0.52 e um F1 score ponderado de 0.4589. Esses resultados de baseline mostram que o modelo já tem alguma capacidade para a tarefa, mas ainda há espaço claro para melhorar com fine-tuning.
Pre-fine-tuning evaluation
Accuracy: 0.52
F1: 0.45889163289429247Com o baseline definido, podemos ajustar o modelo para a tarefa de classificação de notícias. Nesta seção, vamos formatar os dados de treino, configurar os adaptadores LoRA, definir as configurações de treino, treinar o modelo e salvar o adaptador final para uso posterior.
Primeiro, formatamos cada exemplo de treino para que siga a mesma estrutura de prompt usada na inferência. Anexamos o rótulo correto ao final do prompt para que o modelo aprenda a gerar a resposta certa durante o fine-tuning.
def format_train(example):
    prompt = build_prompt(example['text'])
    answer = str(example['label'])
    return {'text': prompt + ' ' + answer}

train_dataset = train_dataset.map(format_train)Em seguida, definimos a configuração do LoRA. Isso informa ao modelo quais camadas adaptar durante o fine-tuning, permitindo treinar um pequeno conjunto de novos parâmetros em vez de atualizar o modelo inteiro.
lora_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    bias='none',
    task_type='CAUSAL_LM',
    target_modules=[
        'q_proj','k_proj','v_proj','o_proj',
        'gate_proj','up_proj','down_proj'
    ]
)Agora definimos os argumentos de treinamento para o ajuste supervisionado. Essas configurações controlam quantos exemplos são processados por vez, como os gradientes são acumulados, quanto tempo o treinamento roda e onde os arquivos de saída são salvos.
training_args = SFTConfig(
    output_dir="./qwen35-lora",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=1,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    packing=False,
)Agora inicializamos o trainer com o modelo, o dataset, a configuração do LoRA, as configurações de treino e o tokenizer. Em seguida, iniciamos o fine-tuning no conjunto de treino formatado do AG News.
trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer
)
trainer.train()
Saída:
TrainOutput(global_step=157, training_loss=1.9094241804378047, metrics={'train_runtime': 616.477, 'train_samples_per_second': 4.055, 'train_steps_per_second': 0.255, 'total_flos': 1041693973114368.0, 'train_loss': 1.9094241804378047})Após o fim do treinamento, salvamos o adaptador LoRA e o tokenizer. Assim podemos recarregar o adaptador ajustado depois para avaliação, compartilhamento ou publicação no Hugging Face.
trainer.model.save_pretrained("qwen35-small-news-class")
tokenizer.save_pretrained("qwen35-small-news-class")Depois do treinamento, recarregamos o modelo base e conectamos o adaptador LoRA salvo. Assim conseguimos rodar a avaliação usando os pesos ajustados e comparar com o baseline anterior.
Primeiro, carregamos novamente o modelo Qwen3.5 base e, depois, anexamos o adaptador LoRA ajustado salvo no diretório de trabalho do Kaggle. Em seguida, colocamos o modelo em modo de avaliação e inspecionamos o resumo de parâmetros treináveis.
from transformers import AutoModelForCausalLM
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype=torch.bfloat16
)


from peft import PeftModel

model = PeftModel.from_pretrained(
    base_model,
    "/kaggle/working/qwen35-small-news-class"
)

model.eval()
model.print_trainable_parameters()
A saída mostra que não há parâmetros treináveis nesta etapa porque o treinamento já terminou e agora estamos usando o adaptador salvo para inferência e avaliação.
trainable params: 0 || all params: 758,782,784 || trainable%: 0.0000Agora, rodamos novamente a mesma função de avaliação no conjunto de teste. Isso permite medir o quanto o modelo melhorou após o fine-tuning.
print('Post-fine-tuning evaluation')
evaluate_model(test_dataset)
A saída reporta uma acurácia de 0.865 e um F1 score ponderado de 0.8661. Comparado ao baseline, isso mostra um ótimo ganho após o fine-tuning.
Post-fine-tuning evaluation
Accuracy: 0.865
F1: 0.8660926258753361Agora podemos comparar o desempenho do modelo antes e depois do fine-tuning. Tanto a acurácia quanto o F1 score melhoram bastante, mostrando que o fine-tuning com QLoRA ajuda o modelo a se adaptar bem à tarefa de classificação de notícias.
|
Métrica |
Antes do treinamento |
Depois do treinamento |
|
Accuracy |
0.52 |
0.865 |
|
F1 Score |
0.4589 |
0.866 |
Como podemos ver, fazer fine-tuning do Qwen3.5 Small com QLoRA melhora significativamente o desempenho de classificação.
Com a avaliação concluída, podemos enviar o adaptador ajustado e o tokenizer para o Hugging Face. Isso facilita o reuso, o compartilhamento e o carregamento em projetos futuros sem repetir todo o processo de treinamento.
model.push_to_hub("kingabzpro/qwen35-small-news-class")
tokenizer.push_to_hub("kingabzpro/qwen35-small-news-class")
Depois que o upload terminar, o modelo estará disponível em:
Model:
https://huggingface.co/kingabzpro/qwen35-small-news-class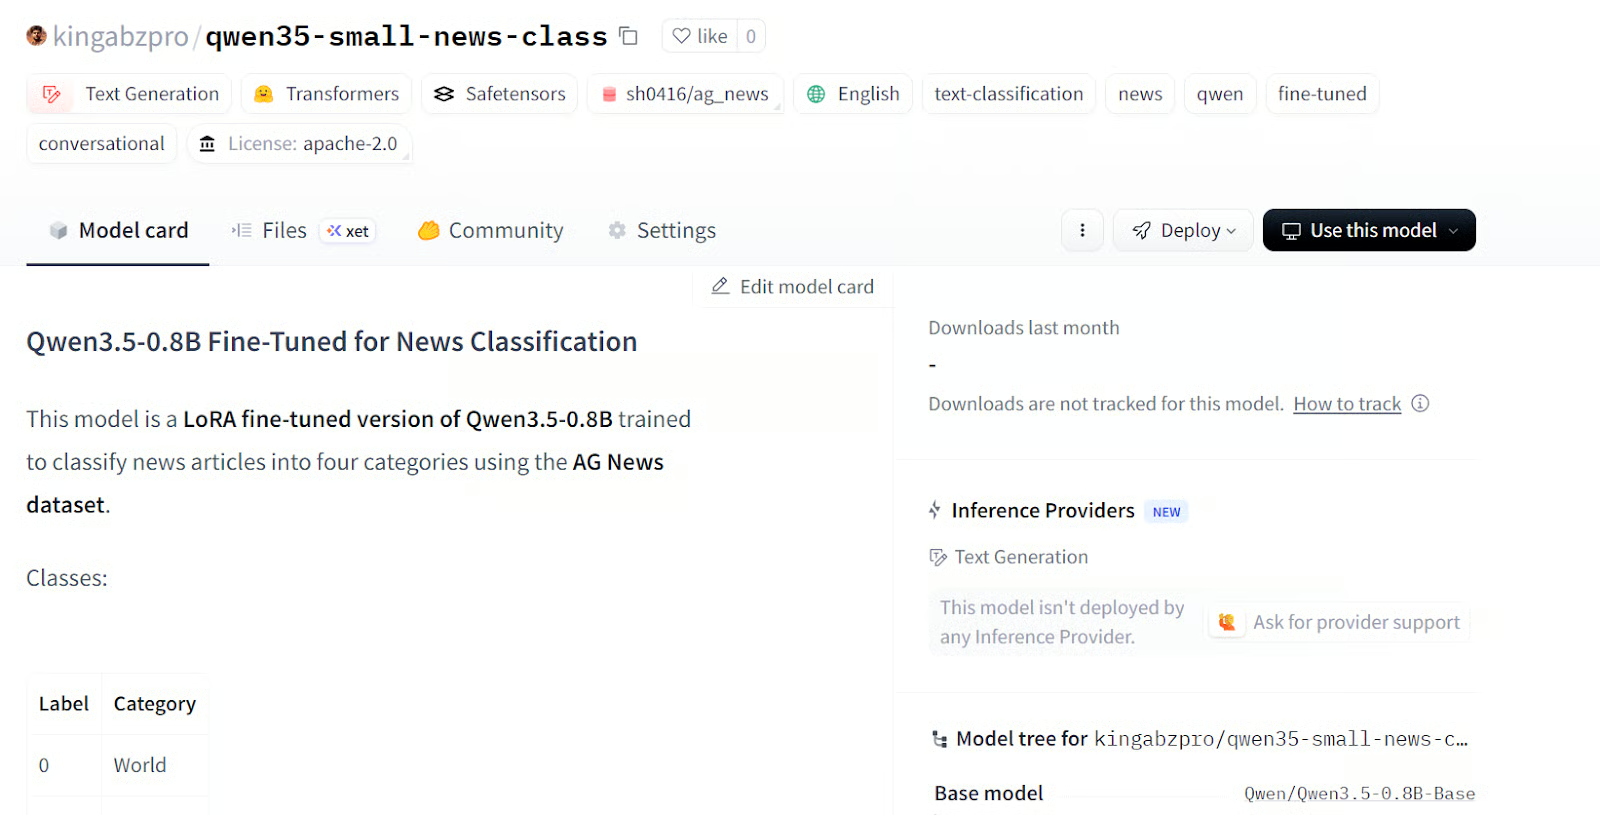
Fonte: kingabzpro/qwen35-small-news-class
O notebook do Kaggle deste tutorial também está disponível. Recomendo usá-lo apenas se você tiver problemas ao reproduzir os passos acima. Você também pode clonar o notebook e rodar no seu próprio sistema, mas lembre-se de atualizar o usuário e o token do Hugging Face para corresponder à sua conta.
Neste tutorial, fizemos fine-tuning do Qwen3.5-0.8B com QLoRA para classificação de notícias e alcançamos um ótimo resultado com uma configuração bem leve. Após apenas uma época em um subconjunto pequeno de dados, a acurácia subiu de 0.52 para 0.865, e o F1 ponderado aumentou de 0.4589 para 0.8661.
Para um modelo tão pequeno, essa é a parte mais surpreendente: não precisamos de um modelo enorme, nem de um dataset gigantesco, nem de um treino longo para obter bons resultados a jusante.
O que torna isso ainda mais útil é o quão prática é a configuração. A Qwen descreve o modelo de 0.8B como um bom encaixe para prototipagem e fine-tuning para tarefas específicas, e o QLoRA mantém o uso de memória baixo ao treinar adaptadores em cima de um modelo base de 4 bits congelado. Isso significa que não é só um fluxo de trabalho para notebook na nuvem. Também é viável testar em GPUs menores de consumidores e notebooks.
Outro motivo pelo qual acho esse modelo interessante é que a família Qwen3.5 suporta fine-tuning de texto e visão. Então, embora tenhamos usado aqui para classificação de texto, a mesma ideia pode se estender a classificação de imagens, image-to-text e text-to-text. Isso torna um modelo pequeno como este uma opção realmente prática quando você quer testar ideias rapidamente, ajustar com baixo custo e ainda manter a implantação leve.
Também recomendo conferir nossos outros recursos, incluindo nosso guia do Qwen3.5 e nosso tutorial sobre como rodar o Qwen3.5 localmente em uma única GPU.
Principais cursos da DataCamp
Curso
Curso
Curso
Tutorial
Moez Ali
11 min
Tutorial
Abid Ali Awan
13 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Josep Ferrer
11 min
Tutorial
Aashi Dutt
14 min
Tutorial
Zoumana Keita
8 min