Cours
Ajustement fin avec Llama 3
2 h
4.1K
Qwen3.5 Small est un modèle pratique pour l’affinage léger, conçu pour le prototypage, l’adaptation à des tâches spécifiques et les workflows de recherche. Associé à QLoRA, nous pouvons l’affiner au-dessus d’un modèle de base figé quantifié en 4 bits, ce qui rend le processus bien plus économe en mémoire et accessible sur un matériel limité.
Dans ce tutoriel, nous allons préparer l’environnement, charger le modèle et le jeu de données AG News, évaluer le modèle de base, puis affiner Qwen3.5 Small pour la classification d’actualités. Nous terminerons en comparant les résultats avant et après l’entraînement, puis nous enregistrerons et publierons l’adaptateur LoRA sur Hugging Face pour réutilisation.
Je vous recommande de suivre le parcours de compétences Hugging Face Fundamentals si vous n’êtes pas encore familiarisé avec la plateforme.
Avant de plonger dans le code, il est utile de comprendre le modèle que nous utilisons. Qwen3.5 est une famille de modèles fondamentaux, et la série « Small » correspond aux versions légères, en dessous de 10 milliards de paramètres. Pour ce tutoriel, nous utiliserons la version 0.8B.
Avec seulement 800 millions de paramètres, Qwen3.5-0.8B reste très performant et extrêmement efficace. Chargé en précision 4 bits, il requiert moins de 2 Go de VRAM. C’est idéal pour des ordinateurs portables grand public, des environnements cloud gratuits comme Kaggle, et des déploiements en périphérie légers.
De plus, l’architecture Qwen3.5 prend en charge une fenêtre de contexte massive de 262 k et la multimodalité native. Même si nous nous concentrons ici sur la classification de texte, les concepts abordés peuvent facilement s’étendre à des tâches de vision par la suite. Le modèle propose aussi un mode de raisonnement hybride, que nous laisserons désactivé afin de maximiser la vitesse d’inférence pour notre tâche d’étiquetage simple.
Dans l’ensemble, Qwen3.5-0.8B est une option très pragmatique pour le prototypage. Il permet de tester rapidement et à faible coût des workflows d’affinage, tout en offrant de solides performances en aval.
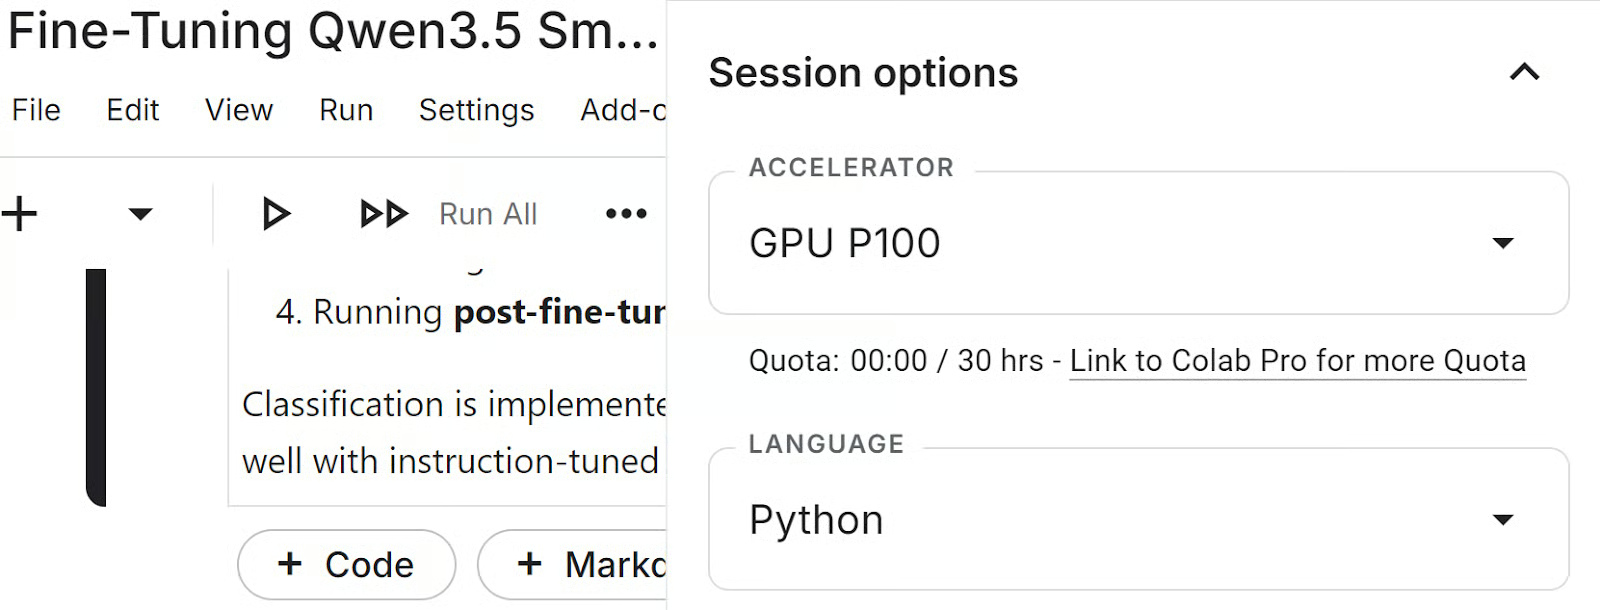
Dans ce tutoriel, nous utiliserons un notebook Kaggle comme environnement d’entraînement. Kaggle nous donne accès à des GPU, ce qui en fait une plateforme pratique pour entraîner, affiner et évaluer notre modèle. Avant d’exécuter le notebook, lancez un nouveau notebook Kaggle, ouvrez les paramètres de la Session et sélectionnez GPU P100 comme accélérateur.
Nous allons maintenant configurer l’environnement, ajouter un jeton Hugging Face à Kaggle et importer les bibliothèques Python utilisées tout au long du tutoriel.
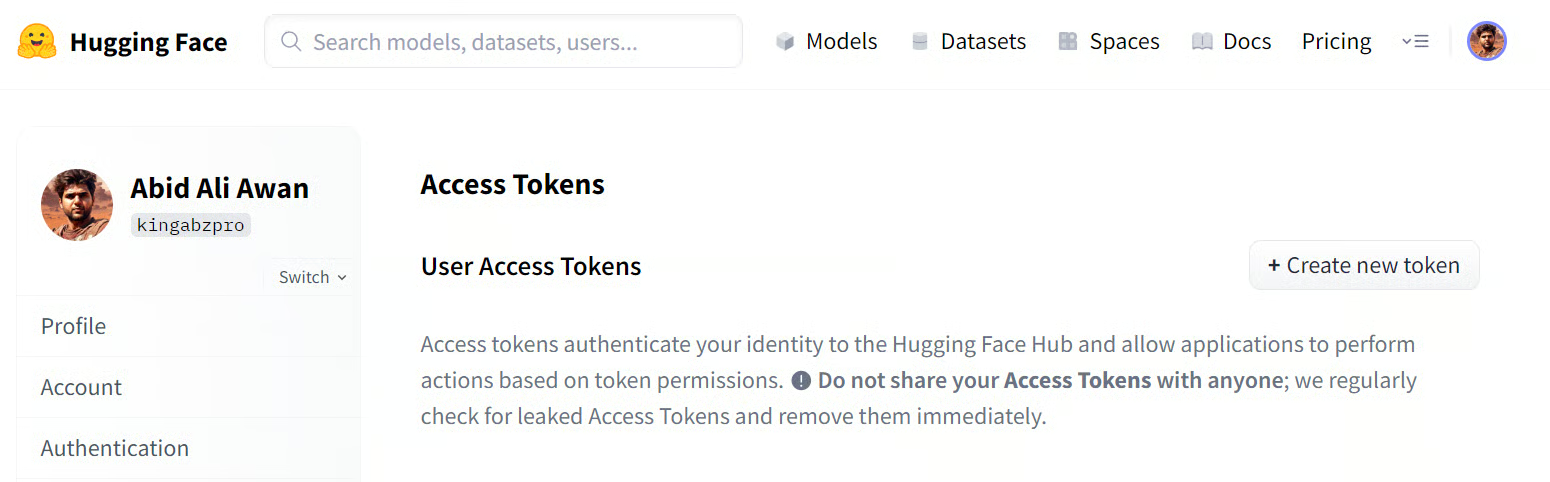
Avant d’exécuter le notebook, créez un jeton d’accès Hugging Face depuis les paramètres de votre compte. Allez dans Settings, ouvrez Access Tokens et générez un nouveau jeton. Si vous souhaitez publier l’adaptateur LoRA affiné sur le Hub Hugging Face à la fin du tutoriel, assurez-vous que le jeton dispose des droits d’écriture.
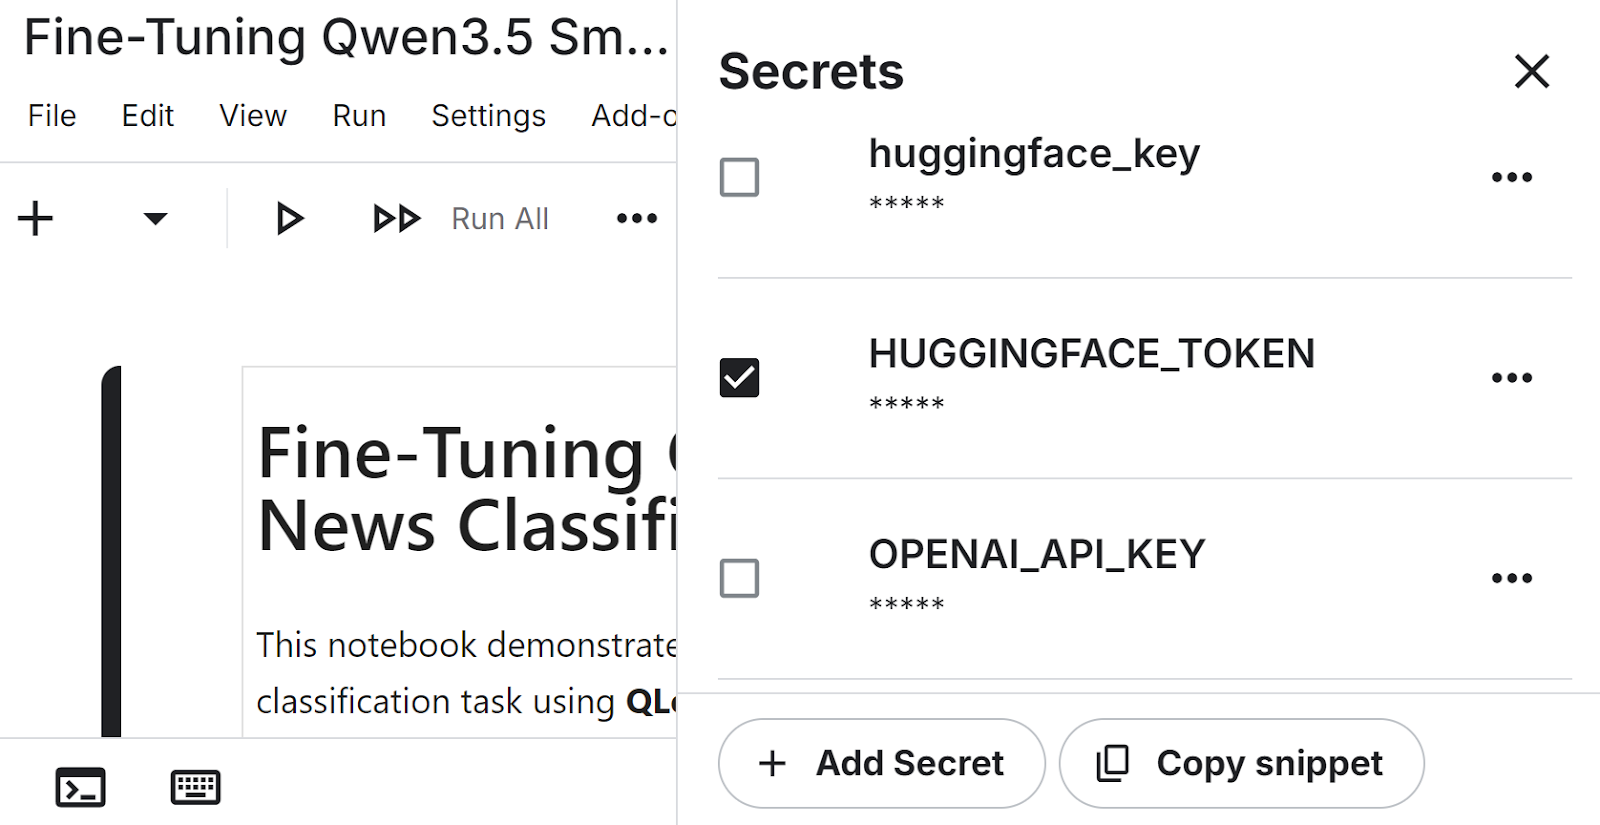
Après avoir généré le jeton, ouvrez votre notebook Kaggle et ajoutez-le comme secret. Dans l’éditeur, allez dans Add-ons puis Secrets, et créez un nouveau secret nommé HUGGINGFACE_TOKEN. Collez la valeur de votre jeton afin que le notebook y accède en toute sécurité sans l’exposer dans le code.
Nous pouvons maintenant installer les principales bibliothèques nécessaires à ce workflow. Ces packages couvrent le chargement de modèle, la quantification, l’affinage économe en paramètres, la gestion de jeux de données et l’évaluation.
!pip install -q -U transformers accelerate
!pip install -q peft trl bitsandbytes datasets scikit-learnNous chargeons ensuite le jeton Hugging Face depuis les secrets Kaggle et l’utilisons pour nous authentifier. Le notebook peut ainsi accéder au modèle et nous pourrons pousser l’adaptateur entraîné par la suite.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient

user_secrets = UserSecretsClient()
login(token=user_secrets.get_secret("HUGGINGFACE_TOKEN"))Enfin, nous importons les bibliothèques Python utilisées tout au long du tutoriel pour le chargement du modèle, l’entraînement, le traitement des jeux de données et l’évaluation.
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig
from transformers import TrainingArguments
from sklearn.metrics import accuracy_score, f1_score
from tqdm.notebook import tqdmMaintenant que l’environnement est prêt, nous pouvons charger le modèle de base et préparer le jeu de données pour l’affinage.
Dans cette section, nous chargerons Qwen3.5-0.8B en précision 4 bits pour rendre l’entraînement plus économe en mémoire, configurerons le tokenizer et chargerons un petit sous-ensemble du jeu de données AG News pour l’entraînement et l’évaluation.
Nous commençons par charger Qwen3.5-0.8B quantifié en 4 bits via BitsAndBytes. Cela réduit l’usage mémoire et rend le modèle plus pratique à utiliser dans un notebook Kaggle.
model_id = "Qwen/Qwen3.5-0.8B"

bnb_config = BitsAndBytesConfig(
  load_in_4bit=True,
  bnb_4bit_quant_type="nf4",
  bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  quantization_config=bnb_config,
  device_map="auto",
  dtype=torch.bfloat16
)Ensuite, nous chargeons le tokenizer du même modèle. Nous définissons également le jeton de padding comme le jeton de fin de séquence afin que le modèle gère correctement le padding pendant l’entraînement et la génération.
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model.config.pad_token_id = tokenizer.eos_token_id
model.generation_config.pad_token_id = tokenizer.eos_token_idEnfin, nous chargeons le jeu de données AG News et créons de plus petits jeux d’entraînement et de test pour ce tutoriel. L’utilisation d’un sous-ensemble accélère le workflow tout en offrant suffisamment de données pour évaluer l’effet de l’affinage.
dataset = load_dataset("ag_news")

train_dataset = dataset["train"].select(range(2500))
test_dataset = dataset["test"].select(range(200))Avant l’affinage, nous devons définir la manière dont le modèle perçoit la tâche et mesurer ses performances dans sa forme d’origine.
Dans cette section, nous allons créer un prompt de type instruction pour la classification d’articles, extraire les prédictions de la sortie du modèle, exécuter une inférence d’exemple, puis évaluer le modèle de base sur le jeu de test avant l’entraînement.
Nous commençons par définir les noms d’étiquettes et construire un prompt qui demande au modèle de classer un article. Le prompt est rédigé pour que le modèle retourne uniquement l’étiquette numérique, ce qui facilite l’analyse de la sortie lors de l’évaluation.
labels = ['World','Sports','Business','Sci/Tech']

def build_prompt(text):

    return f"""
Classify the news article.

Article:
{text}

Return ONLY the number of the correct label.

0 = World
1 = Sports
2 = Business
3 = Sci/Tech

Answer:
"""Nous créons ensuite une petite fonction utilitaire pour extraire l’étiquette prédite du texte généré. Cette fonction supprime d’éventuels jetons de raisonnement et renvoie la classe finale sous forme d’entier.
import re

def extract_label(text):

   text = re.sub(r"<think>.*?</think>", "", text, flags=re.DOTALL)
   matches = re.findall(r"[0-3]", text)

   if matches:
       return int(matches[-1])

return -1Avant d’évaluer le modèle sur l’ensemble du jeu de test, nous l’essayons d’abord sur un exemple unique. Cela permet d’inspecter l’article, de vérifier l’étiquette correcte et d’observer la prédiction du modèle avant l’affinage.
sample = train_dataset[10]

sample_text = sample["text"]
sample_label = sample["label"]

print("Ground truth label:", sample_label)
print("Sample text:")
print(sample_text[:300])
La sortie indique que la véritable étiquette est 2, qui correspond à Business.
Ground truth label: 2
Sample text:
Oil and Economy Cloud Stocks' Outlook  NEW YORK (Reuters) - Soaring crude prices plus worries  about the economy
and the outlook for earnings are expected to  hang over the stock market next week during the depth of the  summer doldrums.
Ensuite, nous formatons le prompt, le passons au modèle et générons une prédiction.
prompt = build_prompt(sample_text)

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

with torch.inference_mode():
    outputs = model.generate(
        **inputs,
        max_new_tokens=5,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id
    )

prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

print("Model prediction (before training):")
print(extract_label(prediction))
Le modèle prédit également 2, il classe donc correctement cet exemple. Cela confirme rapidement que le format du prompt et le pipeline de prédiction fonctionnent comme prévu.
Model prediction (before training):
2Nous évaluons maintenant le modèle de base sur le jeu de test pour établir une référence. Cela nous donne un point de comparaison avant/après l’affinage.
def evaluate_model(dataset):

    preds = []
    refs = []

    model.eval()

    for example in tqdm(dataset):

        text = example["text"]
        label = example["label"]

        prompt = build_prompt(text)

        inputs = tokenizer(prompt, return_tensors="pt", truncation=True)
        inputs = {k: v.to("cuda") for k, v in inputs.items()}

        with torch.inference_mode():

            outputs = model.generate(
                **inputs,
                max_new_tokens=5,
                do_sample=False,
                pad_token_id=tokenizer.eos_token_id
            )

        prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

        pred_label = extract_label(prediction)

        preds.append(pred_label)
        refs.append(label)

    acc = accuracy_score(refs, preds)
    f1 = f1_score(refs, preds, average="weighted")

    print("Accuracy:", acc)
    print("F1:", f1)


print('Pre-fine-tuning evaluation')
evaluate_model(test_dataset)
La sortie indique une accuracy de 0.52 et un score F1 pondéré de 0.4589. Ces résultats de référence montrent que le modèle sait déjà partiellement effectuer la tâche, tout en laissant une belle marge de progression via l’affinage.
Pre-fine-tuning evaluation
Accuracy: 0.52
F1: 0.45889163289429247Maintenant que nous avons une base de comparaison, nous pouvons affiner le modèle sur la tâche de classification d’actualités. Dans cette section, nous allons formater les données d’entraînement, configurer les adaptateurs LoRA, définir les paramètres d’entraînement, entraîner le modèle, puis enregistrer l’adaptateur final pour une utilisation ultérieure.
Nous formatons d’abord chaque exemple d’entraînement pour qu’il corresponde à la même structure de prompt utilisée à l’inférence. Nous ajoutons l’étiquette correcte à la fin du prompt afin que le modèle apprenne à générer la bonne réponse pendant l’affinage.
def format_train(example):
    prompt = build_prompt(example['text'])
    answer = str(example['label'])
    return {'text': prompt + ' ' + answer}

train_dataset = train_dataset.map(format_train)Nous définissons ensuite la configuration LoRA. Elle indique au modèle quelles couches adapter pendant l’affinage, ce qui nous permet d’entraîner un petit ensemble de paramètres supplémentaires plutôt que de mettre à jour tout le modèle.
lora_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    bias='none',
    task_type='CAUSAL_LM',
    target_modules=[
        'q_proj','k_proj','v_proj','o_proj',
        'gate_proj','up_proj','down_proj'
    ]
)Nous définissons ensuite les arguments d’entraînement pour l’affinage supervisé. Ces réglages contrôlent le nombre d’exemples traités simultanément, l’accumulation de gradients, la durée de l’entraînement et l’emplacement des sorties.
training_args = SFTConfig(
    output_dir="./qwen35-lora",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=1,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    packing=False,
)Nous initialisons à présent le trainer avec le modèle, le jeu de données, la configuration LoRA, les paramètres d’entraînement et le tokenizer. Puis nous lançons l’affinage sur le jeu d’entraînement AG News formaté.
trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer
)
trainer.train()
Sortie :
TrainOutput(global_step=157, training_loss=1.9094241804378047, metrics={'train_runtime': 616.477, 'train_samples_per_second': 4.055, 'train_steps_per_second': 0.255, 'total_flos': 1041693973114368.0, 'train_loss': 1.9094241804378047})Une fois l’entraînement terminé, nous enregistrons l’adaptateur LoRA et le tokenizer. Nous pourrons ainsi recharger l’adaptateur affiné plus tard pour l’évaluation, le partage ou la publication sur Hugging Face.
trainer.model.save_pretrained("qwen35-small-news-class")
tokenizer.save_pretrained("qwen35-small-news-class")Après l’entraînement, nous rechargeons le modèle de base et attachons l’adaptateur LoRA sauvegardé. Nous pouvons ainsi lancer l’évaluation avec les poids affinés et comparer aux résultats de référence précédents.
Nous rechargeons d’abord le modèle Qwen3.5 de base, puis nous attachons l’adaptateur LoRA affiné enregistré dans le répertoire de travail Kaggle. Ensuite, nous passons le modèle en mode évaluation et consultons le récapitulatif des paramètres entraînables.
from transformers import AutoModelForCausalLM
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype=torch.bfloat16
)


from peft import PeftModel

model = PeftModel.from_pretrained(
    base_model,
    "/kaggle/working/qwen35-small-news-class"
)

model.eval()
model.print_trainable_parameters()
La sortie montre qu’il n’y a plus de paramètres entraînables à ce stade : l’entraînement est terminé et nous utilisons désormais l’adaptateur sauvegardé pour l’inférence et l’évaluation.
trainable params: 0 || all params: 758,782,784 || trainable%: 0.0000Nous relançons ensuite la même fonction d’évaluation sur le jeu de test. Cela nous permet de mesurer l’amélioration après l’affinage.
print('Post-fine-tuning evaluation')
evaluate_model(test_dataset)
La sortie indique une accuracy de 0.865 et un score F1 pondéré de 0.8661. Comparé à la référence, cela montre une nette amélioration après l’affinage.
Post-fine-tuning evaluation
Accuracy: 0.865
F1: 0.8660926258753361Nous pouvons maintenant comparer les performances du modèle avant et après l’affinage. L’accuracy comme le score F1 s’améliorent sensiblement, montrant que l’affinage QLoRA aide le modèle à bien s’adapter à la classification d’actualités.
|
Métrique |
Avant l’entraînement |
Après l’entraînement |
|
Accuracy |
0.52 |
0.865 |
|
Score F1 |
0.4589 |
0.866 |
Comme on le voit, affiner Qwen3.5 Small avec QLoRA améliore fortement les performances de classification.
Une fois l’évaluation terminée, nous pouvons téléverser l’adaptateur affiné et le tokenizer sur Hugging Face. Le modèle devient plus facile à réutiliser, partager et charger dans de futurs projets sans répéter tout l’entraînement.
model.push_to_hub("kingabzpro/qwen35-small-news-class")
tokenizer.push_to_hub("kingabzpro/qwen35-small-news-class")
Après la fin du téléversement, le modèle sera disponible à l’adresse :
Model:
https://huggingface.co/kingabzpro/qwen35-small-news-class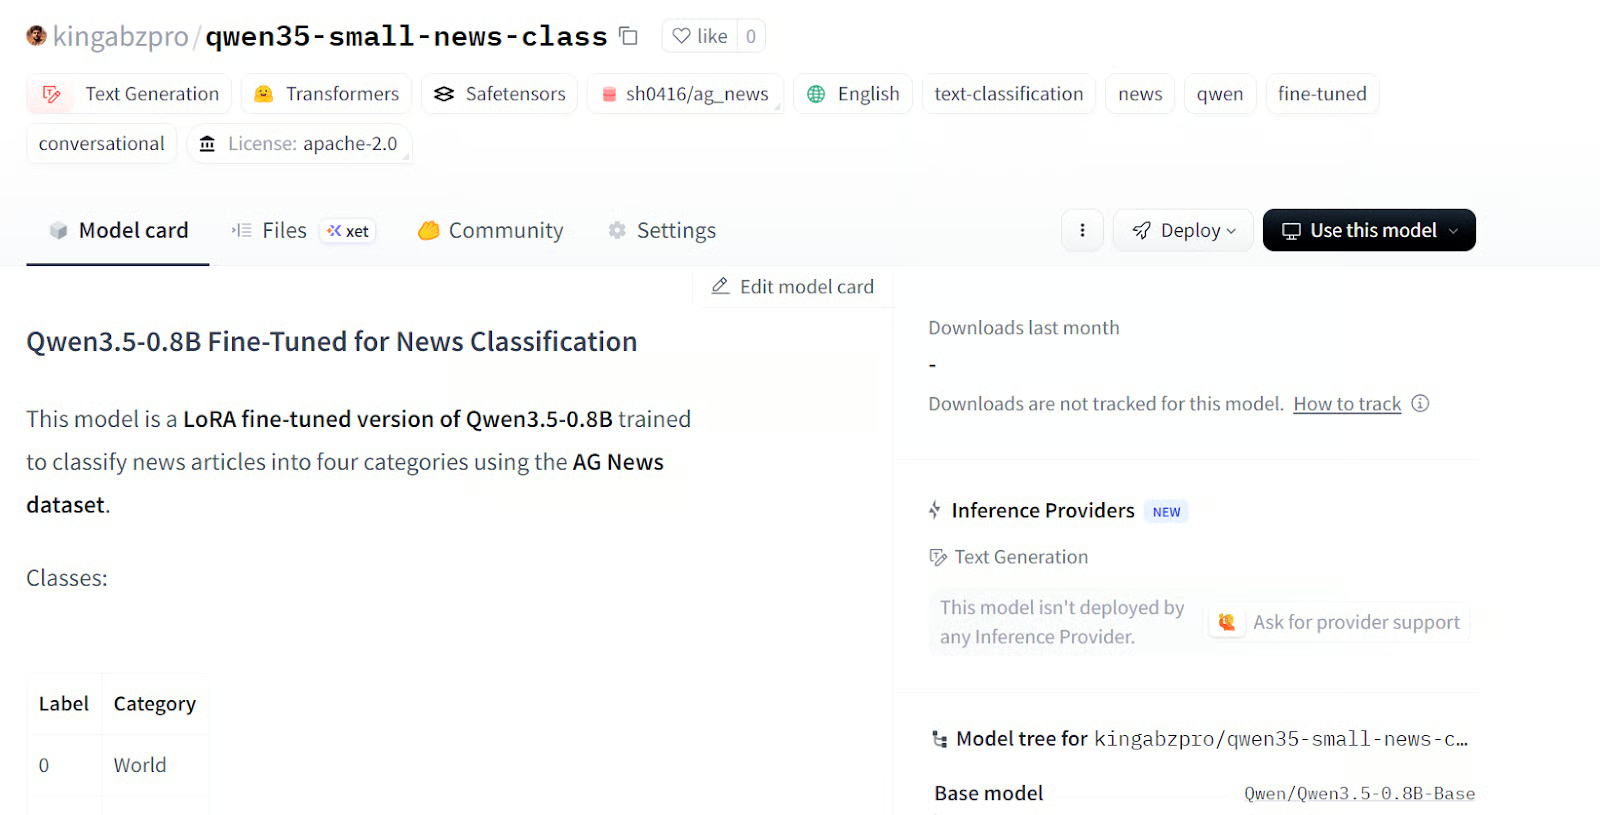
Source : kingabzpro/qwen35-small-news-class
Le notebook Kaggle de ce tutoriel est également disponible. Nous vous conseillons de ne l’utiliser qu’en cas de difficulté à reproduire les étapes ci-dessus. Vous pouvez aussi cloner le notebook et l’exécuter sur votre propre système, mais n’oubliez pas de mettre à jour le nom d’utilisateur et le jeton Hugging Face pour correspondre à votre compte.
Dans ce tutoriel, nous avons affiné Qwen3.5-0.8B avec QLoRA pour la classification d’actualités, et obtenu d’excellents résultats avec une configuration très légère. Après une seule époque sur un petit sous-ensemble de données, l’accuracy est passée de 0.52 à 0.865, et le F1 pondéré de 0.4589 à 0.8661.
Pour un modèle aussi petit, c’est d’ailleurs ce qui surprend le plus : pas besoin d’un énorme modèle, d’un gigantesque jeu de données ni d’un entraînement long pour obtenir de bons résultats en aval.
Ce qui rend le tout encore plus utile, c’est le caractère très pratique de la configuration. Qwen présente le modèle 0.8B comme adapté au prototypage et à l’affinage spécifique à une tâche, et QLoRA maintient une faible empreinte mémoire en entraînant des adaptateurs au-dessus d’un modèle de base 4 bits figé. Autrement dit, ce n’est pas qu’un workflow sur notebook cloud : c’est aussi réaliste pour des tests sur des GPU d’ordinateurs portables et grand public.
Autre point enthousiasmant : la famille Qwen3.5 prend en charge l’affinage texte et vision. Nous l’avons utilisée ici pour de la classification de texte, mais la même logique s’étend à la classification d’images, image-vers-texte et texte-vers-texte. Cela fait d’un petit modèle comme celui-ci une option très pratique pour tester vite, affiner à moindre coût et conserver un déploiement léger.
Je vous recommande également de découvrir nos autres ressources, notamment notre guide de Qwen3.5 et notre tutoriel pour exécuter Qwen3.5 en local sur un seul GPU.
Les meilleurs cours DataCamp
Cours
Cours
Cours
blog
Lynn Heidmann
blog
Kurtis Pykes
9 min
blog
Zoumana Keita
15 min
blog
Tutoriel
Tutoriel
Josef Waples
8 min