
Last chance! 50% off DataCamp Premium
Sale ends in
Anda akan menggunakan dataset sidik jari FVC2002 untuk melatih jaringan Anda. Untuk mengamati efektivitas model, Anda akan menguji model pada dua dataset sensor sidik jari yang berbeda, yaitu sensor Secugen dan Lumidigm.
Catatan : Tutorial ini terutama membahas implementasi praktis convolutional autoencoder. Jadi, jika Anda belum memahami convolutional neural network (CNN) dan autoencoder, sebaiknya melihat tutorial CNN dan Autoencoder.
Singkatnya, Anda akan membahas topik-topik berikut dalam tutorial hari ini:
Sebelum Anda lanjut memuat data, ada baiknya melihat lebih dulu apa yang sebenarnya akan Anda kerjakan! Dataset sidik jari FVC2002 adalah dataset Fingerprint Verification Competition yang diselenggarakan pada tahun 2000 dan kemudian pada tahun 2002. Dataset ini terdiri dari empat jenis sensor sidik jari yang berbeda yaitu Low-cost Optical Sensor, Low-cost Capacitive Sensor, Optical Sensor, dan Synthetic Generator, masing-masing sensor memiliki ukuran gambar yang bervariasi. Dataset memiliki 3200 gambar di set A, 800 gambar per sensor. Anda bisa memeriksanya lagi nanti saat data sudah dimuat! ;)
Dataset Sidik Jari tidak didefinisikan sebelumnya di kerangka Keras atau TensorFlow, jadi Anda harus mengunduh data dari sumber ini. Anda akan melihat cara melakukannya di bagian berikutnya!
Catatan : Sebelum mulai, harap perhatikan bahwa model akan dilatih pada sistem dengan GPU Nvidia 1080 Ti, prosesor Xeon e5 GeForce, dan RAM 32GB. Jika Anda menggunakan Jupyter Notebook, Anda perlu menambahkan tiga baris kode lagi untuk menentukan urutan perangkat CUDA dan perangkat CUDA yang terlihat menggunakan modul bernama os.
Pada kode di bawah, Anda pada dasarnya menetapkan variabel lingkungan di notebook menggunakan os.environ. Sebaiknya lakukan hal berikut sebelum menginisialisasi Keras untuk membatasi backend Keras TensorFlow menggunakan GPU pertama. Jika mesin tempat Anda melatih memiliki GPU pada 0, pastikan menggunakan 0 alih-alih 1. Anda dapat memeriksanya dengan menjalankan perintah sederhana di terminal: misalnya, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Pertama, Anda mengimpor semua modul yang diperlukan seperti cv2, numpy, matplotlib dan yang terpenting keras, karena Anda akan menggunakan kerangka tersebut dalam tutorial hari ini!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Setelah data dimuat, Anda siap menganalisis data untuk mendapatkan intuisi tentang dataset yang akan Anda gunakan pada tutorial hari ini!
Sekarang mari analisis seperti apa tampilan gambar dalam dataset dan juga lihat dimensi gambar dengan bantuan atribut array NumPy .shape:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Dari keluaran di atas, Anda dapat melihat bahwa data memiliki bentuk 3200 x 224 x 224 karena ada 3200 sampel masing-masing berupa matriks berdimensi 224 x 224.
Sekarang, mari lihat beberapa gambar dalam dataset Anda:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
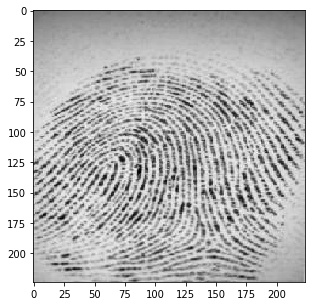
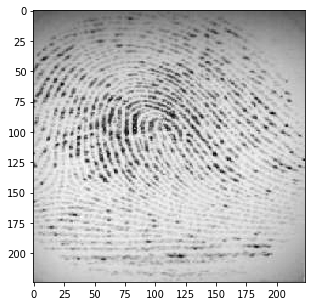
Keluaran dari dua plot di atas berasal dari dataset. Anda dapat melihat bahwa sidik jarinya tidak terlalu jelas; akan menarik untuk melihat apakah convolutional autoencoder mampu mempelajari fitur-fiturnya dan merekonstruksi gambar-gambar ini dengan baik.
Gambar pada dataset memang merupakan citra skala abu-abu dengan nilai piksel berkisar antara 0 hingga 255 dengan dimensi 224 x 224, jadi sebelum Anda memasukkan data ke dalam model, sangat penting untuk melakukan prapemrosesan. Anda akan terlebih dahulu mengonversi setiap gambar 224 x 224 dari dataset menjadi matriks berukuran 224 x 224 x 1, yang kemudian dapat Anda masukkan ke dalam jaringan:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Berikutnya, pastikan untuk memeriksa tipe data array NumPy; seharusnya dalam format float32, jika belum Anda perlu mengonversinya ke format ini, Anda juga harus menskalakan ulang nilai piksel dalam rentang 0 - 1 inklusif. Mari kita lakukan!
Pertama, mari verifikasi tipe datanya:
images_arr.dtype
dtype('float32')
Berikutnya, skala ulang data dengan nilai piksel maksimum dari gambar dalam data:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Mari verifikasi nilai maksimum dan minimum data yang seharusnya 0.0 dan 1.0 setelah diskalakan ulang!
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Setelah semua ini, penting untuk membagi data. Agar model Anda dapat melakukan generalisasi dengan baik, Anda membagi data menjadi dua bagian: set pelatihan dan validasi. Anda akan melatih model pada 80% data dan memvalidasinya pada 20% sisa data pelatihan.
Ini juga akan membantu mengurangi kemungkinan overfitting, karena Anda akan memvalidasi model pada data yang tidak dilihat selama fase pelatihan.
Anda dapat menggunakan modul train_test_split dari scikit-learn untuk membagi data dengan baik:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Catatan bahwa untuk tugas ini, Anda tidak memerlukan label pelatihan dan pengujian. Itulah mengapa Anda akan meneruskan gambar pelatihan dua kali. Gambar pelatihan akan bertindak sebagai masukan sekaligus ground truth serupa dengan label pada tugas klasifikasi.
Sekarang Anda siap mendefinisikan jaringan dan memasukkan data ke dalamnya. Tanpa berlama-lama, mari lanjut ke langkah berikutnya!
Gambar berukuran 224 x 224 x 1 atau vektor berdimensi 50.176. Anda mengonversi matriks gambar menjadi array, menskalakannya antara 0 dan 1, mengubah bentuknya sehingga berukuran 224 x 224 x 1, dan memasukkannya sebagai input ke jaringan.
Selain itu, Anda akan menggunakan ukuran batch 128; menggunakan ukuran batch yang lebih besar 256 atau 512 juga disarankan—semuanya tergantung pada sistem tempat Anda melatih model. Ini sangat berkontribusi dalam menentukan parameter pembelajaran dan memengaruhi akurasi prediksi. Anda akan melatih jaringan selama 50 epoch.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Seperti yang mungkin sudah Anda ketahui, autoencoder terbagi menjadi dua bagian: encoder dan decoder.
Encoder
Decoder
Lapisan max-pooling akan melakukan downsampling input dua kali setiap kali digunakan, sedangkan lapisan upsampling akan melakukan upsampling input dua kali setiap kali digunakan.
Catatan: Jumlah filter, ukuran filter, jumlah lapisan, jumlah epoch Anda melatih model—semuanya adalah hiperparameter dan sebaiknya diputuskan berdasarkan intuisi Anda sendiri. Anda bebas mencoba eksperimen baru dengan mengutak-atik hiperparameter ini dan mengukur kinerja model. Di situlah Anda perlahan belajar seni deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Setelah model dibuat, Anda harus mengomponnya dengan optimizer RMSProp.
Perhatikan bahwa Anda juga harus menentukan jenis loss melalui argumen loss. Dalam kasus ini, yaitu mean squared error, karena loss setelah setiap batch akan dihitung antara batch keluaran yang diprediksi dan ground truth menggunakan mean squared error piksel demi piksel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Mari visualisasikan lapisan yang Anda buat pada langkah di atas dengan fungsi summary; ini akan menampilkan jumlah parameter (bobot dan bias) di setiap lapisan dan juga total parameter dalam model Anda.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Akhirnya saatnya melatih model dengan fungsi fit() Keras! Model dilatih selama 200 epoch. Fungsi fit() akan mengembalikan objek history; Dengan menyimpan hasil fungsi ini di fashion_train, Anda dapat menggunakannya nanti untuk membuat plot fungsi loss antara pelatihan dan validasi yang akan membantu Anda menganalisis kinerja model secara visual.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Akhirnya! Anda telah melatih model pada dataset sidik jari selama 200 epoch. Sekarang, mari plot grafik loss antara data pelatihan dan validasi untuk memvisualisasikan kinerja model.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
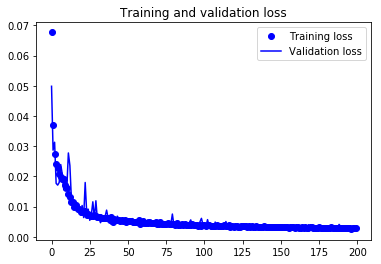
Akhirnya, Anda dapat melihat bahwa validation loss dan training loss selaras. Ini menunjukkan bahwa model Anda tidak overfitting: validation loss menurun dan tidak meningkat, serta jarak antara training dan validation loss hampir tidak ada terutama setelah pelatihan melewati epoch ke-40.
Oleh karena itu, Anda dapat mengatakan bahwa kemampuan generalisasi model Anda baik.
Terakhir, saatnya merekonstruksi gambar uji menggunakan fungsi predict() Keras dan melihat seberapa baik model Anda mampu merekonstruksi data uji.
Sekarang mari simpan model yang telah dilatih. Ini adalah langkah penting saat Anda bekerja dengan Deep Learning. Karena bobot adalah inti dari solusi untuk masalah yang sedang Anda tangani!
Anda kapan saja dapat memuat bobot yang disimpan ke model yang sama dan melatihnya dari titik terakhir pelatihan berhenti. Misalnya, jika model di atas dilatih kembali, parameter seperti bobot, bias, fungsi loss, dll. tidak akan mulai dari awal dan itu tidak lagi merupakan pelatihan baru.
Hanya dengan satu baris kode, Anda dapat menyimpan dan memuat kembali bobot ke dalam model.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Karena di sini Anda tidak memiliki data pengujian, mari gunakan data validasi untuk melakukan prediksi pada model yang baru saja Anda latih.
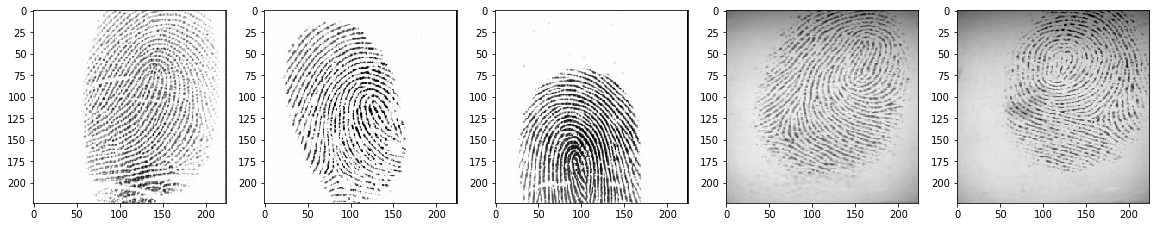
Anda akan memprediksi model terlatih pada 640 gambar validasi yang tersisa dan memplot beberapa gambar yang direkonstruksi untuk memvisualisasikan seberapa baik model Anda mampu merekonstruksi gambar validasi.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
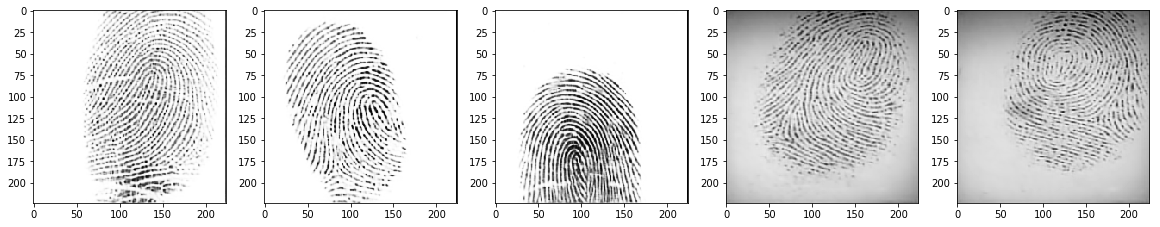
Dari gambar-gambar di atas, Anda dapat mengamati bahwa model Anda melakukan pekerjaan yang sangat baik dalam merekonstruksi gambar uji yang Anda prediksi menggunakan model. Setidaknya secara visual, gambar uji dan gambar yang direkonstruksi terlihat hampir persis serupa.
Seperti yang Anda lihat pada plot pelatihan vs. validasi bahwa model Anda melakukan generalisasi dengan baik pada data yang belum dilihat. Sekarang saatnya menguji ketangguhannya dengan data sensor yang benar-benar berbeda.
Anda akan menguji model pada dua jenis sensor yang berbeda.
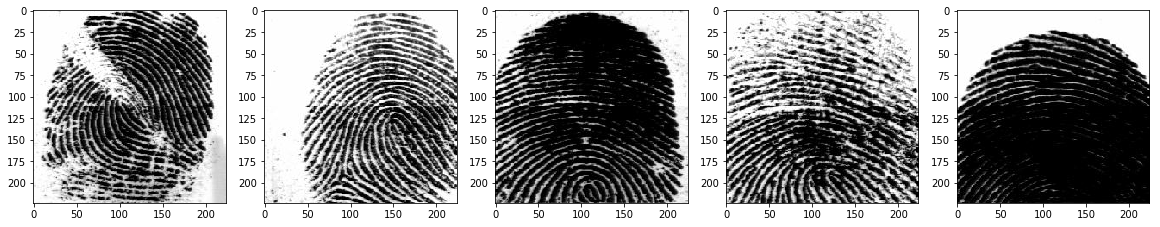
Pertama, mari uji model Anda pada data sensor sidik jari berkualitas rendah yaitu Secugen dan lihat seberapa baik kinerja model!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
Reconstruction of Test Secugen Images
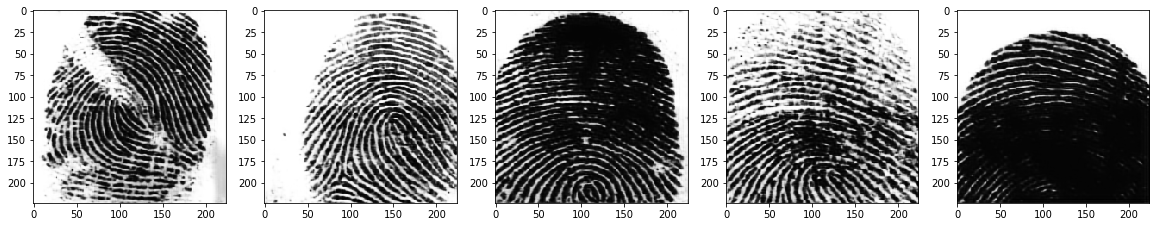
Dari gambar-gambar di atas, Anda dapat mengamati bahwa model Anda melakukan pekerjaan yang hebat dalam merekonstruksi gambar Secugen yang Anda prediksi menggunakan model terlatih. Menakjubkan, bukan?
Sekarang, mari uji model Anda pada gambar sensor dengan kualitas yang cukup baik yaitu Lumidigm
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
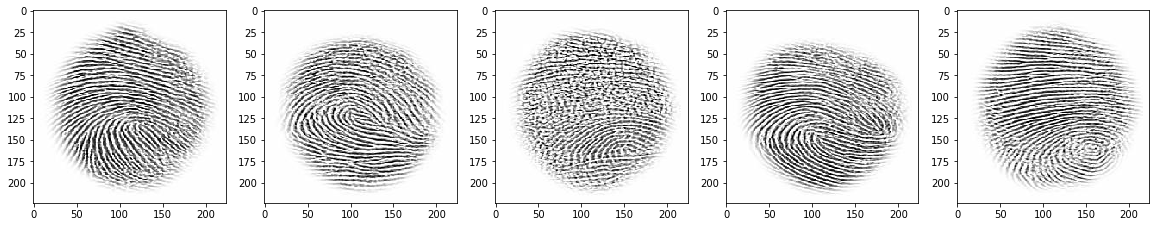
Reconstruction of Test Lumidigm Images
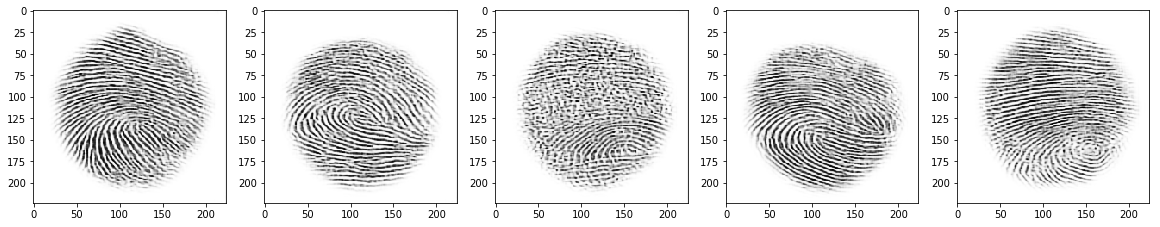
Dari gambar-gambar di atas, Anda dapat mengamati bahwa model Anda kembali melakukan pekerjaan yang sangat baik dalam merekonstruksi gambar lumidigm yang Anda prediksi menggunakan model terlatih.
Tutorial ini merupakan awal yang baik untuk memahami cara membaca gambar dari nol, menganalisis, melakukan prapemrosesan, dan memasukkannya ke dalam model menggunakan dataset sidik jari. Ini menunjukkan salah satu penerapan autoencoder yang menarik secara praktis. Jika Anda dapat mengikutinya dengan mudah atau bahkan dengan sedikit usaha ekstra, bagus!
Pada tutorial berikutnya, Anda akan mempelajari cara membaca citra medis modality T-1 dan merekonstruksinya menggunakan autoencoder!
Masih banyak yang harus dipelajari, jadi mengapa tidak mengikuti kursus Deep Learning in Python dari DataCamp? Jika Anda belum melakukannya. Anda akan belajar dari dasar dan perlahan beranjak menguasai ranah deep learning; ini pasti akan menjadi sumber yang sangat berguna saat Anda belajar bekerja dengan convolutional neural networks di Python, cara mendeteksi wajah, objek, dan lain-lain.
Kursus Python
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt




