Curso
Introdução ao Python
4 h
7M
Você vai usar o dataset de impressões digitais FVC2002 para treinar sua rede. Para observar a eficácia do modelo, vamos testá-lo em dois datasets de sensores de impressões digitais diferentes: Secugen e Lumidigm.
Observação: este tutorial foca principalmente na implementação prática de autoencoders convolucionais. Então, se você ainda não está familiarizado com redes neurais convolucionais (CNN) e autoencoders, vale a pena conferir os tutoriais de CNN e Autoencoder.
Em resumo, hoje você vai abordar os seguintes tópicos:
Antes de carregar os dados, é bom dar uma olhada no que você vai trabalhar! O dataset FVC2002 é da Fingerprint Verification Competition, organizada no ano 2000 e novamente em 2002. Ele reúne impressões digitais de quatro sensores diferentes: Low-cost Optical Sensor, Low-cost Capacitive Sensor, Optical Sensor e Synthetic Generator, cada um com tamanhos de imagem distintos. O conjunto A tem 3200 imagens, sendo 800 por sensor. Você pode confirmar isso quando carregar os dados! ;)
Esse dataset não vem pré-definido no Keras ou no TensorFlow, então você precisará baixá-lo nesta fonte. Na próxima seção, você verá como fazer isso!
Observação: antes de começar, note que o modelo será treinado em um sistema com GPU Nvidia 1080 Ti, processador Xeon e5 GeForce e 32 GB de RAM. Se estiver usando Jupyter Notebook, adicione três linhas de código para especificar a ordem de dispositivos CUDA e as GPUs visíveis usando o módulo os.
No código abaixo, você define variáveis de ambiente no notebook com os.environ. É uma boa prática fazer isso antes de inicializar o Keras para limitar o backend TensorFlow a usar a primeira GPU. Se a máquina em que você treina tiver a GPU em 0, use 0 em vez de 1. Você pode verificar rodando no terminal, por exemplo: nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Primeiro, importe os módulos necessários como cv2, numpy, matplotlib e, principalmente, o keras, já que ele será o framework usado neste tutorial!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Com os dados carregados, já dá para começar a analisá-los e ganhar intuição sobre o dataset com o qual vamos trabalhar hoje!
Vamos ver como são as imagens do dataset e também checar a dimensão delas com o atributo .shape do array NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Pelo output acima, dá para ver que os dados têm shape 3200 x 224 x 224, já que existem 3200 amostras, cada uma com uma matriz 224 x 224.
Agora, vamos visualizar algumas imagens do dataset:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
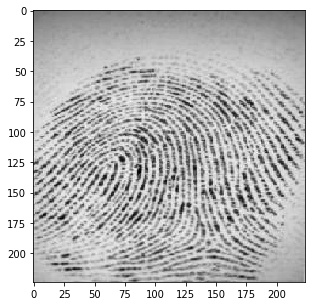
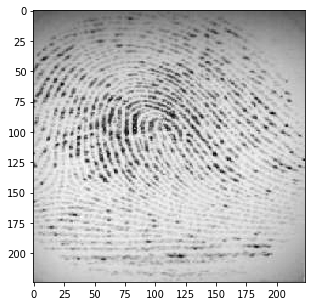
Os dois gráficos acima são do dataset. As impressões digitais não estão muito nítidas; vai ser interessante ver se o autoencoder convolucional consegue aprender as características e reconstruir essas imagens direitinho.
As imagens do dataset são em tons de cinza, com valores de pixel de 0 a 255 e dimensão 224 x 224. Antes de alimentar o modelo, é essencial pré-processar. Primeiro, vamos converter cada imagem 224 x 224 em uma matriz 224 x 224 x 1, que será a entrada da rede:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Em seguida, verifique o tipo dos dados do array NumPy; deve ser float32. Se não for, converta. Também vamos reescalar os valores de pixel para o intervalo 0 a 1. Vamos lá!
Primeiro, confira o tipo:
images_arr.dtype
dtype('float32')
Agora, reescale usando o valor máximo dos pixels nas imagens:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Vamos verificar os valores máximo e mínimo após o reescalonamento (devem ser 0,0 e 1,0):
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Depois disso, é importante particionar os dados. Para o modelo generalizar bem, vamos dividir em treino e validação. Vamos treinar com 80% dos dados e validar com 20%.
Isso também ajuda a reduzir o risco de overfitting, já que a validação ocorre em dados não vistos durante o treino.
Use o train_test_split do scikit-learn para dividir corretamente:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Observação: para esta tarefa, você não precisa de rótulos de treino e teste. Por isso, passamos as imagens de treino duas vezes. Suas imagens de treino atuam como entrada e também como ground truth, assim como rótulos em uma tarefa de classificação.
Pronto! Agora vamos definir a rede e alimentar os dados. Sem mais demora, bora para a próxima etapa!
As imagens têm tamanho 224 x 224 x 1, ou um vetor de 50.176 dimensões. Convertendo a matriz em array, reescalando entre 0 e 1 e remodelando para 224 x 224 x 1, alimentamos isso como entrada da rede.
Vamos usar batch size de 128; valores maiores como 256 ou 512 também funcionam, dependendo do seu hardware. O batch size influencia bastante os parâmetros de aprendizagem e a acurácia das previsões. Vamos treinar por 50 épocas.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Como você já deve saber, um autoencoder tem duas partes: encoder e decoder.
Encoder
Decoder
A camada de max-pooling reduz a entrada pela metade a cada uso, enquanto a de upsampling faz o oposto, dobrando a dimensão.
Observação: a quantidade e o tamanho dos filtros, o número de camadas, o número de épocas de treino, tudo isso são hiperparâmetros e devem ser definidos com base na sua intuição. Fique à vontade para experimentar e medir o desempenho. É assim que você evolui em deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Depois de criar o modelo, compile usando o otimizador RMSProp.
Também é preciso especificar o tipo de loss via o parâmetro loss. Aqui usamos mean squared error, já que a perda após cada batch é calculada entre a saída prevista e o ground truth, pixel a pixel:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Vamos visualizar as camadas criadas usando summary; isso mostra o número de parâmetros (pesos e vieses) por camada e o total do modelo.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Chegou a hora de treinar o modelo com a função fit() do Keras! O modelo treina por 200 épocas. A fit() retorna um objeto de histórico; ao armazená-lo em fashion_train, você pode depois plotar os gráficos de loss de treino e validação para analisar o desempenho visualmente.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Pronto! Você treinou o modelo no dataset de impressões digitais por 200 épocas. Agora, vamos plotar os gráficos de loss de treino e validação para visualizar o desempenho.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
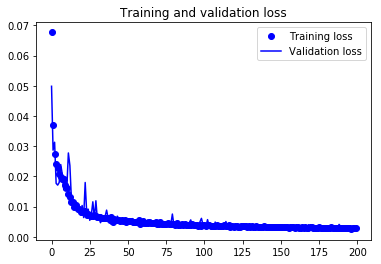
Como dá para ver, as curvas de loss de validação e de treino estão alinhadas. Isso indica que o modelo não está overfittando: a loss de validação diminui (não aumenta) e quase não há gap entre as curvas, especialmente depois da 40ª época.
Ou seja, a capacidade de generalização do modelo está boa.
Agora é hora de reconstruir as imagens de teste com a função predict() do Keras e ver como o modelo se sai.
Vamos salvar o modelo treinado. Isso é essencial em Deep Learning, já que os pesos são o coração da solução.
Você pode carregar os pesos salvos no mesmo modelo a qualquer momento e retomar o treino de onde parou. Por exemplo, ao treinar novamente, parâmetros como pesos, vieses e até a função de loss não começam do zero; não é mais um treino do zero.
Com apenas uma linha de código, você pode salvar e carregar os pesos no modelo.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Como não há um conjunto de teste separado aqui, vamos usar os dados de validação para prever com o modelo que você acabou de treinar.
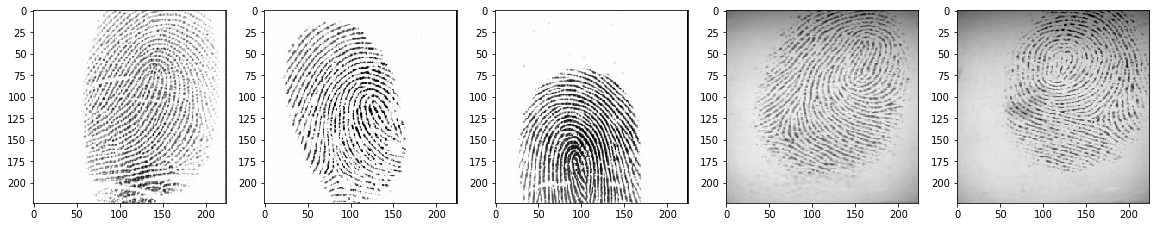
Vamos gerar previsões para as 640 imagens de validação e plotar algumas reconstruções para visualizar o quão bem o modelo reconstrói.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
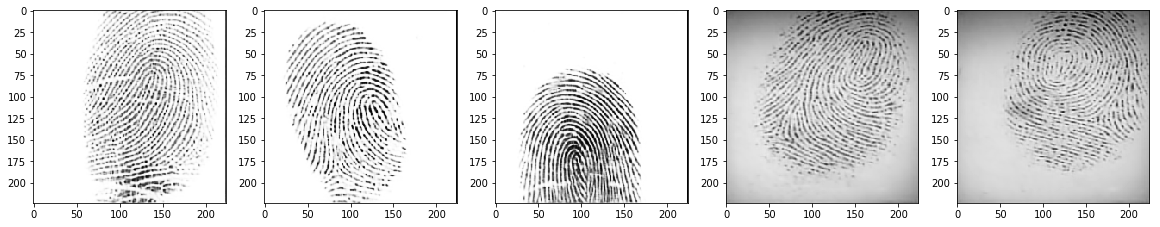
Pelos gráficos acima, dá para ver que o modelo fez um ótimo trabalho reconstruindo as imagens de teste. Visualmente, os pares original e reconstruído são quase idênticos.
Como vimos no gráfico de treino vs. validação, seu modelo generalizou bem para dados não vistos. Agora é hora de testar a robustez com dados de sensores diferentes.
Vamos testar com dois tipos de sensores:
Primeiro, vamos testar com imagens de um sensor de qualidade mais baixa, o Secugen, e ver como o modelo se sai!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
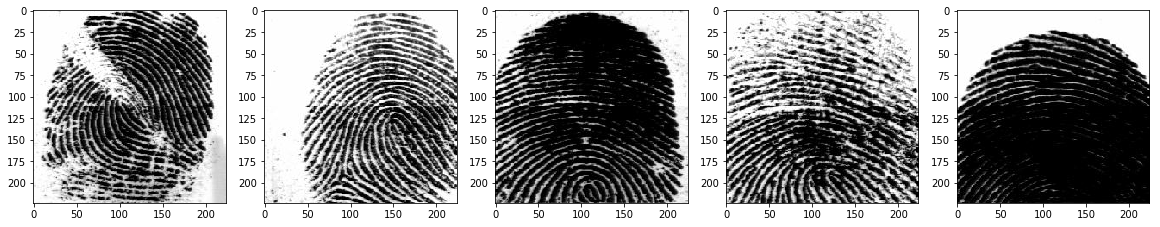
Reconstruction of Test Secugen Images
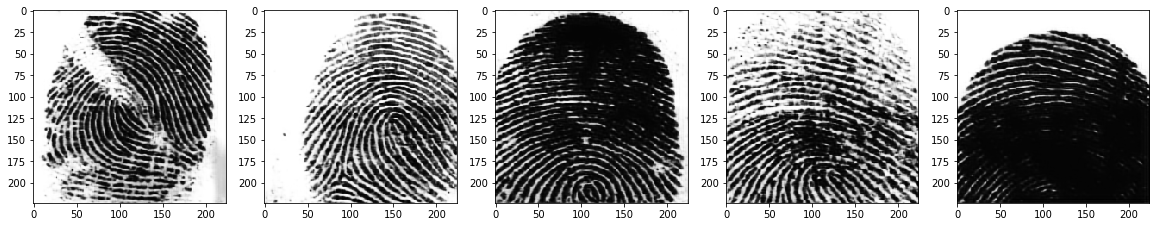
Como dá para ver, o modelo também reconstruiu muito bem as imagens do Secugen. Incrível, né?
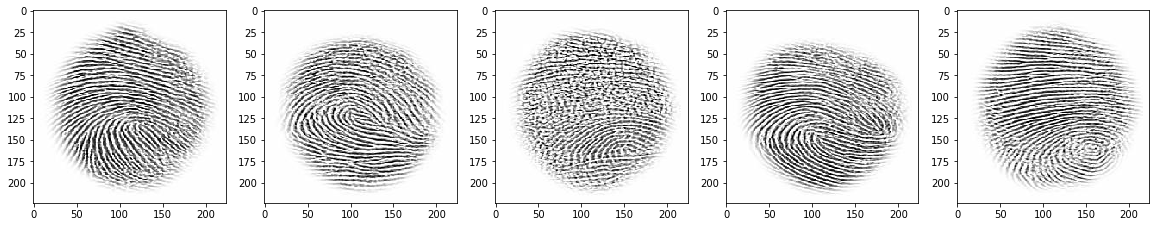
Agora, vamos testar com imagens de um sensor de qualidade melhor, o Lumidigm.
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
Reconstruction of Test Lumidigm Images
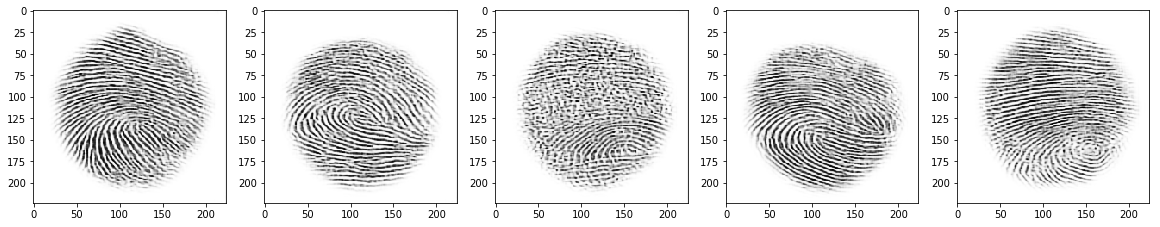
De novo, o modelo foi excelente ao reconstruir as imagens do Lumidigm.
Este tutorial foi um ótimo começo para entender como ler imagens do zero, analisá-las, pré-processá-las e alimentá-las em um modelo usando um dataset de impressões digitais. Você viu, na prática, uma aplicação bem bacana de autoencoders. Se conseguiu acompanhar com facilidade (ou mesmo com um pouco mais de esforço), mandou muito bem!
No próximo tutorial, você vai aprender a ler imagens médicas da modalidade T-1 e reconstruí-las usando um autoencoder!
Ainda há muito para explorar, então que tal fazer o curso Deep Learning in Python da DataCamp? Se ainda não fez, é uma ótima pedida. Você vai do básico até dominar o universo de deep learning; será um recurso indispensável para aprender a trabalhar com redes neurais convolucionais em Python, detectar rostos, objetos e muito mais.
Cursos de Python
Curso
Curso
Curso
blog
Abid Ali Awan
8 min
Tutorial
Zoumana Keita
14 min
Tutorial
Kurtis Pykes
14 min
Tutorial
Zoumana Keita
14 min
Tutorial
Natassha Selvaraj
8 min
Tutorial
Amberle McKee
15 min