Khóa học
Nhập môn Python
4 giờ
7.1M
Bạn sẽ sử dụng bộ dữ liệu vân tay FVC2002 để huấn luyện mạng của mình. Để quan sát hiệu quả của mô hình, bạn sẽ kiểm thử mô hình trên hai bộ dữ liệu cảm biến vân tay khác nhau là cảm biến Secugen và Lumidigm.
Lưu ý: Hướng dẫn này chủ yếu tập trung vào triển khai thực tiễn autoencoder tích chập. Vì vậy, nếu bạn chưa nắm về mạng nơ-ron tích chập (CNN) và autoencoder, bạn có thể xem hướng dẫn về CNN và Autoencoder.
Tóm lại, trong hướng dẫn hôm nay bạn sẽ giải quyết các chủ đề sau:
Trước khi tải dữ liệu, sẽ tốt hơn nếu bạn xem qua chính xác bạn sẽ làm việc với gì! Bộ dữ liệu vân tay FVC2002 là bộ dữ liệu từ cuộc thi Fingerprint Verification Competition được tổ chức vào năm 2000 và sau đó vào năm 2002. Bộ dữ liệu này gồm bốn loại cảm biến vân tay khác nhau: Cảm biến quang học giá rẻ, Cảm biến điện dung giá rẻ, Cảm biến quang học và Bộ tạo tổng hợp, mỗi cảm biến có kích thước ảnh khác nhau. Bộ dữ liệu có 3200 ảnh trong tập A, 800 ảnh mỗi cảm biến. Bạn có thể kiểm tra lại điều này sau khi đã tải dữ liệu! ;)
Bộ dữ liệu vân tay không được định nghĩa sẵn trong Keras hay TensorFlow, vì vậy bạn sẽ phải tải dữ liệu từ nguồn này. Bạn sẽ thấy cách thực hiện ở phần tiếp theo!
Lưu ý: Trước khi bắt đầu, xin lưu ý rằng mô hình sẽ được huấn luyện trên hệ thống dùng GPU Nvidia 1080 Ti, bộ xử lý Xeon e5 GeForce với RAM 32GB. Nếu bạn dùng Jupyter Notebook, bạn sẽ cần thêm ba dòng mã để chỉ định thứ tự thiết bị CUDA và các thiết bị CUDA hiển thị bằng mô-đun os.
Trong đoạn mã dưới đây, về cơ bản bạn đặt các biến môi trường trong notebook bằng os.environ. Nên làm điều sau trước khi khởi tạo Keras để giới hạn backend TensorFlow của Keras chỉ dùng GPU đầu tiên. Nếu máy bạn huấn luyện có GPU ở vị trí 0, hãy dùng 0 thay vì 1. Bạn có thể kiểm tra bằng cách chạy một lệnh đơn giản trên terminal: ví dụ, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Trước hết, bạn nhập tất cả các mô-đun cần thiết như cv2, numpy, matplotlib và quan trọng nhất là keras, vì hôm nay bạn sẽ dùng framework đó!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Khi đã tải dữ liệu, bạn sẵn sàng phân tích để có trực giác về bộ dữ liệu sẽ sử dụng trong hướng dẫn hôm nay!
Giờ hãy phân tích hình ảnh trong bộ dữ liệu trông như thế nào và xem kích thước của ảnh với thuộc tính .shape của mảng NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Từ kết quả trên, bạn thấy dữ liệu có dạng 3200 x 224 x 224 vì có 3200 mẫu, mỗi mẫu là ma trận kích thước 224 x 224.
Bây giờ, hãy xem thử một vài ảnh trong bộ dữ liệu:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
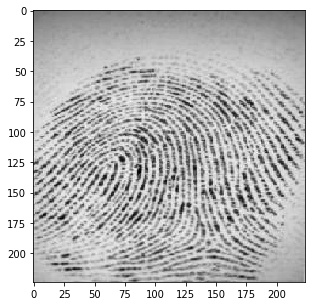
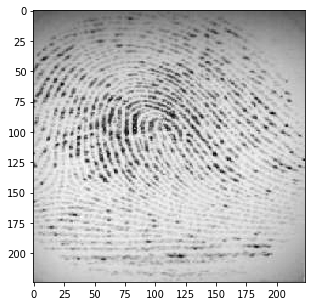
Kết quả của hai biểu đồ trên là từ bộ dữ liệu. Bạn có thể thấy các vân tay không thực sự rõ nét, sẽ thú vị khi xem autoencoder tích chập có học được đặc trưng và tái dựng những ảnh này tốt hay không.
Các ảnh trong bộ dữ liệu là ảnh thang xám với giá trị điểm ảnh từ 0 đến 255 và kích thước 224 x 224, vì vậy trước khi đưa dữ liệu vào mô hình, tiền xử lý là rất quan trọng. Trước hết, bạn sẽ chuyển mỗi ảnh 224 x 224 thành ma trận kích thước 224 x 224 x 1, rồi đưa vào mạng:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Tiếp theo, bạn cần kiểm tra kiểu dữ liệu của mảng NumPy; nó nên là float32, nếu không bạn sẽ cần chuyển về định dạng này, đồng thời cần chuẩn hóa giá trị điểm ảnh về khoảng 0 - 1. Hãy thực hiện!
Đầu tiên, xác minh kiểu dữ liệu:
images_arr.dtype
dtype('float32')
Tiếp theo, chuẩn hóa dữ liệu theo giá trị điểm ảnh lớn nhất trong dữ liệu:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Hãy xác minh giá trị lớn nhất và nhỏ nhất của dữ liệu sau khi chuẩn hóa, chúng phải là 0.0 và 1.0!
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Sau tất cả, việc phân chia dữ liệu là quan trọng. Để mô hình khái quát hóa tốt, bạn chia dữ liệu thành hai phần: huấn luyện và xác thực. Bạn sẽ huấn luyện mô hình trên 80% dữ liệu và xác thực trên 20% còn lại.
Điều này cũng giúp giảm khả năng quá khớp, vì bạn sẽ xác thực trên dữ liệu mô hình chưa thấy trong giai đoạn huấn luyện.
Bạn có thể dùng mô-đun train_test_split của scikit-learn để chia dữ liệu đúng cách:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Lưu ý rằng với tác vụ này, bạn không cần nhãn huấn luyện và kiểm thử. Đó là lý do bạn truyền ảnh huấn luyện hai lần. Ảnh huấn luyện sẽ đồng thời là đầu vào và là ground truth tương tự như nhãn trong bài toán phân loại.
Giờ bạn đã sẵn sàng định nghĩa mạng và đưa dữ liệu vào. Không dài dòng nữa, sang bước tiếp theo!
Các ảnh có kích thước 224 x 224 x 1 tương đương véc-tơ 50.176 chiều. Bạn chuyển ma trận ảnh thành mảng, chuẩn hóa về khoảng 0 đến 1, reshape về kích thước 224 x 224 x 1, rồi đưa làm đầu vào mạng.
Bạn sẽ dùng batch size 128; dùng batch lớn hơn như 256 hoặc 512 cũng phù hợp, tùy hệ thống huấn luyện. Nó ảnh hưởng mạnh đến tham số học và độ chính xác dự đoán. Bạn sẽ huấn luyện mạng trong 50 epoch.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Như bạn đã biết, autoencoder chia làm hai phần: encoder và decoder.
Encoder
Decoder
Lớp max-pooling sẽ giảm lấy mẫu đầu vào xuống hai lần mỗi khi dùng, trong khi lớp upsampling sẽ tăng lấy mẫu đầu vào lên hai lần mỗi khi dùng.
Lưu ý: Số lượng bộ lọc, kích thước bộ lọc, số lớp, số epoch huấn luyện đều là siêu tham số và nên quyết định dựa trên trực giác của bạn; bạn tự do thử nghiệm bằng cách điều chỉnh các siêu tham số này và đo hiệu năng mô hình. Đó là cách bạn dần học được nghệ thuật học sâu!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Sau khi tạo mô hình, bạn cần biên dịch với bộ tối ưu RMSProp.
Lưu ý bạn cũng cần chỉ định loại hàm mất mát qua tham số loss. Ở đây là mean squared error, vì mất mát sau mỗi batch sẽ được tính giữa batch đầu ra dự đoán và ground truth theo từng điểm ảnh bằng bình phương sai số trung bình:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Hãy trực quan hóa các lớp bạn vừa tạo bằng hàm summary; điều này sẽ hiển thị số lượng tham số (trọng số và độ lệch) ở mỗi lớp và tổng tham số trong mô hình.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Đến lúc huấn luyện mô hình bằng hàm fit() của Keras! Mô hình được huấn luyện trong 200 epoch. Hàm fit() sẽ trả về một đối tượng lịch sử; bằng cách lưu kết quả này vào fashion_train, bạn có thể dùng sau để vẽ đồ thị mất mát giữa huấn luyện và xác thực, giúp phân tích hiệu năng mô hình trực quan.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Tuyệt! Bạn đã huấn luyện mô hình trên bộ dữ liệu vân tay trong 200 epoch. Giờ hãy vẽ đồ thị mất mát giữa dữ liệu huấn luyện và xác thực để trực quan hóa hiệu năng mô hình.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
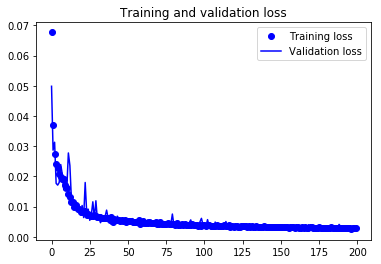
Cuối cùng, bạn có thể thấy mất mát xác thực và mất mát huấn luyện khớp nhau. Điều này cho thấy mô hình không bị quá khớp: mất mát xác thực đang giảm chứ không tăng, và hầu như không có khoảng cách giữa mất mát huấn luyện và xác thực, đặc biệt sau epoch thứ 40.
Vì vậy, có thể nói khả năng khái quát hóa của mô hình là tốt.
Giờ là lúc tái dựng ảnh kiểm thử bằng hàm predict() của Keras và xem mô hình tái dựng dữ liệu kiểm thử tốt đến đâu.
Hãy lưu mô hình đã huấn luyện. Đây là bước quan trọng khi làm việc với học sâu, bởi trọng số là cốt lõi của lời giải cho bài toán bạn đang xử lý!
Bạn có thể tải lại trọng số đã lưu vào cùng mô hình bất cứ lúc nào và huấn luyện tiếp từ nơi đã dừng. Ví dụ, với mô hình trên, nếu huấn luyện lại, các tham số như trọng số, độ lệch, hàm mất mát, v.v. sẽ không bắt đầu từ đầu và đó không còn là một lần huấn luyện mới hoàn toàn.
Chỉ với một dòng mã, bạn có thể lưu và tải lại trọng số vào mô hình.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Vì ở đây bạn không có dữ liệu kiểm thử, hãy dùng dữ liệu xác thực để dự đoán với mô hình vừa huấn luyện.
Bạn sẽ dự đoán trên 640 ảnh xác thực còn lại và vẽ một vài ảnh đã tái dựng để xem mô hình tái dựng ảnh xác thực tốt đến đâu.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
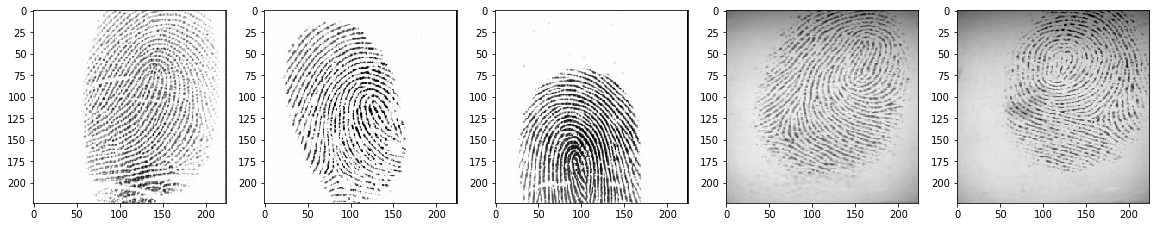
Reconstruction of Test Images
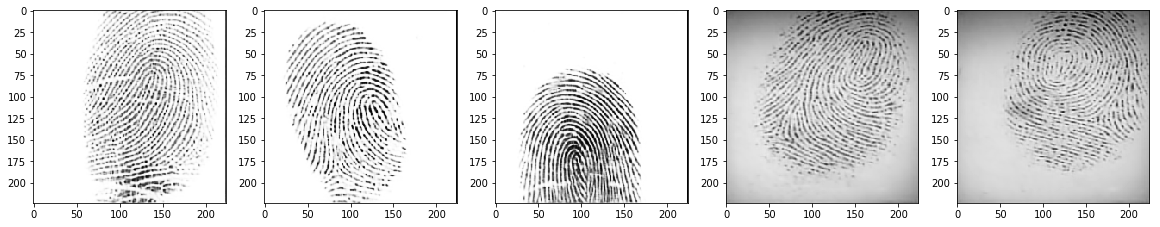
Từ các hình trên, bạn có thể quan sát mô hình đã làm rất tốt trong việc tái dựng các ảnh kiểm thử được dự đoán bằng mô hình. Ít nhất về mặt trực quan, ảnh gốc và ảnh tái dựng trông gần như giống hệt.
Như bạn đã thấy ở đồ thị huấn luyện so với xác thực, mô hình khái quát hóa tốt trên dữ liệu chưa thấy. Giờ là lúc kiểm tra độ bền vững của nó với dữ liệu từ cảm biến hoàn toàn khác.
Bạn sẽ kiểm thử mô hình trên hai loại cảm biến:
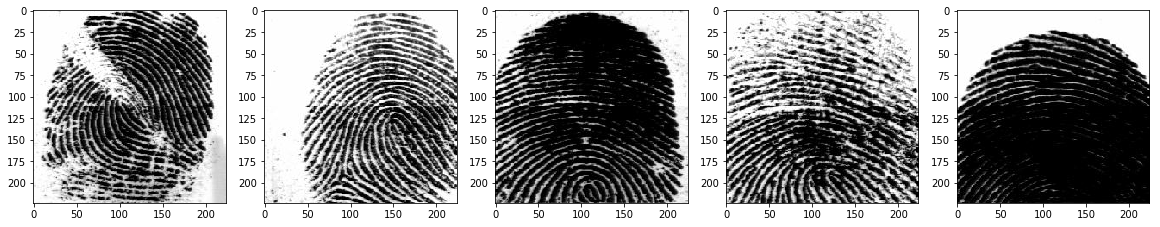
Trước tiên, hãy thử mô hình trên dữ liệu từ cảm biến vân tay chất lượng thấp, tức Secugen, và xem mô hình hoạt động thế nào!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
Reconstruction of Test Secugen Images
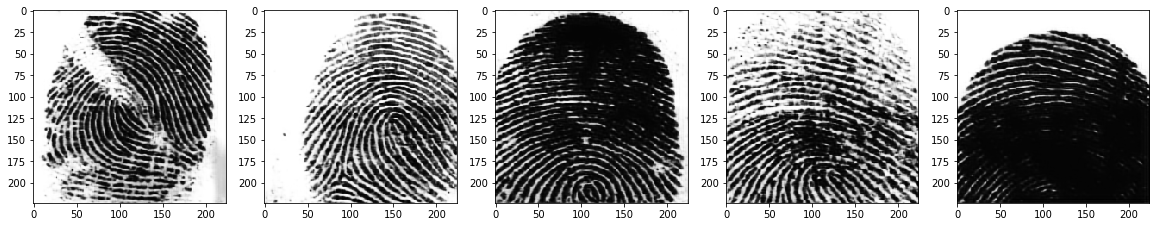
Từ các hình trên, bạn có thể quan sát mô hình đã tái dựng rất tốt các ảnh secugen được dự đoán bằng mô hình đã huấn luyện. Thật ấn tượng phải không?
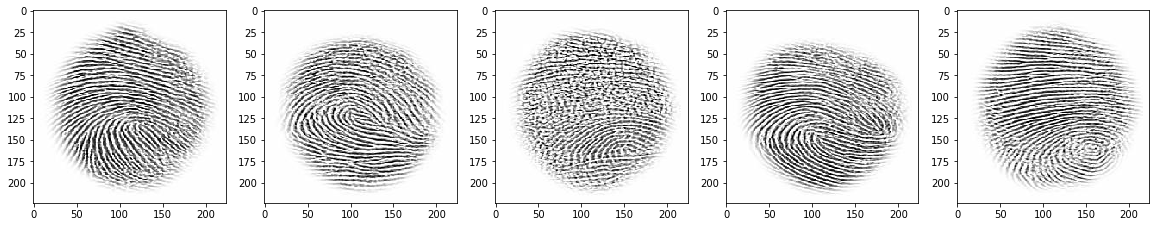
Giờ, hãy kiểm thử mô hình trên ảnh từ cảm biến có chất lượng khá hơn, tức Lumidigm
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
Reconstruction of Test Lumidigm Images
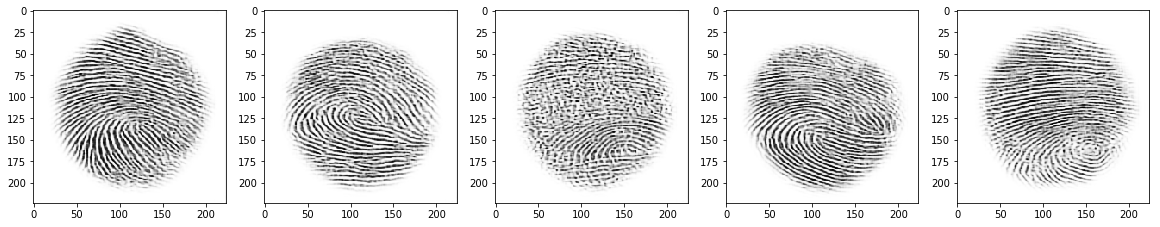
Từ các hình trên, bạn có thể quan sát mô hình lại tiếp tục tái dựng rất tốt các ảnh lumidigm được dự đoán bằng mô hình đã huấn luyện.
Hướng dẫn này là khởi đầu tốt để hiểu cách đọc ảnh từ đầu, phân tích, tiền xử lý và đưa chúng vào mô hình bằng bộ dữ liệu vân tay. Nó cho bạn thấy một ứng dụng thú vị của autoencoder trên thực tế. Nếu bạn theo kịp dễ dàng hoặc dù có chút vất vả, chúc mừng bạn!
Trong hướng dẫn tiếp theo, bạn sẽ học cách đọc ảnh y khoa của mô thức T-1 và tái dựng chúng bằng autoencoder!
Vẫn còn nhiều điều để khám phá, vậy tại sao không học khóa Deep Learning in Python của DataCamp nếu bạn chưa học? Bạn sẽ học từ căn bản và dần làm chủ lĩnh vực học sâu; đây chắc chắn sẽ là nguồn tài nguyên hữu ích khi bạn học cách làm việc với mạng nơ-ron tích chập trong Python, cách phát hiện khuôn mặt, vật thể, v.v.
Khóa học Python
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
