कोर्स
Python परिचय
4 घंटा
7.1M
आप अपना नेटवर्क ट्रेन करने के लिए FVC2002 फिंगरप्रिंट डेटासेट का उपयोग करेंगे। अपने मॉडल की प्रभावशीलता देखने के लिए, आप अपने मॉडल का परीक्षण दो अलग-अलग फिंगरप्रिंट सेंसर डेटासेट पर करेंगे, यानी Secugen और Lumidigm सेंसर पर।
ध्यान दें : यह ट्यूटोरियल मुख्य रूप से convolutional autoencoders के व्यावहारिक कार्यान्वयन को कवर करेगा। तो, यदि आप अभी तक convolutional neural network (CNN) और autoencoder से परिचित नहीं हैं, तो आप CNN और Autoencoder ट्यूटोरियल देखना चाहेंगे।
संक्षेप में, आप आज के ट्यूटोरियल में निम्नलिखित विषयों को संबोधित करेंगे:
डेटा लोड करने से पहले, यह देख लेना अच्छा है कि आप वास्तव में किसके साथ काम करने वाले हैं! FVC2002 फिंगरप्रिंट डेटासेट एक Fingerprint Verification Competition का डेटासेट है, जो वर्ष 2000 और फिर 2002 में आयोजित हुआ था। इस डेटासेट में चार अलग-अलग सेंसर फिंगरप्रिंट शामिल हैं: Low-cost Optical Sensor, Low-cost Capacitive Sensor, Optical Sensor और Synthetic Generator, प्रत्येक सेंसर की इमेज साइज अलग-अलग है। इस डेटासेट में सेट A में 3200 इमेजेस हैं, प्रति सेंसर 800 इमेजेस। जब आप अपना डेटा लोड कर लेंगे, तो आप इसे दोबारा जाँच सकते हैं! ;)
Fingerprint डेटासेट Keras या TensorFlow फ्रेमवर्क में पूर्व-निर्धारित नहीं है, इसलिए आपको इस स्रोत से डेटा डाउनलोड करना होगा। अगला सेक्शन आपको बताएगा कि यह कैसे करना है!
नोट : शुरू करने से पहले कृपया ध्यान दें कि मॉडल को Nvidia 1080 Ti GPU Xeon e5 GeForce प्रोसेसर और 32GB RAM वाले सिस्टम पर ट्रेन किया जाएगा। यदि आप Jupyter Notebook का उपयोग कर रहे हैं, तो आपको os नामक मॉड्यूल का उपयोग करके CUDA device order और CUDA visible devices निर्दिष्ट करने के लिए कोड की तीन और पंक्तियाँ जोड़नी होंगी।
नीचे दिए गए कोड में, आप मूल रूप से os.environ का उपयोग करके नोटबुक में environment variables सेट करते हैं। Keras इनिशियलाइज़ करने से पहले यह करना अच्छा है ताकि Keras backend TensorFlow केवल पहले GPU का उपयोग करे। यदि जिस मशीन पर आप ट्रेन कर रहे हैं उसमें GPU 0 पर है, तो 1 की बजाय 0 का उपयोग करना सुनिश्चित करें। आप इसे अपने टर्मिनल पर एक सरल कमांड चलाकर देख सकते हैं: उदाहरण के लिए, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
सबसे पहले, आप सभी आवश्यक मॉड्यूल्स जैसे cv2, numpy, matplotlib और सबसे महत्वपूर्ण keras इम्पोर्ट करेंगे, क्योंकि आप आज के ट्यूटोरियल में उसी फ्रेमवर्क का उपयोग करेंगे!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
एक बार जब आपने डेटा लोड कर लिया है, तो आप आज के ट्यूटोरियल के लिए जिस डेटासेट पर काम करने जा रहे हैं, उसके बारे में कुछ अंतर्ज्ञान पाने के लिए डेटा का विश्लेषण करने के लिए तैयार हैं!
आइए अब देखें कि डेटासेट में इमेजेस कैसी दिखती हैं और NumPy array के .shape एट्रिब्यूट की मदद से इमेजेस के आयाम भी देखें:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
उपरोक्त आउटपुट से आप देख सकते हैं कि डेटा का आकार 3200 x 224 x 224 है क्योंकि 224 x 224 आयामों के 3200 सैम्पल्स हैं।
अब, अपने डेटासेट में से कुछ इमेजेस पर एक नज़र डालते हैं:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
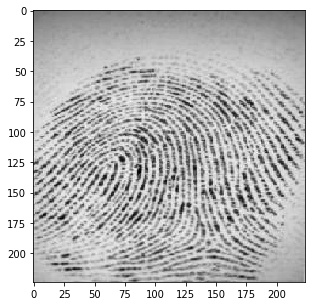
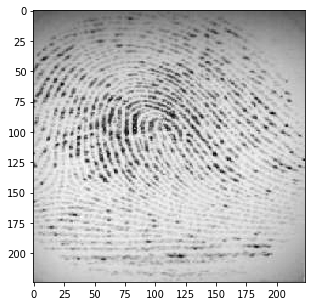
उपरोक्त दोनों प्लॉट्स के आउटपुट डेटासेट से हैं। आप देख सकते हैं कि फिंगरप्रिंट बहुत स्पष्ट नहीं हैं, यह देखना दिलचस्प होगा कि क्या convolutional autoencoder इन फीचर्स को सीख पाता है और इन इमेजेस का सही तरह से पुनर्निर्माण करता है।
डेटासेट की इमेजेस वास्तव में ग्रेस्केल हैं जिनके पिक्सल मान 0 से 255 तक होते हैं और आयाम 224 x 224 है, इसलिए डेटा को मॉडल में फीड करने से पहले इसे प्रीप्रोसेस करना बहुत महत्वपूर्ण है। आप पहले डेटासेट की प्रत्येक 224 x 224 इमेज को 224 x 224 x 1 आकार के मैट्रिक्स में बदलेंगे, जिसे आप फिर नेटवर्क में फीड कर सकते हैं:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
इसके बाद, आप यह सुनिश्चित करना चाहेंगे कि NumPy array का डेटा टाइप क्या है; यह float32 फॉर्मेट में होना चाहिए, यदि नहीं है तो आपको इसे इस फॉर्मेट में कन्वर्ट करना होगा, साथ ही पिक्सल मानों को 0 - 1 की श्रेणी में rescale भी करना होगा। तो चलिए यह करते हैं!
पहले, डेटा टाइप वेरिफाई करते हैं:
images_arr.dtype
dtype('float32')
अगला, डेटा को इमेजेस के अधिकतम पिक्सल मान से rescale करें:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
आइए डेटा के अधिकतम और न्यूनतम मानों को वेरिफाई करें, जो rescale करने के बाद 0.0 और 1.0 होने चाहिए!
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
इन सबके बाद, डेटा को विभाजित करना महत्वपूर्ण है। आपके मॉडल को अच्छी तरह generalize कराने के लिए, आप डेटा को दो भागों में बाँटेंगे: training और validation सेट। आप अपने मॉडल को डेटा के 80% पर ट्रेन करेंगे और शेष training डेटा के 20% पर इसे validate करेंगे।
यह overfitting की संभावनाओं को कम करने में भी मदद करेगा, क्योंकि आप अपने मॉडल को ऐसे डेटा पर validate करेंगे जिसे उसने ट्रेनिंग चरण में नहीं देखा होगा।
आप scikit-learn के train_test_split मॉड्यूल का उपयोग कर डेटा को सही तरीके से बाँट सकते हैं:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
ध्यान दें कि इस कार्य के लिए, आपको training और testing लेबल्स की आवश्यकता नहीं है। इसलिए आप training इमेजेस को दो बार पास करेंगे। आपकी training इमेजेस ही इनपुट और ग्राउंड ट्रुथ दोनों की तरह कार्य करेंगी, ठीक वैसे ही जैसे क्लासिफिकेशन टास्क में लेबल्स होते हैं।
अब आप नेटवर्क परिभाषित करने और उसमें डेटा फीड करने के लिए तैयार हैं। तो बिना देर किए, अगले चरण पर चलते हैं!
इमेजेस का आकार 224 x 224 x 1 या 50,176-डायमेंशनल वेक्टर है। आप इमेज मैट्रिक्स को array में बदलते हैं, उसे 0 और 1 के बीच rescale करते हैं, उसे 224 x 224 x 1 के आकार में reshape करते हैं, और इसे नेटवर्क में इनपुट के रूप में फीड करते हैं।
साथ ही, आप 128 का batch size उपयोग करेंगे; 256 या 512 जैसे अधिक batch size का उपयोग करना भी उपयुक्त है—यह इस पर निर्भर करता है कि आप अपना मॉडल किस सिस्टम पर ट्रेन कर रहे हैं। यह learning पैरामीटर्स निर्धारित करने में महत्वपूर्ण भूमिका निभाता है और prediction सटीकता को प्रभावित करता है। आप अपना नेटवर्क 50 epochs तक ट्रेन करेंगे।
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
जैसा कि आप पहले से जानते होंगे, autoencoder दो भागों में बँटा होता है: एक encoder और एक decoder।
Encoder
Decoder
Max-pooling लेयर हर बार उपयोग करने पर इनपुट को दो गुना downsample करेगी, जबकि upsampling लेयर हर बार उपयोग करने पर इनपुट को दो गुना upsample करेगी।
ध्यान दें: फ़िल्टर्स की संख्या, फ़िल्टर का आकार, लेयर्स की संख्या, आप अपने मॉडल को जितने epochs तक ट्रेन करते हैं—ये सभी हाइपरपैरामीटर्स हैं और इन्हें आपके अपने विवेक के आधार पर तय किया जाना चाहिए। आप इन हाइपरपैरामीटर्स में बदलाव कर नए प्रयोग करने और अपने मॉडल के प्रदर्शन को मापने के लिए स्वतंत्र हैं। और इसी तरह आप धीरे-धीरे deep learning की कला सीखेंगे!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
मॉडल बनने के बाद, आपको इसे RMSProp ऑप्टिमाइज़र के साथ compile करना होगा।
ध्यान दें कि आपको loss का प्रकार भी loss आर्ग्युमेंट के माध्यम से निर्दिष्ट करना होगा। इस मामले में, यह mean squared error है, क्योंकि हर बैच के बाद loss को भविष्यवाणी किए गए आउटपुट और ग्राउंड ट्रुथ के बीच पिक्सल-दर-पिक्सल mean squared error के माध्यम से गणना किया जाएगा:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
आइए summary फ़ंक्शन का उपयोग करके ऊपर बनाए गए लेयर्स को विज़ुअलाइज़ करें; यह प्रत्येक लेयर में पैरामीटर्स (weights और biases) की संख्या और आपके मॉडल में कुल पैरामीटर्स भी दिखाएगा।
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
अंततः Keras की fit() फ़ंक्शन के साथ मॉडल को ट्रेन करने का समय आ गया है! मॉडल 200 epochs तक ट्रेन होता है। fit() फ़ंक्शन एक history ऑब्जेक्ट रिटर्न करेगा; इसे fashion_train में स्टोर करके, आप बाद में training और validation के बीच loss फंक्शन प्लॉट बना सकते हैं, जो आपके मॉडल के प्रदर्शन का दृश्यात्मक विश्लेषण करने में मदद करेगा।
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
आखिरकार! आपने फिंगरप्रिंट डेटासेट पर 200 epochs तक मॉडल को ट्रेन किया। अब, मॉडल के प्रदर्शन को विज़ुअलाइज़ करने के लिए training और validation डेटा के बीच loss प्लॉट बनाते हैं।
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
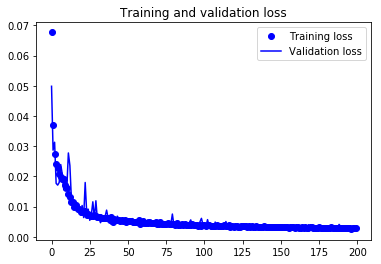
अंत में, आप देख सकते हैं कि validation loss और training loss दोनों एकसाथ चल रहे हैं। यह दिखाता है कि आपका मॉडल overfit नहीं कर रहा है: validation loss घट रहा है, बढ़ नहीं रहा, और विशेषकर 40वें epoch के बाद प्रशिक्षण आगे बढ़ने पर training और validation loss के बीच शायद ही कोई अंतर है।
इसलिए, आप कह सकते हैं कि आपके मॉडल की generalization क्षमता अच्छी है।
अब अंततः, Keras की predict() फ़ंक्शन का उपयोग करके टेस्ट इमेजेस का पुनर्निर्माण करने और यह देखने का समय है कि आपका मॉडल टेस्ट डेटा पर कितना अच्छा पुनर्निर्माण कर पा रहा है।
अब प्रशिक्षित मॉडल को सहेजते हैं। Deep Learning के साथ काम करते समय यह एक महत्वपूर्ण कदम है। क्योंकि आपके द्वारा हल की जा रही समस्या का मूल समाधान weights ही होते हैं!
आप कभी भी सहेजे गए weights को उसी मॉडल में लोड कर सकते हैं और जहाँ आपका प्रशिक्षण रुका था, वहीं से फिर ट्रेन कर सकते हैं। उदाहरण के लिए, ऊपर दिए गए मॉडल को यदि फिर से ट्रेन किया जाए, तो weights, biases, loss फंक्शन आदि जैसे पैरामीटर्स शुरुआत से नहीं चलेंगे और यह अब एक नई ट्रेनिंग नहीं होगी।
सिर्फ एक पंक्ति के कोड से, आप weights को सहेज और वापस मॉडल में लोड कर सकते हैं।
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
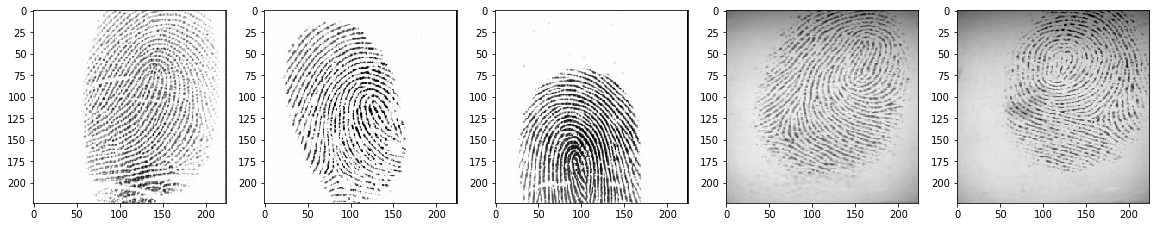
चूँकि यहाँ आपके पास testing डेटा नहीं है। आइए अभी-अभी ट्रेन किए गए मॉडल पर भविष्यवाणी के लिए validation डेटा का उपयोग करें।
आप प्रशिक्षित मॉडल के साथ शेष 640 validation इमेजेस पर प्रिडिक्ट करेंगे और कुछ reconstructed इमेजेस प्लॉट करेंगे ताकि यह देखा जा सके कि आपका मॉडल validation इमेजेस का कितना अच्छा पुनर्निर्माण कर पा रहा है।
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
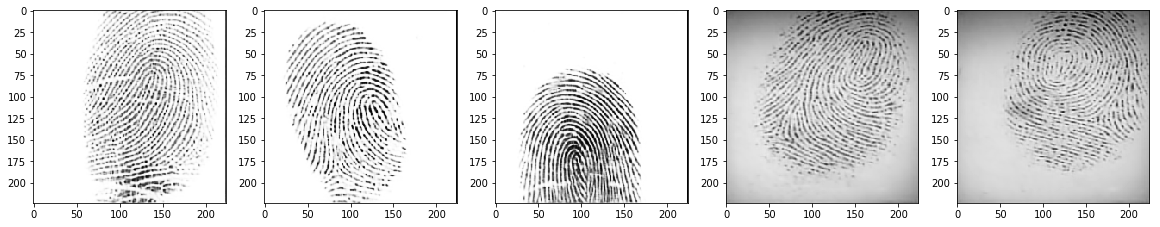
उपरोक्त चित्रों से आप देख सकते हैं कि आपके मॉडल ने प्रशिक्षित मॉडल का उपयोग कर जिन टेस्ट इमेजेस पर भविष्यवाणी की, उनका पुनर्निर्माण उत्कृष्ट रूप से किया। कम से कम दृश्य तौर पर, टेस्ट और reconstructed इमेजेस लगभग बिल्कुल समान दिखती हैं।
जैसा कि आपने training बनाम validation प्लॉट में देखा कि आपका मॉडल अनदेखे डेटा पर अच्छी तरह generalize कर रहा था। अब पूरी तरह अलग सेंसर डेटा के साथ इसकी रोबस्टनेस परखने का समय है।
आप अपने मॉडल का परीक्षण दो अलग-अलग प्रकार के सेंसर पर करेंगे।
पहले, आइए अपने मॉडल को कम-गुणवत्ता वाले फिंगरप्रिंट सेंसर डेटा, यानी Secugen, पर टेस्ट करें और देखें कि मॉडल कितना अच्छा प्रदर्शन करता है!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
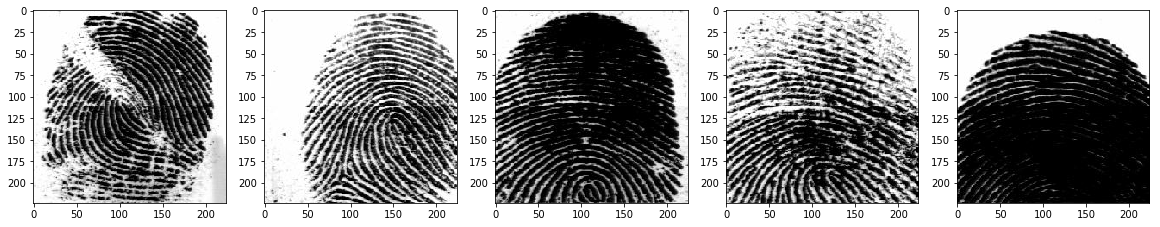
Reconstruction of Test Secugen Images
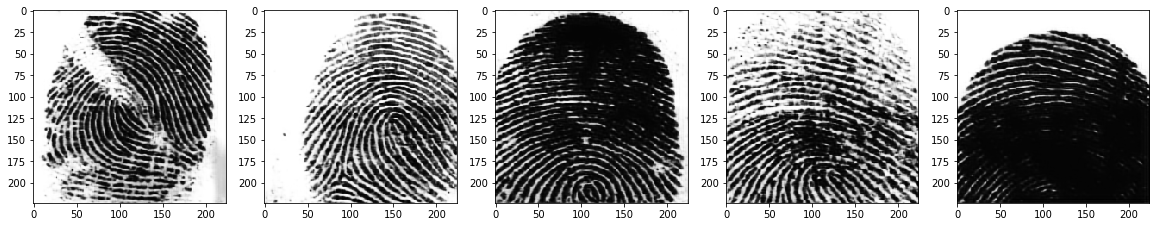
उपरोक्त चित्रों से आप देख सकते हैं कि प्रशिक्षित मॉडल का उपयोग करके जिन secugen इमेजेस पर आपने भविष्यवाणी की, उनके पुनर्निर्माण में आपके मॉडल ने बेहतरीन काम किया। क्या यह अद्भुत नहीं है?
अब, आइए अपने मॉडल को अपेक्षाकृत बेहतर गुणवत्ता वाले सेंसर इमेजेस, यानी Lumidigm, पर टेस्ट करें
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
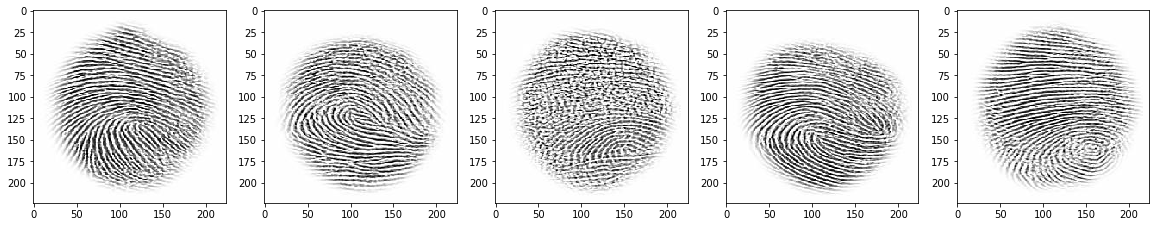
Reconstruction of Test Lumidigm Images
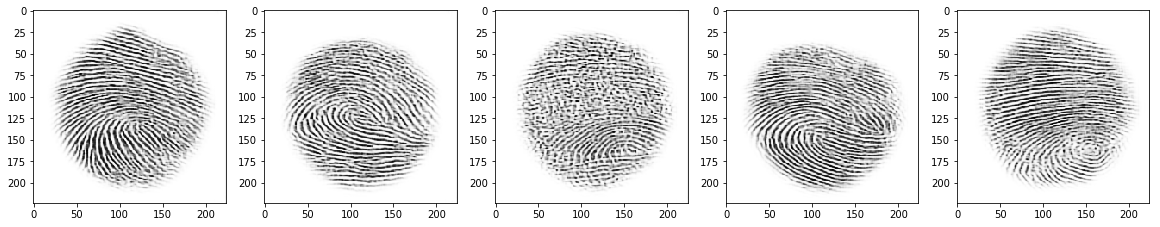
उपरोक्त चित्रों से आप देख सकते हैं कि आपके मॉडल ने प्रशिक्षित मॉडल का उपयोग कर जिन lumidigm इमेजेस पर भविष्यवाणी की, उनका भी उत्कृष्ट पुनर्निर्माण किया।
यह ट्यूटोरियल शुरुआत से इमेजेस पढ़ने, उनका विश्लेषण, प्रीप्रोसेसिंग और उन्हें फिंगरप्रिंट डेटासेट का उपयोग कर मॉडल में फीड करने को समझने के लिए एक अच्छी शुरुआत थी। इसने practically autoencoders के एक शानदार अनुप्रयोग को दिखाया। यदि आप आसानी से या थोड़े अतिरिक्त प्रयास के साथ भी साथ चल पाए—बहुत बढ़िया!
अगले ट्यूटोरियल में, आप T-1 modality की मेडिकल इमेजेस पढ़ना और उन्हें autoencoder का उपयोग करके पुनर्निर्मित करना सीखेंगे!
अभी भी कवर करने के लिए बहुत कुछ बाकी है, तो क्यों न DataCamp का Deep Learning in Python कोर्स करें? यदि आपने अभी तक नहीं किया है। आप मूलभूत से सीखेंगे और धीरे-धीरे deep learning डोमेन में महारत हासिल करेंगे; जब आप Python में convolutional neural networks के साथ काम करना, चेहरों, ऑब्जेक्ट्स आदि का पता लगाना सीख रहे होंगे, तब यह निस्संदेह एक अनिवार्य संसाधन होगा।
Python पाठ्यक्रम
कोर्स
कोर्स
कोर्स