
Last chance! 50% off DataCamp Premium
Sale ends in
Je gebruikt de FVC2002-vingerafdrukdataset om je netwerk te trainen. Om de effectiviteit van je model te beoordelen, test je het op twee verschillende vingerafdruksensor-datasets: Secugen en Lumidigm.
Opmerking: Deze tutorial behandelt vooral de praktische implementatie van convolutionele autoencoders. Als je nog niet bekend bent met convolutional neural networks (CNN) en autoencoders, bekijk dan de tutorials over CNN en Autoencoder.
Samengevat behandel je in deze tutorial de volgende onderwerpen:
Voordat je de data laadt, is het goed om even te kijken waarmee je precies gaat werken. De FVC2002-vingerafdrukdataset komt uit de Fingerprint Verification Competition, die in 2000 en later opnieuw in 2002 werd georganiseerd. Deze dataset bevat vier verschillende sensortypen: Low-cost Optical Sensor, Low-cost Capacitive Sensor, Optical Sensor en Synthetic Generator, met per sensor uiteenlopende afbeeldingsformaten. Set A bevat 3200 afbeeldingen, 800 per sensor. Dat kun je straks verifiëren zodra je de data hebt geladen! ;)
De vingerafdrukdataset is niet vooraf gedefinieerd in Keras of TensorFlow, dus je moet de data downloaden van deze bron. In de volgende sectie zie je hoe dat werkt.
Opmerking : Het model wordt getraind op een systeem met een Nvidia 1080 Ti GPU, Xeon e5 GeForce-processor en 32GB RAM. Als je Jupyter Notebook gebruikt, moet je drie regels code toevoegen waarin je de CUDA-devicevolgorde en zichtbare CUDA-devices specificeert met het os-module.
In de onderstaande code stel je in feite omgevingsvariabelen in de notebook in via os.environ. Het is handig om dit vóór het initialiseren van Keras te doen, zodat de Keras-backend TensorFlow slechts de eerste GPU gebruikt. Als de machine waarop je traint een GPU op 0 heeft, gebruik dan 0 in plaats van 1. Je kunt dit checken met een simpel terminalcommando, bijvoorbeeld nvidia-smi.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Eerst importeer je alle vereiste modules zoals cv2, numpy, matplotlib en vooral keras, want dat framework gebruik je in deze tutorial!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Als de data eenmaal geladen is, kun je aan de slag met analyseren om gevoel te krijgen voor de dataset waarmee je in deze tutorial werkt.
Laten we bekijken hoe de afbeeldingen in de dataset eruitzien en met behulp van het NumPy-arrayattribuut .shape meteen de dimensies ervan bekijken:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Uit de bovenstaande output zie je dat de data de vorm 3200 x 224 x 224 heeft, omdat er 3200 samples zijn, elk een matrix van 224 x 224.
Bekijk nu een paar afbeeldingen uit je dataset:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
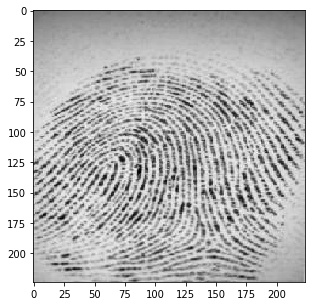
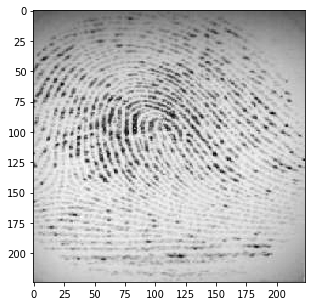
De output van bovenstaande twee plots komt uit de dataset. Je ziet dat de vingerafdrukken niet heel scherp zijn. Het wordt interessant om te zien of de convolutionele autoencoder de kenmerken leert en deze beelden goed reconstrueert.
De afbeeldingen in de dataset zijn grijswaarden met pixelwaarden van 0 tot 255 en een afmeting van 224 x 224. Voor je de data aan het model voert, is pre-processing dus belangrijk. Je zet elke 224 x 224-afbeelding om naar een matrix van 224 x 224 x 1, die je vervolgens in het netwerk kunt voeren:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Controleer vervolgens het datatype van het NumPy-array; dit moet float32 zijn. Zo niet, dan moet je het converteren. Daarnaast schaal je de pixelwaarden opnieuw naar het bereik 0–1. Laten we dat doen!
Eerst het datatype verifiëren:
images_arr.dtype
dtype('float32')
Schaal vervolgens de data met de maximale pixelwaarde van de afbeeldingen:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Laten we de maximum- en minimumwaarde controleren; die zouden na het rescalen 1,0 en 0,0 moeten zijn.
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Daarna is het belangrijk om de data te splitsen. Om je model goed te laten generaliseren, splits je de data in een trainings- en een validatieset. Je traint op 80% van de data en valideert op 20% van de resterende trainingsdata.
Dit helpt ook om overfitting te verminderen, omdat je valideert op data die het model tijdens de training niet heeft gezien.
Je kunt hiervoor train_test_split uit scikit-learn gebruiken:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Opmerking: voor deze taak heb je geen trainings- en testlabels nodig. Daarom geef je de trainingsafbeeldingen twee keer mee. Je trainingsbeelden fungeren zowel als invoer als als ground truth, vergelijkbaar met labels in een classificatietaak.
Nu kun je het netwerk definiëren en de data erin voeren. Dus, door naar de volgende stap!
De afbeeldingen zijn 224 x 224 x 1, oftewel een vector van 50.176 dimensies. Je zet de afbeeldingsmatrix om naar een array, schaalt de waarden tussen 0 en 1, vormt hem om naar 224 x 224 x 1 en voert dit als input aan het netwerk.
Je gebruikt een batchgrootte van 128; een hogere batchgrootte zoals 256 of 512 kan ook, afhankelijk van je systeem. Dit beïnvloedt de leerparameters en de voorspelnauwkeurigheid. Je traint het netwerk 50 epochs.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Zoals je waarschijnlijk weet, bestaat de autoencoder uit twee delen: een encoder en een decoder.
Encoder
Decoder
De max-poolinglaag halveert de invoer bij elk gebruik, terwijl de upsampling-laag de invoer telkens verdubbelt.
Opmerking: Het aantal filters, de filtergrootte, het aantal lagen en het aantal epochs zijn allemaal hyperparameters en kies je op basis van je eigen intuïtie. Experimenteer gerust door deze hyperparameters te tweaken en meet de prestaties van je model. Zo leer je stap voor stap de kunst van deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nadat je het model hebt gemaakt, compileer je het met de RMSProp-optimizer.
Geef ook het verlies (loss) op via het argument loss. In dit geval gebruik je mean squared error, omdat het verlies na elke batch pixel voor pixel wordt berekend tussen de voorspelde output en de ground truth:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualiseer de lagen die je hierboven hebt gemaakt met de summary-functie; deze toont het aantal parameters (gewichten en biases) per laag en het totaal in je model.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Tijd om het model te trainen met de fit()-functie van Keras! Het model traint 200 epochs. De fit()-functie retourneert een history-object; door het resultaat op te slaan in fashion_train kun je later de verliescurves voor training en validatie plotten en zo de prestaties visueel analyseren.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Klaar! Je hebt het model 200 epochs op de vingerafdrukdataset getraind. Laten we nu de verliescurves van training en validatie plotten om de prestaties te visualiseren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
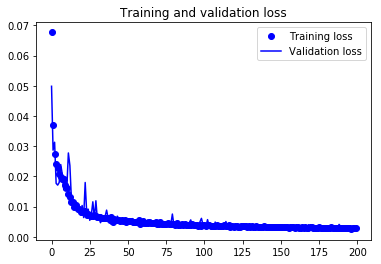
Je ziet dat de validatie- en trainingsverlies in de pas lopen. Je model overfit dus niet: het validatieverlies daalt en stijgt niet, en er is nauwelijks een kloof tussen beide, zeker na ongeveer 40 epochs.
Je kunt dus stellen dat de generalisatiecapaciteit van je model goed is.
Tot slot is het tijd om de testafbeeldingen te reconstrueren met de predict()-functie van Keras en te zien hoe goed je model reconstrueert op de testdata.
Laten we het getrainde model opslaan. Dit is belangrijk bij deep learning, omdat de gewichten het hart vormen van je oplossing!
Je kunt de opgeslagen gewichten later altijd in hetzelfde model laden en verder trainen vanaf waar je was gebleven. Als je het bovenstaande model opnieuw traint, beginnen parameters zoals gewichten, biases, de verliesfunctie, enz. dus niet opnieuw: het is geen verse training meer.
Met één regel code kun je de gewichten opslaan en weer laden.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Aangezien je hier geen aparte testdata hebt, gebruiken we de validatiedata om te voorspellen met het zojuist getrainde model.
Je laat het getrainde model voorspellen op de 640 overgebleven validatiebeelden en plot vervolgens enkele gereconstrueerde afbeeldingen om te zien hoe goed het model reconstrueert.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
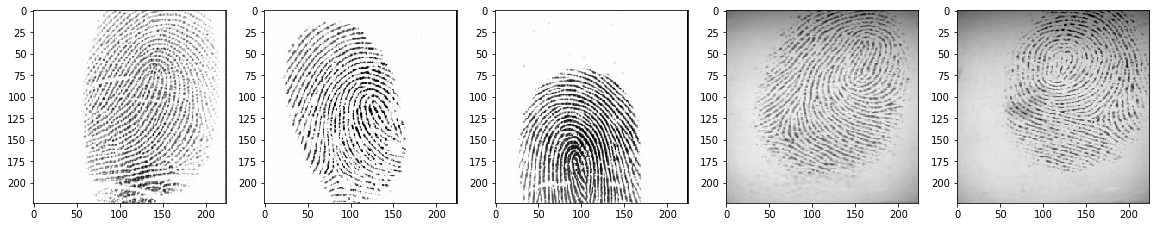
Reconstruction of Test Images
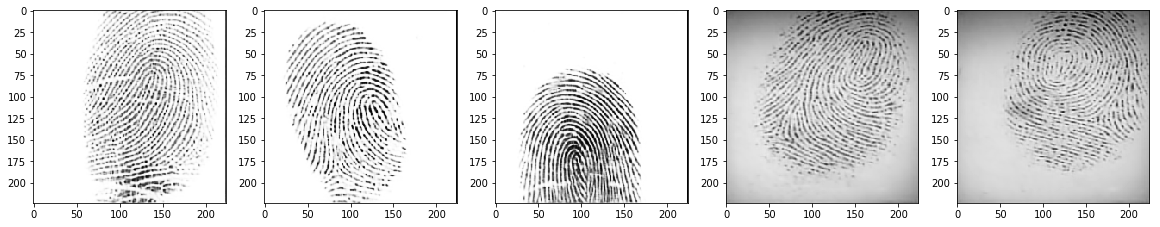
Uit de bovenstaande figuren blijkt dat je model het reconstrueren van de testafbeeldingen uitstekend doet. Visueel lijken de test- en gereconstrueerde beelden bijna identiek.
Zoals je in de training-vs-validatie-plot zag, generaliseerde je model goed naar onzichtbare data. Tijd om de robuustheid te testen met data van totaal andere sensoren.
Je test je model op twee soorten sensoren.
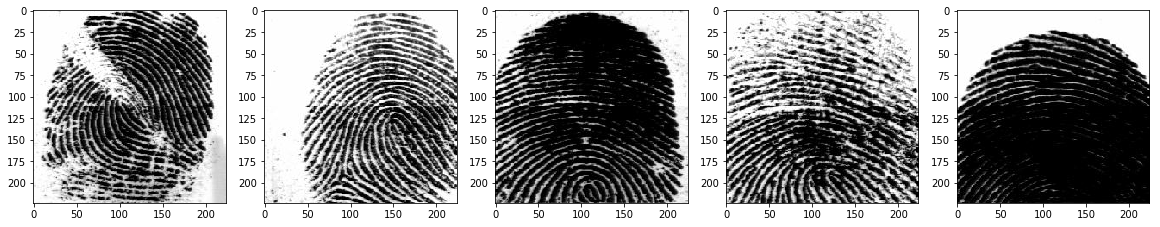
Laten we eerst testen op een sensor met lagere kwaliteit, Secugen, en zien hoe het model presteert.
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
Reconstruction of Test Secugen Images
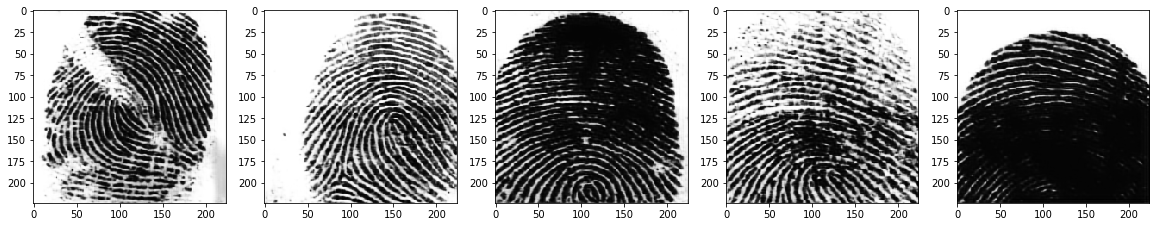
Uit de bovenstaande figuren blijkt dat je model de secugen-afbeeldingen die je met het getrainde model voorspelde, goed reconstrueert. Mooi toch?
Laten we nu testen op afbeeldingen van een sensor met redelijk betere kwaliteit, Lumidigm.
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
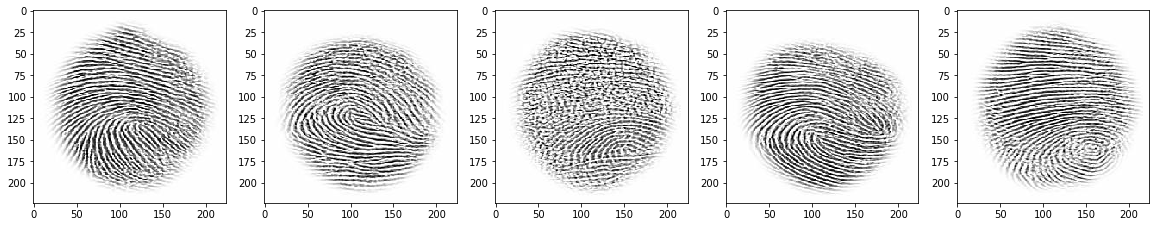
Reconstruction of Test Lumidigm Images
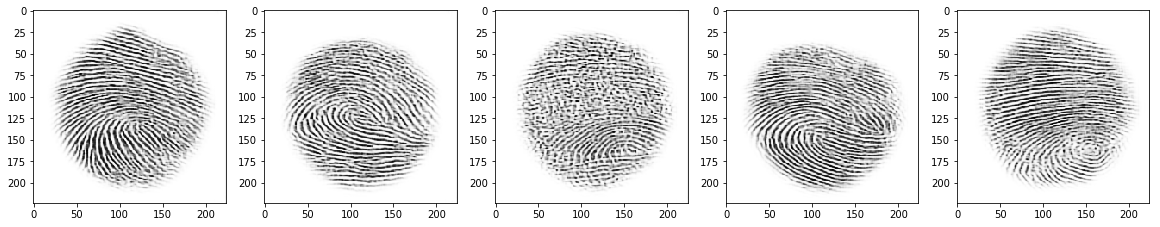
Ook hier zie je dat je model uitstekende reconstructies levert voor de lumidigm-afbeeldingen die je met het getrainde model voorspelde.
Deze tutorial was een goede start om te leren hoe je afbeeldingen from scratch inleest, analyseert, preprocesst en aan een model voert met een vingerafdrukdataset. Je hebt een mooie praktische toepassing van autoencoders gezien. Als je dit soepel of met wat extra inspanning hebt kunnen volgen: goed gedaan!
In de volgende tutorial leer je medische beelden van de T-1-modus in te lezen en te reconstrueren met een autoencoder.
Er valt nog veel te leren, dus waarom niet DataCamp’s Deep Learning in Python-cursus volgen, als je dat nog niet hebt gedaan? Je begint bij de basis en werkt stap voor stap toe naar het beheersen van deep learning. Het wordt ongetwijfeld een onmisbare bron als je leert werken met convolutionele neurale netwerken in Python, gezichten en objecten te detecteren, enz.
Python-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

