
Last chance! 50% off DataCamp Premium
Sale ends in
Userai il dataset di impronte digitali FVC2002 per addestrare la tua rete. Per osservare l’efficacia del modello, lo testerai su due diversi dataset di sensori di impronte digitali, ovvero i sensori Secugen e Lumidigm.
Nota: Questo tutorial tratterà soprattutto l’implementazione pratica degli autoencoder convoluzionali. Quindi, se non hai ancora familiarità con le reti neurali convoluzionali (CNN) e gli autoencoder, potresti voler consultare i tutorial su CNN e Autoencoder.
In sintesi, oggi affronterai i seguenti argomenti:
Prima di caricare i dati, è utile dare un’occhiata a ciò con cui lavorerai! Il dataset FVC2002 è un dataset della Fingerprint Verification Competition, organizzata nel 2000 e poi di nuovo nel 2002. Il dataset consiste di impronte provenienti da quattro sensori diversi: Low-cost Optical Sensor, Low-cost Capacitive Sensor, Optical Sensor e Synthetic Generator, ciascuno con dimensioni d’immagine variabili. Il dataset contiene 3200 immagini nel set A, 800 immagini per sensore. Potrai verificarlo quando avrai caricato i dati! ;)
Il dataset di impronte digitali non è predefinito in Keras o TensorFlow, quindi dovrai scaricarlo da questa fonte. Vedrai come fare nella prossima sezione!
Nota : Prima di iniziare, tieni presente che il modello verrà addestrato su un sistema con GPU Nvidia 1080 Ti, processore Xeon e5 GeForce e 32 GB di RAM. Se usi Jupyter Notebook, dovrai aggiungere tre righe di codice per specificare l’ordine dei dispositivi CUDA e i CUDA visible devices usando il modulo os.
Nel codice seguente, imposti sostanzialmente delle variabili d’ambiente nel notebook mediante os.environ. È utile farlo prima di inizializzare Keras per limitare il backend TensorFlow di Keras a usare la prima GPU. Se la macchina su cui addestri ha la GPU su 0, assicurati di usare 0 invece di 1. Puoi verificarlo eseguendo un semplice comando nel terminale: ad esempio, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Per prima cosa, importa tutti i moduli necessari come cv2, numpy, matplotlib e soprattutto keras, dato che userai questo framework nel tutorial di oggi!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Una volta caricati i dati, sei pronto per analizzarli e farti un’idea del dataset con cui lavorerai oggi!
Analizziamo ora l’aspetto delle immagini nel dataset e vediamo anche le dimensioni delle immagini con l’attributo .shape degli array NumPy:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Dal risultato sopra, puoi vedere che i dati hanno dimensioni 3200 x 224 x 224, dato che ci sono 3200 campioni, ciascuno rappresentato da una matrice 224 x 224.
Ora, diamo un’occhiata a un paio di immagini del dataset:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
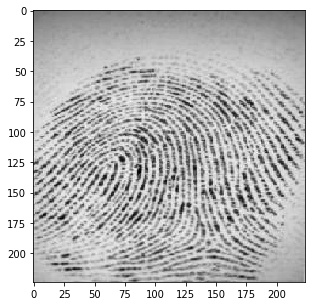
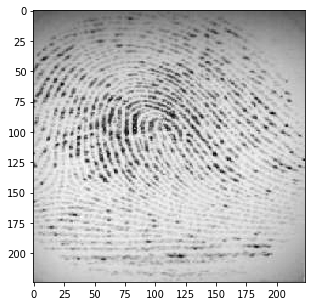
L’output dei due grafici sopra proviene dal dataset. Puoi notare che le impronte non sono molto nitide; sarà interessante vedere se l’autoencoder convoluzionale riesce a imparare le caratteristiche e a ricostruire correttamente queste immagini.
Le immagini del dataset sono in scala di grigi con valori di pixel compresi tra 0 e 255 e dimensioni 224 x 224, quindi prima di passarle al modello è molto importante pre-processarle. Per prima cosa convertirai ciascuna immagine 224 x 224 in una matrice 224 x 224 x 1, che potrai poi fornire alla rete:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Successivamente, assicurati di controllare il tipo di dato dell’array NumPy; dovrebbe essere in formato float32, altrimenti converti l’array in questo formato. Inoltre, devi riscalare i valori dei pixel nell’intervallo 0 - 1 inclusi. Facciamolo!
Per prima cosa, verifichiamo il tipo di dato:
images_arr.dtype
dtype('float32')
Poi, riscaliamo i dati con il valore massimo dei pixel nelle immagini:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Verifichiamo i valori massimo e minimo dei dati, che dopo il riscalamento dovrebbero essere 0.0 e 1.0!
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Dopo tutto questo, è importante suddividere i dati. Per far sì che il modello generalizzi bene, dividerai i dati in due parti: training e validation set. Addestrerai il modello sull’80% dei dati e lo validerai sul restante 20%.
Questo ti aiuterà anche a ridurre le possibilità di overfitting, poiché validerai il modello su dati che non ha visto durante l’addestramento.
Puoi usare il modulo train_test_split di scikit-learn per dividere correttamente i dati:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Nota che per questo task non ti servono etichette di training e testing. Ecco perché passerai le immagini di training due volte. Le immagini di training fungeranno sia da input che da ground truth, in modo analogo alle etichette nei task di classificazione.
Ora sei pronto per definire la rete e passarle i dati. Senza ulteriori indugi, passiamo allo step successivo!
Le immagini hanno dimensioni 224 x 224 x 1, ovvero un vettore di 50.176 dimensioni. Converti la matrice dell’immagine in un array, la riscali tra 0 e 1, la ridimensioni a 224 x 224 x 1 e la fornisci come input alla rete.
Inoltre userai un batch size di 128; un batch size più alto, come 256 o 512, è anch’esso preferibile, tutto dipende dal sistema su cui addestri il modello. Il batch size incide molto nel determinare i parametri di apprendimento e influisce sull’accuratezza delle predizioni. Addestrerai la rete per 50 epoche.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Come già saprai, un autoencoder è diviso in due parti: encoder e decoder.
Encoder
Decoder
Il livello di max-pooling effettua un downsampling dell’input di due volte ogni volta che lo usi, mentre il livello di upsampling effettua un upsampling dell’input di due volte ogni volta che viene usato.
Nota: Il numero di filtri, la dimensione dei filtri, il numero di layer, il numero di epoche di addestramento, sono tutti iperparametri da decidere in base alla tua intuizione; sei libero di fare esperimenti modificando questi iperparametri e misurare le prestazioni del modello. È così che imparerai, passo dopo passo, l’arte del deep learning!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Dopo aver creato il modello, devi compilarlo usando l’ottimizzatore RMSProp.
Nota che devi anche specificare il tipo di loss tramite l’argomento loss. In questo caso è l’errore quadratico medio (mean squared error), poiché la perdita dopo ogni batch verrà calcolata tra l’output predetto e il ground truth, pixel per pixel, usando l’errore quadratico medio:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Visualizziamo i layer creati nello step precedente usando la funzione summary; questa mostrerà il numero di parametri (pesi e bias) in ciascun layer e anche il totale dei parametri del modello.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
È finalmente il momento di addestrare il modello con la funzione fit() di Keras! Il modello viene addestrato per 200 epoche. La funzione fit() restituisce un oggetto history; salvando il risultato in fashion_train, potrai poi usarlo per tracciare il grafico della loss tra training e validazione, il che ti aiuterà ad analizzare visivamente le prestazioni del modello.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Finalmente! Hai addestrato il modello sul dataset di impronte per 200 epoche. Ora tracciamo il grafico della loss tra dati di training e di validazione per visualizzare le prestazioni del modello.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
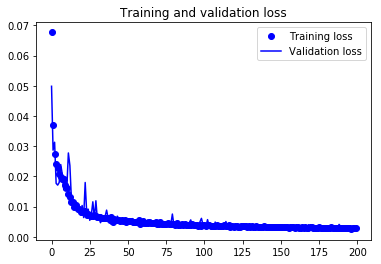
Come puoi vedere, la loss di validazione e quella di training sono allineate. Questo mostra che il modello non sta andando in overfitting: la loss di validazione diminuisce e non aumenta, e c’è raramente uno scarto tra training e validazione, soprattutto dopo la 40ª epoca.
Puoi quindi affermare che la capacità di generalizzazione del modello è buona.
Infine, è il momento di ricostruire le immagini di test usando la funzione predict() di Keras e vedere quanto bene il modello riesce a ricostruire i dati di test.
Salviamo ora il modello addestrato. È uno step importante quando lavori con il Deep Learning. I pesi sono il cuore della soluzione al problema che stai affrontando!
Puoi sempre caricare i pesi salvati nello stesso modello e riprendere l’addestramento da dove si era interrotto. Ad esempio, se alleni di nuovo il modello sopra, i parametri come pesi, bias, funzione di loss, ecc. non partiranno da zero e non sarà più un training da capo.
Con una sola riga di codice puoi salvare e ricaricare i pesi nel modello.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Dato che qui non hai un dataset di test, usiamo i dati di validazione per fare predizioni con il modello appena addestrato.
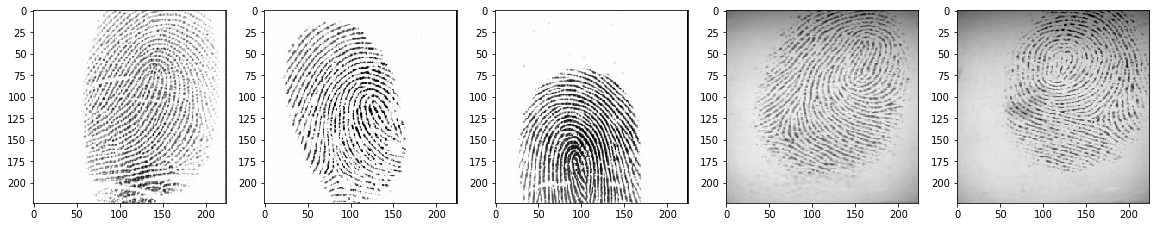
Farai predizioni sulle restanti 640 immagini di validazione e tracerai alcune delle immagini ricostruite per visualizzare quanto bene il modello riesce a ricostruirle.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
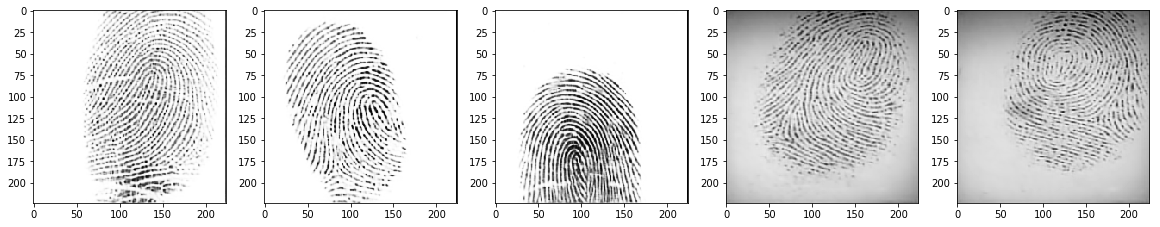
Dalle figure sopra, puoi osservare che il modello ha fatto un lavoro eccellente nel ricostruire le immagini di test. Almeno visivamente, le immagini di test e quelle ricostruite appaiono quasi identiche.
Come hai visto nel grafico training vs. validation, il modello generalizzava bene su dati non visti. È ora il momento di testarne la robustezza con dati provenienti da sensori completamente diversi.
Testerai il modello su due tipi di sensori.
Per prima cosa, testiamo il modello su immagini di un sensore di qualità inferiore, cioè Secugen, e vediamo come si comporta!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
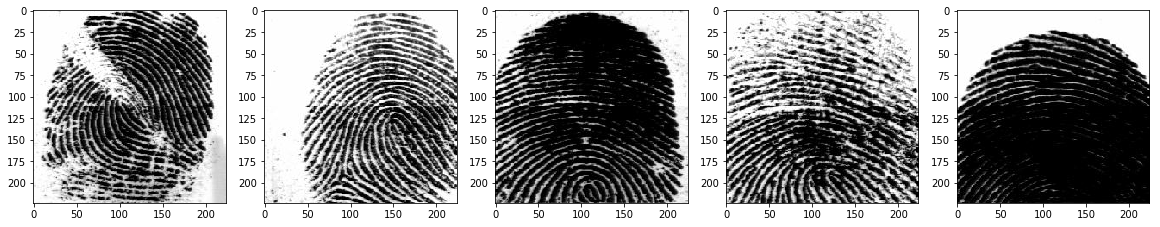
Test Secugen Images
Reconstruction of Test Secugen Images
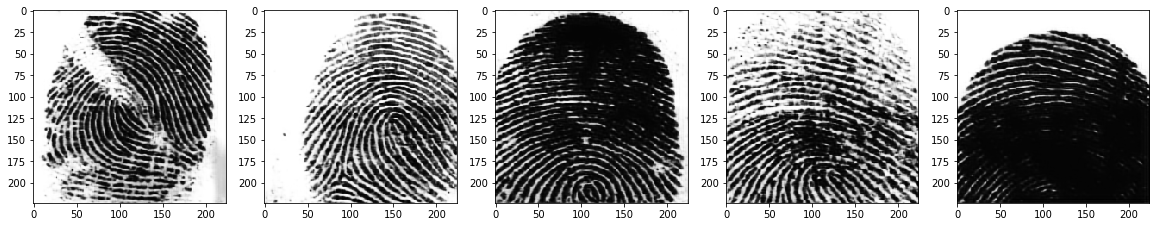
Dalle figure sopra, puoi osservare che il modello ha fatto un ottimo lavoro nel ricostruire le immagini secugen che hai predetto usando il modello addestrato. Non è fantastico?
Ora testiamo il modello su immagini provenienti da un sensore di qualità decisamente migliore, cioè Lumidigm.
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
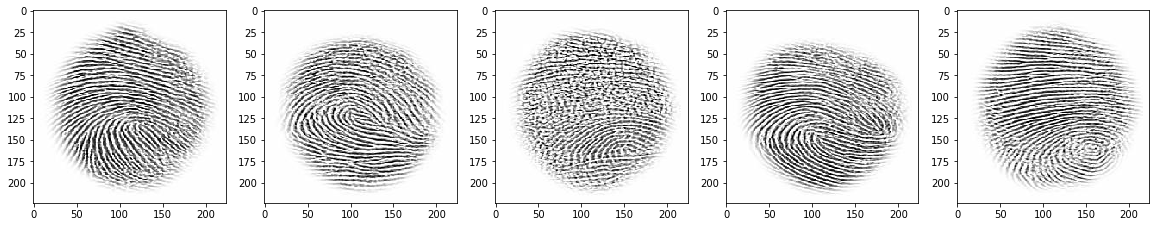
Reconstruction of Test Lumidigm Images
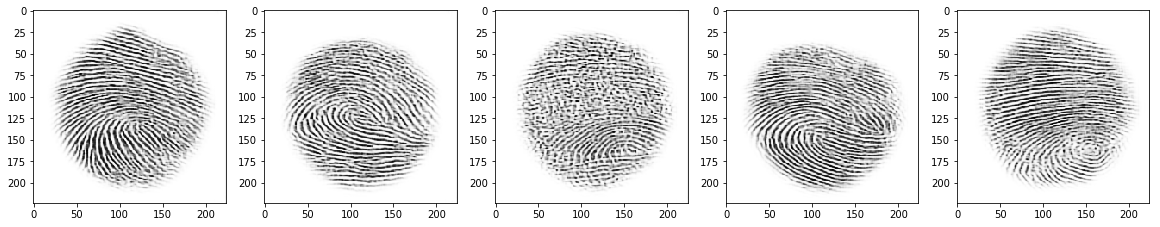
Dalle figure sopra, puoi osservare che anche in questo caso il modello ha fatto un ottimo lavoro nel ricostruire le immagini lumidigm che hai predetto usando il modello addestrato.
Questo tutorial è stato un buon inizio per capire come leggere immagini da zero, analizzarle, pre-processarle e fornirle a un modello usando un dataset di impronte digitali. Ti ha mostrato un’applicazione pratica molto interessante degli autoencoder. Se sei riuscito a seguire facilmente, o anche con un po’ di impegno in più, ottimo lavoro!
Nel prossimo tutorial imparerai a leggere immagini mediche di modalità T-1 e a ricostruirle usando un autoencoder!
C’è ancora molto da coprire, quindi perché non seguire il corso di DataCamp Deep Learning in Python? Se non l’hai già fatto. Imparerai dalle basi per poi arrivare a padroneggiare il deep learning; sarà senza dubbio una risorsa indispensabile quando imparerai a lavorare con reti neurali convoluzionali in Python, a rilevare volti, oggetti, ecc.
Corsi di Python
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



