Kurs
Einführung in Python
4 Std.
7M
Du verwendest den FVC2002-Fingerabdruckdatensatz, um dein Netzwerk zu trainieren. Um die Leistungsfähigkeit deines Modells zu beurteilen, testest du es auf zwei verschiedenen Fingerabdrucksensor-Datensätzen: Secugen und Lumidigm.
Hinweis : Dieses Tutorial konzentriert sich hauptsächlich auf die praktische Umsetzung von Convolutional Autoencodern. Falls du mit Convolutional Neural Networks (CNN) und Autoencodern noch nicht vertraut bist, sieh dir vorher das CNN- und das Autoencoder-Tutorial an.
Zusammengefasst behandelst du heute folgende Themen:
Bevor du die Daten lädst, lohnt sich ein Blick darauf, womit du genau arbeitest. Der FVC2002-Fingerabdruckdatensatz stammt vom Fingerprint Verification Competition, das erstmals im Jahr 2000 und erneut 2002 organisiert wurde. Der Datensatz umfasst vier unterschiedliche Sensortypen: kostengünstiger optischer Sensor, kostengünstiger kapazitiver Sensor, optischer Sensor und synthetischer Generator, jeweils mit unterschiedlichen Bildgrößen. Set A enthält 3200 Bilder, pro Sensor 800 Bilder. Das kannst du später überprüfen, sobald die Daten geladen sind! ;)
Der Fingerabdruckdatensatz ist in Keras oder TensorFlow nicht vordefiniert, du musst ihn daher von dieser Quelle herunterladen. Wie das geht, siehst du im nächsten Abschnitt.
Hinweis : Das Modell wird auf einem System mit Nvidia 1080 Ti GPU, Xeon e5 GeForce Prozessor und 32 GB RAM trainiert. Wenn du Jupyter Notebook verwendest, musst du drei Zeilen Code ergänzen, um über das Modul os die CUDA-Device-Order und die sichtbaren CUDA-Geräte festzulegen.
Im folgenden Code setzt du Umgebungsvariablen im Notebook mit os.environ. Es ist sinnvoll, das vor der Initialisierung von Keras zu tun, um das Keras-Backend TensorFlow auf die erste GPU zu beschränken. Falls sich die GPU auf deinem Trainingsrechner auf Index 0 befindet, nutze 0 statt 1. Das kannst du z. B. mit dem Terminalbefehl nvidia-smi prüfen.
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Als Erstes importierst du alle benötigten Module wie cv2, numpy, matplotlib und vor allem keras, da du damit in diesem Tutorial arbeitest.
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Sobald die Daten geladen sind, kannst du sie analysieren, um ein Gefühl für den Datensatz zu bekommen, mit dem du heute arbeitest.
Schauen wir uns an, wie die Bilder im Datensatz aussehen, und werfen wir mit dem NumPy-Attribut .shape einen Blick auf die Dimensionen:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Wie du siehst, hat das Array die Form 3200 x 224 x 224, da es 3200 Bildmatrizen mit je 224 x 224 Pixeln enthält.
Werfen wir nun einen Blick auf zwei Beispielbilder aus dem Datensatz:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
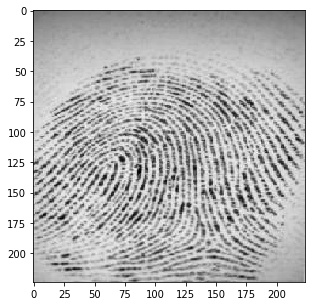
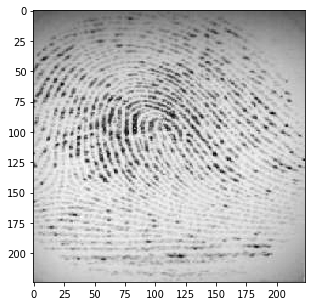
Die beiden Ausgaben stammen aus dem Datensatz. Die Fingerabdrücke sind nicht besonders klar. Es wird spannend zu sehen, ob der Convolutional Autoencoder die Merkmale sauber lernt und die Bilder überzeugend rekonstruieren kann.
Die Bilder sind Graustufenbilder mit Pixelwerten von 0 bis 255 und einer Größe von 224 x 224. Bevor du sie ins Modell gibst, ist Vorverarbeitung wichtig. Zuerst wandelst du jedes 224 x 224 Bild in eine Matrix der Größe 224 x 224 x 1 um, die du anschließend ins Netzwerk einspeist:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Als Nächstes prüfst du den Datentyp des NumPy-Arrays. Er sollte float32 sein. Falls nicht, musst du konvertieren. Außerdem skalierst du die Pixelwerte auf den Bereich 0 bis 1. Los geht’s!
Prüfen wir zuerst den Datentyp:
images_arr.dtype
dtype('float32')
Jetzt skalierst du die Daten mit dem maximalen Pixelwert aus dem Datensatz:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Überprüfen wir Minimum und Maximum. Nach der Skalierung sollten sie 0.0 und 1.0 sein.
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Danach teilst du die Daten auf. Damit dein Modell gut generalisiert, splittest du in Trainings- und Validierungssatz. Du trainierst auf 80% der Daten und validierst auf den übrigen 20%.
So reduzierst du auch das Risiko von Overfitting, da du auf Daten validierst, die das Modell im Training nicht gesehen hat.
Zum Aufteilen nutzt du train_test_split aus scikit-learn:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Hinweis: Für diese Aufgabe brauchst du keine separaten Labels. Deshalb übergibst du die Trainingsbilder zweimal. Sie dienen sowohl als Eingabe als auch als Ground Truth, ähnlich wie Labels in einer Klassifikationsaufgabe.
Jetzt kannst du das Netzwerk definieren und mit Daten füttern. Los geht’s!
Die Bilder haben die Größe 224 x 224 x 1, also 50.176 Werte. Du wandelst die Bildmatrix in ein Array um, skalierst auf 0 bis 1, formst sie auf 224 x 224 x 1 und gibst sie als Input ins Netzwerk.
Du nutzt eine Batchgröße von 128. Größere Batches wie 256 oder 512 sind ebenfalls möglich – das hängt von deinem System ab. Die Batchgröße beeinflusst Lernverhalten und Vorhersagegenauigkeit stark. Du trainierst das Netzwerk 50 Epochen.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Wie du sicher weißt, besteht ein Autoencoder aus zwei Teilen: Encoder und Decoder.
Encoder
Decoder
Die Max-Pooling-Schicht halbiert jeweils die räumliche Auflösung, die Upsampling-Schicht verdoppelt sie wieder.
Hinweis: Anzahl und Größe der Filter, die Zahl der Schichten, die Epochen – all das sind Hyperparameter. Experimentiere gern damit und messe die Leistung deines Modells. So lernst du nach und nach die Feinheiten des Deep Learnings.
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Nachdem das Modell erstellt ist, kompilierst du es mit dem RMSprop-Optimizer.
Außerdem musst du den Verlusttyp über den Parameter loss festlegen. Hier ist es der Mean Squared Error, da der Verlust nach jedem Batch als pixelweiser MSE zwischen vorhergesagter Ausgabe und Ground Truth berechnet wird:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Lass dir mit summary die Modellstruktur ausgeben. So siehst du die Parameteranzahl (Gewichte und Biases) je Schicht und insgesamt.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Jetzt trainierst du mit der Keras-Funktion fit(). Das Training läuft 200 Epochen. Die Funktion gibt ein History-Objekt zurück. Speichere das Ergebnis, um später Trainings- und Validierungsverlust zu plotten und die Performance visuell zu beurteilen.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Geschafft! Du hast das Modell 200 Epochen lang auf dem Fingerabdruckdatensatz trainiert. Jetzt plotten wir den Verlustverlauf von Training und Validierung, um die Leistung zu visualisieren.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
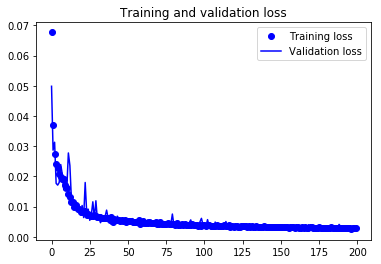
Wie du siehst, verlaufen Validierungs- und Trainingsverlust eng beieinander. Das Modell überanpasst nicht: Der Validierungsverlust sinkt und steigt nicht an, und insbesondere ab etwa Epoche 40 gibt es kaum eine Lücke zwischen beiden Kurven.
Damit lässt sich sagen: Die Generalisierungsfähigkeit deines Modells ist gut.
Jetzt rekonstruieren wir Validierungsbilder mit der predict()-Funktion von Keras und sehen uns an, wie gut die Rekonstruktionen ausfallen.
Speichern wir nun das trainierte Modell. Das ist bei Deep-Learning-Projekten entscheidend, denn die Gewichte sind der Kern deiner Lösung.
Du kannst die gespeicherten Gewichte jederzeit in dasselbe Modell laden und das Training dort fortsetzen, wo du aufgehört hast. Wenn du das obige Modell erneut trainierst, starten Parameter wie Gewichte, Biases und auch die Verlustkurve nicht bei null – es ist kein frisches Training mehr.
Mit nur einer Codezeile kannst du Gewichte speichern und wieder laden.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Da hier kein separates Testset vorliegt, nutzen wir die Validierungsdaten für die Vorhersage mit dem soeben trainierten Modell.
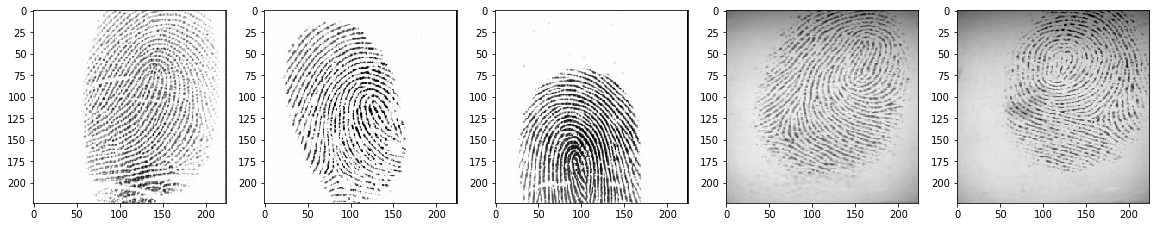
Du lässt das Modell auf den verbleibenden 640 Validierungsbildern vorhersagen und plottest einige rekonstruierte Beispiele, um die Qualität zu beurteilen.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
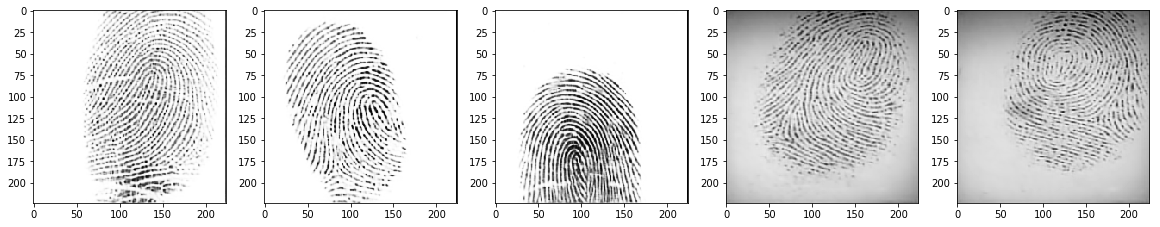
Wie du in den Abbildungen siehst, rekonstruiert das Modell die Testbilder äußerst gut. Visuell sind Original und Rekonstruktion nahezu identisch.
Im Trainings-vs.-Validierungs-Plot hast du gesehen, dass dein Modell auf unbekannten Daten gut generalisiert. Jetzt testen wir die Robustheit mit Daten aus anderen Sensoren.
Du testest auf zwei Sensortypen:
Beginnen wir mit einem Sensor geringerer Qualität, also Secugen, und prüfen, wie gut das Modell performt.
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Secugen Images
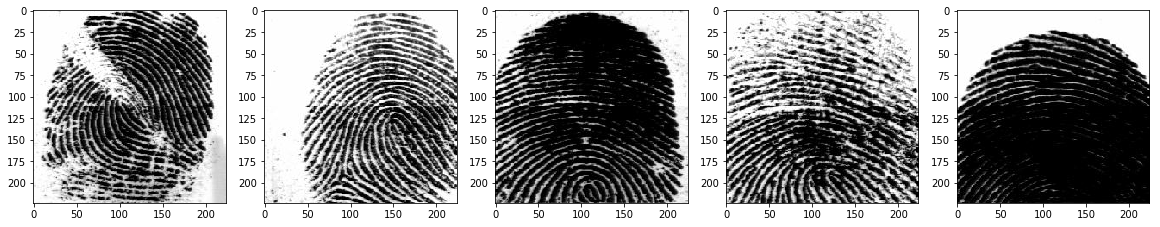
Reconstruction of Test Secugen Images
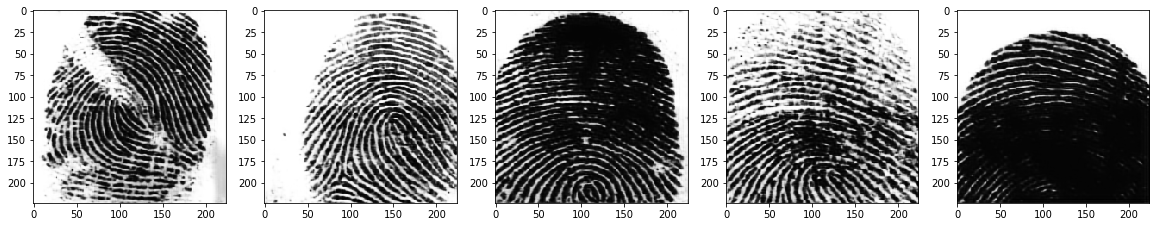
Auch hier leistet das Modell hervorragende Arbeit bei der Rekonstruktion der Secugen-Bilder. Ziemlich beeindruckend, oder?
Nun testen wir mit Bildern eines Sensors besserer Qualität, also Lumidigm.
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Lumidigm Images
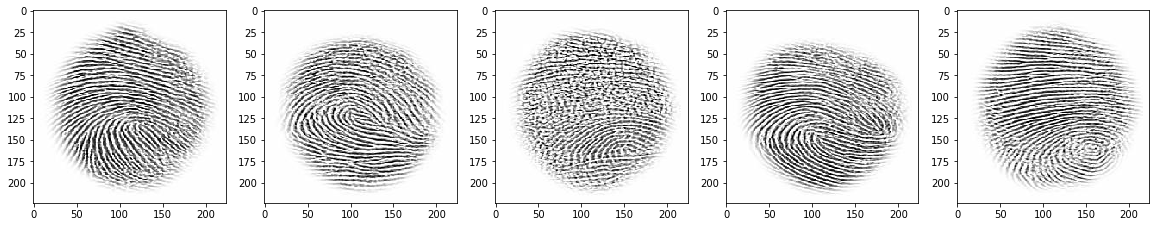
Reconstruction of Test Lumidigm Images
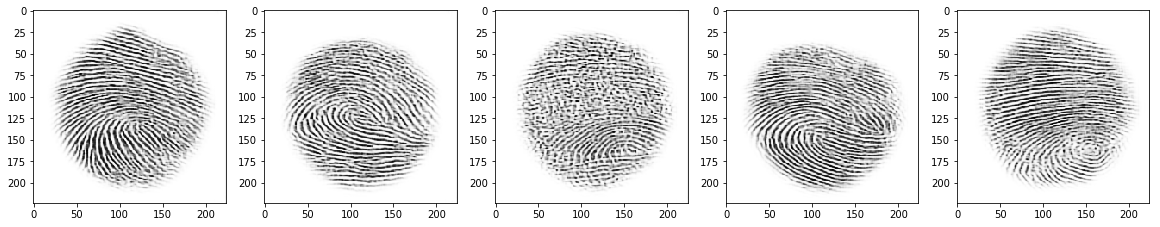
Auch bei den Lumidigm-Bildern liefert dein Modell ausgezeichnete Rekonstruktionen.
Dieses Tutorial war ein guter Einstieg: Du hast gelernt, Bilder von Grund auf einzulesen, zu analysieren, vorzuverarbeiten und mit einem Fingerabdruckdatensatz in ein Modell zu speisen. Du hast eine praktische Anwendung von Autoencodern gesehen. Wenn du gut mitgekommen bist – oder dich durchgebissen hast – starke Leistung!
Im nächsten Tutorial lernst du, medizinische Bilder der T1-Modaliät einzulesen und mit einem Autoencoder zu rekonstruieren.
Es gibt noch viel zu entdecken. Warum nicht DataCamps Kurs Deep Learning in Python belegen, falls noch nicht geschehen? Du startest bei den Grundlagen und arbeitest dich Schritt für Schritt hinein – ideal, um Convolutional Neural Networks in Python zu verstehen und z. B. Gesichter oder Objekte zu erkennen.
Python-Kurse
Kurs
Kurs
Kurs