Kurs
Python’a Giriş
4 sa
7M
Ağınızı eğitmek için FVC2002 parmak izi veri setini kullanacaksınız. Modelinizin etkinliğini gözlemlemek için, modelinizi Secugen ve Lumidigm adlı iki farklı parmak izi sensörü veri seti üzerinde test edeceksiniz.
Not : Bu eğitim büyük ölçüde evrişimsel otomatik kodlayıcıların pratik uygulamasını kapsayacaktır. Bu nedenle, eğer henüz evrişimli sinir ağı (CNN) ve otomatik kodlayıcı hakkında bilgi sahibi değilseniz, CNN ve Otomatik Kodlayıcı eğitimlerine göz atmak isteyebilirsiniz.
Özetle, bugünkü eğitimde aşağıdaki konuları ele alacaksınız:
Verileri yüklemeye geçmeden önce, tam olarak ne ile çalışacağınızı görmek iyi olacaktır! FVC2002 parmak izi veri seti, ilki 2000 yılında ardından 2002 yılında düzenlenen Parmak İzi Doğrulama Yarışması’na aittir. Bu veri seti, her biri farklı görüntü boyutlarına sahip Düşük Maliyetli Optik Sensör, Düşük Maliyetli Kapasitif Sensör, Optik Sensör ve Sentetik Üreteç olmak üzere dört farklı sensöre ait parmak izi görüntülerinden oluşur. Veri setinde A kümesinde toplam 3200 görüntü vardır; sensör başına 800 görüntü. Verilerinizi yüklediğinizde bunu daha sonra kendiniz de iki kez kontrol edebilirsiniz! ;)
Parmak izi veri seti Keras veya TensorFlow çatısında ön tanımlı değildir, bu yüzden verileri bu kaynaktan indirmeniz gerekir. Bir sonraki bölümde bunun nasıl yapılacağını göreceksiniz!
Not : Başlamadan önce, modelin Nvidia 1080 Ti GPU Xeon e5 GeForce işlemci ve 32GB RAM’e sahip bir sistemde eğitileceğini lütfen not edin. Jupyter Notebook kullanıyorsanız, os adlı bir modül kullanarak CUDA cihaz sırasını ve görünür CUDA cihazlarını belirttiğiniz üç satır daha kod eklemeniz gerekecektir.
Aşağıdaki kodda, temelde os.environ kullanarak not defterinde ortam değişkenlerini ayarlıyorsunuz. Keras’ı başlatmadan önce bunu yapmak, Keras arka ucu TensorFlow’u ilk GPU ile sınırlamak için iyidir. Eğittiğiniz makinede GPU 0’da ise, 1 yerine 0 kullandığınızdan emin olun. Bunu terminalinizde basit bir komut çalıştırarak kontrol edebilirsiniz: örneğin, nvidia-smi
import os
os.environ["CUDA_DEVICE_ORDER"]="PCI_BUS_ID"
os.environ["CUDA_VISIBLE_DEVICES"]="1" #model will be trained on GPU 1
Önce, bugün kullanacağınız çatı Keras olduğundan, cv2, numpy, matplotlib ve en önemlisi keras gibi gerekli tüm modülleri içe aktarın!
import cv2
import matplotlib.pyplot as plt
%matplotlib inline
from skimage.filters import threshold_otsu
import numpy as np
from glob import glob
from scipy import misc
from matplotlib.patches import Circle,Ellipse
from matplotlib.patches import Rectangle
import os
from PIL import Image
import keras
from matplotlib import pyplot as plt
import numpy as np
import gzip
%matplotlib inline
from keras.layers import Input,Conv2D,MaxPooling2D,UpSampling2D
from keras.models import Model
from keras.optimizers import RMSprop
from keras.layers.normalization import BatchNormalization
Using TensorFlow backend.
data = glob('FVC2002/Db*/*')
len(data)
3200
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(data)
images_arr = np.asarray(images)
images_arr = images_arr.astype('float32')
images_arr.shape
(3200, 224, 224)
Verileri yükledikten sonra, bugünkü eğitimde çalışacağınız veri seti hakkında sezgi kazanmak için verileri analiz etmeye hazırsınız!
Şimdi veri setindeki görüntülerin nasıl göründüğünü analiz edelim ve NumPy dizisinin .shape özelliğinin yardımıyla görüntülerin boyutlarına bakalım:
# Shapes of training set
print("Dataset (images) shape: {shape}".format(shape=images_arr.shape))
Dataset (images) shape: (3200, 224, 224)
Yukarıdaki çıktıya göre, 224 x 224 boyutunda 3200 örnek olduğundan verilerin boyutu 3200 x 224 x 224’dür.
Şimdi, veri setinizdeki birkaç görüntüye göz atalım:
#plt.figure(figsize=[5,5])

# Display the first image in training data
for i in range(2):
    plt.figure(figsize=[5, 5])
    curr_img = np.reshape(images_arr[i], (224,224))
    plt.imshow(curr_img, cmap='gray')
    plt.show()
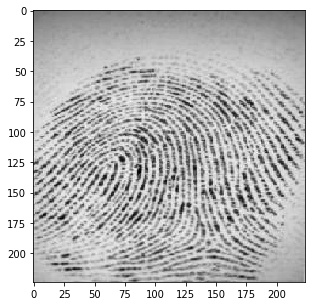
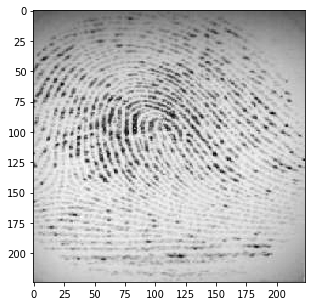
Yukarıdaki iki grafiğin çıktıları veri setinden alınmıştır. Parmak izlerinin çok net olmadığını görebilirsiniz; evrişimsel otomatik kodlayıcının bu özellikleri öğrenip görüntüleri doğru şekilde yeniden inşa edip edemeyeceğini görmek ilginç olacaktır.
Veri setindeki görüntüler, piksel değerleri 0 ile 255 arasında değişen ve boyutu 224 x 224 olan gri tonlamalı görüntülerdir; bu nedenle verileri modele beslemeden önce ön işleme yapmak çok önemlidir. Önce veri setindeki her 224 x 224 görüntüyü 224 x 224 x 1 boyutunda bir matrise dönüştüreceksiniz; böylece bunu ağa girdi olarak verebilirsiniz:
images_arr = images_arr.reshape(-1, 224,224, 1)
images_arr.shape
(3200, 224, 224, 1)
Sonraki adımda, NumPy dizisinin veri türünü kontrol ettiğinizden emin olmak istersiniz; float32 formatında olmalıdır, değilse bu formata dönüştürmeniz gerekir; ayrıca piksel değerlerini 0 - 1 aralığına yeniden ölçeklendirmeniz gerekir. Hadi bunu yapalım!
İlk olarak, veri türünü doğrulayalım:
images_arr.dtype
dtype('float32')
Ardından, verileri görüntülerdeki maksimum piksel değeriyle yeniden ölçeklendirin:
np.max(images_arr)
255.0
images_arr = images_arr / np.max(images_arr)
Yeniden ölçeklendirdikten sonra verinin maksimum ve minimum değerlerini doğrulayalım; 0.0 ve 1.0 olmalıdır!
np.max(images_arr), np.min(images_arr)
(1.0, 0.0)
Tüm bunlardan sonra, verileri bölmek önemlidir. Modelinizin iyi genelleştirebilmesi için verileri iki kısma ayırırsınız: eğitim ve doğrulama kümesi. Modelinizi verilerin %80’i ile eğitecek ve kalan verilerin %20’sinde doğrulayacaksınız.
Bu, modeli eğitim aşamasında görmediği veriler üzerinde doğrulayacağınız için aşırı uyum riskini azaltmanıza da yardımcı olacaktır.
Verileri düzgün bir şekilde bölmek için scikit-learn’ün train_test_split modülünü kullanabilirsiniz:
from sklearn.model_selection import train_test_split
train_X,valid_X,train_ground,valid_ground = train_test_split(images_arr,
                                                             images_arr,
                                                             test_size=0.2,
                                                             random_state=13)
Not bu görev için eğitim ve test etiketlerine ihtiyacınız yok. Bu nedenle eğitim görüntülerini iki kez geçeceksiniz. Sınıflandırma görevindeki etiketlere benzer şekilde, eğitim görüntüleriniz hem girdi hem de yer gerçeği olarak görev yapacaktır.
Artık ağı tanımlamaya ve verileri ağa beslemeye hazırsınız. O halde daha fazla gecikmeden bir sonraki adıma geçelim!
Görüntülerin boyutu 224 x 224 x 1 veya 50.176 boyutlu bir vektördür. Görüntü matrisini bir diziye dönüştürür, 0 ile 1 arasına yeniden ölçeklendirir, 224 x 224 x 1 boyutuna yeniden şekillendirir ve bunu ağa girdi olarak verirsiniz.
Ayrıca, 128’lik bir yığın boyutu kullanacaksınız; 256 veya 512 gibi daha yüksek bir yığın boyutu da tercih edilebilir, bu tamamen modelinizi eğittiğiniz sisteme bağlıdır. Bu seçim, öğrenme parametrelerinin belirlenmesine ve tahmin doğruluğuna büyük ölçüde etki eder. Ağınızı 50 dönem boyunca eğiteceksiniz.
batch_size = 128
epochs = 200
inChannel = 1
x, y = 224, 224
input_img = Input(shape = (x, y, inChannel))
Muhtemelen bildiğiniz gibi, otomatik kodlayıcı iki bölüme ayrılır: bir kodlayıcı ve bir kod çözücü vardır.
Kodlayıcı
Kod Çözücü
Maksimum havuzlama katmanı her kullanıldığında girişi iki kat aşağı örneklerken, yukarı örnekleme katmanı her kullanıldığında girişi iki kat yukarı örnekleyecektir.
Not: Filtre sayısı, filtre boyutu, katman sayısı, modelinizi eğittiğiniz dönem sayısı gibi tümü hiperparametrelerdir ve kendi sezginize göre belirlenmelidir; bu hiperparametrelerle oynayarak yeni deneyler yapıp modelinizin performansını ölçmekte özgürsünüz. Derin öğrenme sanatını yavaş yavaş böyle öğreneceksiniz!
def autoencoder(input_img):
    #encoder
    #input = 28 x 28 x 1 (wide and thin)
    conv1 = Conv2D(32, (3, 3), activation='relu', padding='same')(input_img) #28 x 28 x 32
    pool1 = MaxPooling2D(pool_size=(2, 2))(conv1) #14 x 14 x 32
    conv2 = Conv2D(64, (3, 3), activation='relu', padding='same')(pool1) #14 x 14 x 64
    pool2 = MaxPooling2D(pool_size=(2, 2))(conv2) #7 x 7 x 64
    conv3 = Conv2D(128, (3, 3), activation='relu', padding='same')(pool2) #7 x 7 x 128 (small and thick)

    #decoder
    conv4 = Conv2D(128, (3, 3), activation='relu', padding='same')(conv3) #7 x 7 x 128
    up1 = UpSampling2D((2,2))(conv4) # 14 x 14 x 128
    conv5 = Conv2D(64, (3, 3), activation='relu', padding='same')(up1) # 14 x 14 x 64
    up2 = UpSampling2D((2,2))(conv5) # 28 x 28 x 64
    decoded = Conv2D(1, (3, 3), activation='sigmoid', padding='same')(up2) # 28 x 28 x 1
    return decoded
Model oluşturulduktan sonra, eniyileyici olarak RMSProp kullanarak derlemeniz gerekir.
Ayrıca loss bağımsız değişkeni ile kayıp türünü belirtmeniz gerektiğini unutmayın. Bu durumda ortalama karesel hatadır; çünkü her yığın sonrasında kayıp, tahmin edilen çıktı yığını ile yer gerçeği arasındaki piksel piksel ortalama karesel hata kullanılarak hesaplanacaktır:
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Yukarıdaki adımda oluşturduğunuz katmanları summary işlevini kullanarak görselleştirelim; bu, her katmandaki parametre (ağırlıklar ve yanlılıklar) sayısını ve ayrıca modelinizdeki toplam parametreleri gösterecektir.
autoencoder.summary()
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
input_1 (InputLayer)         (None, 224, 224, 1)       0
_________________________________________________________________
conv2d_1 (Conv2D)            (None, 224, 224, 32)      320
_________________________________________________________________
max_pooling2d_1 (MaxPooling2 (None, 112, 112, 32)      0
_________________________________________________________________
conv2d_2 (Conv2D)            (None, 112, 112, 64)      18496
_________________________________________________________________
max_pooling2d_2 (MaxPooling2 (None, 56, 56, 64)        0
_________________________________________________________________
conv2d_3 (Conv2D)            (None, 56, 56, 128)       73856
_________________________________________________________________
conv2d_4 (Conv2D)            (None, 56, 56, 128)       147584
_________________________________________________________________
up_sampling2d_1 (UpSampling2 (None, 112, 112, 128)     0
_________________________________________________________________
conv2d_5 (Conv2D)            (None, 112, 112, 64)      73792
_________________________________________________________________
up_sampling2d_2 (UpSampling2 (None, 224, 224, 64)      0
_________________________________________________________________
conv2d_6 (Conv2D)            (None, 224, 224, 1)       577
=================================================================
Total params: 314,625
Trainable params: 314,625
Non-trainable params: 0
_________________________________________________________________
Artık modeli Keras’ın fit() işleviyle eğitme zamanı! Model 200 dönem boyunca eğitilir. fit() işlevi bir geçmiş (history) nesnesi döndürür; Bu işlevin sonucunu fashion_train içine kaydederek daha sonra eğitim ve doğrulama arasındaki kayıp grafiğini çizebilir ve modelinizin performansını görsel olarak analiz edebilirsiniz.
autoencoder_train = autoencoder.fit(train_X, train_ground, batch_size=batch_size,epochs=epochs,verbose=1,validation_data=(valid_X, valid_ground))
Train on 2560 samples, validate on 640 samples
Epoch 1/200
2560/2560 [==============================] - 17s - loss: 0.0677 - val_loss: 0.0498
Epoch 2/200
2560/2560 [==============================] - 11s - loss: 0.0369 - val_loss: 0.0287
...
2560/2560 [==============================] - 11s - loss: 0.0029 - val_loss: 0.0024
Epoch 200/200
2560/2560 [==============================] - 11s - loss: 0.0027 - val_loss: 0.0028
Nihayet! Modeli parmak izi veri setinde 200 dönem boyunca eğittiniz. Şimdi, model performansını görselleştirmek için eğitim ve doğrulama verileri arasındaki kayıp grafiğini çizelim.
loss = autoencoder_train.history['loss']
val_loss = autoencoder_train.history['val_loss']
epochs = range(200)
plt.figure()
plt.plot(epochs, loss, 'bo', label='Training loss')
plt.plot(epochs, val_loss, 'b', label='Validation loss')
plt.title('Training and validation loss')
plt.legend()
plt.show()
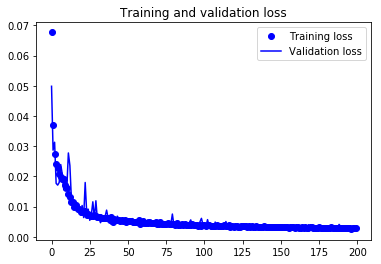
Sonuçta, doğrulama kaybı ile eğitim kaybının uyumlu olduğunu görebilirsiniz. Bu, modelinizin aşırı uyum göstermediğini ortaya koyuyor: doğrulama kaybı artmıyor, azalıyor ve özellikle 40. dönemden sonra eğitim ilerledikçe eğitim ve doğrulama kaybı arasında neredeyse hiç boşluk kalmıyor.
Dolayısıyla, modelinizin genelleme yeteneğinin iyi olduğunu söyleyebilirsiniz.
Son olarak, Keras’ın predict() işlevini kullanarak test görüntülerini yeniden inşa etme zamanı ve modelinizin test verileri üzerinde ne kadar iyi yeniden inşa yapabildiğini görelim.
Şimdi eğitilmiş modeli kaydedelim. Derin Öğrenme ile çalışırken bu önemli bir adımdır. Çünkü ağırlıklar, üzerinde çalıştığınız problemin çözümünün kalbidir!
Kaydedilmiş ağırlıkları istediğiniz zaman aynı modele yükleyebilir ve eğitimi kaldığı yerden sürdürebilirsiniz. Örneğin, yukarıdaki model tekrar eğitilirse, ağırlıklar, yanlılıklar, kayıp işlevi vb. gibi parametreler baştan başlamaz ve eğitim artık sıfırdan olmaz.
Sadece tek satır kodla, ağırlıkları kaydedebilir ve yeniden modele yükleyebilirsiniz.
autoencoder = autoencoder.save_weights('autoencoder.h5')
autoencoder = Model(input_img, autoencoder(input_img))
autoencoder.load_weights('autoencoder.h5')
autoencoder.compile(loss='mean_squared_error', optimizer = RMSprop())
Burada bir test veriniz olmadığı için, az önce eğittiğiniz model üzerinde tahmin yapmak üzere doğrulama verilerini kullanalım.
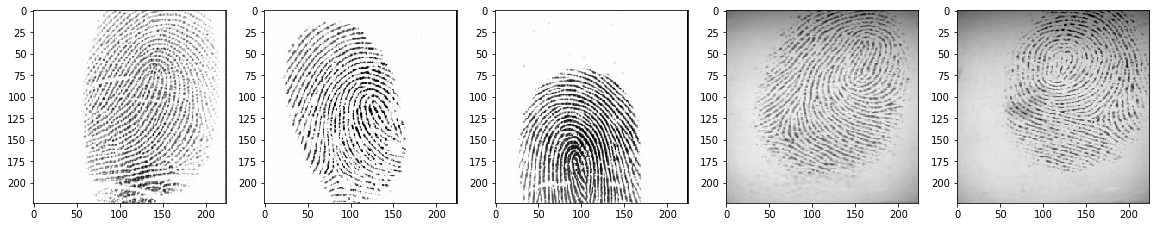
Eğitilmiş modeli kalan 640 doğrulama görüntüsü üzerinde tahmin edeceksiniz ve modelinizin doğrulama görüntülerini ne kadar iyi yeniden inşa edebildiğini görselleştirmek için birkaç yeniden inşa edilmiş görüntüyü çizeceksiniz.
pred = autoencoder.predict(valid_X)
plt.figure(figsize=(20, 4))
print("Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(valid_ground[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
Test Images
Reconstruction of Test Images
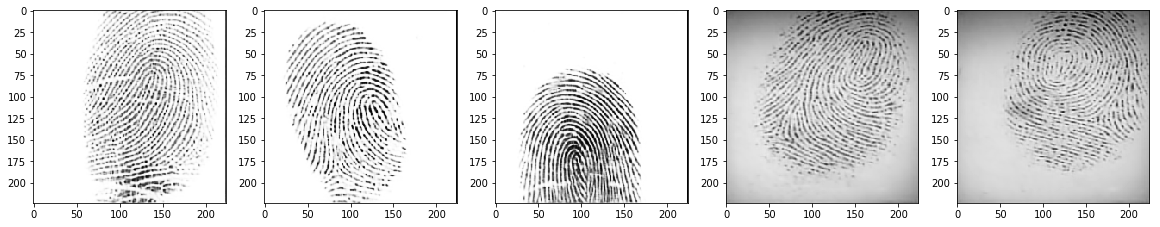
Yukarıdaki şekillerden, modelinizin eğitimli modeli kullanarak tahmin ettiğiniz test görüntülerini yeniden inşa etmede harika bir iş çıkardığını gözlemleyebilirsiniz. En azından görsel olarak, test ve yeniden inşa edilmiş görüntüler neredeyse birebir benzer görünüyor.
Eğitim ve doğrulama grafiğinde gördüğünüz gibi modeliniz görülmemiş veriler üzerinde iyi genelleme yapıyordu. Şimdi, tamamen farklı sensör verileri ile sağlamlığını test etme zamanı.
Modelinizi iki farklı sensör tipi üzerinde test edeceksiniz.
Önce, modelinizi düşük kaliteli bir parmak izi sensörü verisi yani Secugen üzerinde test edelim ve modelin nasıl performans gösterdiğine bakalım!
sec = glob('Secugen/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(sec)
secugen = np.asarray(images)
secugen = secugen.astype('float32')
images_arr.shape
(48, 224, 224, 1)
secugen = secugen / np.max(secugen)
secugen = secugen.reshape(-1, 224,224, 1)
pred = autoencoder.predict(secugen)
plt.figure(figsize=(20, 4))
print("Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(secugen[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Secugen Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
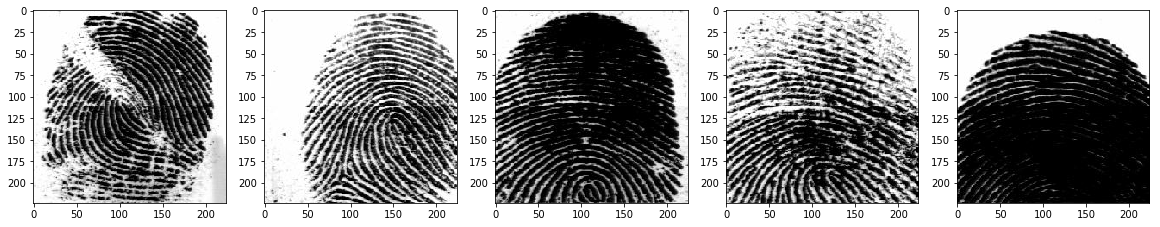
Test Secugen Images
Reconstruction of Test Secugen Images
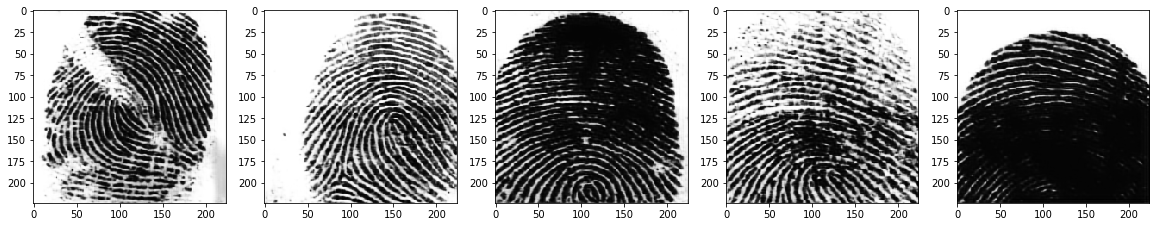
Yukarıdaki şekillerden, eğitilmiş modeli kullanarak tahmin ettiğiniz secugen görüntülerini yeniden inşa etmede modelinizin çok iyi iş çıkardığını gözlemleyebilirsiniz. Bu harika değil mi?
Şimdi, modelinizi nispeten daha iyi kalite sensör görüntülerinde yani Lumidigm üzerinde test edelim
lum = glob('Lumidigm/*')
images = []
def read_images(data):
    for i in range(len(data)):
        img = misc.imread(data[i])
        img = misc.imresize(img,(224,224))
        images.append(img)
    return images
images = read_images(lum)
lumidigm = np.asarray(images)
lumidigm = lumidigm.astype('float32')
lumidigm.shape
(48, 224, 224)
lumidigm = lumidigm / np.max(lumidigm)
lumidigm = lumidigm.reshape(-1, 224,224, 1)
pred = autoencoder.predict(lumidigm)
plt.figure(figsize=(20, 4))
print("Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(lumidigm[i, ..., 0], cmap='gray')
plt.show()
plt.figure(figsize=(20, 4))
print("Reconstruction of Test Lumidigm Images")
for i in range(5):
    plt.subplot(1, 5, i+1)
    plt.imshow(pred[i, ..., 0], cmap='gray')
plt.show()
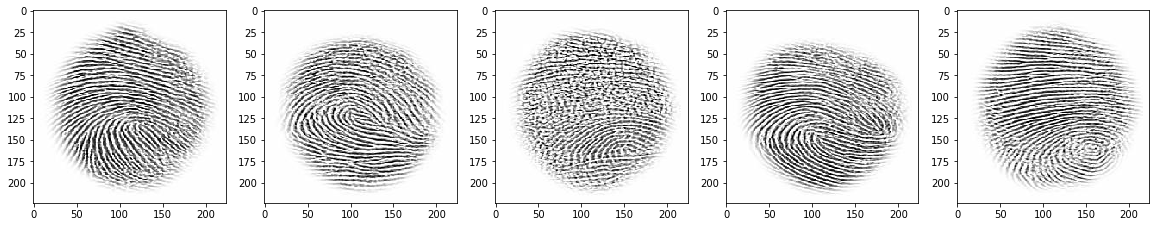
Test Lumidigm Images
Reconstruction of Test Lumidigm Images
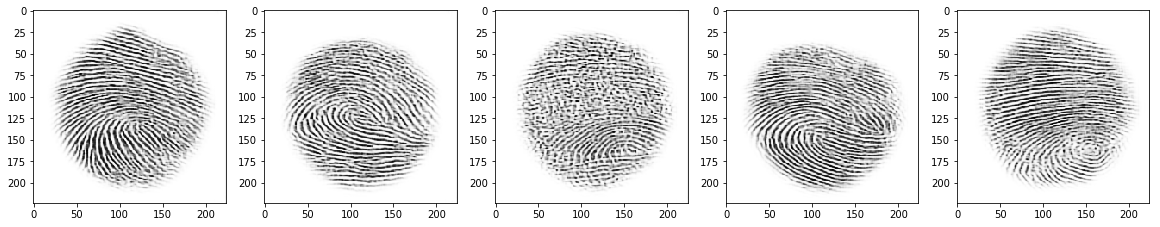
Yukarıdaki şekillerden, eğitilmiş modeli kullanarak tahmin ettiğiniz lumidigm görüntülerini yeniden inşa etmede modelinizin yine mükemmel bir iş çıkardığını gözlemleyebilirsiniz.
Bu eğitim, görüntüleri sıfırdan nasıl okuyacağınızı, analiz edeceğinizi, ön işleyeceğinizi ve bir parmak izi veri seti kullanarak modele nasıl besleyeceğinizi anlamak için iyi bir başlangıç oldu. Otomatik kodlayıcıların güzel bir uygulamasını pratik olarak gösterdi. Kolayca ya da biraz daha fazla çabayla birlikte ilerleyebildiyseniz, tebrikler!
Bir sonraki eğitimde, T-1 modalitesine ait tıbbi görüntülerin nasıl okunacağını ve bir otomatik kodlayıcı kullanarak nasıl yeniden inşa edileceğini öğreneceksiniz!
Ele alınacak daha çok şey var; o halde neden DataCamp’in Python ile Derin Öğrenmeye Giriş kursunu almayasınız? Henüz almadıysanız, temellerden başlayıp yavaş yavaş derin öğrenme alanında uzmanlaşmaya ilerleyeceksiniz; Python’da evrişimli sinir ağlarıyla çalışma, yüzleri, nesneleri vb. algılama gibi konuları öğrenirken şüphesiz vazgeçilmez bir kaynak olacaktır.
Python Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




