Apa itu FLAN-T5?
FLAN-T5 adalah model bahasa besar sequence-to-sequence open-source yang juga dapat digunakan secara komersial. Model ini dipublikasikan oleh peneliti Google pada akhir 2022, dan telah di-fine-tune pada berbagai tugas.
Model T5 membingkai ulang berbagai tugas ke dalam format text-to-text, seperti penerjemahan, kelayakan linguistik, kesamaan kalimat, dan peringkasan dokumen, seperti yang ditunjukkan di bawah ini:
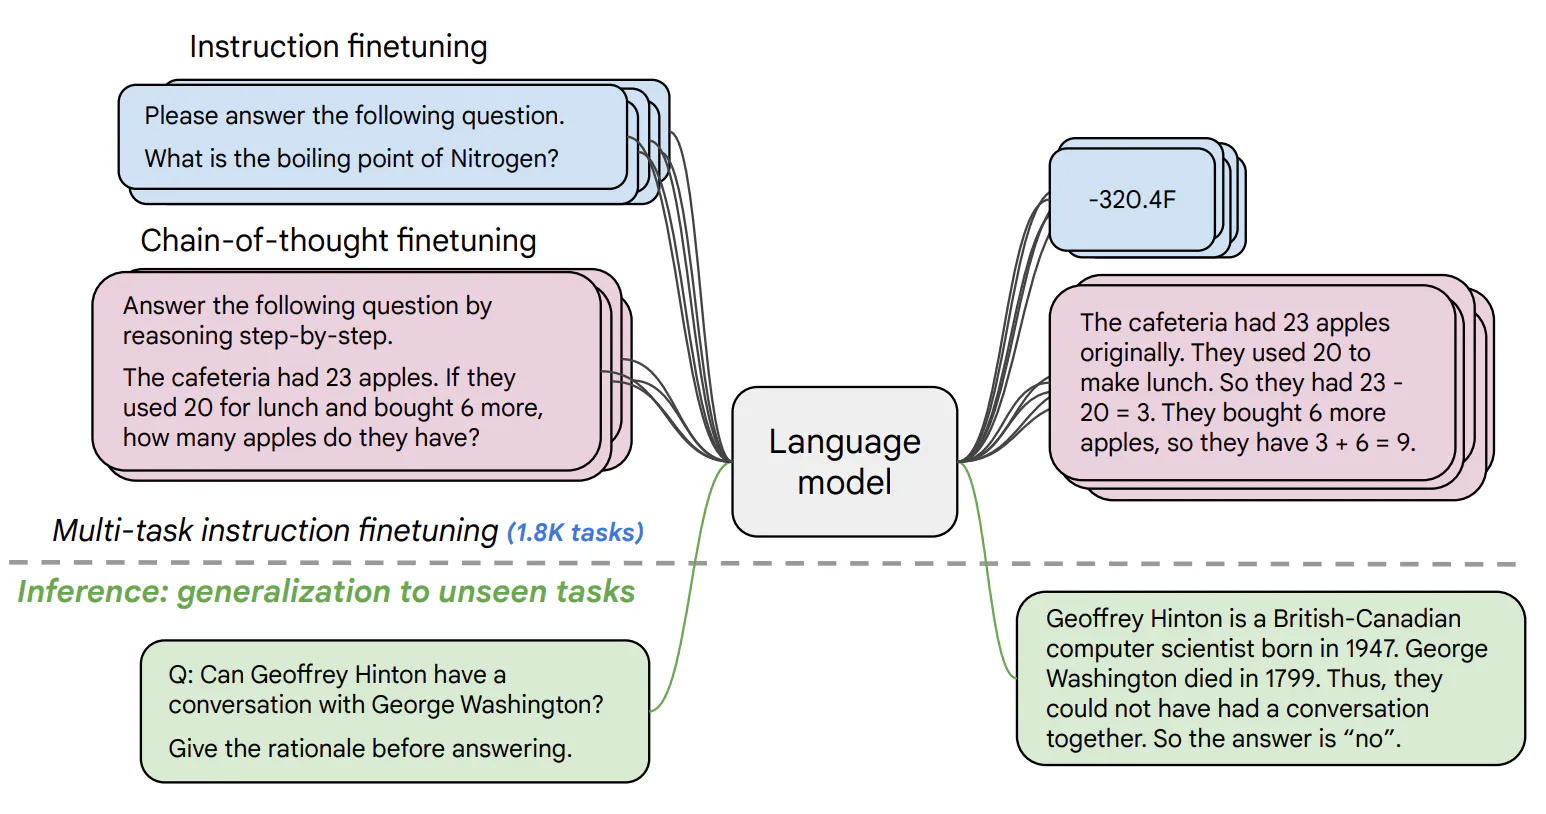
Contoh bagaimana T5 membingkai ulang beragam tugas ke dalam kerangka text-to-text (sumber)
Demikian pula, arsitektur model T5 selaras erat dengan struktur encoder-decoder yang digunakan dalam makalah Transformer asli. Perbedaan utama terletak pada ukuran dan sifat data pelatihan; T5 dilatih pada korpus teks sangat besar sebesar 750GB yang dikenal sebagai Colossal Clean Crawled Corpus (C4).
Sebaliknya, Transformer asli dirancang khusus untuk penerjemahan bahasa dan karena itu dilatih pada dataset yang terdiri dari 1,4 GB pasangan kalimat bahasa Inggris-Jerman.
Artikel kami Pengantar Menggunakan Transformers dan Hugging Face memandu pembaca memahami transformer dan memanfaatkan kekuatannya untuk memecahkan masalah nyata.
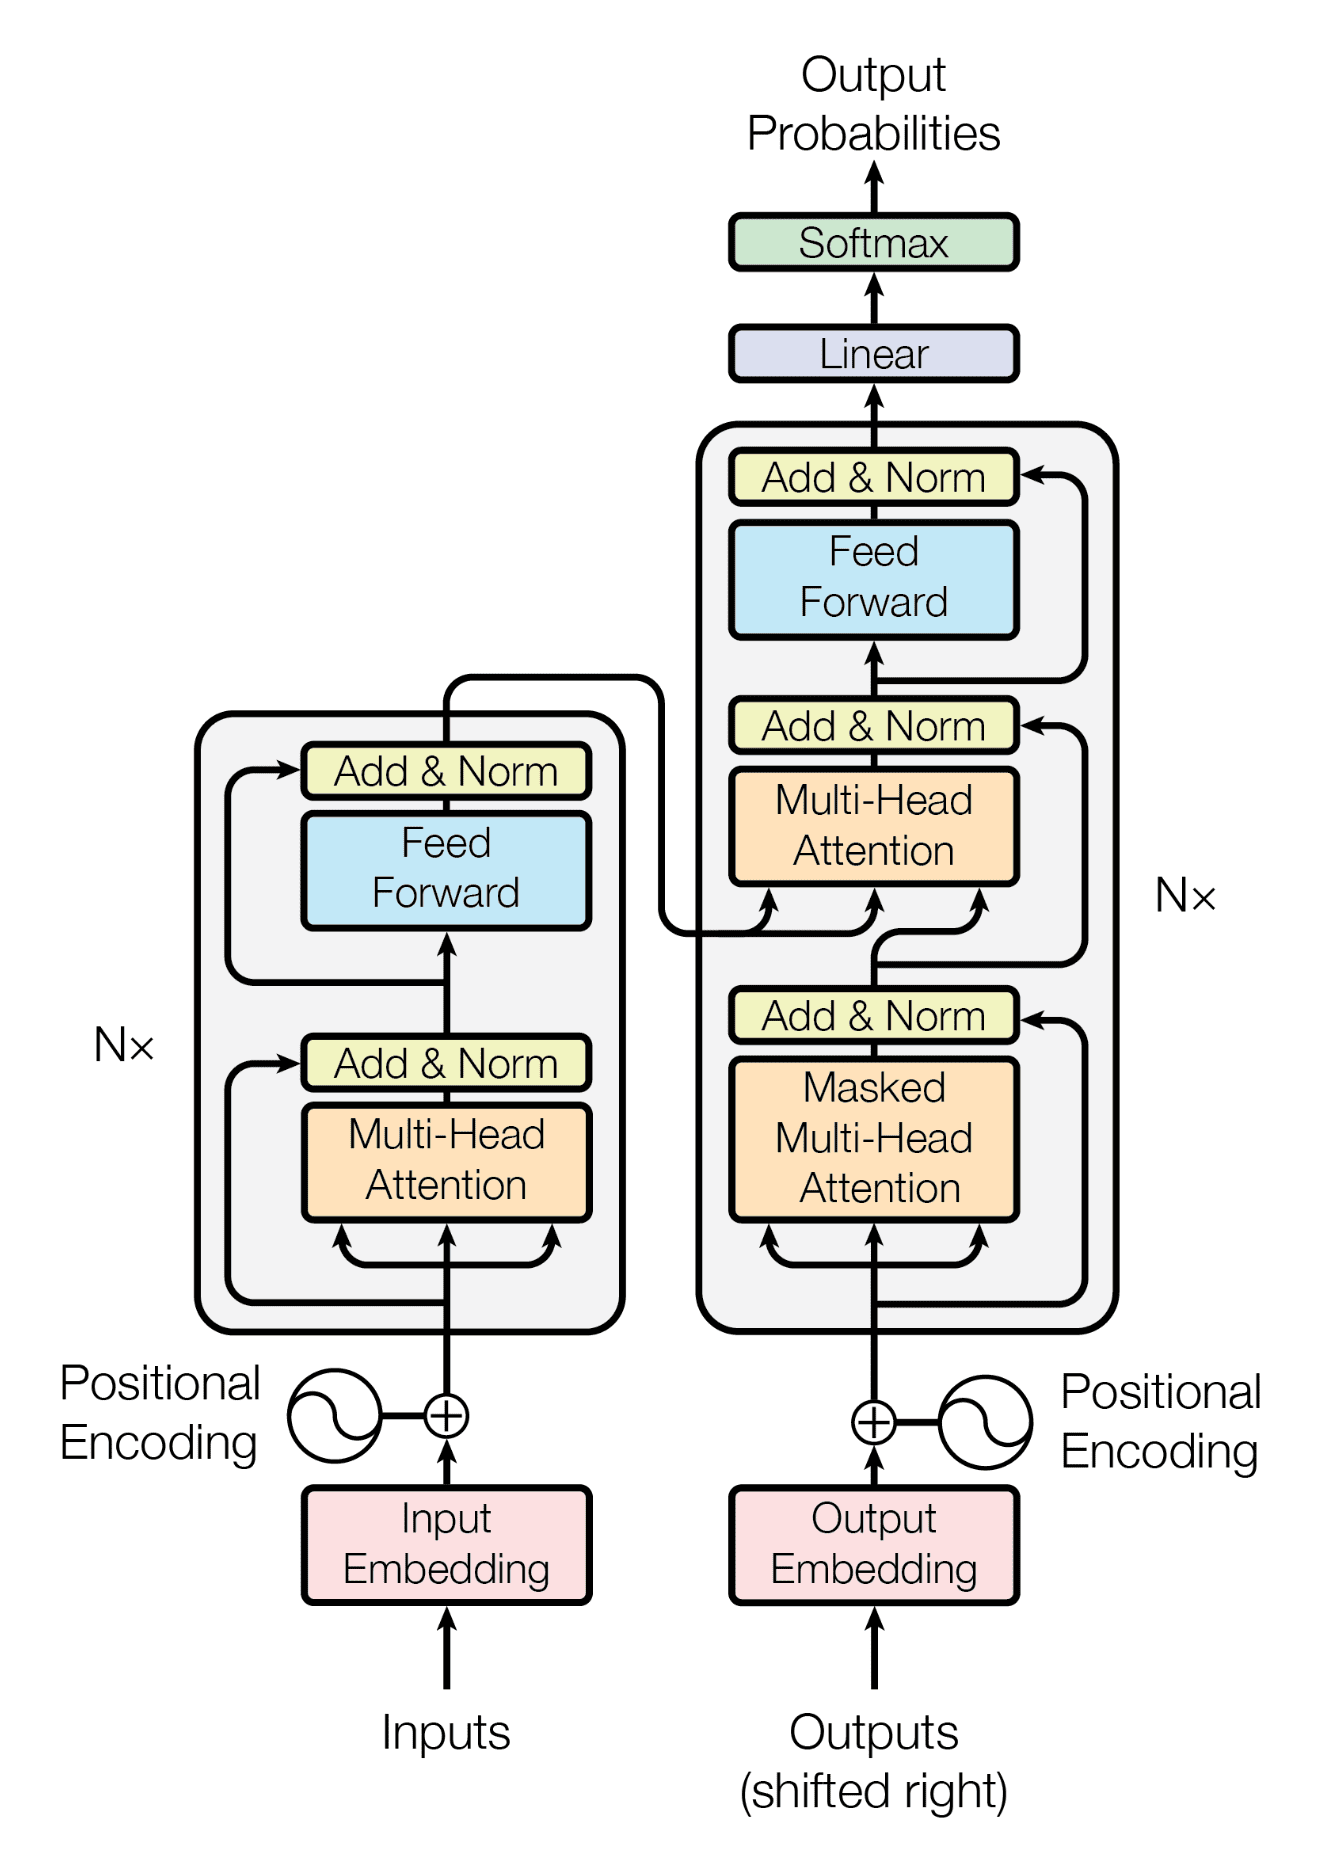
Arsitektur model Transformer (sumber)
Seberapa penting fine-tuning FLAN-T5?
Tidak diragukan lagi FLAN-T5 dapat digunakan untuk berbagai tugas Pemrosesan Bahasa Alami.
Namun, untuk memanfaatkan potensinya secara penuh dan memastikan kinerja optimal untuk aplikasi spesifik, fine-tuning adalah langkah krusial. Di bawah ini adalah poin-poin utama yang menyoroti pentingnya fine-tuning FLAN-T5:
- Fine-tuning FLAN-T5 penting untuk menyesuaikan model dengan tugas tertentu dan meningkatkan kinerjanya pada tugas-tugas tersebut.
- Fine-tuning memungkinkan kustomisasi model agar lebih sesuai dengan kebutuhan dan data pengguna.
- Kemampuan melakukan fine-tuning FLAN-T5 pada workstation lokal dengan CPU membuatnya dapat diakses oleh lebih banyak pengguna.
- Aksesibilitas ini bermanfaat bagi organisasi kecil atau peneliti individual yang mungkin tidak memiliki akses ke sumber daya GPU.
- Secara keseluruhan, fine-tuning FLAN-T5 adalah langkah berharga untuk mengoptimalkan model bagi kasus penggunaan spesifik dan memaksimalkan manfaatnya.
Tujuan tutorial ini adalah memberikan panduan lengkap untuk melakukan fine-tuning FLAN-T5 pada skenario tanya jawab.
Dalam tutorial ini, kami akan membahas berbagai topik untuk membantu Anda memahami dan menerapkan fine-tuning untuk FLAN-T5. Kami akan mulai dengan membahas pustaka dan alat yang diperlukan untuk proses ini, diikuti langkah-langkah menyiapkan lingkungan untuk fine-tuning.
Berikutnya, kami akan memandu Anda melalui proses memuat model FLAN-T5 dan menyiapkan data untuk fine-tuning. Setelah data siap, kami akan menjelaskan langkah-langkah melatih dan melakukan fine-tuning model agar sesuai dengan kebutuhan spesifik Anda.
Terakhir, kami akan menjelajahi beberapa potensi penerapan model FLAN-T5 yang telah di-fine-tune, menunjukkan bagaimana model tersebut dapat digunakan dalam berbagai skenario untuk mencapai kinerja yang lebih baik dan hasil yang lebih akurat.
Potensi Penerapan FLAN-T5 yang Telah Di-Fine-Tune
Sebelum masuk ke implementasi teknis, mari telusuri beberapa potensi penerapan FLAN-T5 yang telah di-fine-tune. Di bawah ini adalah beberapa contoh untuk peringkasan obrolan dan dialog, klasifikasi teks, serta Fast Healthcare Interoperability Resources (FHIR).
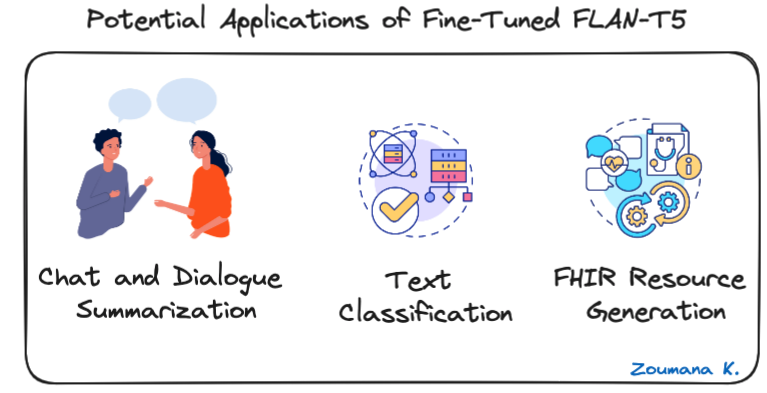
Tiga Potensi Penerapan FLAN-T5 yang Telah Di-Fine-Tune
- Peringkasan obrolan dan dialog: FLAN-T5 dapat merangkum percakapan, memberikan kilas balik cepat atas interaksi layanan pelanggan atau rapat bisnis.
- Klasifikasi teks: berguna untuk mengotomatiskan pengelompokan teks ke dalam kelas yang telah ditentukan, seperti analisis sentimen, deteksi spam, atau pemodelan topik.
- Generasi sumber daya FHIR: FLAN-T5 dapat mengonversi teks klinis menjadi FHIR (Fast Healthcare Interoperability Resources) terstruktur untuk memudahkan berbagi dan integrasi ke dalam sistem layanan kesehatan.
Sebelum menggali aspek teknis inti artikel ini, tutorial kami, Cara Membangun Aplikasi LLM dengan LangChain, memandu pembaca menjelajahi potensi besar Model Bahasa Besar dengan LangChain, kerangka kerja Python open-source untuk membangun aplikasi AI tingkat lanjut.
Prasyarat
Kini setelah kita lebih memahami FLAN-T5, mari lihat cara melakukan fine-tuning untuk kasus penggunaan tanya jawab, dan notebook lengkap tersedia di GitHub.
Untuk memulai, pustaka dan alat berikut diperlukan:
- Hugging Face: Platform yang menyediakan akses ke model FLAN-T5, memudahkan pengunduhan dan penggunaannya untuk fine-tuning
- Transformers: Digunakan untuk menyederhanakan proses memuat model FLAN-T5 pralatih dan menyediakan fungsi berguna untuk fine-tuning
- Datasets: kumpulan dataset siap pakai, penting untuk mendapatkan data relevan untuk fine-tuning
- Sentencepiece: alat tokenisasi yang terutama digunakan untuk menangani data teks besar dan multibahasa
- Tokenizers: pustaka tokenisasi untuk mengonversi teks ke format yang sesuai bagi kasus penggunaan
- Evaluate: Pustaka ini menyediakan berbagai metrik untuk evaluasi model, memastikan model yang di-fine-tune memenuhi standar kinerja yang diinginkan
- Rouge score: metrik khusus untuk mengevaluasi kualitas teks yang dihasilkan oleh model bahasa besar
- NLTK: berguna untuk langkah prapemrosesan data seperti tokenisasi dan stemming
Instalasi pustaka
Instalasi dapat dilakukan sebagai berikut, menggunakan pip, pengelola paket Python dari Jupyter notebook.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
Perintah %%bash digunakan di dalam notebook untuk menjalankan sel terkait sebagai skrip bash alih-alih menjalankan setiap perintah satu per satu.
Impor pustaka
Setelah semua pustaka terinstal, kita dapat mengimpornya sebagai berikut:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Memuat Model FLAN-T5
Berbagai format model FLAN-T5 tersedia di Hugging Face, dari model kecil hingga sangat besar, dan semakin besar model, semakin banyak parameternya.
Di bawah ini adalah ukuran model berbeda yang tersedia dari kartu model Hugging Face:
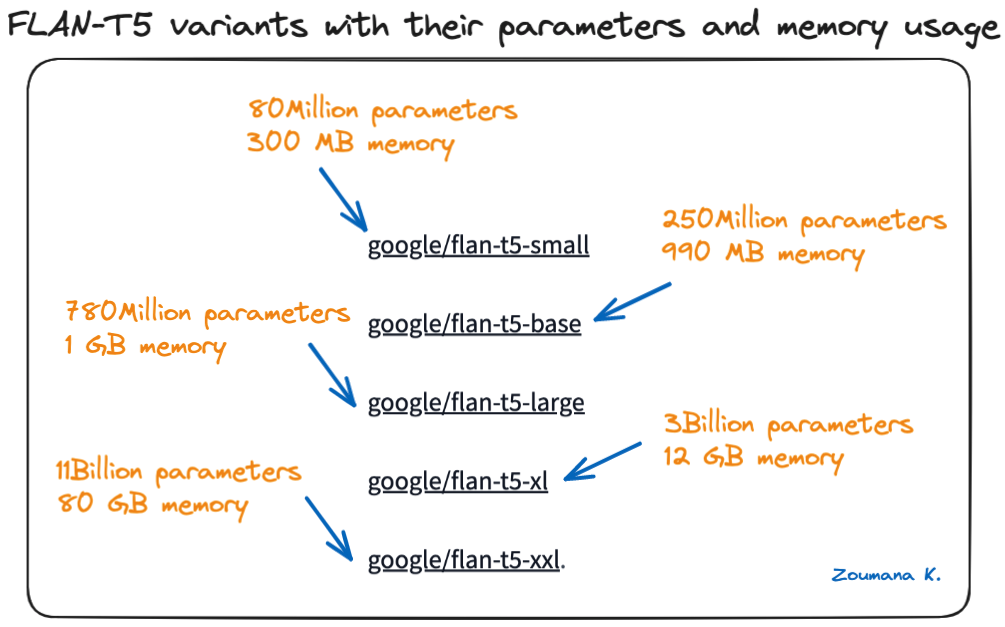
Varian FLAN-T5 beserta parameter dan penggunaan memorinya
Memilih ukuran model yang tepat
Pemilihan ukuran model yang tepat di antara varian FLAN-T5 sangat bergantung pada kriteria berikut:
- Persyaratan spesifik proyek
- Sumber daya komputasi yang tersedia
- Tingkat kinerja yang diharapkan
Sebuah GPU NVIDIA A100 digunakan untuk eksperimen ini, dan model google/flan-t5-base akan memberikan keseimbangan antara efisiensi komputasi dan kompatibilitas kinerja.
Inisialisasi Model dan Tokenizer
Tiga instruksi berikut diperlukan untuk membuat model.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Tokenizer diinstansiasi menggunakan modul T5Tokenizer dan nama model
- Menggunakan fungsi from_pretrained dari T5ForConditionalGeneration, model dimuat
- Dengan DataCollectorForSeq2Seq, dibuat pengumpul data yang akan digunakan untuk tugas tanya jawab
Menyiapkan Data untuk Fine-Tuning
Dengan model, tokenizer, dan pengumpul data tersedia, langkah berikutnya adalah memuat data eksperimen untuk fine-tuning, dan data yang digunakan adalah data diskusi Yahoo yang tersedia di Hugging Face.
Proses pemuatan data cukup mudah dan dapat dilakukan menggunakan fungsi load_dataset, yang menerima nama dataset sebagai parameter. Dalam kasus spesifik ini, fokusnya adalah pada data pelatihan.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Setelah data diperoleh, data dibagi menjadi dataset pelatihan dan pengujian masing-masing dengan proporsi 70% dan 30%, dan ini dicapai menggunakan fungsi train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)Pernyataan berikut menampilkan jumlah total observasi pada data pelatihan dan pengujian.
# Check the length of the data and its structure
yahoo_answers_qa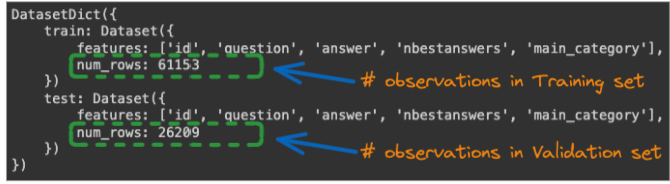
Jumlah total observasi untuk dataset pelatihan dan validasi
Pemformatan data dan tokenisasi
Kita memiliki jumlah data yang signifikan di kedua dataset pelatihan dan pengujian untuk proses fine-tuning. Namun, sebelum itu kita perlu memproses data agar sesuai dengan format fine-tuning.
Sebagian besar fungsi yang digunakan untuk langkah berikut terinspirasi dari artikel Toughdata.
Selama mode inferensi, proses pemanggilan model akan berada dalam format berikut:
“Please answer this question: <USER_QUESTION>”
Di mana <USER_QUESTION> adalah pertanyaan yang ingin dijawab pengguna. Untuk mencapai fungsionalitas tersebut, kita perlu memformat data pelatihan dengan menambahkan prefiks tugas berupa string “Please answer this question,” dan ini dilakukan dengan fungsi preprocess_function di bawah.
Selain pemformatan, fungsi tersebut juga menerapkan tokenisasi pada masukan dan keluaran menggunakan fungsi tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Berikutnya, fungsi tersebut diterapkan ke seluruh dataset menggunakan fungsi map di bawah ini:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Pelatihan dan Fine-Tuning FLAN-T5
Sebelum masuk ke proses pelatihan, sebaiknya kita tentukan metrik untuk mengevaluasi kinerja keseluruhan dari fine-tuning.
Metrik evaluasi yang baik penting dalam proyek deep learning dan machine learning untuk menilai kinerja model, tidak hanya selama pelatihan tetapi juga nantinya di produksi.
Dua metrik paling umum untuk mengevaluasi kinerja model generasi teks adalah BLEU dan ROUGE, dan dalam kasus ini, untuk mengevaluasi kualitas jawaban dengan membandingkannya dengan jawaban acuan.
Fokus tutorial ini adalah ROUGE, namun artikel Wikipedia ini menyediakan informasi lebih lanjut tentang skor BLEU.
Apa itu skor ROUGE?
ROUGE adalah singkatan dari Recall-Oriented Understudy for Gisting Evaluation. Beberapa komponen kunci ROUGE untuk tanya jawab mencakup:
- ROUGE-L: Mengukur longest common subsequence antara jawaban kandidat dan referensi. Berfokus pada recall atas teks penuh.
- ROUGE-1, ROUGE-2, ROUGE-SU4: Membandingkan tumpang tindih unigram, bigram, 4-gram antara kandidat dan referensi. Berfokus pada recall bagian/kepingan kunci
- Skor ROUGE yang lebih tinggi umumnya menunjukkan kinerja tanya jawab yang lebih baik. Skor mendekati atau di atas 0,70+ dianggap kuat
- Saat menggunakan metrik ini, pemrosesan seperti stemming dan penghapusan stopword dapat membantu meningkatkan kinerja keseluruhan
Dengan pemahaman ini, fungsi pembantu compute_metrics berikut dapat membantu menghitung skor ROUGE yang mendasari. Sebelum mengimplementasikan fungsi tersebut, perlu menyiapkan ROUGE dan NLTK.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Di bawah ini adalah implementasi fungsinya.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Proses pelatihan
Untuk memicu fine-tuning, kita perlu menetapkan beberapa hyperparameter dan berikut yang utama:
- Laju pembelajaran (learning rate): untuk mengendalikan seberapa cepat model belajar dari data dan nilai tipikalnya 1e-5 hingga 5e-5, dan untuk kasus ini nilainya ditetapkan 3e-4
- Ukuran batch: jumlah total sampel yang diproses sebelum pembaruan bobot model. Menggunakan batch yang lebih besar dapat mempercepat proses, tetapi kekurangannya adalah dapat menyebabkan kinerja buruk. Kami menggunakan 8 untuk kasus ini
- Per device train batch size: mirip dengan ukuran batch, tetapi ditentukan per perangkat (GPU)
- Weight decay: tujuannya untuk mencegah model overfitting. Nilai 0,01 dapat diterima untuk besaran bobot
- Batas total penyimpanan (save total limit): jumlah total checkpoint yang akan disimpan selama pelatihan. Semakin banyak penyimpanan, semakin besar kemungkinan untuk rollback namun menggunakan lebih banyak disk. Kami melakukan 3 kali penyimpanan untuk kasus ini
- Jumlah epoch: jumlah total lintasan melalui dataset pelatihan. Semakin banyak epoch, semakin lama waktu pelatihan, tetapi juga dapat meningkatkan kinerja model. Biasanya dipilih nilai 3 hingga 10, dan 3 digunakan untuk kasus ini.
Parameter di atas didefinisikan di bawah, dan digunakan untuk menyiapkan argumen pelatihan model, dan seluruh artefak pelatihan disimpan di folder results :
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Berikutnya, trainer disiapkan untuk memicu proses pelatihan model.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
n   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Terakhir, pelatihan model dipicu menggunakan fungsi train sebagai berikut:
trainer.train()Setelah hampir empat jam, kinerja keseluruhan proses pelatihan untuk setiap epoch disajikan di bawah.
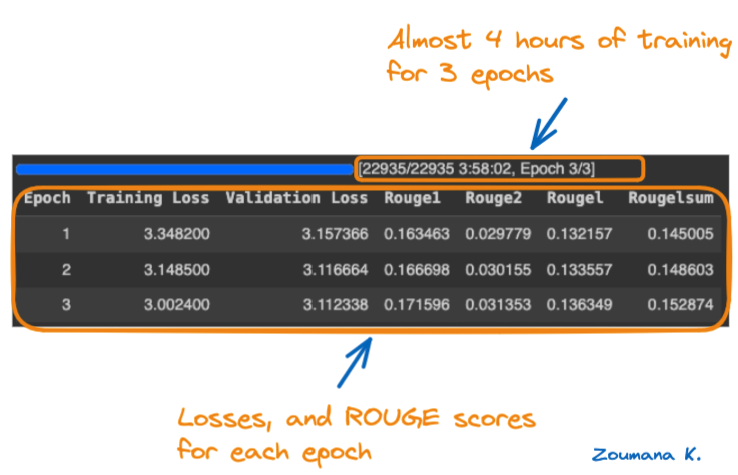
Epoch pelatihan dan skor kinerja yang sesuai
Mari pahami papan metrik kinerja di atas.
- Training Loss dan Validation Loss: Nilai yang lebih rendah pada metrik ini lebih disukai karena menunjukkan kecocokan model yang lebih baik terhadap data. Training loss dan validation loss menurun seiring epoch, dengan nilai terendah pada epoch 3.
- Metrik Rouge (Rouge1, Rouge2, Rougel, dan Rougelsum): Nilai yang lebih tinggi pada metrik ini lebih disukai karena menunjukkan kinerja peringkasan teks yang lebih baik. Di keempat metrik Rouge, nilainya meningkat seiring epoch, dengan nilai tertinggi pada epoch 3.
Secara keseluruhan, model berkinerja baik pada epoch ketiga, karena menunjukkan training loss dan validation loss terendah, bersama nilai tertinggi di semua metrik ROUGE. Di bawah ini adalah isi folder results dengan semua checkpoint:
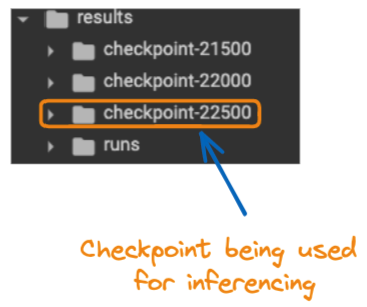
Isi folder “results”
Inferensi Model
Sekarang model telah di-fine-tune, bukankah bagus jika kita menerapkannya pada skenario nyata?
Itulah inti dari inferensi model. Gunakan model yang ada untuk memecahkan masalah dunia nyata, dan inilah yang dilakukan dengan model yang telah di-fine-tune.
Sebelum itu, kita perlu melakukan beberapa langkah:
- Memuat model yang di-fine-tune dari checkpoint terakhir
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Menentukan pertanyaan spesifik untuk dijawab
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Menjalankan prediksi
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Di bawah ini adalah hasil dari model yang telah di-fine-tune, dan terlihat cukup baik. Metode fill dari textwrap digunakan untuk membatasi jumlah maksimum karakter menjadi 80 per baris, alih-alih seluruh string dalam satu baris.

Respons model yang telah di-fine-tune terhadap pertanyaan
Kesimpulan dan Langkah Berikutnya
Artikel ini telah memberikan panduan lengkap untuk melakukan fine-tuning model FLAN-T5. Pertama, artikel memperkenalkan pemahaman yang lebih baik tentang model dan potensi kasus penggunaannya, sebelum menelusuri implementasi teknis secara menyeluruh, mulai dari memuat data eksperimen dan model dari hugging face hingga melatih model pada GPU. Model terbaik, sesuai skor ROUGE, diuji pada skenario dunia nyata
Ke mana melangkah dari sini?
Artikel kami 12 Alternatif Open-Source GPT-4, dan Cara Melatih LLM dengan PyTorch bisa menjadi langkah hebat berikutnya untuk peningkatan keterampilan. Yang pertama menyoroti alternatif open-source GPT-4 yang dapat menawarkan kinerja serupa dan memerlukan sumber daya komputasi lebih sedikit untuk dijalankan. Proyek-proyek ini dilengkapi petunjuk, sumber kode, bobot model, dataset, dan UI chatbot.
Artikel kedua membantu pembaca menguasai proses melatih model bahasa besar menggunakan PyTorch, dari penyiapan awal hingga implementasi akhir. Anda juga dapat meningkatkan keterampilan dengan kerangka kerja deep learning andal yang digunakan oleh para profesional AI. Ikuti kursus Deep Learning dengan PyTorch hari ini.




