Che cos’è FLAN-T5?
FLAN-T5 è un modello linguistico open source, sequence-to-sequence, di grandi dimensioni che può essere utilizzato anche a fini commerciali. Il modello è stato pubblicato dai ricercatori di Google alla fine del 2022 ed è stato sottoposto a fine-tuning su più task.
Il modello T5 riformula vari compiti in un formato text-to-text, come traduzione, accettabilità linguistica, similarità tra frasi e sintesi di documenti, come mostrato di seguito:
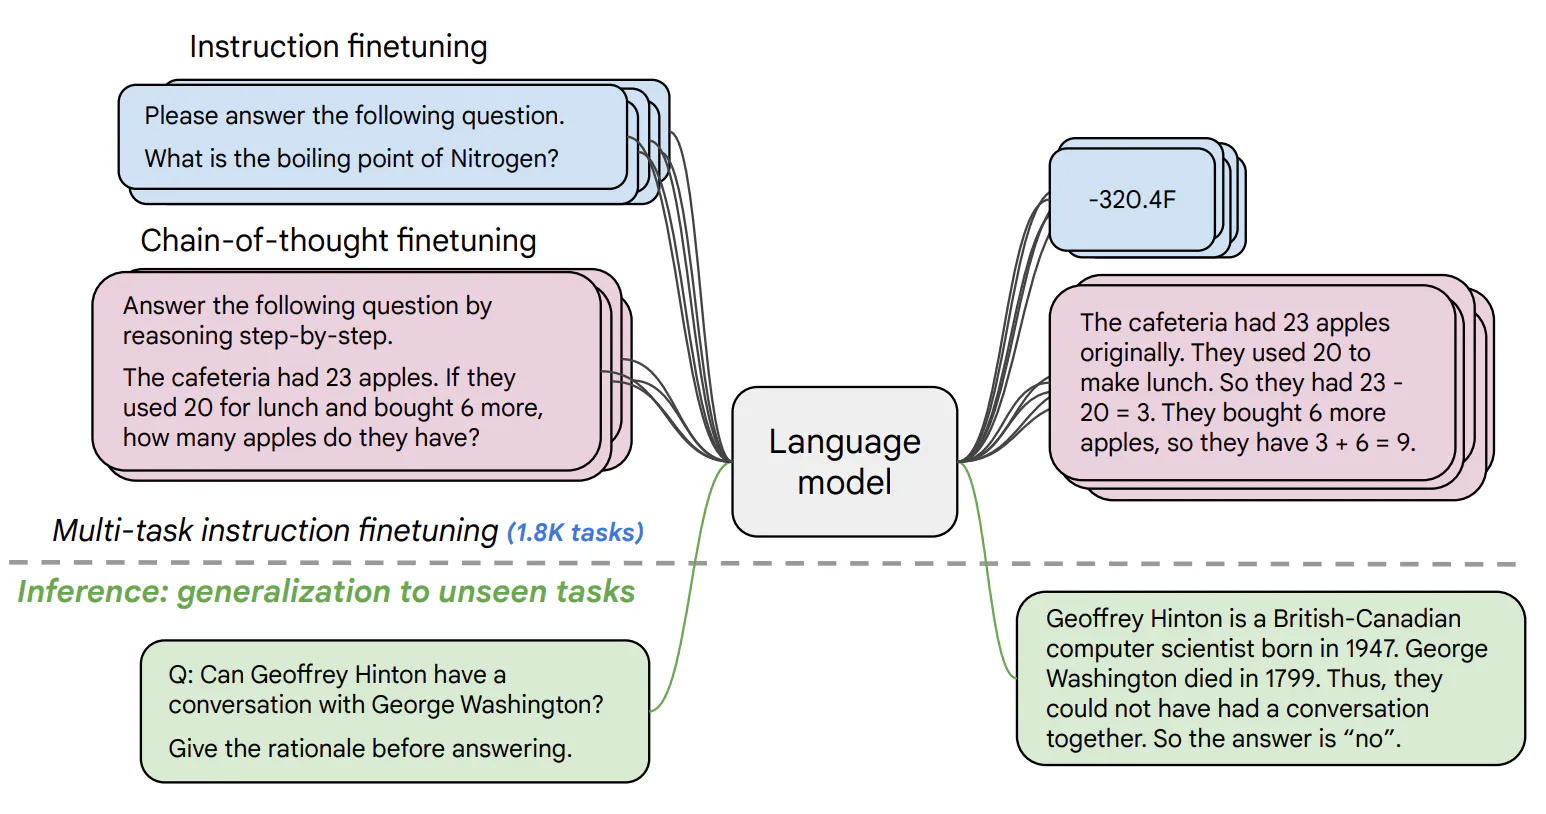
Esempi di come T5 riformula una serie di task in un framework text-to-text (fonte)
In modo analogo, l’architettura del modello T5 è molto vicina alla struttura encoder-decoder utilizzata nel paper originale sui Transformer. La differenza principale risiede nella dimensione e nella natura dei dati di addestramento; T5 è stato addestrato su un esteso corpus di testo da 750 GB noto come Colossal Clean Crawled Corpus (C4).
Al contrario, il Transformer originale era stato progettato specificamente per la traduzione automatica e, perciò, addestrato su un dataset composto da 1,4 GB di coppie di frasi inglese-tedesco.
Il nostro articolo Un’introduzione all’uso dei Transformer e di Hugging Face guida il lettore a comprendere i transformer e a sfruttarne la potenza per risolvere problemi reali.
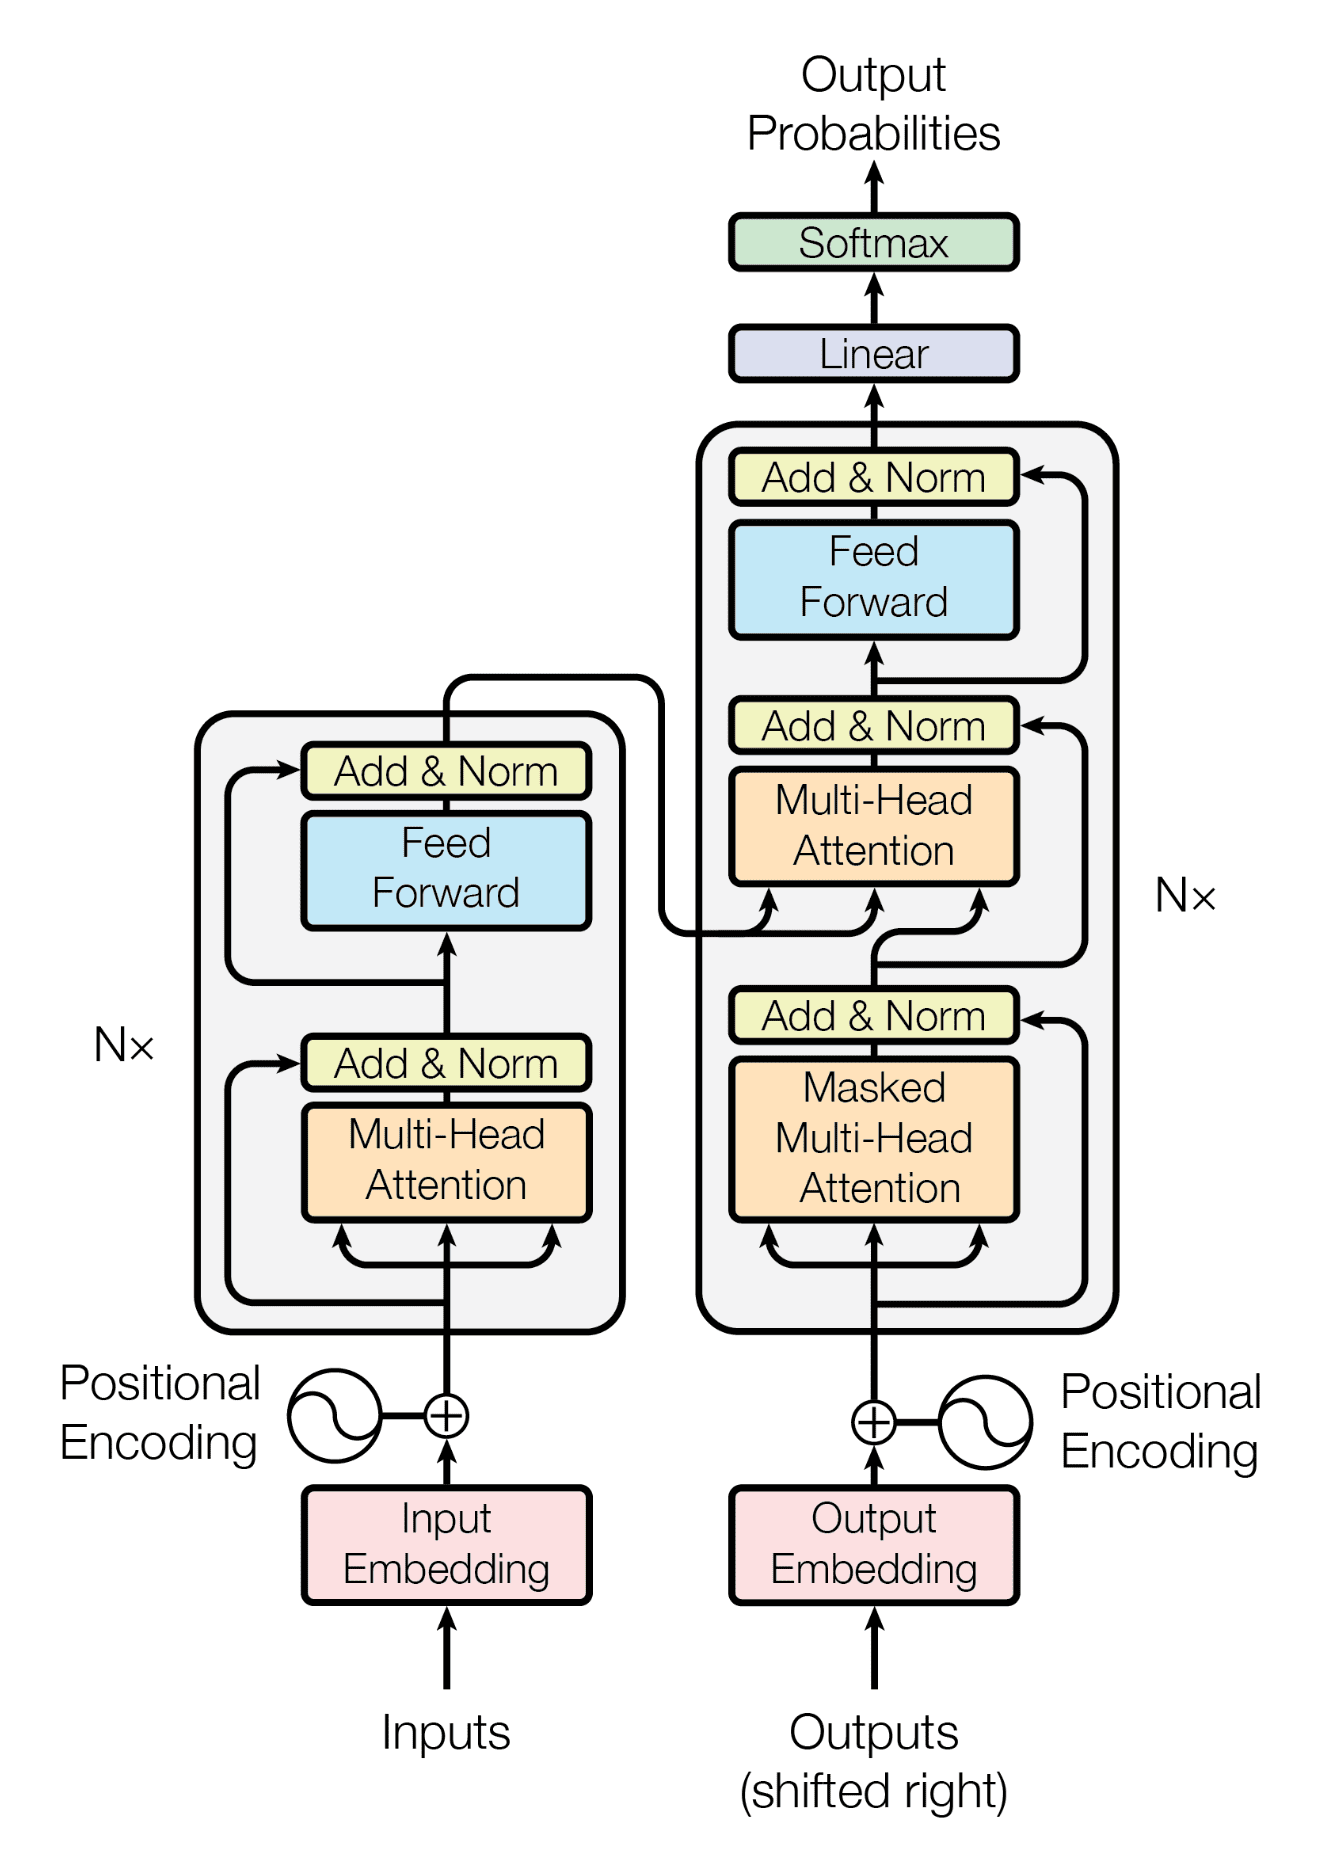
L’architettura del modello Transformer (fonte)
Quanto è importante il fine-tuning di FLAN-T5?
Non c’è dubbio che FLAN-T5 possa essere utilizzato per vari compiti di elaborazione del linguaggio naturale.
Tuttavia, per sfruttarne appieno il potenziale e garantire prestazioni ottimali per applicazioni specifiche, il fine-tuning è un passaggio cruciale. Di seguito sono riportati i punti principali che evidenziano l’importanza del fine-tuning di FLAN-T5:
- Il fine-tuning di FLAN-T5 è importante per adattare il modello a compiti specifici e migliorarne le prestazioni su quei compiti.
- Il fine-tuning consente di personalizzare il modello per adattarlo meglio alle esigenze e ai dati dell’utente.
- La possibilità di eseguire il fine-tuning di FLAN-T5 su workstation locali con CPU lo rende accessibile a un pubblico più ampio.
- Questa accessibilità è vantaggiosa per le organizzazioni più piccole o i singoli ricercatori che potrebbero non avere accesso a risorse GPU.
- Nel complesso, il fine-tuning di FLAN-T5 è un passaggio prezioso per ottimizzare il modello per casi d’uso specifici e massimizzarne i benefici potenziali.
L’obiettivo di questo tutorial è fornire una guida completa al fine-tuning di FLAN-T5 in uno scenario di question answering.
In questo tutorial tratteremo una serie di argomenti per aiutarti a comprendere e implementare il fine-tuning per FLAN-T5. Inizieremo discutendo le librerie e gli strumenti necessari per questo processo, per poi passare ai passaggi per configurare l’ambiente per il fine-tuning.
Successivamente ti guideremo nel processo di caricamento del modello FLAN-T5 e nella preparazione dei dati per il fine-tuning. Una volta che i dati sono pronti, ti illustreremo i passaggi per addestrare e mettere a punto il modello in base alle tue esigenze specifiche.
Infine, esploreremo alcune potenziali applicazioni del modello FLAN-T5 ottimizzato, mostrando come possa essere utilizzato in vari scenari per ottenere prestazioni migliori e risultati più accurati.
Applicazioni potenziali di FLAN-T5 ottimizzato
Prima di addentrarci nell’implementazione tecnica, esploriamo alcune possibili applicazioni di FLAN-T5 ottimizzato; di seguito trovi esempi per il riassunto di chat e dialoghi, la classificazione del testo e le Fast Healthcare Interoperability Resources (FHIR).
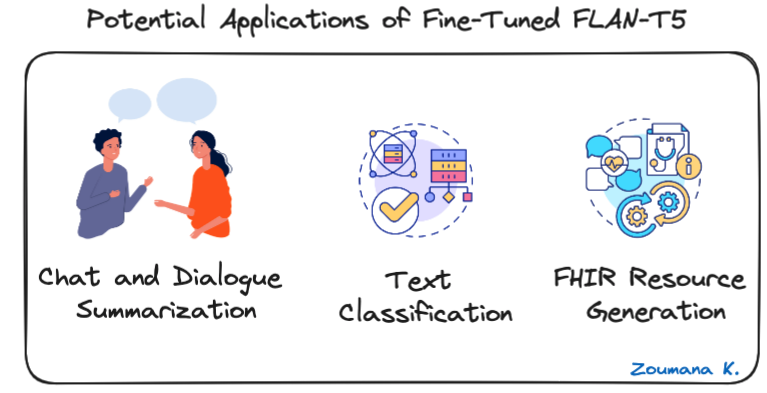
Tre possibili applicazioni di FLAN-T5 ottimizzato
- Riassunto di chat e dialoghi: FLAN-T5 può condensare le conversazioni, offrendo un rapido riepilogo di interazioni con l’assistenza clienti o riunioni di lavoro.
- Classificazione del testo: utile per automatizzare la categorizzazione del testo in classi predefinite, come analisi del sentiment, rilevamento dello spam o topic modeling.
- Generazione di risorse FHIR: FLAN-T5 può convertire testo clinico in FHIR (Fast Healthcare Interoperability Resources) strutturato per una condivisione e un’integrazione agevoli nei sistemi sanitari.
Prima di entrare nel cuore degli aspetti tecnici dell’articolo, il nostro tutorial, Come creare applicazioni LLM con LangChain, guida il lettore a esplorare il potenziale inesplorato dei Large Language Model con LangChain, un framework Python open source per costruire applicazioni AI avanzate.
Prerequisiti
Ora che abbiamo una migliore comprensione di FLAN-T5, vediamo come effettuare il fine-tuning per un caso d’uso di question answering; il notebook completo è disponibile su GitHub.
Per iniziare, sono necessarie le seguenti librerie e i seguenti strumenti:
- Hugging Face: una piattaforma che fornisce accesso al modello FLAN-T5, facilitandone il download e l’uso per il fine-tuning
- Transformers: serve a semplificare il caricamento del modello FLAN-T5 pre-addestrato e fornisce funzioni utili per il fine-tuning
- Datasets: una raccolta di dataset pronti all’uso, fondamentale per reperire dati rilevanti per il fine-tuning
- Sentencepiece: uno strumento di tokenizzazione usato principalmente per gestire testi ampi e multilingue
- Tokenizers: una libreria di tokenizzazione per convertire il testo in un formato adatto al caso d’uso
- Evaluate: questa libreria fornisce un’ampia gamma di metriche per la valutazione dei modelli, assicurando che il modello ottimizzato soddisfi lo standard di prestazioni desiderato
- Rouge score: metrica specifica per valutare la qualità del testo generato dai large language model
- NLTK: utile per fasi di preprocessing dei dati come tokenizzazione e stemming
Installazione delle librerie
L’installazione può essere eseguita come segue, usando pip, il gestore dei pacchetti Python, dal notebook Jupyter.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
Il comando %%bash è usato nel notebook per eseguire la cella corrispondente come script bash invece di eseguire ogni comando singolarmente.
Import delle librerie
Dopo l’installazione di tutte le librerie, possiamo importarle come segue:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Caricamento del modello FLAN-T5
Su Hugging Face sono disponibili più formati di modelli FLAN-T5, da quelli piccoli a quelli extra-large, e più grande è il modello, più parametri possiede.
Di seguito sono riportate le diverse dimensioni dei modelli disponibili dalla model card su Hugging Face:
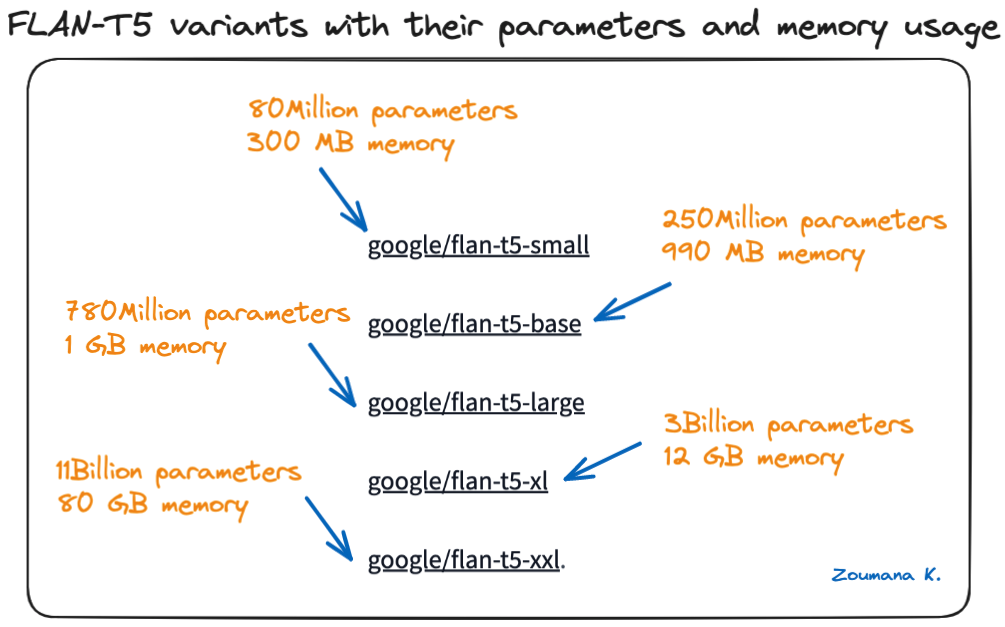
Varianti di FLAN-T5 con relativi parametri e uso di memoria
Scegliere la dimensione giusta del modello
La scelta della dimensione giusta tra le varianti di FLAN-T5 dipende fortemente dai seguenti criteri:
- Le esigenze specifiche del progetto
- Le risorse computazionali disponibili
- Il livello di prestazioni atteso
Per questa sperimentazione si utilizza una GPU NVIDIA A100 e il modello google/flan-t5-base offre un buon compromesso tra efficienza computazionale e prestazioni.
Inizializzazione di modello e tokenizer
Per creare il modello sono necessarie le tre istruzioni seguenti.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Il tokenizer viene istanziato usando il modulo T5Tokenizer e il nome del modello
- Usando la funzione from_pretrained di T5ForConditionalGeneration, viene caricato il modello
- Con DataCollectorForSeq2Seq viene creato un data collator da usare per il task di question answering
Preparazione dei dati per il fine-tuning
Disponendo di modello, tokenizer e data collator, il passo successivo è caricare i dati di sperimentazione per il fine-tuning; i dati utilizzati sono le discussioni Yahoo disponibili su Hugging Face.
Il caricamento dei dati è semplice e può essere eseguito usando la funzione load_dataset, che accetta come parametro il nome del dataset. In questo caso specifico, ci concentriamo sui dati di addestramento.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Una volta acquisiti i dati, vengono suddivisi rispettivamente in training e test set nella proporzione del 70% e 30%, e questo è ottenuto usando la funzione train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)L’istruzione seguente mostra il numero totale di osservazioni sia nei dati di training che in quelli di test.
# Check the length of the data and its structure
yahoo_answers_qa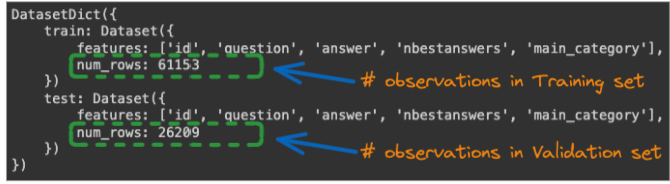
Numero totale di osservazioni per i dataset di training e validazione
Formattazione dei dati e tokenizzazione
Disponiamo di una quantità significativa di dati sia nei training che nei test set per il processo di fine-tuning. Ma prima dobbiamo elaborare i dati per adattarli al formato richiesto.
La maggior parte delle funzioni utilizzate nel passaggio successivo si ispira all’articolo di Toughdata.
In modalità di inferenza, il modello verrà richiamato in questo formato:
“Per favore, rispondi a questa domanda: <USER_QUESTION>”
Dove <USER_QUESTION> è la domanda a cui l’utente desidera una risposta. Per ottenere questa funzionalità dobbiamo formattare i dati di training premettendo al task la stringa “Per favore, rispondi a questa domanda,” e questo è fatto con la funzione preprocess_function seguente.
Oltre alla formattazione, la funzione applica anche la tokenizzazione degli input e degli output usando la funzione tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Successivamente, la funzione viene applicata all’intero dataset usando la funzione map seguente:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Addestramento e fine-tuning di FLAN-T5
Prima di entrare nel processo di addestramento, è bene individuare le metriche per valutare le prestazioni complessive del fine-tuning.
Buone metriche di valutazione sono importanti in qualsiasi progetto di deep learning e machine learning per valutare le prestazioni dei modelli, non solo durante l’addestramento ma anche successivamente in produzione.
Due delle metriche più comuni per valutare le prestazioni di un modello di generazione del testo sono BLEU e ROUGE; in questo caso, servono a valutare la qualità di una risposta confrontandola con una risposta di riferimento.
Il focus di questo tutorial è ROUGE, ma questo articolo di Wikipedia fornisce maggiori informazioni sul punteggio BLEU.
Che cos’è il punteggio ROUGE?
ROUGE sta per Recall-Oriented Understudy for Gisting Evaluation. Alcuni componenti chiave di ROUGE per il question answering includono:
- ROUGE-L: misura la più lunga sottosequenza comune tra la risposta candidata e quella di riferimento. Si concentra sul recall del testo completo.
- ROUGE-1, ROUGE-2, ROUGE-SU4: confrontano le sovrapposizioni di unigrammi, bigrammi e 4-grammi tra candidata e riferimento. Si concentrano sul recall delle parti/segmenti chiave
- Punteggi ROUGE più alti indicano in genere prestazioni migliori nel question answering. Punteggi vicini o superiori a 0,70+ sono considerati solidi
- Nell’uso di questa metrica, elaborazioni come stemming e rimozione delle stopword possono aiutare a migliorare le prestazioni complessive
Con questa comprensione, la seguente funzione di supporto compute_metrics può aiutare a calcolare il punteggio ROUGE sottostante. Prima di implementare la funzione, è necessario configurare ROUGE e NLTK.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Di seguito l’implementazione della funzione.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Processo di addestramento
Per avviare il fine-tuning, dobbiamo impostare alcuni iperparametri; i principali sono riportati di seguito:
- Learning rate: controlla la velocità con cui il modello apprende dai dati; i valori tipici vanno da 1e-5 a 5e-5 e, per questo caso d’uso, è impostato a 3e-4
- Batch size: il numero totale di campioni elaborati prima dell’aggiornamento dei pesi del modello. Usare batch più grandi può accelerare il processo, ma lo svantaggio è un possibile peggioramento delle prestazioni. Qui usiamo 8
- Per device train batch size: simile al batch size, ma specificato per ciascun dispositivo (GPU)
- Weight decay: serve a prevenire l’overfitting del modello. 0,01 è un valore accettabile per la dimensione del peso
- Save total limit: il numero totale di checkpoint da salvare durante l’addestramento. Più salvataggi ci sono, maggiori sono le possibilità di rollback, ma aumenta l’uso del disco. In questo caso ne effettuiamo 3
- Numero di epoche: il numero totale di passaggi attraverso il dataset di training. Più epoche implicano tempi di addestramento più lunghi, ma potrebbero anche migliorare le prestazioni del modello. In genere si sceglie un valore da 3 a 10; qui usiamo 3.
I parametri sopra sono definiti di seguito e usati per impostare gli argomenti di addestramento del modello; tutti gli artefatti di training vengono salvati nella cartella results:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Successivamente si configura il trainer per avviare il processo di addestramento del modello.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Infine, l’addestramento del modello viene avviato usando la funzione train come segue:
trainer.train()Dopo quasi quattro ore, le prestazioni complessive del processo di addestramento per ciascuna epoca sono riportate di seguito.
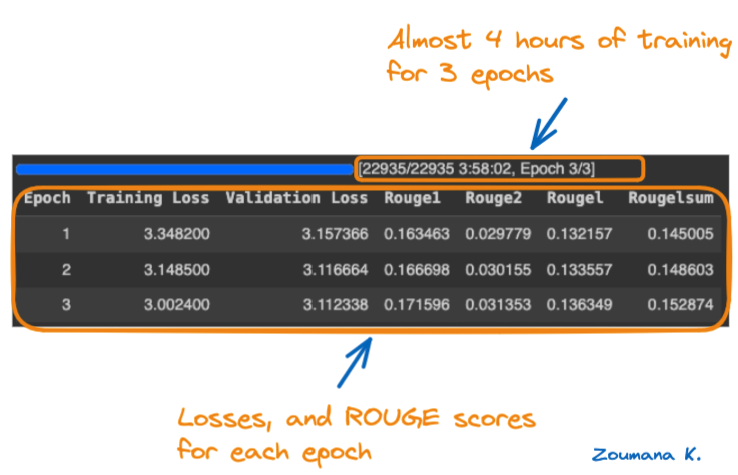
Epoche di addestramento e relativi punteggi di performance
Vediamo di capire la dashboard delle metriche qui sopra.
- Training loss e validation loss: Valori più bassi sono preferibili perché indicano un miglior adattamento del modello ai dati. La perdita di addestramento e di validazione è diminuita nel corso delle epoche, con i valori più bassi registrati all’epoca 3.
- Metriche ROUGE (Rouge1, Rouge2, Rougel e Rougelsum): Valori più alti sono preferibili in quanto indicano migliori prestazioni di sintesi del testo. Per tutte e quattro le metriche ROUGE, i valori sono aumentati nel corso delle epoche, con i massimi registrati all’epoca 3.
Nel complesso, il modello si è comportato bene durante la terza epoca, poiché mostra la perdita di training e di validazione più bassa, insieme ai valori più alti su tutte le metriche ROUGE. Di seguito il contenuto della cartella results con tutti i checkpoint:
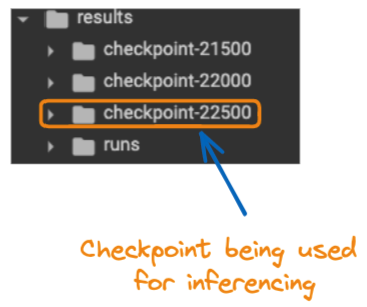
Contenuto della cartella “results”
Inferenza del modello
Ora che il modello è stato ottimizzato, non sarebbe bello applicarlo a uno scenario reale?
Questo è proprio lo scopo dell’inferenza del modello: usare un modello esistente per risolvere un problema reale, ed è ciò che facciamo con il modello ottimizzato.
Prima, dobbiamo eseguire alcuni passaggi:
- Caricare il modello ottimizzato dall’ultimo checkpoint
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Definire una domanda specifica a cui rispondere
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Eseguire la predizione
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Di seguito il risultato del modello ottimizzato, che sembra piuttosto buono. Inoltre, il metodo fill di textwrap è usato per limitare a 80 il numero massimo di caratteri per riga, invece di avere l’intera stringa su una singola riga.

Risposta del modello ottimizzato alla domanda
Conclusione e prossimi passi
Questo articolo ha fornito una guida completa al fine-tuning di un modello FLAN-T5. Per prima cosa ha aiutato il lettore a comprendere meglio il modello e i suoi potenziali casi d’uso, quindi ha descritto l’implementazione tecnica complessiva, dal caricamento dei dati di sperimentazione e del modello da Hugging Face all’addestramento del modello su una GPU. Il modello migliore, in base ai punteggi ROUGE, è stato testato in uno scenario reale
Dove andare da qui?
I nostri articoli 12 alternative open source a GPT-4 e Come addestrare un LLM con PyTorch possono essere un ottimo prossimo passo per migliorare le competenze. Il primo mette in evidenza alternative open source a GPT-4 che possono offrire prestazioni simili e richiedono meno risorse computazionali per l’esecuzione. Questi progetti includono istruzioni, sorgenti del codice, pesi dei modelli, dataset e interfacce chatbot.
Il secondo articolo aiuta il lettore a padroneggiare il processo di addestramento dei large language model con PyTorch, dall’impostazione iniziale all’implementazione finale. Puoi anche migliorare le tue competenze con il potente framework di deep learning usato dai professionisti dell’AI. Iscriviti oggi al corso Deep Learning con PyTorch.



