Wat is FLAN-T5?
FLAN-T5 is een open-source, sequence-to-sequence, groot taalmodel dat ook commercieel gebruikt kan worden. Het model werd eind 2022 gepubliceerd door onderzoekers van Google en is gefinetuned op meerdere taken.
Het T5-model giet uiteenlopende taken in een text-to-text-formaat, zoals vertaling, linguïstische aanvaardbaarheid, zinsgelijkenis en samenvatting van documenten, zoals hieronder getoond:
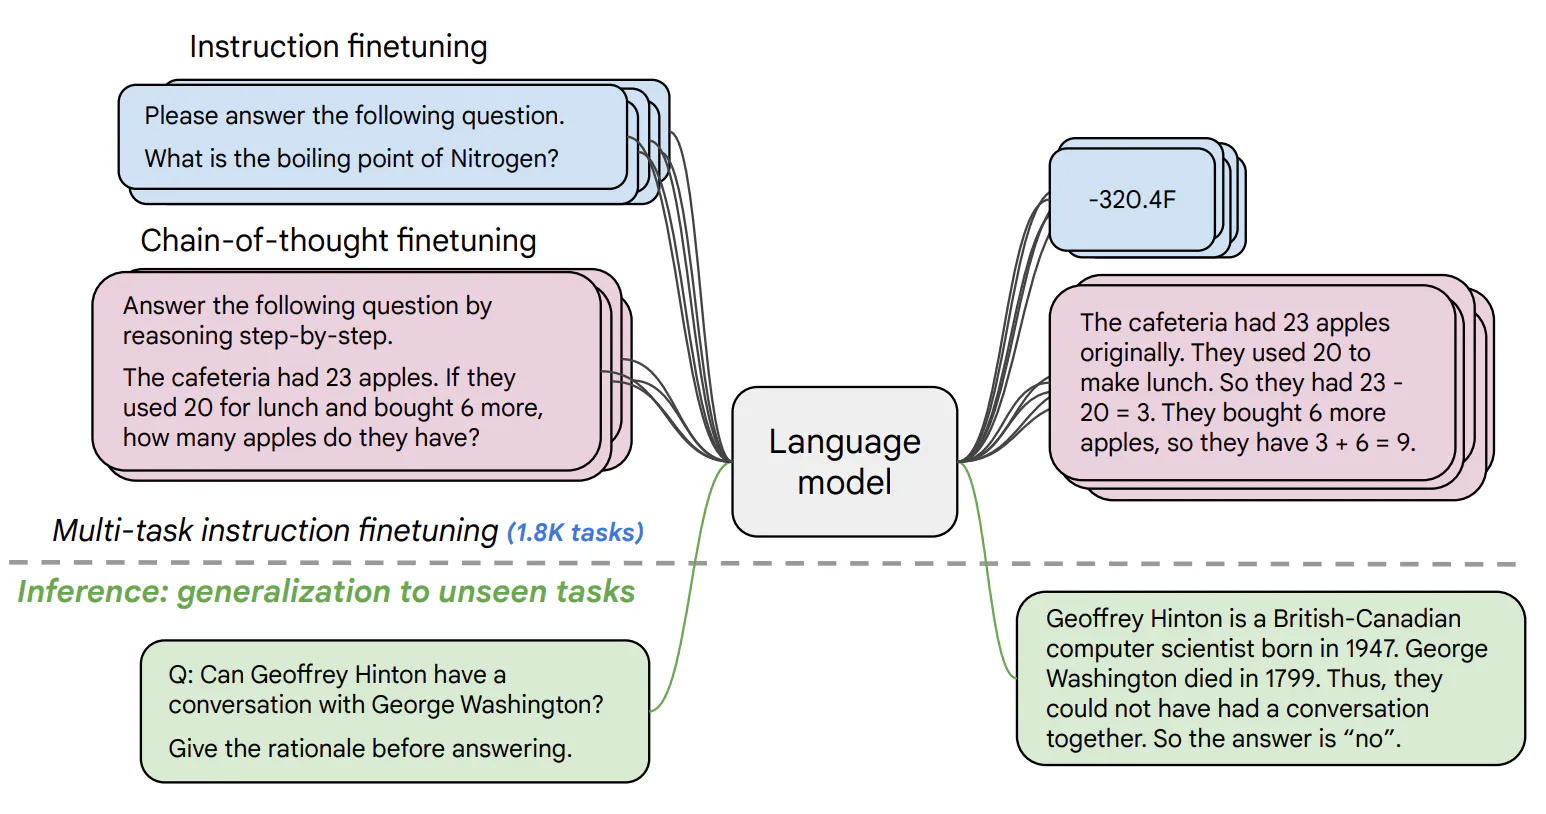
Voorbeelden van hoe T5 uiteenlopende taken herschikt naar een text-to-text-raamwerk (bron)
Ook sluit de architectuur van het T5-model nauw aan bij de encoder-decoderstructuur uit de oorspronkelijke Transformer-paper. Het belangrijkste verschil zit in de omvang en aard van de trainingsdata; T5 is getraind op een omvangrijk corpus van 750 GB tekst, bekend als de Colossal Clean Crawled Corpus (C4).
Daarentegen was de oorspronkelijke Transformer specifiek ontworpen voor taalvertaling en daarom getraind op een dataset van 1,4 GB met Engels-Duitse zinnenparen.
Ons artikel An Introduction to Using Transformers and Hugging Face helpt je transformers te begrijpen en hun kracht in te zetten om echte problemen op te lossen.
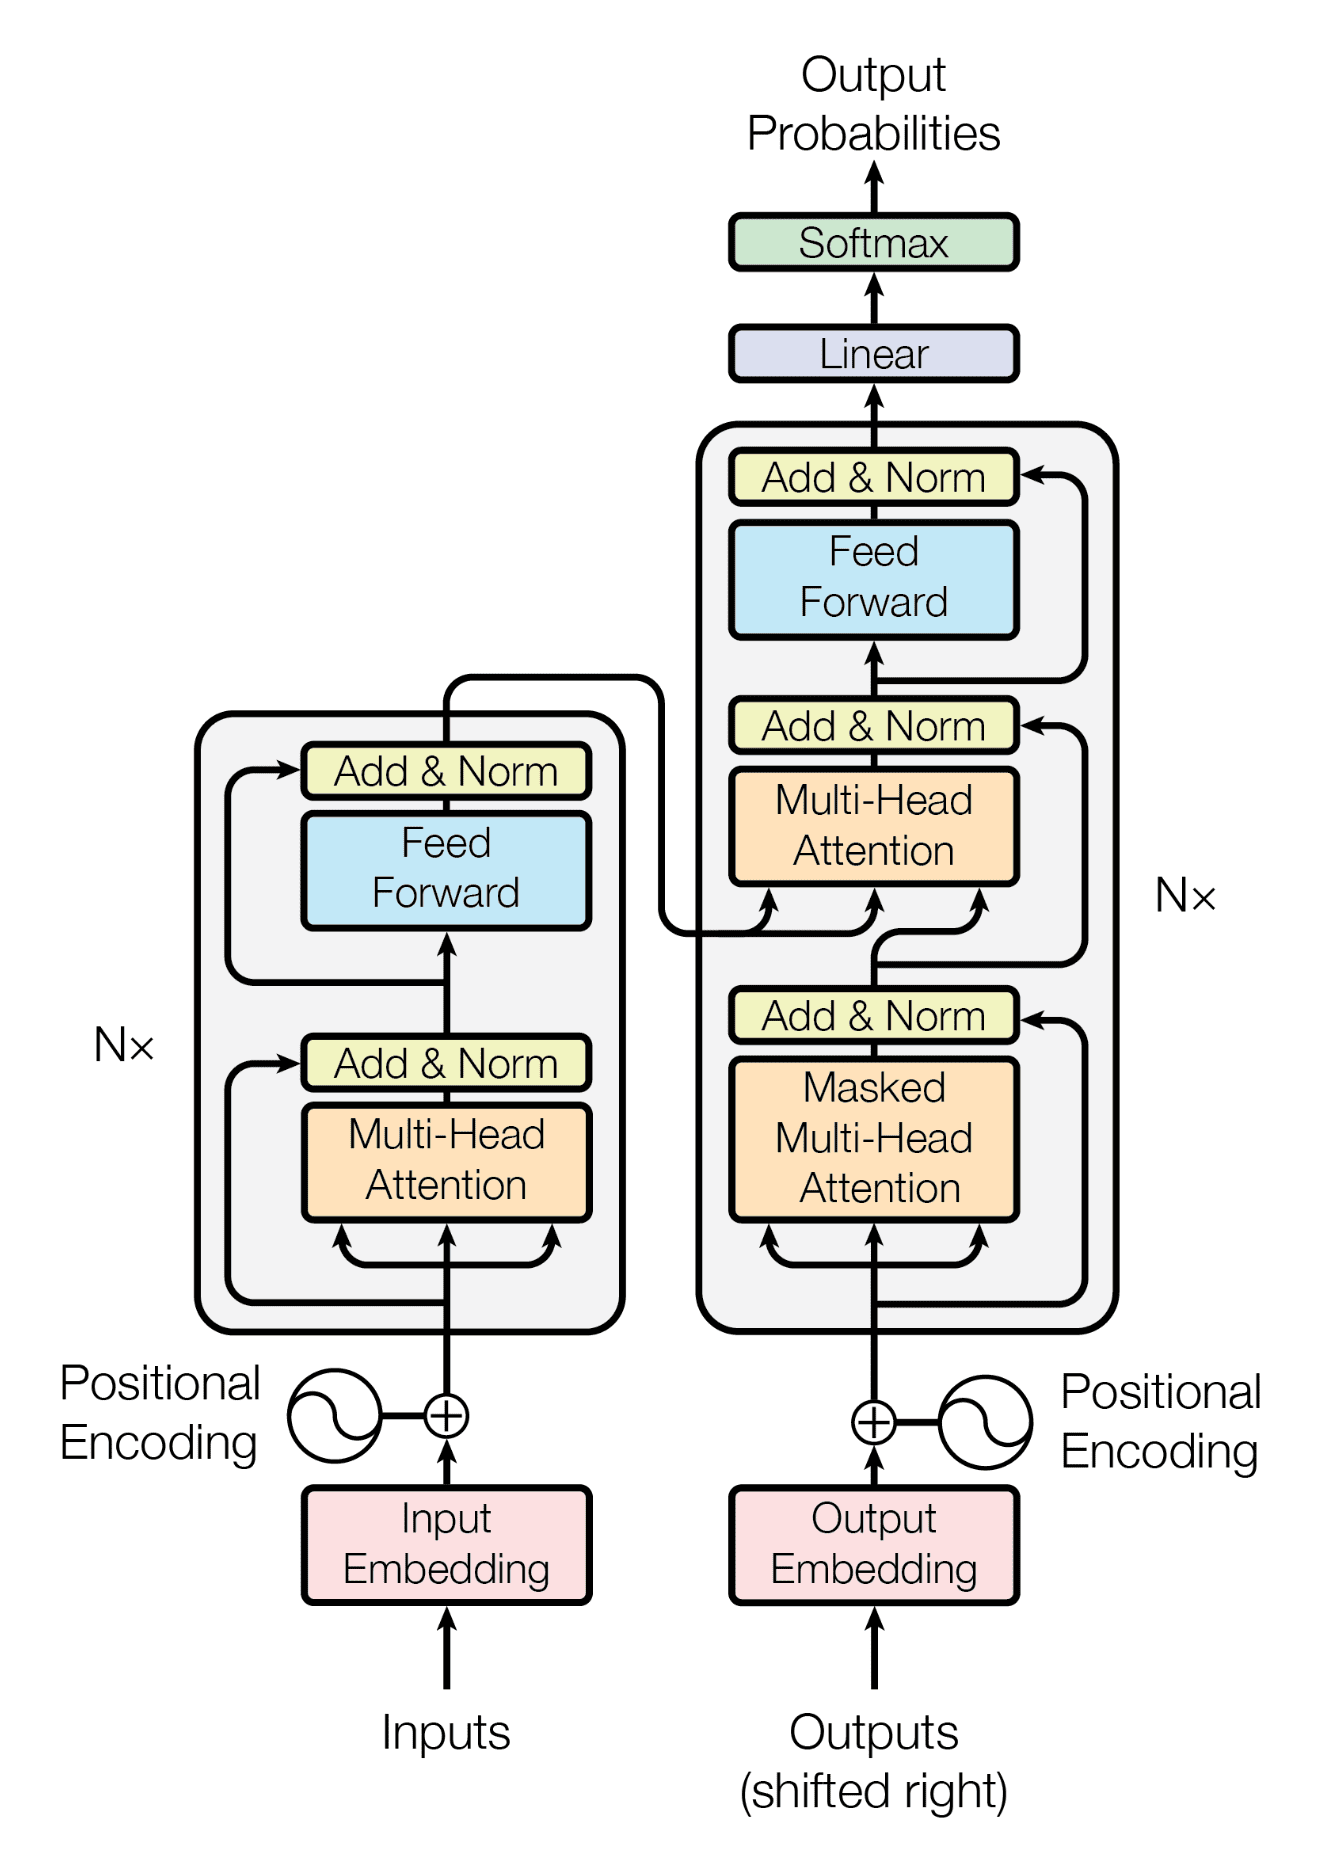
De architectuur van het Transformer-model (bron)
Hoe belangrijk is het fine-tunen van FLAN-T5?
Er bestaat geen twijfel over dat FLAN-T5 voor uiteenlopende Natural Language Processing-taken gebruikt kan worden.
Maar om het volledige potentieel te benutten en optimale prestaties voor specifieke toepassingen te garanderen, is fine-tuning een cruciale stap. Hieronder staan de belangrijkste punten die het belang van het fine-tunen van FLAN-T5 benadrukken:
- Fine-tuning van FLAN-T5 is belangrijk om het model aan te passen aan specifieke taken en de prestaties daarop te verbeteren.
- Fine-tuning maakt het mogelijk het model te personaliseren zodat het beter aansluit bij de behoeften en data van de gebruiker.
- Doordat je FLAN-T5 op lokale werkstations met CPU's kunt finetunen, is het toegankelijk voor een breder publiek.
- Die toegankelijkheid is gunstig voor kleinere organisaties of individuele onderzoekers die geen GPU-resources hebben.
- Al met al is het fine-tunen van FLAN-T5 een waardevolle stap om het model te optimaliseren voor specifieke use-cases en de mogelijke voordelen te maximaliseren.
Het doel van deze tutorial is om een complete gids te bieden voor het fine-tunen van FLAN-T5 in een vraag-en-antwoordscenario.
In deze tutorial behandelen we verschillende onderwerpen om je te helpen het fine-tunen van FLAN-T5 te begrijpen en toe te passen. We beginnen met de benodigde libraries en tools, gevolgd door de stappen om de omgeving voor fine-tuning in te richten.
Vervolgens begeleiden we je bij het laden van het FLAN-T5-model en het voorbereiden van je data voor fine-tuning. Zodra de data klaar is, doorlopen we de stappen om het model te trainen en te finetunen voor jouw specifieke behoeften.
Tot slot verkennen we een paar mogelijke toepassingen van het gefinetunede FLAN-T5-model en laten we zien hoe je het in verschillende scenario's kunt inzetten voor betere prestaties en nauwkeurigere resultaten.
Mogelijke toepassingen van gefinetunede FLAN-T5
Voordat we de technische implementatie induiken, verkennen we eerst enkele mogelijke toepassingen van een gefinetunede FLAN-T5: hieronder staan voorbeelden voor samenvatten van chat en dialoog, tekstclassificatie en Fast Healthcare Interoperability Resources (FHIR).
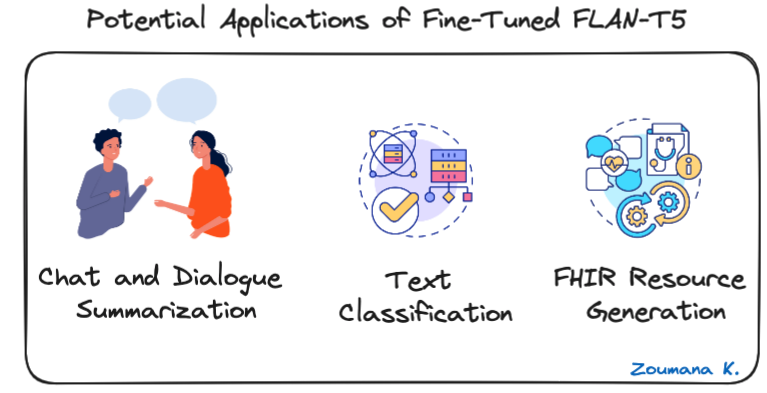
Drie mogelijke toepassingen van gefinetunede FLAN-T5
- Samenvatten van chat en dialoog: FLAN-T5 kan gesprekken comprimeren en zo een snelle recap geven van klantcontact of zakelijke meetings.
- Tekstclassificatie: handig om tekst automatisch in vooraf gedefinieerde klassen te categoriseren, zoals sentimentanalyse, spamdetectie of topic modelling.
- FHIR-resourcegeneratie: FLAN-T5 kan klinische tekst omzetten naar gestructureerde FHIR (Fast Healthcare Interoperability Resources) voor eenvoudig delen en integratie in zorgsystemen.
Voordat we de kerntechniek van het artikel induiken, gidst onze tutorial, How to Build LLM Applications with LangChain, je door het onbenutte potentieel van Large Language Models met LangChain, een open-source Python-framework voor het bouwen van geavanceerde AI-toepassingen.
Vereisten
Nu we een beter begrip hebben van FLAN-T5, kijken we hoe je het kunt fine-tunen voor een vraag-en-antwoord-use-case. Het volledige notebook staat op GitHub.
De volgende libraries en tools zijn nodig om te beginnen:
- Hugging Face: een platform dat toegang biedt tot het FLAN-T5-model, zodat je het kunt downloaden en gebruiken voor fine-tuning
- Transformers: wordt gebruikt om het laden van het voorgetrainde FLAN-T5-model te vereenvoudigen en biedt handige functies voor fine-tuning
- Datasets: een verzameling kant-en-klare datasets, cruciaal om relevante data voor fine-tuning te vinden
- Sentencepiece: een tokenisatietool die vooral wordt gebruikt voor grote en meertalige tekstdata
- Tokenizers: een tokenisatiebibliotheek om tekst om te zetten naar een geschikt formaat voor de use-case
- Evaluate: deze library biedt een breed scala aan metrics voor model-evaluatie, zodat het gefinetunede model aan de gewenste prestatienorm voldoet
- Rouge score: specifieke metric om de kwaliteit van door grote taalmodellen gegenereerde tekst te evalueren
- NLTK: nuttig voor datapreprocessingstappen zoals tokenisatie en stemming
Installatie van de libraries
De installatie kan als volgt worden uitgevoerd met pip, de Python-pakketmanager, vanuit een Jupyter-notebook.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
Het commando %%bash wordt in het notebook gebruikt om de betreffende cel als bashscript uit te voeren in plaats van elk commando afzonderlijk te draaien.
Libraries importeren
Na de installatie van alle libraries kunnen we ze als volgt importeren:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Het FLAN-T5-model laden
Op Hugging Face zijn meerdere varianten van FLAN-T5 beschikbaar, van klein tot extra groot; hoe groter het model, hoe meer parameters.
Hieronder staan de verschillende modelgroottes die op de modelkaart van Hugging Face beschikbaar zijn:
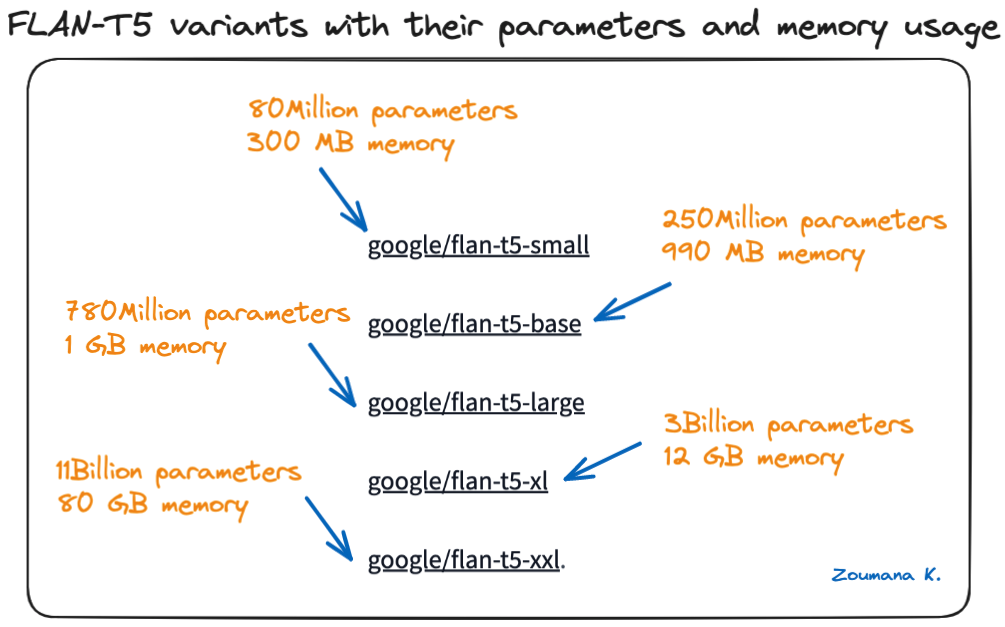
FLAN-T5-varianten met hun parameters en geheugengebruik
De juiste modelgrootte kiezen
De keuze voor de juiste modelgrootte binnen de FLAN-T5-varianten hangt sterk af van de volgende criteria:
- De specifieke eisen van het project
- De beschikbare rekenresources
- Het verwachte prestatieniveau
Voor deze experimenten gebruiken we een NVIDIA A100-GPU, en het model google/flan-t5-base biedt een goede balans tussen reken-efficiëntie en prestaties.
Initialisatie van model en tokenizer
De volgende drie instructies zijn nodig om het model te maken.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- De tokenizer wordt geïnstantieerd met de T5Tokenizer-module en de naam van het model
- Met de functie from_pretrained van T5ForConditionalGeneration wordt het model geladen
- Met de DataCollectorForSeq2Seq wordt een datacollector gemaakt voor de vraag-en-antwoordtaak
Data voorbereiden voor fine-tuning
Met het model, de tokenizer en de datacollector beschikbaar, is de volgende stap het laden van de experimenteerdata voor fine-tuning. We gebruiken de Yahoo-discussiedata die op Hugging Face beschikbaar is.
Het laden van de data is eenvoudig en kan met de functie load_dataset, die de naam van de dataset als parameter neemt. In dit specifieke geval focussen we op de trainingsdata.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Zodra de data is opgehaald, wordt deze gesplitst in een trainings- en testset, respectievelijk 70% en 30%, met de functie train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)De volgende instructie toont het totale aantal observaties in zowel de trainings- als testdata.
# Check the length of the data and its structure
yahoo_answers_qa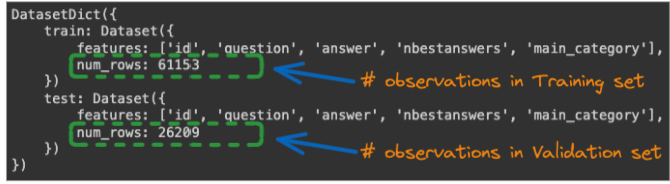
Totaal aantal observaties voor zowel de trainings- als validatiesets
Dataformattering en tokenisatie
We hebben veel data in zowel de trainings- als testsets voor het fine-tuningproces. Maar eerst moeten we de data bewerken zodat die past bij het fine-tuningformaat.
De meeste functies die we in de volgende stap gebruiken, zijn geïnspireerd op het artikel van Toughdata.
Tijdens inference roepen we het model als volgt aan:
“Please answer this question: <USER_QUESTION>”
Waarbij <USER_QUESTION> de vraag is waarop de gebruiker een antwoord wil. Om die functionaliteit te bereiken, moeten we de trainingsdata formatteren door de taak te voorzien van het voorvoegsel “Please answer this question,” en dat doen we met de functie preprocess_function hieronder.
Naast de formattering past de functie ook tokenisatie toe op de inputs en outputs met de functie tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Vervolgens passen we de functie toe op de hele dataset met de map-functie hieronder:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
FLAN-T5 trainen en fine-tunen
Voordat we het trainingsproces induiken, is het goed om de metrics te bepalen waarmee we de algehele prestatie van de fine-tuning evalueren.
Goede evaluatiemetrics zijn in elk deep-learning- en machinelearningproject belangrijk om de prestaties van modellen te beoordelen, niet alleen tijdens training maar ook later in productie.
Twee van de meest gebruikte metrics om de prestaties van een tekstgeneratiemodel te evalueren zijn BLEU en ROUGE, in dit geval om de kwaliteit van een antwoord te beoordelen door het te vergelijken met een referentieantwoord.
De focus van deze tutorial ligt op ROUGE, maar dit Wikipedia-artikel geeft meer informatie over de BLEU-score.
Wat is de ROUGE-score?
ROUGE staat voor Recall-Oriented Understudy for Gisting Evaluation. Enkele kerncomponenten van ROUGE voor vraag-en-antwoord zijn:
- ROUGE-L: meet de langste gemeenschappelijke subsequence tussen kandidaat- en referentieantwoorden. Richt zich op recall van de volledige tekst.
- ROUGE-1, ROUGE-2, ROUGE-SU4: vergelijken unigram-, bigram- en 4-gram-overlap tussen kandidaat en referentie. Focus op recall van kernonderdelen/-fragmenten
- Hogere ROUGE-scores duiden over het algemeen op betere prestaties bij vraag-en-antwoord. Scores dicht bij of boven 0,70+ worden als sterk beschouwd
- Bij gebruik van deze metric kunnen bewerkingen zoals stemming en het verwijderen van stopwoorden de algehele prestaties helpen verbeteren
Met dit begrip kan de volgende helperfunctie compute_metrics helpen de onderliggende ROUGE-score te berekenen. Voordat we de functie implementeren, moeten we ROUGE en NLTK instellen.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Hieronder staat de implementatie van de functie.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Trainingsproces
Om de fine-tuning te starten, moeten we enkele hyperparameters instellen; de belangrijkste staan hieronder:
- Learning rate: bepaalt hoe snel het model van de data leert; typische waarden zijn 1e-5 tot 5e-5, en voor deze use-case is de waarde 3e-4
- Batchgrootte: het totale aantal samples dat wordt verwerkt voordat de gewichten van het model worden bijgewerkt. Grotere batches kunnen het proces versnellen, maar kunnen leiden tot slechtere prestaties. We gebruiken 8 in deze use-case
- Per device train batch size: vergelijkbaar met batchgrootte, maar dan per apparaat (GPU) gespecificeerd
- Weight decay: doel is overfitting te voorkomen. 0,01 is een acceptabele waarde voor de wegingsgrootte
- Save total limit: het totale aantal checkpoints dat tijdens training wordt opgeslagen. Hoe meer saves, hoe groter de mogelijkheid om terug te rollen, maar dit gebruikt meer schijfruimte. We slaan 3 keer op in dit geval
- Aantal epochs: het totale aantal passes door de trainingsdataset. Meer epochs verlengen de trainingstijd maar kunnen ook de modelprestaties verbeteren. Doorgaans kies je een waarde van 3 tot 10; wij gebruiken 3 in deze use-case.
Bovenstaande parameters definiëren we hieronder en gebruiken we voor het instellen van de training-arguments van het model; de trainingsartefacten worden opgeslagen in de map results:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Vervolgens stellen we de trainer in om het trainingsproces van het model te starten.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Tot slot starten we de modeltraining met de functie train als volgt:
trainer.train()Na bijna vier uur zijn de algehele prestaties van het trainingsproces per epoch hieronder weergegeven.
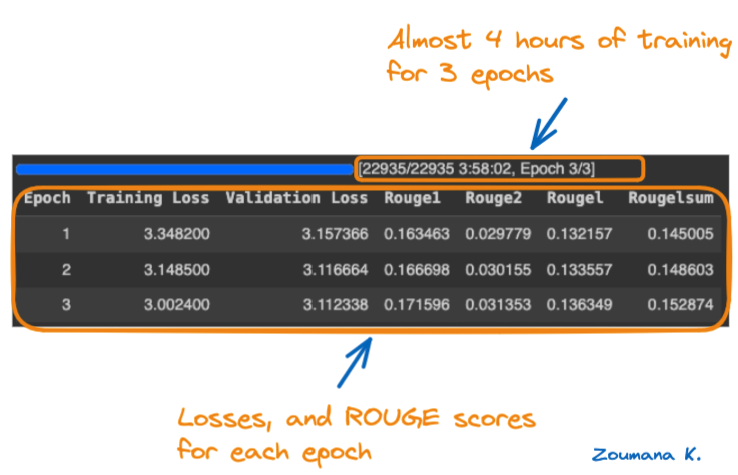
Training-epochs en de bijbehorende prestatiescores
Laten we het bovenstaande scorebord met prestatiestatistieken duiden.
- Training loss en validatieloss: Lagere waarden zijn beter, omdat ze aangeven dat het model beter op de data past. De training- en validatieloss zijn over de epochs gedaald, met de laagste waarden in epoch 3.
- Rouge-metrics (Rouge1, Rouge2, Rougel en Rougelsum): Hogere waarden zijn beter, omdat ze wijzen op betere prestaties bij tekstsamenvatting. Over alle vier de Rouge-metrics zijn de waarden gestegen, met de hoogste scores in epoch 3.
Al met al presteerde het model goed tijdens de derde epoch, met de laagste training- en validatieloss én de hoogste waarden op alle ROUGE-metrics. Hieronder staat de inhoud van de map results met alle checkpoints:
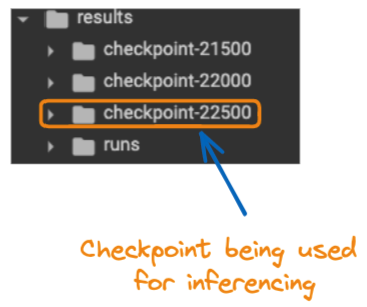
Inhoud van de map “results”
Modelinference
Nu het model is gefinetuned, is het tijd om het toe te passen in een realistisch scenario.
Daar draait modelinference om: een bestaand model gebruiken om een probleem uit de echte wereld op te lossen — precies wat we hier met het gefinetunede model doen.
Voor we beginnen, voeren we een paar stappen uit:
- Laad het gefinetunede model vanaf de laatste checkpoint
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Definieer een specifieke vraag om te beantwoorden
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Voer de voorspelling uit
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Hieronder staat het resultaat van het gefinetunede model — en dat oogt behoorlijk goed. De fill-methode van textwrap beperkt het maximale aantal tekens tot 80 per regel, zodat je niet één lange regel krijgt.

Antwoord van het gefinetunede model op de vraag
Conclusie en volgende stappen
Dit artikel gaf een complete gids voor het fine-tunen van een FLAN-T5-model. Eerst kreeg je een beter begrip van het model en de mogelijke use-cases, daarna liepen we de technische implementatie door: van het laden van de experimenteerdata en het model van Hugging Face tot het trainen van het model op een GPU. Het beste model, gemeten met de ROUGE-scores, is getest in een realistisch scenario.
Waar ga je hierna naartoe?
Onze artikelen 12 GPT-4 Open-Source Alternatives en How to Train a LLM with PyTorch zijn een mooie volgende stap om je skills te ontwikkelen. Het eerste artikel belicht open-source alternatieven voor GPT-4 die vergelijkbare prestaties kunnen bieden en minder rekenkracht vereisen. Deze projecten bevatten instructies, broncode, modelgewichten, datasets en een chatbot-UI.
Het tweede artikel helpt je het trainen van grote taalmodellen met PyTorch te beheersen, van de initiële setup tot de uiteindelijke implementatie. Versterk ook jouw skills met het krachtige deep-learningframework dat door AI-professionals wordt gebruikt. Volg vandaag nog de cursus Deep Learning with PyTorch.

