FLAN-T5 nedir?
FLAN-T5, ticari olarak da kullanılabilen, açık kaynaklı, uçtan uca (sequence-to-sequence) bir büyük dil modelidir. Model, 2022 sonlarında Google araştırmacıları tarafından yayımlandı ve birden çok görev üzerinde ince ayarlandı.
T5 modeli, aşağıda gösterildiği gibi çeviri, dilbilimsel kabul edilebilirlik, cümle benzerliği ve belge özetleme gibi çeşitli görevleri metinden-metne bir formata dönüştürür:
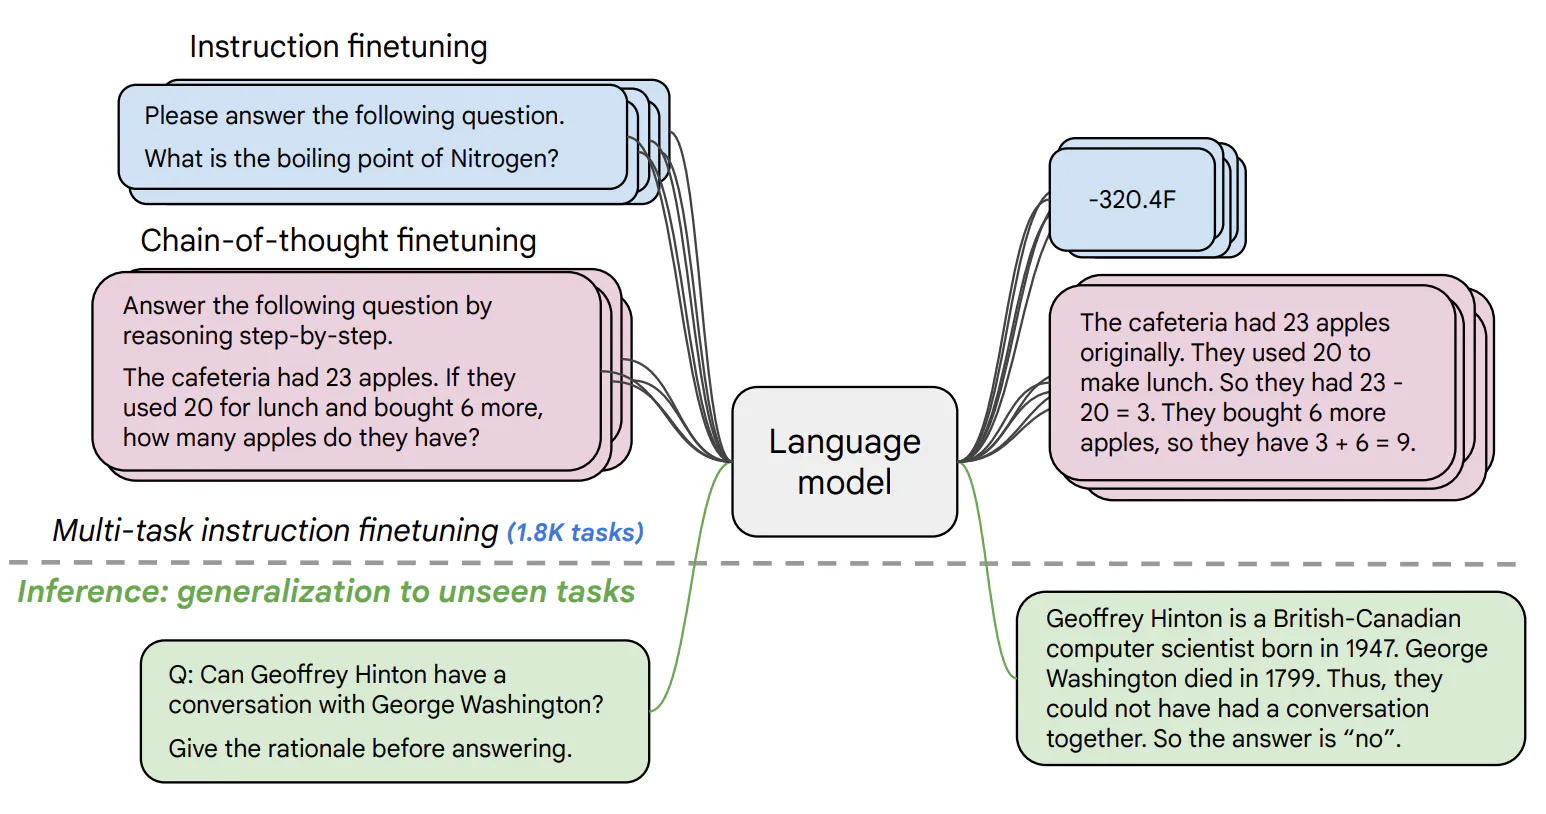
T5'in çok çeşitli görevleri metinden-metne çerçevesine nasıl dönüştürdüğüne dair örnekler (kaynak)
Benzer şekilde, T5 modelinin mimarisi, orijinal Transformer makalesinde kullanılan kodlayıcı-kod çözücü yapısıyla yakından örtüşür. Başlıca fark, eğitim verisinin boyutu ve niteliğidir; T5, Colossal Clean Crawled Corpus (C4) olarak bilinen 750 GB'lık geniş bir metin külliyatı üzerinde eğitilmiştir.
Buna karşılık, orijinal Transformer özellikle dil çevirisi için tasarlanmıştı ve bu nedenle 1,4 GB'lık İngilizce-Almanca cümle çiftlerinden oluşan bir veri kümesi üzerinde eğitildi.
Transformers ve Hugging Face Kullanımına Giriş başlıklı makalemiz, okuyucuya transformer'ları anlaması ve gerçek hayattaki sorunları çözmek için güçlerinden yararlanması konusunda rehberlik eder.
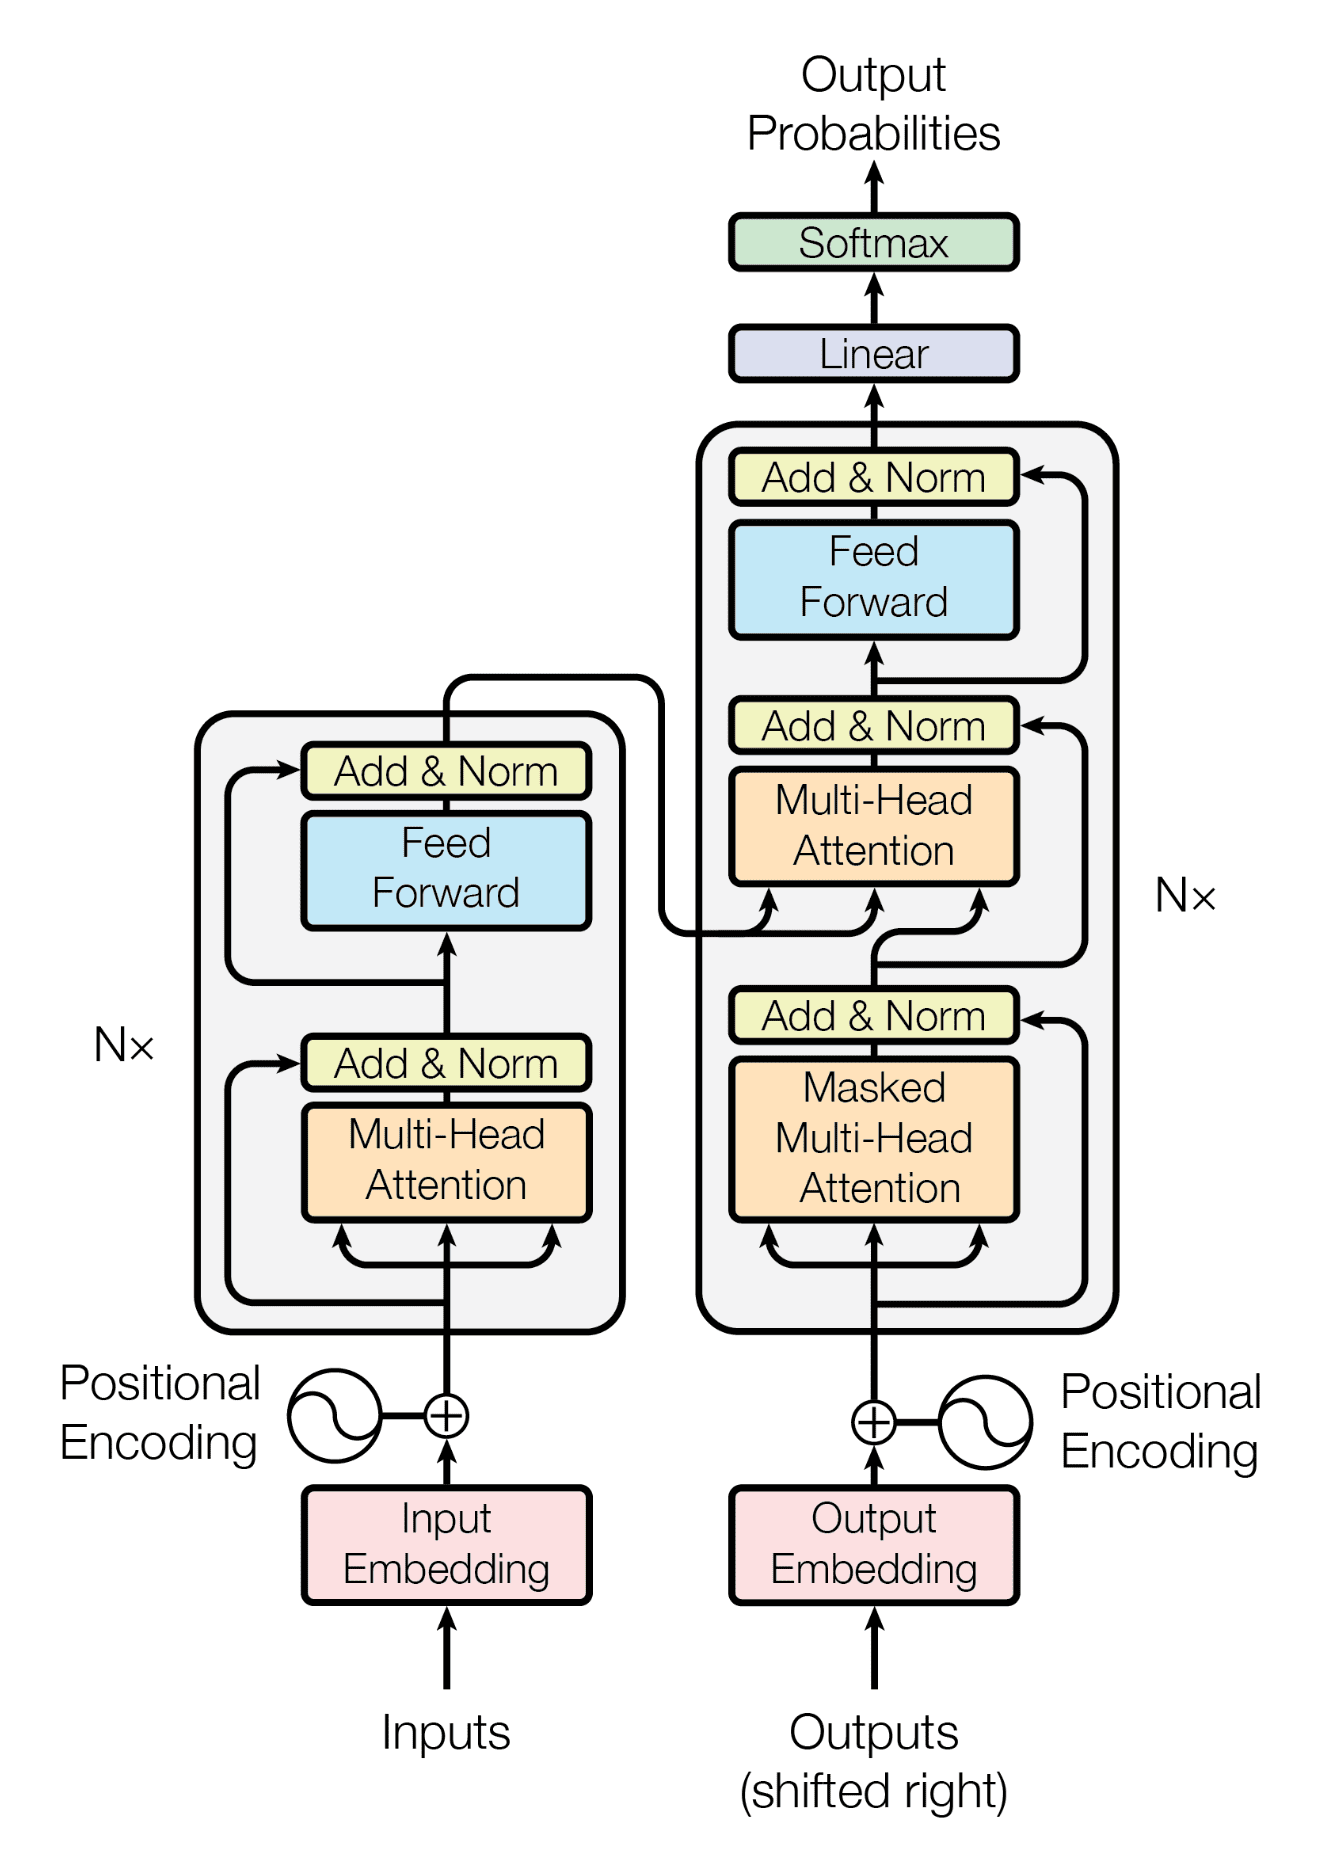
Transformer model mimarisi (kaynak)
FLAN-T5'in ince ayarı ne kadar önemli?
FLAN-T5'in çeşitli Doğal Dil İşleme görevlerinde kullanılabileceği tartışmasızdır.
Ancak, tam potansiyelinden yararlanmak ve belirli uygulamalarda en iyi performansı sağlamak için ince ayar kritik bir adımdır. Aşağıda, FLAN-T5'in ince ayarının önemini vurgulayan başlıca noktalar yer almaktadır:
- FLAN-T5'in ince ayarı, modeli belirli görevlere uyarlamak ve bu görevlerdeki performansını artırmak için önemlidir.
- İnce ayar, modelin kullanıcının ihtiyaçlarına ve verisine daha iyi uyacak şekilde özelleştirilmesine olanak tanır.
- FLAN-T5'in yerel iş istasyonlarında CPU'larla ince ayar yapılabilmesi, onu daha geniş bir kullanıcı kitlesi için erişilebilir kılar.
- Bu erişilebilirlik, GPU kaynaklarına erişimi olmayan daha küçük kuruluşlar veya bireysel araştırmacılar için faydalıdır.
- Genel olarak, FLAN-T5'in ince ayarı, modeli belirli kullanım senaryoları için optimize etmede ve potansiyel faydalarını en üst düzeye çıkarmada değerli bir adımdır.
Bu eğitimin amacı, FLAN-T5'in bir soru-cevap senaryosunda ince ayarı için kapsamlı bir rehber sunmaktır.
Bu eğitimde, FLAN-T5 için ince ayarı anlamanıza ve uygulamanıza yardımcı olacak bir dizi konuyu ele alacağız. Önce bu süreç için gerekli kütüphane ve araçları tartışacak, ardından ince ayar ortamının nasıl kurulacağını adım adım göstereceğiz.
Sonrasında, FLAN-T5 modelini yükleme ve verilerinizi ince ayara hazırlama sürecinde size rehberlik edeceğiz. Veri hazır olduğunda, modeli özel ihtiyaçlarınıza uyacak şekilde eğitme ve ince ayar adımlarını birlikte yürüteceğiz.
Son olarak, ince ayar uygulanmış FLAN-T5 modelinin bazı olası kullanım alanlarını keşfedecek, farklı senaryolarda nasıl daha iyi performans ve daha doğru sonuçlar elde etmek için kullanılabileceğini göstereceğiz.
İnce Ayar Uygulanmış FLAN-T5'in Olası Kullanım Alanları
Teknik uygulamaya geçmeden önce, ince ayar uygulanmış FLAN-T5'in olası kullanım alanlarını inceleyelim; aşağıda sohbet ve diyalog özetleme, metin sınıflandırma ve Fast Healthcare Interoperability Resources (FHIR) için bazı örnekler yer almaktadır.
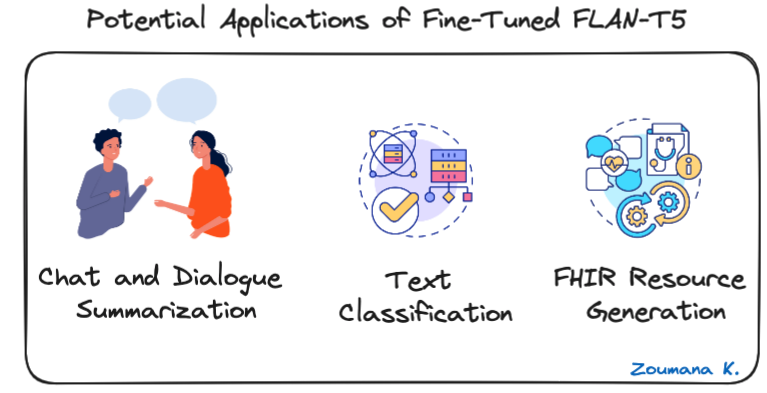
İnce Ayar Uygulanmış FLAN-T5'in Üç Olası Kullanım Alanı
- Sohbet ve diyalog özetleme: FLAN-T5, görüşmeleri kısaltarak müşteri hizmetleri etkileşimleri veya iş toplantıları için hızlı bir özet sağlayabilir.
- Metin sınıflandırma: duygu analizi, spam tespiti veya konu modelleme gibi önceden tanımlanmış sınıflara metni otomatik olarak ayırmak için kullanışlıdır.
- FHIR kaynak üretimi: FLAN-T5, klinik metni, sağlık sistemlerine kolay paylaşım ve entegrasyon için yapılandırılmış FHIR (Fast Healthcare Interoperability Resources) formatına dönüştürebilir.
Makalenin temel teknik yönlerine girmeden önce, LangChain ile LLM Uygulamaları Nasıl Geliştirilir başlıklı eğitimimiz, gelişmiş yapay zeka uygulamaları geliştirmek için açık kaynaklı bir Python çerçevesi olan LangChain ile Büyük Dil Modellerinin keşfedilmemiş potansiyelini keşfetmenize yardımcı olur.
Önkoşullar
Artık FLAN-T5'i daha iyi anladığımıza göre, onu bir soru-cevap kullanım durumu için nasıl ince ayar yapacağımıza bakalım; tam not defteri GitHub'da mevcuttur.
Başlamak için aşağıdaki kütüphane ve araçlar gereklidir:
- Hugging Face: FLAN-T5 modeline erişim sağlayarak indirme ve ince ayar için kullanımını kolaylaştıran bir platform
- Transformers: önceden eğitilmiş FLAN-T5 modelini yükleme sürecini basitleştirir ve ince ayar için yararlı işlevler sunar
- Datasets: ince ayar için ilgili verilerin temininde kritik öneme sahip, kullanıma hazır veri kümeleri koleksiyonu
- Sentencepiece: büyük ve çok dilli metin verilerini işlemek için ağırlıklı olarak kullanılan bir ayrıştırma (tokenization) aracı
- Tokenizers: metni kullanım senaryosuna uygun bir formata dönüştürmeye yönelik bir ayrıştırma kütüphanesi
- Evaluate: ince ayar uygulanmış modelin istenen performans standardını karşıladığından emin olmak için geniş bir değerlendirme metriği yelpazesi sunar
- Rouge score: büyük dil modellerinin ürettiği metnin kalitesini değerlendirmek için kullanılan özel bir metrik
- NLTK: ayrıştırma ve kök bulma gibi veri ön işleme adımları için kullanışlıdır
Kütüphanelerin kurulumu
Kurulum, Jupyter not defterinden Python paket yöneticisi pip kullanılarak aşağıdaki gibi yapılabilir.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
%%bash komutu, not defterinde ilgili hücreyi her komutu tek tek çalıştırmak yerine bir bash betiği olarak çalıştırmak için kullanılır.
Kütüphaneleri içe aktarma
Tüm kütüphanelerin kurulmasının ardından, her birini aşağıdaki gibi içe aktarabiliriz:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
FLAN-T5 Modelini Yükleme
Hugging Face üzerinde küçükten ekstra büyüğe farklı FLAN-T5 model formatları mevcuttur ve model büyüdükçe içerdiği parametre sayısı artar.
Aşağıda, Hugging Face model kartında bulunan farklı model boyutları verilmiştir:
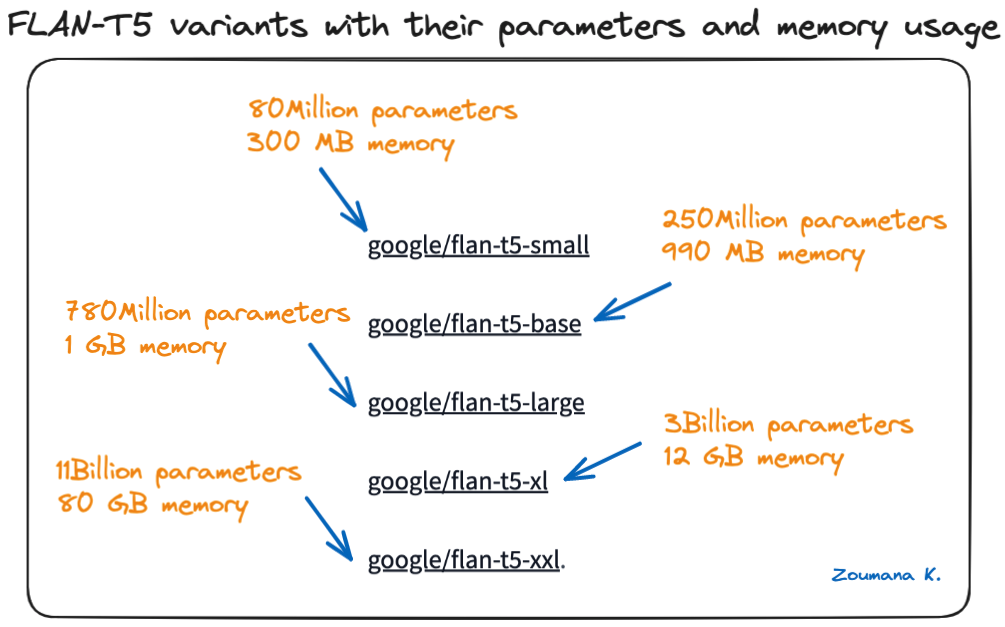
FLAN-T5 varyantları, parametreleri ve bellek kullanımlarıyla
Doğru model boyutunu seçmek
FLAN-T5 varyantları arasından doğru model boyutunun seçimi büyük ölçüde aşağıdaki ölçütlere bağlıdır:
- Projenin özel gereksinimleri
- Mevcut hesaplama kaynakları
- Beklenen performans seviyesi
Bu denemede bir NVIDIA A100 GPU kullanılmaktadır ve google/flan-t5-base modeli, hesaplama verimliliği ile performans uyumluluğu arasında bir denge sağlayacaktır.
Model ve Ayrıştırıcı başlatma
Modeli oluşturmak için aşağıdaki üç talimat gereklidir.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Ayrıştırıcı, T5Tokenizer modülü ve modelin adı kullanılarak oluşturulur
- T5ForConditionalGeneration içindeki from_pretrained işlevi kullanılarak model yüklenir
- DataCollectorForSeq2Seq ile soru-cevap görevi için kullanılacak bir veri toplayıcı oluşturulur
İnce Ayar için Verilerin Hazırlanması
Model, ayrıştırıcı ve veri toplayıcı hazır olduğuna göre, sonraki adım ince ayar için denemeyi yüklemektir ve burada kullanılan veri, Hugging Face üzerinde mevcut olan Yahoo tartışma verisidir.
Verinin yüklenme süreci basittir ve parametre olarak veri kümesinin adını alan load_dataset işleviyle gerçekleştirilebilir. Bu özel durumda odak, eğitim verisindedir.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Veri alındıktan sonra, sırasıyla %70 ve %30 oranlarında eğitim ve test veri kümelerine bölünür; bu da train_test_split işleviyle yapılır.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)Aşağıdaki ifade, hem eğitim hem de test verilerindeki toplam gözlem sayısını gösterir.
# Check the length of the data and its structure
yahoo_answers_qa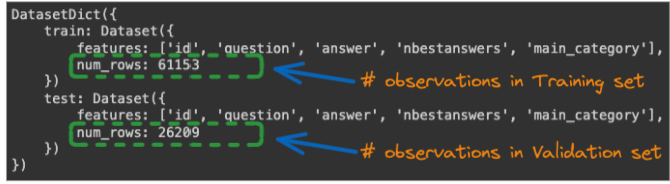
Eğitim ve doğrulama veri kümeleri için toplam gözlem sayısı
Veri biçimleme ve ayrıştırma
İnce ayar süreci için hem eğitim hem de test veri setlerinde önemli miktarda veri var. Ancak bundan önce, verileri ince ayar formatına uyacak şekilde işlememiz gerekiyor.
Sonraki adımda kullanılan işlevlerin çoğu, Toughdata makalesinden esinlenmiştir.
Çıkarım modunda, modeli çağırma süreci şu biçimde olacaktır:
“Lütfen şu soruyu yanıtlayın: <USER_QUESTION>”
Burada <USER_QUESTION>, kullanıcının yanıt almak istediği sorudur. Bu işlevselliğe ulaşmak için, eğitim verisini “Lütfen şu soruyu yanıtlayın:” ifadesiyle görevi öne ekleyerek biçimlendirmemiz gerekir; bu da aşağıdaki preprocess_function işleviyle yapılır.
Biçimlemenin yanı sıra, işlev giriş ve çıkışların ayrıştırılmasını da tokenizer işlevi ile uygular.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Sonrasında, işlev tüm veri kümesine aşağıdaki map işlevi kullanılarak uygulanır:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
FLAN-T5 Eğitimi ve İnce Ayarı
Eğitim sürecine dalmadan önce, ince ayarın genel performansını değerlendirmek için kullanılacak metrikleri belirlemek daha iyidir.
İyi değerlendirme metrikleri, yalnızca eğitim sırasında değil, üretimde de modellerin performansını değerlendirmek için her derin öğrenme ve makine öğrenmesi projesinde önemlidir.
Bir metin üretim modelinin performansını değerlendirmek için en yaygın iki metrik BLEU ve ROUGE'tur ve bu durumda bir yanıtın kalitesini, başvuru yanıtıyla karşılaştırarak değerlendirmek için kullanılır.
Bu eğitimin odağı ROUGE'tur; ancak bu Vikipedi makalesi BLEU puanı hakkında daha fazla bilgi sağlar.
ROUGE skoru nedir?
ROUGE, Recall-Oriented Understudy for Gisting Evaluation ifadesinin kısaltmasıdır. Soru-cevap için ROUGE'un bazı kilit bileşenleri şunlardır:
- ROUGE-L: Aday ve başvuru yanıtları arasındaki en uzun ortak alt diziyi ölçer. Bu, tüm metnin geri çağrımına odaklanır.
- ROUGE-1, ROUGE-2, ROUGE-SU4: Aday ve başvuru arasında tekli, ikili ve 4-gram örtüşmelerini karşılaştırır. Kilit parçaların/bölümlerin geri çağrımına odaklanır
- Daha yüksek ROUGE skorları, genellikle soru-cevap için daha iyi performansa işaret eder. 0,70 ve üzeri skorlar güçlü kabul edilir
- Bu metriği kullanırken, gövdeleme (stemming) ve durak sözcükleri kaldırma gibi işlemler genel performansı artırmaya yardımcı olabilir
Bu anlayışla, aşağıdaki compute_metrics yardımcı işlevi, alttaki ROUGE skorunu hesaplamaya yardımcı olabilir. İşlevin uygulanmasından önce ROUGE ve NLTK'nın ayarlanması gerekir.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Aşağıda işlevin uygulanışı yer alıyor.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Eğitim süreci
İnce ayarı başlatmak için bazı hiperparametreleri ayarlamamız gerekir ve başlıcaları aşağıda verilmiştir:
- Öğrenme oranı (Learning rate): modelin veriden ne kadar hızlı öğrendiğini kontrol eder; tipik değerler 1e-5 ile 5e-5 arasındadır ve bu kullanımda değer 3e-4 olarak ayarlanmıştır
- Yığın boyutu (Batch size): modelin ağırlıkları güncellenmeden önce işlenen toplam örnek sayısıdır. Daha büyük yığınlar süreci hızlandırabilir; ancak dezavantajı performansın düşmesine yol açabilmesidir. Bu kullanımda 8 kullanıyoruz
- Cihaz başına eğitim yığın boyutu: yığın boyutuna benzer, ancak her cihaz (GPU) için ayrı ayrı belirtilir
- Ağırlık bozunumu (Weight decay): amacı, modelin aşırı uyum yapmasını önlemektir. 0,01, ağırlık boyutu için kabul edilebilir bir değerdir
- Toplam kayıt sınırı (Save total limit): eğitim sırasında kaydedilecek kontrol noktalarının toplam sayısıdır. Kayıt sayısı arttıkça geri dönme olasılığı artar, ancak daha fazla disk kullanır. Bu durumda 3 kayıt alıyoruz
- Dönem sayısı (Epochs): eğitim veri kümesi üzerinden tamamlanan geçiş sayısıdır. Dönem sayısı arttıkça eğitim süresi uzar, ancak model performansı da iyileşebilir. Genellikle 3 ila 10 arasında bir değer seçilir; bu kullanımda 3 kullanılmıştır.
Yukarıdaki parametreler aşağıda tanımlanmış ve model eğitim argümanlarını ayarlamak için kullanılmıştır; tüm eğitim çıktıları results klasörüne kaydedilir:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Ardından, modelin eğitim sürecini başlatmak için eğitici (trainer) yapılandırılır.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Son olarak, model eğitimi aşağıdaki gibi train işlevi kullanılarak başlatılır:
trainer.train()Yaklaşık dört saat sonra, her dönem için eğitim sürecinin genel performansı aşağıda verilmiştir.
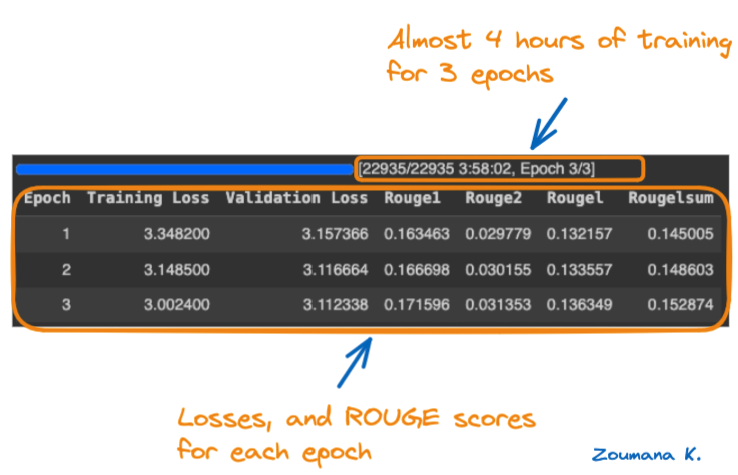
Eğitim dönemleri ve karşılık gelen performans skorları
Yukarıdaki performans panosunu anlayalım.
- Eğitim Kaybı ve Doğrulama Kaybı: Bu metriklerdeki daha düşük değerler tercih edilir; çünkü modelin veriye daha iyi uyum sağladığını gösterir. Eğitim ve doğrulama kaybı dönemler boyunca azalmış ve en düşük değerler 3. dönemde kaydedilmiştir.
- Rouge Metrikleri (Rouge1, Rouge2, Rougel ve Rougelsum): Bu metriklerde daha yüksek değerler tercih edilir; çünkü daha iyi metin özetleme performansına işaret eder. Dört Rouge metriğinin tamamında değerler dönemler boyunca artmış ve en yüksek değerler 3. dönemde kaydedilmiştir.
Genel olarak, model üçüncü dönemde iyi performans göstermiştir; çünkü en düşük eğitim ve doğrulama kaybının yanı sıra tüm ROUGE metriklerinde en yüksek değerleri sunmaktadır. Aşağıda, tüm kontrol noktalarıyla results klasörünün içeriği verilmiştir:
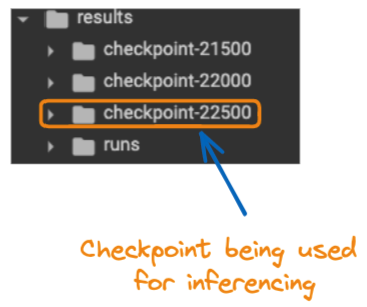
“results” klasörünün içeriği
Model Çıkarımı
Modelin ince ayarı yapıldığına göre, bunu gerçek bir senaryoda uygulamak güzel olmaz mıydı?
Model çıkarımı tam da bununla ilgilidir. Mevcut bir modeli gerçek bir sorunu çözmek için kullanmak ve burada da ince ayar uygulanmış modelle bunu yapıyoruz.
Bundan önce birkaç adımı gerçekleştirmemiz gerekiyor:
- Son kontrol noktası için ince ayarlı modeli yükleyin
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Yanıtlanacak belirli bir soru tanımlayın
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Tahmini çalıştırın
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Aşağıda ince ayar uygulanmış modelin sonucu verilmiştir ve oldukça iyi görünüyor. Ayrıca textwrap içindeki fill yöntemi, tüm dizgenin tek satırda olmasındansa satır başına en fazla 80 karakter olacak şekilde sınırlamak için kullanılmıştır.

Soruyu yanıtlayan ince ayarlı modelin çıktısı
Sonuç ve Sonraki Adımlar
Bu makale, bir FLAN-T5 modelinin ince ayarı için eksiksiz bir rehber sundu. Önce okuyucuya model ve olası kullanım alanları hakkında daha iyi bir anlayış kazandırdı; ardından deneme verilerini ve modeli hugging face üzerinden yüklemekten, modeli bir GPU üzerinde eğitmeye kadar genel teknik uygulamayı adım adım anlattı. ROUGE skorlarına göre en iyi model, gerçek bir senaryoda test edildi
Buradan sonra nereye?
12 GPT-4 Açık Kaynak Alternatifi ve PyTorch ile Bir LLM Nasıl Eğitilir başlıklı makalelerimiz, yetkinliklerinizi geliştirmek için harika bir sonraki adım olabilir. İlki, benzer performans sunabilen ve çalıştırmak için daha az hesaplama kaynağı gerektiren GPT-4 açık kaynak alternatiflerini öne çıkarır. Bu projeler, talimatlar, kaynak kodları, model ağırlıkları, veri kümeleri ve sohbet botu arayüzü ile birlikte gelir.
İkinci makale, okuyucunun PyTorch kullanarak büyük dil modellerini eğitme sürecine, ilk kurululumdan nihai uygulamaya kadar hâkim olmasına yardımcı olur. Ayrıca, AI profesyonellerinin kullandığı güçlü derin öğrenme çerçevesiyle becerilerinizi geliştirebilirsiniz. Bugün PyTorch ile Derin Öğrenme kursuna katılın.




