Qu'est-ce que FLAN-T5 ?
FLAN-T5 est un grand modèle de langage open source, séquence à séquence, qui peut également être utilisé à des fins commerciales. Publié par des chercheurs de Google fin 2022, il a été affiné sur de multiples tâches.
Le modèle T5 reformule diverses tâches au format texte-à-texte, comme la traduction, l'acceptabilité linguistique, la similarité de phrases ou la synthèse de documents, comme illustré ci-dessous :
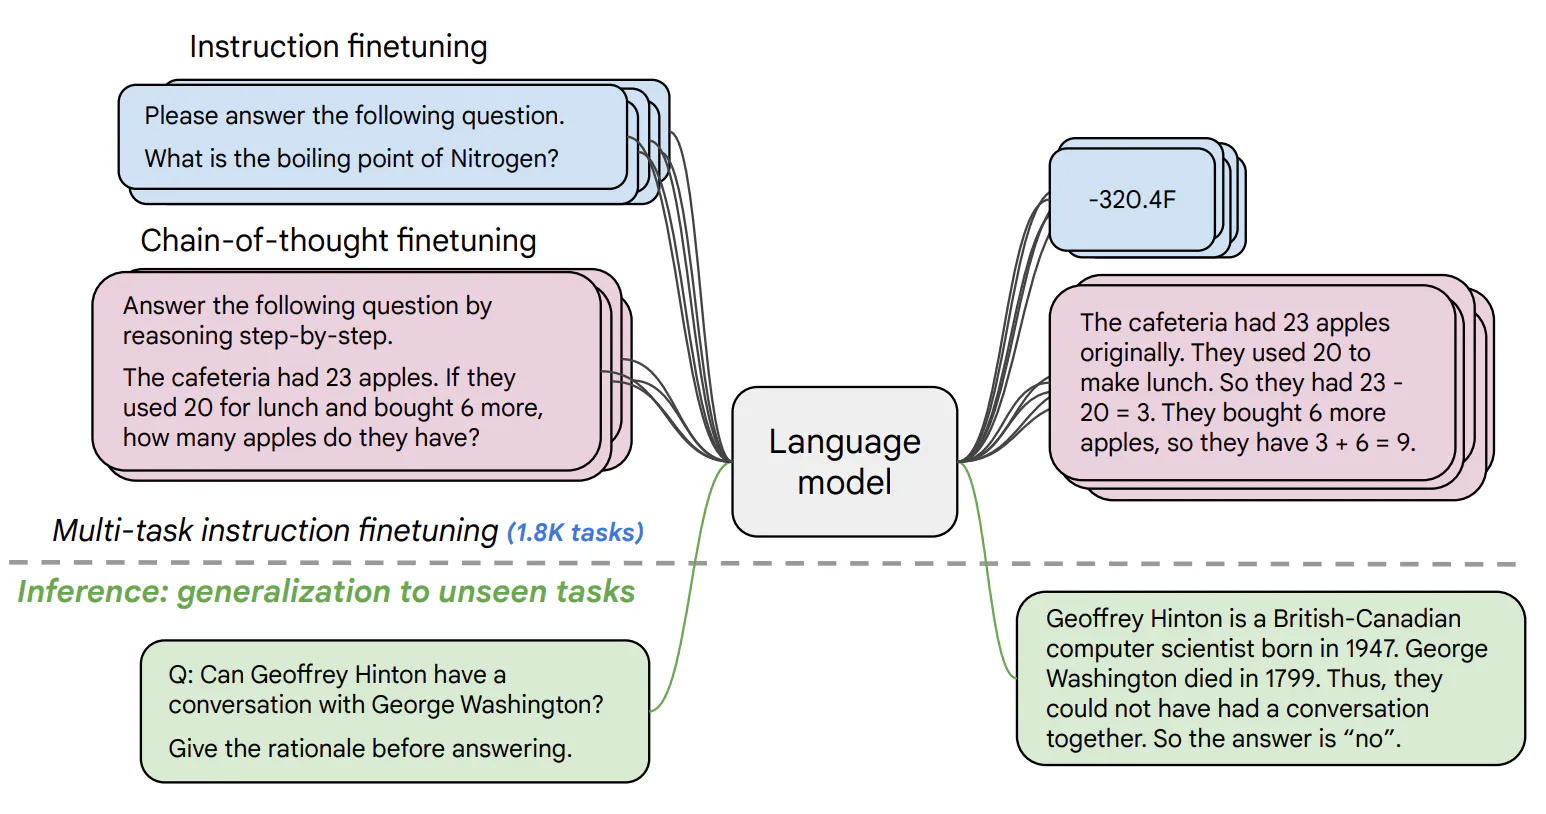
Exemples montrant comment T5 reformule diverses tâches dans un cadre texte-à-texte (source)
De même, l'architecture de T5 s'aligne étroitement sur la structure encodeur-décodeur utilisée dans l'article original sur les Transformers. La principale différence tient à la taille et à la nature des données d'entraînement : T5 a été entraîné sur un corpus massif de 750 Go, le Colossal Clean Crawled Corpus (C4).
À l'inverse, le Transformer original a été spécifiquement conçu pour la traduction et a donc été entraîné sur un jeu de données de 1,4 Go de paires de phrases anglais-allemand.
Notre article Introduction aux Transformers et à Hugging Face vous aide à comprendre les transformers et à exploiter leur puissance pour résoudre des problèmes concrets.
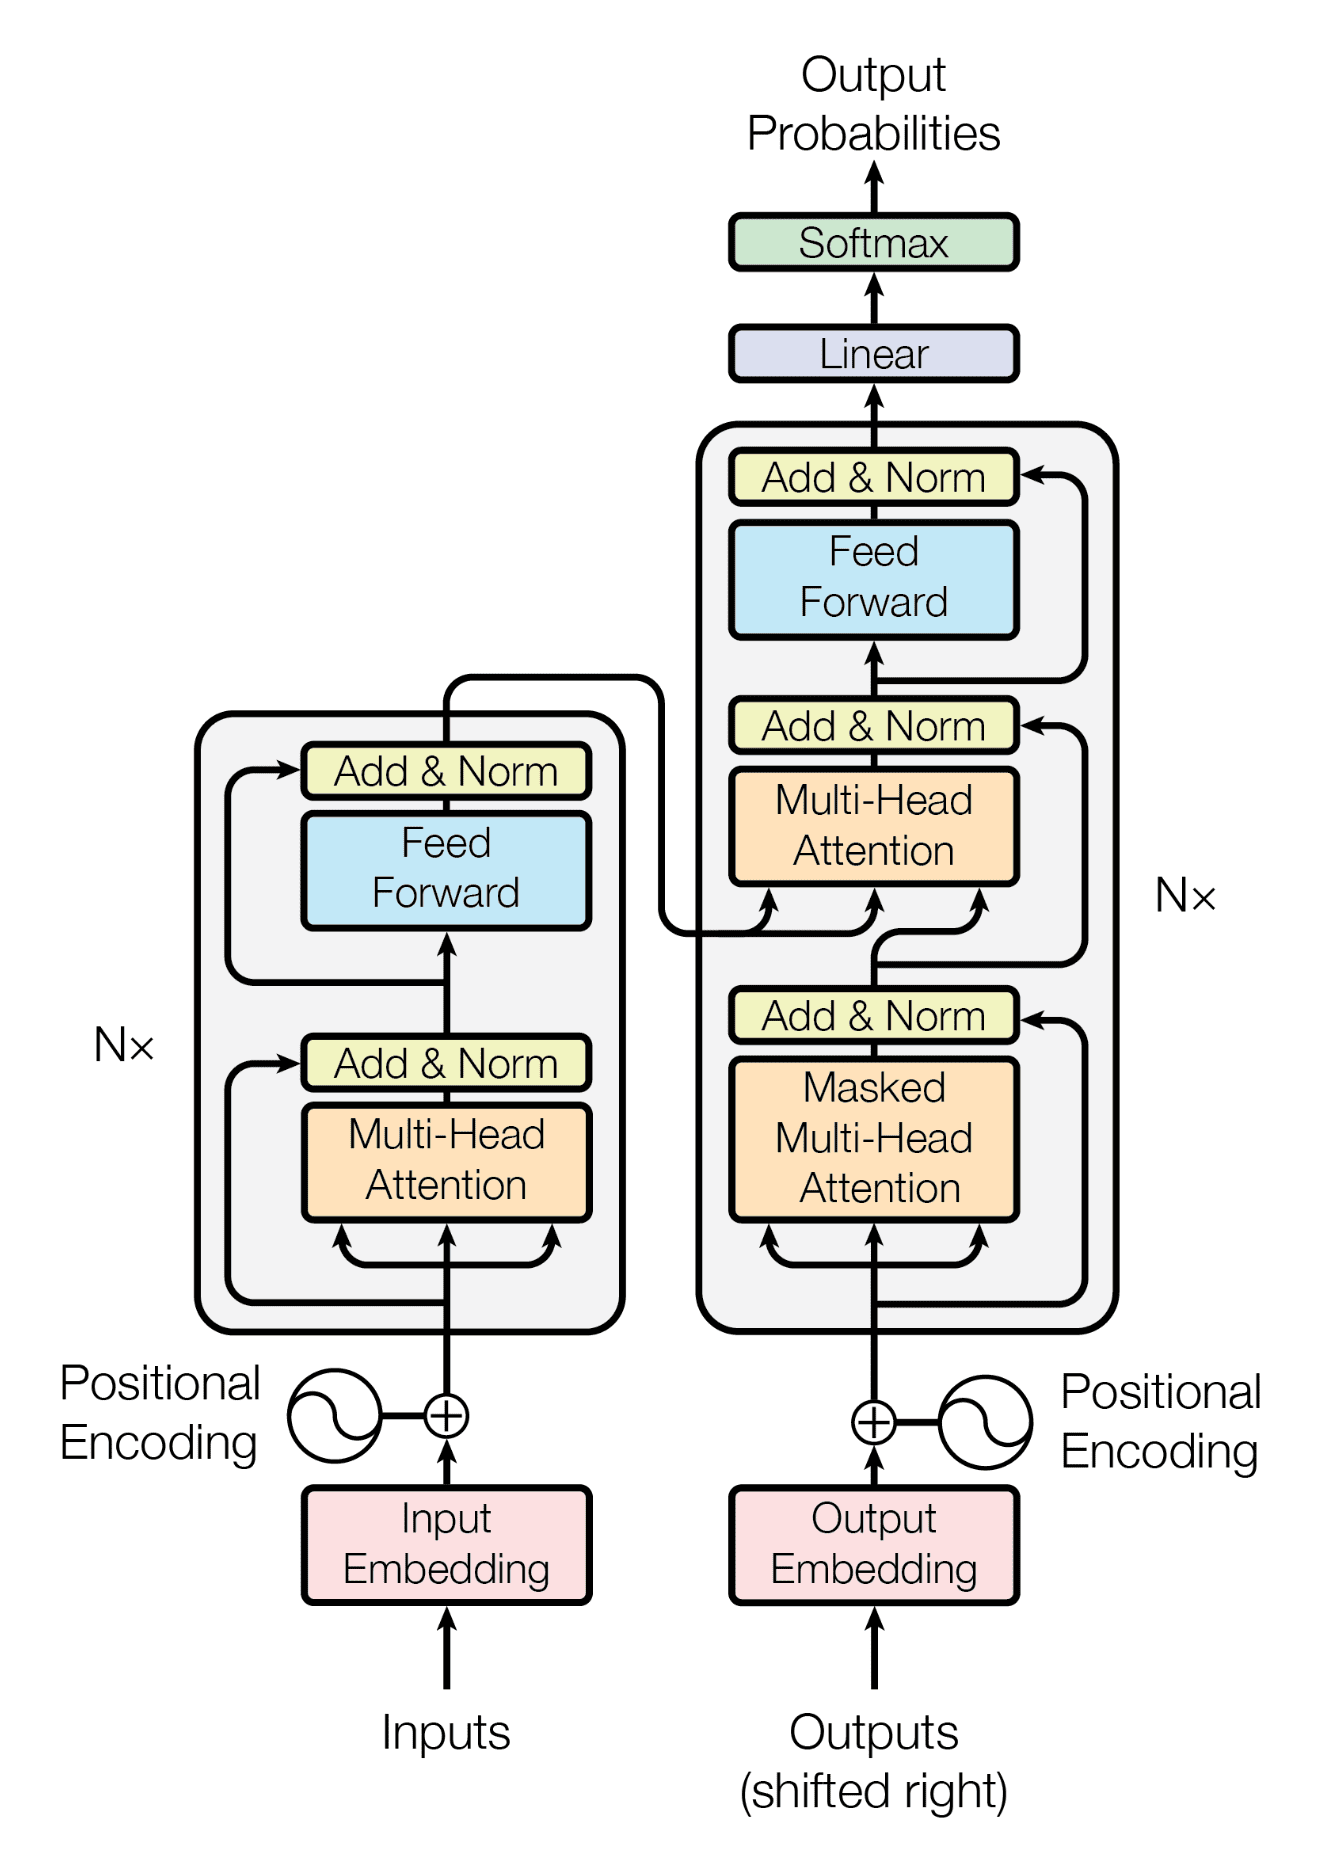
L'architecture du modèle Transformer (source)
Quelle est l'importance de l'affinage de FLAN-T5 ?
Il ne fait aucun doute que FLAN-T5 peut être utilisé pour diverses tâches de traitement du langage naturel.
Cependant, pour en tirer tout le potentiel et garantir des performances optimales pour des applications spécifiques, l'affinage est une étape essentielle. Voici les principaux points qui soulignent l'importance d'affiner FLAN-T5 :
- Affiner FLAN-T5 permet d'adapter le modèle à des tâches précises et d'améliorer ses performances sur ces tâches.
- L'affinage autorise une personnalisation du modèle pour mieux répondre aux besoins et aux données de l'utilisateur.
- La possibilité d'affiner FLAN-T5 sur des stations de travail locales avec des CPU le rend accessible à un plus large public.
- Cette accessibilité est précieuse pour les petites organisations ou les chercheurs indépendants qui n'ont pas forcément accès à des ressources GPU.
- Globalement, l'affinage de FLAN-T5 est une étape clé pour optimiser le modèle sur des cas d'usage spécifiques et maximiser ses bénéfices.
L'objectif de ce tutoriel est de proposer un guide complet pour affiner FLAN-T5 sur un scénario de questions-réponses.
Nous couvrirons un ensemble de sujets pour vous aider à comprendre et mettre en œuvre l'affinage de FLAN-T5. Nous commencerons par les bibliothèques et outils nécessaires, puis les étapes de préparation de l'environnement.
Ensuite, nous vous guiderons dans le chargement du modèle FLAN-T5 et la préparation des données pour l'affinage. Une fois les données prêtes, nous détaillerons l'entraînement et l'affinage du modèle selon vos besoins.
Enfin, nous explorerons quelques applications potentielles du modèle affiné FLAN-T5, en montrant comment l'utiliser dans divers scénarios pour de meilleures performances et des résultats plus précis.
Applications potentielles de FLAN-T5 affiné
Avant d'entrer dans l'implémentation technique, voyons quelques applications possibles de FLAN-T5 après affinage : ci-dessous, des exemples pour la synthèse de conversations, la classification de texte et FHIR (Fast Healthcare Interoperability Resources).
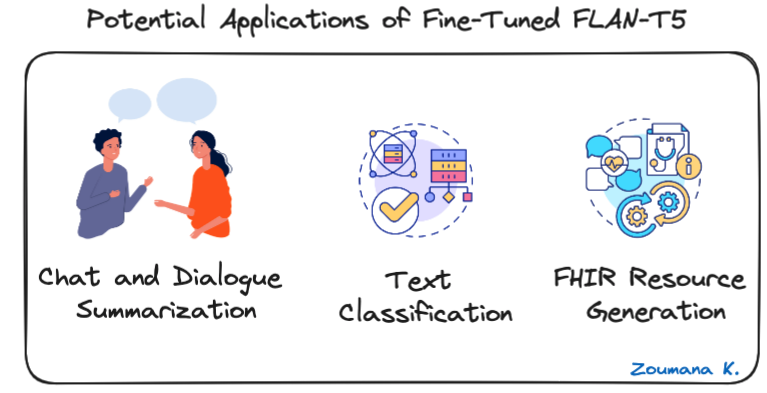
Trois applications potentielles de FLAN-T5 affiné
- Synthèse de chats et de dialogues : FLAN-T5 peut condenser des échanges pour fournir un récapitulatif rapide d'interactions de service client ou de réunions.
- Classification de texte : utile pour automatiser la catégorisation de textes en classes prédéfinies, comme l'analyse de sentiment, la détection de spam ou la modélisation de sujets.
- Génération de ressources FHIR : FLAN-T5 peut convertir du texte clinique en ressources FHIR structurées (Fast Healthcare Interoperability Resources) pour un partage et une intégration facilités dans les SI de santé.
Avant d'aborder le cœur technique de l'article, notre tutoriel Comment créer des applications LLM avec LangChain vous guide pour explorer le potentiel des grands modèles de langage avec LangChain, un framework Python open source pour construire des applications d'IA avancées.
Prérequis
Maintenant que nous avons une meilleure compréhension de FLAN-T5, voyons comment l'affiner pour un cas d'usage de questions-réponses. Le notebook complet est disponible sur GitHub.
Pour commencer, les bibliothèques et outils suivants sont requis :
- Hugging Face : une plateforme qui donne accès au modèle FLAN-T5 et facilite son téléchargement et son utilisation pour l'affinage
- Transformers : utilisé pour simplifier le chargement du modèle FLAN-T5 pré-entraîné et fournir des fonctions utiles pour l'affinage
- Datasets : une collection de jeux de données prêts à l'emploi, essentielle pour obtenir des données pertinentes d'affinage
- SentencePiece : un outil de tokenisation principalement utilisé pour de grands volumes de texte multilingue
- Tokenizers : une bibliothèque de tokenisation pour convertir le texte dans un format adapté au cas d'usage
- Evaluate : cette bibliothèque propose un large éventail de métriques d'évaluation pour s'assurer que le modèle affiné atteint le niveau de performance attendu
- ROUGE score : métrique spécifique pour évaluer la qualité du texte généré par de grands modèles de langage
- NLTK : utile pour le prétraitement des données, notamment la tokenisation et le stemming
Installation des bibliothèques
L'installation peut se faire comme suit avec pip, le gestionnaire de paquets Python, depuis un notebook Jupyter.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
La commande %%bash est utilisée dans le notebook pour exécuter la cellule comme un script bash, au lieu d'exécuter chaque commande individuellement.
Importer les bibliothèques
Après l'installation, importez chaque bibliothèque comme suit :
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Chargement du modèle FLAN-T5
Plusieurs variantes de FLAN-T5 sont disponibles sur Hugging Face, des petits aux très grands modèles : plus le modèle est grand, plus il comporte de paramètres.
Voici les différentes tailles proposées sur la fiche du modèle Hugging Face :
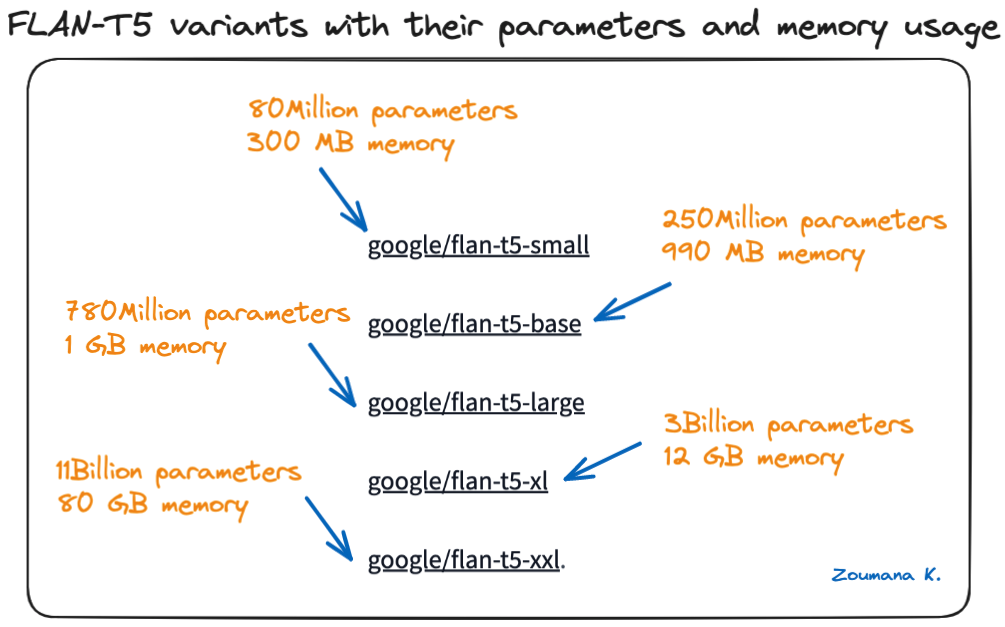
Variantes de FLAN-T5, avec nombre de paramètres et usage mémoire
Choisir la bonne taille de modèle
Le choix de la taille adéquate parmi les variantes de FLAN-T5 dépend fortement des critères suivants :
- Les exigences spécifiques du projet
- Les ressources de calcul disponibles
- Le niveau de performance attendu
Une GPU NVIDIA A100 est utilisée pour cette expérimentation, et le modèle google/flan-t5-base offre un bon compromis entre efficacité de calcul et performances.
Initialisation du modèle et du tokenizer
Les trois instructions suivantes suffisent pour créer le modèle.
# Charger le tokenizer, le modèle et le data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Le tokenizer est instancié avec le module T5Tokenizer et le nom du modèle.
- Via la fonction from_pretrained de T5ForConditionalGeneration, le modèle est chargé.
- Avec DataCollatorForSeq2Seq, un collecteur de données est créé pour la tâche de questions-réponses.
Préparer les données pour l'affinage
Avec le modèle, le tokenizer et le collecteur de données prêts, l'étape suivante consiste à charger les données d'expérimentation pour l'affinage. Nous utilisons les discussions Yahoo disponibles sur Hugging Face.
Le chargement est simple et se fait avec la fonction load_dataset, à laquelle on passe le nom du jeu de données. Ici, nous nous concentrons sur les données d'entraînement.
# Récupérer les données d'entraînement depuis Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Une fois les données chargées, elles sont scindées en ensembles d'entraînement et de test, respectivement à 70 % et 30 %, via la fonction train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)La commande suivante affiche le nombre total d'observations dans les jeux d'entraînement et de test.
# Vérifier la longueur des données et leur structure
yahoo_answers_qa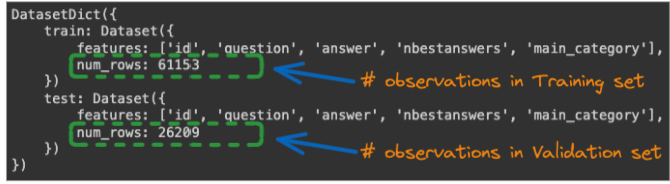
Nombre total d'observations pour les jeux d'entraînement et de validation
Mise en forme des données et tokenisation
Nous disposons d'un volume conséquent de données pour l'affinage, tant pour l'entraînement que pour le test. Mais avant cela, nous devons préparer les données au format attendu pour l'affinage.
La plupart des fonctions utilisées à l'étape suivante s'inspirent de l'article Toughdata.
En mode inférence, l'appel au modèle suivra ce format :
« Please answer this question: <USER_QUESTION> »
Où <USER_QUESTION> est la question à laquelle l'utilisateur souhaite une réponse. Pour obtenir ce comportement, nous devons formater les données d'entraînement en préfixant la tâche avec la chaîne « Please answer this question: », ce que réalise la fonction preprocess_function ci-dessous.
En plus du formatage, la fonction applique la tokenisation des entrées et sorties via le tokenizer.
# Nous préfixons nos tâches avec "answer the question"
prefix = "Please answer this question: "

# Définir la fonction de prétraitement

def preprocess_function(examples):
   """Ajouter un préfixe, tokenizer le texte et définir les labels"""
   # Les "inputs" sont les questions tokenisées :
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # Les "labels" sont les réponses tokenisées :
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Ensuite, on applique la fonction à l'ensemble du jeu de données avec map :
# Appliquer la fonction de prétraitement à tout le dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Entraînement et affinage de FLAN-T5
Avant de lancer l'entraînement, il est préférable de définir les métriques qui permettront d'évaluer les performances de l'affinage.
De bonnes métriques d'évaluation sont essentielles dans tout projet de deep learning et de machine learning, non seulement pendant l'entraînement mais aussi plus tard en production.
Deux des métriques les plus courantes pour évaluer un modèle de génération de texte sont BLEU et ROUGE, ici pour juger la qualité d'une réponse en la comparant à une réponse de référence.
Nous nous concentrons sur ROUGE dans ce tutoriel, mais cet article Wikipedia fournit plus d'informations sur le score BLEU.
Qu'est-ce que le score ROUGE ?
ROUGE signifie Recall-Oriented Understudy for Gisting Evaluation. Ses composantes clés pour la question-réponse incluent :
- ROUGE-L : mesure la plus longue sous-séquence commune entre la réponse candidate et la référence. Met l'accent sur le rappel du texte complet.
- ROUGE-1, ROUGE-2, ROUGE-SU4 : comparent les recouvrements en unigrammes, bigrammes et 4-grammes entre la candidate et la référence. Focalisés sur le rappel des éléments clés.
- Des scores ROUGE plus élevés indiquent généralement de meilleures performances en question-réponse. Des scores proches ou supérieurs à 0,70 sont considérés comme solides.
- Avec cette métrique, des traitements comme le stemming et la suppression des stopwords peuvent améliorer les performances globales.
Avec cela en tête, la fonction utilitaire compute_metrics ci-dessous permet de calculer le score ROUGE. Avant son implémentation, configurons ROUGE et NLTK.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Voici l'implémentation de la fonction.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # décoder les prédictions et labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum attend un retour à la ligne après chaque phrase
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Processus d'entraînement
Pour lancer l'affinage, nous devons définir quelques hyperparamètres, notamment :
- Taux d'apprentissage : contrôle la vitesse d'apprentissage du modèle. Des valeurs typiques vont de 1e-5 à 5e-5, et pour ce cas, la valeur est 3e-4.
- Taille de lot (batch size) : nombre total d'échantillons traités avant la mise à jour des poids du modèle. Des lots plus grands accélèrent l'entraînement mais peuvent dégrader les performances. Nous utilisons 8 ici.
- Taille de lot par périphérique (entraînement) : similaire à la taille de lot, mais spécifiée par périphérique (GPU).
- Weight decay : vise à éviter le surapprentissage. 0,01 est une valeur acceptable.
- Save total limit : nombre total de checkpoints à conserver pendant l'entraînement. Plus il y en a, plus il est facile de revenir en arrière, mais cela consomme plus d'espace disque. Nous en conservons 3.
- Nombre d'époques : nombre total de passages sur le jeu d'entraînement. Plus il y en a, plus l'entraînement est long, avec un gain potentiel de performance. On choisit généralement entre 3 et 10 ; nous utilisons 3 ici.
Les paramètres ci-dessus sont définis ci-dessous et utilisés pour configurer les arguments d'entraînement. Tous les artéfacts d'entraînement sont enregistrés dans le dossier results :
# Paramètres globaux
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Définir les arguments d'entraînement
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Ensuite, on configure le trainer pour déclencher l'entraînement du modèle.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Enfin, l'entraînement est lancé avec la fonction train :
trainer.train()Après près de quatre heures, les performances obtenues à chaque époque sont présentées ci-dessous.
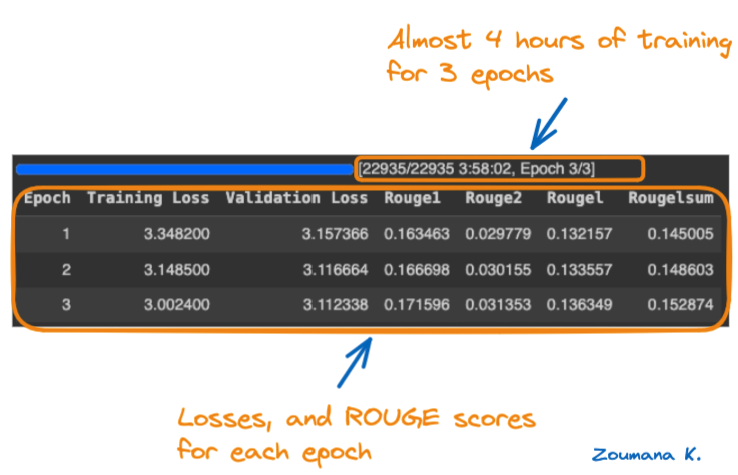
Époques d'entraînement et scores de performance correspondants
Décryptons ces métriques de performance.
- Perte d'entraînement et perte de validation : des valeurs plus faibles sont préférables, elles indiquent un meilleur ajustement du modèle. Les pertes d'entraînement et de validation diminuent au fil des époques, avec des minima à l'époque 3.
- Métriques ROUGE (ROUGE-1, ROUGE-2, ROUGE-L et ROUGE-Lsum) : des valeurs plus élevées sont souhaitables, synonymes de meilleure performance de synthèse. Toutes progressent au fil des époques, avec des maxima à l'époque 3.
Globalement, le modèle se comporte le mieux à la troisième époque, avec les pertes les plus basses et les meilleurs scores ROUGE. Ci-dessous, le contenu du dossier results avec tous les checkpoints :
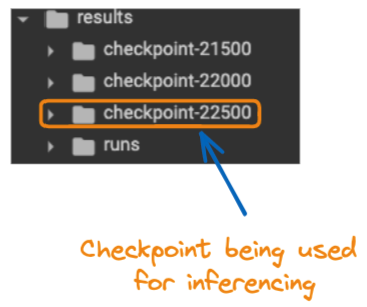
Contenu du dossier « results »
Inférence du modèle
Maintenant que le modèle a été affiné, pourquoi ne pas l'appliquer à un cas réel ?
C'est tout l'objet de l'inférence : utiliser un modèle existant pour résoudre un problème concret, ici avec notre modèle affiné.
Avant cela, quelques étapes s'imposent :
- Charger le modèle affiné au dernier checkpoint
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Définir une question précise à laquelle répondre
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Lancer la prédiction
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Ci-dessous, le résultat du modèle affiné : il est plutôt convaincant. La méthode fill du module textwrap est utilisée pour limiter le texte à 80 caractères par ligne, au lieu d'un seul bloc.

Réponse du modèle affiné à la question
Conclusion et prochaines étapes
Cet article a proposé un guide complet pour affiner un modèle FLAN-T5. Nous avons d'abord présenté le modèle et ses cas d'usage, puis parcouru l'implémentation technique de bout en bout : chargement des données d'expérimentation et du modèle via Hugging Face jusqu'à l'entraînement sur GPU. Le meilleur modèle, selon les scores ROUGE, a ensuite été testé sur un cas réel.
Et maintenant ?
Nos articles 12 alternatives open source à GPT-4 et Comment entraîner un LLM avec PyTorch constituent une excellente suite pour votre montée en compétences. Le premier met en avant des alternatives open source à GPT-4 offrant des performances comparables et nécessitant moins de ressources. Ces projets incluent instructions, code source, poids de modèles, jeux de données et interfaces de chatbot.
Le second vous aide à maîtriser l'entraînement de grands modèles de langage avec PyTorch, de la configuration initiale à la mise en production. Développez vos compétences avec ce framework de deep learning plébiscité par les professionnels de l'IA. Rejoignez dès aujourd'hui le cours Deep Learning with PyTorch.