FLAN-T5 là gì?
FLAN-T5 là một mô hình ngôn ngữ lớn mã nguồn mở theo kiến trúc sequence-to-sequence, có thể sử dụng cho mục đích thương mại. Mô hình được các nhà nghiên cứu Google công bố vào cuối năm 2022 và đã được tinh chỉnh trên nhiều tác vụ.
Mô hình T5 chuyển nhiều tác vụ khác nhau về định dạng văn bản-đến-văn bản, như dịch thuật, khả năng chấp nhận ngôn ngữ, độ tương đồng câu, và tóm tắt tài liệu, như minh họa bên dưới:
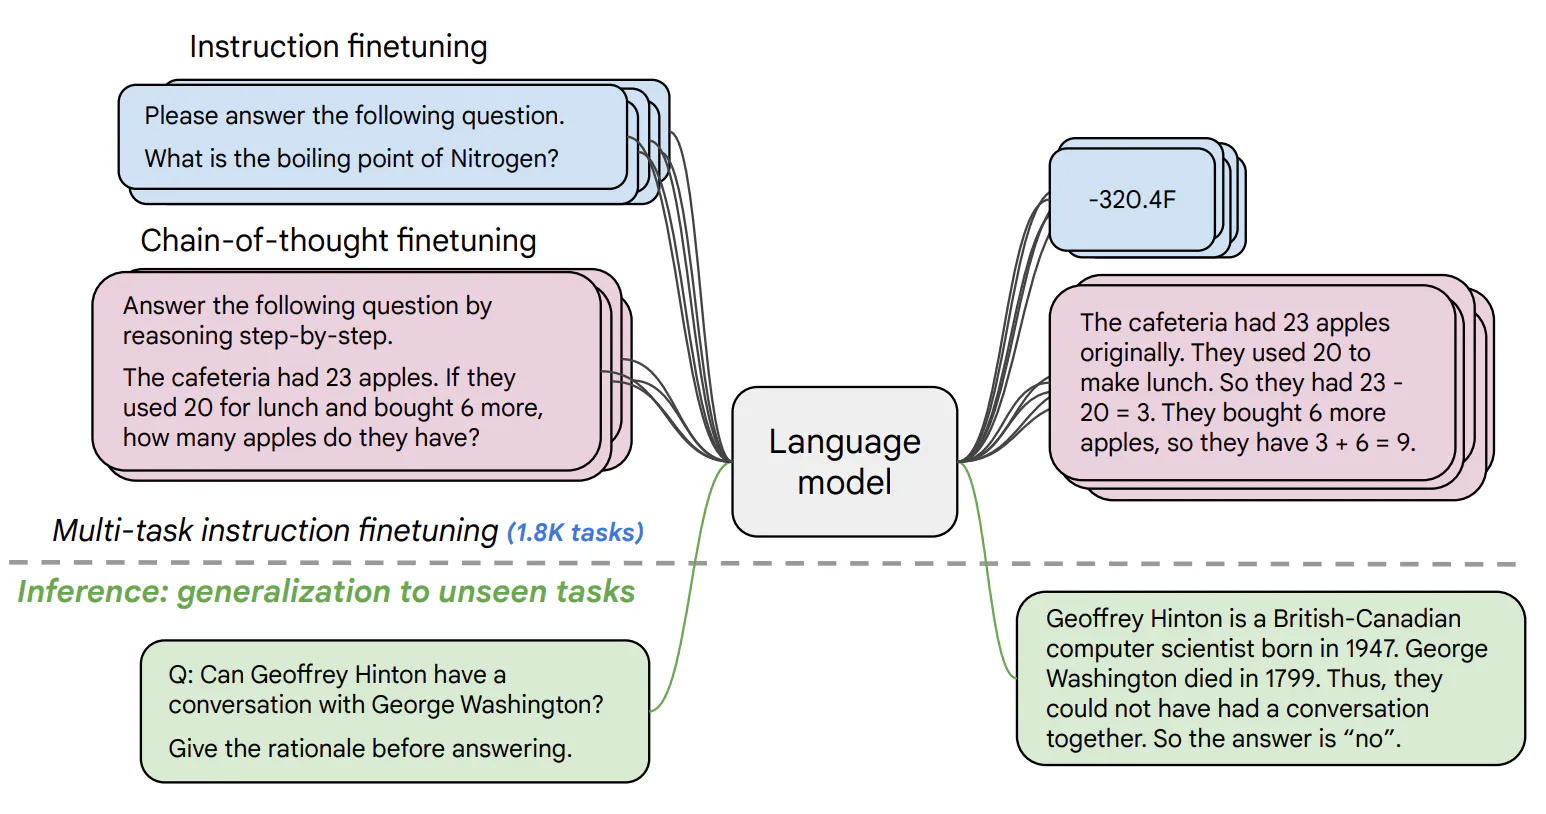
Ví dụ về cách T5 chuyển nhiều tác vụ về khung văn bản-đến-văn bản (nguồn)
Tương tự, kiến trúc của T5 bám sát cấu trúc encoder-decoder được sử dụng trong bài báo Transformer gốc. Khác biệt chủ yếu nằm ở kích thước và bản chất dữ liệu huấn luyện; T5 được huấn luyện trên kho văn bản khổng lồ 750GB có tên Colossal Clean Crawled Corpus (C4).
Trong khi đó, Transformer gốc được thiết kế riêng cho dịch ngôn ngữ và do đó được huấn luyện trên bộ dữ liệu gồm 1,4 GB cặp câu Anh-Đức.
Bài viết Nhập môn Transformers và Hugging Face của chúng tôi hướng dẫn bạn hiểu về transformers và khai thác sức mạnh của chúng để giải quyết các bài toán thực tế.
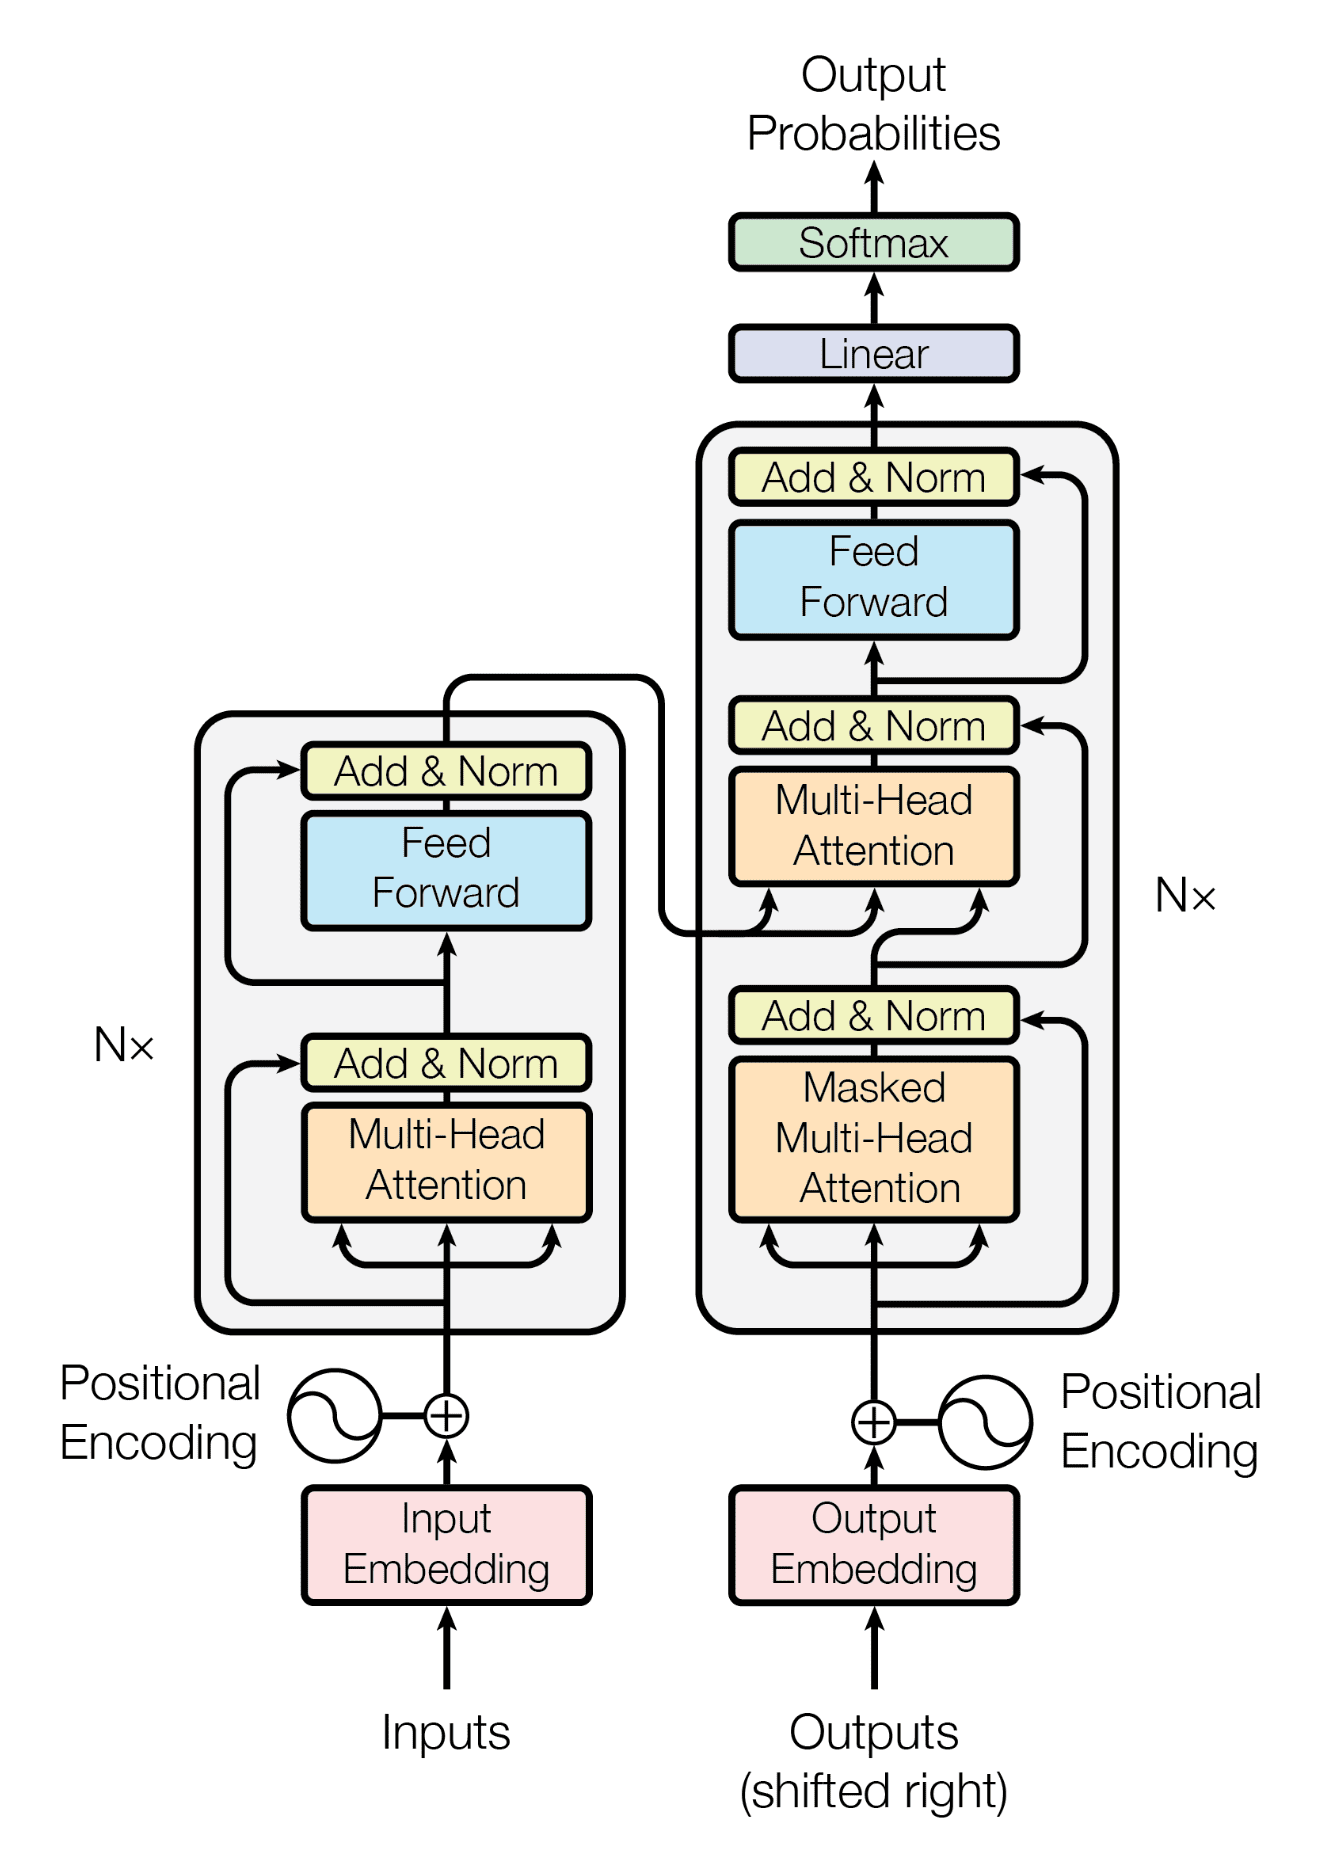
Kiến trúc mô hình Transformer (nguồn)
Tinh chỉnh FLAN-T5 quan trọng thế nào?
Không nghi ngờ gì, FLAN-T5 có thể dùng cho nhiều tác vụ Xử lý ngôn ngữ tự nhiên.
Tuy nhiên, để khai thác hết tiềm năng và đảm bảo hiệu năng tối ưu cho ứng dụng cụ thể, tinh chỉnh là bước quan trọng. Dưới đây là các điểm chính nêu bật tầm quan trọng của việc tinh chỉnh FLAN-T5:
- Tinh chỉnh FLAN-T5 giúp thích ứng mô hình với tác vụ cụ thể và cải thiện hiệu suất trên các tác vụ đó.
- Tinh chỉnh cho phép tùy biến mô hình để phù hợp hơn với nhu cầu và dữ liệu của người dùng.
- Khả năng tinh chỉnh FLAN-T5 trên máy trạm cục bộ chỉ với CPU giúp nhiều đối tượng người dùng tiếp cận hơn.
- Tính dễ tiếp cận này có lợi cho các tổ chức nhỏ hoặc nhà nghiên cứu cá nhân không có GPU.
- Tựu trung, tinh chỉnh FLAN-T5 là bước giá trị để tối ưu mô hình cho các trường hợp sử dụng cụ thể và tối đa hóa lợi ích.
Mục tiêu của hướng dẫn này là cung cấp cẩm nang hoàn chỉnh để tinh chỉnh FLAN-T5 cho kịch bản hỏi đáp.
Trong hướng dẫn này, chúng ta sẽ đi qua nhiều chủ đề để giúp bạn hiểu và triển khai tinh chỉnh cho FLAN-T5. Trước tiên, chúng ta thảo luận các thư viện và công cụ cần thiết cho quy trình này, sau đó là các bước thiết lập môi trường để tinh chỉnh.
Tiếp theo, chúng tôi hướng dẫn bạn quy trình tải mô hình FLAN-T5 và chuẩn bị dữ liệu cho tinh chỉnh. Khi dữ liệu đã sẵn sàng, chúng tôi sẽ đi qua các bước huấn luyện và tinh chỉnh mô hình để đáp ứng nhu cầu cụ thể của bạn.
Cuối cùng, chúng ta sẽ khám phá một số ứng dụng tiềm năng của mô hình FLAN-T5 đã tinh chỉnh, minh họa cách sử dụng trong nhiều tình huống để đạt hiệu năng tốt hơn và kết quả chính xác hơn.
Ứng dụng tiềm năng của FLAN-T5 đã tinh chỉnh
Trước khi đi vào triển khai kỹ thuật, hãy cùng điểm qua một số ứng dụng tiềm năng của FLAN-T5 đã tinh chỉnh, dưới đây là ví dụ về tóm tắt hội thoại, phân loại văn bản và Fast Healthcare Interoperability Resources (FHIR).
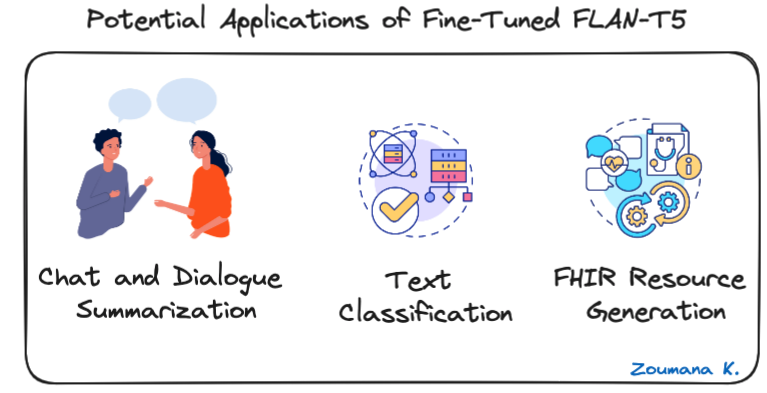
Ba ứng dụng tiềm năng của FLAN-T5 đã tinh chỉnh
- Tóm tắt trò chuyện và đối thoại: FLAN-T5 có thể cô đọng hội thoại, cung cấp phần tóm lược nhanh cho tương tác dịch vụ khách hàng hoặc cuộc họp kinh doanh.
- Phân loại văn bản: hữu ích để tự động phân loại văn bản vào các nhóm định sẵn, như phân tích cảm xúc, phát hiện spam hoặc phân chủ đề.
- Tạo tài nguyên FHIR: FLAN-T5 có thể chuyển văn bản lâm sàng thành FHIR (Fast Healthcare Interoperability Resources) có cấu trúc để dễ chia sẻ và tích hợp vào hệ thống y tế.
Trước khi đào sâu các khía cạnh kỹ thuật cốt lõi, hướng dẫn Cách xây dựng ứng dụng LLM với LangChain của chúng tôi giúp bạn khám phá tiềm năng còn bỏ ngỏ của các mô hình ngôn ngữ lớn với LangChain, một framework Python mã nguồn mở để xây dựng ứng dụng AI nâng cao.
Điều kiện tiên quyết
Giờ đây khi đã hiểu rõ hơn về FLAN-T5, hãy xem cách tinh chỉnh nó cho bài toán hỏi đáp; toàn bộ notebook có trên GitHub.
Để bắt đầu, cần các thư viện và công cụ sau:
- Hugging Face: Nền tảng cung cấp quyền truy cập mô hình FLAN-T5, hỗ trợ tải về và sử dụng để tinh chỉnh
- Transformers: Dùng để đơn giản hóa việc tải mô hình FLAN-T5 đã huấn luyện và cung cấp các hàm hữu ích để tinh chỉnh
- Datasets: bộ sưu tập các bộ dữ liệu sẵn dùng, thiết yếu để lấy dữ liệu liên quan cho tinh chỉnh
- Sentencepiece: công cụ tách từ chủ yếu để xử lý dữ liệu văn bản lớn và đa ngôn ngữ
- Tokenizers: thư viện tách từ để chuyển văn bản sang định dạng phù hợp với trường hợp sử dụng
- Evaluate: Thư viện cung cấp nhiều thước đo đánh giá mô hình, đảm bảo mô hình đã tinh chỉnh đạt chuẩn hiệu năng mong muốn
- Rouge score: thước đo cụ thể để đánh giá chất lượng văn bản do mô hình ngôn ngữ lớn sinh ra
- NLTK: hữu ích cho các bước tiền xử lý dữ liệu như tách từ và stemming
Cài đặt các thư viện
Việc cài đặt có thể thực hiện như sau bằng pip, trình quản lý gói Python, từ Jupyter notebook.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
Lệnh %%bash được dùng trong notebook để chạy ô tương ứng như một script bash thay vì chạy từng lệnh riêng lẻ.
Import thư viện
Sau khi cài đặt tất cả thư viện, chúng ta có thể import từng thư viện như sau:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Tải mô hình FLAN-T5
Có nhiều phiên bản FLAN-T5 trên Hugging Face, từ nhỏ đến cực lớn, và mô hình càng lớn thì càng có nhiều tham số.
Dưới đây là các kích thước mô hình khác nhau từ thẻ mô hình trên Hugging Face:
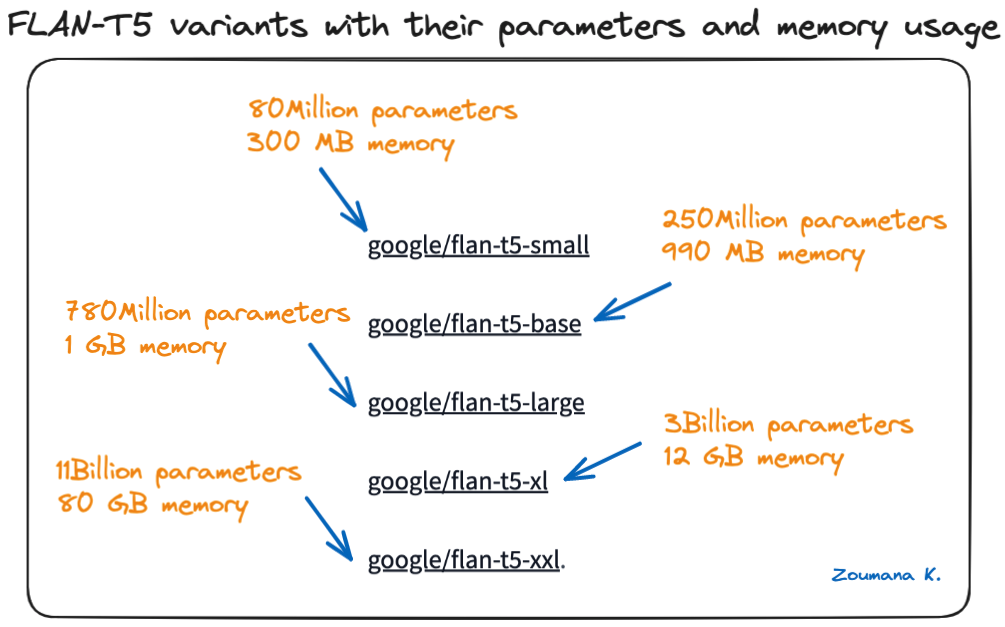
Các biến thể FLAN-T5 với số tham số và mức sử dụng bộ nhớ
Chọn kích thước mô hình phù hợp
Việc chọn kích thước mô hình phù hợp trong các biến thể FLAN-T5 phụ thuộc nhiều vào các tiêu chí sau:
- Yêu cầu cụ thể của dự án
- Tài nguyên tính toán sẵn có
- Mức hiệu năng kỳ vọng
Một GPU NVIDIA A100 được sử dụng cho thử nghiệm này, và mô hình google/flan-t5-base sẽ cân bằng giữa hiệu quả tính toán và khả năng đáp ứng hiệu năng.
Khởi tạo mô hình và Tokenizer
Cần ba câu lệnh sau để tạo mô hình.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Tokenizer được khởi tạo bằng mô-đun T5Tokenizer và tên mô hình
- Sử dụng hàm from_pretrained từ T5ForConditionalGeneration để tải mô hình
- Với DataCollectorForSeq2Seq, tạo một bộ gom dữ liệu để dùng cho tác vụ hỏi đáp
Chuẩn bị dữ liệu để tinh chỉnh
Khi đã có mô hình, tokenizer và bộ gom dữ liệu, bước tiếp theo là tải dữ liệu thử nghiệm cho tinh chỉnh; dữ liệu được dùng là dữ liệu thảo luận Yahoo có trên Hugging Face.
Quy trình tải dữ liệu khá đơn giản và có thể thực hiện bằng hàm load_dataset, hàm này nhận tên bộ dữ liệu làm tham số. Trong trường hợp này, tập trung vào dữ liệu huấn luyện.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Sau khi lấy dữ liệu, ta chia thành tập huấn luyện và tập kiểm tra lần lượt theo tỷ lệ 70% và 30%, sử dụng hàm train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)Câu lệnh sau hiển thị tổng số quan sát ở cả dữ liệu huấn luyện và kiểm tra.
# Check the length of the data and its structure
yahoo_answers_qa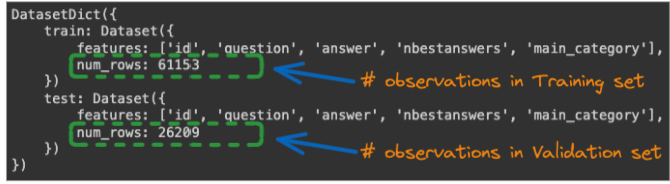
Tổng số quan sát của cả tập huấn luyện và tập xác thực
Định dạng dữ liệu và tách từ
Chúng ta có lượng dữ liệu đáng kể ở cả tập huấn luyện và kiểm tra cho quá trình tinh chỉnh. Tuy nhiên, trước đó cần xử lý dữ liệu để phù hợp với định dạng tinh chỉnh.
Hầu hết các hàm dùng cho bước tiếp theo được lấy cảm hứng từ bài viết Toughdata.
Trong chế độ suy luận, quá trình gọi mô hình sẽ theo định dạng sau:
“Please answer this question: <USER_QUESTION>”
Trong đó <USER_QUESTION> là câu hỏi người dùng muốn có câu trả lời. Để đạt được chức năng này, ta cần định dạng dữ liệu huấn luyện bằng cách thêm tiền tố tác vụ với chuỗi “Please answer this question,” và việc này được thực hiện bằng hàm preprocess_function dưới đây.
Ngoài việc định dạng, hàm cũng áp dụng tách từ cho đầu vào và đầu ra bằng hàm tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Tiếp theo, áp dụng hàm cho toàn bộ tập dữ liệu bằng hàm map dưới đây:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Huấn luyện và tinh chỉnh FLAN-T5
Trước khi đi vào quá trình huấn luyện, tốt hơn hết là xác định các thước đo để đánh giá hiệu năng tổng thể của việc tinh chỉnh.
Các thước đo đánh giá tốt là quan trọng trong mọi dự án học sâu và học máy để đánh giá hiệu năng mô hình, không chỉ trong huấn luyện mà cả khi đưa vào sản xuất.
Hai thước đo phổ biến để đánh giá hiệu năng mô hình sinh văn bản là BLEU và ROUGE, và trong trường hợp này dùng để đánh giá chất lượng câu trả lời bằng cách so với câu trả lời tham chiếu.
Trọng tâm của hướng dẫn này là ROUGE, còn bài Wikipedia này cung cấp thêm thông tin về điểm BLEU.
ROUGE là gì?
ROUGE là viết tắt của Recall-Oriented Understudy for Gisting Evaluation. Một số thành phần chính của ROUGE cho hỏi đáp bao gồm:
- ROUGE-L: Đo dãy con chung dài nhất giữa câu trả lời ứng viên và tham chiếu. Tập trung vào khả năng bao quát (recall) toàn văn bản.
- ROUGE-1, ROUGE-2, ROUGE-SU4: So sánh mức trùng lặp unigram, bigram, 4-gram giữa ứng viên và tham chiếu. Tập trung vào khả năng bao quát các phần/khối quan trọng
- Điểm ROUGE cao hơn thường cho thấy hiệu năng hỏi đáp tốt hơn. Điểm gần hoặc trên 0,70+ được xem là mạnh
- Khi dùng thước đo này, các bước xử lý như stemming và loại bỏ stopword có thể giúp cải thiện hiệu năng tổng thể
Với hiểu biết này, hàm trợ giúp compute_metrics dưới đây có thể tính điểm ROUGE. Trước khi triển khai hàm, cần thiết lập ROUGE và NLTK.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Dưới đây là triển khai hàm.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Quy trình huấn luyện
Để bắt đầu tinh chỉnh, chúng ta cần đặt một số siêu tham số, dưới đây là những tham số chính:
- Tốc độ học (Learning rate): điều khiển tốc độ mô hình học từ dữ liệu, giá trị điển hình là 1e-5 đến 5e-5, và trong trường hợp này đặt là 3e-4
- Kích thước batch: tổng số mẫu được xử lý trước khi cập nhật trọng số mô hình. Dùng batch lớn có thể tăng tốc, nhưng có thể làm giảm hiệu năng. Chúng tôi dùng 8 cho trường hợp này
- Per device train batch size: tương tự kích thước batch, nhưng chỉ định theo từng thiết bị (GPU)
- Weight decay: mục tiêu là ngăn mô hình quá khớp. 0,01 là giá trị chấp nhận được cho trọng số này
- Save total limit: tổng số checkpoint sẽ được lưu trong quá trình huấn luyện. Lưu càng nhiều thì khả năng quay lui càng cao nhưng tốn dung lượng. Ở đây chúng tôi lưu 3 lần
- Số epoch: tổng số lượt đi qua tập huấn luyện. Nhiều epoch hơn thì thời gian huấn luyện dài hơn nhưng có thể cải thiện hiệu năng. Thường chọn từ 3 đến 10, và ở đây dùng 3.
Các tham số trên được định nghĩa dưới đây, dùng để thiết lập đối số huấn luyện mô hình, và các artefact huấn luyện được lưu trong thư mục results:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Tiếp theo, thiết lập trainer để kích hoạt quá trình huấn luyện mô hình.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Cuối cùng, kích hoạt huấn luyện mô hình bằng hàm train như sau:
trainer.train()Sau gần bốn giờ, hiệu năng tổng thể của quá trình huấn luyện cho mỗi epoch được cung cấp dưới đây.
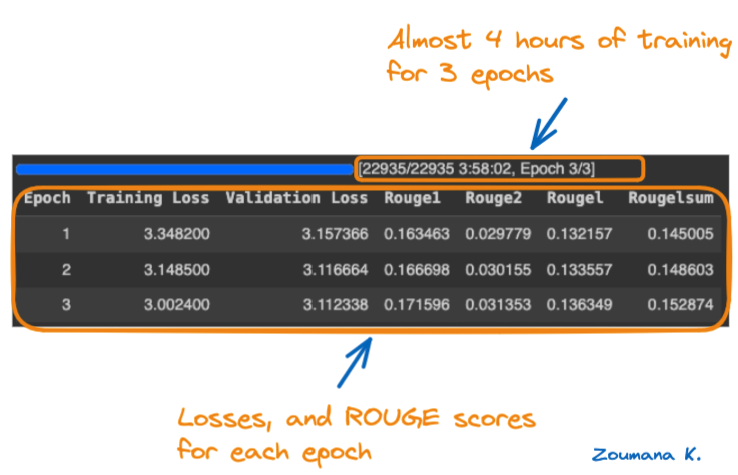
Các epoch huấn luyện và điểm hiệu năng tương ứng
Hãy cùng hiểu bảng chỉ số hiệu năng ở trên.
- Training Loss và Validation Loss: Giá trị thấp hơn là tốt hơn vì cho thấy mô hình khớp dữ liệu tốt hơn. Training và validation loss giảm dần qua các epoch, với giá trị thấp nhất ở epoch 3.
- Các thước đo Rouge (Rouge1, Rouge2, Rougel và Rougelsum): Giá trị cao hơn là tốt hơn vì cho thấy hiệu năng tóm tắt văn bản tốt hơn. Ở cả bốn thước đo Rouge, giá trị tăng dần qua các epoch, đạt cao nhất ở epoch 3.
Nhìn chung, mô hình thể hiện tốt ở epoch thứ ba, khi có training loss và validation loss thấp nhất, cùng với giá trị cao nhất ở tất cả thước đo ROUGE. Dưới đây là nội dung thư mục results với tất cả checkpoint:
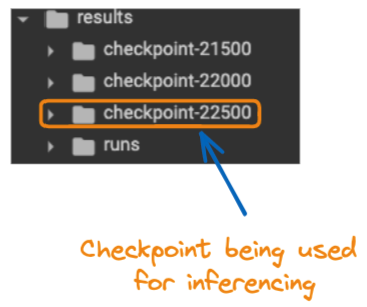
Nội dung thư mục “results”
Suy luận mô hình
Giờ mô hình đã được tinh chỉnh, sẽ thật tuyệt nếu áp dụng vào kịch bản đời thực?
Đó chính là mục đích của suy luận mô hình. Dùng mô hình hiện có để giải quyết bài toán thực tế, và đó là điều chúng ta làm với mô hình đã tinh chỉnh.
Trước đó, cần thực hiện vài bước:
- Tải mô hình đã tinh chỉnh ở checkpoint cuối
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Xác định một câu hỏi cụ thể để trả lời
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Chạy dự đoán
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Dưới đây là kết quả của mô hình đã tinh chỉnh, và trông khá ổn. Phương thức fill từ textwrap được dùng để giới hạn tối đa 80 ký tự mỗi dòng, thay vì in toàn bộ chuỗi trên một dòng.

Phản hồi của mô hình đã tinh chỉnh cho câu hỏi
Kết luận và bước tiếp theo
Bài viết này đã cung cấp hướng dẫn hoàn chỉnh để tinh chỉnh mô hình FLAN-T5. Trước tiên, bài viết giúp người đọc hiểu rõ hơn về mô hình và các trường hợp sử dụng tiềm năng, sau đó đi qua toàn bộ triển khai kỹ thuật, từ tải dữ liệu thử nghiệm và mô hình từ Hugging Face đến huấn luyện mô hình trên GPU. Mô hình tốt nhất theo điểm ROUGE được kiểm thử trên kịch bản thực tế
Tiếp theo nên làm gì?
Các bài viết 12 lựa chọn thay thế GPT-4 mã nguồn mở và Cách huấn luyện LLM với PyTorch có thể là bước tiếp theo tuyệt vời để nâng cao kỹ năng. Bài đầu nêu bật các lựa chọn thay thế GPT-4 mã nguồn mở có thể mang lại hiệu năng tương tự và cần ít tài nguyên tính toán hơn để chạy. Các dự án này đi kèm hướng dẫn, mã nguồn, trọng số mô hình, bộ dữ liệu và giao diện chatbot.
Bài thứ hai giúp bạn nắm vững quy trình huấn luyện mô hình ngôn ngữ lớn bằng PyTorch, từ thiết lập ban đầu đến triển khai cuối cùng. Bạn cũng có thể nâng cao kỹ năng với framework học sâu mạnh mẽ được các chuyên gia AI sử dụng. Tham gia khóa Deep Learning với PyTorch ngay hôm nay.
