
Was ist FLAN-T5?
FLAN-T5 ist ein Open-Source-Sprachmodell im Sequence-to-Sequence-Format, das auch kommerziell genutzt werden kann. Das Modell wurde Ende 2022 von Google-Forschenden veröffentlicht und auf eine Vielzahl von Aufgaben feinabgestimmt.
Das T5-Modell bildet unterschiedliche Aufgaben in ein Text-zu-Text-Format ab, etwa Übersetzung, linguistische Akzeptabilität, Satzähnlichkeit und Textzusammenfassung – wie unten gezeigt:
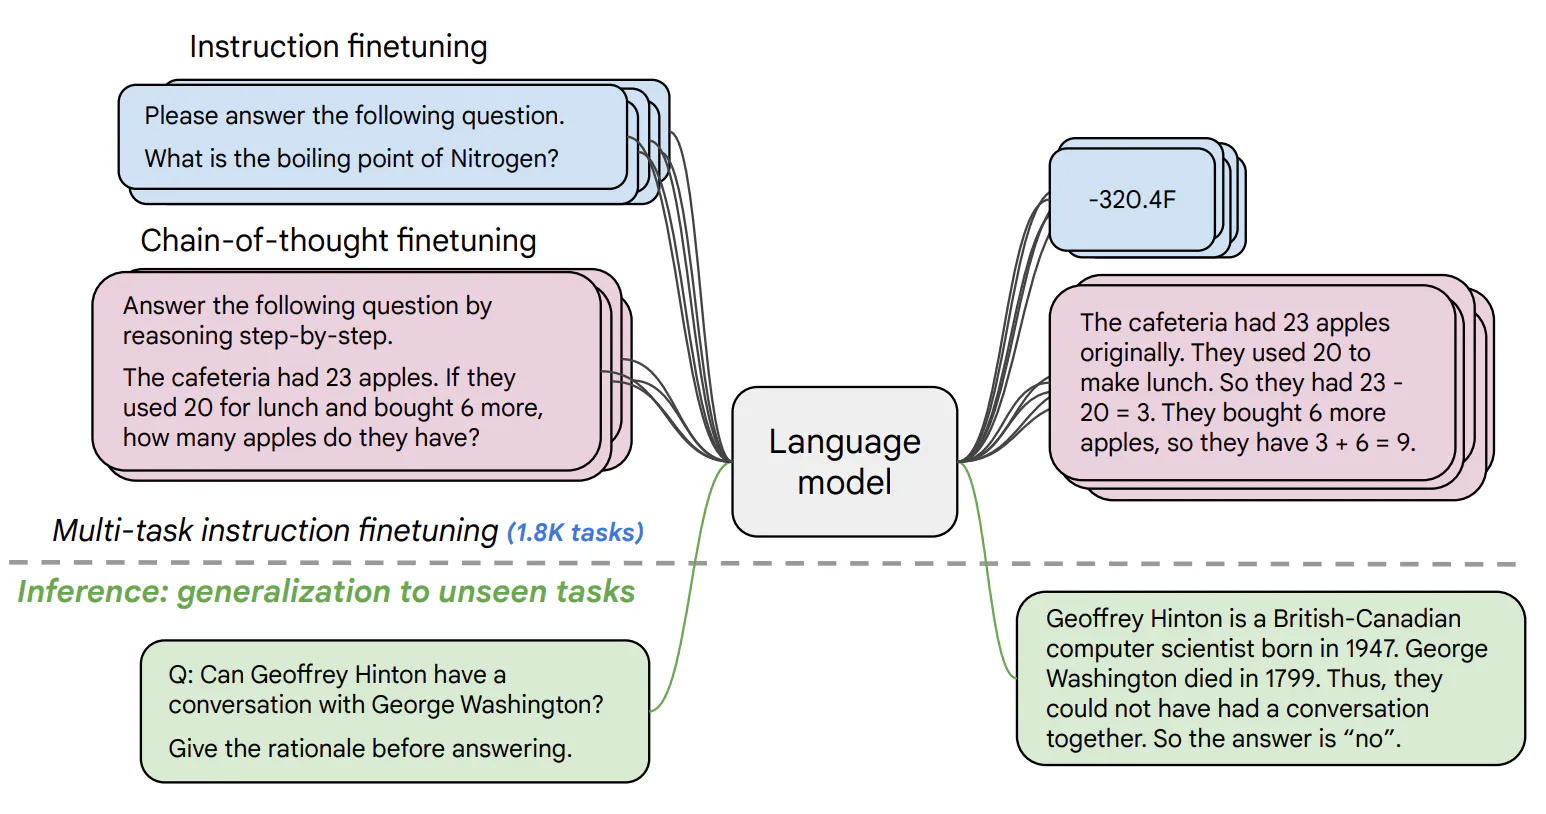
Beispiele dafür, wie T5 verschiedenste Aufgaben ins Text-zu-Text-Framework überführt (Quelle)
Auch die Architektur von T5 orientiert sich eng an der Encoder-Decoder-Struktur aus dem ursprünglichen Transformer-Paper. Der größte Unterschied liegt in Umfang und Art der Trainingsdaten: T5 wurde auf dem 750-GB-Korpus Colossal Clean Crawled Corpus (C4) trainiert.
Der originale Transformer hingegen wurde speziell für maschinelle Übersetzung entwickelt und auf 1,4 GB englisch-deutschen Satzpaaren trainiert.
Unser Artikel An Introduction to Using Transformers and Hugging Face hilft dir, Transformer zu verstehen und für reale Anwendungsfälle zu nutzen.
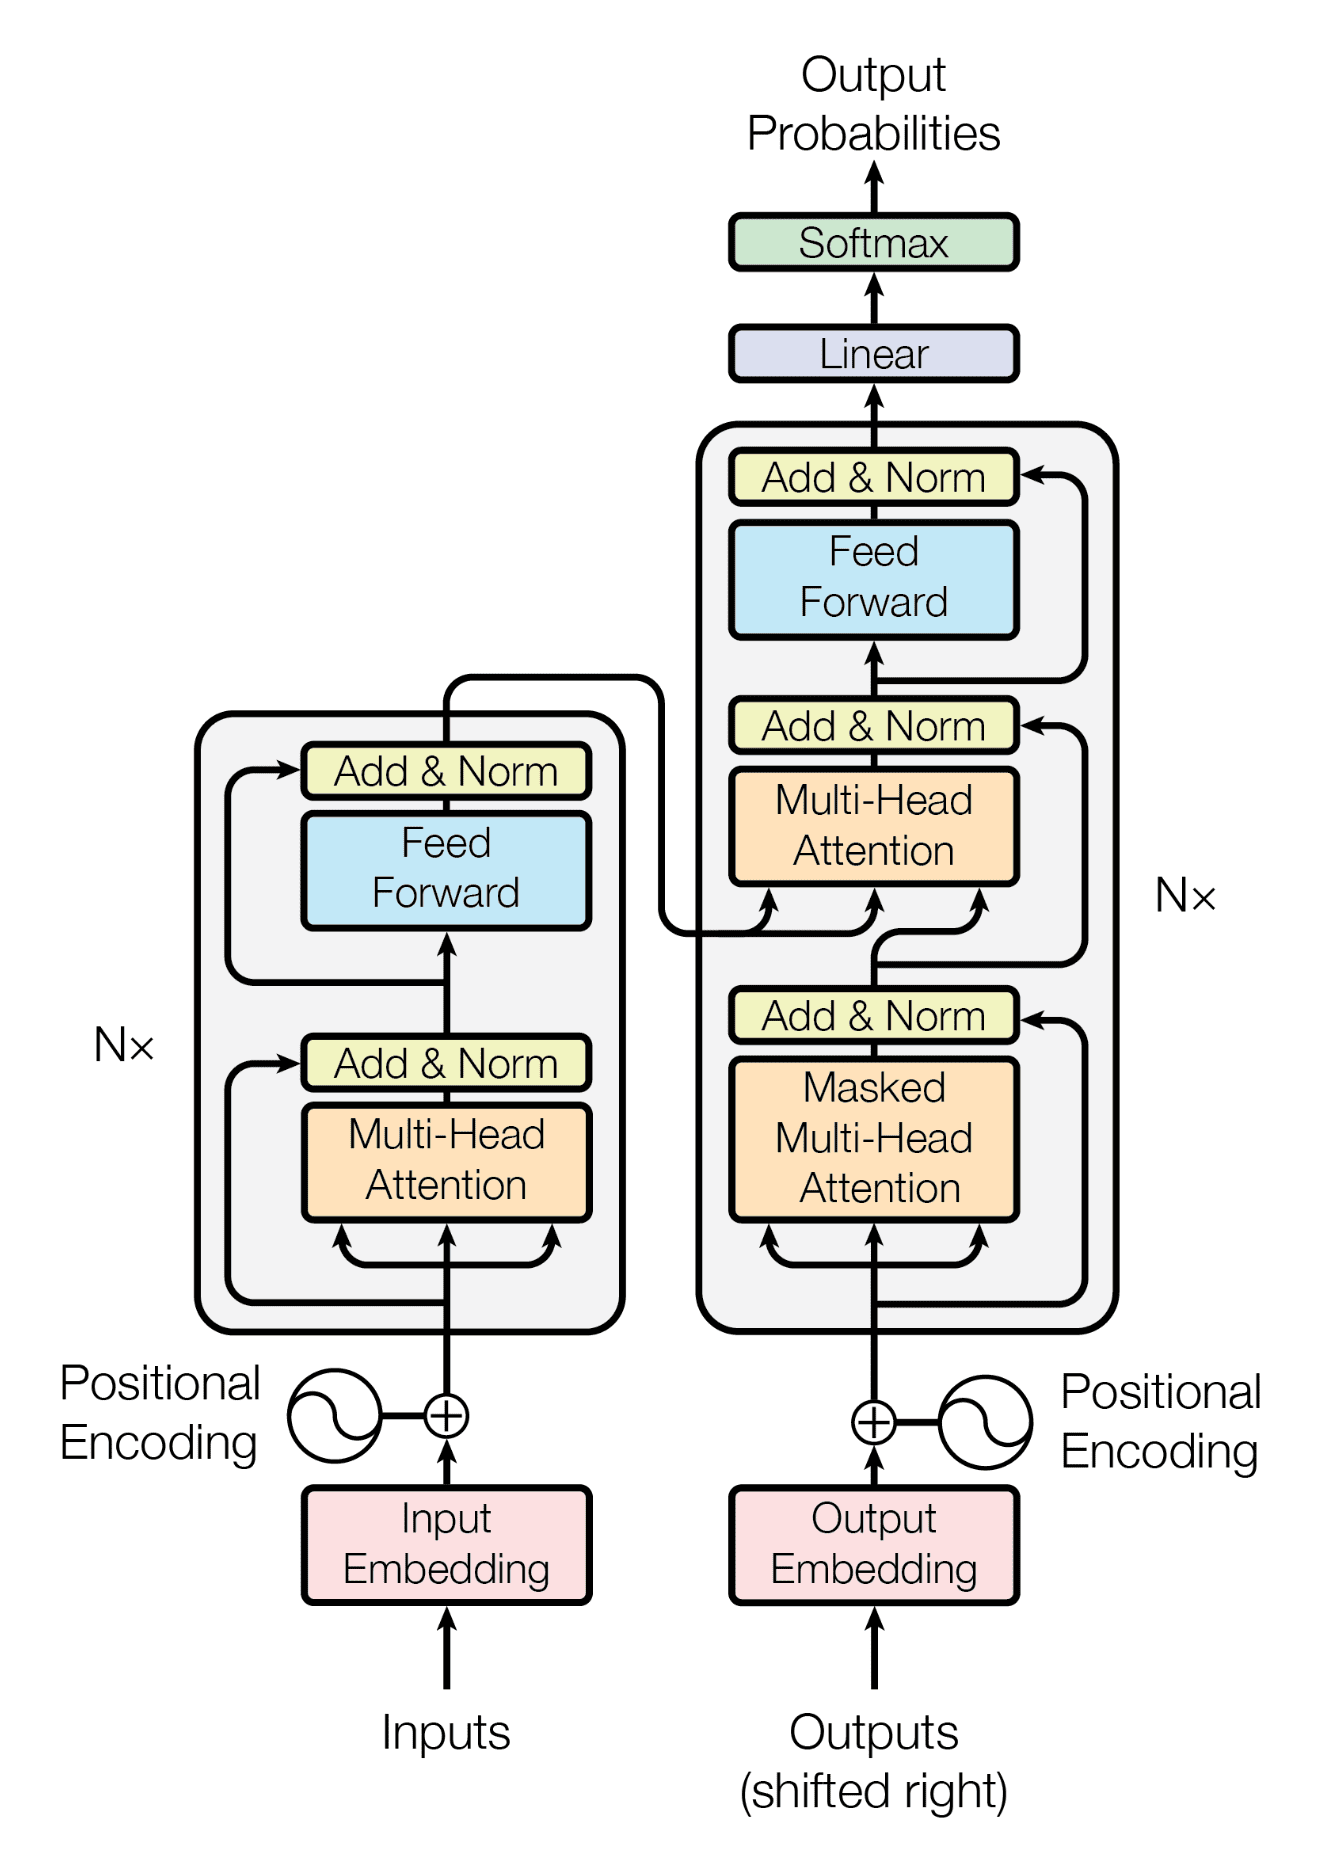
Die Architektur des Transformer-Modells (Quelle)
Wie wichtig ist das Fine-Tuning von FLAN-T5?
Es besteht kein Zweifel, dass sich FLAN-T5 für zahlreiche NLP-Aufgaben einsetzen lässt.
Um sein volles Potenzial auszuschöpfen und für spezifische Anwendungen optimale Ergebnisse zu erzielen, ist Fine-Tuning jedoch entscheidend. Hier die wichtigsten Punkte, die die Bedeutung des Fine-Tunings von FLAN-T5 unterstreichen:
- Fine-Tuning passt das Modell an eine konkrete Aufgabe an und verbessert seine Leistung genau dafür.
- Es ermöglicht eine Maßschneiderung an deine Anforderungen und Daten.
- Das Fine-Tuning von FLAN-T5 kann auf lokalen Workstations mit CPUs erfolgen – und macht das Modell so für mehr Nutzer zugänglich.
- Diese Zugänglichkeit hilft insbesondere kleineren Organisationen oder Einzelpersonen ohne GPU-Ressourcen.
- In Summe ist Fine-Tuning ein zentraler Schritt, um FLAN-T5 für konkrete Use Cases zu optimieren und maximalen Nutzen zu erzielen.
Ziel dieses Tutorials ist ein vollständiger Leitfaden zum Fine-Tuning von FLAN-T5 für ein Question-Answering-Szenario.
Dafür behandeln wir die benötigten Bibliotheken und Tools sowie die Einrichtung der Umgebung für das Fine-Tuning.
Anschließend zeigen wir, wie du das FLAN-T5-Modell lädst und deine Daten für das Fine-Tuning vorbereitest. Ist alles bereit, gehen wir Schritt für Schritt durch das Training und passen das Modell auf deinen Bedarf an.
Zum Schluss beleuchten wir mögliche Anwendungen des feinabgestimmten FLAN-T5 und zeigen, wie es in verschiedenen Szenarien bessere Performance und präzisere Ergebnisse liefert.
Mögliche Anwendungsfälle eines feinabgestimmten FLAN-T5
Bevor wir in die Technik einsteigen, werfen wir einen Blick auf potenzielle Anwendungen eines feinabgestimmten FLAN-T5. Unten findest du Beispiele für Chat- und Dialogzusammenfassung, Textklassifikation und Fast Healthcare Interoperability Resources (FHIR).
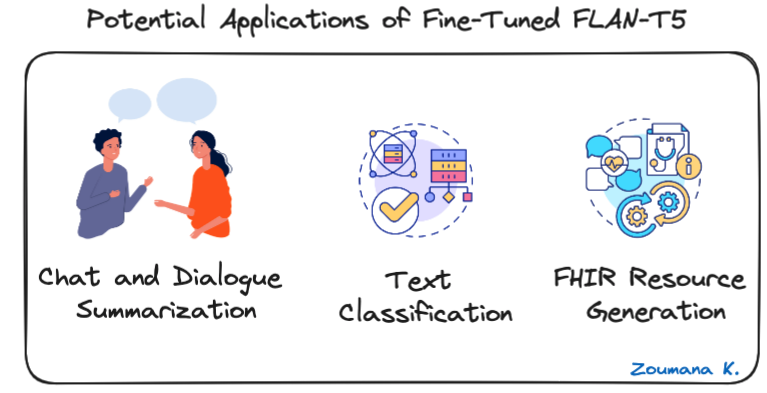
Drei mögliche Anwendungsfälle von feinabgestimmtem FLAN-T5
- Chat- und Dialogzusammenfassung: FLAN-T5 kann Gespräche verdichten – etwa für kurze Recaps von Kundenservice-Interaktionen oder Meetings.
- Textklassifikation: Nützlich, um Texte automatisch vordefinierten Klassen zuzuordnen, z. B. Sentiment-Analyse, Spam-Erkennung oder Topic Modeling.
- FHIR-Ressourcenerzeugung: FLAN-T5 kann klinische Texte in strukturierte FHIR-Daten (Fast Healthcare Interoperability Resources) überführen, um sie einfacher zu teilen und in Gesundheitssysteme zu integrieren.
Vor den technischen Details: Unser Tutorial How to Build LLM Applications with LangChain zeigt dir, wie du das Potenzial großer Sprachmodelle mit LangChain, einem Open-Source-Python-Framework für fortgeschrittene KI-Anwendungen, ausschöpfst.
Voraussetzungen
Jetzt, da wir FLAN-T5 besser kennen, sieh dir an, wie du es für ein Question-Answering-Use-Case feinabstimmst. Das vollständige Notebook findest du auf GitHub.
Zu Beginn benötigst du folgende Bibliotheken und Tools:
- Hugging Face: Plattform mit Zugriff auf das FLAN-T5-Modell, inkl. Download und Nutzung für Fine-Tuning
- Transformers: Vereinfacht das Laden des vortrainierten FLAN-T5 und bietet hilfreiche Funktionen für das Fine-Tuning
- Datasets: Sammlung sofort nutzbarer Datensätze – zentral, um passende Daten fürs Fine-Tuning zu beziehen
- SentencePiece: Tokenizer, insbesondere für große und mehrsprachige Textdaten
- Tokenizers: Tokenizer-Bibliothek, um Text in ein passendes Format zu überführen
- Evaluate: Stellt eine breite Auswahl an Metriken zur Modellbewertung bereit, damit das feinabgestimmte Modell den Zielwerten entspricht
- ROUGE Score: Spezifische Metrik zur Bewertung der Qualität von Texten aus großen Sprachmodellen
- NLTK: Hilfreich für Vorverarbeitungsschritte wie Tokenisierung und Stemming
Installation der Bibliotheken
Die Installation erfolgt mit pip, dem Python-Paketmanager, direkt aus dem Jupyter-Notebook.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
Der Befehl %%bash lässt die Zelle als Bash-Skript ausführen, statt jeden Befehl einzeln laufen zu lassen.
Bibliotheken importieren
Nach der Installation können wir die Bibliotheken wie folgt importieren:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
FLAN-T5 laden
Auf Hugging Face gibt es FLAN-T5 in mehreren Größen von klein bis extra groß. Je größer das Modell, desto mehr Parameter.
Unten siehst du die verfügbaren Modellgrößen aus der Model Card von Hugging Face:
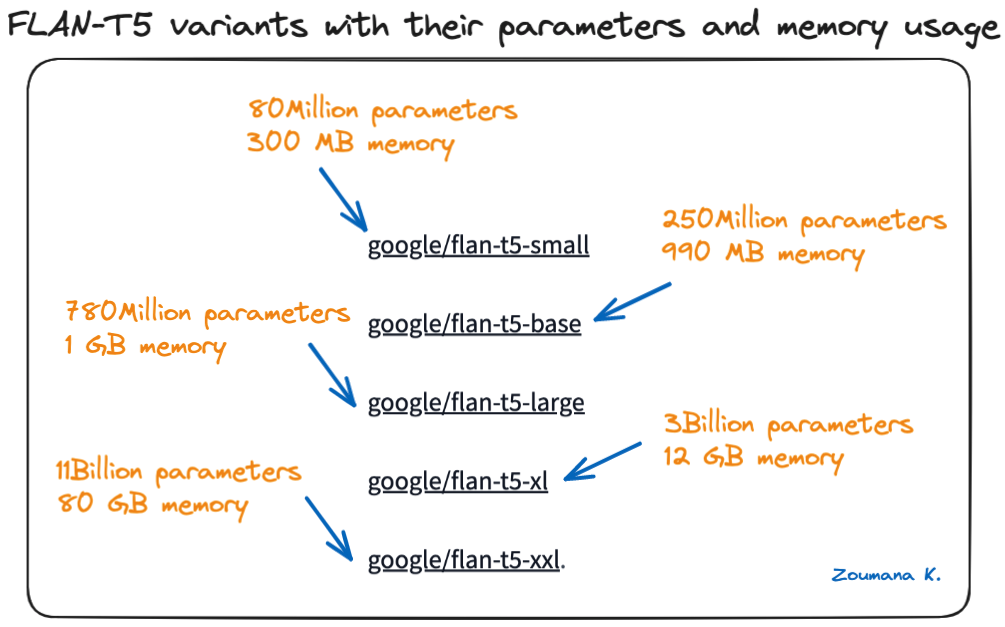
FLAN-T5-Varianten mit ihren Parametern und dem Speicherbedarf
Die richtige Modellgröße wählen
Die Wahl der passenden Modellvariante hängt stark ab von:
- Den Anforderungen deines Projekts
- Verfügbaren Rechenressourcen
- Der erwarteten Performance
Für dieses Experiment verwenden wir eine NVIDIA A100 GPU. Das Modell google/flan-t5-base bietet hier einen guten Kompromiss aus Effizienz und Leistung.
Initialisierung von Modell und Tokenizer
Die folgenden drei Schritte genügen, um das Modell zu erstellen.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- Der Tokenizer wird über T5Tokenizer und den Modellnamen instanziiert.
- Mit der Funktion from_pretrained aus T5ForConditionalGeneration wird das Modell geladen.
- Mit DataCollatorForSeq2Seq wird ein Data Collator für die Question-Answering-Aufgabe erstellt.
Daten für das Fine-Tuning vorbereiten
Sind Modell, Tokenizer und Data Collator bereit, laden wir die Daten für das Fine-Tuning. Hier nutzen wir die Yahoo-Diskussionsdaten auf Hugging Face.
Das Laden ist unkompliziert und erfolgt mit der Funktion load_dataset, die den Datensatznamen als Parameter erhält. In diesem Fall konzentrieren wir uns auf die Trainingsdaten.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Nach dem Laden teilen wir die Daten im Verhältnis 70 % zu 30 % in Trainings- und Testdaten auf. Das übernimmt train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)Die folgende Anweisung zeigt die Gesamtzahl der Beobachtungen in Trainings- und Testdaten.
# Check the length of the data and its structure
yahoo_answers_qa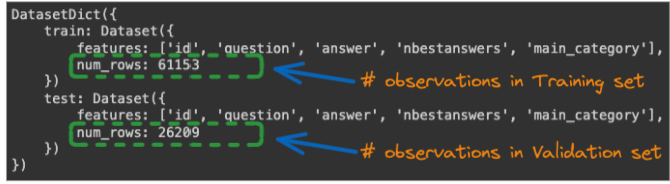
Gesamtzahl der Beobachtungen in Trainings- und Validierungsdaten
Datenformatierung und Tokenisierung
Wir haben für das Fine-Tuning reichlich Daten in Training und Test. Vor dem Start bringen wir sie in das passende Format.
Viele der folgenden Funktionen sind vom Toughdata-Artikel inspiriert.
In der Inferenz rufen wir das Modell in folgendem Format auf:
„Please answer this question: <USER_QUESTION>“
Dabei ist <USER_QUESTION> die Frage, zu der die Antwort gewünscht ist. Um dieses Verhalten zu erreichen, präfixen wir die Trainingsdaten mit dem String „Please answer this question:“. Das erledigt die Funktion preprocess_function unten.
Zusätzlich tokenisiert die Funktion Eingaben und Ausgaben mit dem tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Anschließend wenden wir die Funktion mit map auf den gesamten Datensatz an:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Training und Fine-Tuning von FLAN-T5
Bevor wir mit dem Training starten, legen wir die Metriken zur Leistungsbewertung fest.
Gute Evaluationsmetriken sind in jedem Deep-Learning- und Machine-Learning-Projekt wichtig – während des Trainings und später in der Produktion.
Für Textgenerierungsmodelle sind BLEU und ROUGE sehr verbreitet. Hier vergleichen wir die Qualität einer erzeugten Antwort mit einer Referenzantwort.
In diesem Tutorial fokussieren wir uns auf ROUGE. Mehr zu BLEU findest du in diesem Wikipedia-Artikel.
Was ist der ROUGE-Score?
ROUGE steht für Recall-Oriented Understudy for Gisting Evaluation. Wichtige Komponenten von ROUGE für Question-Answering sind:
- ROUGE-L: Misst die längste gemeinsame Teilfolge zwischen Kandidat und Referenz. Fokus auf Recall des Volltexts.
- ROUGE-1, ROUGE-2, ROUGE-SU4: Vergleichen Uni-, Bi- und 4-Gramm-Überlappungen zwischen Kandidat und Referenz. Fokus auf wichtige Textteile.
- Höhere ROUGE-Werte deuten generell auf bessere QA-Leistung hin. Werte ab etwa 0,70 gelten als stark.
- Vorverarbeitung wie Stemming und Entfernen von Stoppwörtern kann die Ergebnisse verbessern.
Mit diesem Verständnis berechnet die folgende Hilfsfunktion compute_metrics den ROUGE-Score. Vorher richten wir ROUGE und NLTK ein.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Hier die Implementierung der Funktion.
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Trainingsprozess
Für das Fine-Tuning legen wir einige Hyperparameter fest. Die wichtigsten sind:
- Learning Rate: Steuert, wie schnell das Modell aus den Daten lernt. Typisch sind 1e-5 bis 5e-5, hier setzen wir 3e-4.
- Batch-Größe: Anzahl Samples vor einem Gewichtsupdate. Größere Batches beschleunigen das Training, können aber die Leistung verschlechtern. Wir verwenden 8.
- Per-Device Train Batch Size: Entspricht der Batch-Größe pro Gerät (GPU).
- Weight Decay: Regulärisierung gegen Overfitting. Ein Wert von 0,01 ist gut praxiserprobt.
- Save Total Limit: Anzahl der während des Trainings zu speichernden Checkpoints. Mehr Checkpoints erleichtern das Zurückrollen, benötigen aber mehr Speicher. Wir speichern 3.
- Anzahl Epochen: Wie oft der Trainingsdatensatz komplett durchlaufen wird. Mehr Epochen bedeuten längere Trainingszeit, können aber die Leistung verbessern. Üblich sind 3 bis 10, hier nutzen wir 3.
Diese Parameter definieren wir unten und setzen damit die Trainingsargumente auf. Die Artefakte werden im Ordner results gespeichert:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Als nächstes richten wir den Trainer ein und starten das Training.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Schließlich starten wir das Training mit train:
trainer.train()Nach rund vier Stunden liegen die Leistungswerte pro Epoche vor:
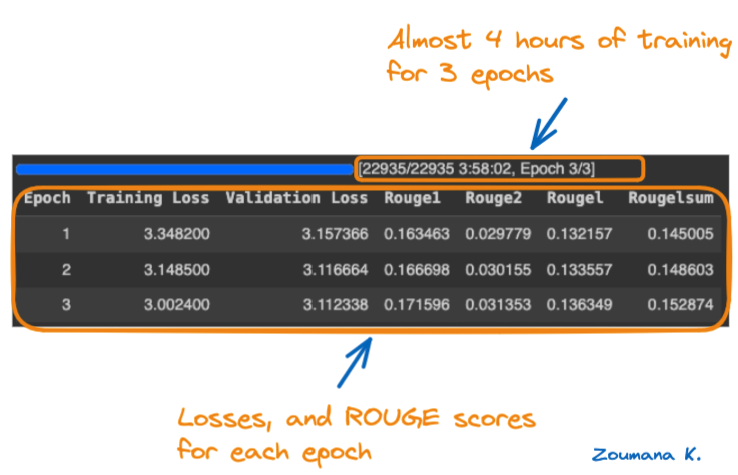
Trainingsepochen und zugehörige Performancescores
So liest du das Dashboard:
- Training Loss und Validation Loss: Niedriger ist besser – die Werte sinken über die Epochen, mit den niedrigsten Werten in Epoche 3.
- ROUGE-Metriken (ROUGE1, ROUGE2, ROUGEL, ROUGELsum): Höhere Werte sind besser und steigen über die Epochen – ebenfalls mit Spitzenwerten in Epoche 3.
Insgesamt performt das Modell in Epoche 3 am besten: niedrigste Verluste und höchste ROUGE-Werte. Unten der Inhalt des Ergebnisordners mit allen Checkpoints:
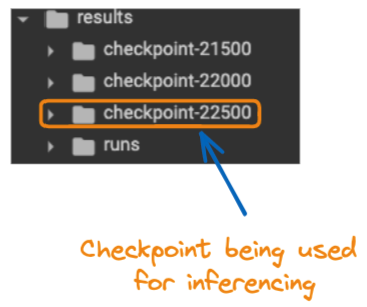
Inhalt des Ordners „results“
Modellinferenz
Jetzt, da das Modell feinabgestimmt ist, wollen wir es in einem realen Szenario anwenden.
Genau darum geht es bei der Inferenz: Ein vorhandenes Modell löst ein reales Problem – hier mit unserem feinabgestimmten Modell.
Davor erledigen wir ein paar Schritte:
- Lade das feinabgestimmte Modell vom letzten Checkpoint
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Definiere eine konkrete Frage
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Starte die Vorhersage
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Unten siehst du das Ergebnis des feinabgestimmten Modells – es wirkt überzeugend. Die Funktion fill aus textwrap begrenzt die Zeilenlänge auf maximal 80 Zeichen, statt alles in einer Zeile auszugeben.

Antwort des feinabgestimmten Modells auf die Frage
Fazit und nächste Schritte
Dieser Artikel bietet einen vollständigen Leitfaden für das Fine-Tuning eines FLAN-T5-Modells. Zuerst haben wir Modell und Anwendungsfälle eingeordnet, dann die technische Umsetzung durchlaufen – vom Laden der Experimentdaten und des Modells von Hugging Face bis hin zum Training auf der GPU. Das beste Modell gemäß ROUGE-Werten wurde in einem realen Szenario getestet.
Wie geht es weiter?
Unsere Artikel 12 GPT-4 Open-Source Alternatives und How to Train a LLM with PyTorch sind ideale nächste Schritte für deine Weiterbildung. Der erste zeigt Open-Source-Alternativen zu GPT-4, die ähnliche Leistung bieten und weniger Rechenressourcen benötigen. Diese Projekte enthalten Anleitungen, Code, Modellgewichte, Datensätze und Chatbot-UIs.
Der zweite Artikel hilft dir, das Training großer Sprachmodelle mit PyTorch von der Einrichtung bis zur Implementierung zu meistern. Bring deine Kompetenzen mit dem leistungsstarken Deep-Learning-Framework der KI-Profis aufs nächste Level. Starte noch heute mit dem Kurs Deep Learning with PyTorch.


