O que é o FLAN-T5?
FLAN-T5 é um modelo de linguagem grande, open source, do tipo sequência a sequência, que também pode ser usado comercialmente. O modelo foi publicado por pesquisadores do Google no fim de 2022 e passou por fine-tuning em múltiplas tarefas.
O T5 reformula várias tarefas em um formato texto-para-texto, como tradução, aceitabilidade linguística, similaridade de sentenças e sumarização de documentos, como mostrado abaixo:
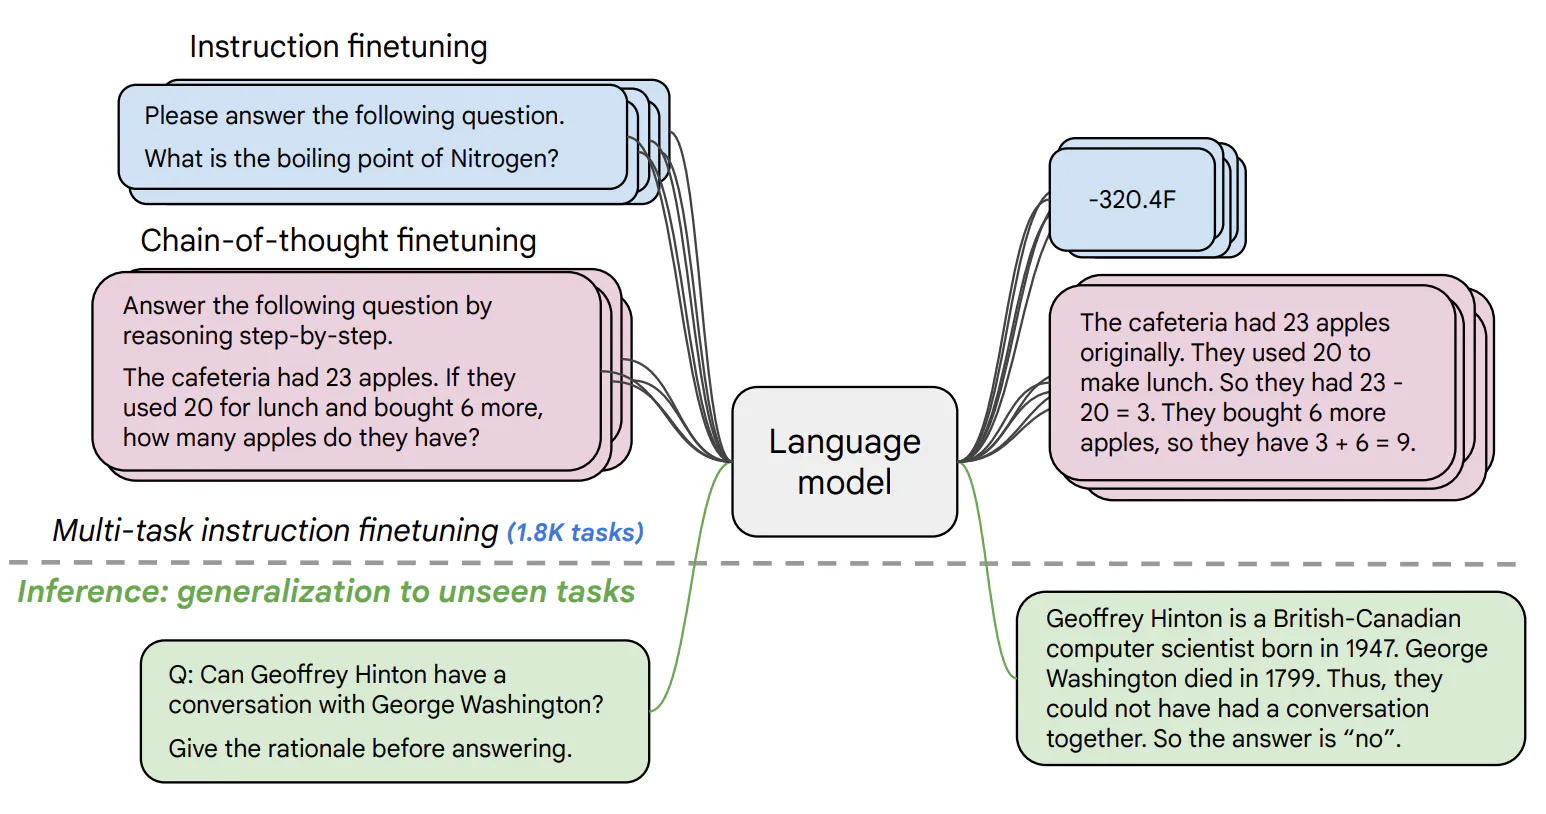
Exemplos de como o T5 reformula várias tarefas em um framework texto-para-texto (fonte)
Da mesma forma, a arquitetura do T5 se alinha de perto à estrutura codificador-decodificador utilizada no artigo original do Transformer. A principal diferença está no tamanho e na natureza dos dados de treinamento: o T5 foi treinado em um corpus massivo de 750 GB conhecido como Colossal Clean Crawled Corpus (C4).
Já o Transformer original foi projetado especificamente para tradução automática e, por isso, foi treinado em um conjunto de 1,4 GB de pares de sentenças em inglês e alemão.
Nosso artigo uma introdução ao uso de Transformers e Hugging Face ajuda você a entender transformers e a aproveitar seu poder para resolver problemas reais.
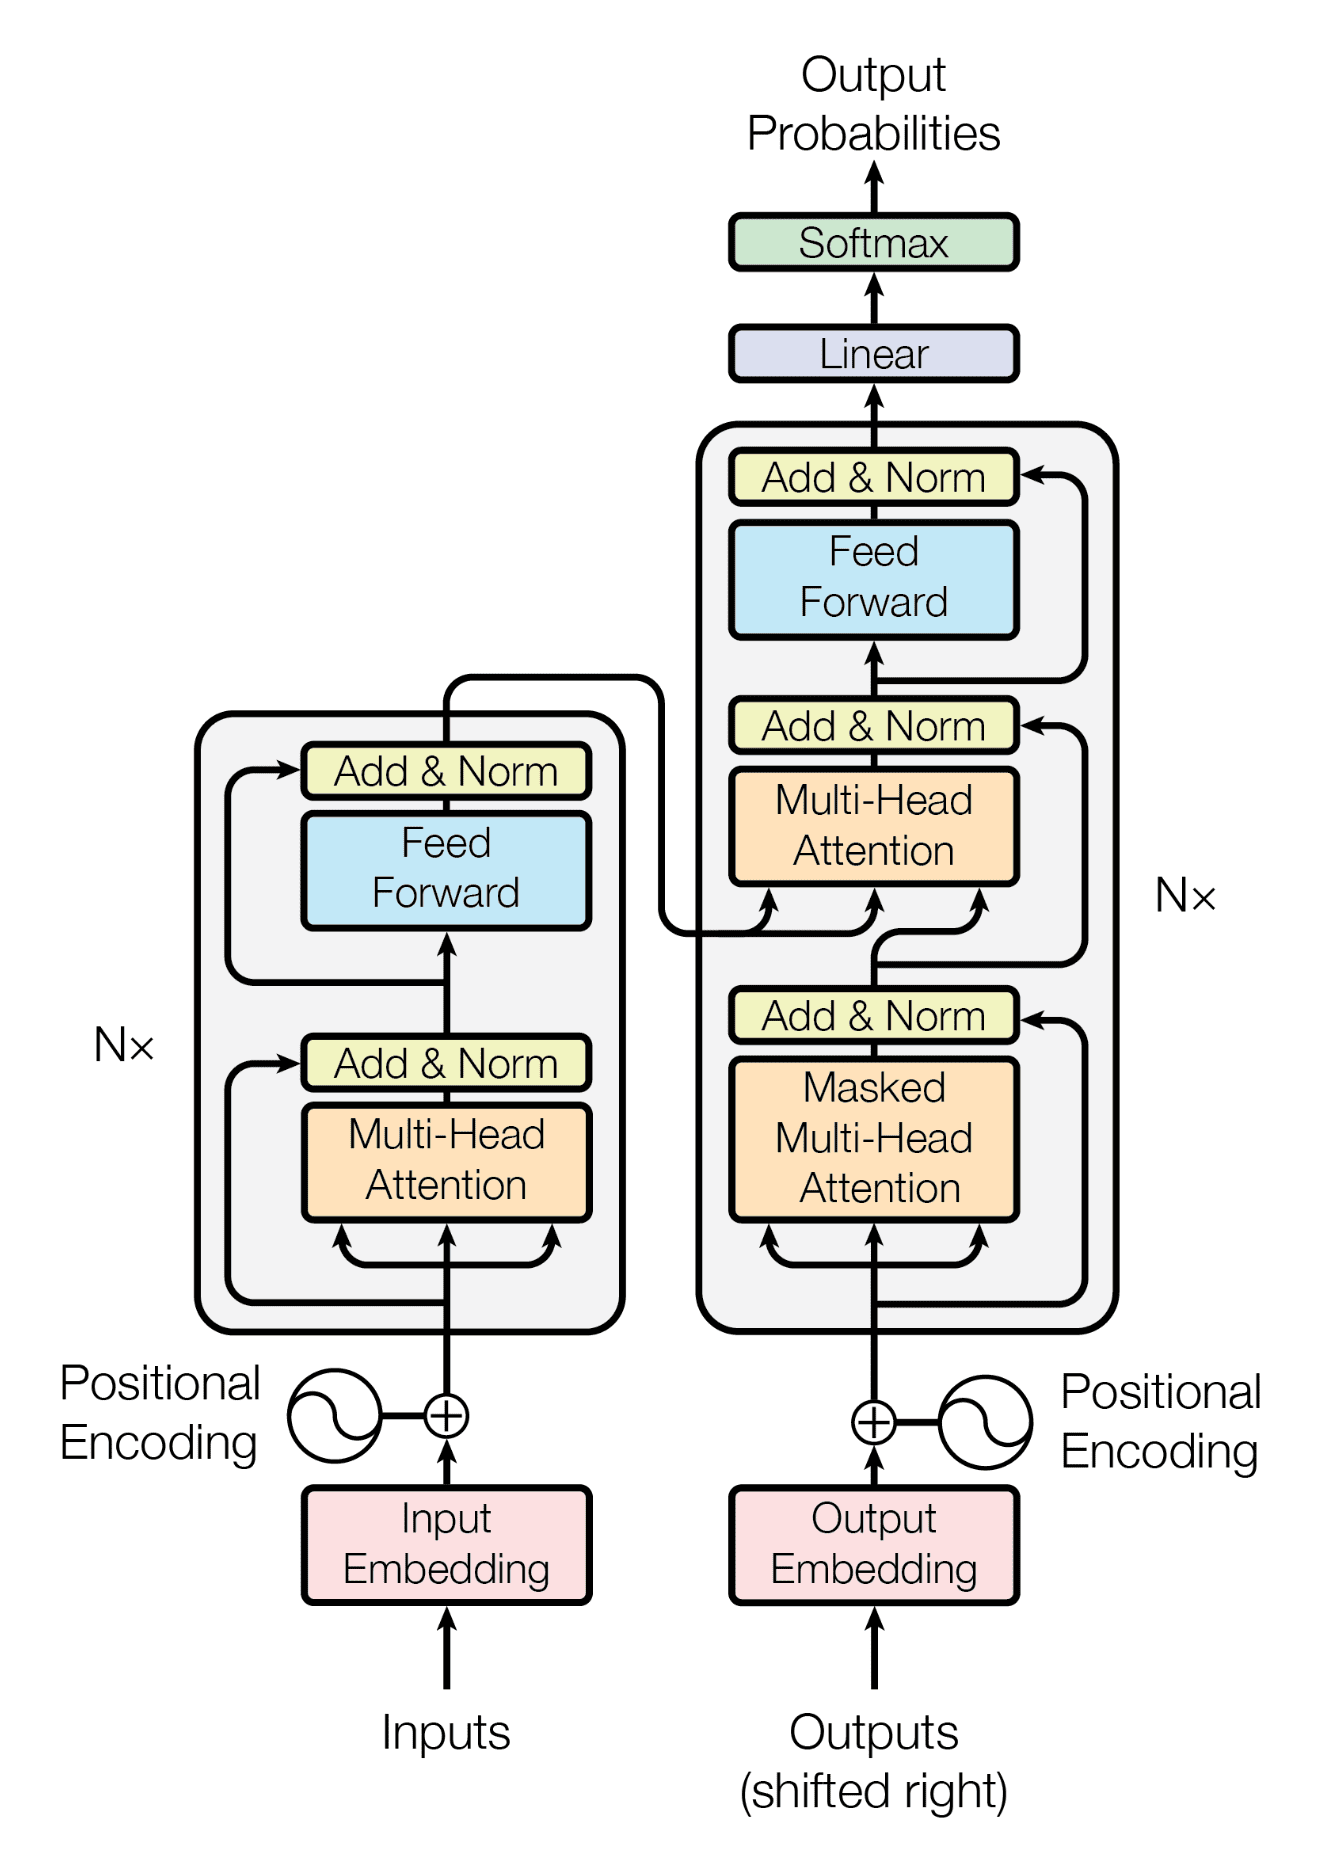
A arquitetura do modelo Transformer (fonte)
Qual é a importância do fine-tuning do FLAN-T5?
Não há dúvida de que o FLAN-T5 pode ser usado em várias tarefas de processamento de linguagem natural.
No entanto, para liberar todo o seu potencial e garantir o melhor desempenho em aplicações específicas, o fine-tuning é uma etapa essencial. Abaixo, os principais pontos que destacam a importância de fazer fine-tuning no FLAN-T5:
- O fine-tuning do FLAN-T5 é importante para adaptar o modelo a tarefas específicas e melhorar seu desempenho nessas tarefas.
- O fine-tuning permite personalizar o modelo para atender melhor às suas necessidades e aos seus dados.
- A possibilidade de ajustar o FLAN-T5 em máquinas locais com CPUs o torna acessível para mais pessoas.
- Essa acessibilidade beneficia organizações menores ou pesquisadores independentes que podem não ter acesso a GPUs.
- No geral, fazer fine-tuning do FLAN-T5 é uma etapa valiosa para otimizar o modelo em casos de uso específicos e maximizar seus benefícios.
O objetivo deste tutorial é oferecer um guia completo para fazer fine-tuning do FLAN-T5 em um cenário de perguntas e respostas.
Neste tutorial, vamos abordar uma série de tópicos para ajudar você a entender e implementar o fine-tuning do FLAN-T5. Vamos começar discutindo as bibliotecas e ferramentas necessárias para o processo, seguidas dos passos para configurar o ambiente.
Depois, vamos orientar você no carregamento do modelo FLAN-T5 e na preparação dos dados para o fine-tuning. Com os dados prontos, mostraremos como treinar e ajustar o modelo às suas necessidades.
Por fim, exploraremos algumas aplicações potenciais do FLAN-T5 ajustado, mostrando como usá-lo em diferentes cenários para alcançar melhor desempenho e resultados mais precisos.
Aplicações potenciais do FLAN-T5 com fine-tuning
Antes de entrar na implementação técnica, vamos explorar algumas aplicações possíveis do FLAN-T5 ajustado. Abaixo estão exemplos para resumo de chats e diálogos, classificação de texto e Fast Healthcare Interoperability Resources (FHIR).
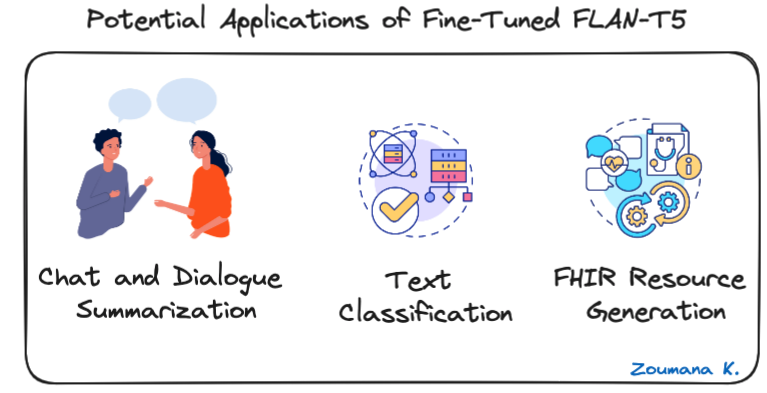
Três aplicações potenciais do FLAN-T5 com fine-tuning
- Resumo de chats e diálogos: o FLAN-T5 pode condensar conversas, oferecendo um resumo rápido de interações de suporte ao cliente ou reuniões de negócios.
- Classificação de texto: útil para automatizar a categorização de textos em classes predefinidas, como análise de sentimento, detecção de spam ou modelagem de tópicos.
- Geração de recursos FHIR: o FLAN-T5 pode converter texto clínico em FHIR (Fast Healthcare Interoperability Resources) estruturado para facilitar o compartilhamento e a integração em sistemas de saúde.
Antes de mergulhar nos aspectos técnicos centrais do artigo, nosso tutorial como construir aplicações com LLMs usando LangChain convida você a explorar o potencial dos Large Language Models com o LangChain, um framework Python open source para criar aplicações avançadas de IA.
Pré-requisitos
Agora que entendemos melhor o FLAN-T5, vamos ver como fazer fine-tuning para um caso de perguntas e respostas. O notebook completo está disponível no GitHub.
Para começar, as seguintes bibliotecas e ferramentas são necessárias:
- Hugging Face: uma plataforma que dá acesso ao modelo FLAN-T5, facilitando seu download e uso para fine-tuning
- Transformers: usada para simplificar o carregamento do FLAN-T5 pré-treinado e fornecer funções úteis para fine-tuning
- Datasets: coleção de datasets prontos para uso, essencial para obter dados relevantes para o fine-tuning
- Sentencepiece: ferramenta de tokenização usada principalmente para lidar com textos grandes e multilíngues
- Tokenizers: biblioteca de tokenização para converter texto em um formato adequado ao caso de uso
- Evaluate: biblioteca com uma ampla variedade de métricas de avaliação, garantindo que o modelo ajustado atinja o desempenho esperado
- Rouge score: métrica específica para avaliar a qualidade de texto gerado por modelos de linguagem
- NLTK: útil para etapas de pré-processamento de dados, como tokenização e stemming
Instalação das bibliotecas
A instalação pode ser feita assim, usando o pip, o gerenciador de pacotes do Python, direto do Jupyter Notebook.
%%bash
pip install nltk
pip install datasets
pip install transformers[torch]
pip install tokenizers
pip install evaluate
pip install rouge_score
pip install sentencepiece
pip install huggingface_hub
O comando %%bash é usado no notebook para executar a célula como um script bash em vez de rodar cada comando separadamente.
Importar bibliotecas
Após instalar tudo, podemos importar as bibliotecas assim:
import nltk
import evaluate
import numpy as np
from datasets import load_dataset
from transformers import T5Tokenizer, DataCollatorForSeq2Seq
from transformers import T5ForConditionalGeneration, Seq2SeqTrainingArguments, Seq2SeqTrainer
Carregando o modelo FLAN-T5
Várias versões do FLAN-T5 estão disponíveis no Hugging Face, de modelos pequenos a extra grandes; quanto maior o modelo, mais parâmetros ele tem.
Abaixo estão os diferentes tamanhos disponíveis na model card do Hugging Face:
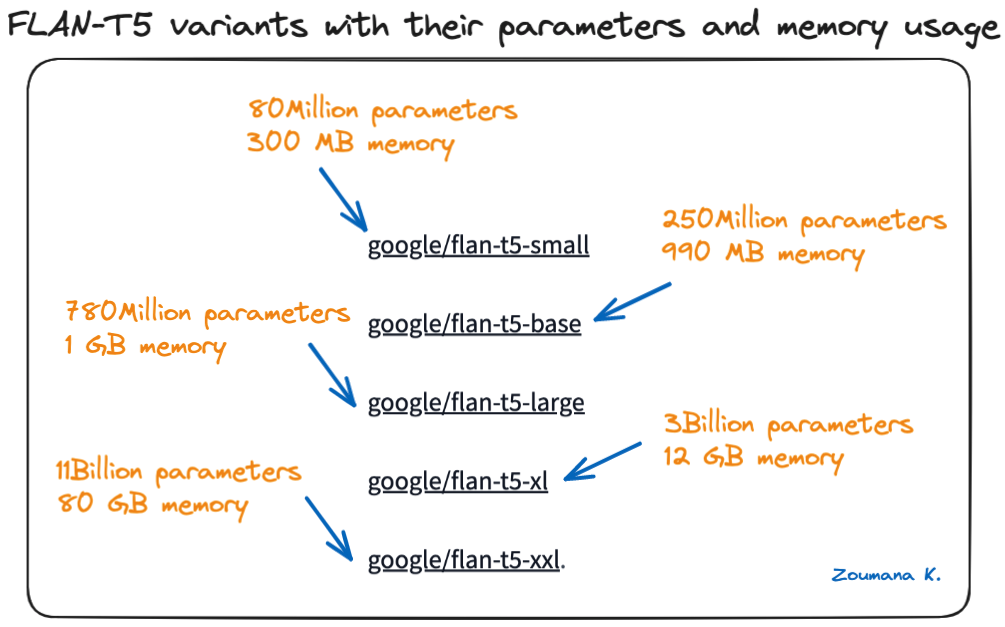
Variantes do FLAN-T5 com seus parâmetros e uso de memória
Como escolher o tamanho certo
A escolha do tamanho adequado entre as variantes do FLAN-T5 depende muito de:
- Requisitos específicos do projeto
- Recursos computacionais disponíveis
- Nível de desempenho esperado
Usamos uma GPU NVIDIA A100 nesta experimentação, e o modelo google/flan-t5-base oferece um bom equilíbrio entre eficiência computacional e desempenho.
Inicialização do modelo e do tokenizer
As três instruções a seguir são necessárias para criar o modelo.
# Load the tokenizer, model, and data collator
MODEL_NAME = "google/flan-t5-base"

tokenizer = T5Tokenizer.from_pretrained(MODEL_NAME)
model = T5ForConditionalGeneration.from_pretrained(MODEL_NAME)
data_collator = DataCollatorForSeq2Seq(tokenizer=tokenizer, model=model)- O tokenizer é instanciado usando o módulo T5Tokenizer e o nome do modelo
- Com a função from_pretrained do T5ForConditionalGeneration, o modelo é carregado
- Com o DataCollectorForSeq2Seq, criamos um data collator para a tarefa de perguntas e respostas
Preparando os dados para o fine-tuning
Com o modelo, o tokenizer e o data collator prontos, o próximo passo é carregar os dados para o fine-tuning. Usaremos os dados de discussões do Yahoo disponíveis no Hugging Face.
O carregamento é simples e pode ser feito com a função load_dataset, que recebe o nome do dataset como parâmetro. Neste caso, o foco é nos dados de treino.
# Acquire the training data from Hugging Face
DATA_NAME = "yahoo_answers_qa"
yahoo_answers_qa = load_dataset(DATA_NAME)
Depois de carregar, dividimos em conjuntos de treino e teste, respectivamente, nas proporções de 70% e 30%, usando a função train_test_split.
yahoo_answers_qa = yahoo_answers_qa["train"].train_test_split(test_size=0.3)A instrução a seguir mostra o número total de observações nos dados de treino e de validação.
# Check the length of the data and its structure
yahoo_answers_qa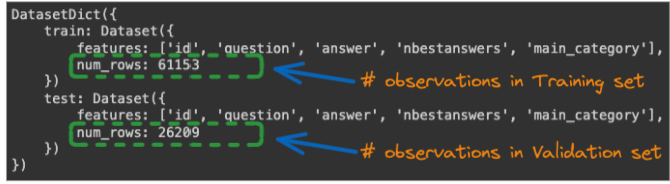
Número total de observações nos datasets de treino e validação
Formatação e tokenização dos dados
Temos uma quantidade significativa de dados em treino e teste para o processo de fine-tuning. Mas, antes, precisamos processá-los para o formato adequado.
A maioria das funções usadas na próxima etapa foi inspirada no artigo da Toughdata.
Durante a inferência, a chamada ao modelo seguirá este formato:
“Please answer this question: <USER_QUESTION>”
Em que <USER_QUESTION> é a pergunta para a qual o usuário deseja a resposta. Para chegar a esse comportamento, precisamos formatar os dados de treino prefixando a tarefa com a string “Please answer this question:”, o que é feito com a função preprocess_function abaixo.
Além da formatação, a função também aplica a tokenização das entradas e saídas usando o tokenizer.
# We prefix our tasks with "answer the question"
prefix = "Please answer this question: "

# Define the preprocessing function

def preprocess_function(examples):
   """Add prefix to the sentences, tokenize the text, and set the labels"""
   # The "inputs" are the tokenized answer:
   inputs = [prefix + doc for doc in examples["question"]]
   model_inputs = tokenizer(inputs, max_length=128, truncation=True)

   # The "labels" are the tokenized outputs:
   labels = tokenizer(text_target=examples["answer"],
                      max_length=512,
                      truncation=True)

   model_inputs["labels"] = labels["input_ids"]
   return model_inputs
Em seguida, aplicamos a função a todo o dataset usando map:
# Map the preprocessing function across our dataset
tokenized_dataset = yahoo_answers_qa.map(preprocess_function, batched=True)
Treinamento e fine-tuning do FLAN-T5
Antes de começar o treinamento, é melhor definir as métricas para avaliar o desempenho geral do fine-tuning.
Boas métricas de avaliação são essenciais em qualquer projeto de deep learning e machine learning para medir o desempenho dos modelos, não só durante o treino, mas também depois, em produção.
Duas das métricas mais comuns para avaliar modelos de geração de texto são BLEU e ROUGE — neste caso, para avaliar a qualidade de uma resposta comparando-a com uma resposta de referência.
O foco deste tutorial é o ROUGE, mas este artigo na Wikipedia traz mais informações sobre a métrica BLEU.
O que é o ROUGE?
ROUGE significa Recall-Oriented Understudy for Gisting Evaluation. Alguns componentes-chave do ROUGE para perguntas e respostas incluem:
- ROUGE-L: mede a maior subsequência comum entre as respostas candidata e de referência. Foca no recall do texto completo.
- ROUGE-1, ROUGE-2, ROUGE-SU4: comparam sobreposições de unigramas, bigramas e 4-gramas entre candidato e referência. Focam no recall de partes/trechos-chave
- Escores ROUGE mais altos geralmente indicam melhor desempenho em QA. Pontuações próximas ou acima de 0,70 são consideradas fortes
- Ao usar essa métrica, processamentos como stemming e remoção de stopwords podem ajudar a melhorar o desempenho geral
Com isso em mente, a função auxiliar compute_metrics abaixo calcula o ROUGE. Antes de implementá-la, é necessário configurar ROUGE e NLTK.
nltk.download("punkt", quiet=True)
metric = evaluate.load("rouge")
Veja a implementação da função:
def compute_metrics(eval_preds):
   preds, labels = eval_preds

   # decode preds and labels
   labels = np.where(labels != -100, labels, tokenizer.pad_token_id)
   decoded_preds = tokenizer.batch_decode(preds, skip_special_tokens=True)
   decoded_labels = tokenizer.batch_decode(labels, skip_special_tokens=True)

   # rougeLSum expects newline after each sentence
   decoded_preds = ["\n".join(nltk.sent_tokenize(pred.strip())) for pred in decoded_preds]
   decoded_labels = ["\n".join(nltk.sent_tokenize(label.strip())) for label in decoded_labels]

   result = metric.compute(predictions=decoded_preds, references=decoded_labels, use_stemmer=True)

   return result
Processo de treinamento
Para iniciar o fine-tuning, precisamos definir alguns hiperparâmetros. Os principais são:
- Learning rate: controla a velocidade de aprendizado do modelo a partir dos dados; valores típicos vão de 1e-5 a 5e-5, e neste caso usamos 3e-4
- Batch size: número total de amostras processadas antes da atualização dos pesos do modelo. Batches maiores podem acelerar, mas podem prejudicar o desempenho. Usamos 8 aqui
- Per device train batch size: semelhante ao batch size, mas especificado por dispositivo (GPU)
- Weight decay: ajuda a evitar overfitting. 0,01 é um valor aceitável
- Save total limit: número total de checkpoints salvos durante o treinamento. Quanto mais, maior a chance de rollback, mas maior o uso de disco. Aqui, salvamos 3
- Número de épocas (epochs): quantidade de passagens completas pelo dataset de treino. Mais épocas aumentam o tempo de treino, mas podem melhorar o desempenho. Tipicamente de 3 a 10; usamos 3 neste caso.
Os parâmetros acima são definidos a seguir e usados para configurar os argumentos de treinamento do modelo. Os artefatos do treinamento serão salvos na pasta results:
# Global Parameters
L_RATE = 3e-4
BATCH_SIZE = 8
PER_DEVICE_EVAL_BATCH = 4
WEIGHT_DECAY = 0.01
SAVE_TOTAL_LIM = 3
NUM_EPOCHS = 3

# Set up training arguments
training_args = Seq2SeqTrainingArguments(
   output_dir="./results",
   evaluation_strategy="epoch",
   learning_rate=L_RATE,
   per_device_train_batch_size=BATCH_SIZE,
   per_device_eval_batch_size=PER_DEVICE_EVAL_BATCH,
   weight_decay=WEIGHT_DECAY,
   save_total_limit=SAVE_TOTAL_LIM,
   num_train_epochs=NUM_EPOCHS,
   predict_with_generate=True,
   push_to_hub=False
)
Depois, configuramos o trainer para iniciar o processo de treinamento do modelo.
trainer = Seq2SeqTrainer(
   model=model,
   args=training_args,
   train_dataset=tokenized_dataset["train"],
   eval_dataset=tokenized_dataset["test"],
   tokenizer=tokenizer,
   data_collator=data_collator,
   compute_metrics=compute_metrics
)
Por fim, iniciamos o treinamento com a função train:
trainer.train()Depois de quase quatro horas, o desempenho geral do processo de treinamento por época é mostrado abaixo.
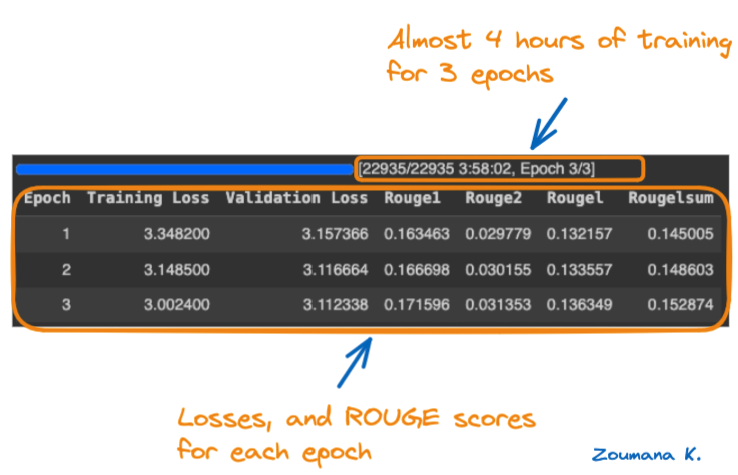
Épocas de treinamento e suas pontuações de desempenho
Vamos entender o painel de métricas acima.
- Training loss e validation loss: valores menores são preferíveis, pois indicam melhor ajuste do modelo aos dados. As perdas de treino e validação caíram ao longo das épocas, com os menores valores na época 3.
- Métricas ROUGE (ROUGE-1, ROUGE-2, ROUGE-L e ROUGE-Lsum): valores maiores são preferíveis, pois indicam melhor desempenho em sumarização de texto. Em todas as quatro métricas ROUGE, os valores aumentaram ao longo das épocas, com os maiores na época 3.
No geral, o modelo teve melhor desempenho na terceira época, com as menores perdas de treino e validação e os maiores valores de ROUGE. Abaixo está o conteúdo da pasta results com todos os checkpoints:
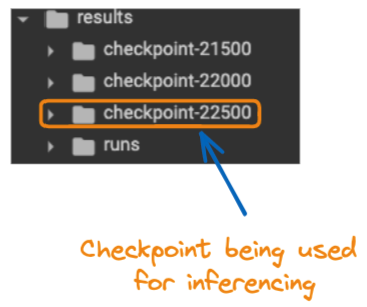
Conteúdo da pasta “results”
Inferência do modelo
Agora que o modelo passou por fine-tuning, que tal aplicá-lo em um cenário real?
É exatamente isso que a inferência faz: usar um modelo existente para resolver um problema do mundo real — como faremos com o modelo ajustado.
Antes, precisamos seguir alguns passos:
- Carregar o modelo ajustado do último checkpoint
last_checkpoint = "./results/checkpoint-22500"

finetuned_model = T5ForConditionalGeneration.from_pretrained(last_checkpoint)
tokenizer = T5Tokenizer.from_pretrained(last_checkpoint)- Definir uma pergunta específica a ser respondida
my_question = "What do you think about the benefit of Artificial Intelligence?"
inputs = "Please answer to this question: " + my_question- Executar a previsão
inputs = tokenizer(inputs, return_tensors="pt")
outputs = finetuned_model.generate(**inputs)
answer = tokenizer.decode(outputs[0])
from textwrap import fill

print(fill(res, width=80))
Abaixo está o resultado do modelo ajustado — e ficou bem bom. O método fill do textwrap é usado para limitar a 80 o número máximo de caracteres por linha, em vez de imprimir tudo em uma única linha.

Resposta do modelo ajustado à pergunta
Conclusão e próximos passos
Este artigo apresentou um guia completo de fine-tuning de um FLAN-T5. Primeiro, trouxe uma visão mais clara do modelo e de seus possíveis casos de uso; depois percorreu a implementação técnica, do carregamento dos dados e do modelo no Hugging Face ao treinamento em GPU. O melhor modelo, de acordo com os escores ROUGE, foi testado em um cenário real.
E agora, para onde ir?
Nossos artigos 12 alternativas open source ao GPT-4 e como treinar um LLM com PyTorch são ótimos próximos passos para capacitação. O primeiro destaca alternativas abertas ao GPT-4 que podem oferecer desempenho semelhante e exigir menos recursos computacionais para rodar. Esses projetos trazem instruções, código-fonte, pesos de modelos, datasets e interface de chatbot.
O segundo ajuda você a dominar o processo de treinar Large Language Models com PyTorch, do setup inicial à implementação final. Você também pode aprimorar suas habilidades com o framework de deep learning usado por profissionais de IA. Participe do curso Deep Learning with PyTorch hoje mesmo.







