
Kursus
Pengantar Visualisasi Data dengan Seaborn
4 jam
184.5K
Visualisasi data adalah komponen penting dalam menafsirkan kumpulan data yang kompleks.
Dalam ranah pemrograman Python, Seaborn menonjol sebagai pustaka yang kuat untuk membuat grafik statistik yang informatif dan menarik secara visual seperti histogram dan plot garis.
Pustaka ini dibangun di atas kapabilitas Matplotlib, menyempurnakan antarmukanya dan menawarkan lebih banyak opsi untuk memvisualisasikan data, terutama untuk analisis statistik. Integrasi Seaborn yang mulus dengan Pandas DataFrame membuatnya digemari para data scientist dan analis.
Dalam panduan mendetail ini, kita akan berfokus pada salah satu plot yang paling umum digunakan di Seaborn—histogram.
sns.histplotFungsi sns.histplot di Seaborn dirancang untuk menggambar histogram, yang penting untuk menelaah distribusi data kontinu. Fungsi ini serbaguna dan memungkinkan kustomisasi yang luas, sehingga memudahkan Anda menarik wawasan bermakna dari data.
Fungsi ini adalah salah satu dari banyak fungsi yang tersedia dari pustaka Seaborn. Lihat lembar contekan di bawah ini untuk gambaran cepat.
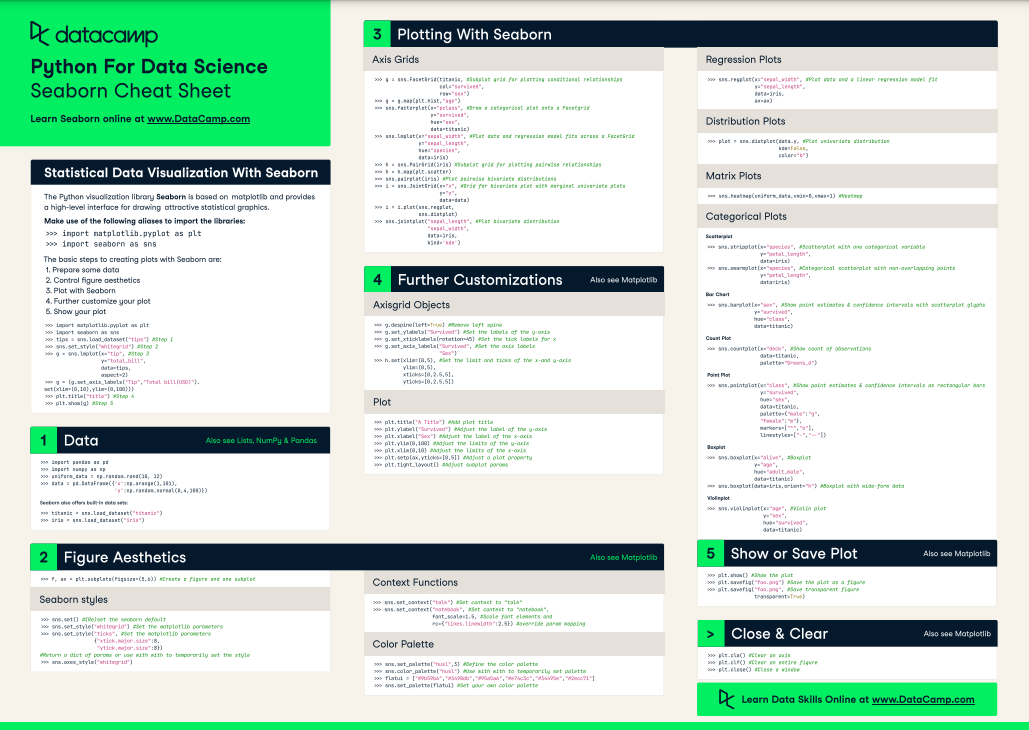
Lembar contekan Seaborn untuk data science - sumber
Sebelum masuk ke visualisasi data, kita perlu menyiapkan lingkungan. Ini melibatkan pengimporan pustaka yang diperlukan, dengan Seaborn sebagai fokus utama. Seaborn biasanya diimpor sebagai sns untuk kemudahan.
Selain Seaborn, pustaka penting lain yang sering digunakan meliputi NumPy untuk operasi numerik, pandas untuk pengolahan data, dan Matplotlib untuk opsi kustomisasi tambahan.
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Semua ini adalah pustaka penting yang menyediakan alat yang diperlukan untuk membuat dan memanipulasi visualisasi data di Python. Pustaka-pustaka ini paling sering digunakan oleh analis data dan data scientist.
Jika Anda baru mulai belajar Python, saya sarankan mencoba kursus Introduction to Python kami. Untuk pembelajaran lebih lanjut tentang pandas, NumPy, dan Matplotlib, ikuti kursus Data Manipulation with pandas, Introduction to NumPy, dan Introduction to Data Visualization with Matplotlib kami.
Kita akan menggunakan dataset Boston Housing Prices, yang dapat dimuat dari pustaka Scikit-Learn. Dataset ini menyediakan nilai properti di berbagai area Boston beserta beberapa atribut seperti tingkat kriminalitas, jumlah rata-rata kamar, dan lain-lain.
from sklearn.datasets import load_boston
boston = load_boston()
df = pd.DataFrame(boston.data, columns=boston.feature_names)
df['MEDV'] = boston.target
Kesesuaian data untuk histogram Anda adalah faktor penentu kegunaannya. Dalam kasus ini, kita menggunakan variabel kontinu, yaitu nilai median rumah yang dihuni pemilik (MEDV) di Boston.
Karena histogram umumnya menampilkan distribusi satu variabel, kita akan memilih satu kolom dari DataFrame.
Baru mengenal Scikit-Learn? Coba tutorial Machine Learning Python kami. Jika Anda menginginkan informasi lebih lanjut, kursus Supervised Learning with scikit-learn kami akan membantu menutup dasar-dasarnya.
Sebelum memulai, berikut beberapa prasyarat dasar sebelum Anda membangun histogram Seaborn:
Kita akan mulai dengan membahas beberapa sintaks dan parameter umum dari fungsi `sns.histplot`.
Sintaks dasar untuk membuat histogram menggunakan `sns.histplot` cukup langsung.
Parameter kunci meliputi:
data: Kumpulan data, yang sering kali berupa Pandas DataFrame.x: Variabel yang akan diplot histogramnya.color: Untuk menentukan warna batang.alpha: Transparansi batang.bins: Jumlah bin (kelompok batang) yang digunakan.binwidth: Lebar tiap bin.kde: Boolean untuk menambahkan plot Kernel Density Estimate.hue: Untuk membedakan subset data berdasarkan variabel lain.Fungsi ini menerima banyak parameter dan argumen, tetapi kita akan fokus pada yang diperlukan untuk dataset kita.
Mari buat histogram dasar untuk memvisualisasikan distribusi harga rumah median (MEDV).
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Perintah ini akan menampilkan histogram untuk kolom MEDV.
Berikut plot yang dihasilkan dari kode ini:
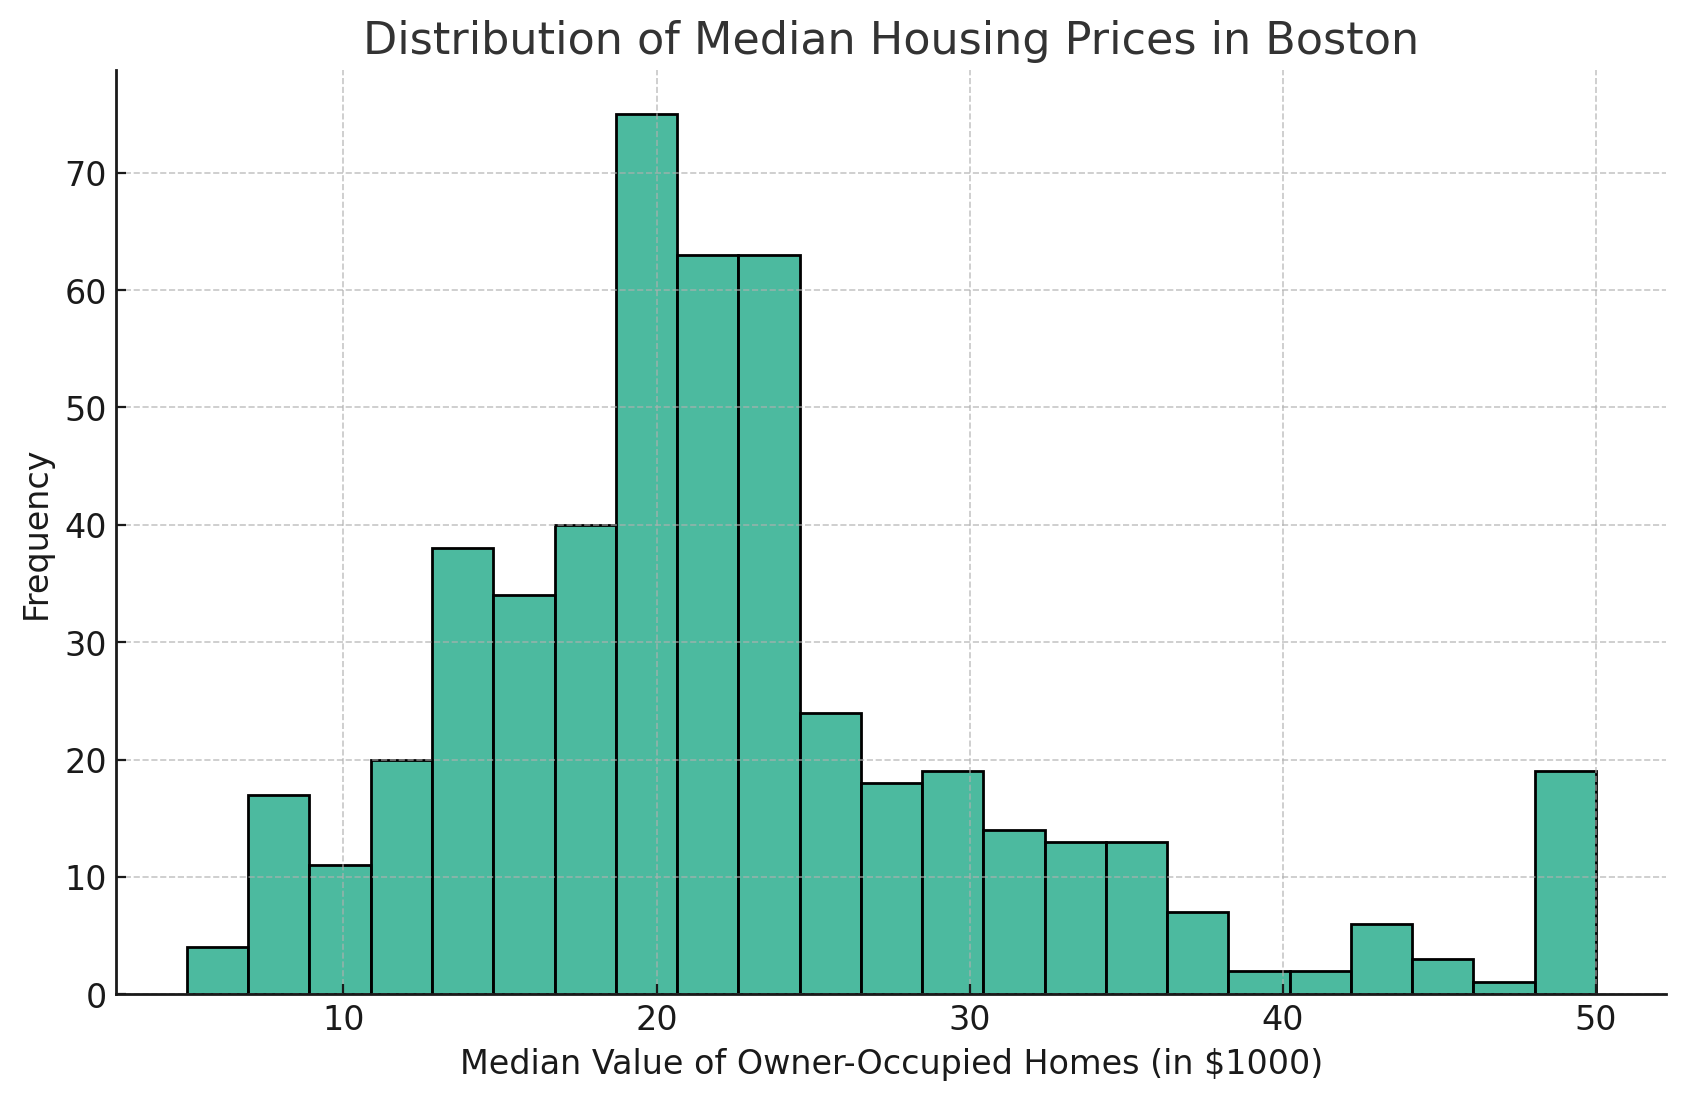
Berikut adalah plot histogram yang menampilkan distribusi harga rumah median (MEDV) dalam dataset Boston. Histogram memberikan representasi visual dari distribusi frekuensi nilai median rumah yang dihuni pemilik.
Menyesuaikan jumlah bin dapat membantu memahami distribusi dengan lebih baik. Jumlah bin yang lebih tinggi dapat mengungkap lebih banyak detail, sedangkan jumlah yang lebih rendah menyederhanakan visualisasi.
Untuk meningkatkan jumlah bin, Anda dapat mengubah parameter bins.
Berikut contohnya:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', bins=30)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
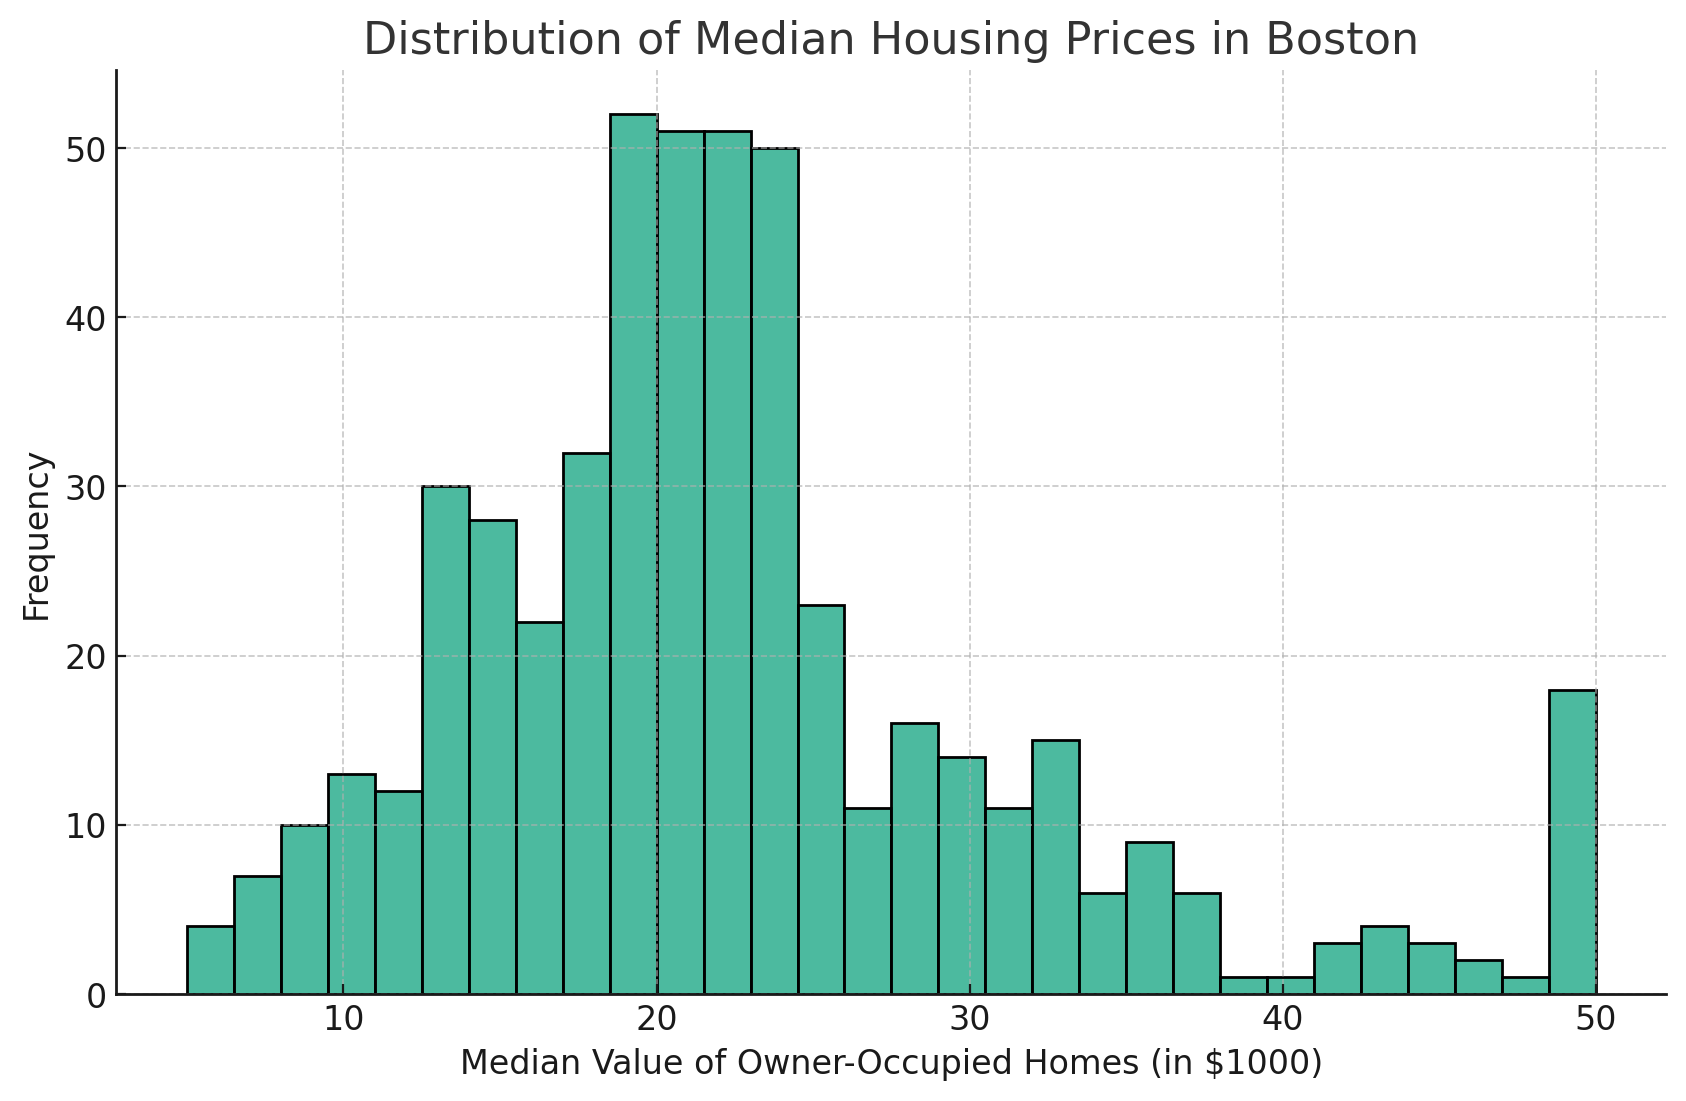
Seperti yang terlihat pada histogram Seaborn di atas, jumlah batang meningkat sesuai nilai yang saya tetapkan, yaitu 30. Ini adalah cara yang baik untuk menggali detail guna mendapatkan granularitas data yang lebih tinggi.
Menyesuaikan estetika, seperti mengubah warna dan transparansi batang, dapat membuat histogram lebih informatif dan menarik secara visual.
Pada contoh di bawah, saya membuat ulang histogram awal menggunakan warna ungu alih-alih warna bawaan.
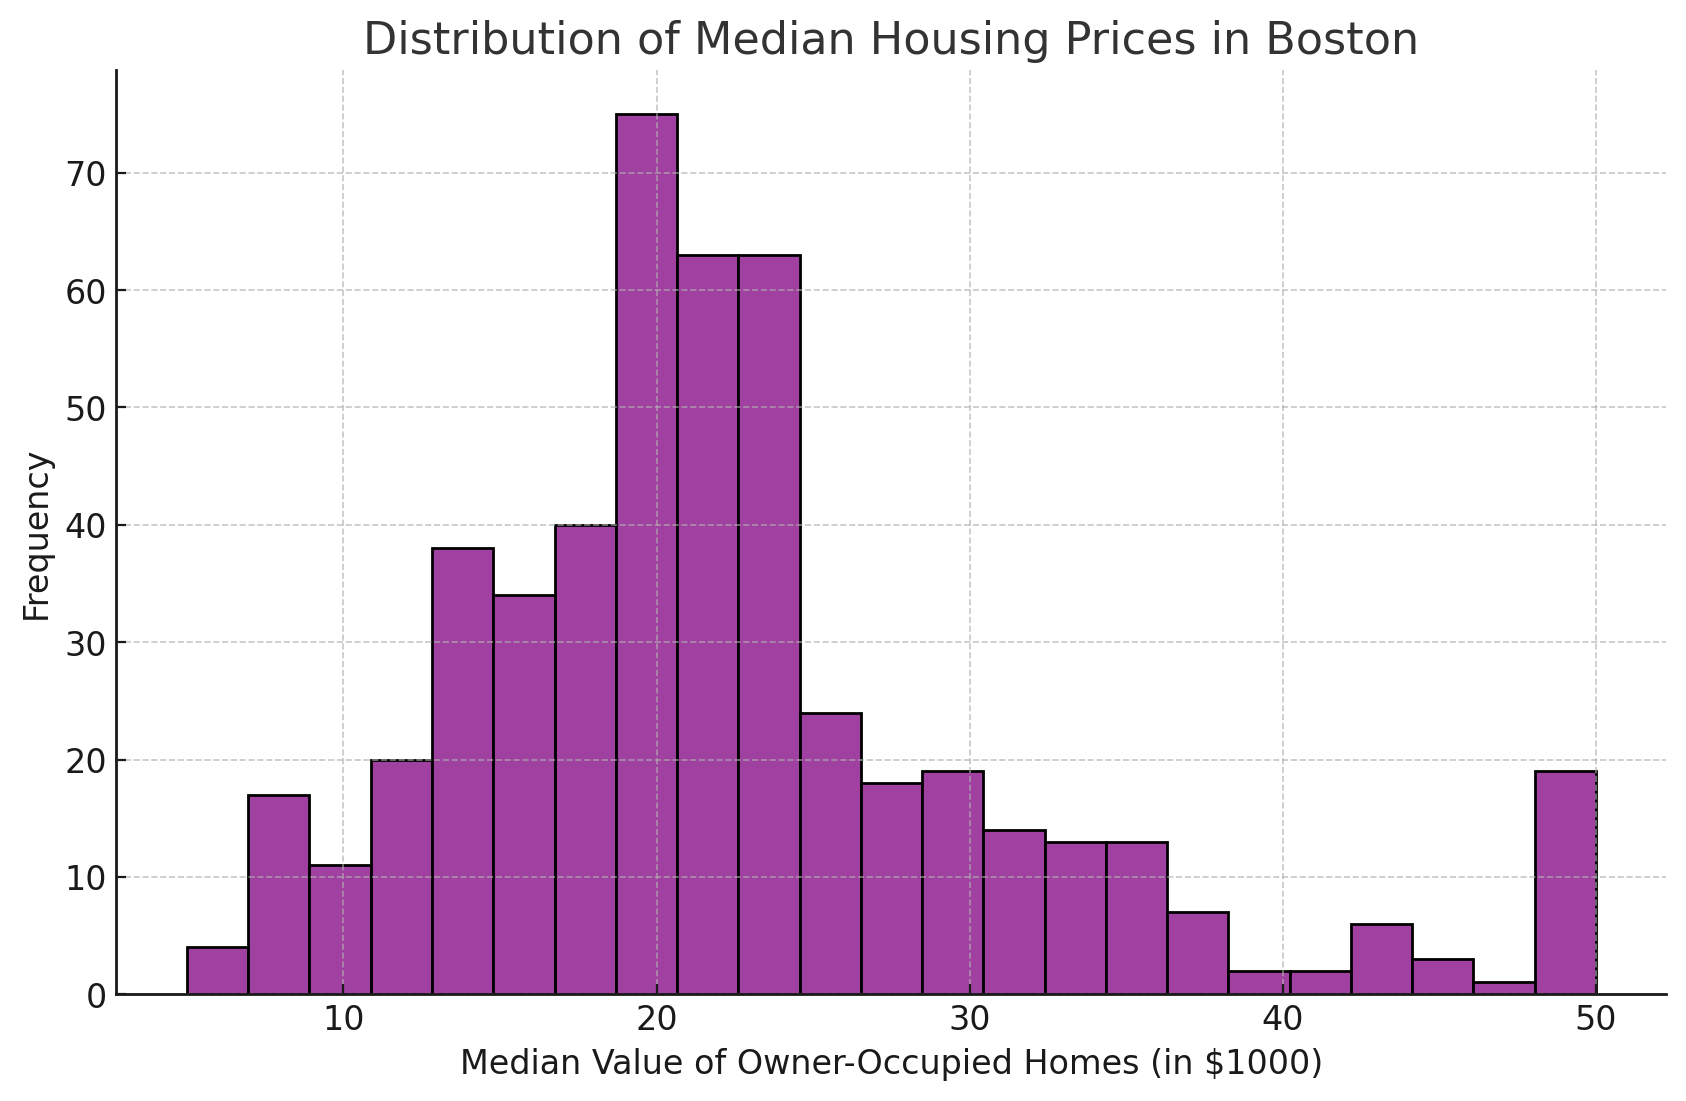
Berikut kode yang saya gunakan untuk membuat bagan di atas.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', color='purple')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
KDE memberikan estimasi halus dari distribusi data. Ini bisa sangat berguna untuk mengidentifikasi pola dalam data.
Ini menghasilkan kurva garis halus yang dapat membantu memvisualisasikan tren keseluruhan.
Untuk mencapainya, kita menggunakan parameter kde pada fungsi ini:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', kde=True)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Ini akan menghasilkan kurva yang bagus pada histogram kita, seperti yang ditunjukkan di bawah.
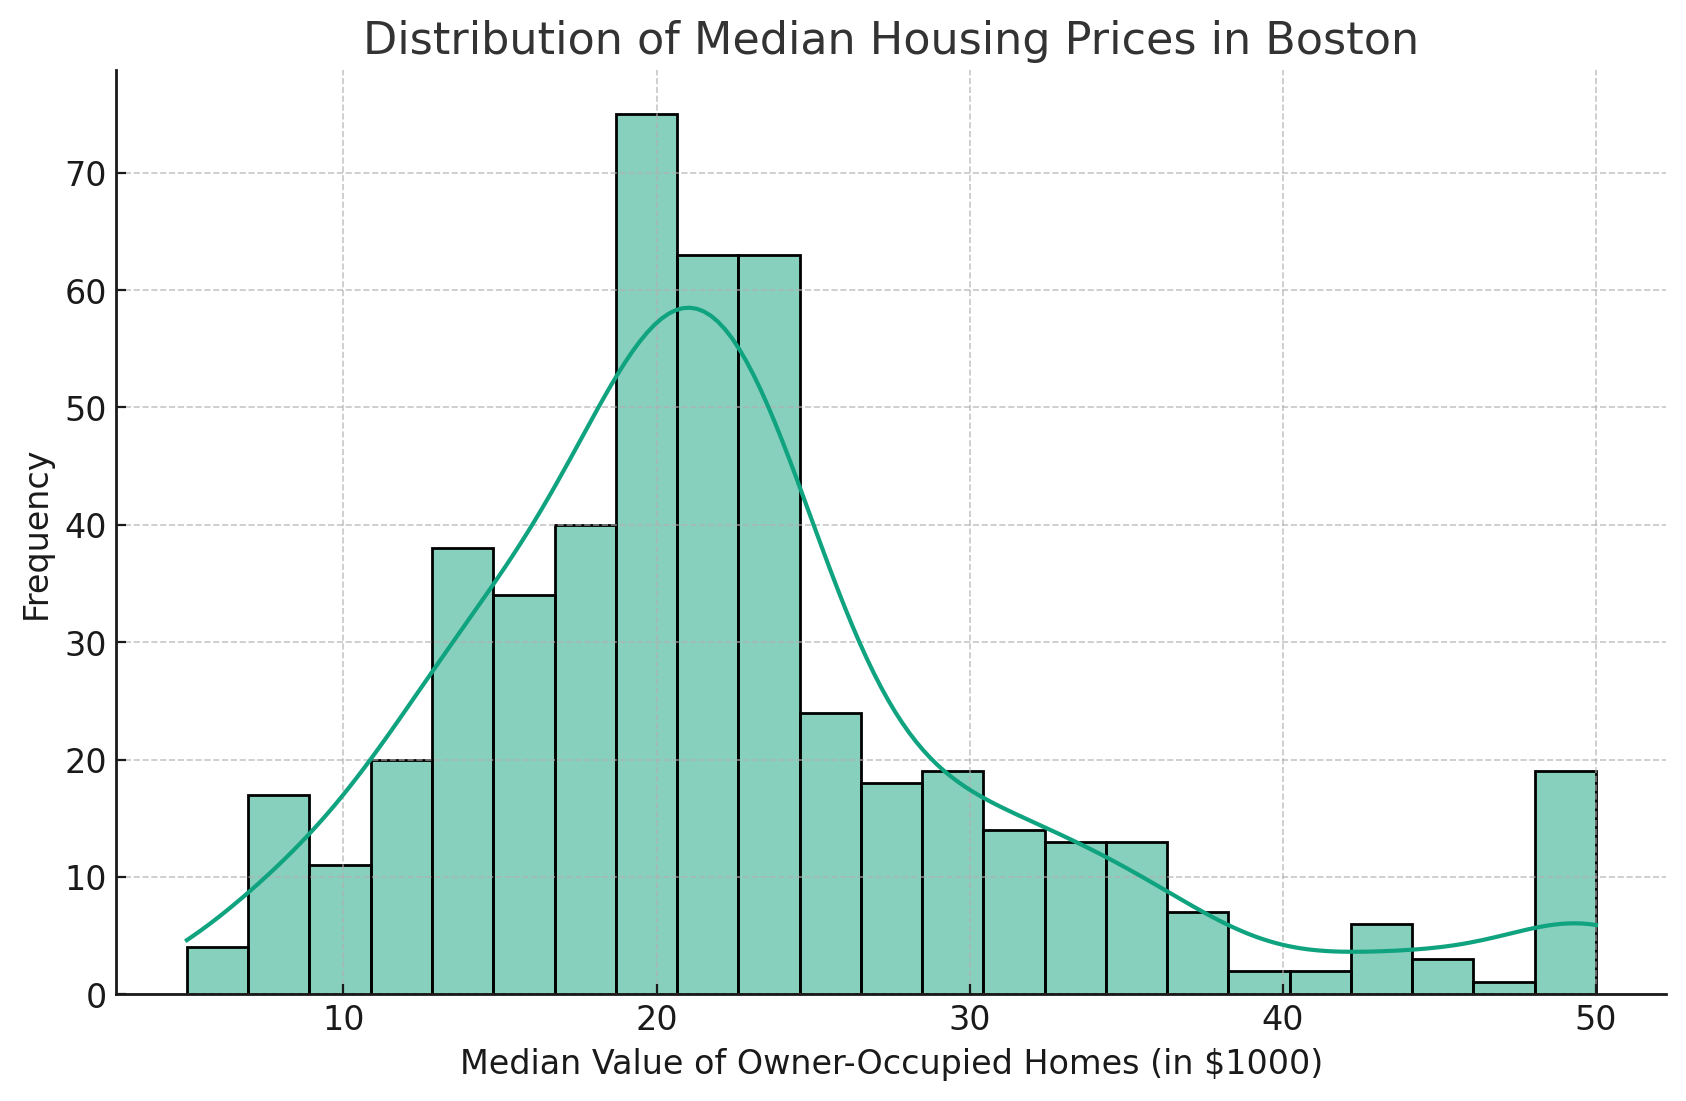
Penambahan garis Kernel Density Estimate (KDE) memberikan estimasi distribusi yang lebih mulus.
Parameter hue memungkinkan perbandingan kategori berbeda dalam histogram.
Parameter ini memungkinkan kita membedakan berbagai kategori dalam histogram yang sama, sehingga memberikan perbandingan visual atas distribusi.
Sederhananya, parameter ini mengambil kolom kategorikal dari DataFrame dan membedakan data menggunakan warna yang berbeda.
Sebagai contoh, jika kita memiliki kolom bernama 'CHAS' dalam DataFrame, yang menunjukkan apakah sebuah rumah berada di sepanjang Sungai Charles (1) atau tidak (0), kita dapat menggunakan parameter 'hue' untuk membandingkan distribusi harga rumah median untuk rumah yang dekat sungai versus yang tidak.
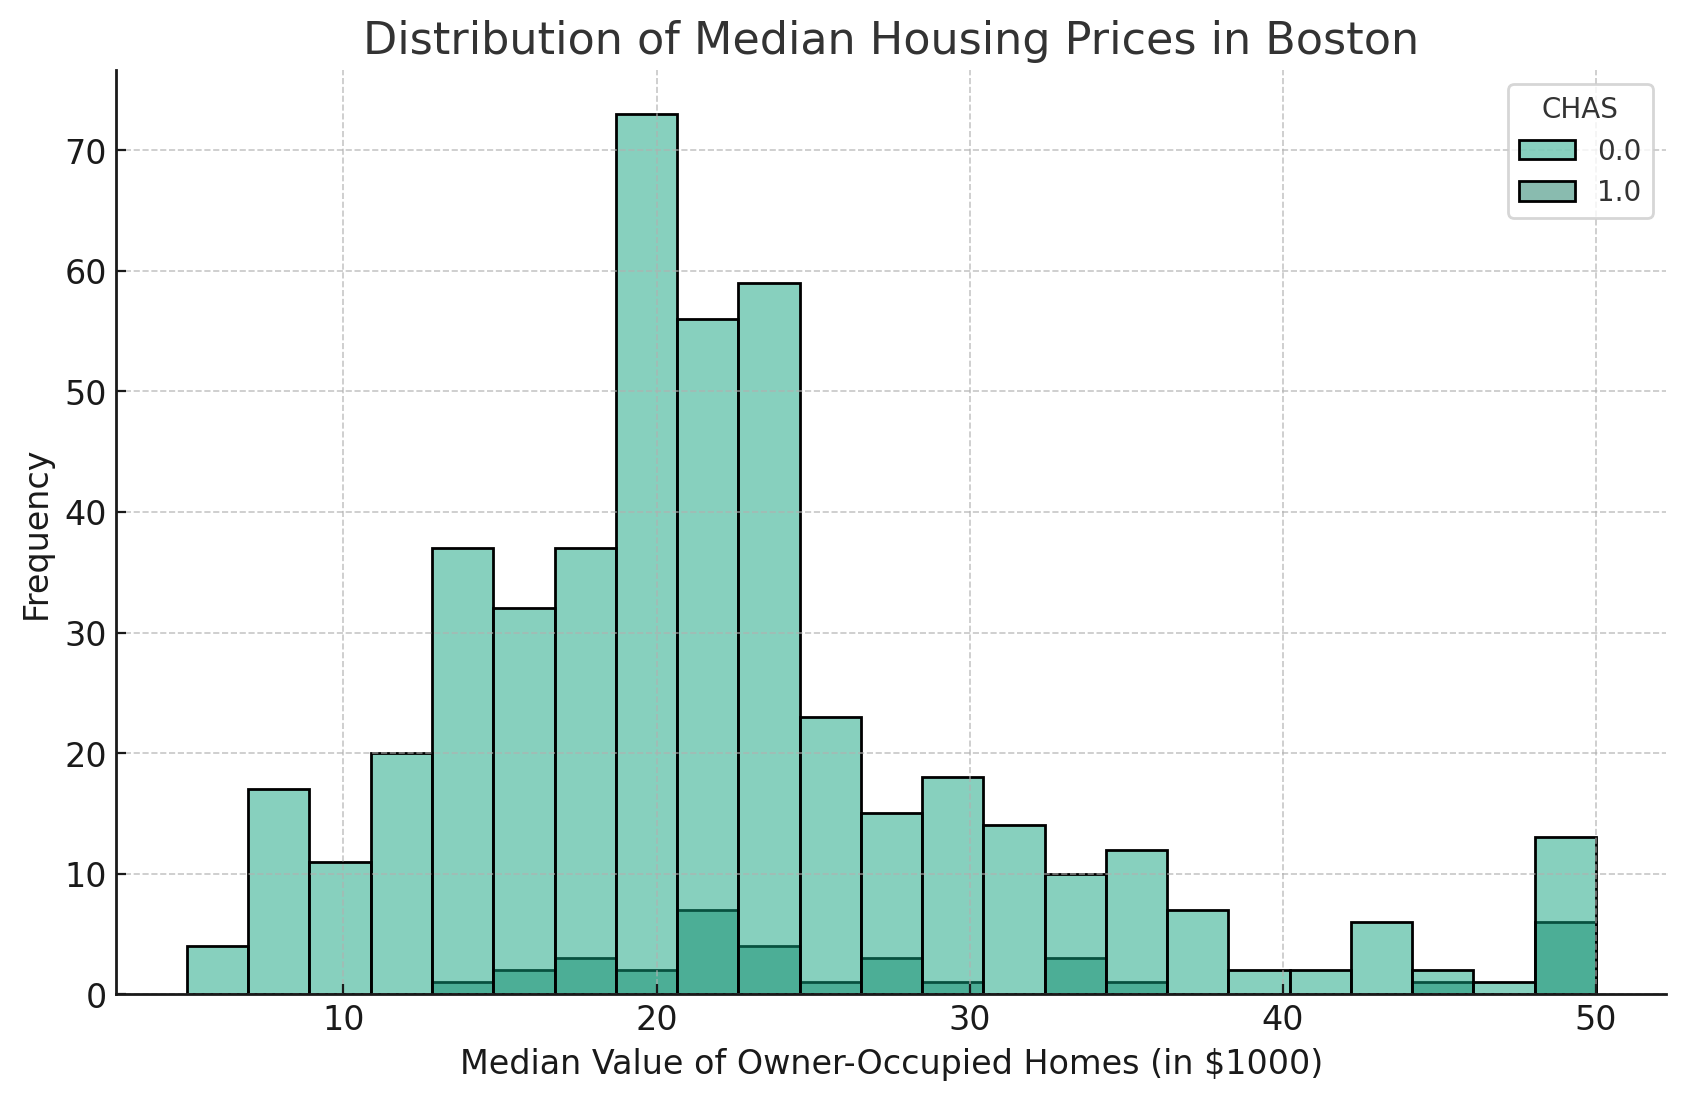
Kodenya akan terlihat sebagai berikut:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', hue='CHAS')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Ini akan menghasilkan histogram di mana distribusi MEDV untuk rumah yang berbatasan dengan Sungai Charles (CHAS=1) dibedakan dari yang tidak berbatasan (CHAS=0), masing-masing diwakili oleh warna berbeda.
Saat Anda membangun histogram Seaborn, ada beberapa hal yang perlu diingat, seperti yang diuraikan di bawah ini:
Memilih jumlah bin yang optimal adalah kunci untuk membuat histogram yang informatif. Meskipun jumlah bin yang lebih tinggi dapat memberikan lebih banyak detail, hal itu juga dapat menyebabkan overfitting dan salah merepresentasikan data.
Di sisi lain, terlalu sedikit bin dapat menyederhanakan distribusi secara berlebihan.
Salah satu cara untuk memilih jumlah bin yang tepat adalah dengan menggunakan aturan praktis yang disebut Aturan Scott (Scott's Rule). Aturan ini menghitung ukuran bin ideal berdasarkan jumlah titik data dalam dataset.
Walaupun penting untuk memberikan detail yang cukup dalam histogram, memastikan bahwa visualisasi tetap jelas dan mudah ditafsirkan juga krusial.
Menambahkan terlalu banyak elemen, seperti garis KDE atau terlalu banyak warna, dapat menyebabkan visual yang berantakan dan sulit dipahami.
Sebaiknya temukan keseimbangan antara menambahkan elemen informatif dan mempertahankan kesederhanaan.
Jenis data yang divisualisasikan juga berperan dalam pemilihan parameter histogram yang sesuai.
Misalnya, variabel kontinu akan memerlukan ukuran bin yang berbeda dibandingkan variabel kategorikal.
Penting untuk mempertimbangkan sifat data saat membuat histogram agar representasi distribusinya akurat.
Namun, Seaborn hanyalah salah satu pustaka yang tersedia untuk visualisasi data di Python. Anda juga bisa mempertimbangkan membuat histogram di Matplotlib jika Anda lebih menyukainya.
Seaborn adalah pustaka yang kuat untuk membuat visualisasi di Python, dan fungsi `histplot` memudahkan pembuatan histogram. Hanya dengan mengubah parameter dalam fungsi, Anda dapat memodifikasi tampilan bagan untuk mencapai tingkat detail dan estetika yang Anda inginkan.
Ingat semua kiat histogram Seaborn yang disebutkan di atas: selalu pertimbangkan jenis data, pilih ukuran bin yang sesuai, dan seimbangkan detail dengan kejelasan saat membuat histogram menggunakan Seaborn.
Tertarik mempelajari lebih lanjut tentang Seaborn dan kapabilitas visualisasi data kuat lainnya? Kursus Introduction to Data Visualization with Seaborn kami sangat cocok untuk pemula.
Mulai Perjalanan Anda dengan Seaborn Hari Ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



