
Cursus
Introductie tot datavisualisatie met Seaborn
4 uur
184.5K
Datavisualisatie is een cruciaal onderdeel bij het interpreteren van complexe datasets.
Binnen het Python-ecosysteem onderscheidt Seaborn zich als een krachtige bibliotheek voor het maken van aantrekkelijke en informatieve statistische visualisaties zoals histogrammen en lijndiagrammen.
Het bouwt voort op de mogelijkheden van Matplotlib, verbetert de interface en biedt meer opties voor datavisualisatie, vooral voor statistische analyses. Dankzij de naadloze integratie met Pandas DataFrames is Seaborn favoriet bij data scientists en analisten.
In deze uitgebreide gids focussen we op een van de meest gebruikte grafieken in Seaborn—het histogram.
sns.histplot-functieDe functie sns.histplot in Seaborn is bedoeld voor het tekenen van histogrammen, die essentieel zijn om de verdeling van continue data te onderzoeken. Deze functie is veelzijdig en biedt uitgebreide aanpassingsmogelijkheden, zodat je gemakkelijker betekenisvolle inzichten uit de data kunt halen.
Dit is een van de vele functies uit de Seaborn-bibliotheek. Bekijk onderstaande cheatsheet voor een snel overzicht.
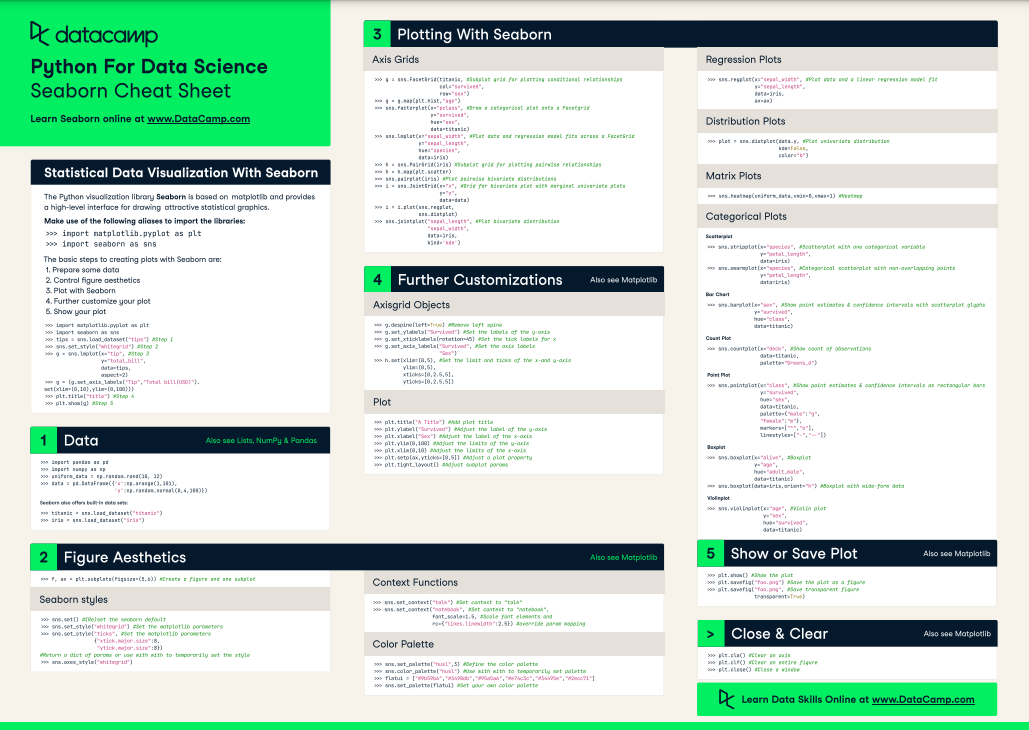
Seaborn-cheatsheet voor data science - bron
Voordat we met datavisualisatie aan de slag gaan, moeten we onze omgeving inrichten. Dit houdt in dat we de nodige bibliotheken importeren, met Seaborn als belangrijkste. Seaborn wordt voor het gemak meestal geïmporteerd als sns.
Naast Seaborn zijn andere essentiële bibliotheken vaak NumPy voor numerieke bewerkingen, pandas voor datahandling en Matplotlib voor extra aanpassingsopties.
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Dit zijn allemaal essentiële bibliotheken die de nodige tools bieden om datavisualisaties in Python te maken en te bewerken. Het zijn de meest gebruikte bibliotheken voor data-analisten en data scientists.
Als je net begint met Python leren, probeer dan onze cursus Inleiding tot Python. Voor verdere verdieping in pandas, NumPy en Matplotlib: onze cursussen Data Manipulation met pandas, Inleiding tot NumPy en Inleiding tot datavisualisatie met Matplotlib.
We gebruiken de Boston Housing Prices-dataset, die je kunt laden uit de Scikit-Learn-bibliotheek. Deze dataset bevat woningwaarden in verschillende gebieden van Boston, samen met diverse kenmerken zoals misdaadcijfer, gemiddeld aantal kamers, enz.
from sklearn.datasets import load_boston
boston = load_boston()
df = pd.DataFrame(boston.data, columns=boston.feature_names)
df['MEDV'] = boston.target
Geschikte data voor je histogrammen bepalen of ze slagen of falen. In dit geval gebruiken we een continue variabele: de mediane waarde van door eigenaren bewoonde huizen (MEDV) in Boston.
Omdat histogrammen doorgaans de verdeling van één variabele tonen, kiezen we één kolom uit onze DataFrame.
Nieuw met Scikit-Learn? Probeer onze tutorial over Machine Learning met Python. Wil je meer informatie, dan helpt onze cursus Supervised Learning met scikit-learn je om de basis te dekken.
Voordat je begint, zijn dit enkele basisvereisten voor je je Seaborn-histogram gaat bouwen:
We beginnen met het doornemen van een deel van de gangbare syntaxis en parameters van de `sns.histplot`-functie.
De basale syntaxis voor het maken van een histogram met `sns.histplot` is eenvoudig.
Belangrijke parameters zijn onder andere:
data: De dataset, vaak een Pandas DataFrame.x: De variabele waarvoor het histogram wordt getekend.color: Om de kleur van de balken op te geven.alpha: De transparantie van de balken.bins: Het aantal bins (balkgroepen) dat wordt gebruikt.binwidth: De breedte van elke bin.kde: Een boolean om een Kernel Density Estimate-plot toe te voegen.hue: Om datasubsets te onderscheiden op basis van een andere variabele.De functie accepteert veel parameters en argumenten, maar we focussen op de parameters die we voor onze dataset nodig hebben.
Laten we een basis-histogram maken om de verdeling van de mediane woningprijzen (MEDV) te visualiseren.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Deze opdracht toont het histogram voor de kolom MEDV.
Hier is de plot die door deze code is gegenereerd:
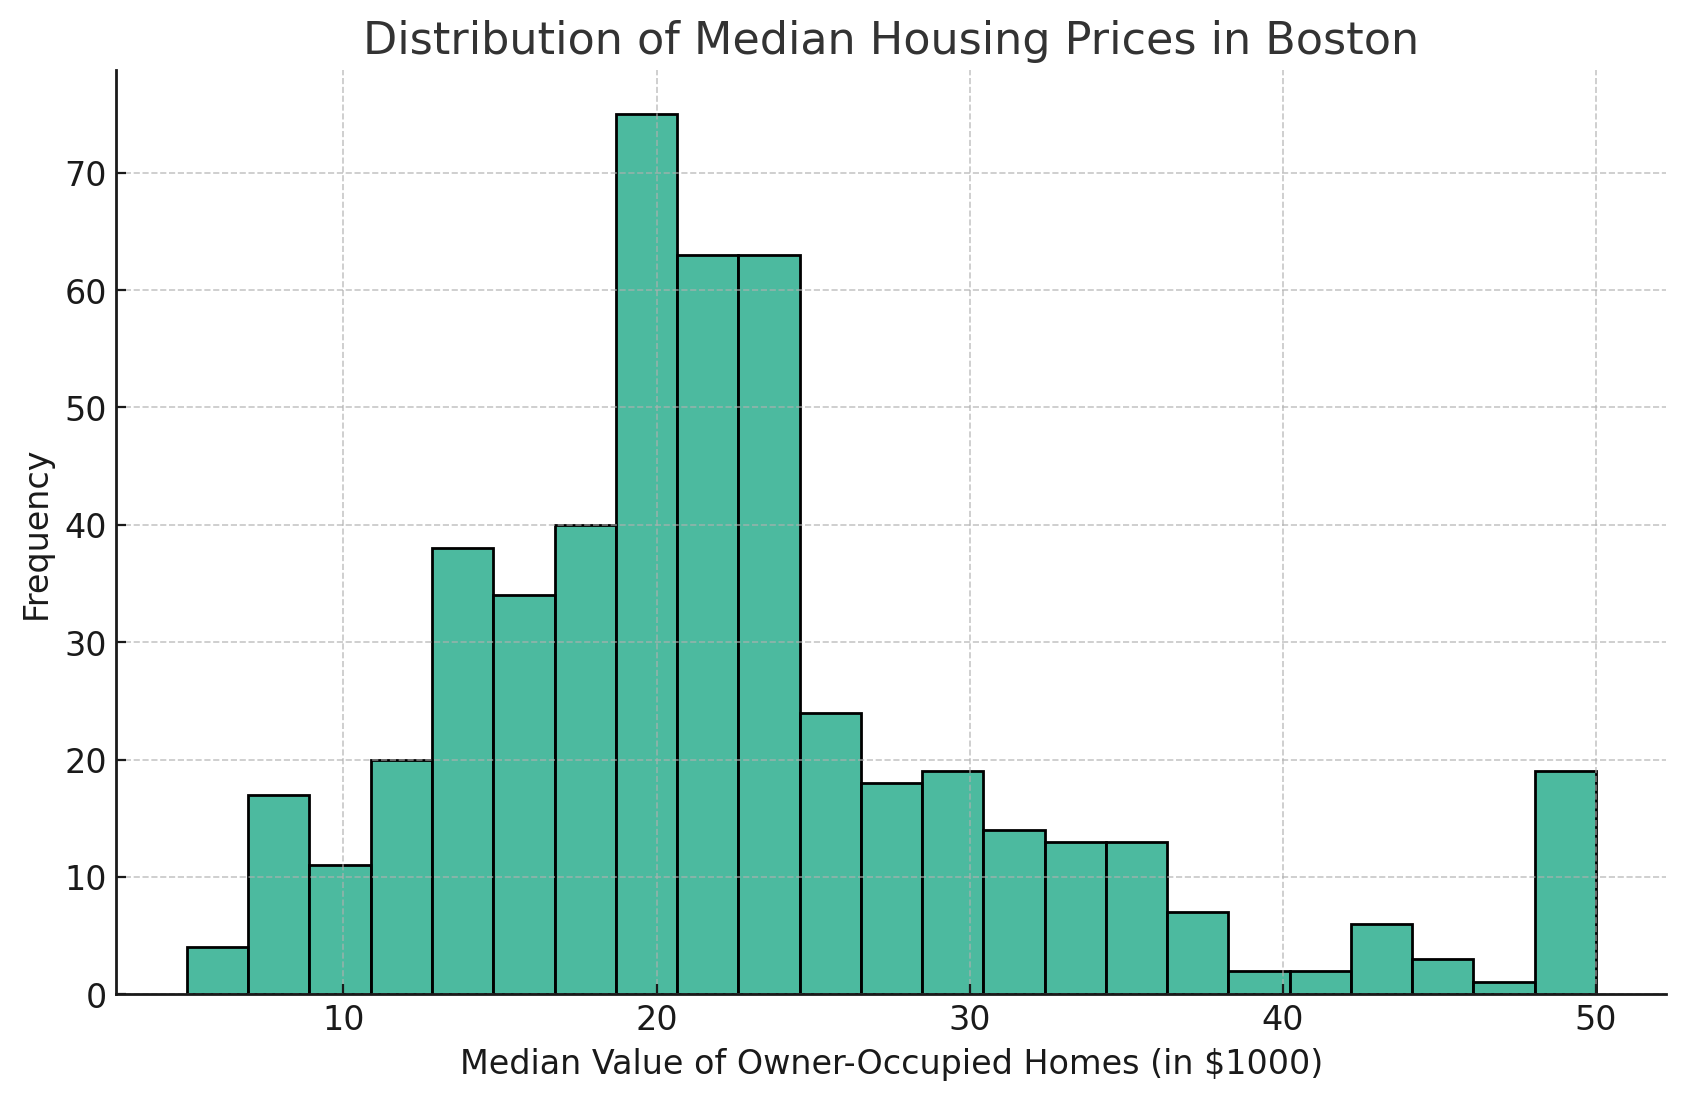
Hier zie je het histogram dat de verdeling van de mediane woningprijzen (MEDV) in de Boston-dataset weergeeft. Het histogram geeft een visuele weergave van de frequentieverdeling van de mediane waarden van door eigenaren bewoonde huizen.
Het aanpassen van het aantal bins kan helpen om de verdeling beter te begrijpen. Meer bins kunnen meer details onthullen, terwijl minder bins de visualisatie vereenvoudigen.
Om het aantal bins te verhogen, kun je de parameter bins aanpassen.
Hier is een voorbeeld:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', bins=30)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
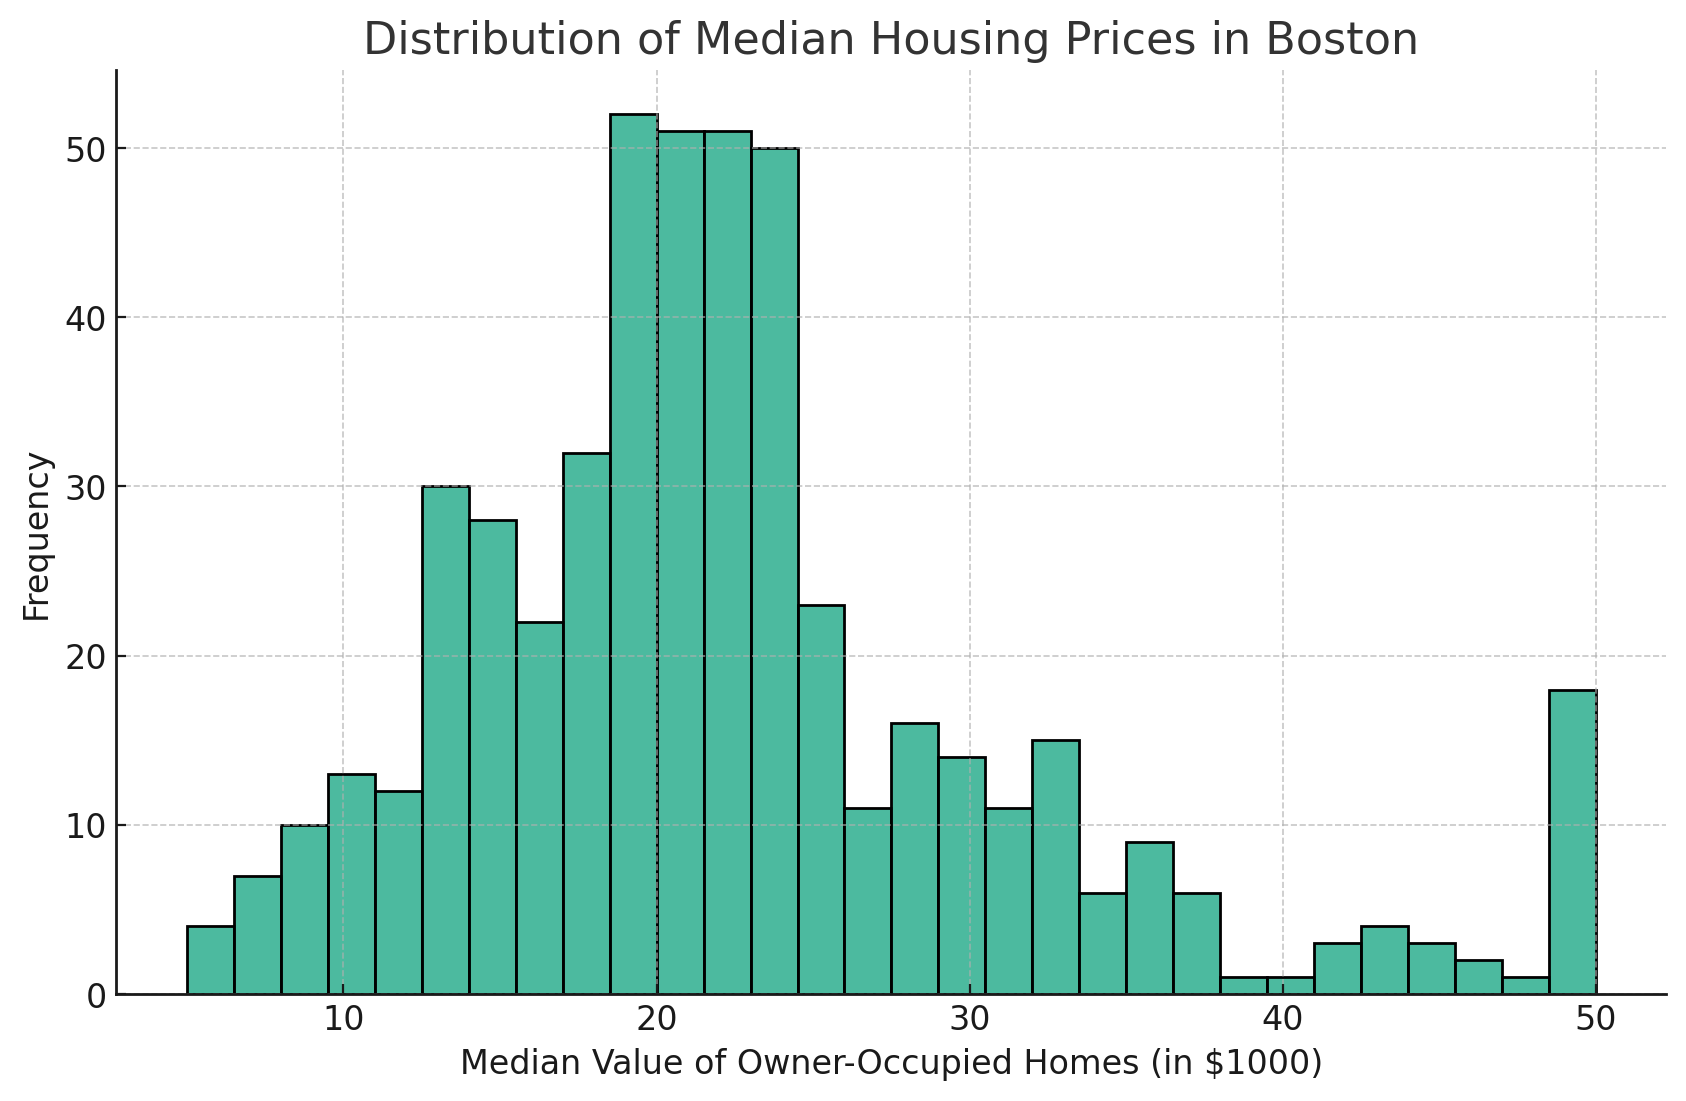
Zoals je ziet in het Seaborn-histogram hierboven, is het aantal balken toegenomen tot het door mij ingestelde aantal, in dit geval 30. Dit is een goede manier om meer detail in je data aan te brengen.
Door de vormgeving aan te passen, zoals het veranderen van de balkkleur en de transparantie, kun je het histogram informatiever en aantrekkelijker maken.
In het onderstaande voorbeeld heb ik ons oorspronkelijke histogram opnieuw gemaakt met paars in plaats van de standaardkleur.
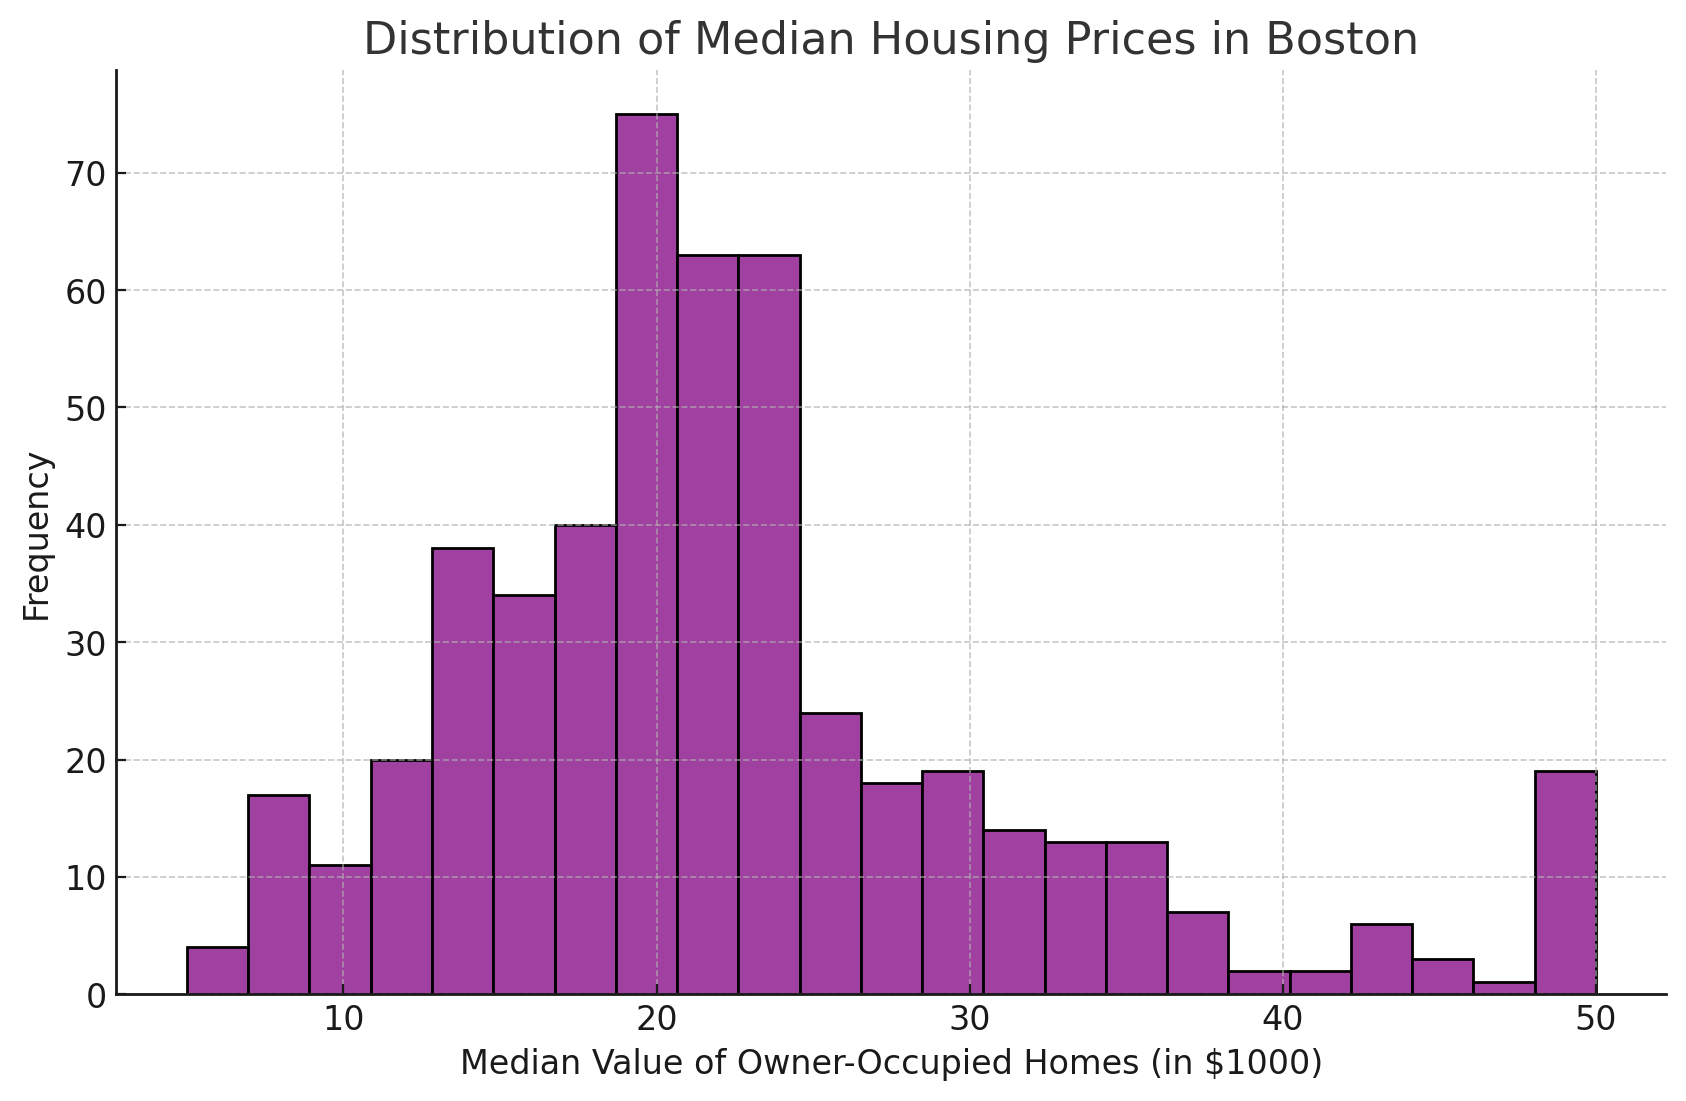
Hier is de code die ik heb gebruikt om de bovenstaande grafiek te maken.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', color='purple')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
KDE geeft een vloeiende schatting van de dataverdeling. Dit kan vooral nuttig zijn om patronen in de data te identificeren.
Dit creëert een vloeiende lijncurve die helpt om de algemene trends te visualiseren.
Om dit te bereiken, gebruiken we de parameter kde in deze functie:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', kde=True)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Dit voegt een mooie curve toe aan ons histogram, zoals hieronder te zien is.
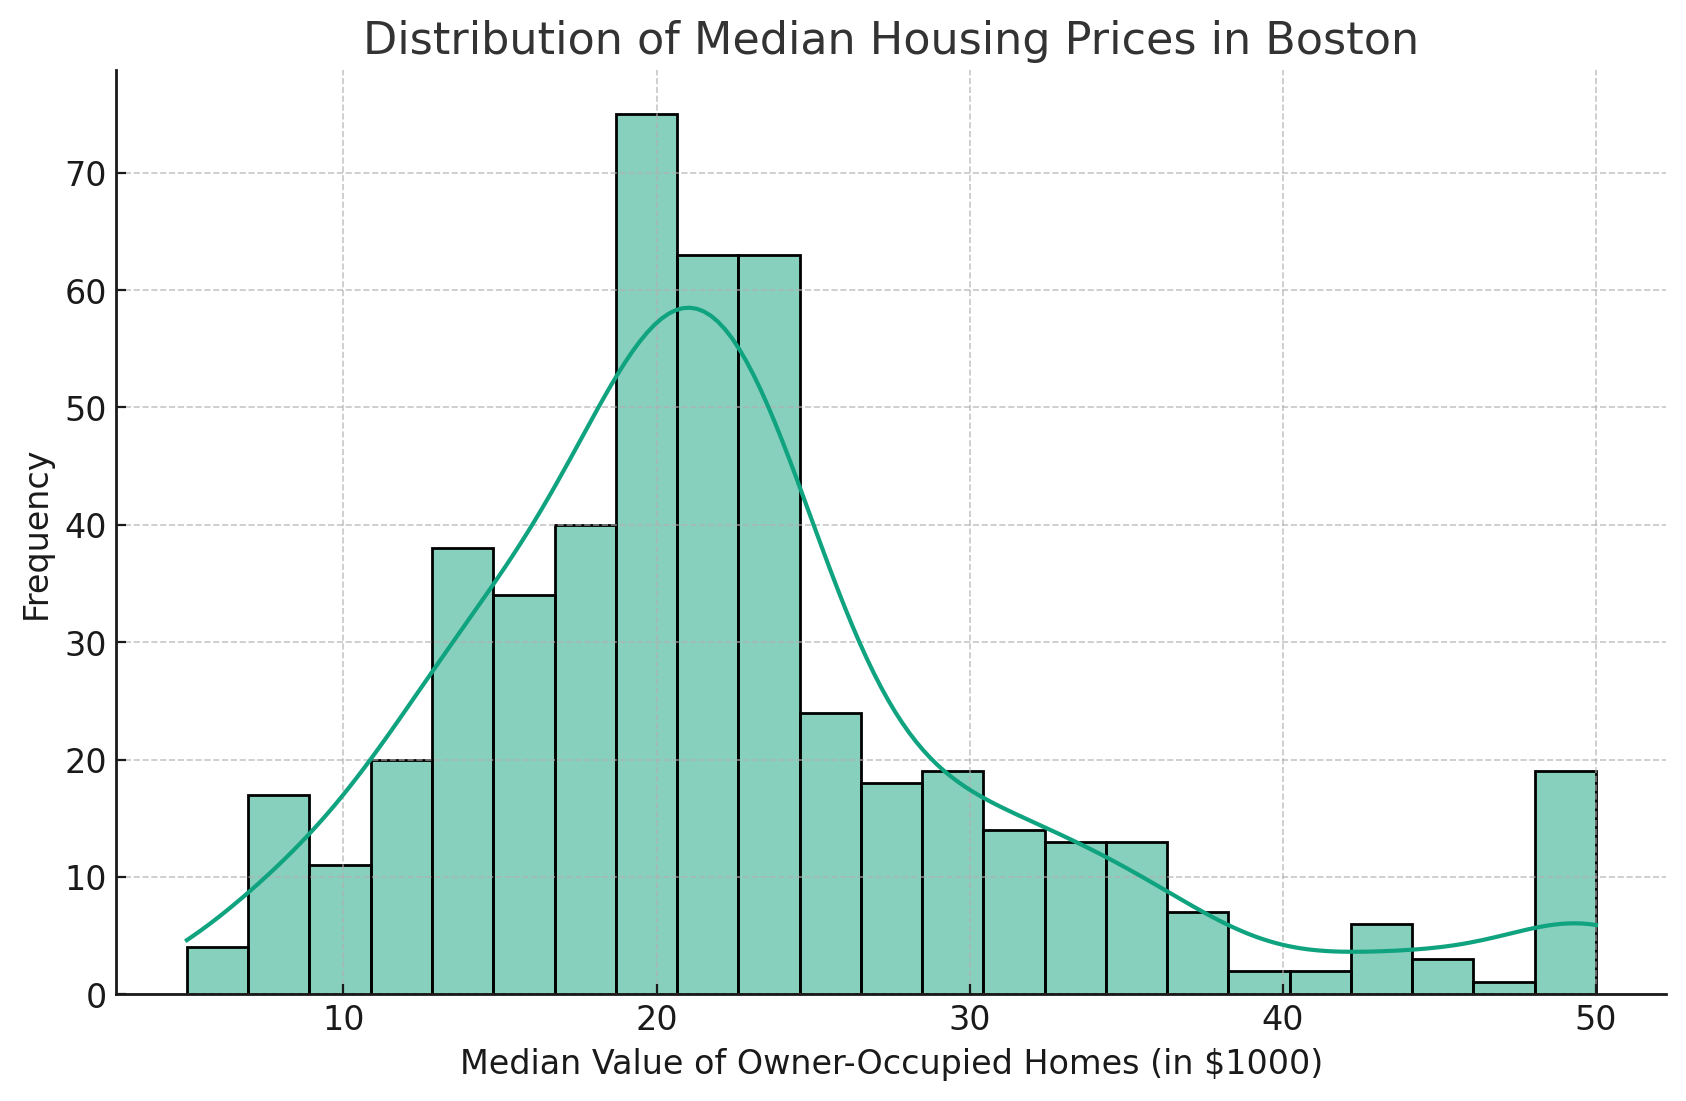
De toevoeging van de Kernel Density Estimate (KDE)-lijn geeft een gladdere schatting van de verdeling.
Met de parameter hue kun je verschillende categorieën binnen het histogram vergelijken.
Met deze parameter kunnen we verschillende categorieën binnen hetzelfde histogram onderscheiden, wat een visuele vergelijking van verdelingen oplevert.
Simpel gezegd: hij neemt een categorische kolom uit de DataFrame en onderscheidt de data met verschillende kleuren.
Als we bijvoorbeeld een kolom 'CHAS' in onze DataFrame hebben, die aangeeft of een huis aan de Charles River ligt (1) of niet (0), dan kunnen we de parameter 'hue' gebruiken om de verdeling van mediane woningprijzen te vergelijken voor huizen die bij de rivier liggen versus huizen die dat niet doen.
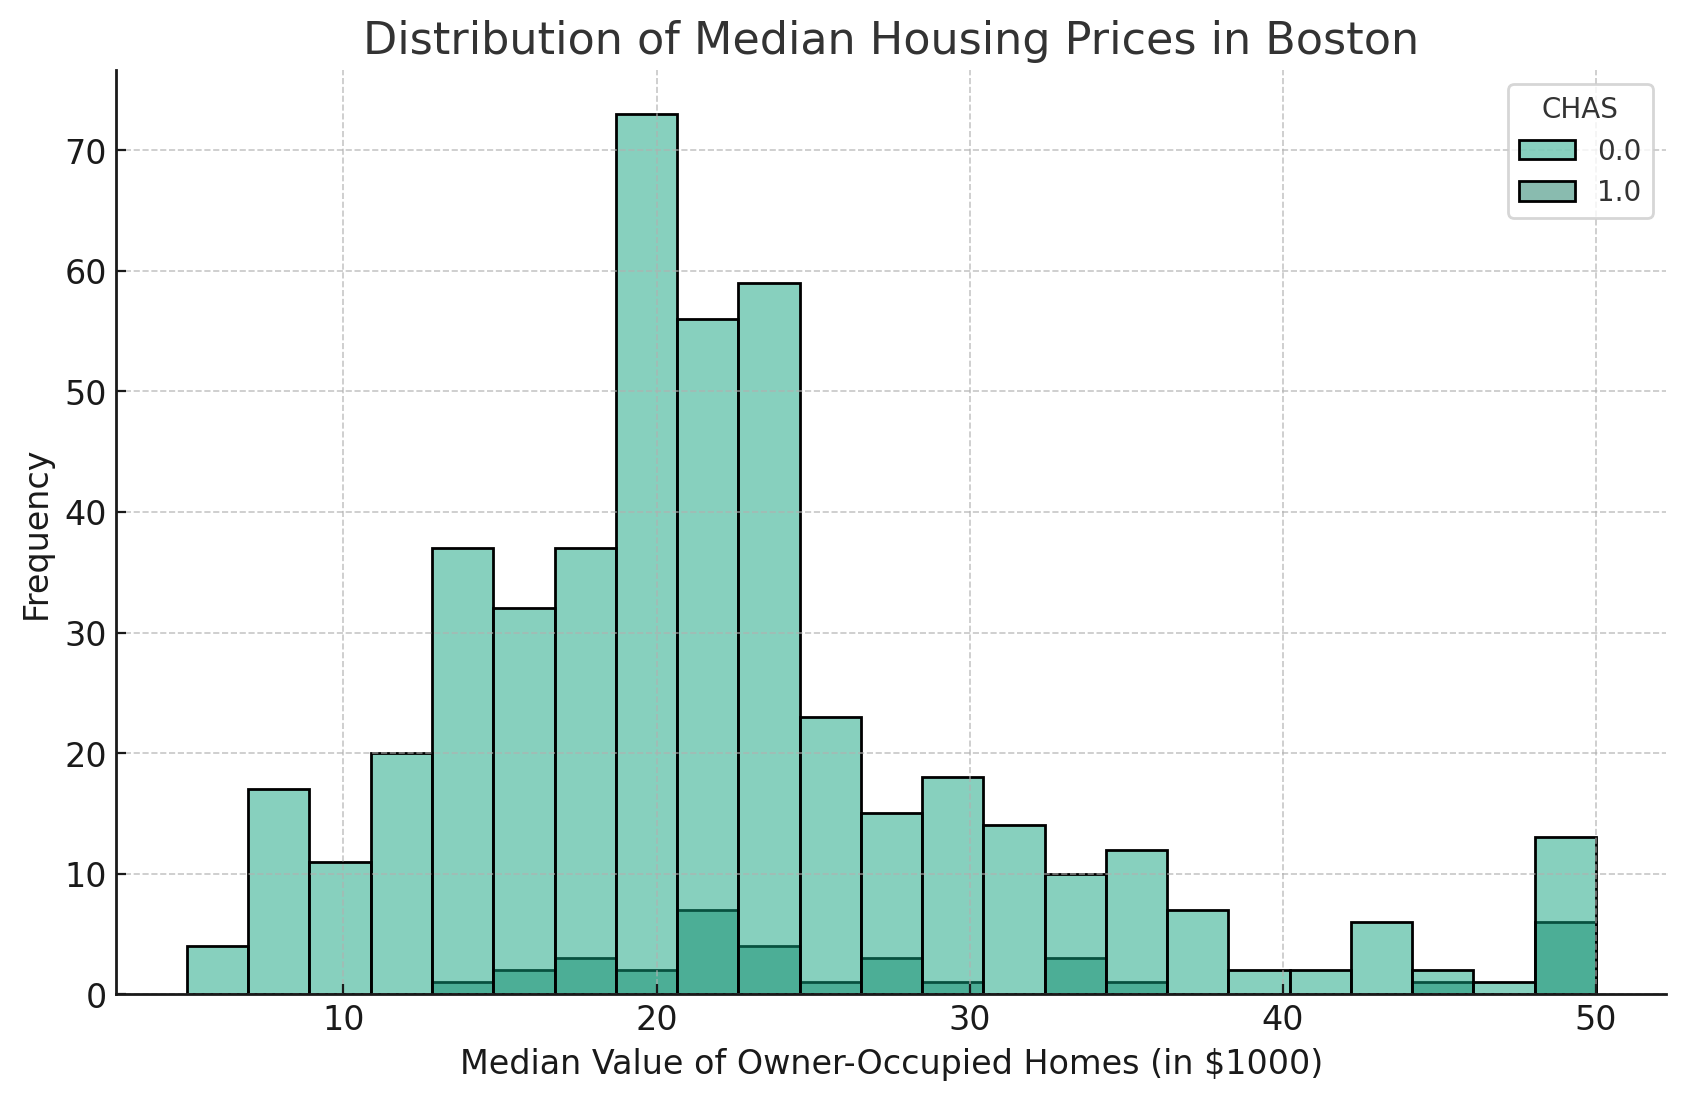
De code ziet er als volgt uit:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', hue='CHAS')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Dit genereert een histogram waarin de verdeling van MEDV voor huizen aan de Charles River (CHAS=1) wordt onderscheiden van die voor huizen niet aan de rivier (CHAS=0), elk weergegeven in een andere kleur.
Bij het bouwen van Seaborn-histogrammen zijn er verschillende aandachtspunten, zoals hieronder uiteengezet:
Het kiezen van het optimale aantal bins is cruciaal voor een informatief histogram. Hoewel meer bins meer detail kunnen bieden, kan dit ook leiden tot overfitting en een vertekende weergave van de data.
Aan de andere kant kunnen te weinig bins de verdeling te veel versimpelen.
Een manier om het juiste aantal bins te kiezen is door een vuistregel te gebruiken, zoals de regel van Scott. Deze regel berekent de ideale bingrootte op basis van het aantal datapunten in de dataset.
Hoewel het belangrijk is om genoeg detail in een histogram te bieden, is het ook cruciaal om de visualisatie helder en makkelijk te interpreteren te houden.
Te veel elementen toevoegen, zoals KDE-lijnen of te veel kleuren, kan leiden tot rommelige visuals die lastig te begrijpen zijn.
Het is het beste om een balans te vinden tussen informatieve elementen en eenvoud.
Het type data dat je visualiseert speelt ook een rol bij het kiezen van de juiste histogramparameters.
Continue variabelen vereisen bijvoorbeeld andere bingroottes dan categorische variabelen.
Het is belangrijk om rekening te houden met de aard van de data bij het maken van histogrammen, zodat ze de verdeling nauwkeurig weergeven.
Houd er echter rekening mee dat Seaborn slechts één van de beschikbare bibliotheken voor datavisualisatie in Python is. Je kunt er ook voor kiezen om je histogrammen in Matplotlib te maken als je dat prettiger vindt.
Seaborn is een krachtige bibliotheek voor het maken van visualisaties in Python, en met de functie `histplot` kun je eenvoudig histogrammen maken. Door simpelweg de parameters binnen de functie te wijzigen, kun je de uitstraling van je grafiek aanpassen om het gewenste detailniveau en de gewenste vormgeving te bereiken.
Onthoud alle hierboven genoemde tips voor Seaborn-histogrammen: houd altijd rekening met het type data, kies passende bingroottes en houd de balans tussen detail en helderheid bij het maken van histogrammen met Seaborn.
Wil je meer leren over Seaborn en de andere krachtige mogelijkheden voor datavisualisatie? Onze cursus Inleiding tot datavisualisatie met Seaborn is een uitstekende cursus voor beginners.
Begin vandaag nog aan je Seaborn-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

