
कोर्स
Seaborn के साथ Data Visualization परिचय
4 घंटा
184.6K
जटिल डेटा सेट्स की व्याख्या में डेटा विज़ुअलाइज़ेशन एक महत्वपूर्ण घटक है।
Python प्रोग्रामिंग के क्षेत्र में, Seaborn हिस्टोग्राम और लाइन प्लॉट्स जैसी आकर्षक और सूचनाप्रद सांख्यिकीय ग्राफ़िक्स बनाने के लिए एक शक्तिशाली लाइब्रेरी के रूप में उभरकर सामने आती है।
यह Matplotlib की क्षमताओं पर आधारित है, उसके इंटरफ़ेस को बेहतर बनाती है और विशेष रूप से सांख्यिकीय विश्लेषण के लिए विज़ुअलाइज़ेशन के अधिक विकल्प प्रदान करती है। Pandas DataFrames के साथ Seaborn का सहज एकीकरण इसे डेटा वैज्ञानिकों और विश्लेषकों के बीच पसंदीदा बनाता है।
इस विस्तृत गाइड में, हम Seaborn में सबसे अधिक उपयोग होने वाले प्लॉट्स में से एक—हिस्टोग्राम—पर ध्यान केंद्रित करेंगे।
sns.histplot फ़ंक्शन का अवलोकनSeaborn में sns.histplot फ़ंक्शन हिस्टोग्राम ड्रॉ करने के लिए बनाया गया है, जो सतत डेटा के वितरण की जाँच के लिए आवश्यक होते हैं। यह फ़ंक्शन बहुमुखी है और व्यापक कस्टमाइज़ेशन की अनुमति देता है, जिससे डेटा से सार्थक अंतर्दृष्टि निकालना आसान हो जाता है।
यह फ़ंक्शन Seaborn लाइब्रेरी में उपलब्ध कई फ़ंक्शनों में से एक है। त्वरित अवलोकन के लिए नीचे दिए गए चीट शीट पर नज़र डालें।
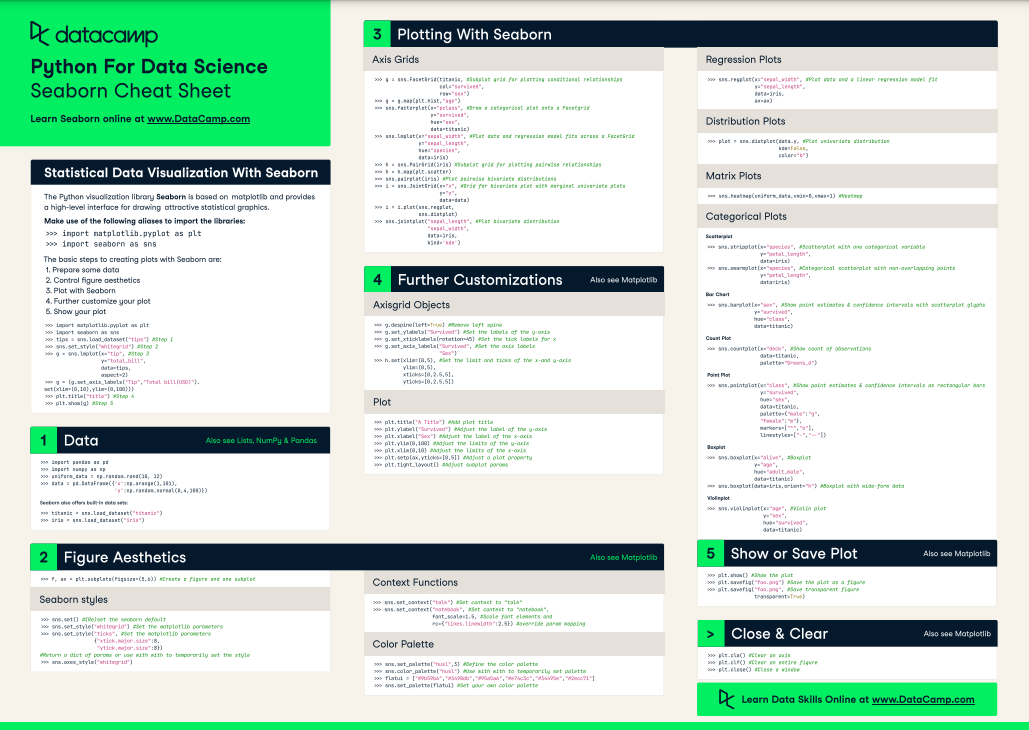
डेटा साइंस के लिए Seaborn चीट शीट - स्रोत
डेटा विज़ुअलाइज़ेशन में उतरने से पहले, हमें अपना वातावरण सेट करना होगा। इसमें आवश्यक लाइब्रेरीज़ इम्पोर्ट करना शामिल है, जिनमें Seaborn प्राथमिक फोकस है। सुविधा के लिए Seaborn को आम तौर पर sns के रूप में इम्पोर्ट किया जाता है।
Seaborn के साथ-साथ, अन्य आवश्यक लाइब्रेरीज़ में संख्यात्मक ऑपरेशंस के लिए NumPy, डेटा हैंडलिंग के लिए pandas, और अतिरिक्त कस्टमाइज़ेशन विकल्पों के लिए Matplotlib शामिल हैं।
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
ये सभी आवश्यक लाइब्रेरीज़ हैं जो Python में डेटा विज़ुअलाइज़ेशन बनाने और उनमें बदलाव करने के लिए ज़रूरी टूल्स प्रदान करती हैं। ये डेटा विश्लेषकों और डेटा वैज्ञानिकों द्वारा सबसे अधिक उपयोग की जाने वाली लाइब्रेरीज़ हैं।
यदि आप Python सीखना शुरू कर रहे हैं, तो मैं आपको हमारा Introduction to Python कोर्स आज़माने का सुझाव देता हूँ। pandas, NumPy, और Matplotlib पर आगे सीखने के लिए हमारे Data Manipulation with pandas, Introduction to NumPy, और Introduction to Data Visualization with Matplotlib कोर्स देखें।
हम Boston Housing Prices डेटा सेट का उपयोग करेंगे, जिसे Scikit-Learn लाइब्रेरी से लोड किया जा सकता है। यह डेटा सेट बोस्टन के विभिन्न क्षेत्रों में आवास मूल्यों के साथ-साथ अपराध दर, औसत कमरों की संख्या आदि जैसे कई गुण प्रदान करता है।
from sklearn.datasets import load_boston
boston = load_boston()
df = pd.DataFrame(boston.data, columns=boston.feature_names)
df['MEDV'] = boston.target
आपके हिस्टोग्राम के लिए उपयुक्त डेटा होना ही उन्हें सफल या असफल बनाता है। इस मामले में, हम एक सतत चर का उपयोग कर रहे हैं—बोस्टन में मालिक द्वारा कब्जे वाले घरों का माध्य मान (MEDV)।
चूंकि हिस्टोग्राम आमतौर पर किसी एकल चर का वितरण दिखाते हैं, हम अपने DataFrame से एक कॉलम चुनेंगे।
Scikit-Learn में नए हैं? हमारा Python Machine Learning ट्यूटोरियल आज़माएँ। यदि आप और जानकारी चाहते हैं, तो हमारा Supervised Learning with scikit-learn कोर्स बुनियादी बातें कवर करने में मदद करेगा।
शुरू करने से पहले, Seaborn हिस्टोग्राम बनाने से पहले कुछ बुनियादी पूर्व-आवश्यकताएँ यहाँ दी गई हैं:
हम sns.histplot फ़ंक्शन के कुछ सामान्य सिंटैक्स और पैरामीटर्स से होकर शुरुआत करेंगे।
sns.histplot का उपयोग करके हिस्टोग्राम बनाने का मूल सिंटैक्स सीधा-सादा है।
मुख्य पैरामीटर्स में शामिल हैं:
data: डेटा सेट, जो अक्सर एक Pandas DataFrame होता है।x: वह वेरिएबल जिसके लिए हिस्टोग्राम प्लॉट किया जाता है।color: बार्स का रंग निर्दिष्ट करने के लिए।alpha: बार्स की पारदर्शिता।bins: उपयोग किए जाने वाले बिन्स (बार समूहों) की संख्या।binwidth: प्रत्येक बिन की चौड़ाई।kde: Kernel Density Estimate प्लॉट जोड़ने के लिए एक बूलियन।hue: किसी अन्य वेरिएबल के आधार पर डेटा सबसेट्स में अंतर करने के लिए।फ़ंक्शन कई पैरामीटर्स और आर्ग्युमेंट्स स्वीकार करता है, लेकिन हम अपने डेटा सेट के लिए आवश्यक लोगों पर ध्यान केंद्रित करेंगे।
आइए माध्य आवास मूल्यों (MEDV) के वितरण को विज़ुअलाइज़ करने के लिए एक बुनियादी हिस्टोग्राम बनाते हैं।
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
यह कमांड MEDV कॉलम के लिए हिस्टोग्राम प्रदर्शित करेगा।
इस कोड से उत्पन्न प्लॉट यहाँ है:
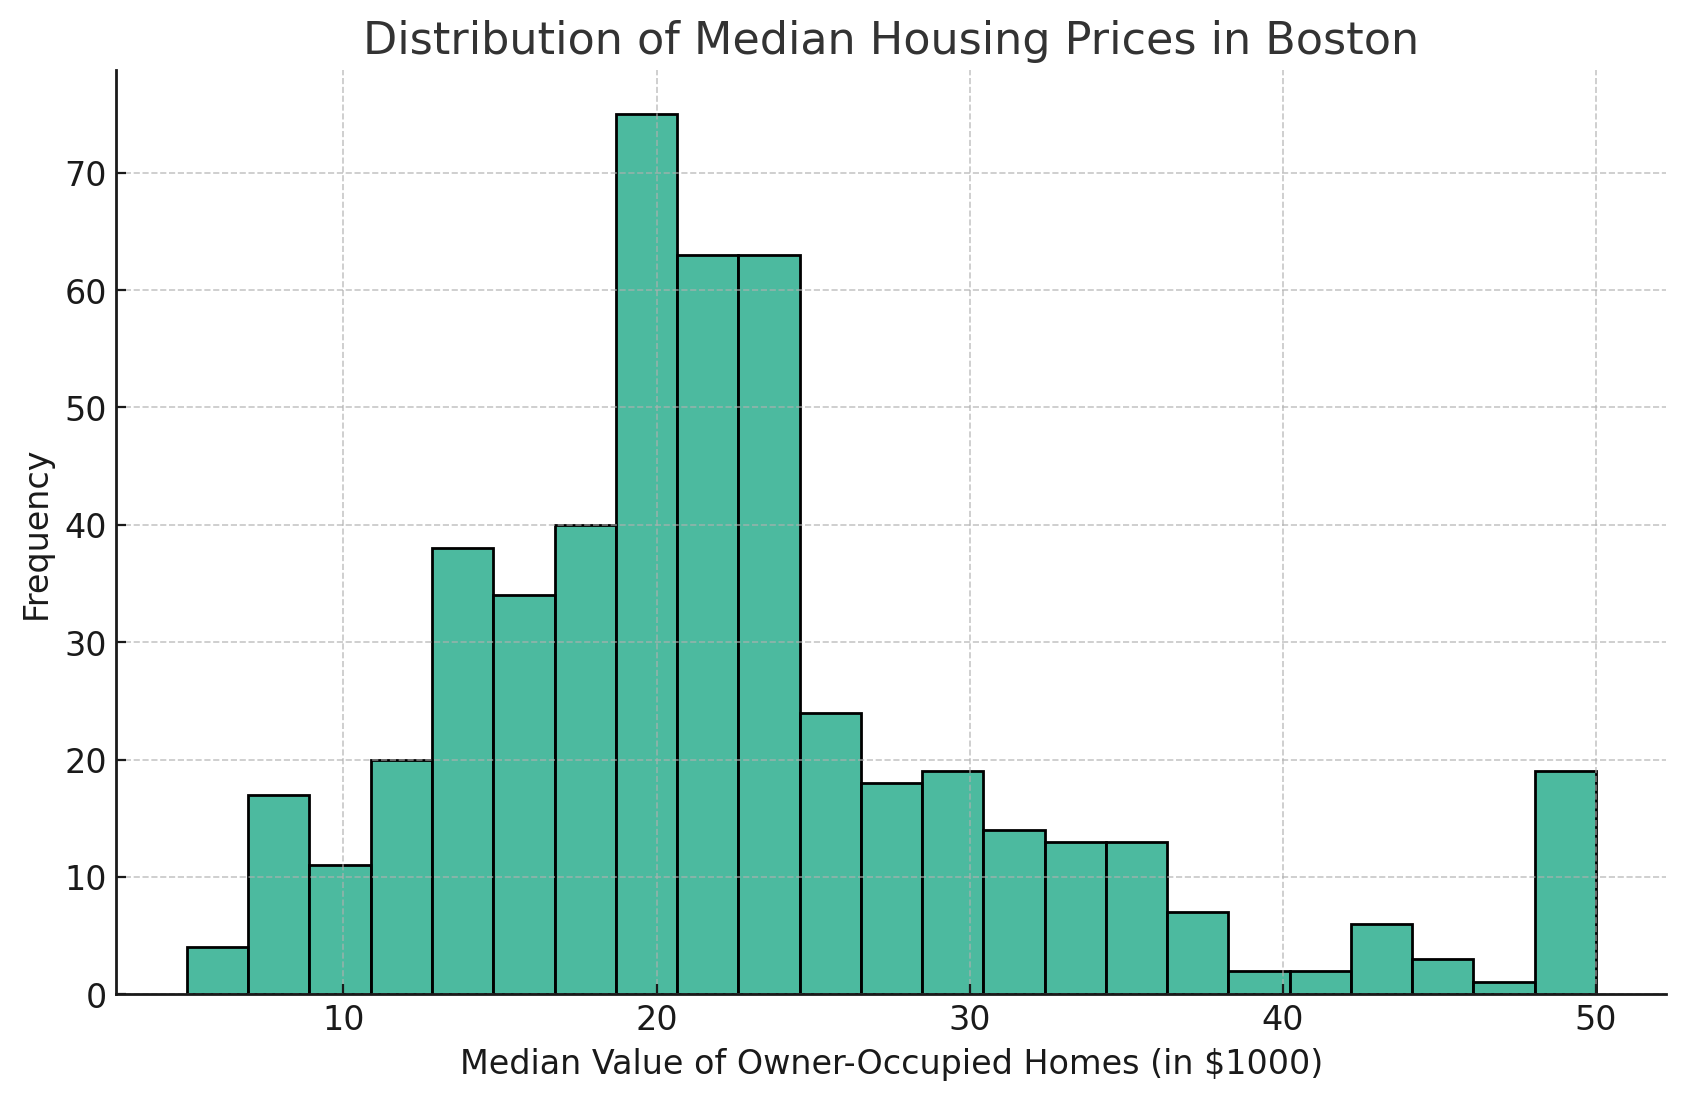
यहाँ बोस्टन डेटा सेट में माध्य आवास मूल्यों (MEDV) के वितरण को दर्शाता हिस्टोग्राम प्लॉट है। हिस्टोग्राम मालिक द्वारा कब्जे वाले घरों के माध्य मूल्यों के आवृत्ति वितरण का दृश्य प्रतिनिधित्व प्रदान करता है।
बिन्स की संख्या को समायोजित करने से वितरण को बेहतर ढंग से समझने में मदद मिल सकती है। अधिक बिन्स अधिक विवरण प्रकट कर सकते हैं, जबकि कम संख्या विज़ुअलाइज़ेशन को सरल बनाती है।
बिन्स की संख्या बढ़ाने के लिए, आप bins पैरामीटर को संशोधित कर सकते हैं।
यहाँ एक उदाहरण है:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', bins=30)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
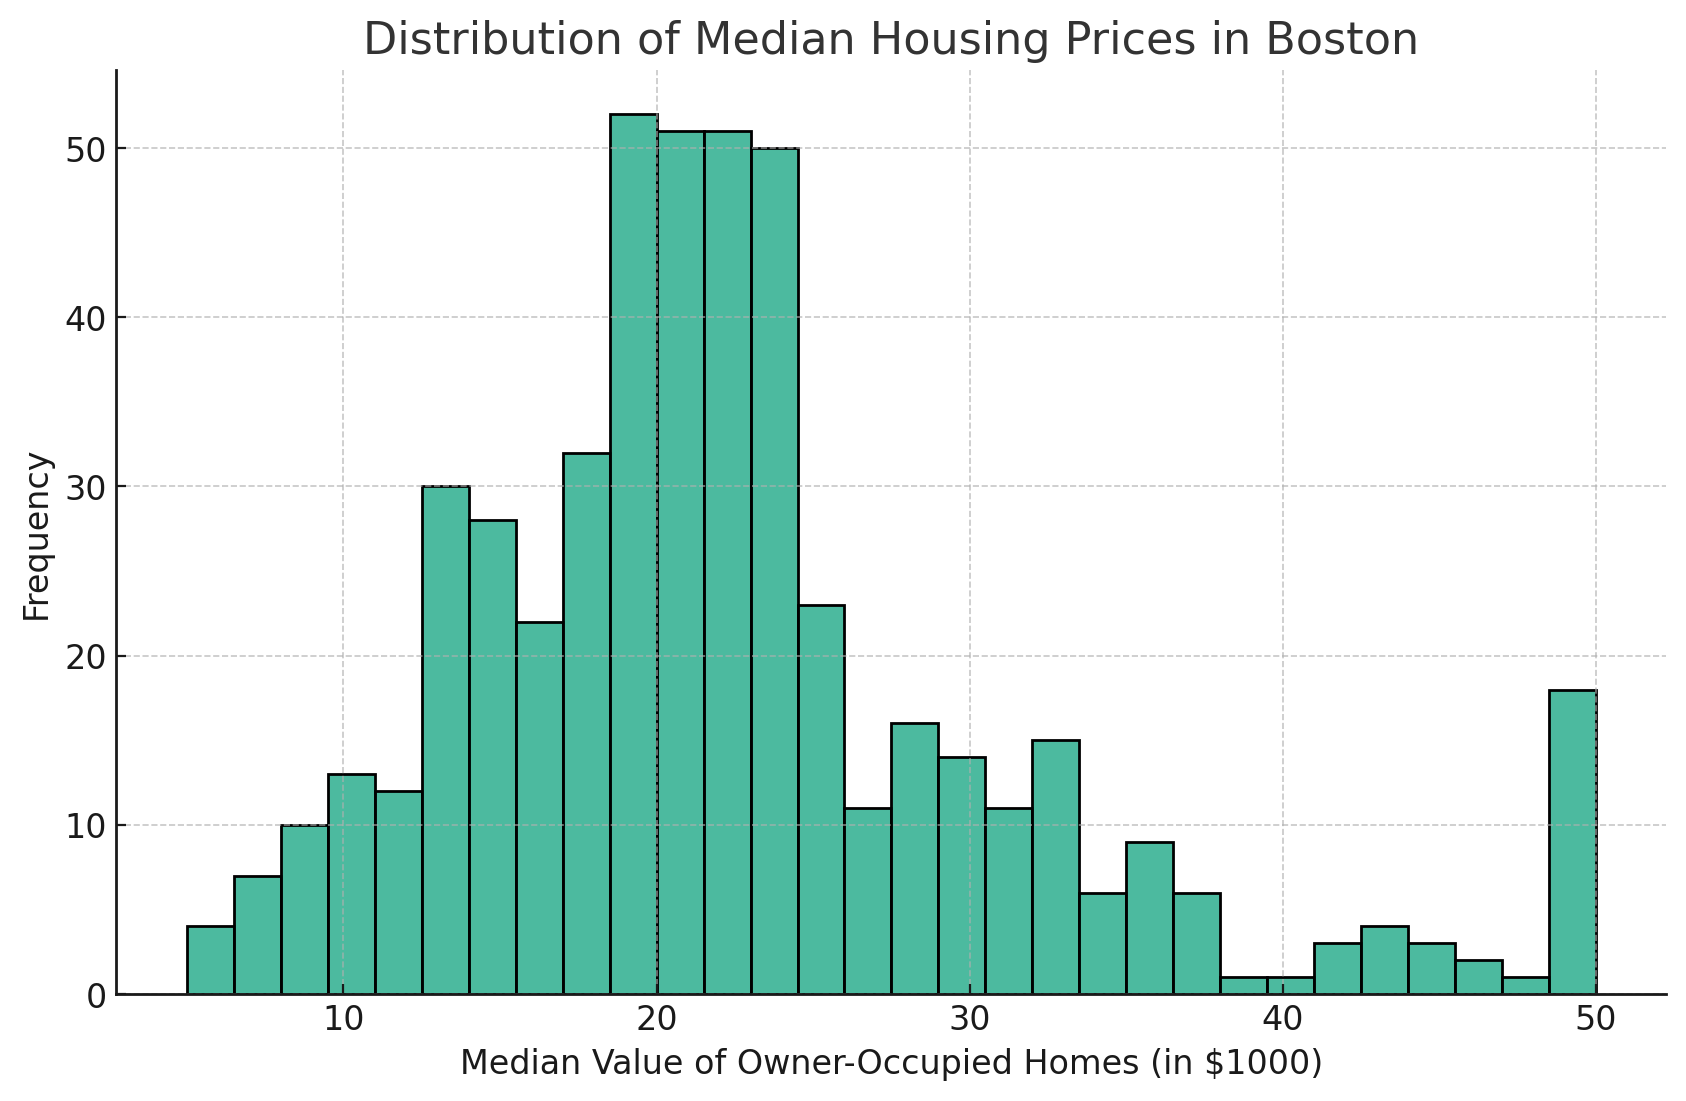
जैसा कि आप ऊपर दिए गए Seaborn हिस्टोग्राम से देख सकते हैं, बार्स की संख्या मेरी निर्धारित मात्रा तक बढ़ गई है, जो इस मामले में 30 है। यह आपके डेटा की सूक्ष्मता में अधिक ग्रैन्युलैरिटी के लिए विवरण में उतरने का एक अच्छा तरीका है।
बार का रंग और पारदर्शिता बदलने जैसी एस्थेटिक्स को कस्टमाइज़ करना हिस्टोग्राम को अधिक सूचनाप्रद और आकर्षक बना सकता है।
नीचे दिए गए उदाहरण में, मैंने डिफ़ॉल्ट रंग के बजाय बैंगनी रंग का उपयोग करके हमारे मूल हिस्टोग्राम को फिर से बनाया।
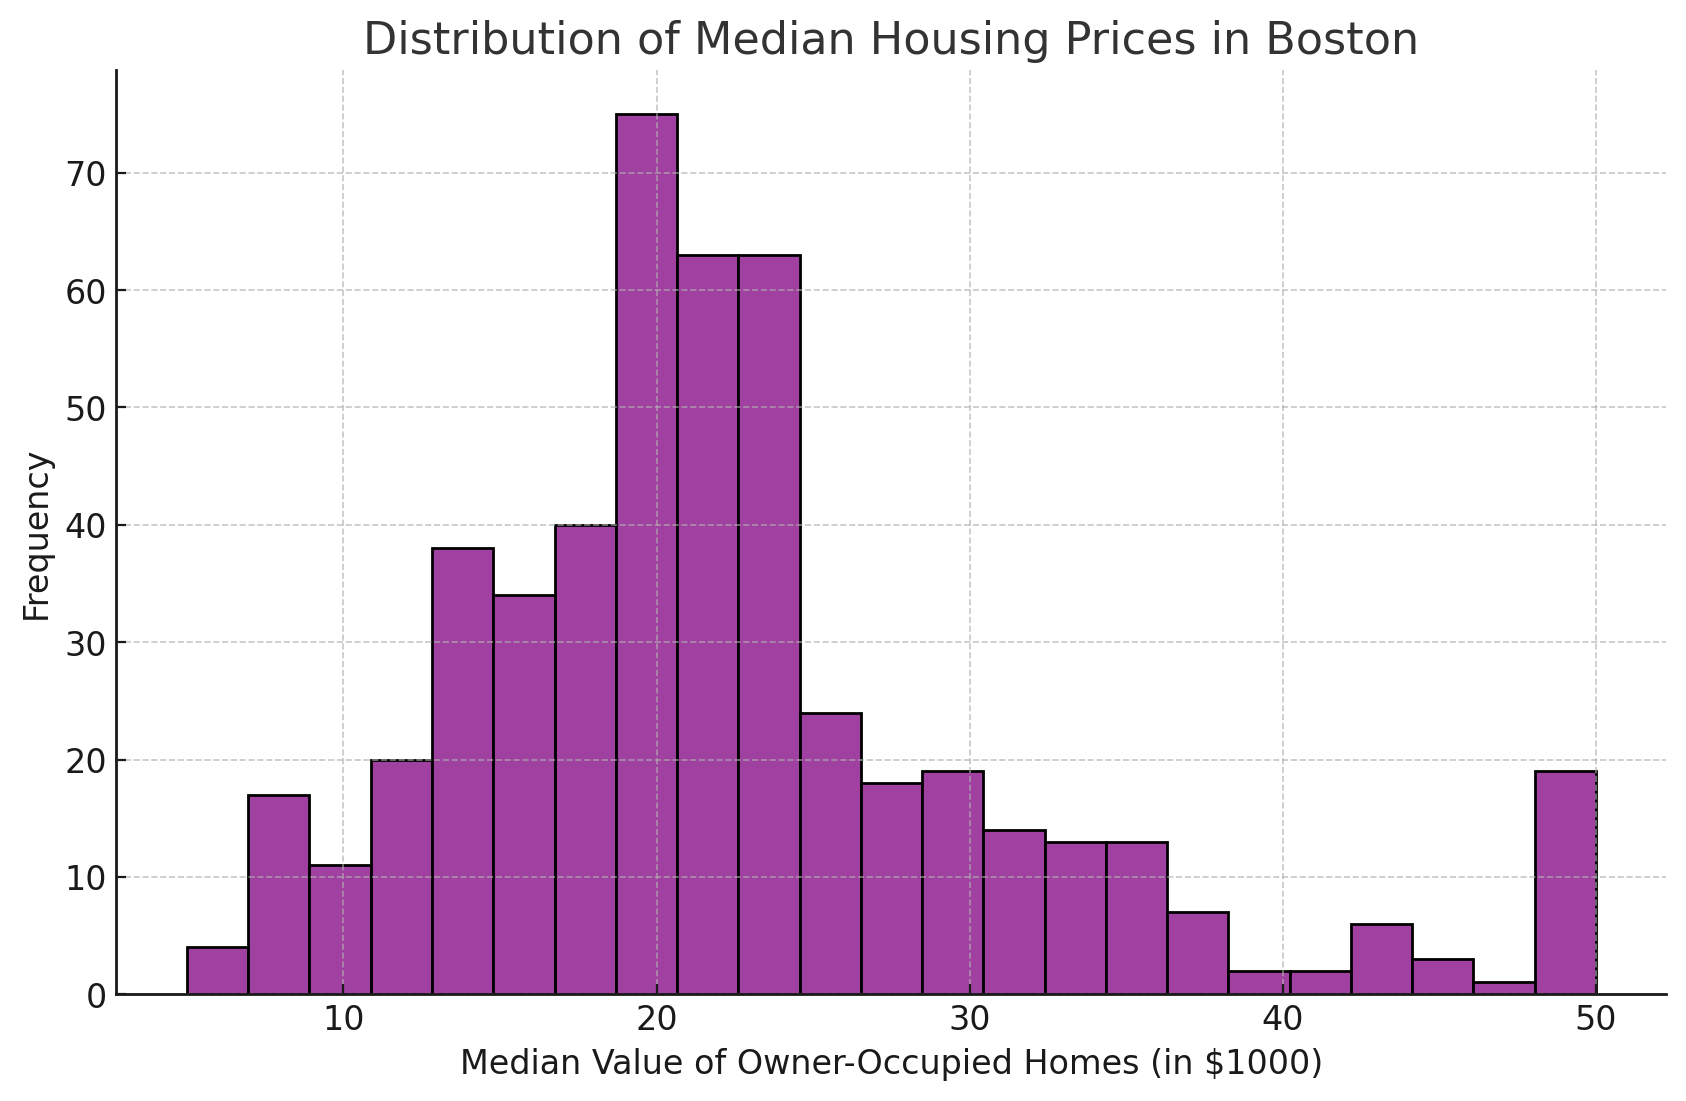
ऊपर दिए गए चार्ट को बनाने के लिए मैंने यह कोड इस्तेमाल किया।
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', color='purple')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
KDE डेटा वितरण का एक स्मूद अनुमान प्रदान करता है। यह डेटा में पैटर्न्स की पहचान करने के लिए विशेष रूप से उपयोगी हो सकता है।
यह एक स्मूद कर्व बनाता है जो समग्र रुझानों को विज़ुअलाइज़ करने में मदद कर सकता है।
इसे प्राप्त करने के लिए, हम इस फ़ंक्शन में kde पैरामीटर का उपयोग करते हैं:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', kde=True)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
यह हमारे हिस्टोग्राम में एक अच्छा कर्व उत्पन्न करेगा, जैसा कि नीचे दिखाया गया है।
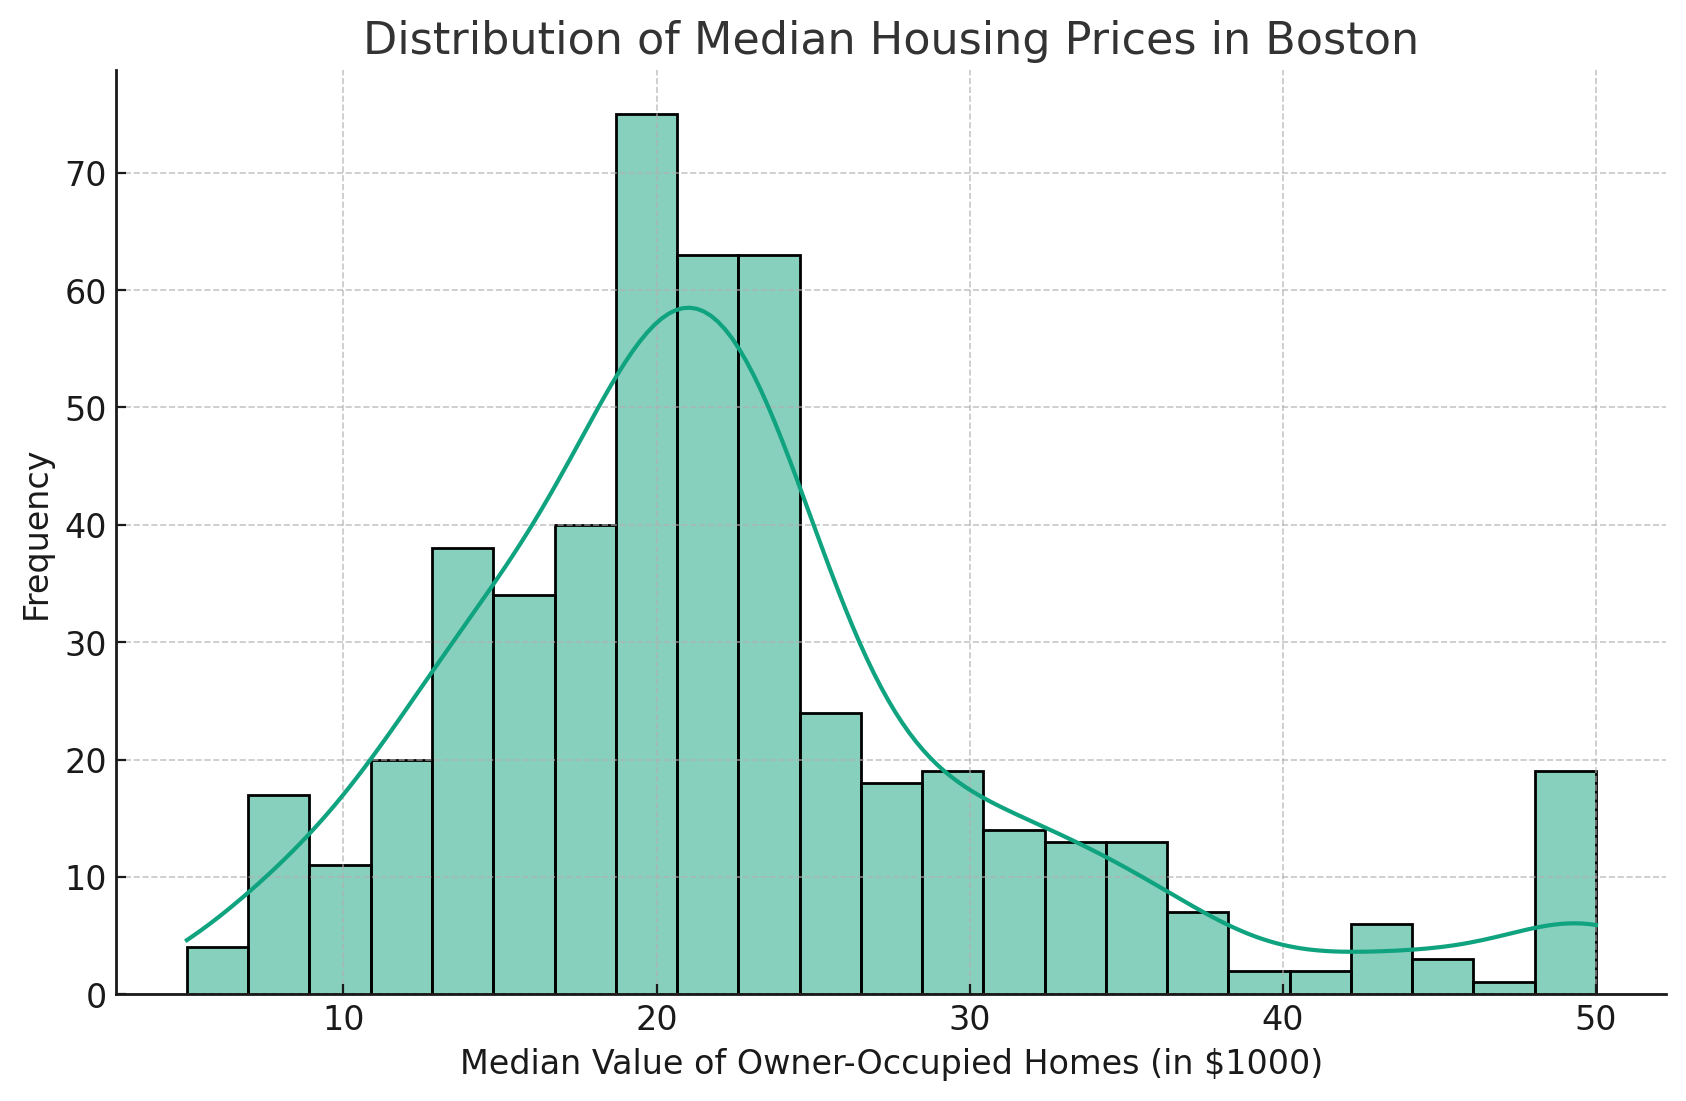
Kernel Density Estimate (KDE) लाइन जोड़ने से वितरण का स्मूदर अनुमान मिलता है।
hue पैरामीटर हिस्टोग्राम के भीतर विभिन्न श्रेणियों की तुलना की अनुमति देता है।
यह पैरामीटर हमें एक ही हिस्टोग्राम के भीतर विभिन्न श्रेणियों के बीच अंतर करने की अनुमति देता है, जिससे वितरणों की दृश्य तुलना मिलती है।
सीधे शब्दों में, यह DataFrame से एक श्रेणीबद्ध कॉलम लेता है और विभिन्न रंगों का उपयोग करके डेटा में अंतर करता है।
उदाहरण के लिए, यदि हमारे DataFrame में 'CHAS' नाम का एक कॉलम है, जो इंगित करता है कि कोई घर चार्ल्स नदी के किनारे (1) है या नहीं (0), तो हम 'hue' पैरामीटर का उपयोग करके नदी के पास वाले घरों बनाम जो नहीं हैं, उनके लिए माध्य आवास मूल्यों के वितरण की तुलना कर सकते हैं।
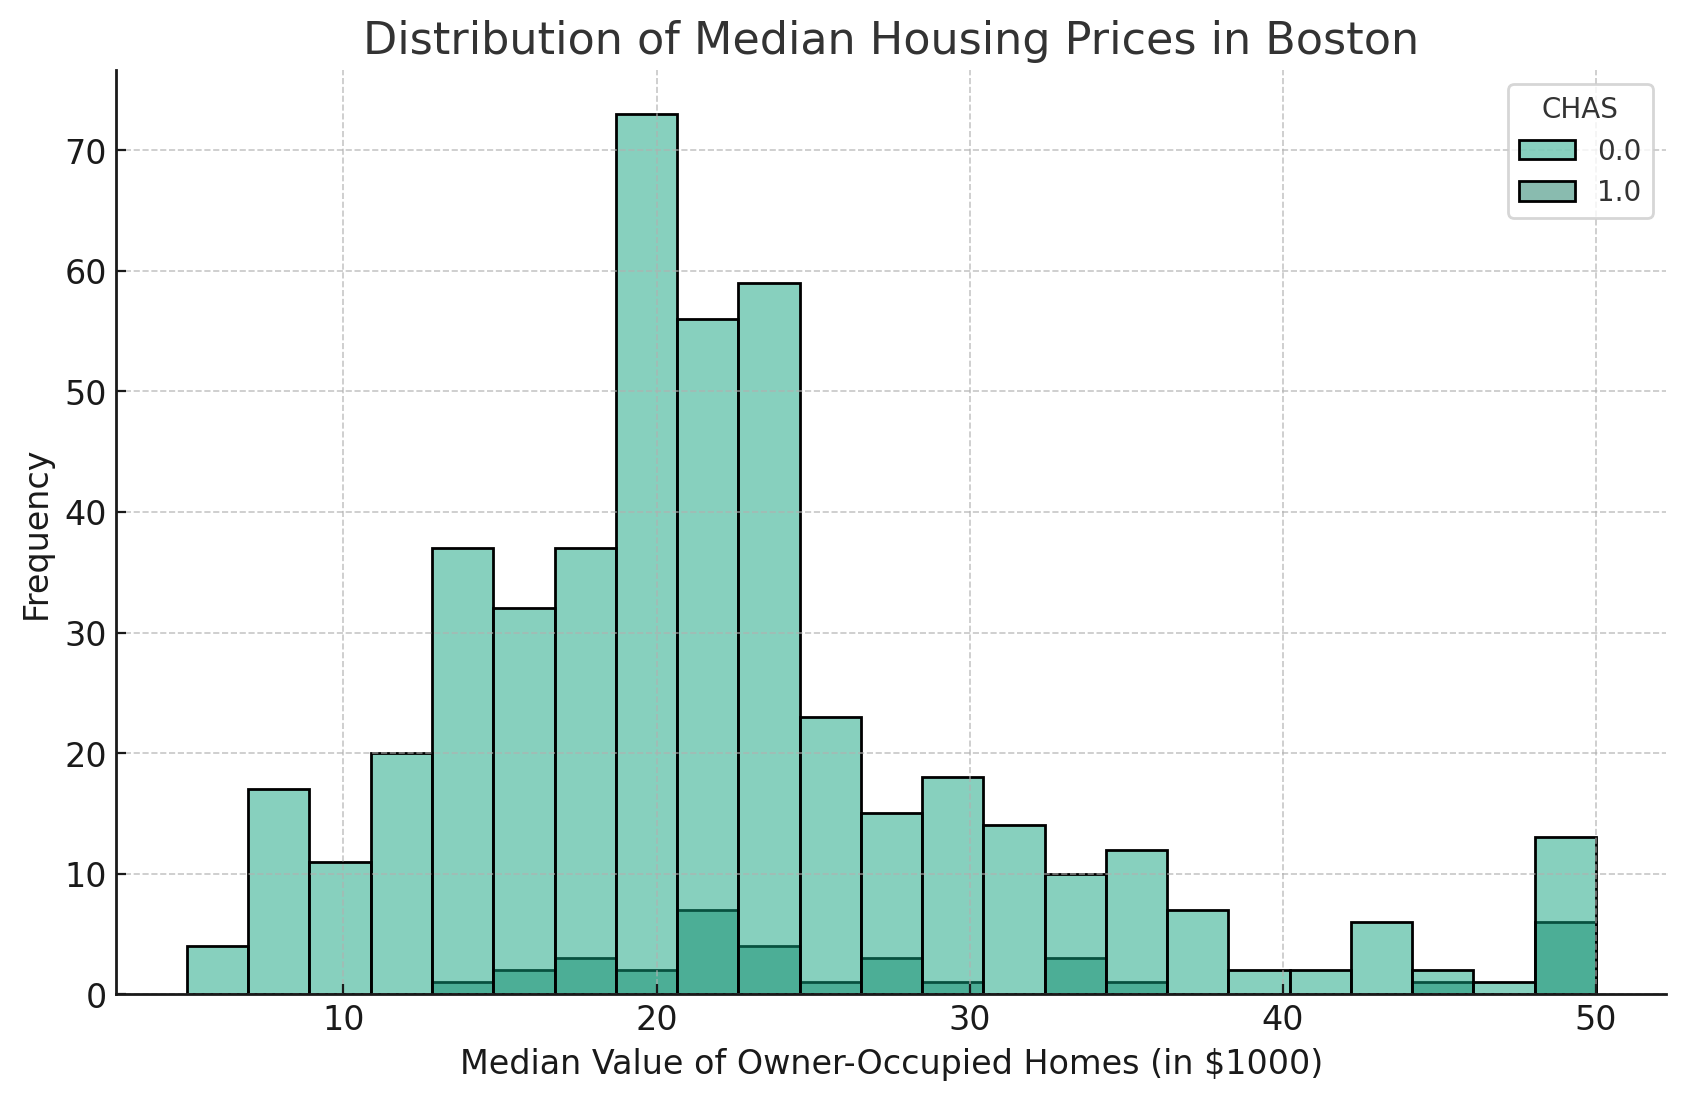
कोड इस प्रकार होगा:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', hue='CHAS')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
यह एक ऐसा हिस्टोग्राम उत्पन्न करेगा जिसमें चार्ल्स नदी से सटे घरों (CHAS=1) के लिए MEDV के वितरण को नदी से न सटे घरों (CHAS=0) से अलग रंगों द्वारा अलग किया गया है।
जब आप Seaborn हिस्टोग्राम बना रहे हों, तो नीचे बताए गए कई पहलुओं को ध्यान में रखना चाहिए:
सूचनाप्रद हिस्टोग्राम बनाने के लिए बिन्स की इष्टतम संख्या का चयन करना महत्वपूर्ण है। जहाँ अधिक बिन्स अधिक विवरण प्रदान कर सकते हैं, वहीं इससे ओवरफिटिंग और डेटा के गलत प्रतिनिधित्व का जोखिम भी हो सकता है।
दूसरी ओर, बहुत कम बिन्स वितरण को अत्यधिक सरल बना सकते हैं।
सही बिन संख्या चुनने का एक तरीका स्कॉट्स रूल नामक एक thumb-rul का उपयोग करना है। यह रूल डेटा सेट में डेटा बिंदुओं की संख्या के आधार पर आदर्श बिन आकार की गणना करता है।
जहाँ हिस्टोग्राम में पर्याप्त विवरण प्रदान करना महत्वपूर्ण है, वहीं यह सुनिश्चित करना भी आवश्यक है कि विज़ुअलाइज़ेशन स्पष्ट और व्याख्यायोग्य बना रहे।
बहुत से तत्व जोड़ना, जैसे KDE लाइनें या बहुत सारे रंग, अव्यवस्थित विज़ुअल्स का कारण बन सकता है जिन्हें समझना कठिन हो।
सबसे अच्छा है कि सूचनाप्रद तत्व जोड़ने और सरलता बनाए रखने के बीच संतुलन बनाया जाए।
विज़ुअलाइज़ किए जा रहे डेटा का प्रकार भी उपयुक्त हिस्टोग्राम पैरामीटर्स चुनने में भूमिका निभाता है।
उदाहरण के लिए, सतत वेरिएबल्स के लिए श्रेणीबद्ध वेरिएबल्स की तुलना में अलग बिन आकारों की आवश्यकता होगी।
हिस्टोग्राम बनाते समय डेटा की प्रकृति पर विचार करना महत्वपूर्ण है ताकि वे वितरण का सटीक प्रतिनिधित्व कर सकें।
हालाँकि, Python में डेटा विज़ुअलाइज़ेशन के लिए उपलब्ध लाइब्रेरीज़ में Seaborn केवल एक है। यदि आप चाहें, तो आप Matplotlib में अपने हिस्टोग्राम भी बना सकते हैं।
Seaborn Python में विज़ुअलाइज़ेशन बनाने के लिए एक शक्तिशाली लाइब्रेरी है, और histplot फ़ंक्शन हिस्टोग्राम को आसानी से बनाने की सुविधा देता है। केवल फ़ंक्शन के भीतर पैरामीटर्स बदलकर, आप अपने चार्ट के रूप-रंग को उस स्तर के विवरण और एस्थेटिक्स तक संशोधित कर सकते हैं जिसकी आपको आवश्यकता है।
ऊपर बताए गए सभी Seaborn हिस्टोग्राम टिप्स याद रखें: हमेशा डेटा के प्रकार पर विचार करें, उपयुक्त बिन आकार चुनें, और हिस्टोग्राम बनाते समय विवरण व स्पष्टता में संतुलन बनाए रखें।
Seaborn और इसकी अन्य शक्तिशाली डेटा विज़ुअलाइज़ेशन क्षमताओं के बारे में और सीखने में रुचि है? हमारा Introduction to Data Visualization with Seaborn कोर्स शुरुआती लोगों के लिए एक उत्कृष्ट पाठ्यक्रम है।
आज ही अपनी Seaborn यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स