
Kurs
Seaborn ile Veri Görselleştirmeye Giriş
4 sa
184.7K
Veri görselleştirme, karmaşık veri kümelerinin yorumlanmasında kritik bir bileşendir.
Python programlama dünyasında, Seaborn, histogramlar ve çizgi grafikleri gibi görsel olarak etkileyici ve bilgilendirici istatistiksel grafikler oluşturmak için öne çıkan güçlü bir kütüphanedir.
Matplotlib'in yetenekleri üzerine inşa edilmiştir; arayüzünü geliştirir ve özellikle istatistiksel analiz için daha fazla görselleştirme seçeneği sunar. Seaborn'un Pandas DataFrame'leriyle sorunsuz entegrasyonu, onu veri bilimciler ve analistler arasında favori yapar.
Bu ayrıntılı rehberde, Seaborn'da en sık kullanılan grafiklerden biri olan histogram üzerine odaklanacağız.
sns.histplot fonksiyonuna genel bakışSeaborn'daki sns.histplot fonksiyonu, sürekli verilerin dağılımını incelemek için temel olan histogramları çizmek üzere tasarlanmıştır. Bu fonksiyon esnektir ve kapsamlı özelleştirmeye izin verir, böylece verilerden anlamlı içgörüler çıkarmayı kolaylaştırır.
Bu fonksiyon, Seaborn kütüphanesinde bulunan birçok fonksiyondan yalnızca biridir. Hızlı bir genel bakış için aşağıdaki kısa bilgi kağıdına göz atın.
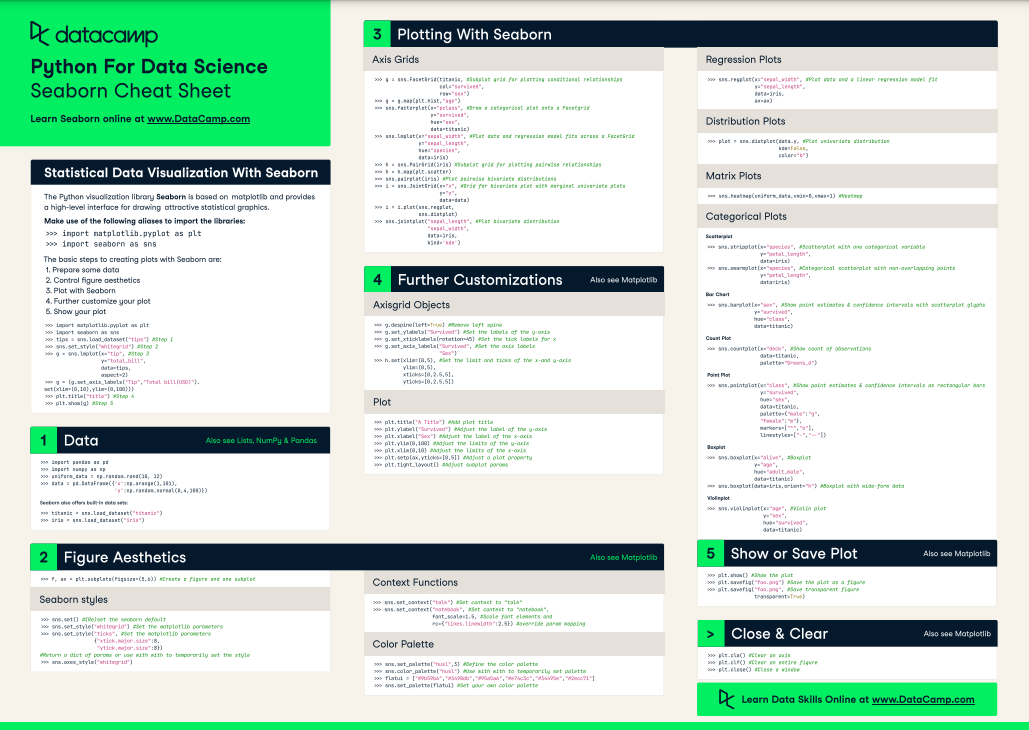
Veri bilimi için Seaborn kısa bilgi kağıdı - kaynak
Veri görselleştirmeye geçmeden önce ortamımızı kurmamız gerekir. Bu, başta Seaborn olmak üzere gerekli kütüphaneleri içe aktarmayı içerir. Kolaylık açısından Seaborn genellikle sns olarak içe aktarılır.
Seaborn'un yanında, sayısal işlemler için NumPy, veri işleme için pandas ve ek özelleştirme seçenekleri için Matplotlib gibi diğer temel kütüphaneler de sıkça kullanılır.
import seaborn as sns
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
Bunların tümü, Python'da veri görselleştirmeleri oluşturmak ve bunları değiştirmek için gerekli araçları sağlayan temel kütüphanelerdir. Veri analistleri ve veri bilimcileri tarafından en sık kullanılan kütüphanelerdir.
Python öğrenmeye yeni başlıyorsanız, Veri Bilimi için Python'a Giriş kursumuzu denemenizi öneririm. pandas, NumPy ve Matplotlib hakkında daha fazla öğrenim için ise pandas ile Veri Manipülasyonu, NumPy'ye Giriş ve Matplotlib ile Veri Görselleştirmeye Giriş kurslarımızı inceleyin.
Scikit-Learn kütüphanesinden yüklenebilen Boston Konut Fiyatları veri setini kullanacağız. Bu veri seti, Boston'ın farklı bölgelerindeki konut değerlerini; suç oranı, ortalama oda sayısı gibi çeşitli özniteliklerle birlikte sunar.
from sklearn.datasets import load_boston
boston = load_boston()
df = pd.DataFrame(boston.data, columns=boston.feature_names)
df['MEDV'] = boston.target
Histogramlarınız için uygun veriye sahip olmak, onların başarılı olup olmayacağını belirler. Bu örnekte, Boston'daki sahiplerinin oturduğu konutların medyan değeri (MEDV) adlı sürekli bir değişkeni kullanıyoruz.
Histogramlar genellikle tek bir değişkenin dağılımını gösterdiğinden, DataFrame'imizden bir sütun seçeceğiz.
Scikit-Learn'e yeni misiniz? Python ile Makine Öğrenimi öğreticimizi deneyin. Daha fazla bilgi isterseniz, scikit-learn ile Denetimli Öğrenme kursumuz temel konuları kapsamanıza yardımcı olacaktır.
Başlamadan önce, Seaborn histogramınızı oluşturmadan evvel bazı temel ön koşullar şunlardır:
sns.histplot fonksiyonunun bazı yaygın sözdizimi ve parametrelerini inceleyerek başlayacağız.
sns.histplot kullanarak histogram oluşturmanın temel sözdizimi basittir.
Başlıca parametreler şunlardır:
data: Genellikle bir Pandas DataFrame olan veri kümesi.x: Histogramın çizileceği değişken.color: Sütunların rengini belirtir.alpha: Sütunların saydamlığı.bins: Kullanılacak bölme (çubuk grubu) sayısı.binwidth: Her bir bölmenin genişliği.kde: Çekirdek Yoğunluk Tahmini (Kernel Density Estimate) grafiği eklemek için boolean değer.hue: Başka bir değişkene göre veri alt kümelerini ayırt etmek için.Fonksiyon birçok parametre ve argüman kabul eder, ancak biz veri setimiz için gerekenlere odaklanacağız.
Medyan konut fiyatlarının (MEDV) dağılımını görselleştirmek için temel bir histogram oluşturalım.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Bu komut, MEDV sütunu için histogramı görüntüleyecektir.
İşte bu koddan üretilen grafik:
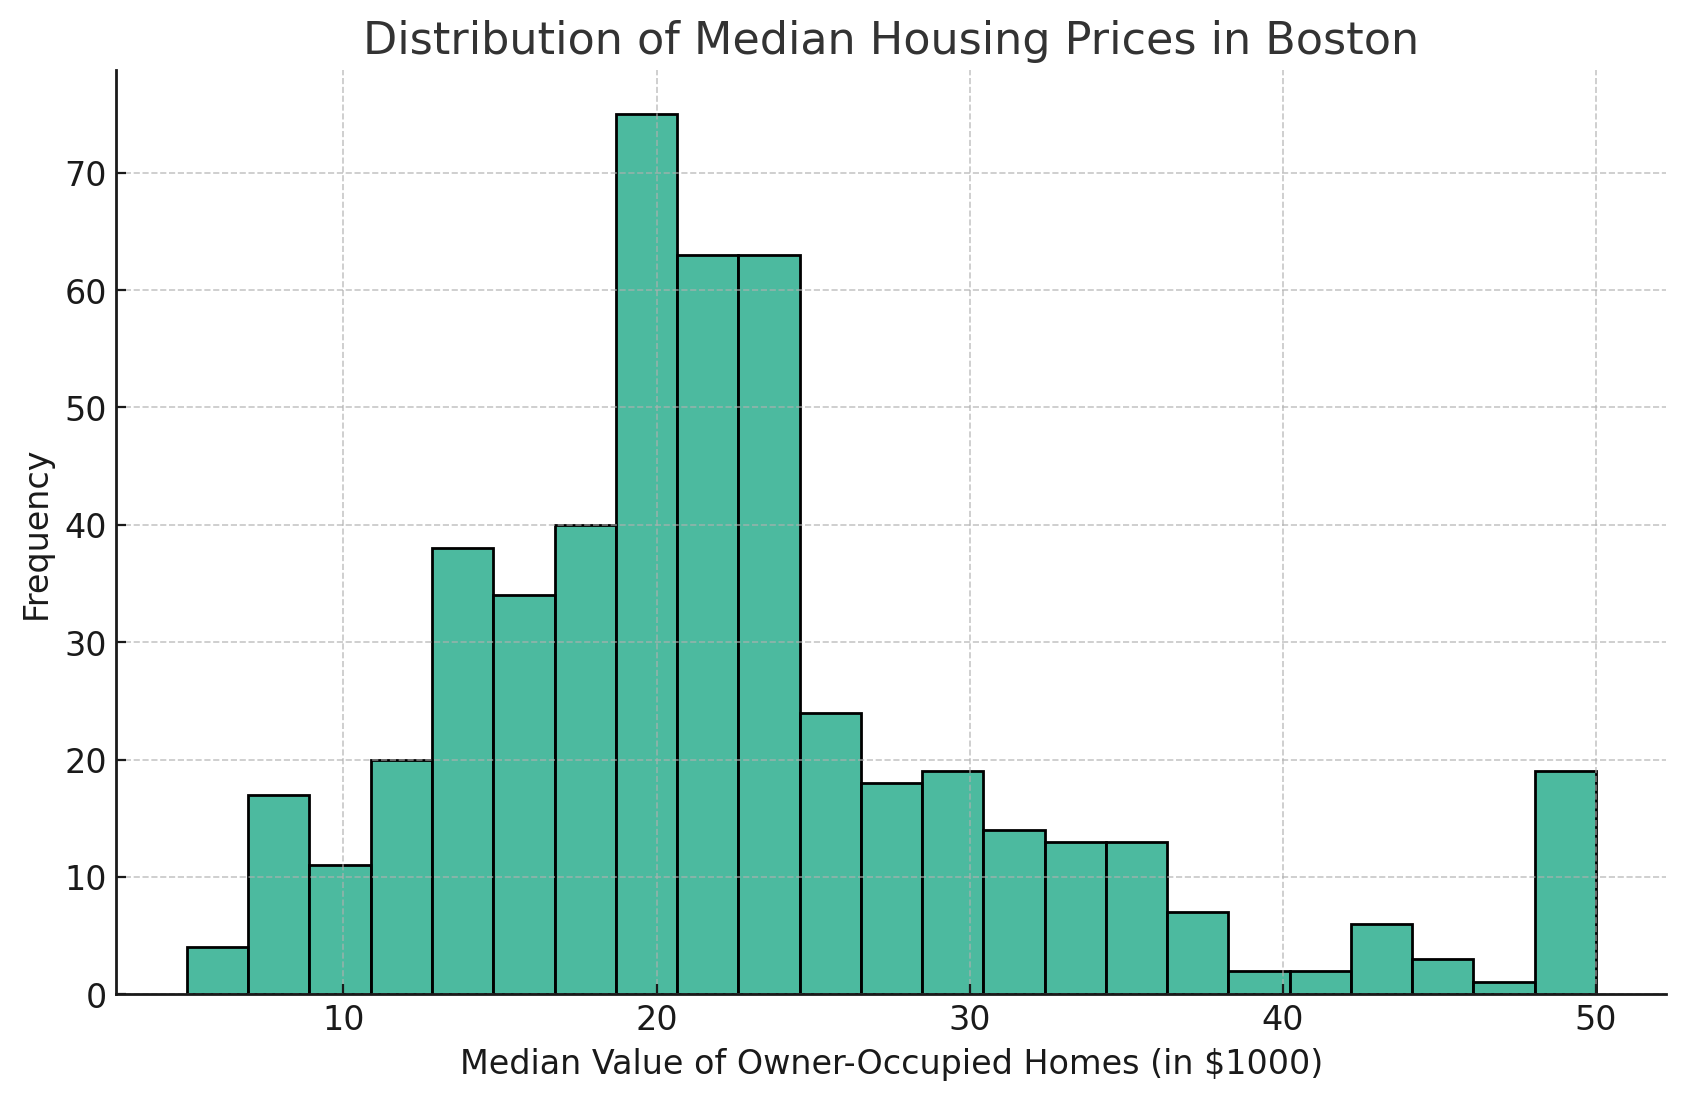
Bu histogram, Boston veri setindeki medyan konut fiyatlarının (MEDV) dağılımını göstermektedir. Histogram, sahiplerinin oturduğu konutların medyan değerlerinin frekans dağılımını görsel olarak sunar.
Bölme sayısını ayarlamak, dağılımı daha iyi anlamaya yardımcı olabilir. Daha yüksek bölme sayısı daha fazla ayrıntı ortaya çıkarabilirken, daha düşük sayı görselleştirmeyi basitleştirir.
Bölme sayısını artırmak için bins parametresini değiştirebilirsiniz.
İşte bir örnek:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', bins=30)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
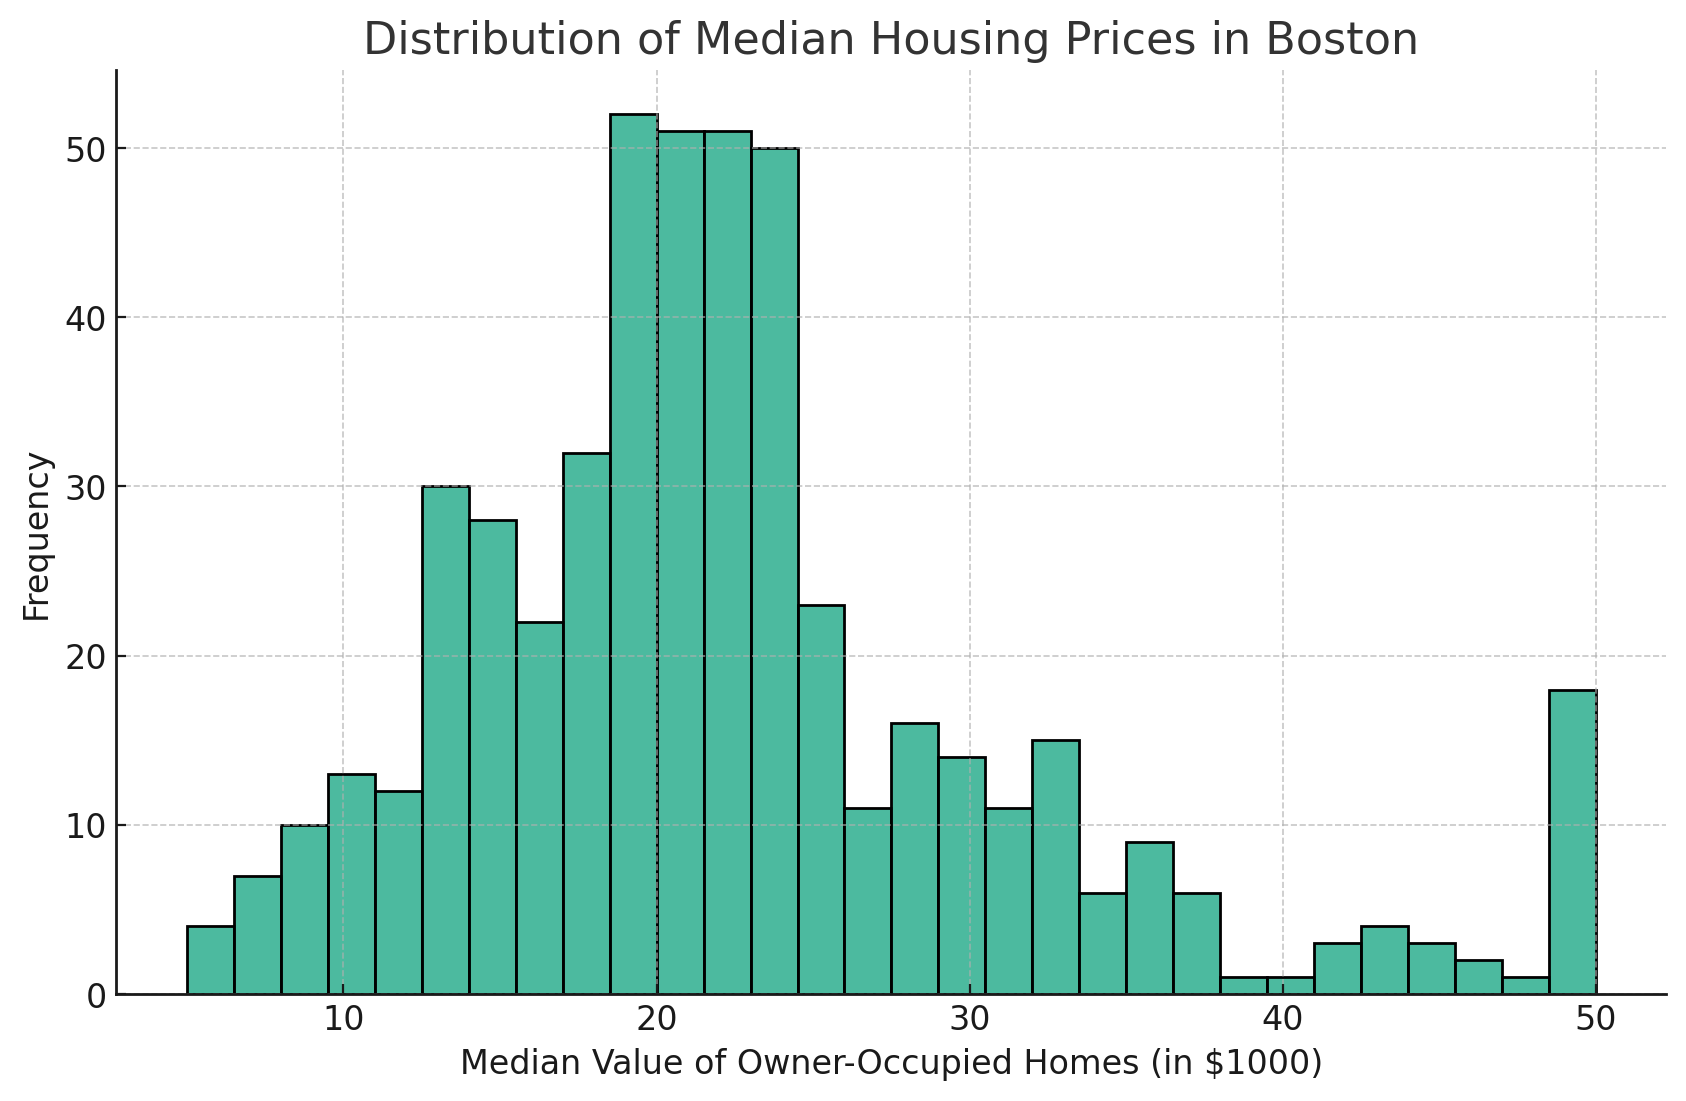
Yukarıdaki Seaborn histogramından da görebileceğiniz gibi, çubuk sayısı belirlediğim değere, bu durumda 30'a, yükselmiştir. Bu, verinizde daha ayrıntılı bir görünüm için iyi bir yöntemdir.
Sütun rengi ve saydamlığını değiştirmek gibi estetik unsurları özelleştirmek, histogramı daha bilgilendirici ve görsel açıdan çekici hale getirebilir.
Aşağıdaki örnekte, orijinal histogramımızı varsayılan renk yerine mor kullanarak yeniden oluşturdum.
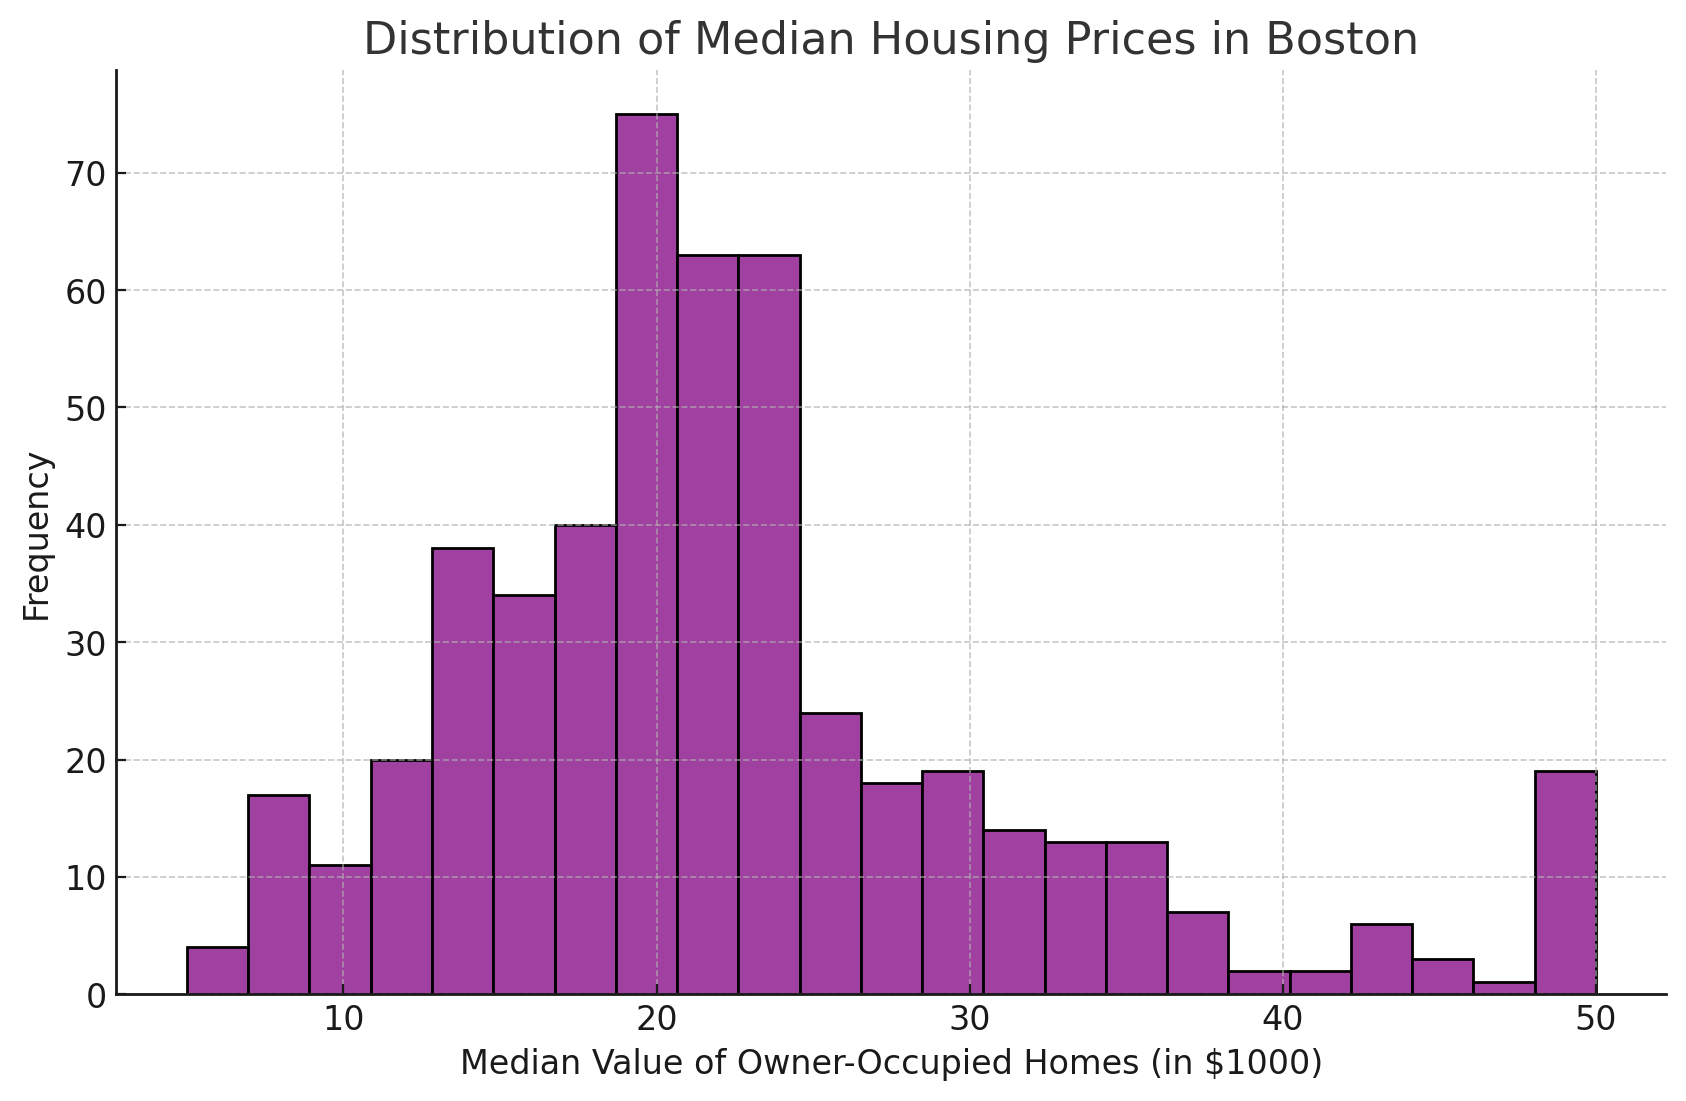
Yukarıdaki grafiği oluşturmak için kullandığım kod aşağıdadır.
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', color='purple')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
KDE, veri dağılımının düzgün bir tahminini sağlar. Verideki desenleri belirlemede özellikle faydalı olabilir.
Bu, genel eğilimleri görselleştirmeye yardımcı olan düzgün bir eğri oluşturur.
Bunu sağlamak için, bu fonksiyonda kde parametresini kullanırız:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', kde=True)
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Bu, aşağıda gösterildiği gibi histogramımıza hoş bir eğri ekleyecektir.
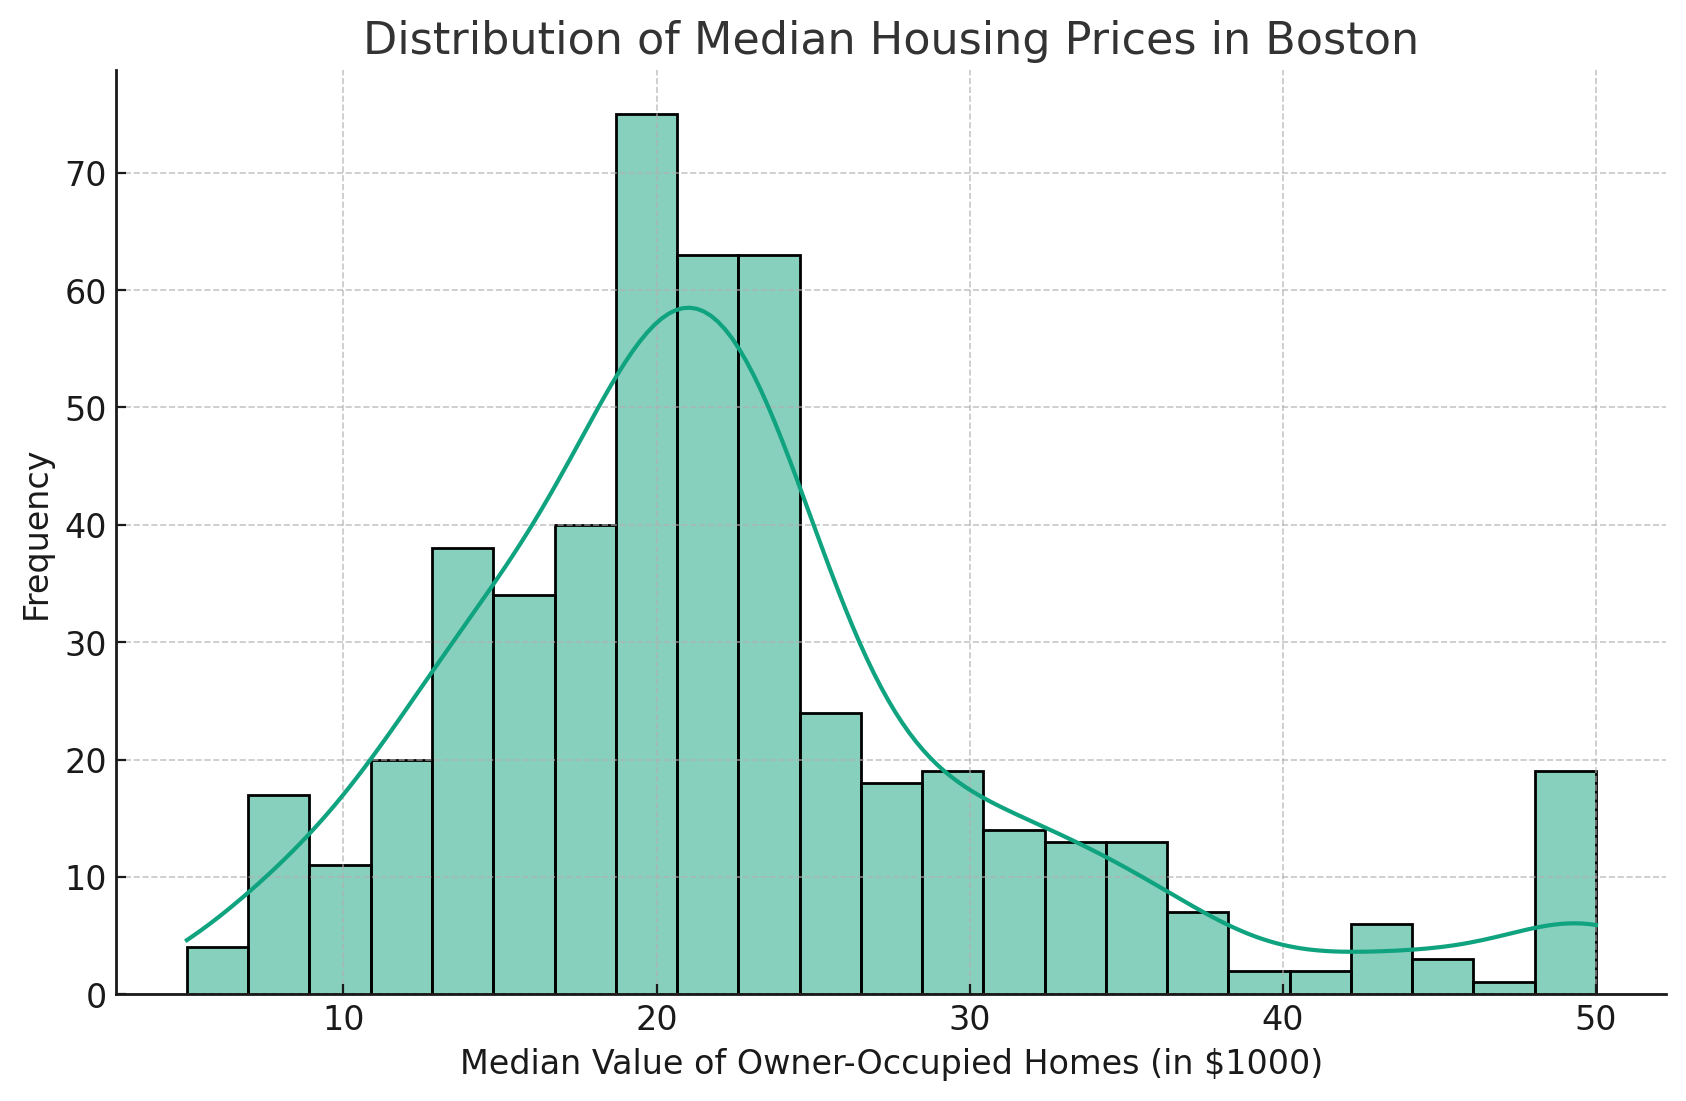
Çekirdek Yoğunluk Tahmini (KDE) çizgisinin eklenmesi, dağılımın daha düzgün bir tahminini sunar.
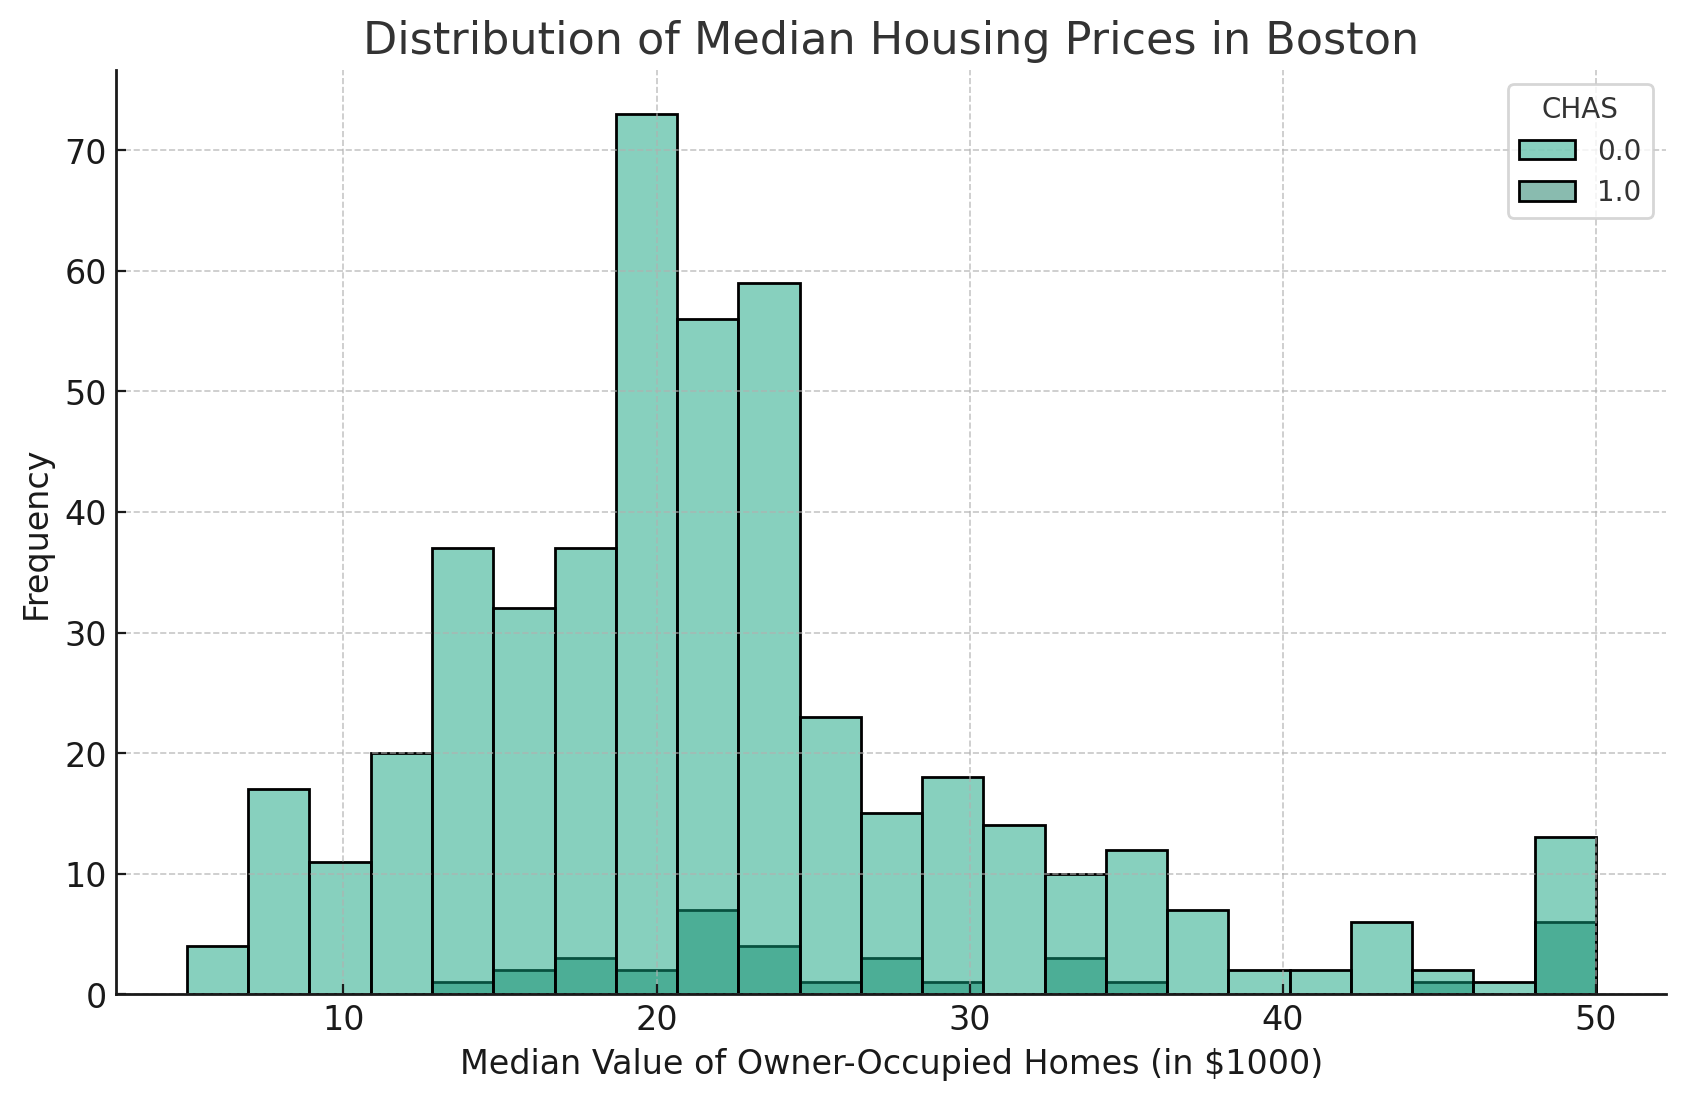
hue parametresi, histogram içinde farklı kategorilerin karşılaştırılmasına olanak tanır.
Bu parametre, aynı histogram içinde farklı kategorileri ayırt etmemizi sağlayarak dağılımların görsel bir karşılaştırmasını sunar.
Kısaca, DataFrame'den kategorik bir sütun alır ve veriyi farklı renklerle ayırt eder.
Örneğin, DataFrame'imizde bir evin Charles Nehri boyunca olup olmadığını (1) ya da olmadığını (0) gösteren 'CHAS' adlı bir sütun varsa, nehre yakın olan evlerin medyan konut fiyatlarının dağılımını, yakın olmayanlarla karşılaştırmak için 'hue' parametresini kullanabiliriz.
Kod aşağıdaki gibi olacaktır:
plt.figure(figsize=(10, 6))
sns.histplot(data=df, x='MEDV', hue='CHAS')
plt.title('Distribution of Median Housing Prices in Boston')
plt.xlabel('Median Value of Owner-Occupied Homes (in $1000)')
plt.ylabel('Frequency')
plt.grid(True)
plt.show()
Bu, Charles Nehri'ne komşu olan evler (CHAS=1) ile nehre komşu olmayan evlerin (CHAS=0) MEDV dağılımlarının, her biri farklı bir renkle temsil edildiği bir histogram üretecektir.
Seaborn histogramları oluştururken aşağıda özetlenen birkaç noktayı akılda tutmanız gerekir:
En uygun bölme sayısını seçmek, bilgilendirici bir histogram oluşturmanın anahtarıdır. Daha yüksek bölme sayısı daha fazla ayrıntı sağlayabilse de aşırı uyuma ve verinin yanlış temsil edilmesine yol açabilir.
Diğer yandan, çok az bölme dağılımı aşırı basitleştirebilir.
Doğru bölme sayısını seçmenin yollarından biri, Scott Kuralı olarak bilinen bir başparmak kuralını kullanmaktır. Bu kural, veri kümesindeki veri noktalarının sayısına göre ideal bölme boyutunu hesaplar.
Bir histogramda yeterli ayrıntı sağlamak önemli olmakla birlikte, görselleştirmenin net ve yorumlaması kolay kalmasını sağlamak da kritiktir.
KDE çizgileri veya çok fazla renk gibi çok sayıda öğe eklemek, anlaşılması zor, karmaşık görsellere yol açabilir.
Bilgilendirici öğeler eklemekle sadeliği korumak arasında bir denge kurmak en iyisidir.
Görselleştirilen veri türü, uygun histogram parametrelerinin seçilmesinde de rol oynar.
Örneğin, sürekli değişkenler, kategorik değişkenlerle karşılaştırıldığında farklı bölme boyutları gerektirir.
Histogramlar oluştururken, dağılımı doğru bir şekilde temsil ettiklerinden emin olmak için verinin doğasını dikkate almak önemlidir.
Ancak, Seaborn Python'da veri görselleştirmesi için mevcut kütüphanelerden yalnızca biridir. İsterseniz histogramlarınızı Matplotlib ile de oluşturmayı düşünebilirsiniz.
Seaborn, Python'da görselleştirmeler oluşturmak için güçlü bir kütüphanedir ve histplot fonksiyonu histogramların kolayca oluşturulmasını sağlar. Yalnızca fonksiyon içindeki parametreleri değiştirerek, grafiğinizin görünümünü istediğiniz ayrıntı ve estetik düzeyine ulaşacak şekilde değiştirebilirsiniz.
Yukarıda bahsedilen tüm Seaborn histogram ipuçlarını unutmayın: her zaman veri türünü göz önünde bulundurun, uygun bölme boyutlarını seçin ve Seaborn kullanarak histogramlar oluştururken ayrıntı ile açıklık arasında denge kurun.
Daha fazla Seaborn ve diğer güçlü veri görselleştirme yetenekleri hakkında bilgi edinmek ister misiniz? Seaborn ile Veri Görselleştirmeye Giriş kursumuz, yeni başlayanlar için mükemmeldir.
Seaborn Yolculuğunuza Bugün Başlayın!
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




