
Kursus
Bekerja dengan OpenAI API
3 jam
184.5K
Bayangkan Anda telah menghabiskan berjam-jam menulis sebuah konten.
Anda puas dengan hasil akhirnya, lalu memublikasikannya.
Setelah beberapa waktu tayang, Anda menyadari bahwa Anda menutup akses bagi audiens yang besar karena banyak orang merasa tidak punya waktu untuk duduk dan membaca karya Anda sampai tuntas.
Anda mempertimbangkan untuk menarasikan konten itu sendiri, tetapi waktu tidak berpihak pada Anda. Anda sempat terpikir merekrut narator, namun penawaran yang masuk jauh melampaui anggaran, dan proses menemukan seseorang dengan suara yang “tepat” juga menjadi beban.
Sebagaimana lazimnya di abad ke-21, Anda mencari solusi lewat teknologi. Saat itulah Anda mengenal Text-to-Speech (TTS) API dari OpenAI.
Dalam sisa tutorial ini, kita akan membahas TTS API dari OpenAI: fitur utamanya, cara memulai, opsi kustomisasi, dan contoh penerapan di dunia nyata.
Text-to-speech (TTS) adalah jenis teknologi asistif yang digunakan untuk mengonversi bahasa alami dalam format teks menjadi ucapan. Singkatnya, sistem text-to-speech mengambil kata-kata yang ditulis di komputer (atau perangkat digital lain) dan membacakannya dengan lantang.
TTS API dari OpenAI adalah endpoint yang memungkinkan pengguna berinteraksi dengan model AI TTS yang mengonversi teks menjadi bahasa lisan yang terdengar alami. Modelnya memiliki dua variasi:
Endpoint ini sudah dilengkapi enam suara bawaan dan, menurut Dokumentasi TTS OpenAI, dapat digunakan untuk:
Namun, penting untuk dicatat bahwa Kebijakan Penggunaan OpenAI mewajibkan pengguna memberikan pemberitahuan yang jelas kepada pengguna akhir bahwa suara TTS yang mereka dengar dihasilkan oleh AI dan bukan suara manusia.
Mari kita lihat bagaimana cara mulai menggunakan OpenAI Text-to-Speech API, mencakup prasyarat dan langkah-langkah yang perlu Anda ikuti:
Setelah masuk ke akun OpenAI Anda, Anda akan diarahkan ke layar beranda. Dari sini, buka logo OpenAI di pojok kiri atas halaman untuk menampilkan sidebar.
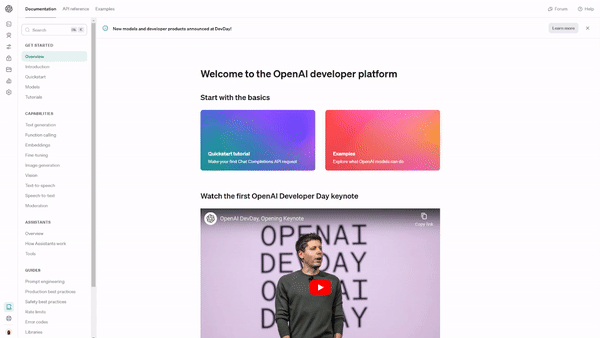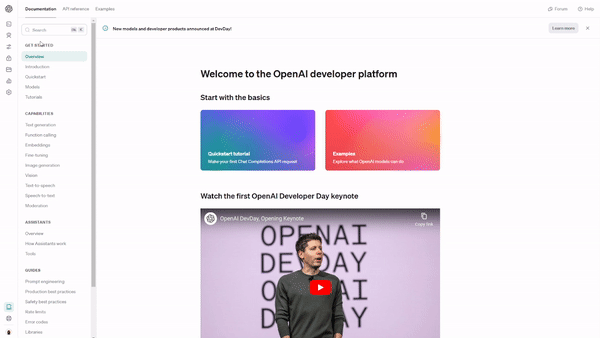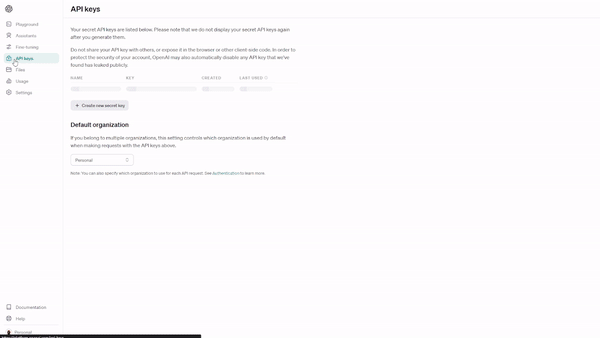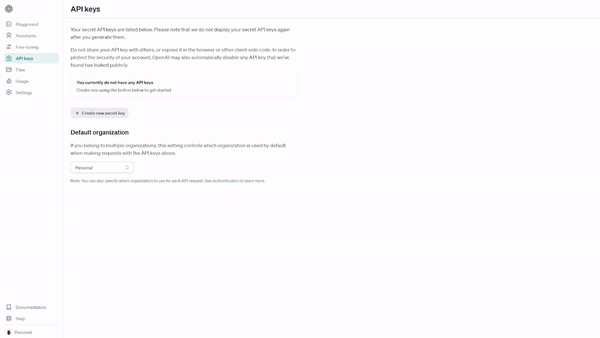
Pilih “API Keys.”
Pilih “Create new secret key” dan beri nama kunci API Anda – kami menamai milik kami “tts-example.”
Saat Anda membuat kunci API, sebuah secret key akan dibuat. Pastikan menyimpan kunci tersebut di tempat yang aman.
Kini Anda sudah punya kunci, Anda siap memulai!
Virtual Environment digunakan untuk membuat wadah atau lingkungan terisolasi tempat dependensi terkait Python dipasang untuk suatu proyek tertentu. Seseorang dapat bekerja dengan banyak versi Python beserta berbagai paketnya.
Pembahasan lebih mendalam tentang virtual environment di luar cakupan artikel ini. Lihat tutorial Virtual Environment in Python untuk mempelajari cara membuatnya.
Ada tiga masukan utama yang diterima endpoint speech:
Dalam dokumentasi text-to-speech OpenAI, tersedia contoh permintaan; jadi kita tidak perlu membuat dari nol.
Berikut tampilan contoh permintaannya:
from pathlib import Path
from openai import OpenAI

client = OpenAI()

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Dalam kondisi saat ini, kodenya tidak akan berjalan.
Alasannya, kita belum meneruskan kunci API yang kita buat pada langkah satu ke klien OpenAI kita…
Cara termudah untuk menyelesaikan masalah ini adalah menambahkan parameter api_key tempat kita bisa meneruskan secret key ke objek OpenAI().
Contohnya:
client = OpenAI(api_key="secret key goes here") Melakukan ini adalah praktik yang kurang baik di Python.
Sebagai gantinya, kita akan menggunakan dotenv untuk membaca secret key dari berkas .env.
Hal pertama yang harus Anda lakukan adalah memasang dotenv ke dalam virtual environment Anda. Jalankan perintah ini dari virtual environment Anda:
pip install python-dotenvSekarang dotenv sudah terpasang, kita bisa membuat berkas .env yang berisi pasangan key-value, lalu menetapkan nilainya sebagai variabel lingkungan.
Ini memungkinkan kita menyembunyikan secret key, meskipun kodenya dibagikan secara publik.
Pertama-tama, kita harus membuat berkas .env dan memasukkan hal berikut:
SECRET_KEY = "insert your secret key token here" Di berkas main.py, kini kita bisa memanggil variabel lingkungan menggunakan dotenv.
Berikut tampilan kodenya.
import os
from pathlib import Path
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
SECRET_KEY = os.getenv("SECRET_KEY")

client = OpenAI(api_key=SECRET_KEY)

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Sekarang kodenya berjalan.
Perilaku baku kode ini adalah menghasilkan berkas MP3 dari audio yang diucapkan. Jika Anda menginginkan format berkas yang berbeda, Anda dapat mengonfigurasikan keluaran ke salah satu format yang didukung.
Ada begitu banyak suara dan aksen di dunia.
Meski mungkin mustahil untuk menangkap semuanya satu per satu, TTS dari OpenAI berupaya mencerminkan keragaman dunia yang kita tinggali dengan menghadirkan enam suara unik bawaan ke dalam API:
Suara-suara ini dapat menyiratkan kepribadian yang berbeda, atau Anda dapat memilihnya sesuai preferensi Anda. Yang perlu Anda lakukan hanyalah menetapkan voice yang ingin digunakan melalui parameter voice pada objek client.
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy", # Update this to change voice
  input="Today is a wonderful day to build something people love!"
)
Lihat dokumentasi API text-to-speech OpenAI untuk mempelajari lebih lanjut suara yang tersedia.
Anda juga dapat mengubah format keluarannya.
Respons baku API adalah berkas MP3 dari teks yang dikonversi. Namun, OpenAI menyediakan beragam format lain untuk memenuhi kebutuhan dan preferensi Anda. Misalnya:
Ringkasnya: pilihan format keluaran dapat memengaruhi kualitas audio, ukuran berkas, serta kompatibilitas berkas dengan berbagai perangkat dan aplikasi.
Dari sisi dukungan bahasa, model text-to-speech mengikuti model Whisper yang digunakan untuk speech-to-text; suara-suara tersebut dioptimalkan untuk bahasa Inggris namun memiliki dukungan untuk beberapa bahasa lain.
Sekarang kita sudah tahu cara menyiapkan TTS API, mari lihat beberapa contoh cara menggunakannya.
Misalkan Anda menulis sebuah buku atau posting blog dan ingin memperluas jangkauannya ke audiens yang lebih luas dengan mengonversinya menjadi audio. Jika dilakukan dengan cara lama, Anda harus mencari narator (atau menarasikannya sendiri), yang bisa memakan waktu lama.
OpenAI TTS API dapat memperpendek proses ini; yang perlu Anda lakukan adalah meneruskan dokumen teks ke API, dan API akan mengonversinya menjadi ucapan.
Alih-alih mengajar dalam kelompok, pengajar bahasa dapat menggunakan text-to-speech API dari OpenAI untuk membuat pelajaran yang dipersonalisasi bagi siswa menggunakan berbagai bahasa dan dialek. Meski suara-suara dioptimalkan untuk bahasa Inggris, API ini tetap dapat digunakan untuk menghasilkan konten audio dalam beberapa bahasa.
OpenAI TTS API dapat digunakan untuk membuat suara AI yang terdengar lebih realistis dan ekspresif dibandingkan sistem TTS tradisional. Pengembang gim video dapat memanfaatkan kemampuan ini dan menerapkannya pada karakter untuk membuat pengalaman bermain lebih imersif.
Contoh lain adalah membuat asisten virtual dan chatbot yang lebih menarik dibandingkan yang tradisional.
Batas laju untuk OpenAI TTS API dimulai dari 50 Request Per Minute (RPM) untuk akun berbayar, dan ukuran masukan maksimum adalah 4096 karakter – setara dengan sekitar 5 menit audio pada kecepatan baku.
Terkait model TTS, harganya sebagai berikut:
Jika Anda mencari cara yang hemat biaya untuk mengintegrasikan TTS API ke proyek kecil, Anda mungkin lebih baik memilih model TTS standar. Model TTS HD sedikit lebih mahal tetapi menawarkan audio definisi tinggi, yang ideal ketika kualitas audio menjadi prioritas – pelajari lebih lanjut tentang harga untuk model audio OpenAI.
Text-to-speech API dari OpenAI adalah endpoint bagi pengguna untuk menghasilkan audio lisan berkualitas tinggi dari teks. API ini hadir dengan enam suara bawaan, dan pengguna dapat memilih salah satu dari dua model, TTS-1 dan TTS-1-HD, sesuai kasus penggunaan; model TTS-1 dioptimalkan untuk text-to-speech waktu nyata, sedangkan TTS-1-HD dioptimalkan untuk kualitas.
Dalam posting blog ini, kita telah membahas:
Lihat sumber daya menarik berikut untuk melanjutkan pembelajaran Anda:
Mulai Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



