
Kurs
Arbeiten mit der OpenAI-API
3 Std.
172.6K
Stell dir vor, du hast stundenlang an einem Content-Stück gearbeitet.
Du bist mit dem Ergebnis zufrieden und veröffentlichst es.
Nach einiger Zeit merkst du, dass du ein großes Publikum ausschließt, weil viele keine Zeit haben, sich in Ruhe durch deinen Text zu lesen.
Du spielst mit dem Gedanken, den Inhalt selbst einzusprechen, aber die Zeit fehlt. Eine Sprecherin oder einen Sprecher zu engagieren, klingt verlockend, ist aber zu teuer, und die Suche nach der „richtigen“ Stimme dauert ebenfalls.
Ganz zeitgemäß suchst du nach einer technischen Lösung. So stößt du auf die Text-to-Speech (TTS) API von OpenAI.
In diesem Tutorial schauen wir uns OpenAIs TTS-API an: die wichtigsten Funktionen, den Einstieg, Anpassungsmöglichkeiten und Praxisbeispiele.
Text-to-Speech (TTS) ist eine Assistenztechnologie, die natürliche Sprache aus Text in gesprochene Sprache umwandelt. TTS-Systeme nehmen also Wörter, die auf einem Computer (oder anderen digitalen Geräten) stehen, und lesen sie laut vor.
OpenAIs TTS-API ist ein Endpunkt, über den Nutzerinnen und Nutzer mit dem TTS-KI-Modell interagieren, das Text in natürlich klingende Sprache konvertiert. Das Modell gibt es in zwei Varianten:
Der Endpunkt liefert sechs vorkonfigurierte Stimmen und kann laut der OpenAI TTS-Dokumentation unter anderem dafür genutzt werden,
Wichtig: Laut OpenAIs Nutzungsrichtlinien musst du für Endnutzer klar und deutlich kennzeichnen, dass die TTS-Stimme von einer KI erzeugt wird und nicht menschlich ist.
Schauen wir uns an, wie du mit der OpenAI Text-to-Speech-API startest – von den Voraussetzungen bis zu den konkreten Schritten:
Nach dem Login in dein OpenAI-Konto landest du auf dem Homescreen. Klicke oben links auf das OpenAI-Logo, um die Seitenleiste zu öffnen.
Wähle „API Keys“.
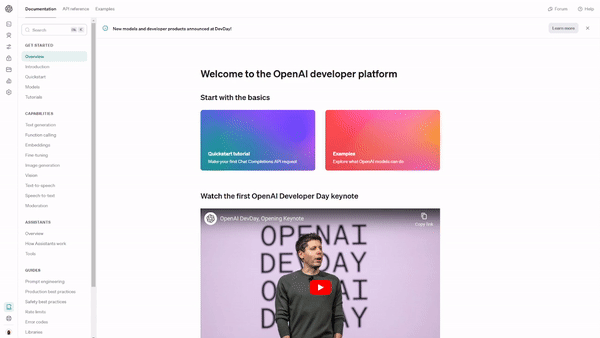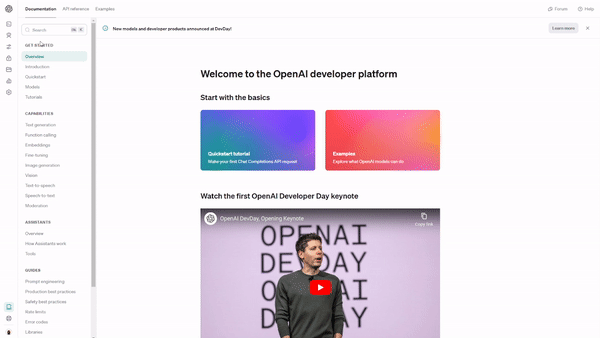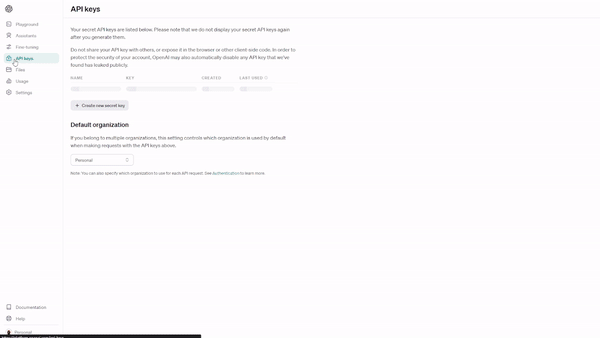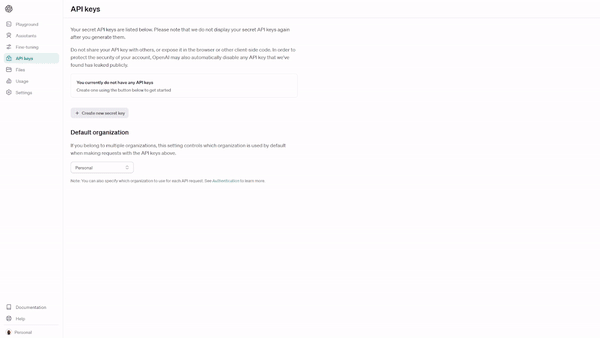
Klicke auf „Create new secret key“ und gib deinem API-Schlüssel einen Namen – wir haben unseren „tts-example“ genannt.
Beim Erstellen deines API-Schlüssels wird ein geheimer Schlüssel generiert. Speichere ihn unbedingt sicher ab.
Mit dem Schlüssel bist du startklar!
Eine virtuelle Umgebung bildet einen isolierten Container, in dem die Python-Abhängigkeiten für ein bestimmtes Projekt installiert werden. So kannst du mit verschiedenen Python-Versionen und Paketständen arbeiten.
Ein tiefer Einstieg in virtuelle Umgebungen sprengt hier den Rahmen. Mehr dazu findest du im Tutorial Virtual Environment in Python.
Der Sprach-Endpunkt erwartet drei zentrale Eingaben:
In der Text-to-Speech-Dokumentation von OpenAI gibt es eine Beispielanfrage – das Rad müssen wir also nicht neu erfinden.
So sieht ein Beispiel aus:
from pathlib import Path
from openai import OpenAI

client = OpenAI()

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
So wie es ist, läuft der Code noch nicht.
Der Grund: Wir haben den in Schritt 1 erzeugten API-Schlüssel noch nicht an den OpenAI-Client übergeben …
Am einfachsten wäre es, einen api_key-Parameter zu setzen und den geheimen Schlüssel direkt an das OpenAI()-Objekt zu übergeben.
Zum Beispiel:
client = OpenAI(api_key="secret key goes here") Das ist in Python jedoch schlechte Praxis.
Stattdessen nutzen wir dotenv, um den geheimen Schlüssel aus einer .env-Datei auszulesen.
Zuerst installierst du dotenv in deiner virtuellen Umgebung. Führe dort diesen Befehl aus:
pip install python-dotenvJetzt, da dotenv installiert ist, erstellen wir eine .env-Datei mit Schlüssel-Wert-Paaren und setzen diese als Umgebungsvariablen.
So bleibt der geheime Schlüssel verborgen – selbst wenn du den Code öffentlich teilst.
Lege zuerst die .env-Datei an und trage Folgendes ein:
SECRET_KEY = "insert your secret key token here" In unserer main.py können wir die Umgebungsvariablen nun mit dotenv einlesen.
So sieht der Code aus:
import os
from pathlib import Path
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
SECRET_KEY = os.getenv("SECRET_KEY")

client = OpenAI(api_key=SECRET_KEY)

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Jetzt läuft der Code.
Standardmäßig wird eine MP3-Datei mit dem gesprochenen Audio ausgegeben. Wenn du ein anderes Format bevorzugst, kannst du die Ausgabe auf eines der unterstützten Formate umstellen.
Es gibt unzählige Stimmen und Akzente auf der Welt.
Auch wenn sich nicht jede Nuance abbilden lässt, spiegelt OpenAIs TTS die Vielfalt durch sechs einzigartige, integrierte Stimmen wider:
Diese transportieren unterschiedliche Charaktere – oder du wählst einfach nach persönlicher Vorliebe. Setze dafür den gewünschten voice-Wert im Client-Objekt.
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy", # Update this to change voice
  input="Today is a wonderful day to build something people love!"
)
Mehr zu den verfügbaren Stimmen findest du in der Text-to-Speech-API-Dokumentation von OpenAI.
Auch das Ausgabeformat lässt sich ändern.
Standardmäßig liefert die API eine MP3-Datei deines konvertierten Textes. OpenAI stellt jedoch eine Reihe weiterer Formate bereit, je nach Bedarf, zum Beispiel:
Kurzfassung: Deine Wahl des Ausgabeformats beeinflusst Audioqualität, Dateigröße sowie die Kompatibilität mit Geräten und Anwendungen.
Bei der Sprachunterstützung folgt das Text-to-Speech-Modell dem für Speech-to-Text genutzten Whisper-Modell; die Stimmen sind auf Englisch optimiert, bieten jedoch Unterstützung für mehrere andere Sprachen.
Jetzt, da wir die Einrichtung kennen, schauen wir uns an, wie du die TTS-API konkret einsetzen kannst.
Angenommen, du hast ein Buch oder einen Blogpost geschrieben und willst die Reichweite erhöhen, indem du eine Audiofassung anbietest. Klassisch müsstest du eine Sprecherin oder einen Sprecher suchen (oder selbst sprechen) – ein zeitaufwendiger Prozess.
Mit der OpenAI TTS-API lässt sich das deutlich abkürzen: Du übergibst das Textdokument an die API, und sie wandelt es in Sprache um.
Sprachlehrkräfte können statt Gruppenunterricht personalisierte Lektionen in verschiedenen Sprachen und Dialekten mit der Text-to-Speech-API von OpenAI erstellen. Obwohl die Stimmen für Englisch optimiert sind, kann die API Inhalte in mehreren Sprachen generieren.
Mit der OpenAI TTS-API lassen sich KI-Stimmen erzeugen, die natürlicher und ausdrucksstärker klingen als traditionelle TTS-Systeme. Spieleentwickler können das nutzen, um Charaktere lebendiger zu machen und Spieler noch stärker ins Geschehen zu ziehen.
Ein weiteres Szenario sind virtuelle Assistenten und Chatbots, die durch natürliche Stimmen deutlich ansprechender werden.
Die Rate-Limits der OpenAI TTS-API starten bei 50 Requests pro Minute (RPM) für zahlende Konten, und die maximale Eingabelänge beträgt 4.096 Zeichen – das entspricht bei Standardgeschwindigkeit etwa 5 Minuten Audio.
Für die TTS-Modelle gelten folgende Preise:
Für kleine Projekte mit knappem Budget ist das Standardmodell oft die beste Wahl. Das TTS-HD-Modell ist etwas teurer, liefert aber hochauflösendes Audio – ideal, wenn Klangqualität an erster Stelle steht. Mehr dazu unter Preise für OpenAIs Audiomodelle.
OpenAIs Text-to-Speech-API ist ein Endpunkt, mit dem sich hochwertiges gesprochenes Audio aus Text erzeugen lässt. Sechs integrierte Stimmen stehen bereit; je nach Anwendungsfall wählst du zwischen TTS-1 und TTS-1-HD: TTS-1 ist auf Echtzeit-Text-zu-Sprache optimiert, TTS-1-HD auf maximale Qualität.
In diesem Blogpost haben wir behandelt:
Vertiefe dein Wissen mit diesen Ressourcen:
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs