
Cursus
Werken met de OpenAI API
3 uur
184.5K
Stel, je hebt uren besteed aan het schrijven van content.
Je bent tevreden met het eindresultaat en publiceert het.
Na een tijdje in de openbaarheid kom je erachter dat je een groot publiek mist, omdat veel mensen niet de tijd nemen om rustig je werk te lezen.
Je overweegt de content zelf in te spreken, maar tijd is niet je vriend. Je speelt met het idee om een voice-over in te huren, maar de offertes zijn ver boven je budget, en de tijd om iemand met de “juiste” stem te vinden is ook een last.
In typische 21e-eeuwse stijl zoek je technologie voor een oplossing. Zo ontdek je de Text-to-Speech (TTS) API van OpenAI.
In de rest van deze tutorial behandelen we de TTS-API van OpenAI: de belangrijkste features, hoe je begint, maatwerkopties en toepassingen in de praktijk.
Text-to-speech (TTS) is een vorm van ondersteunende technologie die natuurlijke taal in tekstformaat omzet naar spraak. TTS-systemen nemen woorden die op een computer (of ander digitaal apparaat) zijn geschreven en lezen de tekst hardop voor.
De TTS-API van OpenAI is een endpoint waarmee gebruikers kunnen werken met hun TTS-AI-model dat tekst omzet in natuurlijk klinkende gesproken taal. Het model heeft twee varianten:
Het endpoint wordt geleverd met zes stemmen en kan volgens de OpenAI TTS-documentatie worden gebruikt om:
Let er wel op dat de gebruiksvoorwaarden van OpenAI vereisen dat je eindgebruikers duidelijk vertelt dat de TTS-stem die ze horen door AI is gegenereerd en niet door een mens.
Laten we kijken hoe je aan de slag gaat met de OpenAI Text-to-Speech-API: de vereisten en de stappen die je moet volgen.
Zodra je bent ingelogd op je OpenAI-account, kom je op het startscherm. Navigeer vanaf hier naar het OpenAI-logo linksonder om de zijbalk te openen.
Kies “API Keys”.
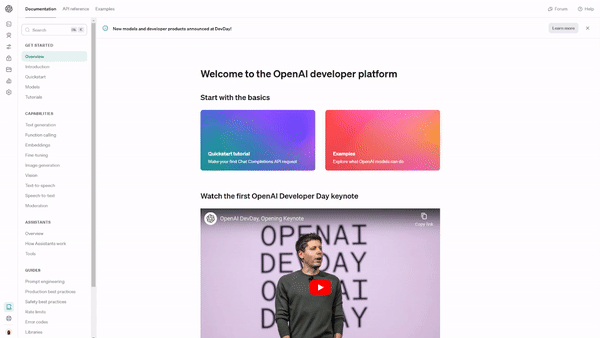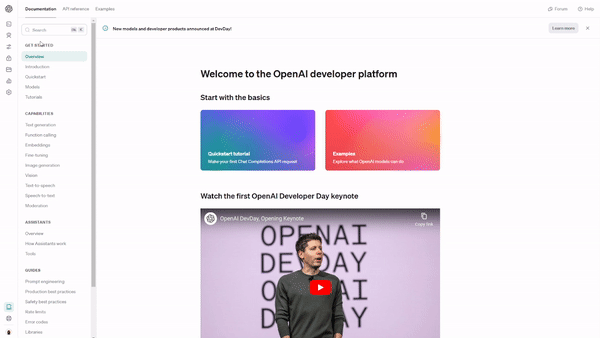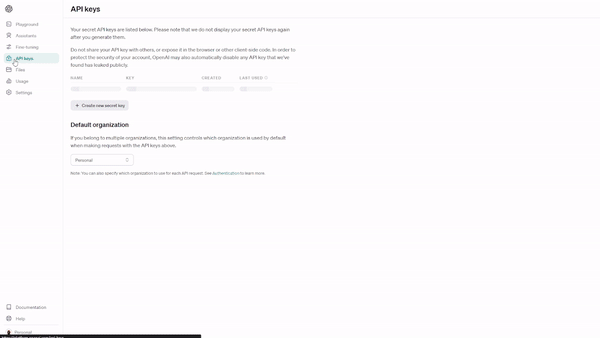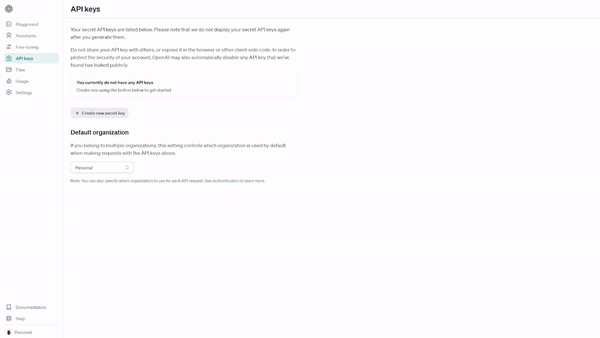
Selecteer “Create new secret key” en geef je API-sleutel een naam – wij noemden de onze “tts-example.”
Wanneer je je API-sleutel aanmaakt, wordt er een geheime sleutel gegenereerd. Zorg dat je de sleutel veilig opslaat.
Nu je de sleutel hebt, kun je aan de slag!
Een virtual environment wordt gebruikt om een container of geïsoleerde omgeving te maken waarin de Python-gerelateerde dependencies voor een specifiek project worden geïnstalleerd. Je kunt met veel verschillende Python-versies en bijbehorende packages werken.
Dieper ingaan op virtual environments valt buiten de scope van dit artikel. Bekijk de tutorial Virtual Environment in Python om er meer over te leren.
Er zijn drie belangrijke inputs die het speech-endpoint nodig heeft:
In de text-to-speech documentatie van OpenAI staat een voorbeeldrequest; we hoeven het wiel dus niet opnieuw uit te vinden.
Zo ziet een voorbeeldrequest eruit:
from pathlib import Path
from openai import OpenAI

client = OpenAI()

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Zoals het er nu staat, zal de code niet draaien.
De reden dat het niet werkt, is dat we de API-sleutel die we in stap één hebben gegenereerd nog niet hebben doorgegeven aan onze OpenAI-client…
De makkelijkste manier om dit op te lossen is een api_key-parameter toe te voegen, zodat we onze geheime sleutel aan het OpenAI()-object kunnen meegeven.
Bijvoorbeeld:
client = OpenAI(api_key="secret key goes here") Dit is echter slechte praktijk in Python.
In plaats daarvan gebruiken we dotenv om de geheime sleutel uit een .env-bestand te lezen.
Het eerste wat je moet doen, is dotenv installeren in je virtual environment. Voer dit commando uit vanuit je virtual environment:
pip install python-dotenvNu dotenv is geïnstalleerd, kunnen we een .env-bestand aanmaken met key-value pairs en de waarden instellen als omgevingsvariabelen.
Zo kunnen we onze geheime sleutel afschermen, zelfs als de code openbaar wordt gedeeld.
Eerst maken we een .env-bestand en zetten we het volgende erin:
SECRET_KEY = "insert your secret key token here" In ons main.py-bestand kunnen we nu onze omgevingsvariabelen met dotenv aanroepen.
Zo ziet de code eruit.
import os
from pathlib import Path
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
SECRET_KEY = os.getenv("SECRET_KEY")

client = OpenAI(api_key=SECRET_KEY)

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Nu draait de code.
Het standaardgedrag van de code is om een MP3-bestand met de gesproken audio te genereren. Als je liever een ander bestandsformaat hebt, kun je de output instellen op elk van de ondersteunde formaten.
Er zijn enorm veel verschillende stemmen en accenten in de wereld.
Hoewel het onmogelijk is om ze allemaal te vangen, probeert de TTS van OpenAI de diversiteit van onze wereld te weerspiegelen door zes unieke ingebouwde stemmen te integreren in de API:
Deze kunnen verschillende persoonlijkheden overbrengen, of je kiest ze gewoon op basis van je voorkeur. Het enige wat je hoeft te doen is de gewenste voice instellen via de voice-parameter in het client-object.
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy", # Update this to change voice
  input="Today is a wonderful day to build something people love!"
)
Bekijk de text-to-speech API-documentatie van OpenAI voor meer informatie over de beschikbare stemmen.
Je kunt ook het outputformaat wijzigen.
De standaardrespons van de API is een MP3-bestand van je geconverteerde tekst. OpenAI biedt echter een reeks andere formaten om aan je behoeften en voorkeuren te voldoen. Zoals:
TL;DR: de gekozen output kan invloed hebben op de audiokwaliteit, bestandsgrootte en compatibiliteit met verschillende apparaten en applicaties.
Qua taalondersteuning volgt het text-to-speech-model het Whisper-model dat voor speech-to-text wordt gebruikt; de stemmen zijn geoptimaliseerd voor Engels, maar hebben ondersteuning voor meerdere andere talen.
Nu we weten hoe we de TTS-API opzetten, kijken we naar een paar voorbeelden van hoe je die kunt gebruiken.
Stel, je hebt een boek of blogpost geschreven en wilt het bereik vergroten door het naar audio te converteren. Doe je dat op de ouderwetse manier, dan moet je een stemacteur zoeken (of het zelf inspreken), wat lang kan duren.
Met de TTS-API van OpenAI kun je dit proces verkorten; je geeft de tekst aan de API door en die zet het om naar spraak.
In plaats van groepslessen te geven, kunnen taaldocenten met de text-to-speech-API van OpenAI gepersonaliseerde lessen maken voor studenten in verschillende talen en dialecten. Ondanks dat de stemmen zijn geoptimaliseerd voor Engels, kun je met de API nog steeds audiocontent in meerdere talen genereren.
De TTS-API van OpenAI kan worden gebruikt om AI-stemmen te creëren die realistischer en expressiever klinken dan traditionele TTS-systemen. Game-ontwikkelaars kunnen deze mogelijkheid benutten voor personages, zodat spelers nog meer worden ondergedompeld in de ervaring.
Een andere toepassing is het maken van virtuele assistenten en chatbots die boeiender zijn dan veel traditionele varianten.
De snelheidslimieten voor de OpenAI TTS-API beginnen bij 50 requests per minuut (RPM) voor betaalde accounts, en de maximale invoerlengte is 4096 tekens – ongeveer gelijk aan 5 minuten audio op standaard snelheid.
Wat de TTS-modellen betreft, zijn de prijzen als volgt:
Zoek je een voordelige manier om de TTS-API in een klein project te integreren, dan kun je beter voor het standaard TTS-model kiezen. Het TTS HD-model is iets duurder maar biedt high-definition audio, ideaal als de audiokwaliteit cruciaal is – lees meer over prijzen voor de audiomodellen van OpenAI.
De text-to-speech-API van OpenAI is een endpoint waarmee je hoogwaardige gesproken audio uit tekst kunt genereren. Er zijn zes ingebouwde stemmen en je kunt kiezen uit twee modellen, TTS-1 en TTS-1-HD, afhankelijk van je use case; TTS-1 is geoptimaliseerd voor realtime text-to-speech, terwijl TTS-1-HD is geoptimaliseerd voor kwaliteit.
In deze blogpost hebben we behandeld:
Bekijk deze handige resources om verder te leren:
Begin vandaag nog aan je AI-reis!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

