
Corso
Lavorare con l'API di OpenAI
3 ore
185.3K
Immagina di aver passato ore a scrivere un contenuto.
Sei soddisfatto del risultato finale, quindi lo pubblichi.
Dopo un po' che è online, ti rendi conto che ti stai precludendo un pubblico enorme: molte persone non sentono di avere il tempo per sedersi e leggere il tuo lavoro.
Valuti l'idea di narrarlo tu stesso, ma il tempo non è dalla tua. Prendi in considerazione l'idea di assumere un narratore, ma i preventivi che ricevi sono ben oltre il tuo budget, e trovare qualcuno con la voce "giusta" richiede tempo.
Come spesso accade nel XXI secolo, ti rivolgi alla tecnologia in cerca di una soluzione. È così che scopri la Text-to-Speech (TTS) API di OpenAI.
Nel resto di questo tutorial, tratteremo la TTS API di OpenAI: le caratteristiche principali, come iniziare, la personalizzazione e alcuni casi d'uso reali.
La sintesi vocale (TTS) è una tecnologia assistiva che converte il linguaggio naturale, fornito in formato testuale, in parlato. In pratica, i sistemi TTS prendono parole scritte su un computer (o altro dispositivo digitale) e leggono il testo ad alta voce.
La TTS API di OpenAI è un endpoint che consente agli utenti di interagire con il loro modello di IA TTS che converte il testo in parlato dal suono naturale. Il modello ha due varianti:
L'endpoint include sei voci predefinite e, secondo la documentazione TTS di OpenAI, può essere usato per:
È però importante notare che le Norme d'uso di OpenAI richiedono di informare chiaramente gli utenti finali che la voce TTS che ascoltano è generata da un'IA e non da una voce umana.
Vediamo come iniziare a usare la Text-to-Speech API di OpenAI, partendo dai prerequisiti e dai passaggi da seguire:
Una volta effettuato l'accesso al tuo account OpenAI, verrai indirizzato alla schermata iniziale. Da qui, vai al logo OpenAI nell'angolo in alto a sinistra della pagina per aprire la barra laterale.
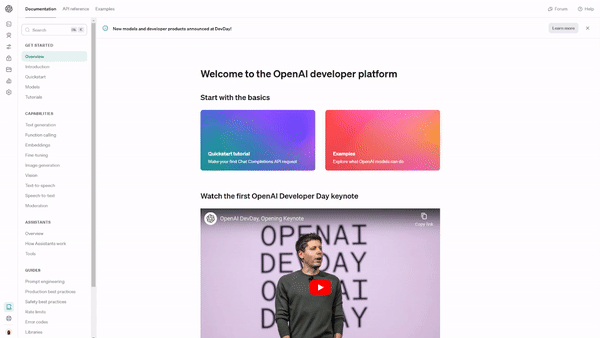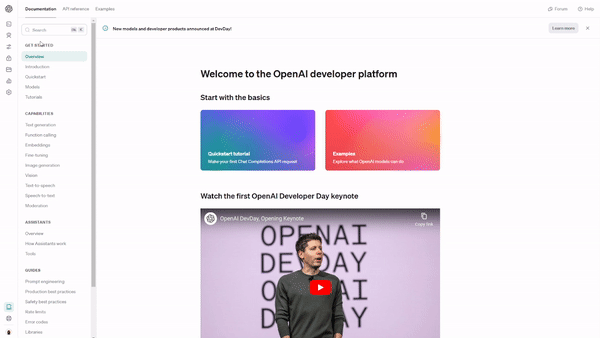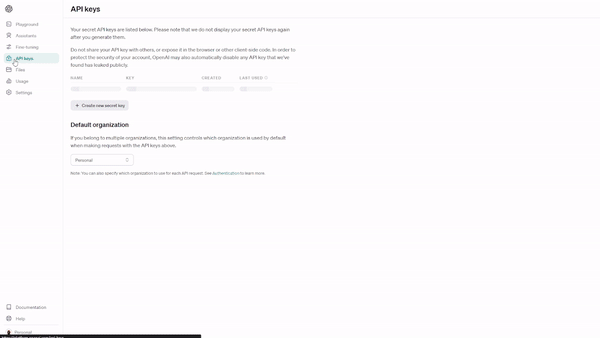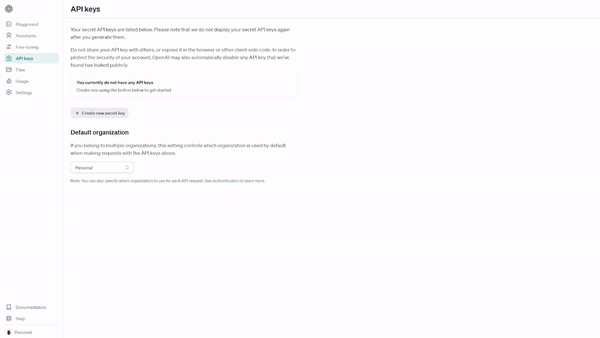
Seleziona "API Keys".
Seleziona "Create new secret key" e dai un nome alla tua chiave API – noi l'abbiamo chiamata "tts-example".
Quando crei la chiave API, verrà generata una chiave segreta. Assicurati di salvarla in un posto sicuro.
Ora che hai la chiave, sei pronto per iniziare!
Un ambiente virtuale serve a creare un contenitore o ambiente isolato in cui installare le dipendenze legate a Python per un progetto specifico. Si può lavorare con molte versioni diverse di Python e i relativi pacchetti.
Approfondire gli ambienti virtuali esula dallo scopo di questo articolo. Dai un'occhiata al tutorial Virtual Environment in Python per saperne di più sulla loro creazione.
Ci sono tre input chiave che l'endpoint per la sintesi vocale richiede:
Nella documentazione text-to-speech di OpenAI trovi una richiesta di esempio; non dobbiamo quindi reinventare la ruota.
Ecco come appare una richiesta di esempio:
from pathlib import Path
from openai import OpenAI

client = OpenAI()

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Così com'è, il codice non verrà eseguito.
Il motivo è che non abbiamo passato al client OpenAI la chiave API generata al passo uno…
Il modo più semplice per risolvere il problema è aggiungere un parametro api_key con cui passare la nostra chiave segreta all'oggetto OpenAI().
Per esempio:
client = OpenAI(api_key="secret key goes here") Farlo in questo modo è una cattiva pratica in Python.
Invece, useremo dotenv per leggere la chiave segreta da un file .env.
Per prima cosa devi installare dotenv nel tuo ambiente virtuale. Esegui questo comando dal tuo ambiente virtuale:
pip install python-dotenvOra che dotenv è installato, possiamo creare un file .env, che contiene coppie chiave-valore, e impostare i valori come variabili d'ambiente.
Questo ci permette di occultare la chiave segreta, anche se il codice viene condiviso pubblicamente.
Per prima cosa, creiamo un file .env e inseriamo quanto segue:
SECRET_KEY = "insert your secret key token here" Nel nostro file main.py possiamo ora richiamare le variabili d'ambiente usando dotenv.
Ecco come appare il codice.
import os
from pathlib import Path
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
SECRET_KEY = os.getenv("SECRET_KEY")

client = OpenAI(api_key=SECRET_KEY)

speech_file_path = Path(__file__).parent / "speech.mp3"
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy",
  input="Today is a wonderful day to build something people love!"
)

response.stream_to_file(speech_file_path)
Ora il codice funziona.
Il comportamento predefinito del codice è di produrre un file MP3 dell'audio parlato. Se preferisci un formato diverso, puoi configurare l'output in uno qualsiasi dei formati supportati.
Nel mondo esistono moltissime voci e accenti.
Pur non essendo possibile catturarli tutti, la TTS di OpenAI ha cercato di riflettere la diversità del nostro mondo integrando sei voci uniche direttamente nell'API:
Queste possono trasmettere personalità diverse, oppure puoi sceglierle in base alle tue preferenze. Tutto ciò che devi fare è impostare la voice che vuoi usare tramite il parametro della voce nell'oggetto client.
response = client.audio.speech.create(
  model="tts-1",
  voice="alloy", # Update this to change voice
  input="Today is a wonderful day to build something people love!"
)
Dai un'occhiata alla documentazione dell'API text-to-speech di OpenAI per saperne di più sulle voci disponibili.
Puoi anche modificare il formato di output.
La risposta predefinita dell'API è un file MP3 del testo convertito. Tuttavia, OpenAI offre una serie di altri formati per adattarsi alle tue esigenze e preferenze. Ad esempio:
In sintesi: la scelta dell'output può influire sulla qualità dell'audio, sulla dimensione del file e sulla compatibilità con vari dispositivi e applicazioni.
Quanto al supporto delle lingue, il modello text-to-speech segue il modello Whisper usato per il riconoscimento vocale; le voci sono ottimizzate per l'inglese ma supportano diverse altre lingue.
Ora che sappiamo come configurare la TTS API, vediamo alcuni esempi di utilizzo.
Poniamo che tu abbia scritto un libro o un post del blog e voglia ampliarnee la portata convertendolo in audio. Con i metodi tradizionali, dovresti trovare un narratore (o narrarlo tu), cosa che può richiedere molto tempo.
La TTS API di OpenAI può abbreviare questo processo: ti basta passare il documento di testo all'API, che lo convertirà in parlato.
Invece di tenere lezioni di gruppo, gli insegnanti di lingue possono usare la text-to-speech API di OpenAI per creare lezioni personalizzate per gli studenti in varie lingue e dialetti. Nonostante le voci siano ottimizzate per l'inglese, l'API può comunque generare contenuti audio in diverse lingue.
La TTS API di OpenAI può essere utilizzata per creare voci di IA più realistiche ed espressive rispetto ai sistemi TTS tradizionali. Gli sviluppatori di videogiochi possono sfruttare questa capacità e applicarla ai personaggi per rendere l'esperienza più immersiva.
Un altro caso d'uso può essere la creazione di assistenti virtuali e chatbot più coinvolgenti rispetto a quelli tradizionali.
I limiti di velocità per la TTS API di OpenAI partono da 50 richieste al minuto (RPM) per gli account a pagamento, e la dimensione massima dell'input è di 4096 caratteri – equivalente a circa 5 minuti di audio alla velocità predefinita.
Per quanto riguarda i modelli TTS, i prezzi sono i seguenti:
Se cerchi un modo conveniente per integrare la TTS API in un progetto piccolo, potresti optare per il modello TTS standard. Il modello TTS HD è leggermente più costoso ma offre audio in alta definizione, ideale quando la qualità è fondamentale – scopri di più sui prezzi dei modelli audio di OpenAI.
La text-to-speech API di OpenAI è un endpoint che permette di generare audio parlato di alta qualità a partire dal testo. Include sei voci integrate e consente di scegliere tra due modelli, TTS-1 e TTS-1-HD, a seconda del caso d'uso: TTS-1 è ottimizzato per la sintesi in tempo reale, mentre TTS-1-HD è ottimizzato per la qualità.
In questo post abbiamo visto:
Dai un'occhiata a queste risorse per continuare ad imparare:
Inizia oggi il tuo percorso nell'IA!
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



