
{count, plural, one {Kursus} other {Kursus}}
Konsep Databricks
{hours} jam
23.6K
Pertama, ada data warehouse. Mereka menyimpan data dalam baris dan kolom karena pada masa itu Internet dan komputer hanya mampu mendistribusikan informasi teks sederhana. Jauh kemudian hadir data lake — yang dapat menyimpan hampir semua jenis data yang dapat Anda kumpulkan. Ini sangat cocok untuk era media sosial dan YouTube.
Namun, keduanya memiliki kelemahan — data warehouse mahal dan tidak cocok untuk ilmu data modern, sementara data lake berantakan dan sering berubah menjadi data swamp. Jadi, perusahaan mulai memiliki dua tumpukan teknologi terpisah — warehouse untuk BI dan analitik serta lake untuk machine learning.
Akan tetapi, mengelola dua arsitektur data yang berbeda begitu merepotkan sehingga perusahaan sering mendapatkan hasil yang kurang baik. Masalah ini memunculkan arsitektur lakehouse, yang menjadi alasan utama Databricks terkenal.
Databricks adalah platform berbasis cloud yang memungkinkan pengguna mendapatkan nilai dari warehouse dan lake dalam lingkungan terpadu. Artikel ini akan memberikan gambaran umum tentang platform tersebut, menampilkan fitur-fitur terpentingnya dan cara menggunakannya.
Databricks adalah platform yang begitu besar hingga dokumentasinya saja bisa dijadikan buku. Jadi, tujuan artikel ini adalah memberikan hierarki konsep — penjelasan berurutan tentang fitur-fitur Databricks yang akan membawa Anda dari pemula menjadi praktisi Databricks yang mumpuni. Jika Anda benar-benar baru, Anda juga dapat melihat kursus Introduction to Databricks kami.
Mari kita mulai!
Saat Anda membaca kata Databricks, Anda harus langsung memikirkannya sebagai sebuah platform, bukan sekadar framework atau pustaka Python. Biasanya, platform menawarkan beragam fitur, dan Databricks tidak terkecuali. Ini adalah salah satu dari sedikit platform yang dapat digunakan oleh profesional data mana pun, dari data engineer hingga machine learning engineer modern (atau yang kini sering disebut media sebagai programmer AI).
Databricks memiliki komponen inti berikut:
Kombinasi komponen-komponen ini membuka berbagai manfaat:
Jika saya sudah berhasil meyakinkan Anda tentang pentingnya Databricks di dunia data, mari kita mulai menggunakan platform ini.
Untuk menyiapkan akun Anda, buka https://www.databricks.com/try-databricks dan daftar untuk Community Edition.
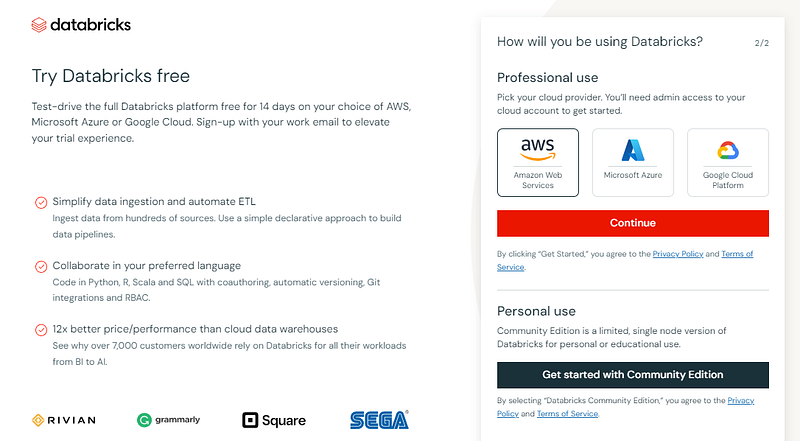
Community Edition memiliki fitur yang lebih sedikit dibandingkan versi Enterprise, tetapi tidak memerlukan penyiapan penyedia cloud, yang sangat cocok untuk penggunaan kecil seperti tutorial.
Jika Anda melihat halaman ini setelah verifikasi email, berarti Anda siap memulai:
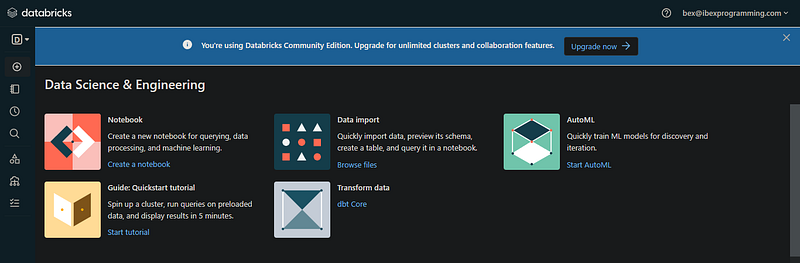
Antarmuka yang Anda lihat adalah Workspace untuk alamat email Anda (workspace Community Edition dapat ditemukan dengan mudah). Dalam praktiknya, biasanya admin akun dari perusahaan Anda membuat satu akun Databricks dan mengelola akses ke workspace.
Sekarang, mari pahami UI platform. Di panel kiri, ada menu untuk berbagai komponen yang ditawarkan Databricks. Versi enterprise akan memiliki lebih banyak tombol:
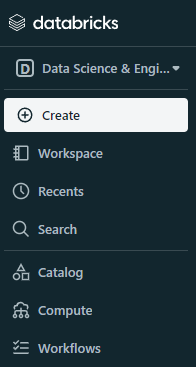
Pilihan pertama di menu adalah jenis workspace, yang secara bawaan disetel ke data science and engineering. Jika Anda mengubahnya ke machine learning, opsi Experiments baru akan muncul:
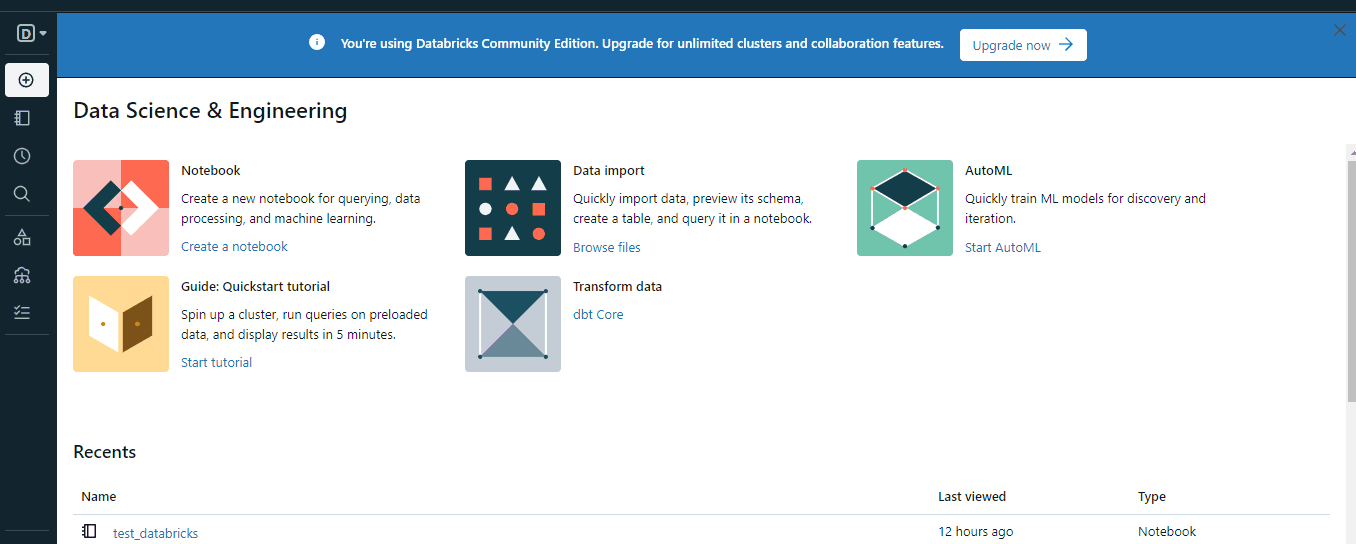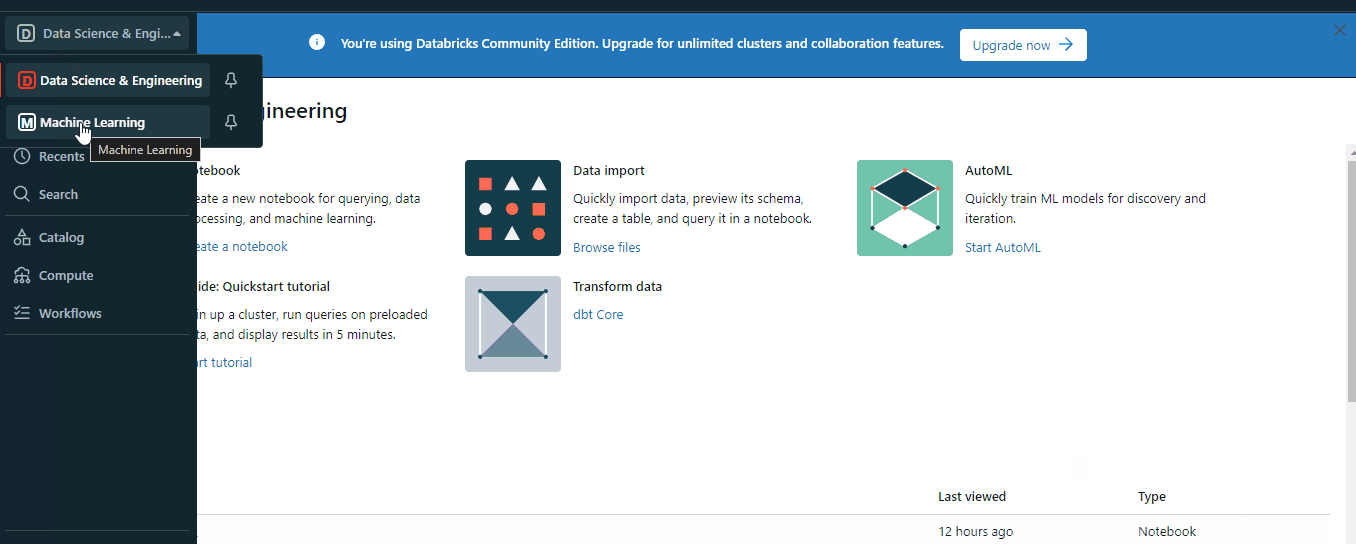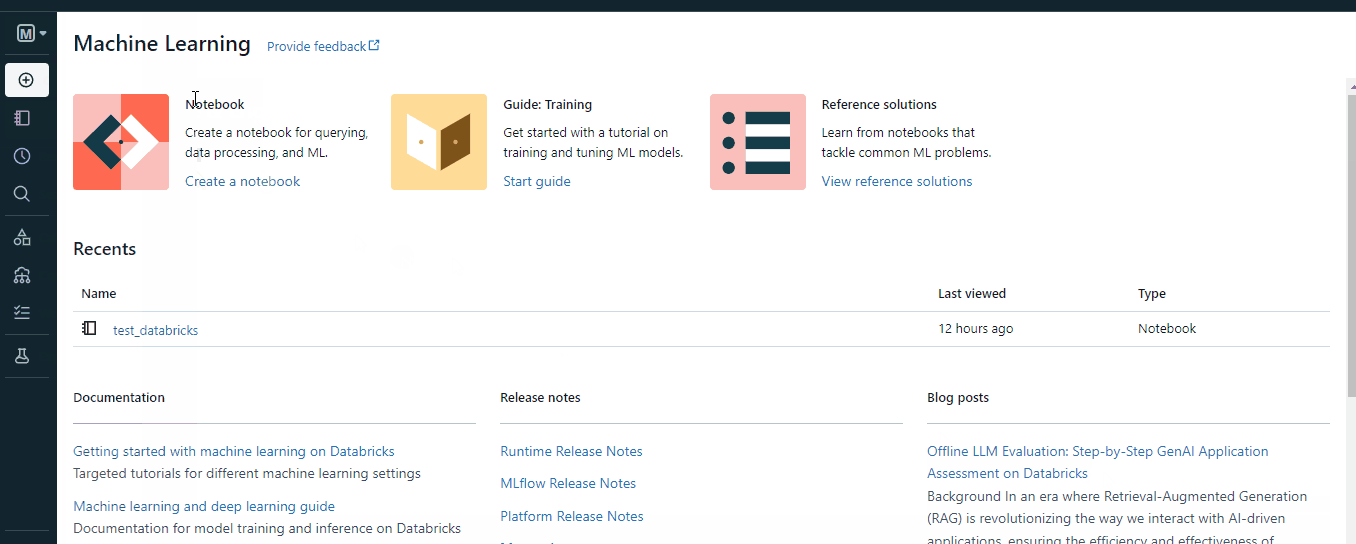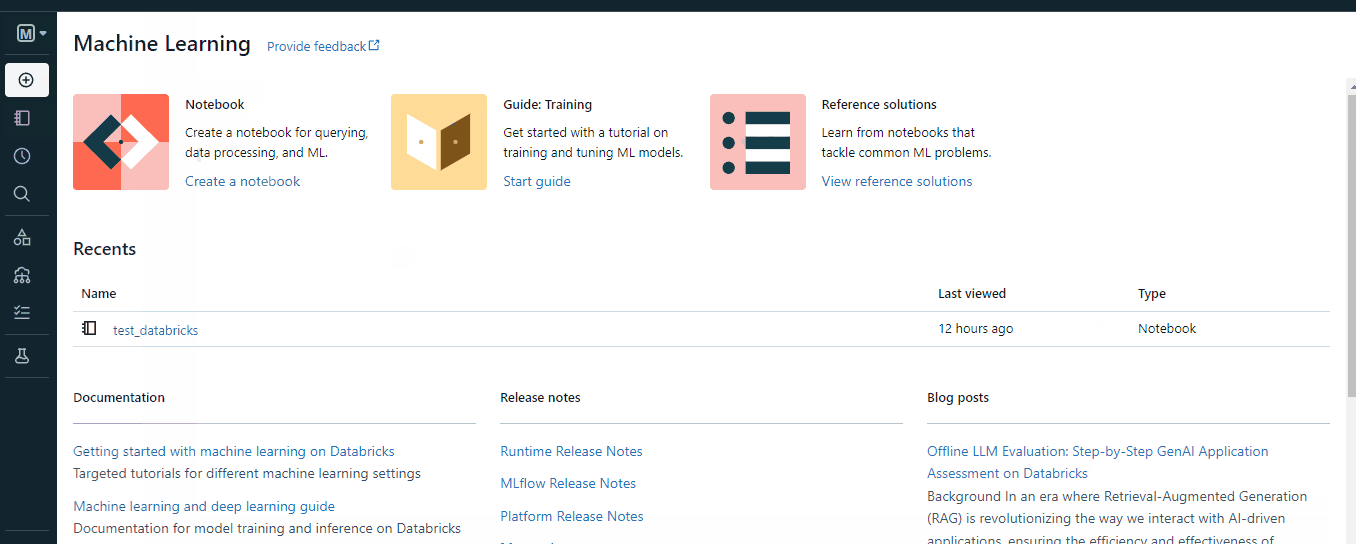
Sekilas, tampaknya tidak banyak yang berubah, tetapi setelah Anda meningkatkan akun dan mulai bereksperimen, Anda akan melihat beberapa fitur platform yang hebat:
dan seterusnya.
Sekarang, mari kita lihat beberapa komponen ini lebih dekat.
Cluster di Databricks mengacu pada sumber daya komputasi yang digunakan untuk mengeksekusi tugas pemrosesan data. Biasanya, cluster disediakan oleh penyedia cloud pilihan Anda saat menyiapkan akun.
Cluster Community Edition terbatas dalam RAM dan daya CPU, serta tidak menyertakan GPU. Namun, pengguna premium sering kali dapat melakukan tugas-tugas berikut dengan cluster secara mudah:
Untuk membuat cluster, Anda dapat menggunakan tombol “Create” atau opsi “Compute” dari menu:
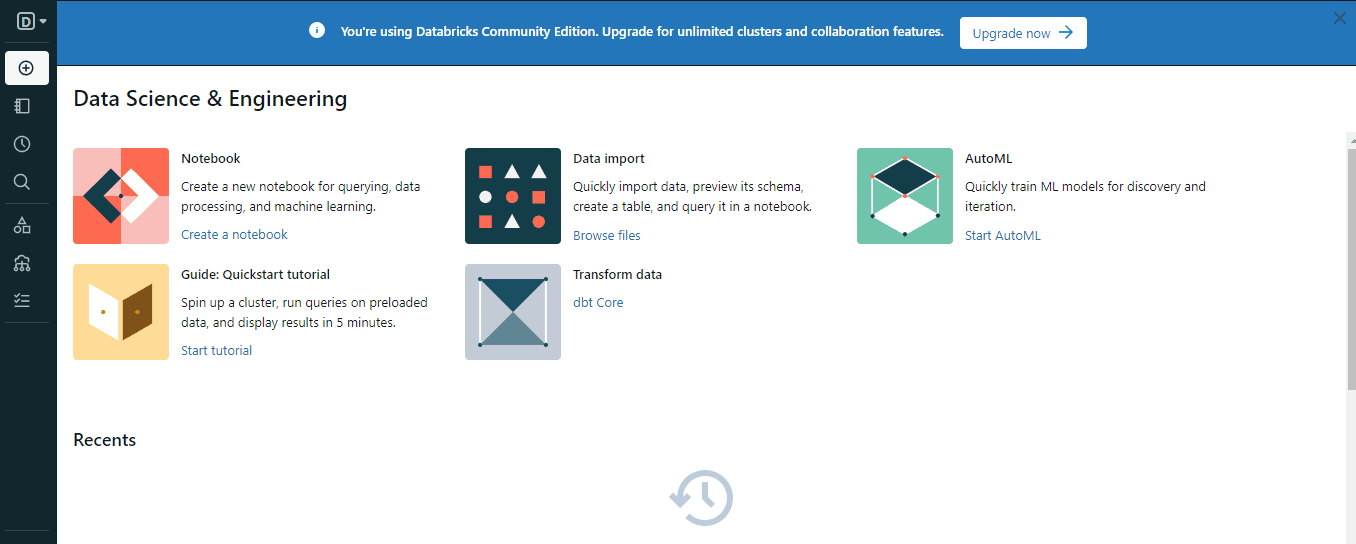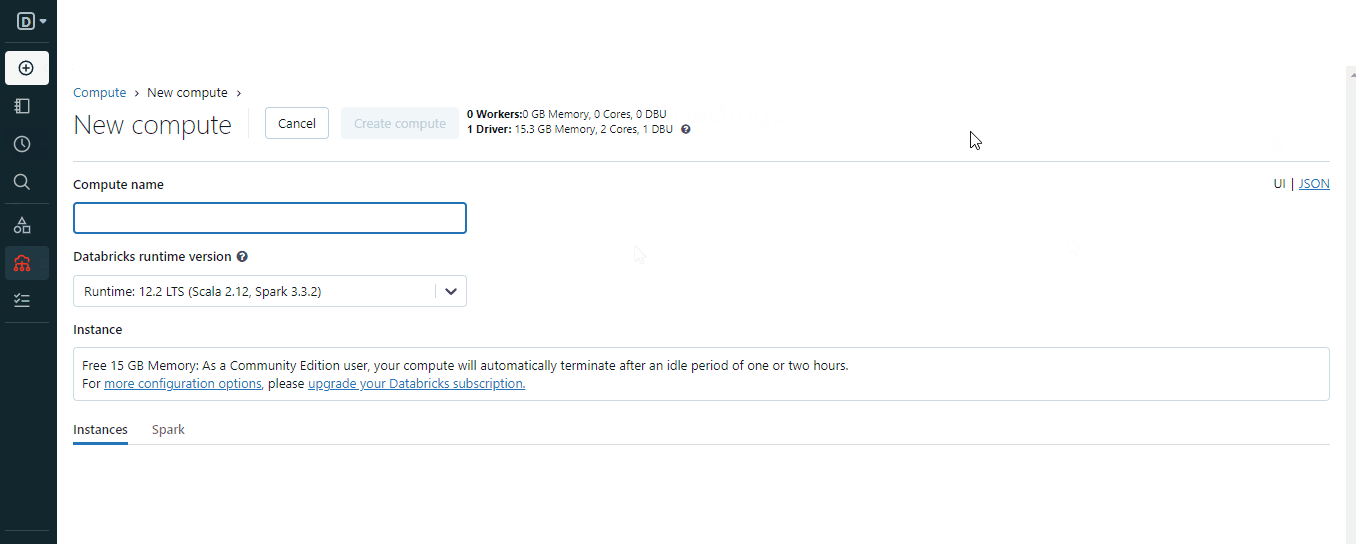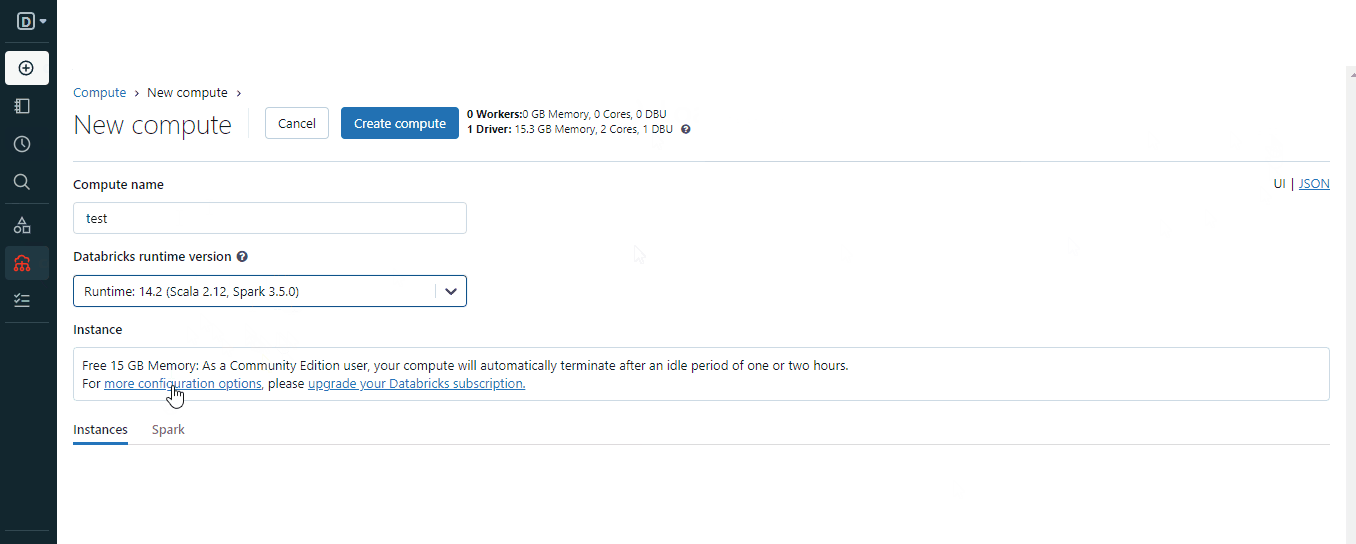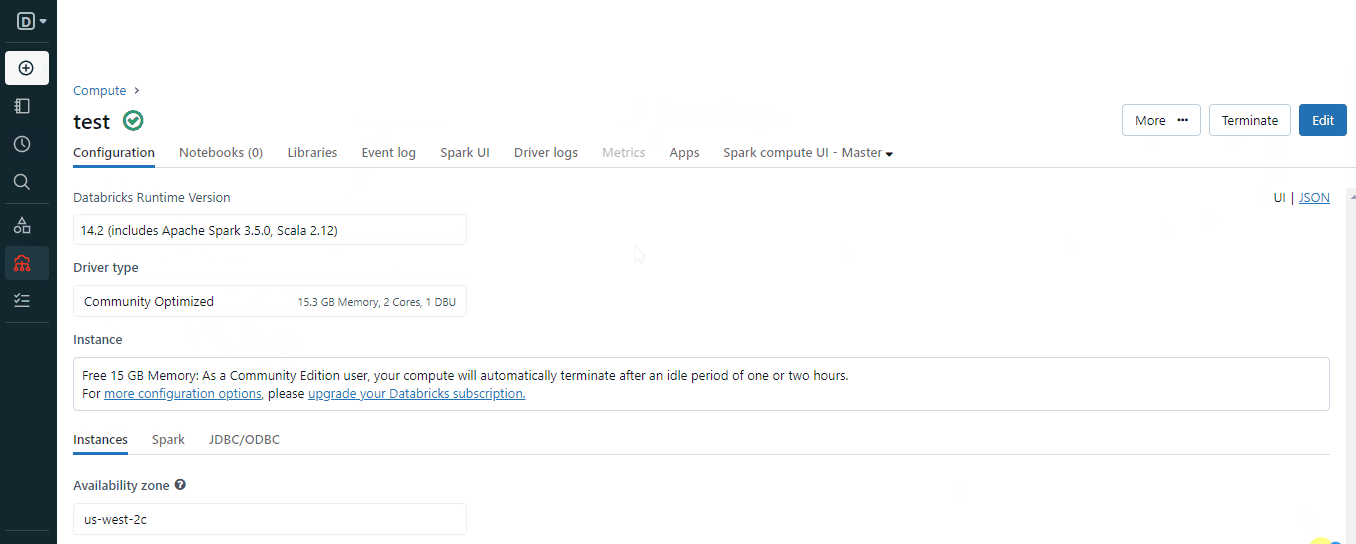
Saat membuat cluster, pilih versi Spark yang sesuai untuk lingkungan Anda dan tunggu beberapa menit hingga siap digunakan.
Setelah Anda memiliki cluster yang berjalan, Anda siap membuat notebook. Jika Anda pernah menggunakan Jupyter, Colab, atau DataCamp Workspaces, tampilan ini akan terasa familiar:
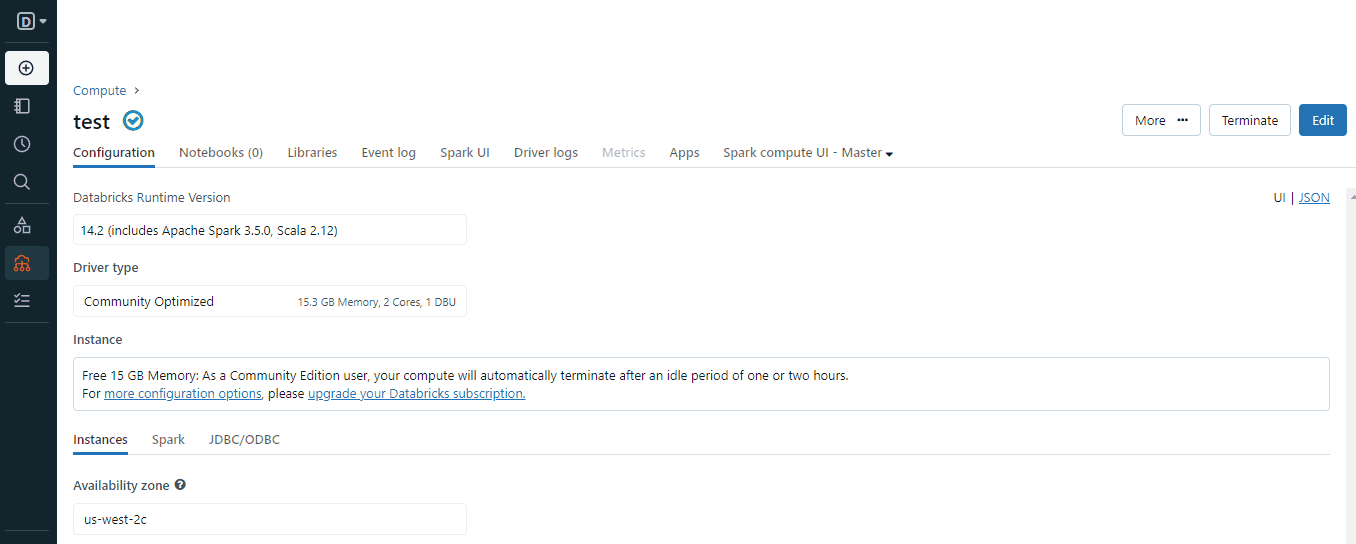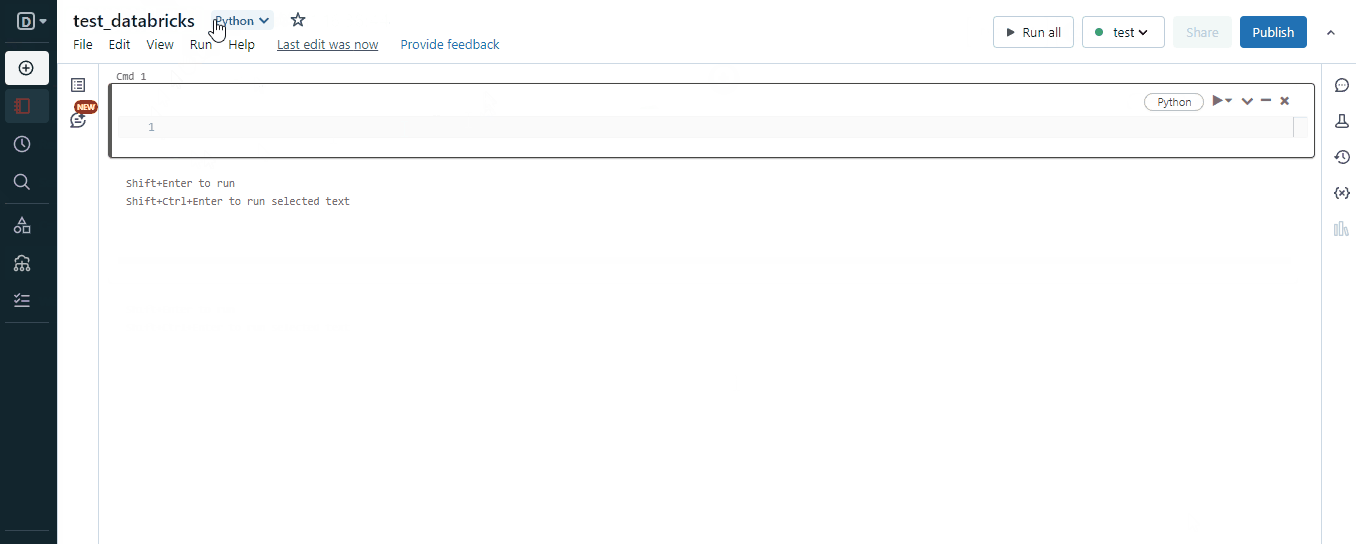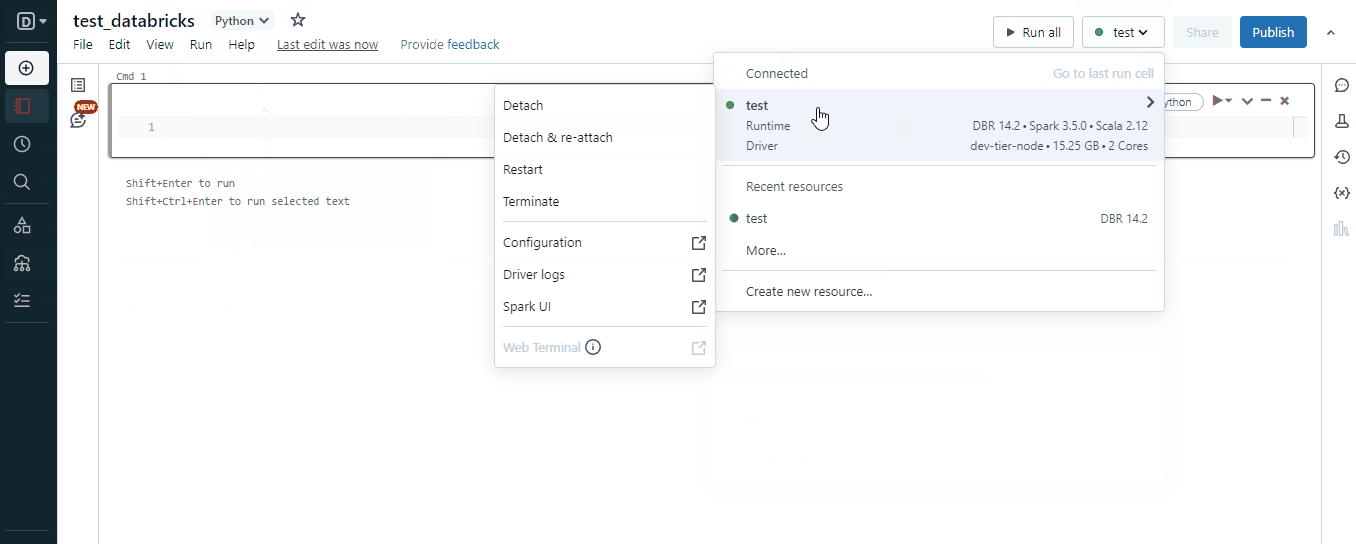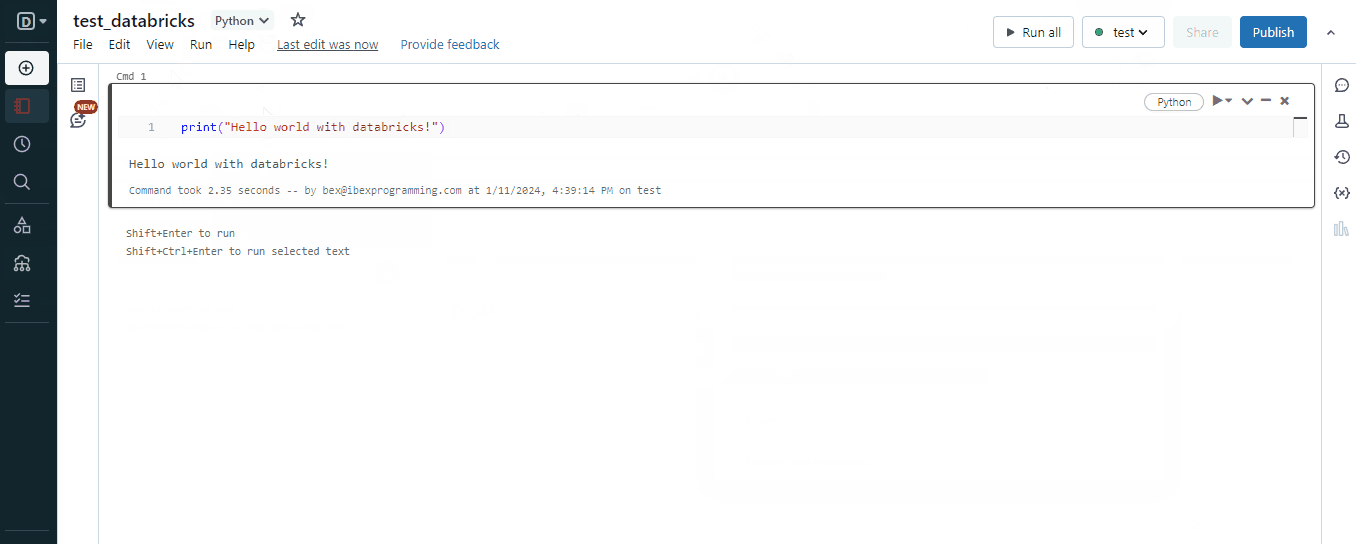
Namun di dunia yang sudah memiliki Jupyter, mengapa memilih sesuatu yang “mirip Jupyter”? Nah, notebook Databricks memiliki keunggulan berikut dibandingkan notebook Jupyter:
Ada banyak keunggulan lain dari notebook Databricks dibandingkan Jupyter, jadi berikut tabel yang merangkum perbedaannya:
|
Fitur |
Jupyter Notebook |
Notebook Databricks |
|
Platform |
Sumber terbuka, berjalan secara lokal atau di platform cloud |
Eksklusif untuk platform Databricks |
|
Kolaborasi dan Berbagi |
Fitur kolaborasi terbatas, berbagi manual |
Kolaborasi bawaan, penyuntingan serentak secara real-time |
|
Eksekusi |
Bergantung pada server lokal atau eksternal |
Eksekusi pada cluster Databricks |
|
Integrasi dengan Big Data |
Dapat diintegrasikan dengan Spark, memerlukan konfigurasi tambahan |
Integrasi native dengan Apache Spark, dioptimalkan untuk big data |
|
Fitur Bawaan |
Alat/ekstensi eksternal untuk kontrol versi, kolaborasi, dan visualisasi |
Terintegrasi dengan fitur khusus Databricks seperti Delta Lake, dukungan bawaan untuk alat kolaborasi dan analitik |
|
Biaya dan Skalabilitas |
Instalasi lokal sering gratis, solusi berbasis cloud mungkin berbiaya |
Layanan berbayar, biaya bergantung penggunaan, skala mulus dengan cluster Databricks |
|
Kemudahan Penggunaan |
Familiar dan banyak digunakan di komunitas ilmu data |
Didesain untuk analitik big data, mungkin memiliki kurva belajar lebih tinggi untuk fitur khusus Databricks |
|
Visualisasi Data |
Dukungan bawaan untuk visualisasi data terbatas |
Dukungan bawaan untuk visualisasi data dalam lingkungan notebook |
|
Manajemen Cluster |
Pengguna perlu mengelola sesi Spark dan dependensi secara manual |
Platform Databricks menangani manajemen dan penskalaan cluster secara otomatis |
|
Kasus Penggunaan |
Serbaguna untuk berbagai tugas ilmu data |
Dikhususkan untuk analitik big data kolaboratif dalam platform Databricks |
Pada akhirnya, keunggulan notebook Databricks di atas akan terasa pada kasus penggunaan tertentu. Jika Anda ingin bereksperimen dengan dataset CSV menggunakan Pandas di laptop, Jupyter jauh lebih baik.
Namun, untuk aplikasi tingkat perusahaan, Databricks sebagai platform bisa menjadi pilihan yang lebih baik.
Ingesti data mengacu pada proses mengimpor data dari berbagai sumber. Databricks mendukung ingest dari berbagai sumber, termasuk:
dan seterusnya.
Sekarang, mari kita lihat bagaimana Anda dapat memuat jenis data tertentu ke Databricks. Kita akan mulai dengan file lokal:
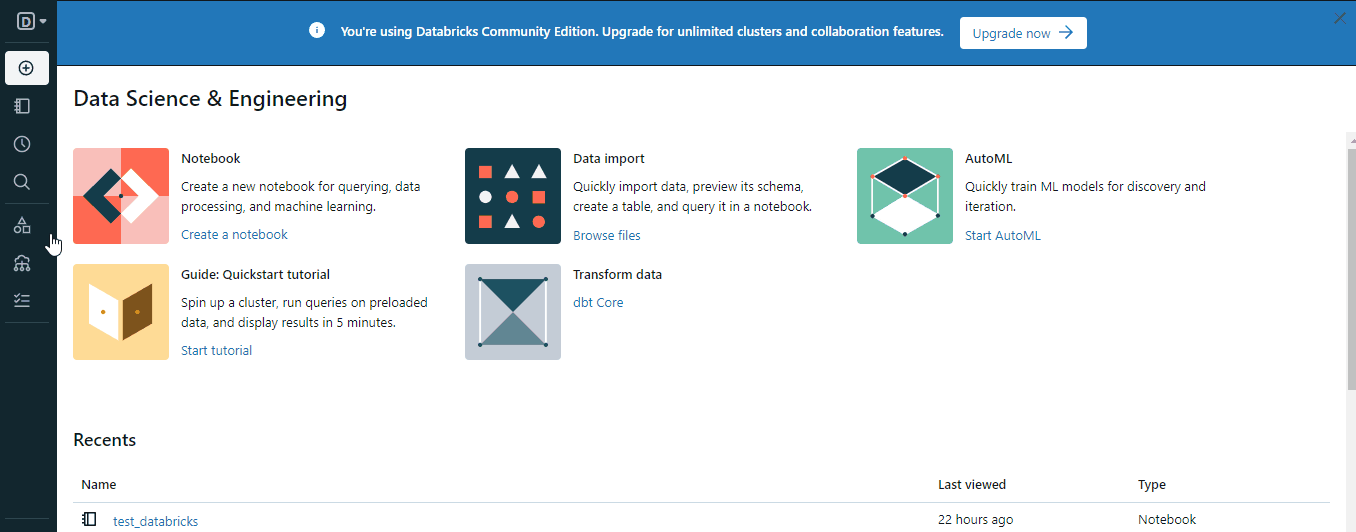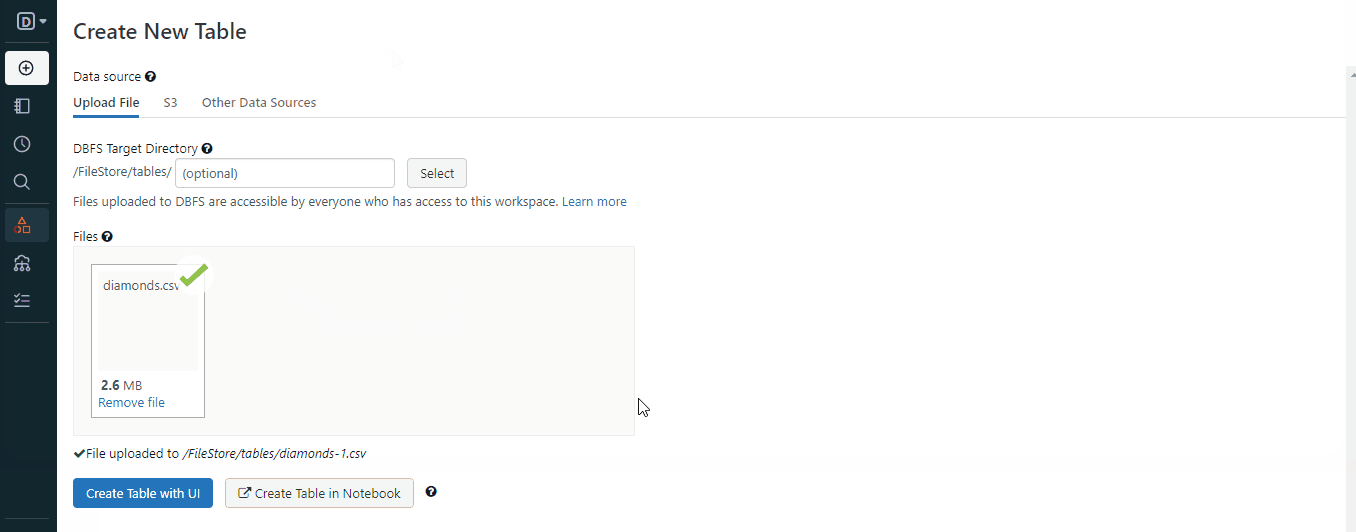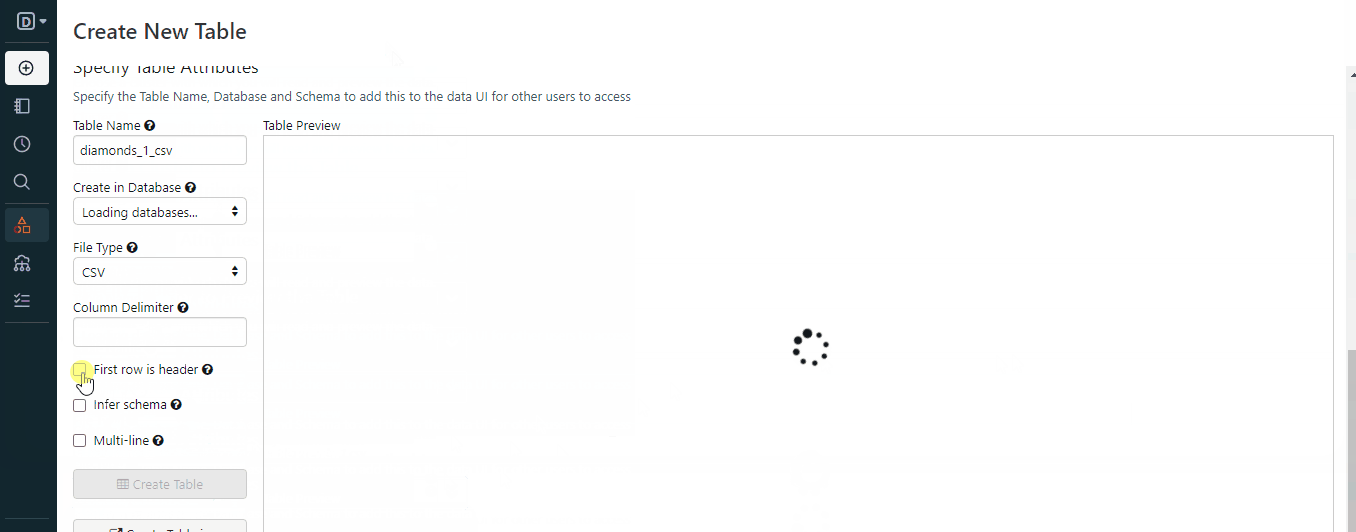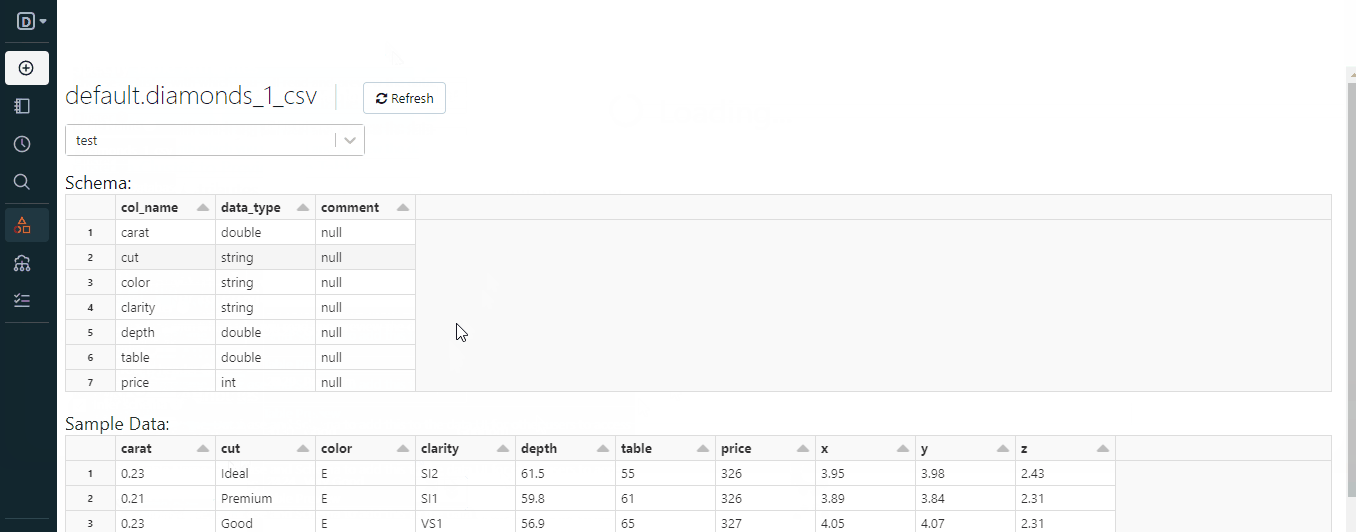
Setelah mengikuti langkah-langkah dalam GIF, Anda akan memiliki file yang tersimpan di workspace. Berikut cara memuatnya dengan Spark:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Perhatikan awalan dbfs:. Semua file workspace harus menyertakannya agar file dapat dimuat dengan benar menggunakan Spark. DBFS adalah singkatan dari databricks file system.
Mengimpor data dari bucket S3 serupa (untuk akun enterprise):
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Untuk jenis data lainnya, Anda dapat melihat bagian Data engineering dan Connect to data sources pada dokumentasi Databricks.
Saat kita mengunggah file diamonds.csv, file tersebut menjadi tabel Databricks dalam database bernama default:
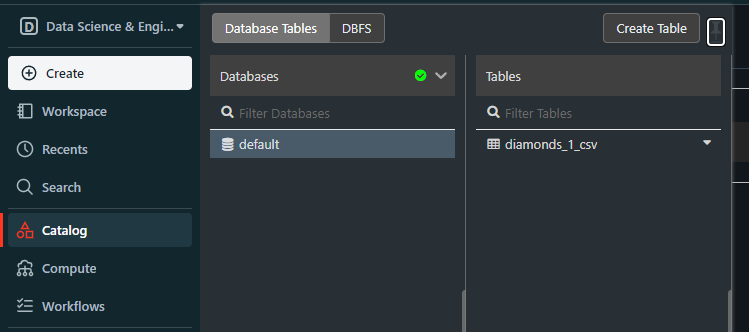
Database default ini dibuat setiap kali kita mencoba memuat file terstruktur tanpa membuat database terlebih dahulu.
Jika kita sudah memiliki database, artinya kita dapat menanyakannya dengan SQL, tidak hanya dengan Spark. Untuk melakukannya, buat notebook baru atau ubah bahasa notebook saat ini ke SQL. Lalu, coba cuplikan kode berikut:
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
Perintah ini akan mengembalikan lima baris teratas dari tabel diamonds:
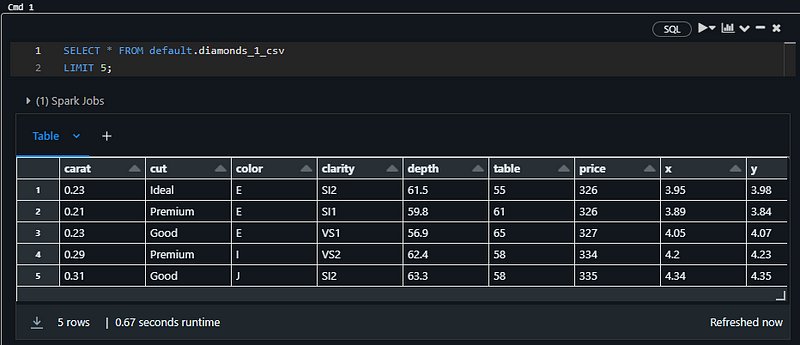
Catatan: Saya menggunakan notebook SQL untuk cuplikan di atas
Anda juga dapat memuat tabel ini di Pandas. Dalam notebook yang sama, tempel cuplikan berikut:
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
Ini akan menampilkan head dari tabel:
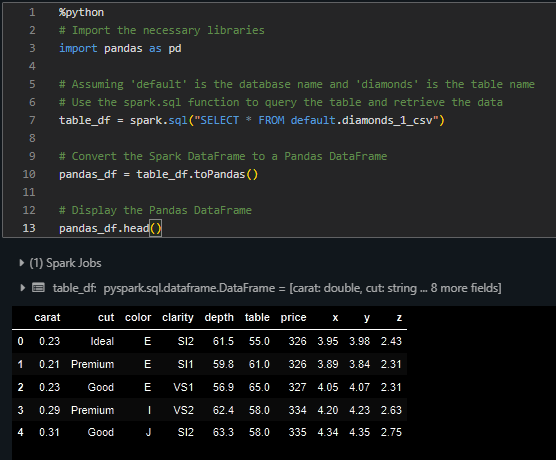
Sekarang, Anda dapat melakukan tugas analisis data apa pun pada tabel tersebut baik dengan SQL maupun Pandas.
Kita berhasil mempelajari dan melakukan banyak hal hanya dengan akun Databricks Community Edition yang minimal. Untuk terus belajar tentang platform ini, langkah pertama adalah menggunakan uji coba gratis dua minggu yang ditawarkan Databricks untuk akun premium.
Setelah itu, Anda dapat sepenuhnya menikmati pelajaran dari kursus Introduction to Databricks yang ditawarkan oleh DataCamp. Selain penyiapan akun, Anda akan belajar dan berlatih menggunakan fitur inti berikut dari DataCamp:
Mulai Perjalanan Databricks Anda Hari Ini!
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Program} other {Program}}
{count, plural, one {Program} other {Program}}
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



