
Khóa học
Các khái niệm về Databricks
4 giờ
23.8K
Ban đầu là kho dữ liệu (data warehouse). Chúng lưu trữ dữ liệu theo hàng và cột vì thời đó Internet và máy tính chỉ có thể phân phối thông tin dạng văn bản đơn giản. Về sau xuất hiện hồ dữ liệu (data lake) — có thể lưu hầu như mọi kiểu dữ liệu bạn thu thập được. Chúng rất phù hợp với thời đại mạng xã hội và YouTube.
Nhưng cả hai đều có nhược điểm — kho dữ liệu đắt đỏ và không phù hợp với khoa học dữ liệu hiện đại, trong khi hồ dữ liệu thì lộn xộn và thường biến thành "đầm lầy dữ liệu". Vì vậy, các công ty bắt đầu có hai ngăn xếp công nghệ riêng biệt — warehouse cho BI và phân tích, còn lake cho máy học.
Tuy nhiên, việc quản lý hai kiến trúc dữ liệu khác nhau lại quá phiền toái khiến kết quả thường không tốt. Vấn đề này đã làm nảy sinh kiến trúc lakehouse, cũng chính là điều làm nên tên tuổi của Databricks.
Databricks là nền tảng đám mây cho phép người dùng khai thác giá trị của cả warehouse và lake trong một môi trường hợp nhất. Bài viết này sẽ giới thiệu tổng quan về nền tảng, nêu các tính năng quan trọng nhất và cách sử dụng.
Databricks là một nền tảng lớn đến mức tài liệu của nó cũng có thể viết thành sách. Vì vậy, mục tiêu của bài viết là cung cấp cho bạn một trật tự khái niệm — những giải thích theo trình tự tuyến tính về các tính năng của Databricks, giúp bạn đi từ người mới bắt đầu đến người dùng vững vàng. Nếu bạn hoàn toàn mới, bạn cũng có thể xem khóa học Introduction to Databricks của chúng tôi.
Hãy bắt đầu!
Khi đọc đến Databricks, bạn nên nghĩ ngay đó là một nền tảng, không phải một framework hay thư viện Python. Thông thường, các nền tảng cung cấp phạm vi tính năng rộng, và Databricks cũng không ngoại lệ. Đây là một trong số rất ít nền tảng có thể được mọi chuyên gia dữ liệu sử dụng, từ kỹ sư dữ liệu đến kỹ sư máy học hiện đại (hay báo chí ngày nay gọi là lập trình viên AI).
Databricks gồm các thành phần cốt lõi sau:
Sự kết hợp các thành phần này mở khóa nhiều lợi ích:
Nếu tôi đã thuyết phục được bạn về tầm quan trọng của Databricks trong thế giới dữ liệu, hãy cùng bắt tay vào sử dụng nền tảng.
Để thiết lập tài khoản, truy cập https://www.databricks.com/try-databricks và đăng ký Community Edition.
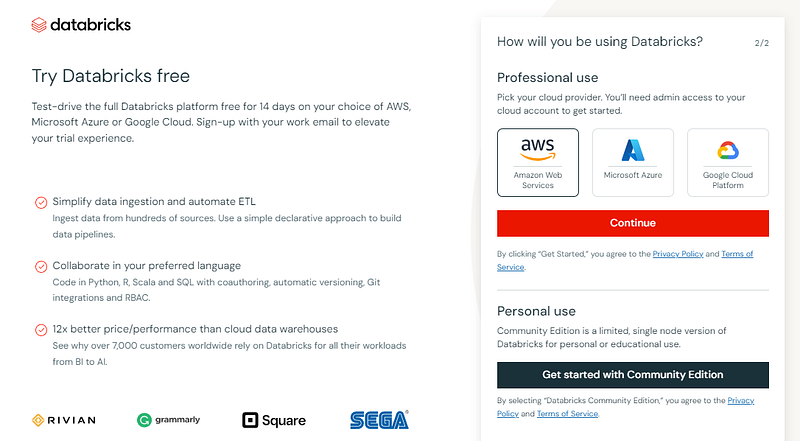
Community Edition có ít tính năng hơn bản Enterprise, nhưng không yêu cầu cấu hình nhà cung cấp đám mây, rất phù hợp cho các trường hợp nhỏ như hướng dẫn.
Nếu sau khi xác minh email bạn thấy trang này, là bạn đã sẵn sàng:
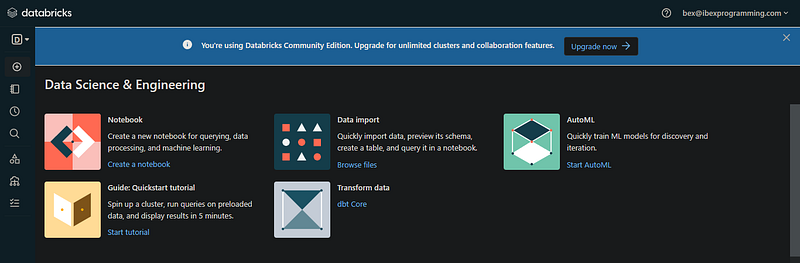
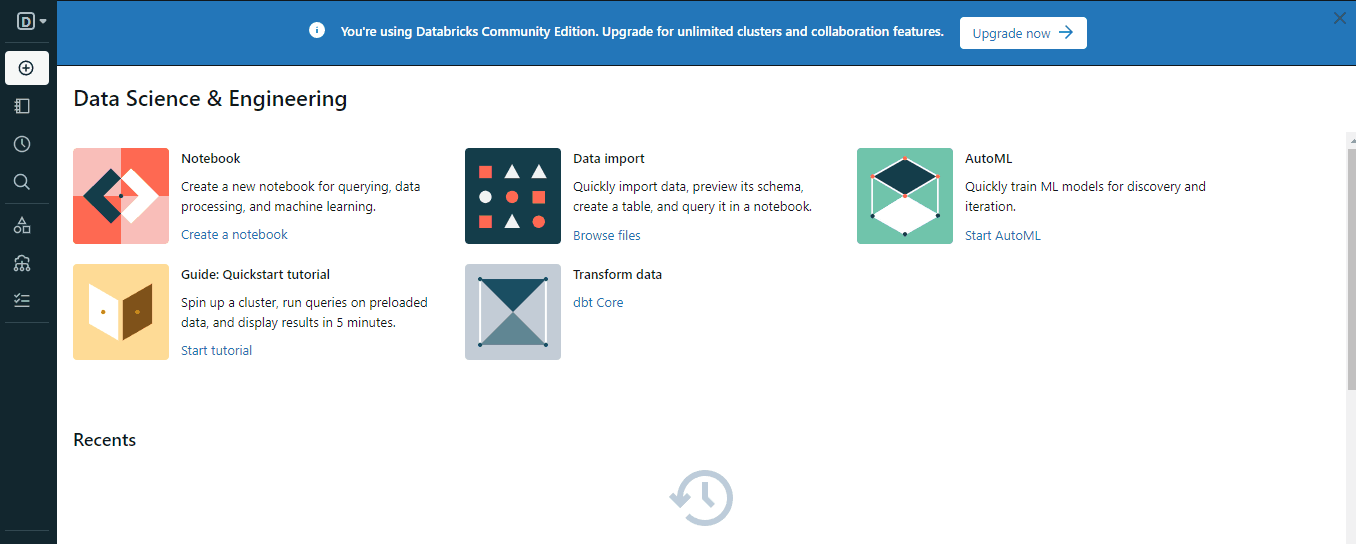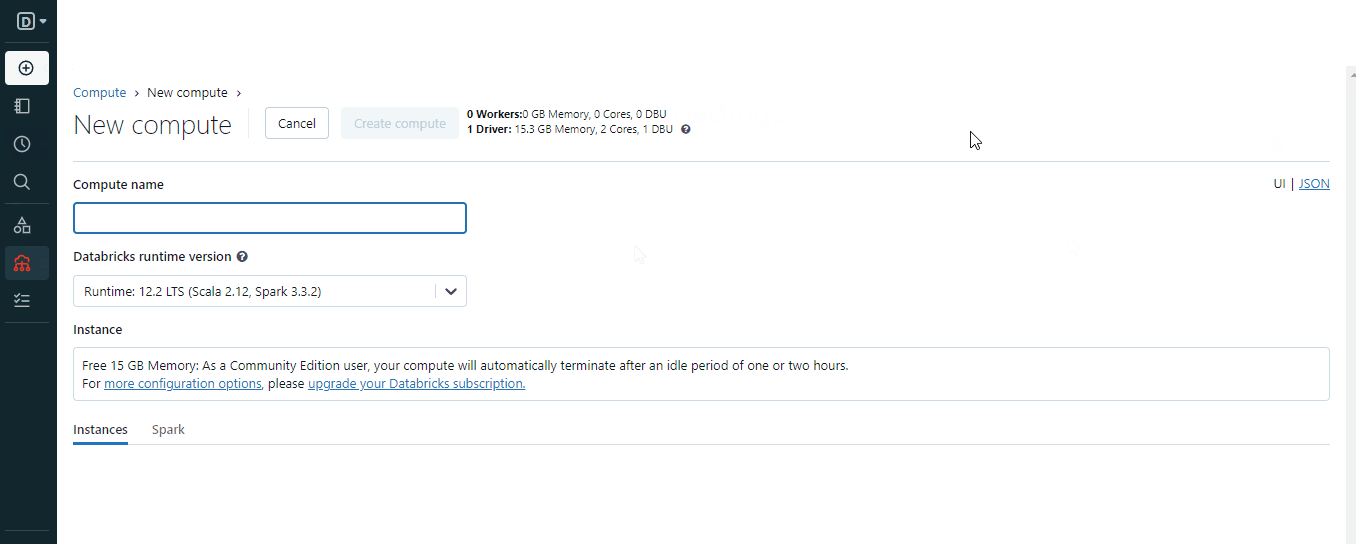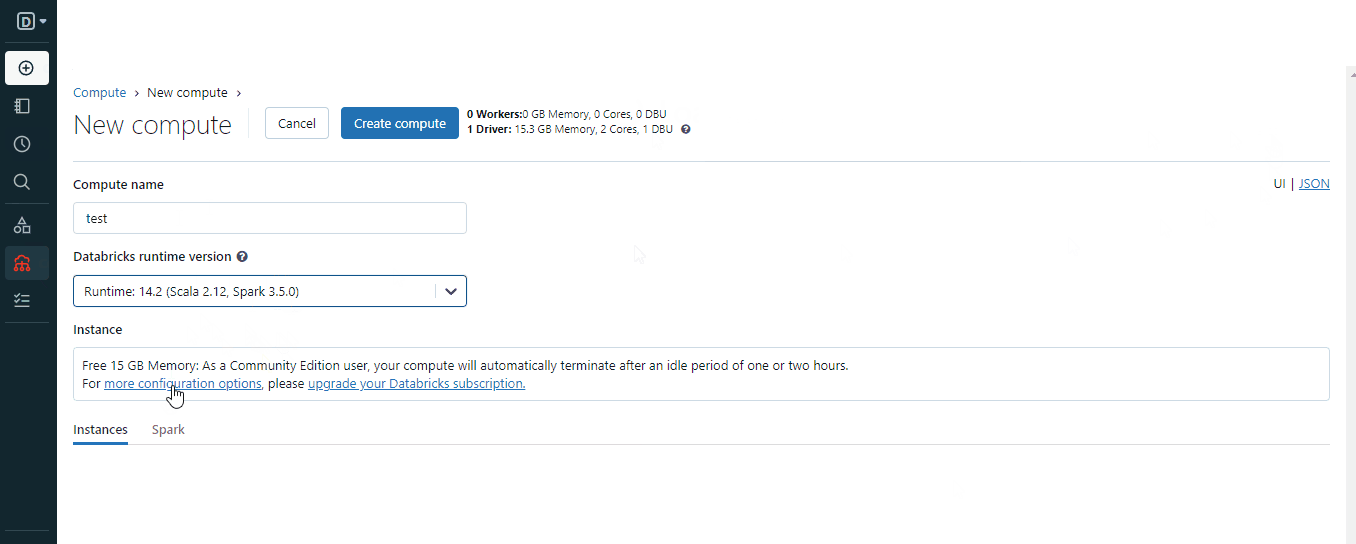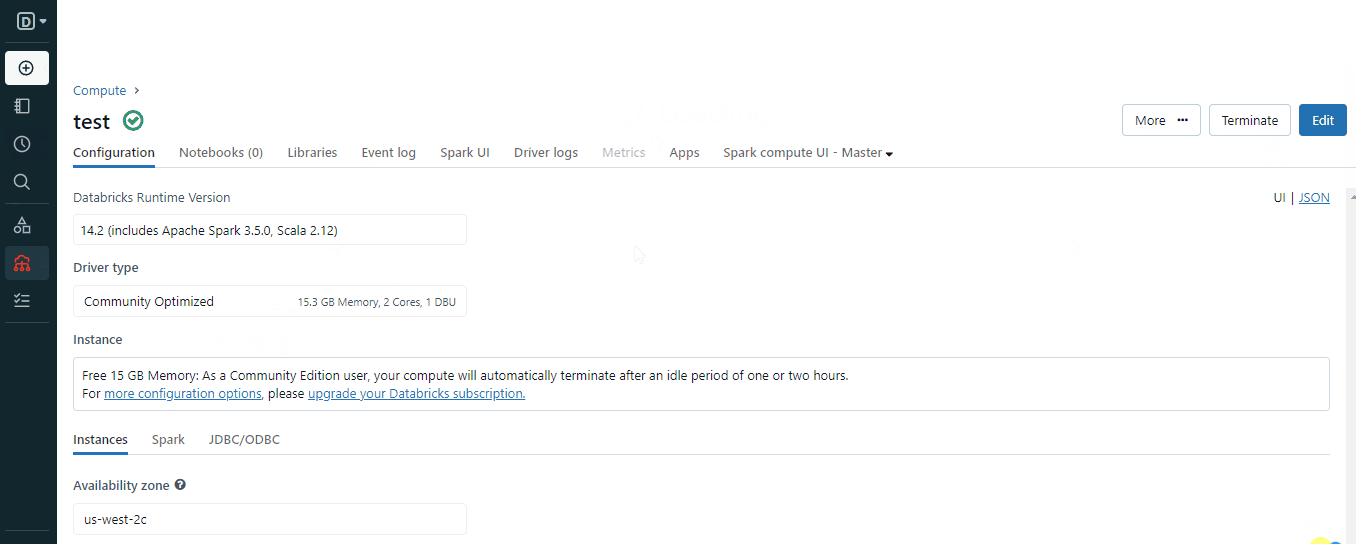
Giao diện bạn thấy chính là Workspace cho địa chỉ email của bạn (có thể dễ dàng tìm thấy workspace bản community). Trong thực tế, thường quản trị viên của công ty bạn sẽ tạo một tài khoản Databricks duy nhất và quản lý quyền truy cập vào workspace.
Giờ hãy tìm hiểu UI của nền tảng. Ở panel bên trái là menu cho các thành phần khác nhau mà Databricks cung cấp. Bản enterprise sẽ có nhiều nút hơn nữa:
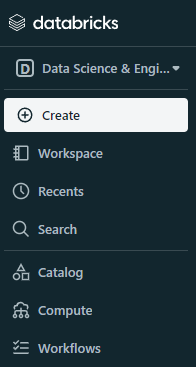
Tùy chọn đầu tiên trong menu là loại workspace, mặc định là data science and engineering. Nếu bạn chuyển sang machine learning, sẽ xuất hiện tùy chọn Experiments mới:
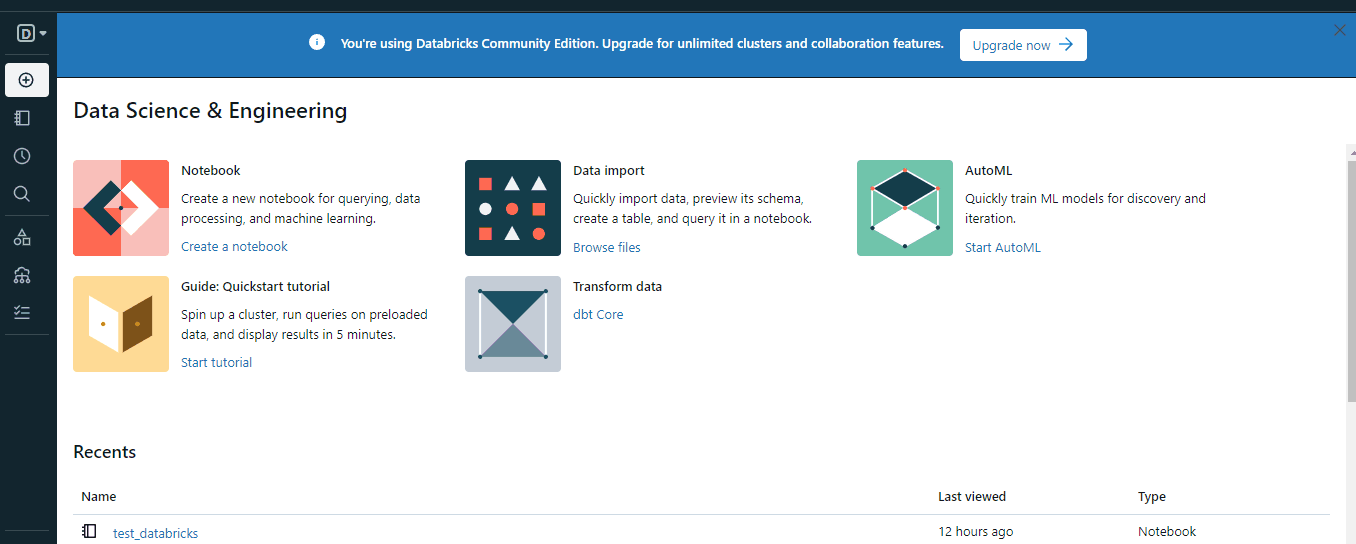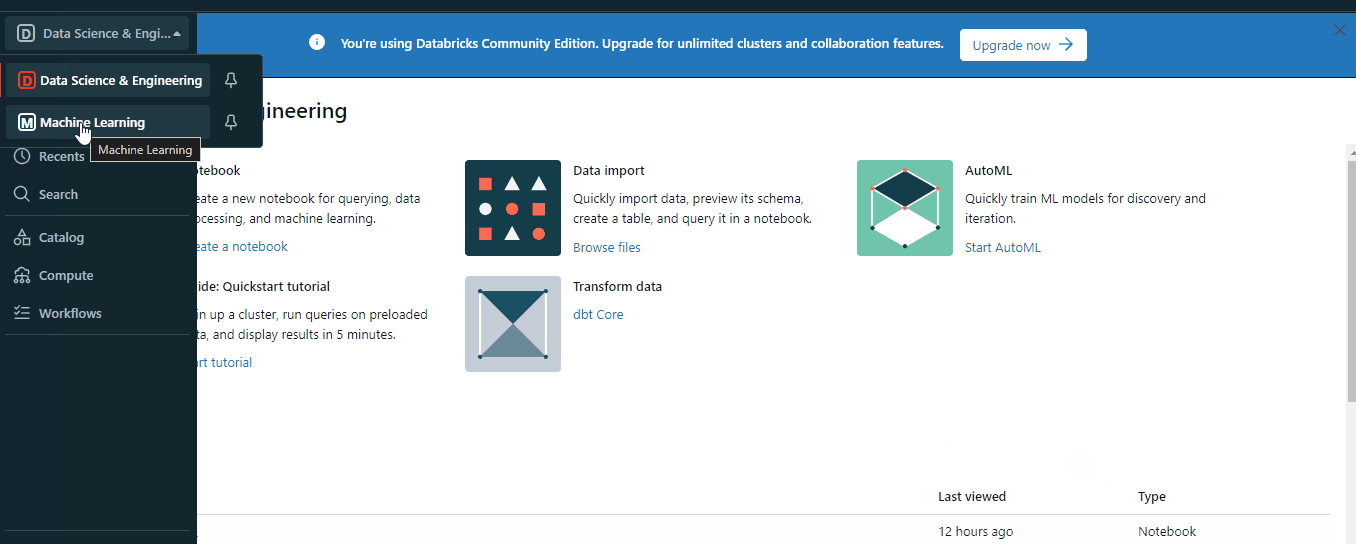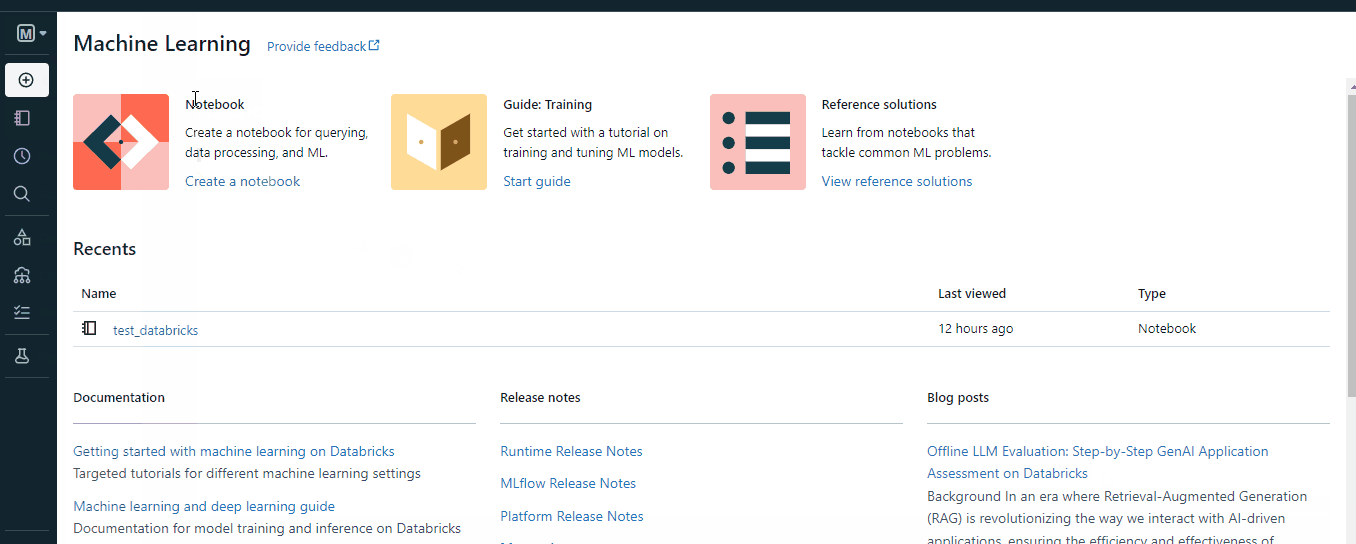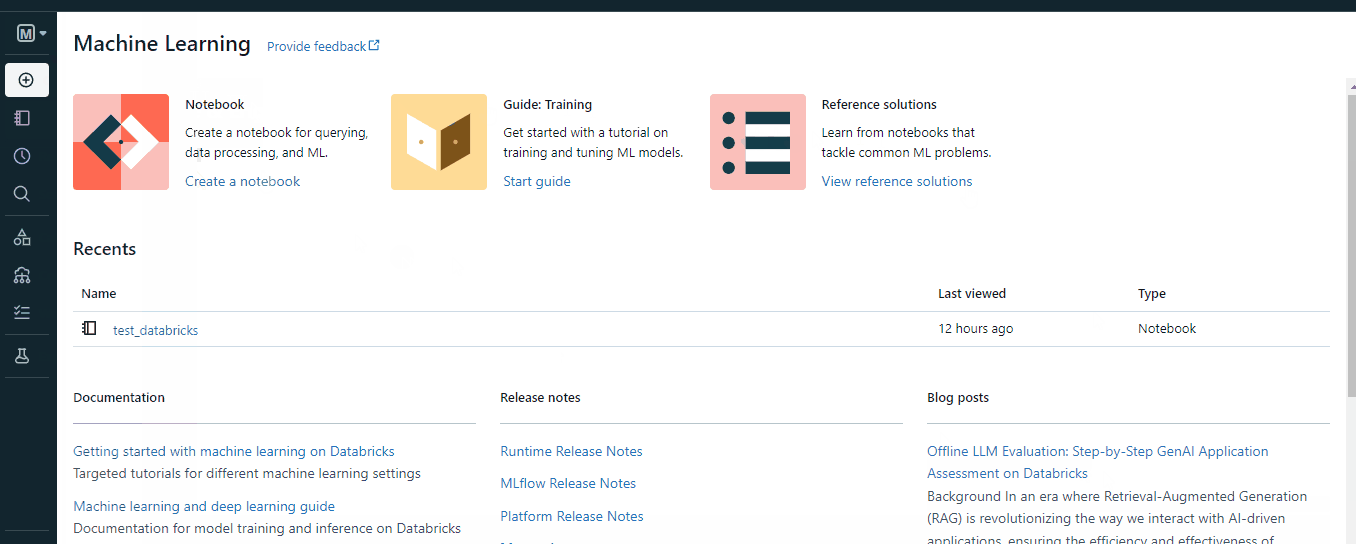
Bề ngoài có thể trông như không làm được nhiều, nhưng khi bạn nâng cấp tài khoản và bắt đầu khám phá, bạn sẽ thấy nhiều tính năng hay của nền tảng:
v.v.
Giờ hãy xem kỹ hơn một số thành phần này.
Cluster trong Databricks là các tài nguyên tính toán dùng để thực thi tác vụ xử lý dữ liệu. Thường các cluster được cung cấp bởi nhà cung cấp đám mây bạn chọn khi thiết lập tài khoản.
Cluster ở bản community edition bị giới hạn RAM và CPU, không có GPU. Tuy nhiên, người dùng premium thường có thể làm các việc sau với cluster một cách đơn giản:
Để tạo cluster, bạn có thể dùng nút “Create” hoặc mục “Compute” từ menu:
Khi tạo cluster, hãy chọn phiên bản Spark phù hợp với môi trường của bạn và đợi vài phút để sẵn sàng hoạt động.
Khi cluster đã chạy, bạn có thể tạo notebook. Nếu bạn đã dùng Jupyter, Colab hoặc DataCamp Workspaces, mọi thứ sẽ quen thuộc:
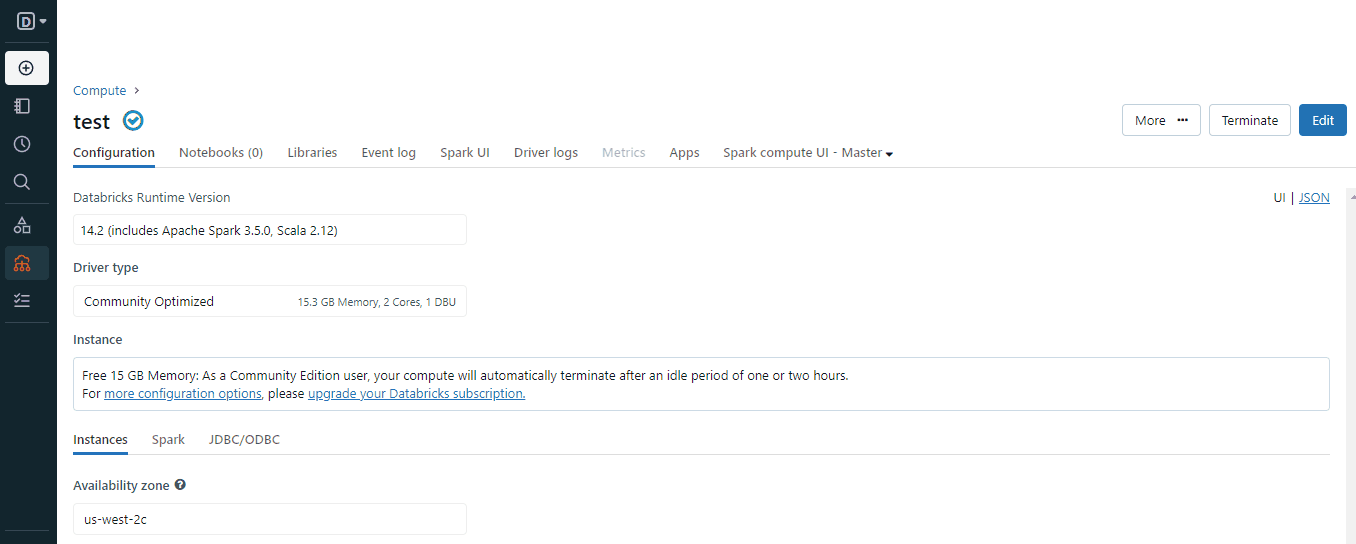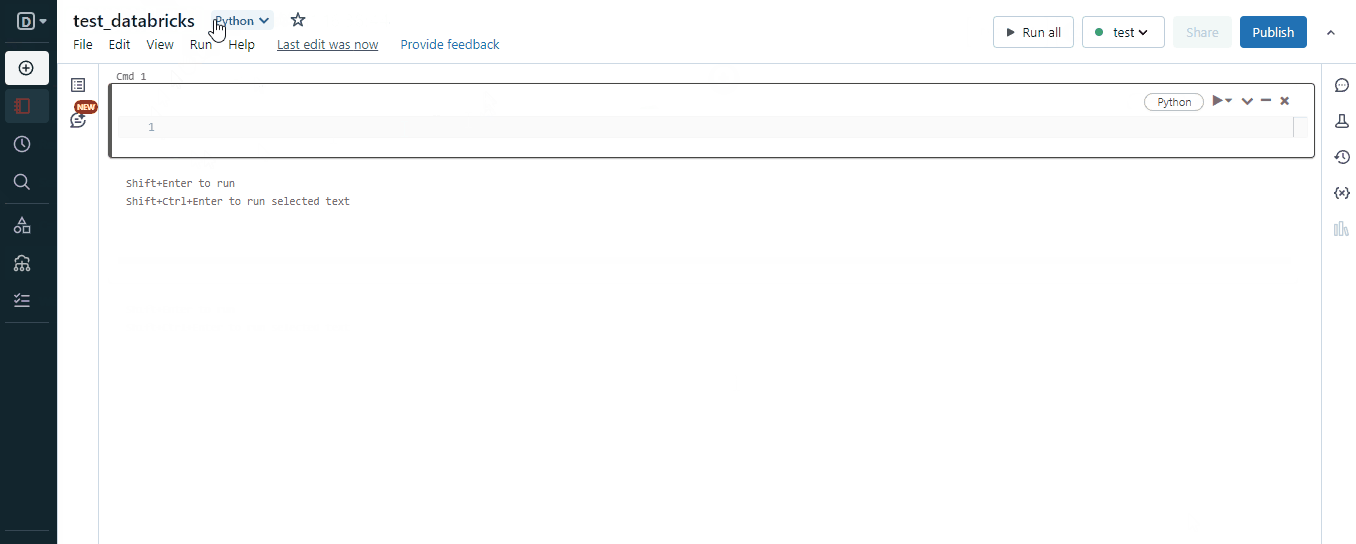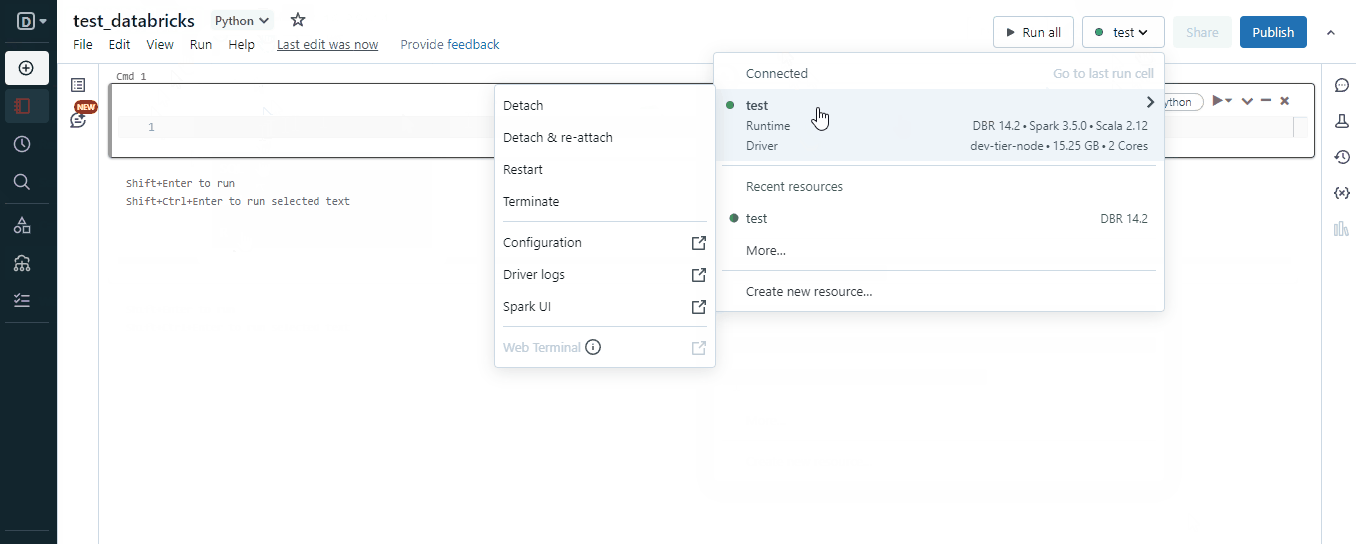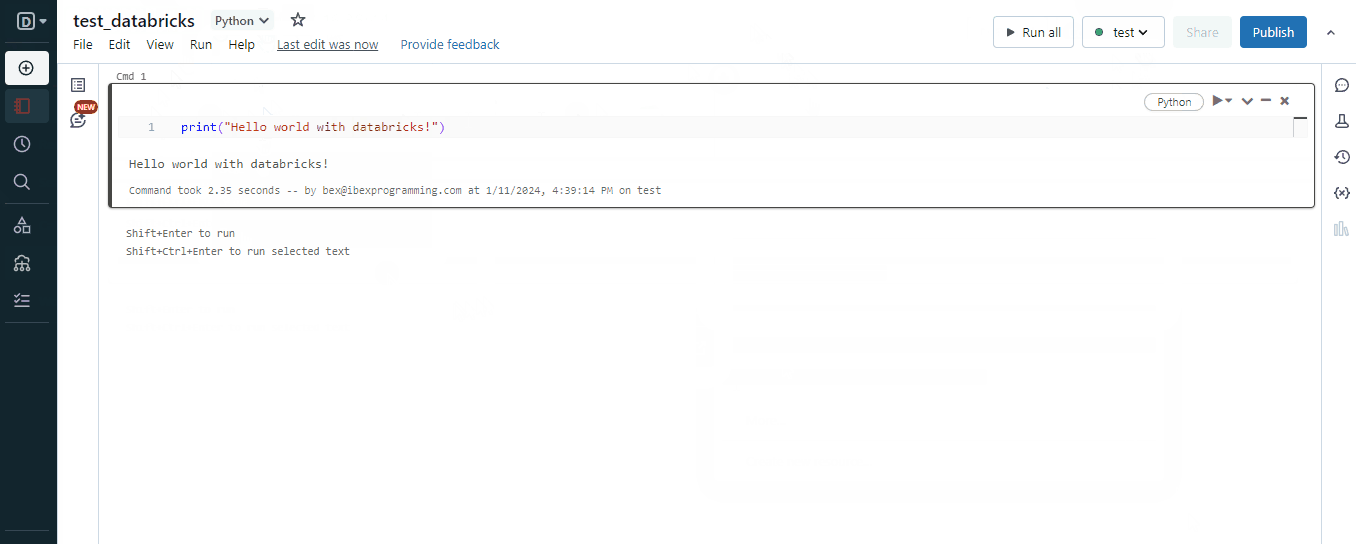
Nhưng trong một thế giới đã có Jupyter “xịn”, tại sao dùng thứ “tương tự Jupyter”? Thực ra, notebook của Databricks có những ưu điểm sau so với Jupyter:
Còn nhiều ưu điểm khác của notebook Databricks so với Jupyter, dưới đây là bảng tóm tắt khác biệt:
|
Tính năng |
Jupyter Notebooks |
Databricks Notebooks |
|
Nền tảng |
Mã nguồn mở, chạy cục bộ hoặc trên đám mây |
Độc quyền trong nền tảng Databricks |
|
Cộng tác và chia sẻ |
Tính năng cộng tác hạn chế, chia sẻ thủ công |
Cộng tác tích hợp, chỉnh sửa đồng thời thời gian thực |
|
Thực thi |
Phụ thuộc máy cục bộ hoặc máy chủ bên ngoài |
Thực thi trên cluster Databricks |
|
Tích hợp Big Data |
Có thể tích hợp với Spark, cần cấu hình bổ sung |
Tích hợp nguyên bản với Apache Spark, tối ưu cho dữ liệu lớn |
|
Tính năng tích hợp sẵn |
Cần công cụ/tiện ích ngoài cho kiểm soát phiên bản, cộng tác, trực quan hóa |
Tích hợp các tính năng đặc thù Databricks như Delta Lake, hỗ trợ sẵn cho cộng tác và công cụ phân tích |
|
Chi phí và mở rộng |
Cài đặt cục bộ thường miễn phí, giải pháp đám mây có thể tốn phí |
Dịch vụ trả phí, chi phí tùy mức sử dụng, mở rộng liền mạch với cluster Databricks |
|
Dễ sử dụng |
Quen thuộc và phổ biến trong cộng đồng khoa học dữ liệu |
Tối ưu cho phân tích dữ liệu lớn, có thể cần làm quen sâu với tính năng đặc thù Databricks |
|
Trực quan hóa dữ liệu |
Hỗ trợ tích hợp sẵn còn hạn chế |
Hỗ trợ trực quan hóa dữ liệu ngay trong môi trường notebook |
|
Quản lý cluster |
Người dùng tự quản lý phiên Spark và phụ thuộc |
Nền tảng Databricks tự động xử lý quản lý và mở rộng cluster |
|
Trường hợp sử dụng |
Linh hoạt cho nhiều tác vụ khoa học dữ liệu |
Chuyên cho phân tích dữ liệu lớn cộng tác trong nền tảng Databricks |
Rốt cuộc, các ưu điểm trên của notebook Databricks phát huy trong những trường hợp cụ thể. Nếu bạn chỉ muốn nghịch một tập dữ liệu CSV bằng Pandas trên laptop, Jupyter phù hợp hơn nhiều.
Nhưng với các ứng dụng cấp doanh nghiệp, Databricks với tư cách là nền tảng có thể là lựa chọn tốt hơn.
Nạp dữ liệu (data ingestion) là quá trình nhập dữ liệu từ các nguồn khác nhau. Databricks hỗ trợ nạp từ nhiều nguồn, bao gồm:
v.v.
Giờ hãy xem cách bạn có thể tải một số loại dữ liệu vào Databricks. Ta bắt đầu với tệp cục bộ:
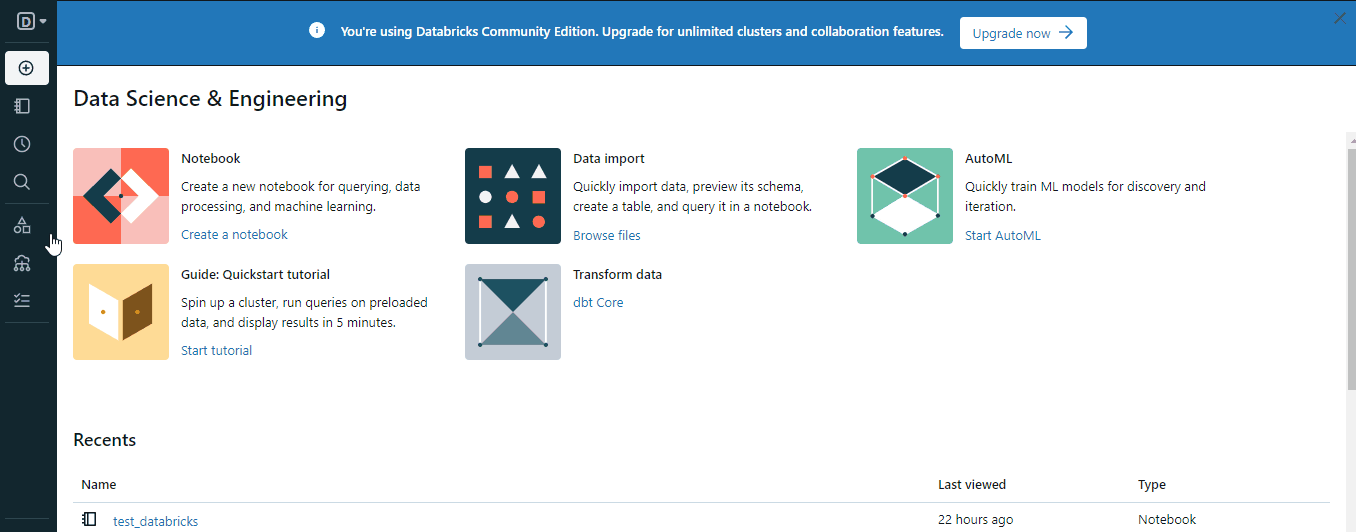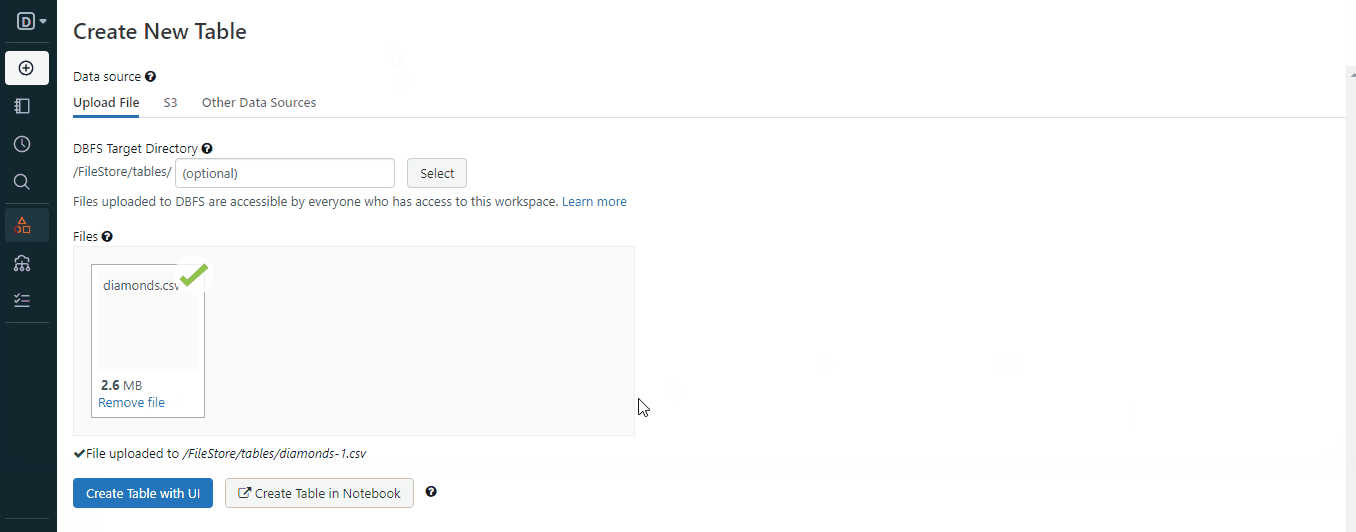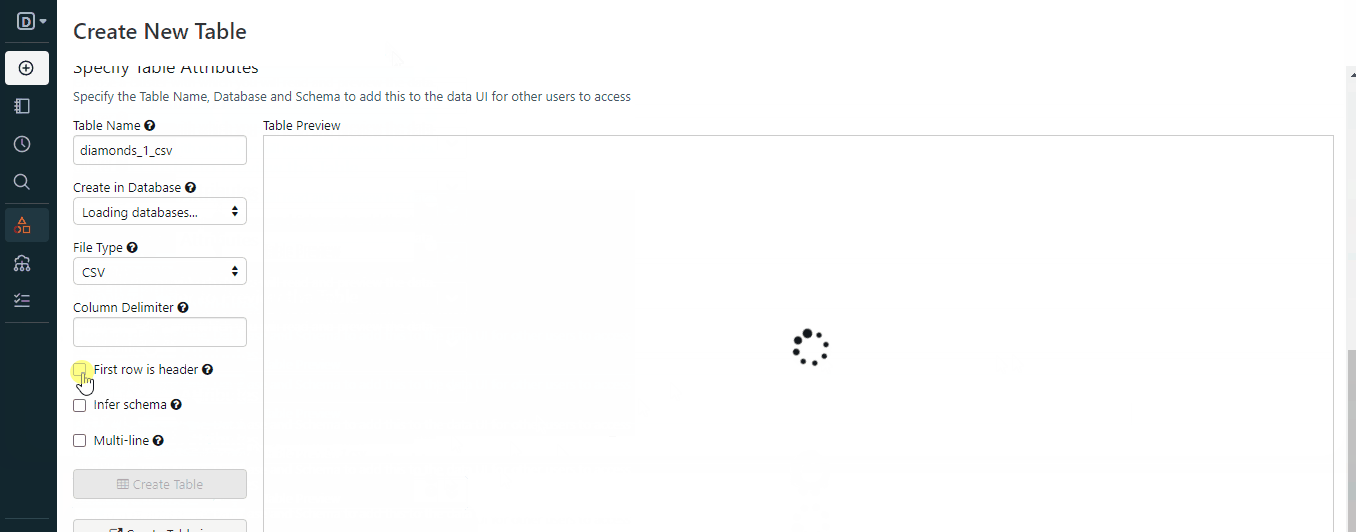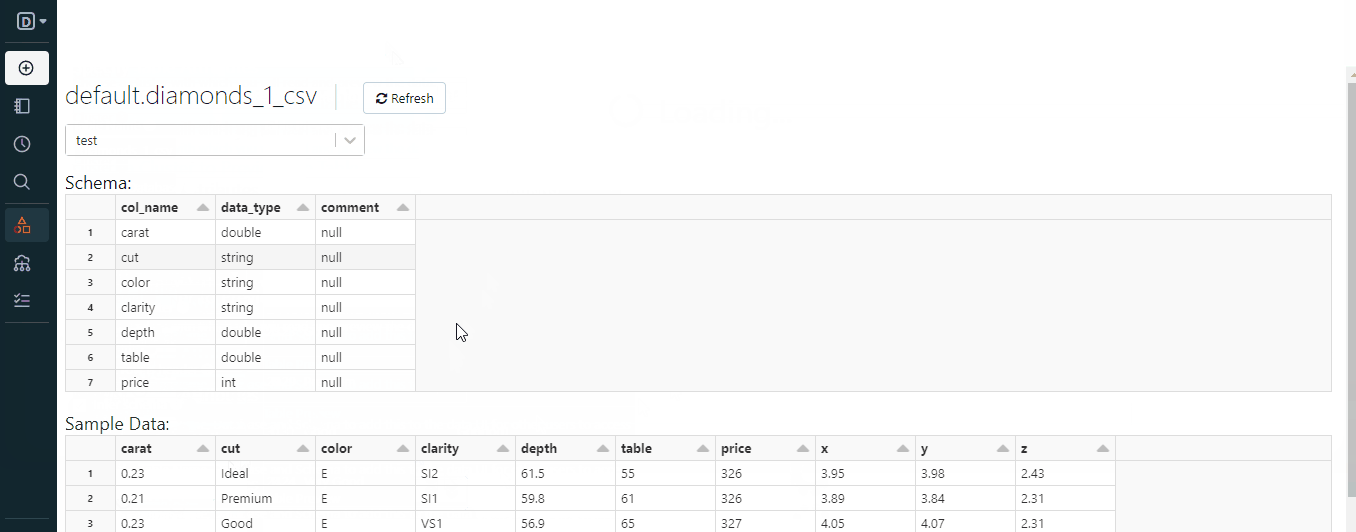
Sau khi làm theo các bước trong GIF, bạn sẽ có một tệp được lưu trong workspace. Đây là cách tải nó bằng Spark:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Lưu ý tiền tố dbfs:. Mọi tệp trong workspace phải có tiền tố này để Spark tải đúng. DBFS là viết tắt của Databricks File System.
Nhập dữ liệu từ S3 bucket cũng tương tự (đối với tài khoản enterprise):
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Với các loại dữ liệu khác, bạn có thể xem các mục Data engineering và Connect to data sources trong tài liệu Databricks.
Khi chúng ta tải tệp diamonds.csv, nó trở thành một bảng Databricks trong cơ sở dữ liệu tên là default:
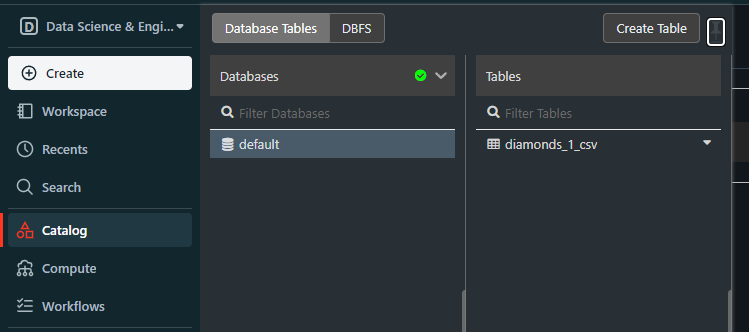
Cơ sở dữ liệu default được tạo mỗi khi chúng ta cố tải các tệp có cấu trúc mà chưa tạo sẵn cơ sở dữ liệu.
Nếu đã có cơ sở dữ liệu, nghĩa là ta có thể truy vấn bằng SQL, không chỉ bằng Spark. Để làm vậy, tạo notebook mới hoặc đổi ngôn ngữ của notebook hiện tại sang SQL. Sau đó, thử đoạn mã sau:
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
Kết quả sẽ trả về năm dòng đầu tiên của bảng diamonds:
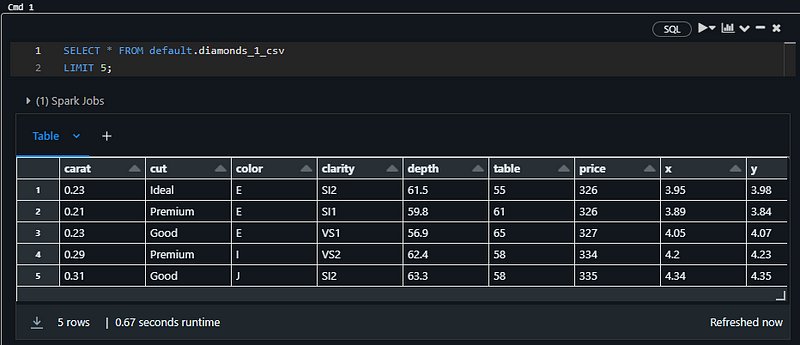
Lưu ý: Tôi dùng notebook SQL cho đoạn trên
Bạn cũng có thể nạp bảng này vào Pandas. Ngay trong cùng notebook, dán đoạn sau:
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
Nó sẽ in phần đầu của bảng:
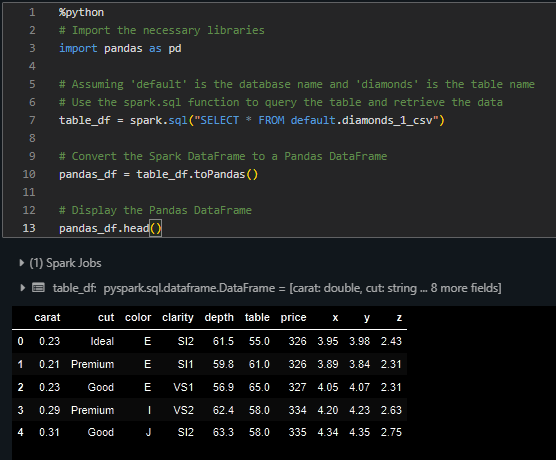
Giờ bạn có thể thực hiện mọi tác vụ phân tích dữ liệu điển hình trên bảng bằng cả SQL và Pandas.
Chúng ta đã học và làm được nhiều điều chỉ với tài khoản community edition tối giản của Databricks. Để tiếp tục tìm hiểu nền tảng, bước đầu tiên là dùng bản dùng thử hai tuần cho tài khoản premium mà Databricks cung cấp.
Sau đó, bạn có thể tận hưởng trọn vẹn các bài học trong khóa Introduction to Databricks do DataCamp cung cấp. Ngoài phần thiết lập tài khoản, bạn sẽ học và thực hành các tính năng cốt lõi sau của DataCamp:
Bắt đầu hành trình Databricks của bạn ngay hôm nay!
Khóa học
Lộ trình
Lộ trình