
Last chance! 50% off DataCamp Premium
Sale ends in
सबसे पहले डेटा वेयरहाउस थे। वे डेटा को पंक्तियों और स्तंभों में संग्रहीत करते थे क्योंकि उस समय का इंटरनेट और कंप्यूटर केवल साधारण टेक्स्ट जानकारी वितरित करने में सक्षम थे। बहुत बाद में डेटा लेक आए — वे लगभग हर प्रकार के डेटा को संग्रहीत कर सकते थे जिसे आप एकत्र कर सकें। वे सोशल मीडिया और YouTube के युग के लिए बेहतरीन थे।
लेकिन दोनों के अपने नुकसान थे — डेटा वेयरहाउस महंगे थे और आधुनिक डेटा साइंस के लिए उपयुक्त नहीं, जबकि डेटा लेक बिखरे-बिखरे रहते और अक्सर डेटा स्वैम्प में बदल जाते। नतीजतन, कंपनियों ने दो अलग-अलग टेक स्टैक रखने शुरू कर दिए — BI और एनालिटिक्स के लिए वेयरहाउस, और मशीन लर्निंग के लिए लेक।
हालाँकि, दो अलग-अलग डेटा आर्किटेक्चर का प्रबंधन करना इतना मुश्किल था कि कंपनियों के परिणाम अक्सर खराब रहते। इसी समस्या ने लेकहाउस आर्किटेक्चर को जन्म दिया, जिसके लिए Databricks विशेष रूप से प्रसिद्ध है।
Databricks एक क्लाउड-आधारित प्लेटफ़ॉर्म है जो उपयोगकर्ताओं को एकीकृत वातावरण में वेयरहाउस और लेक—दोनों से मूल्य निकालने की अनुमति देता है। यह लेख प्लेटफ़ॉर्म का एक अवलोकन देगा, इसकी सबसे महत्वपूर्ण विशेषताओं को दिखाएगा और उनका उपयोग कैसे करें यह समझाएगा।
Databricks इतना बड़ा प्लेटफ़ॉर्म है कि उसकी प्रलेखन सामग्री ही एक किताब बन सकती है। इसलिए, इस लेख का लक्ष्य आपको अवधारणाओं की एक पदानुक्रम देना है — Databricks की विशेषताओं की रैखिक रूप से क्रमबद्ध व्याख्याएँ जो आपको शुरुआती स्तर से एक अच्छे Databricks प्रैक्टिशनर तक ले जाएँगी। यदि आप बिल्कुल नए हैं, तो आप हमारा Introduction to Databricks कोर्स भी देखना चाहेंगे।
चलिए शुरू करते हैं!
जब भी आप Databricks शब्द पढ़ें, उसे एक प्लेटफ़ॉर्म के रूप में सोचें, न कि किसी फ़्रेमवर्क या Python लाइब्रेरी के रूप में। आमतौर पर, प्लेटफ़ॉर्म व्यापक फीचर-सेट प्रदान करते हैं, और Databricks भी अपवाद नहीं है। यह उन चंद प्लेटफ़ॉर्मों में से एक है जिसे किसी भी डेटा प्रोफ़ेशनल—डेटा इंजीनियर से लेकर आधुनिक मशीन लर्निंग इंजीनियर (या जिसे आजकल प्रेस AI प्रोग्रामर कहती है)—द्वारा उपयोग किया जा सकता है।
Databricks के निम्नलिखित कोर घटक हैं:
ये घटक मिलकर अनेक लाभों का ताला खोलते हैं:
यदि मैंने आपको डेटा जगत में Databricks के महत्व के बारे में आश्वस्त कर दिया है, तो आइए आपको प्लेटफ़ॉर्म पर चालू करते हैं।
अपना खाता सेट करने के लिए https://www.databricks.com/try-databricks पर जाएँ और Community Edition के लिए साइन अप करें।
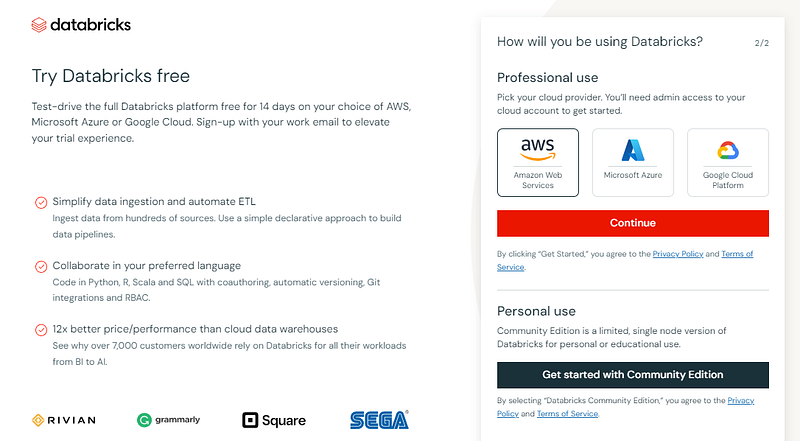
Community Edition में Enterprise संस्करण की तुलना में कम फीचर्स होते हैं, लेकिन इसमें क्लाउड-प्रोवाइडर सेटअप की आवश्यकता नहीं होती, जो कि ट्यूटोरियल जैसे छोटे उपयोग मामलों के लिए बेहतरीन है।
यदि ईमेल सत्यापन के बाद आपके पास यह पेज है, तो सब ठीक है:
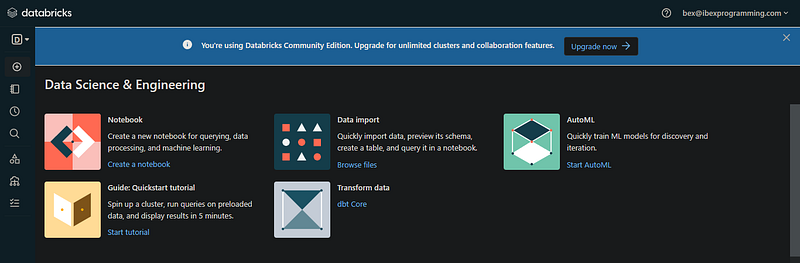
जो इंटरफ़ेस आपने देखा, वह आपके ईमेल पते के लिए वर्कस्पेस है (कम्युनिटी एडिशन वर्कस्पेस आसानी से मिल जाता है)। व्यवहार में, आमतौर पर आपकी कंपनी का एक अकाउंट एडमिन एकल Databricks अकाउंट बनाता है और वर्कस्पेस की ऐक्सेस को मैनेज करता है।
अब, प्लेटफ़ॉर्म के UI को समझते हैं। बाएँ पैनल पर, Databricks द्वारा प्रदान किए गए विभिन्न घटकों के लिए मेनू है। एंटरप्राइज़ संस्करण में और भी अधिक बटन होंगे:
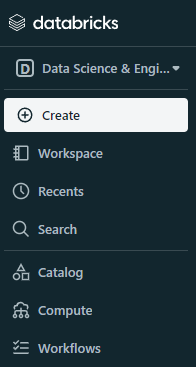
मेनू में पहला विकल्प वर्कस्पेस का प्रकार है, जो डिफ़ॉल्ट रूप से डेटा साइंस और इंजीनियरिंग पर सेट होता है। यदि आप इसे मशीन लर्निंग में बदलते हैं, तो एक नया Experiments विकल्प दिखाई देता है:
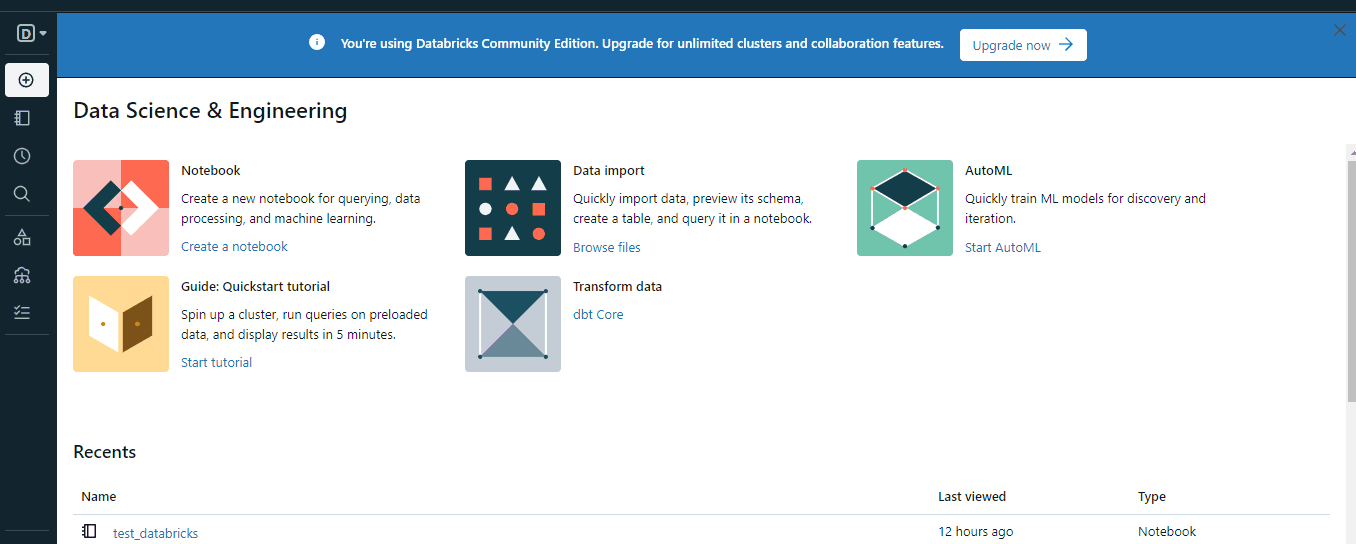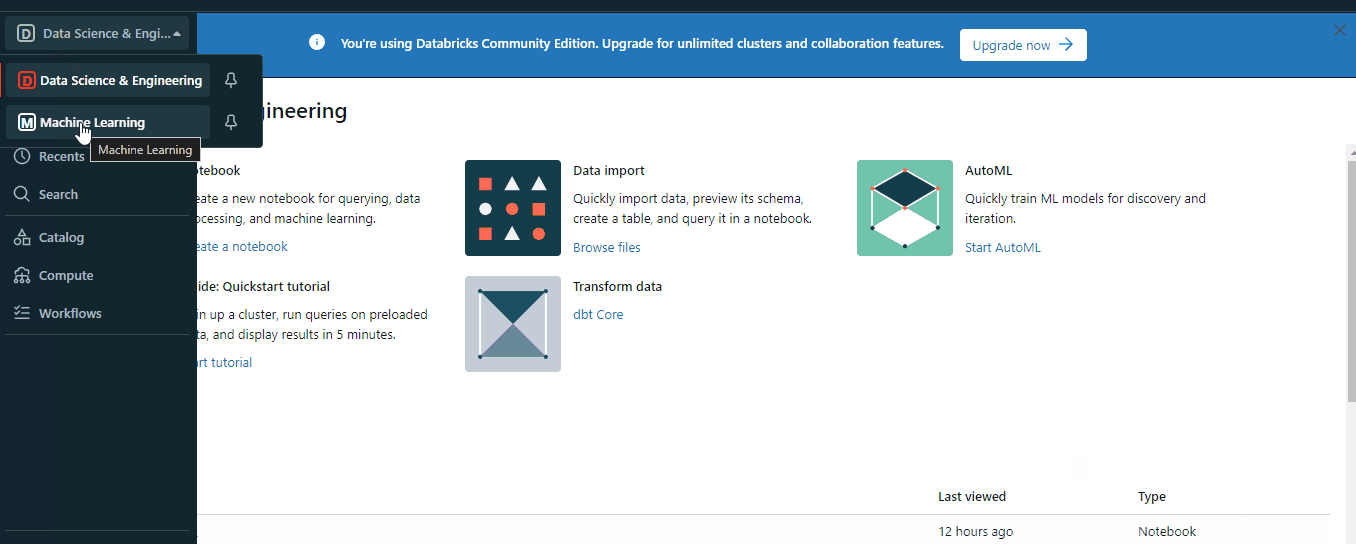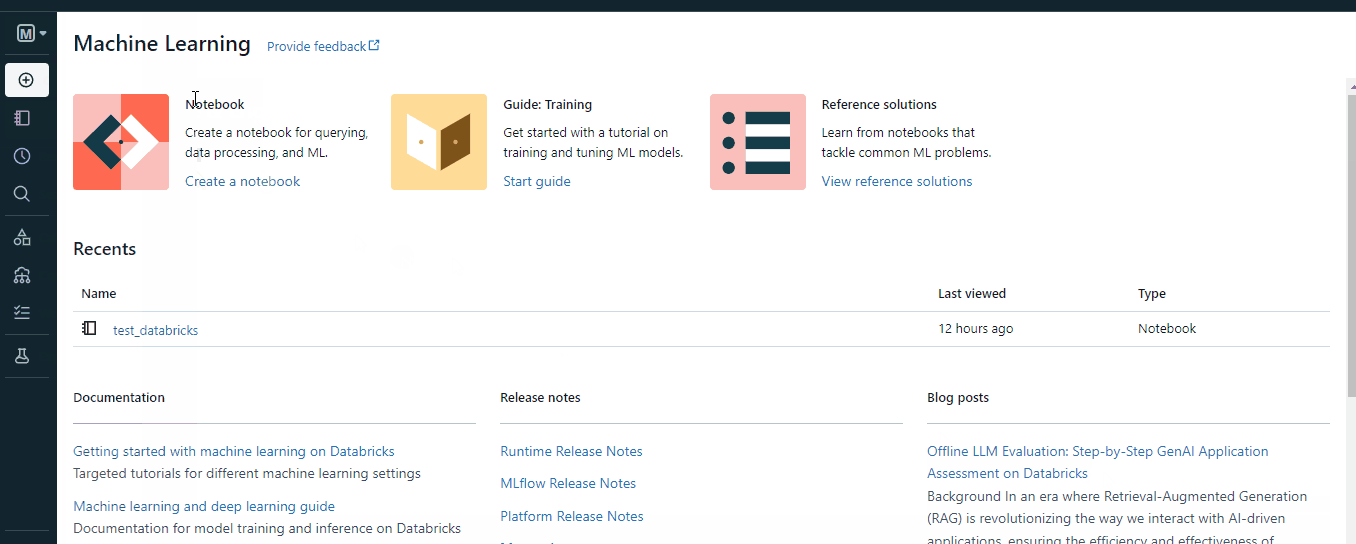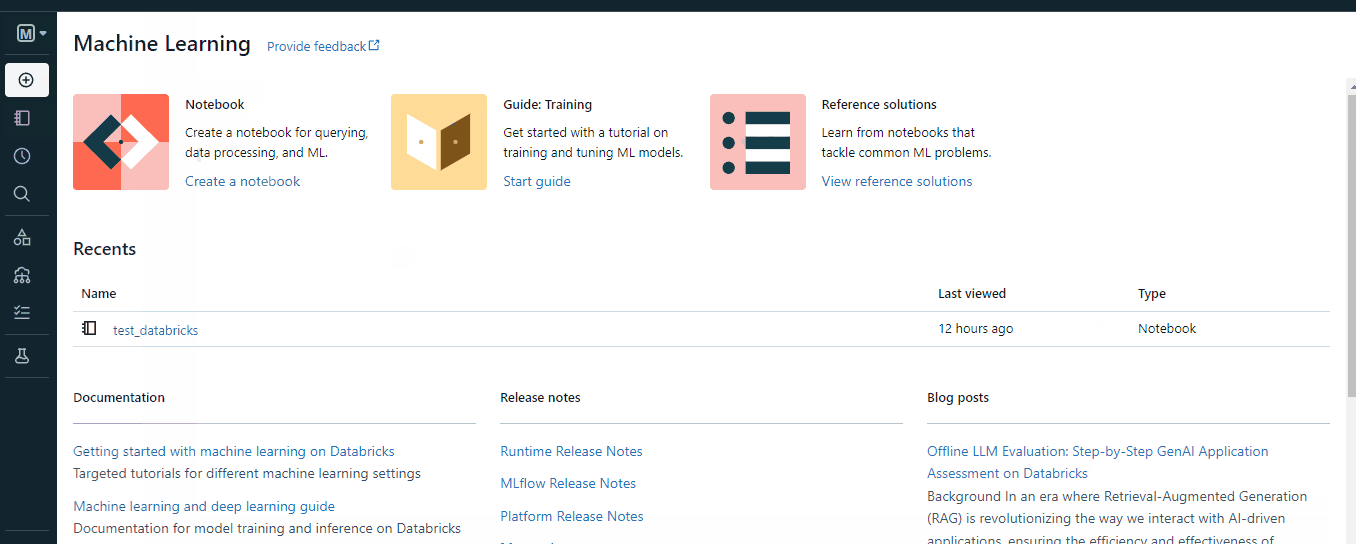
ऊपर-ऊपर से देखें तो लग सकता है कि यह बहुत कुछ नहीं करता, लेकिन एक बार जब आप अपना अकाउंट अपग्रेड करते हैं और प्रयोग शुरू करते हैं, तो आप प्लेटफ़ॉर्म की कुछ बेहतरीन विशेषताएँ देखेंगे:
आदि।
अब, इन घटकों में से कुछ को और क़रीब से देखते हैं।
Databricks में क्लस्टर्स का मतलब वे कंप्यूटेशनल संसाधन हैं जो डेटा प्रोसेसिंग कार्यों को निष्पादित करने के लिए उपयोग किए जाते हैं। आम तौर पर, अकाउंट सेटअप के दौरान आपके चुने हुए क्लाउड प्रोवाइडर द्वारा क्लस्टर्स उपलब्ध कराए जाते हैं।
कम्युनिटी एडिशन के क्लस्टर्स RAM और CPU पावर में सीमित होते हैं, और GPU शामिल नहीं होते। हालाँकि, प्रीमियम उपयोगकर्ता अक्सर क्लस्टर्स के साथ निम्न कार्य सीधे-सादे तरीके से कर सकते हैं:
क्लस्टर बनाने के लिए, आप “Create” बटन या मेनू में “Compute” विकल्प का उपयोग कर सकते हैं:
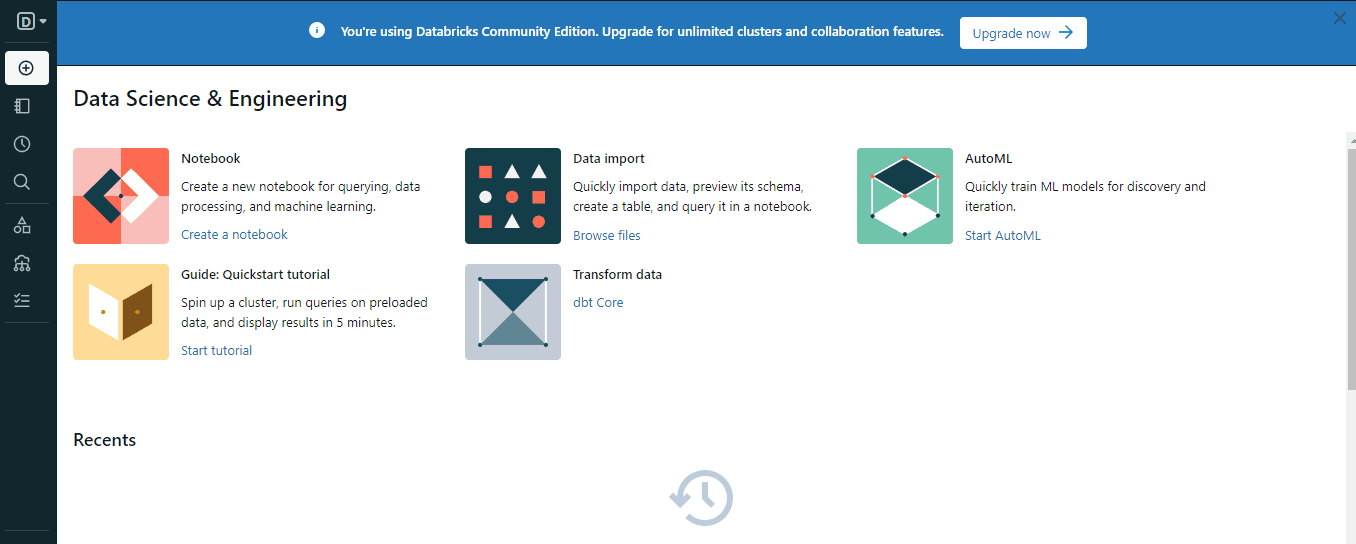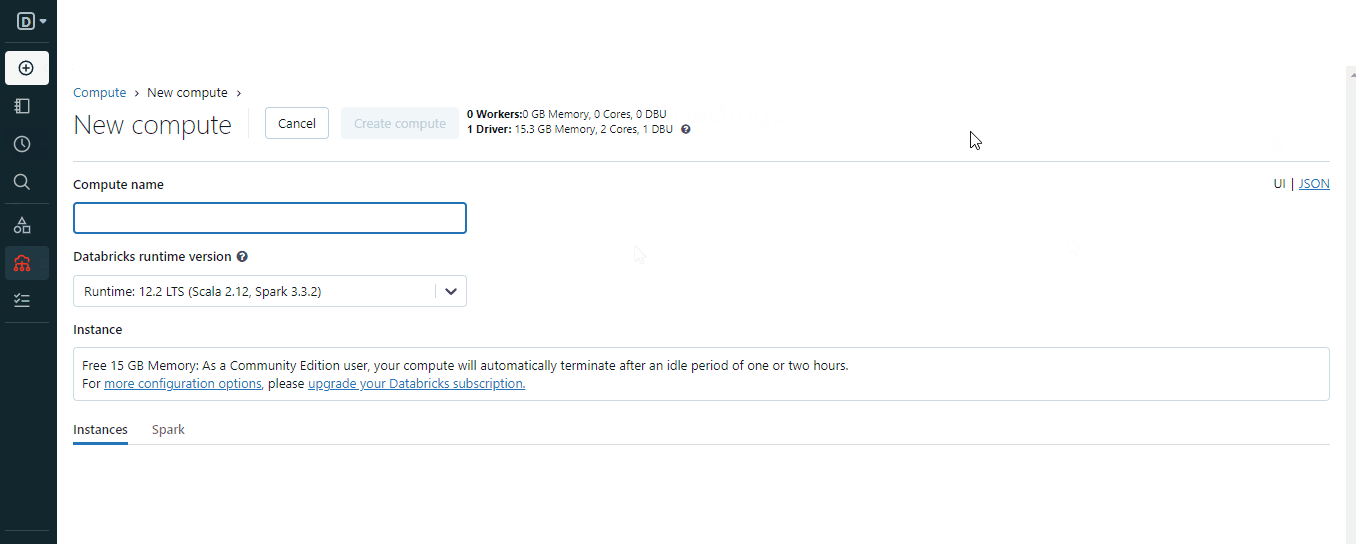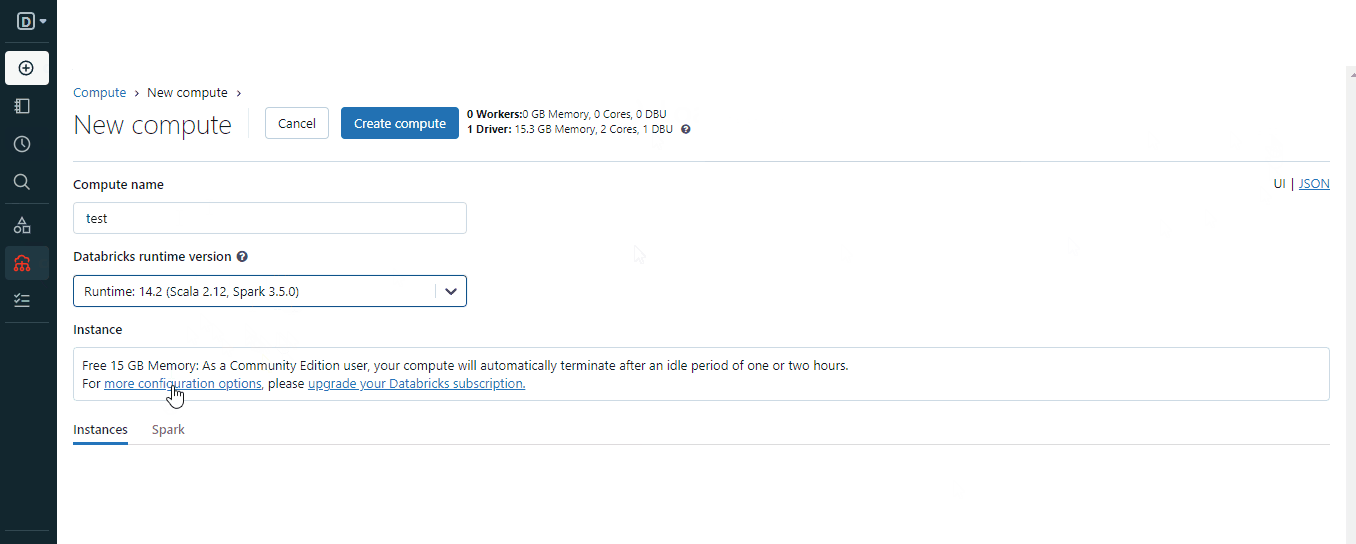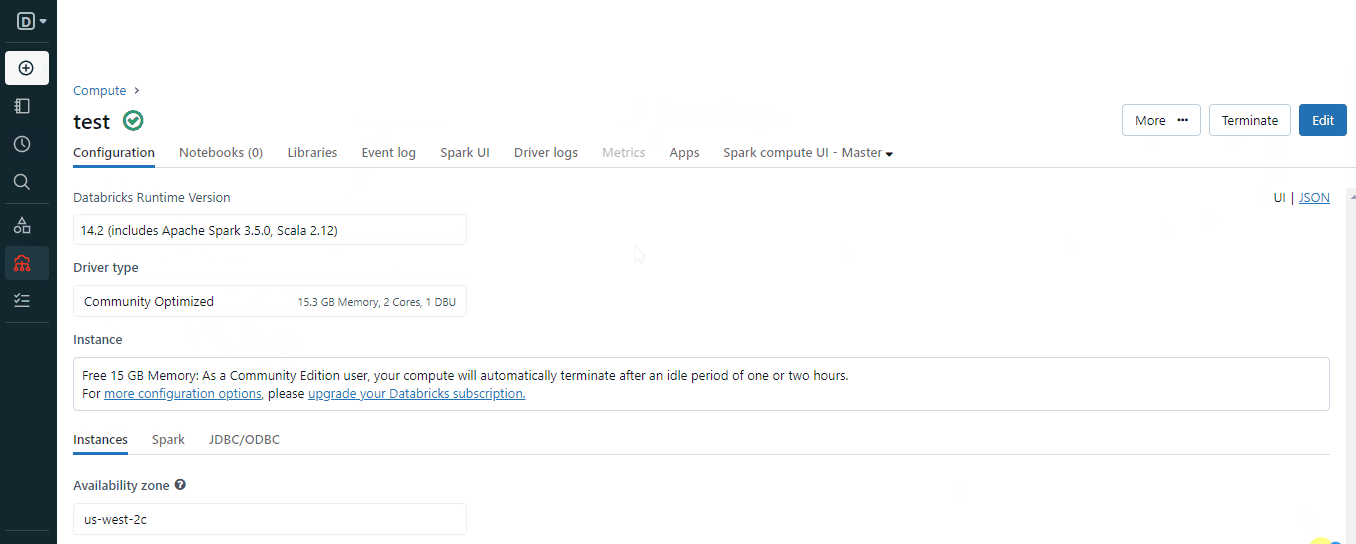
क्लस्टर बनाते समय, अपने वातावरण के लिए उपयुक्त Spark संस्करण चुनें और उसके सक्रिय होने के लिए कुछ मिनट प्रतीक्षा करें।
जब आपका क्लस्टर चल रहा हो, तो आप नोटबुक्स बनाने के लिए तैयार हैं। यदि आपने Jupyter, Colab, या DataCamp Workspaces के साथ काम किया है, तो यह परिचित लगेगा:
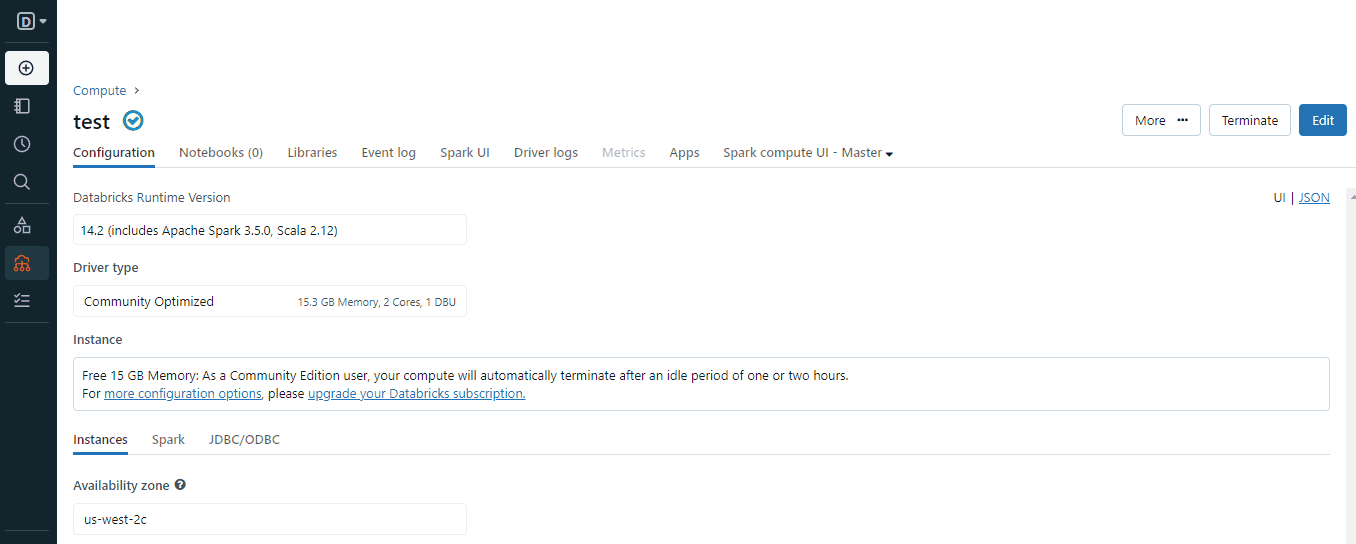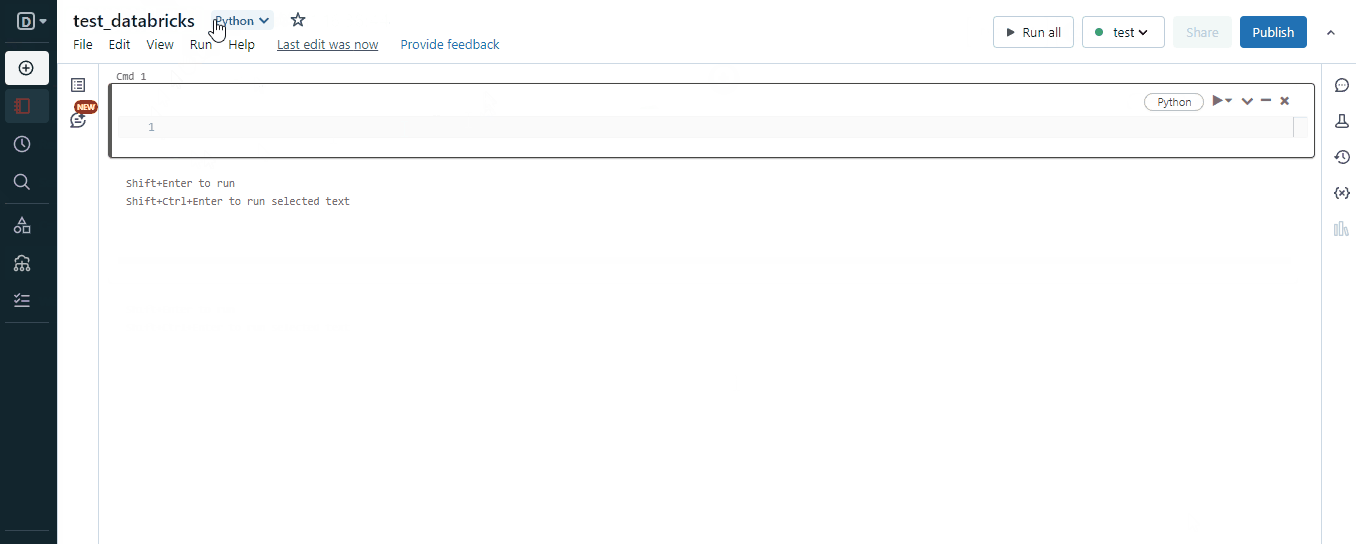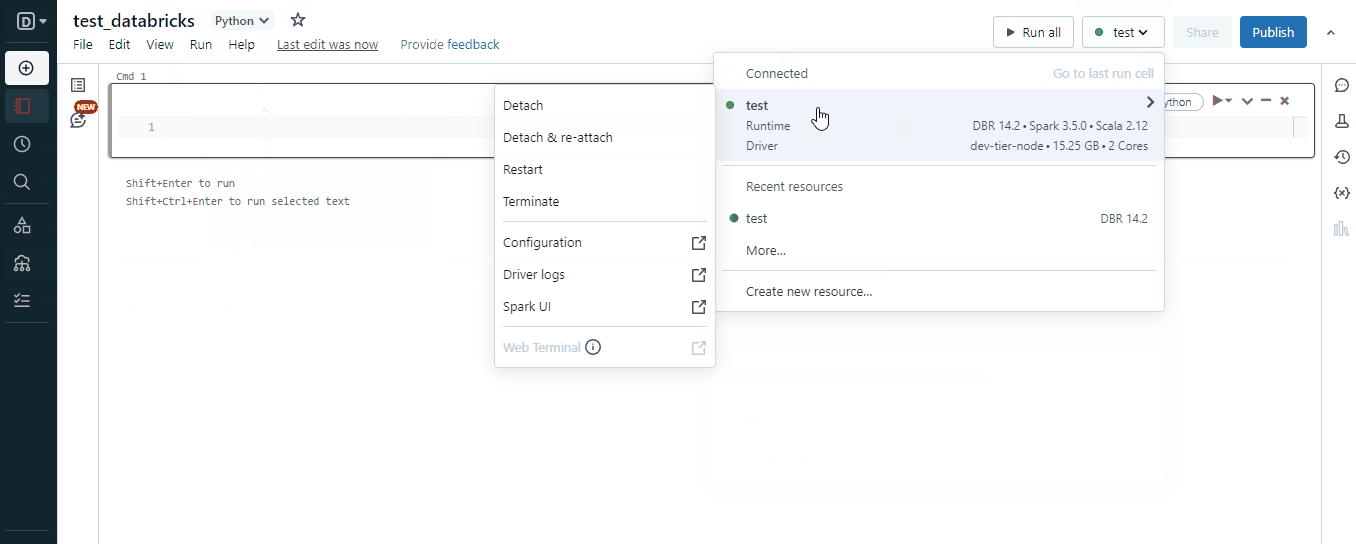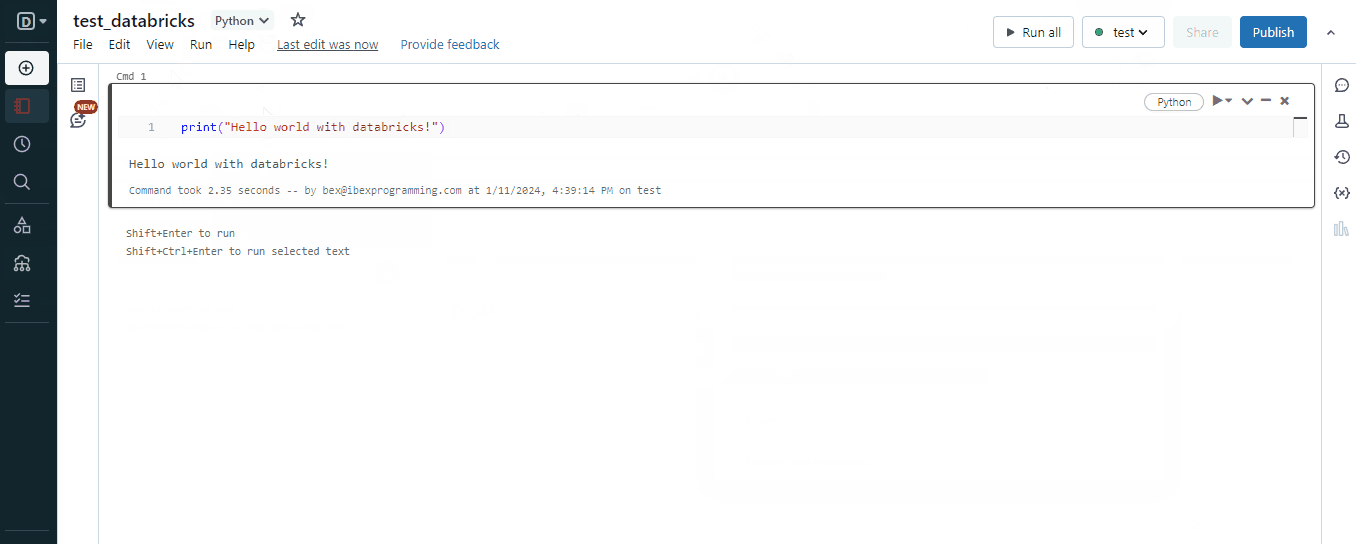
लेकिन जब वास्तविक Jupyter मौजूद है, तो आप “Jupyter जैसा” कुछ क्यों चुनें? दरअसल, Databricks नोटबुक्स के Jupyter नोटबुक्स पर निम्नलिखित फायदे हैं:
Databricks नोटबुक्स के और भी अनेक लाभ हैं, इसलिए यहाँ उनके बीच के अंतर का सार प्रस्तुत करने वाली एक तालिका है:
|
फ़ीचर |
Jupyter नोटबुक्स |
Databricks नोटबुक्स |
|
प्लेटफ़ॉर्म |
ओपन-सोर्स, लोकल या क्लाउड प्लेटफ़ॉर्म पर चलता है |
केवल Databricks प्लेटफ़ॉर्म के भीतर |
|
सहयोग और साझा करना |
सीमित सहयोग सुविधाएँ, मैन्युअल साझा करना |
बिल्ट-इन सहयोग, रीयल-टाइम समकालिक संपादन |
|
निष्पादन |
लोकल या बाहरी सर्वरों पर निर्भर |
Databricks क्लस्टर्स पर निष्पादन |
|
बिग डेटा के साथ एकीकरण |
Spark के साथ एकीकृत हो सकता है, अतिरिक्त कॉन्फ़िगरेशन की आवश्यकता |
Apache Spark के साथ नैटिव एकीकरण, बिग डेटा के लिए अनुकूलित |
|
बिल्ट-इन फ़ीचर्स |
वर्ज़न कंट्रोल, सहयोग और विज़ुअलाइज़ेशन के लिए बाहरी टूल/एक्सटेंशन |
Delta Lake जैसे Databricks-विशिष्ट फ़ीचर्स से एकीकृत, सहयोग और एनालिटिक्स टूल्स के लिए बिल्ट-इन सपोर्ट |
|
लागत और स्केलिंग |
लोकल इंस्टॉलेशन अक्सर मुफ़्त, क्लाउड-आधारित समाधानों की लागत हो सकती है |
सशुल्क सेवा, लागत उपयोग पर निर्भर, Databricks क्लस्टर्स के साथ सहजता से स्केल |
|
उपयोग में सरलता |
डेटा साइंस समुदाय में परिचित और व्यापक रूप से प्रयुक्त |
बिग डेटा एनालिटिक्स के लिए विशेष रूप से तैयार, Databricks-विशिष्ट फ़ीचर्स के लिए सीखने की वक्र कुछ तीखी हो सकती है |
|
डेटा विज़ुअलाइज़ेशन |
डेटा विज़ुअलाइज़ेशन के लिए सीमित बिल्ट-इन सपोर्ट |
नोटबुक वातावरण के भीतर डेटा विज़ुअलाइज़ेशन के लिए बिल्ट-इन सपोर्ट |
|
क्लस्टर प्रबंधन |
उपयोगकर्ताओं को Spark सत्र और डिपेंडेंसी मैन्युअली मैनेज करनी पड़ती हैं |
Databricks प्लेटफ़ॉर्म क्लस्टर प्रबंधन और स्केलिंग को स्वचालित रूप से संभालता है |
|
उपयोग के मामले |
विविध डेटा साइंस कार्यों के लिए बहुआयामी |
Databricks प्लेटफ़ॉर्म के भीतर सहयोगात्मक बिग डेटा एनालिटिक्स के लिए विशिष्टीकृत |
आख़िरकार, Databricks नोटबुक्स के ये फायदे विशेष उपयोग मामलों में प्रभावी होते हैं। यदि आप अपने लैपटॉप पर Pandas के साथ किसी CSV डेटासेट से खेलना चाहते हैं, तो Jupyter कहीं बेहतर है।
लेकिन, एंटरप्राइज़-स्तर के अनुप्रयोगों के लिए, एक प्लेटफ़ॉर्म के रूप में Databricks बेहतर विकल्प हो सकता है।
डेटा इनजेशन का अर्थ विभिन्न स्रोतों से डेटा आयात करने की प्रक्रिया से है। Databricks निम्न सहित कई स्रोतों से इनजेशन को सपोर्ट करता है:
आदि।
अब, देखते हैं कि आप कुछ प्रकार के डेटा को Databricks में वास्तव में कैसे लोड कर सकते हैं। हम लोकल फ़ाइलों से शुरू करेंगे:
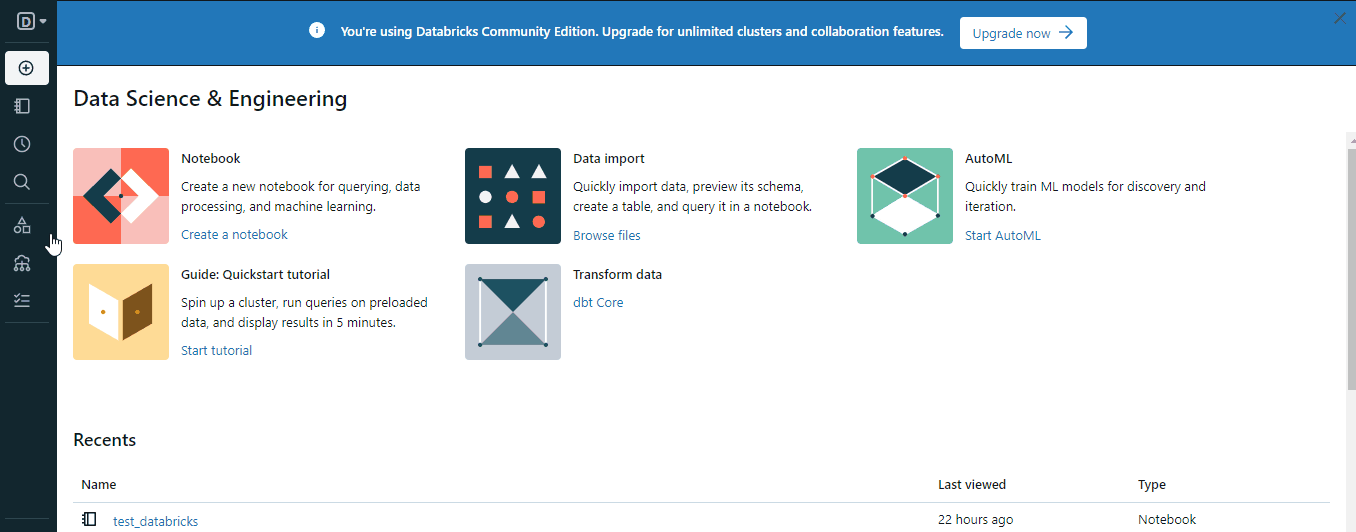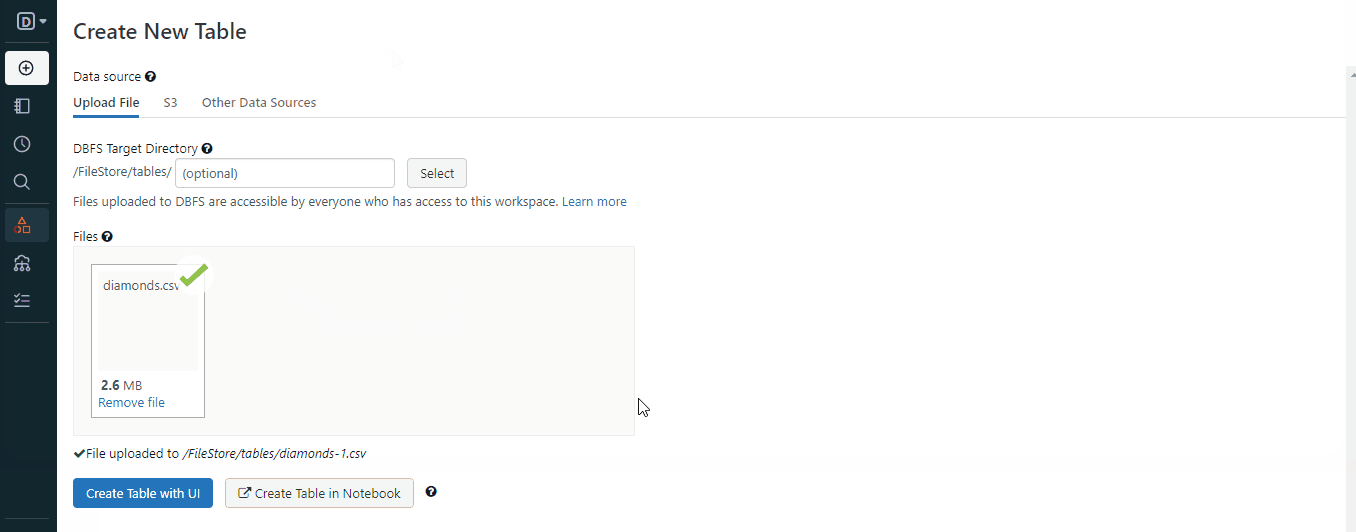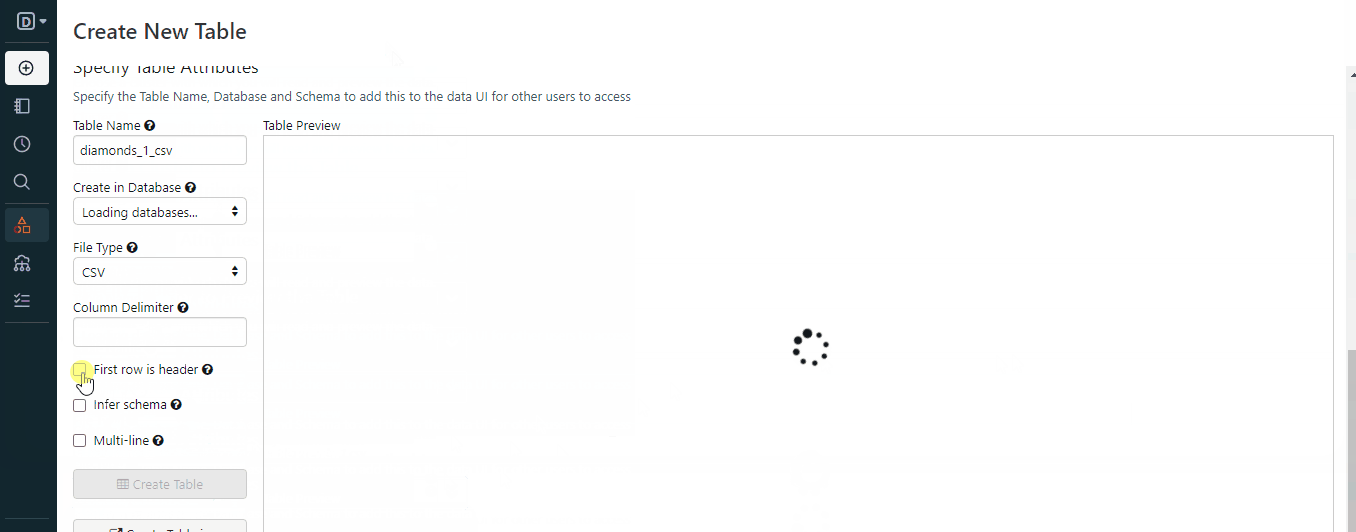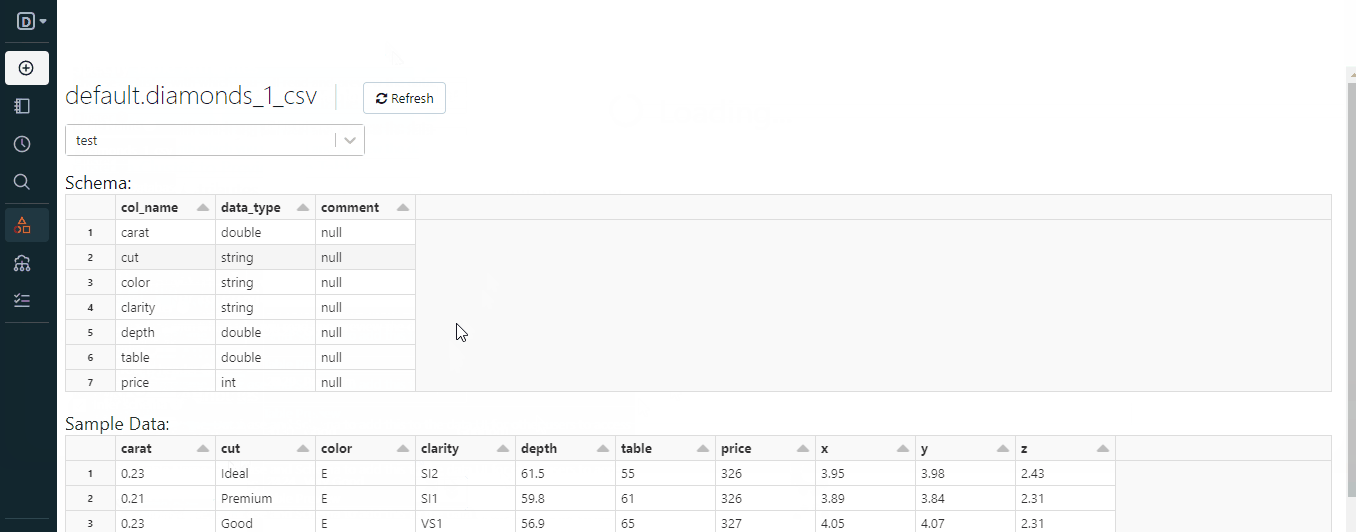
GIF में दिए चरणों का पालन करने के बाद, आपके पास वर्कस्पेस में एक फ़ाइल संग्रहीत होगी। इसे Spark के साथ ऐसे लोड कर सकते हैं:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
dbfs: प्रीफ़िक्स पर ध्यान दें। सभी वर्कस्पेस फ़ाइलों में इसे शामिल करना ज़रूरी है ताकि Spark के साथ फ़ाइल सही तरह लोड हो सके। DBFS का अर्थ है Databricks File System।
S3 बकेट से डेटा आयात करना (एंटरप्राइज़ अकाउंट्स के लिए) इसी तरह है:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
अन्य प्रकार के डेटा के लिए, आप Databricks डाक्यूमेंटेशन के Data engineering और Connect to data sources सेक्शन देख सकते हैं।
जब हमने diamonds.csv फ़ाइल अपलोड की, तो वह default नामक डेटाबेस में एक Databricks टेबल बन गई:
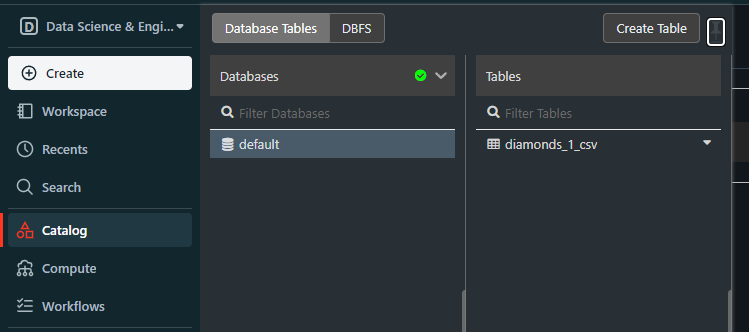
यह default डेटाबेस तब बनता है जब हम बिना डेटाबेस बनाए संरचित फ़ाइलें लोड करने का प्रयास करते हैं।
यदि हमारे पास एक डेटाबेस है, तो इसका मतलब हम इसे केवल Spark से ही नहीं, SQL से भी क्वेरी कर सकते हैं। ऐसा करने के लिए, एक नई नोटबुक बनाएँ या वर्तमान नोटबुक की भाषा को SQL में बदलें। फिर, निम्न कोड स्निपेट आज़माएँ:
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
यह diamonds टेबल की शीर्ष पाँच पंक्तियाँ लौटाना चाहिए:
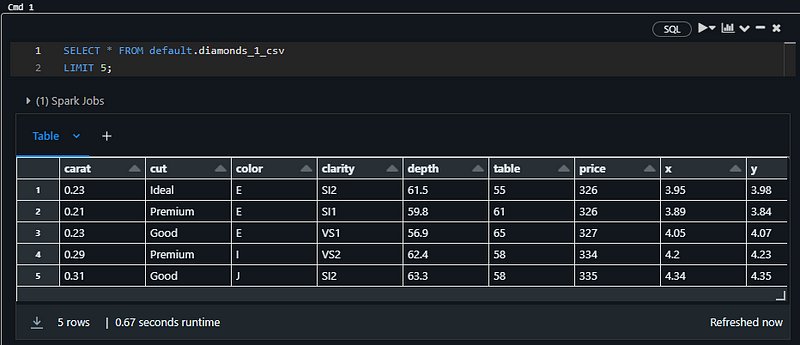
नोट: ऊपर दिए गए स्निपेट के लिए मैं SQL नोटबुक का उपयोग कर रहा हूँ
आप इस टेबल को Pandas में भी लोड कर सकते हैं। उसी नोटबुक में, यह स्निपेट पेस्ट करें:
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
यह टेबल का head प्रिंट करेगा:
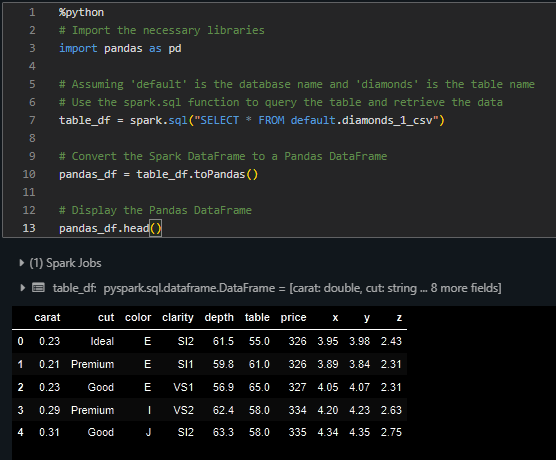
अब, आप इस टेबल पर SQL और Pandas—दोनों के साथ कोई भी सामान्य डेटा विश्लेषण कार्य कर सकते हैं।
हमने केवल Databricks कम्युनिटी एडिशन के बेसिक अकाउंट का उपयोग करते हुए बहुत कुछ सीखा और किया। प्लेटफ़ॉर्म के बारे में सीखना जारी रखने के लिए, पहला कदम Databricks द्वारा प्रीमियम अकाउंट्स के लिए दी जाने वाली दो-सप्ताह की मुफ़्त ट्रायल का उपयोग करना है।
उसके बाद, आप DataCamp के Introduction to Databricks कोर्स के पाठों का पूरा आनंद ले सकते हैं। अकाउंट सेटअप के अलावा, आप DataCamp की निम्न कोर विशेषताओं का उपयोग करना सीखेंगे और अभ्यास करेंगे:
आज ही अपनी Databricks यात्रा शुरू करें!
कोर्स
लर्निंग पाथ
लर्निंग पाथ
