
Cours
Concepts Databricks
4 h
23.3K
Au départ, il y avait les entrepôts de données. Ils stockaient les données en lignes et colonnes, car l’Internet et les ordinateurs de l’époque ne géraient que des informations textuelles simples. Bien plus tard sont arrivés les lacs de données — ils pouvaient stocker presque tout type de données collectées. Parfaits pour l’ère des réseaux sociaux et de YouTube.
Mais chacun avait ses limites — les entrepôts de données étaient coûteux et peu adaptés à la science des données moderne, tandis que les data lakes étaient désordonnés et se transformaient souvent en marécages de données. Les entreprises ont alors mis en place deux piles technologiques distinctes — des entrepôts pour la BI et l’analytique, et des lacs pour le machine learning.
Cependant, gérer deux architectures données différentes s’est révélé si complexe que les résultats étaient souvent décevants. Ce problème a donné naissance à l’architecture lakehouse, qui fait justement la renommée de Databricks.
Databricks est une plateforme cloud qui permet de tirer parti à la fois des entrepôts et des lacs de données dans un environnement unifié. Cet article présente la plateforme, ses fonctionnalités majeures et comment les utiliser.
Databricks est une plateforme si vaste que sa documentation pourrait tenir en un livre. L’objectif de cet article est donc de vous proposer une hiérarchie de concepts — une progression linéaire des fonctionnalités Databricks qui vous fera passer de débutant à praticien confirmé. Si vous découvrez totalement l’outil, jetez aussi un œil à notre cours Introduction to Databricks.
C’est parti !
Quand vous lisez Databricks, pensez immédiatement « plateforme », et non framework ou bibliothèque Python. Les plateformes proposent généralement un large éventail de fonctionnalités, et Databricks ne fait pas exception. C’est l’une des rares plateformes utilisables par tous les métiers de la donnée, des data engineers aux machine learning engineers (ou « programmeurs IA », comme on les appelle aujourd’hui dans la presse).
Databricks repose sur les composants clés suivants :
Ensemble, ces composants débloquent de nombreux avantages :
Si je vous ai convaincu de l’importance de Databricks dans l’écosystème data, passons à la prise en main.
Pour créer votre compte, rendez-vous sur https://www.databricks.com/try-databricks et inscrivez-vous à la Community Edition.
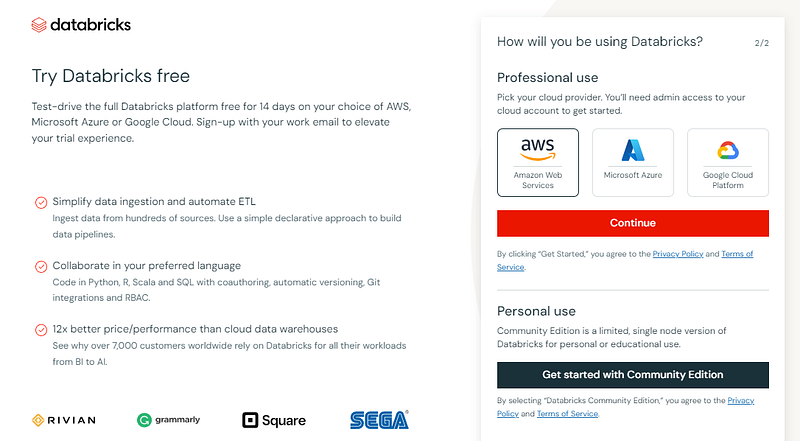
La Community Edition propose moins de fonctionnalités que la version Enterprise, mais elle ne nécessite pas de configuration d’un fournisseur cloud, ce qui est idéal pour de petits usages comme les tutoriels.
Si, après vérification de votre e‑mail, vous obtenez cette page, vous êtes prêt :
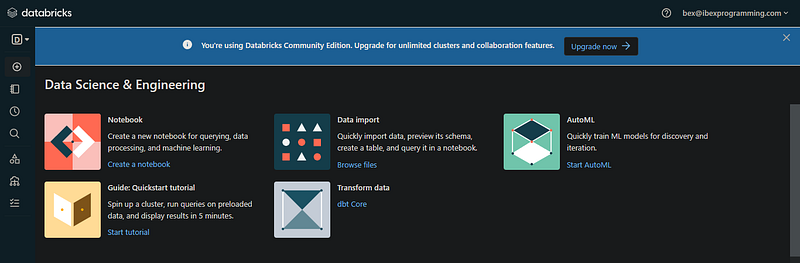
L’interface que vous découvrez est l’espace de travail associé à votre adresse e‑mail (l’espace de travail Community Edition est facile à trouver). En pratique, l’administrateur de votre entreprise crée généralement un compte Databricks unique et gère les accès à l’espace de travail.
Voyons maintenant l’interface de la plateforme. Dans le panneau de gauche, vous trouverez le menu des différents composants proposés par Databricks. La version Enterprise affiche encore plus d’options :
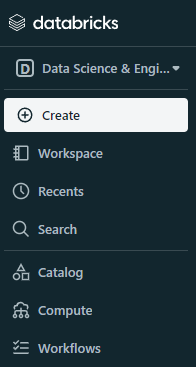
La première option du menu définit le type d’espace de travail, réglé par défaut sur data science and engineering. Si vous le basculez en machine learning, une nouvelle option Experiments apparaît :
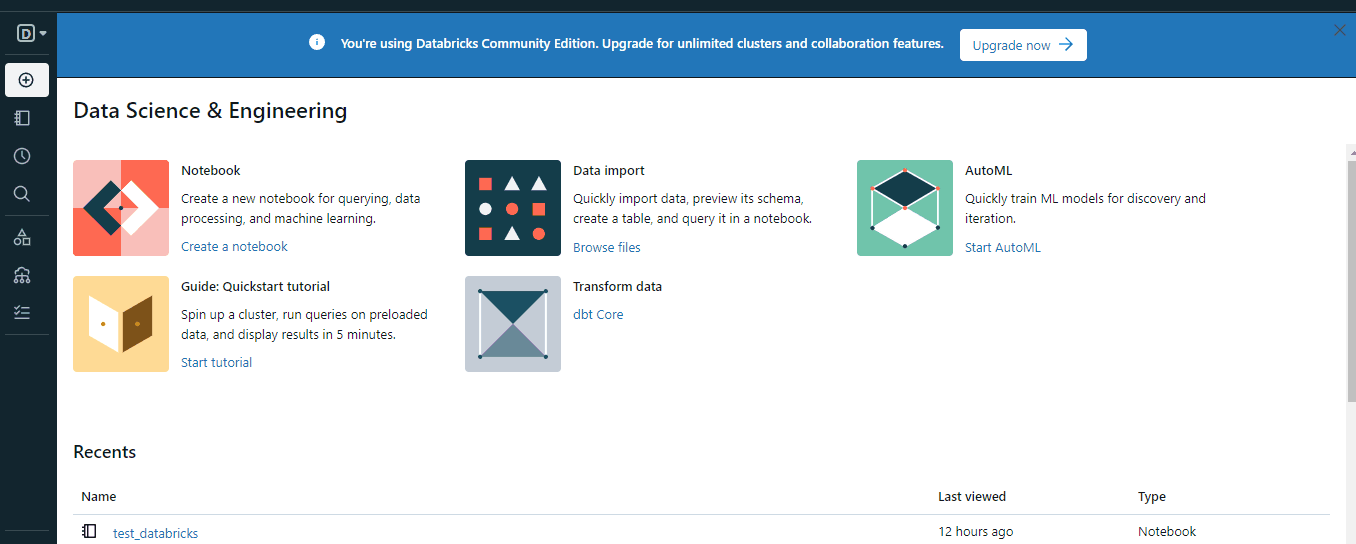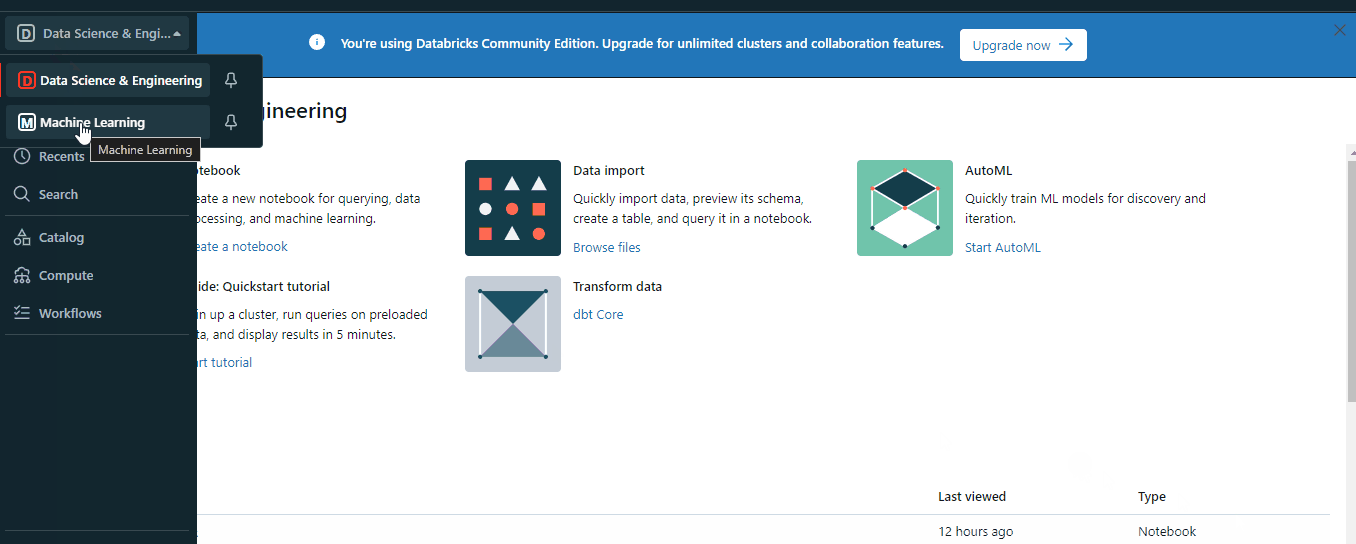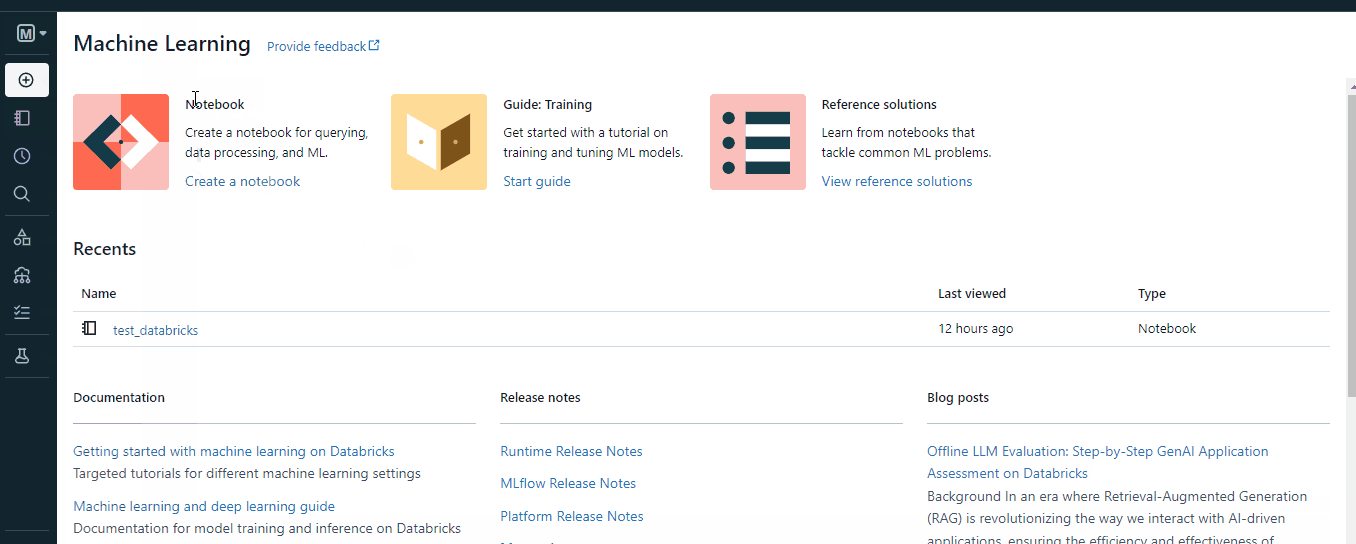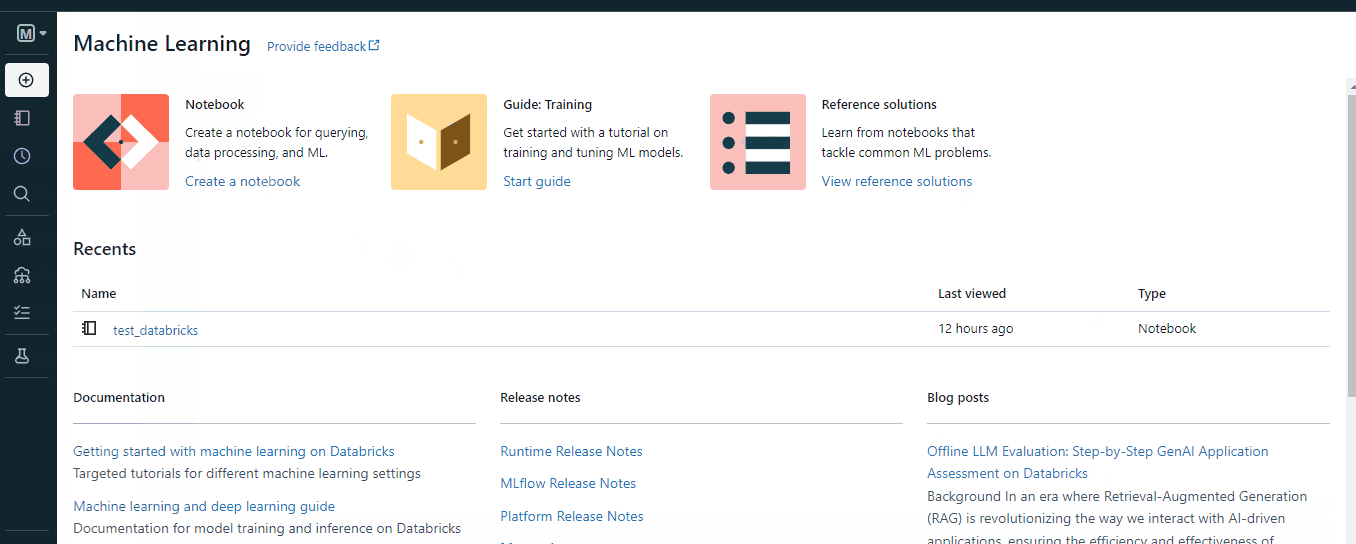
À première vue, cela peut sembler anecdotique, mais une fois votre compte mis à niveau et après quelques essais, vous remarquerez des fonctionnalités très utiles de la plateforme :
etc.
Passons maintenant à certains de ces composants plus en détail.
Dans Databricks, les clusters désignent les ressources de calcul utilisées pour exécuter les traitements de données. En général, ils sont fournis par votre prestataire cloud choisi lors de la configuration du compte.
Les clusters de la Community Edition sont limités en RAM et CPU, et ne proposent pas de GPU. En revanche, les utilisateurs premium peuvent généralement effectuer facilement les tâches suivantes :
Pour créer un cluster, utilisez le bouton « Create » ou le menu « Compute » :
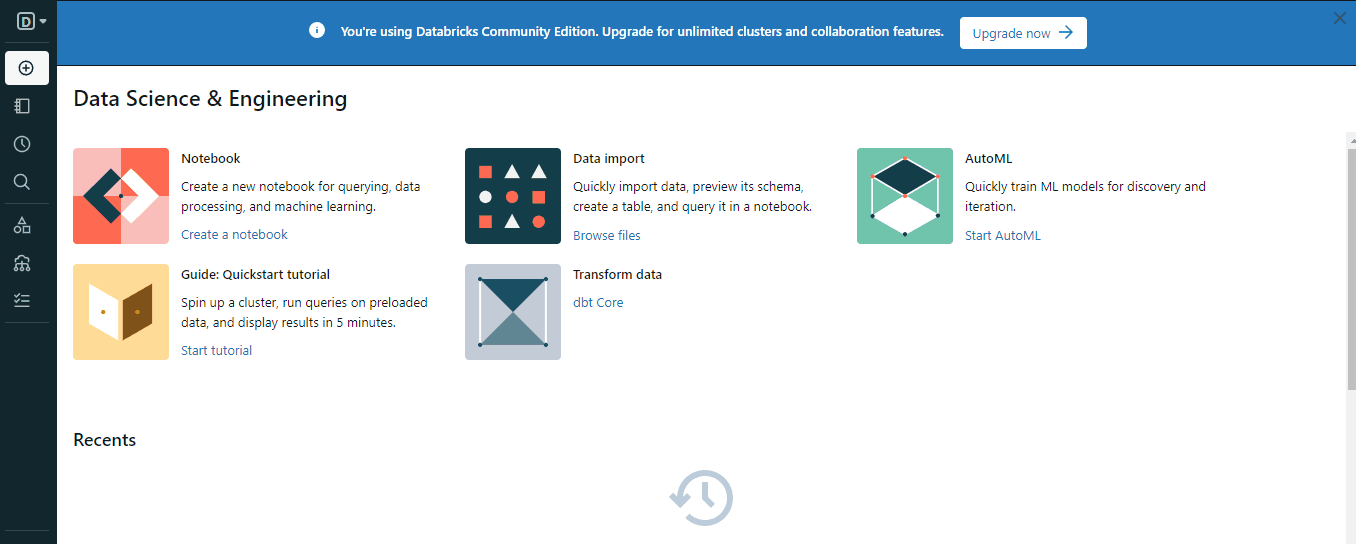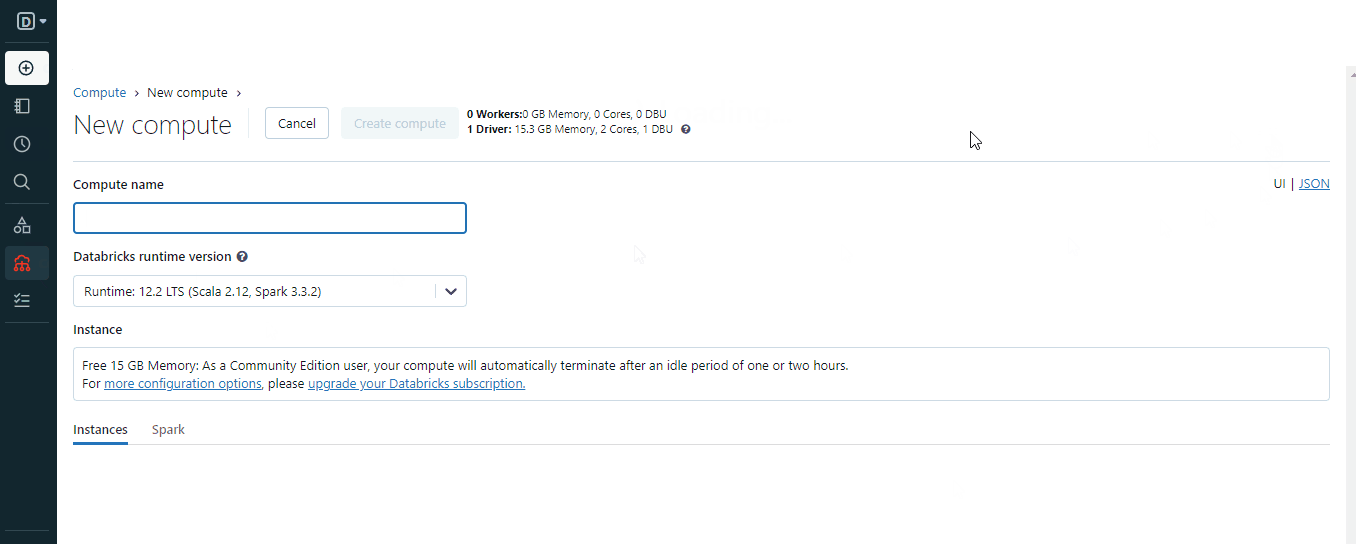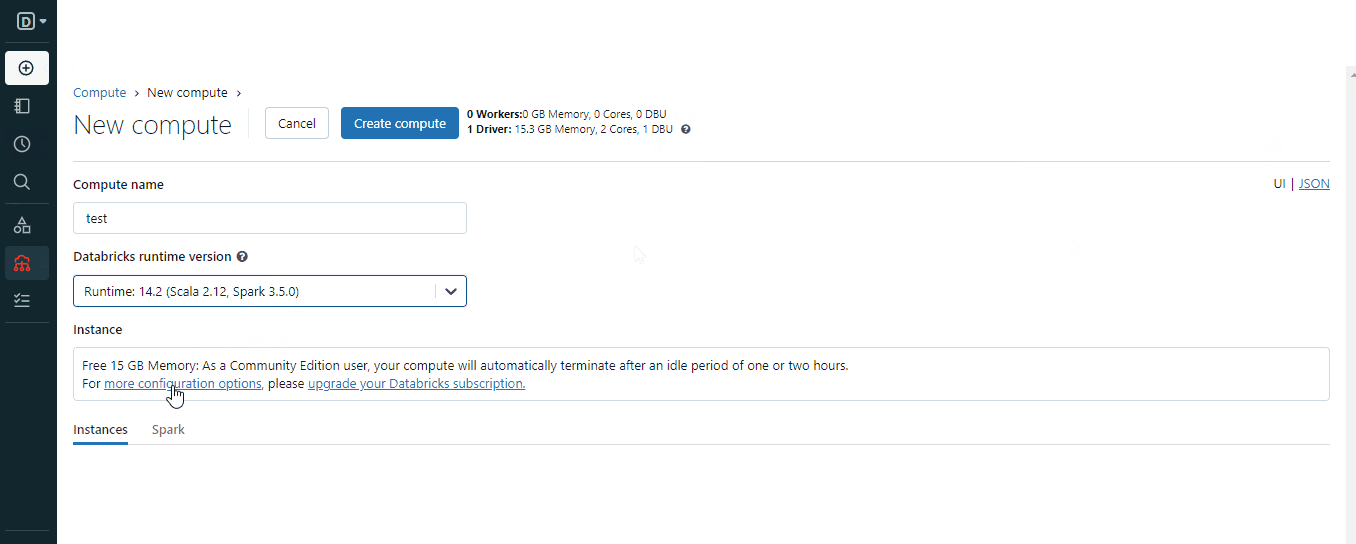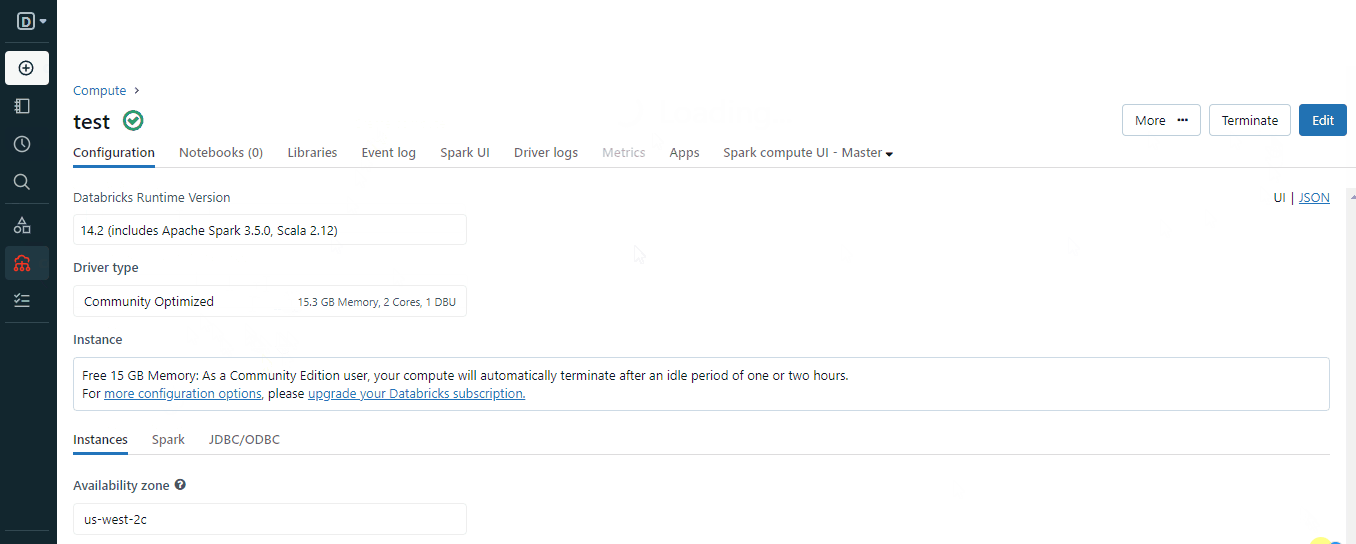
Lors de la création, choisissez une version de Spark adaptée à votre environnement et patientez quelques minutes le temps qu’il devienne opérationnel.
Une fois un cluster démarré, vous pouvez créer des notebooks. Si vous avez déjà utilisé Jupyter, Colab ou les DataCamp Workspaces, vous ne serez pas dépaysé :
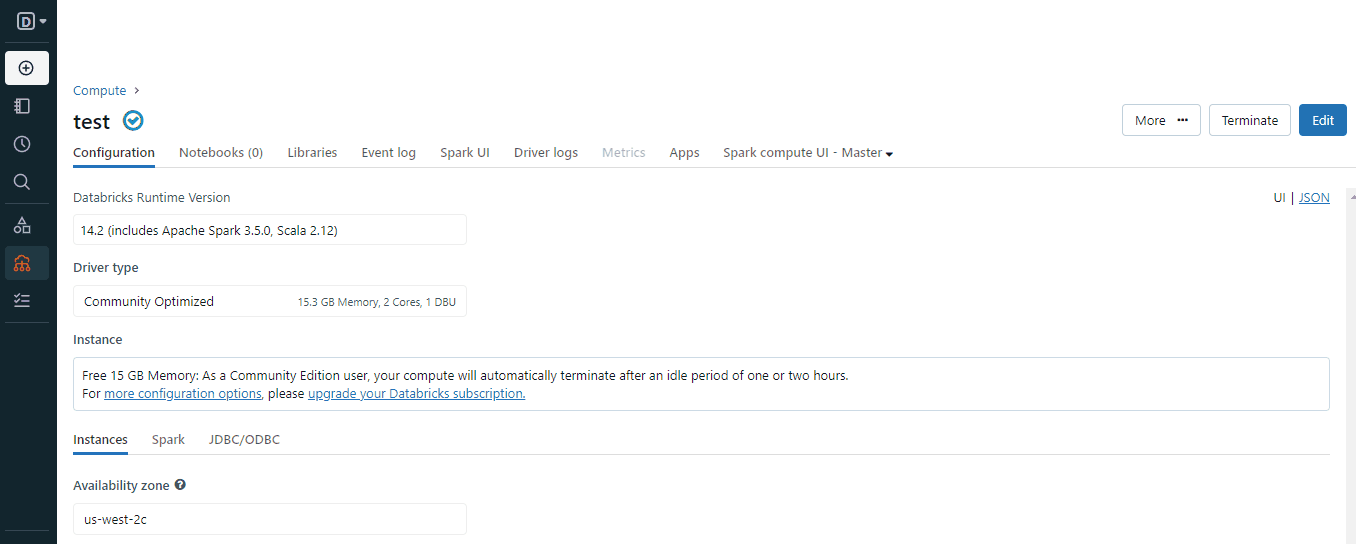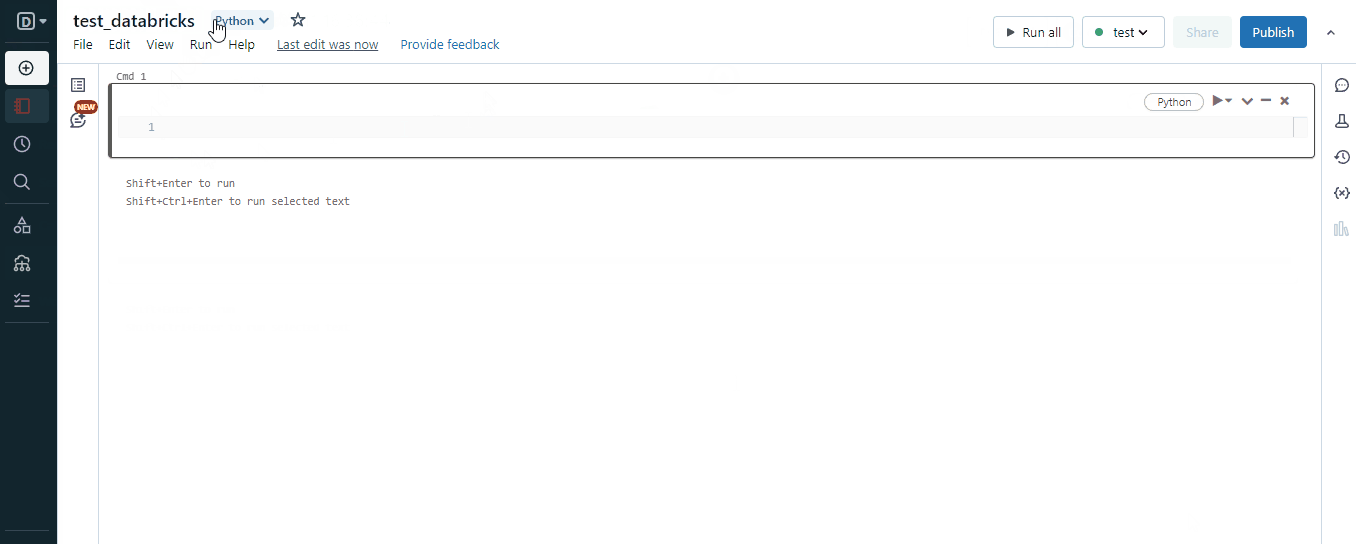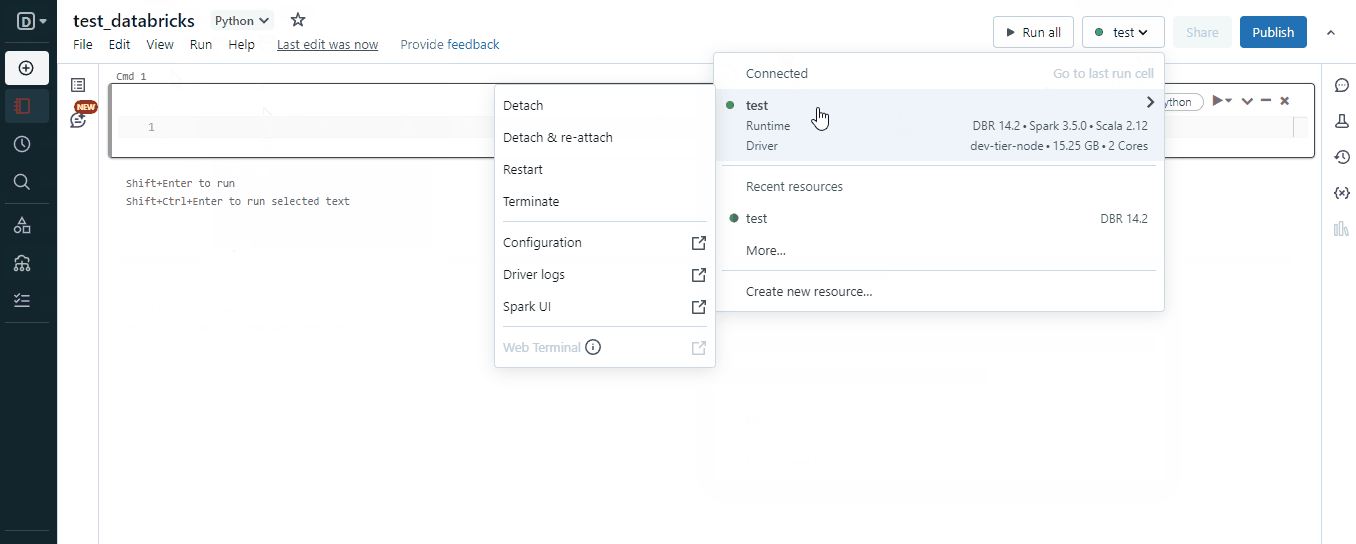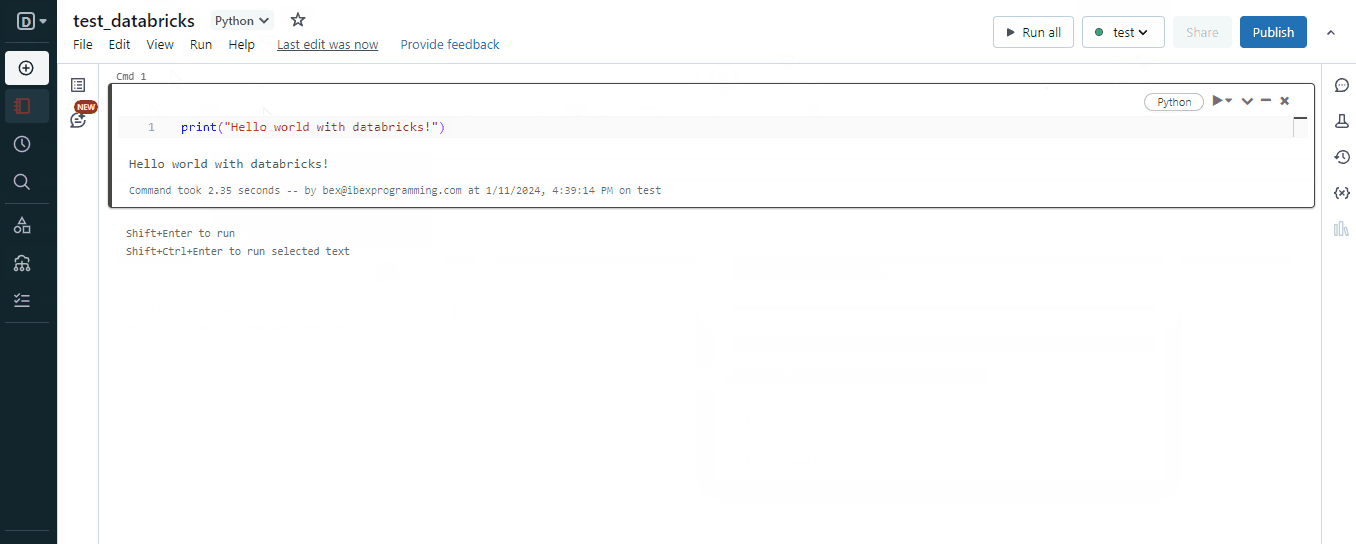
Mais dans un monde où Jupyter existe, pourquoi choisir quelque chose de « similaire à Jupyter » ? Les notebooks Databricks offrent plusieurs atouts par rapport aux notebooks Jupyter :
Il existe bien d’autres avantages des notebooks Databricks par rapport à Jupyter ; voici un tableau récapitulatif des différences :
|
Fonctionnalité |
Jupyter Notebooks |
Databricks Notebooks |
|
Plateforme |
Open source, exécution locale ou sur le cloud |
Exclusifs à la plateforme Databricks |
|
Collaboration et partage |
Fonctionnalités limitées, partage manuel |
Collaboration intégrée, co‑édition en temps réel |
|
Exécution |
Repose sur des serveurs locaux ou externes |
Exécution sur des clusters Databricks |
|
Intégration Big Data |
Intégrable avec Spark, nécessite des configurations supplémentaires |
Intégration native avec Apache Spark, optimisée pour le big data |
|
Fonctionnalités natives |
Outils/extensions externes pour le versioning, la collaboration et la visualisation |
Intégration à des fonctionnalités propres à Databricks comme Delta Lake, et prise en charge native de la collaboration et des outils analytiques |
|
Coûts et mise à l’échelle |
Installations locales souvent gratuites, solutions cloud potentiellement payantes |
Service payant, coûts liés à l’usage, montée en charge fluide via les clusters Databricks |
|
Prise en main |
Familier et très répandu dans la communauté data science |
Optimisé pour l’analytique big data, avec une courbe d’apprentissage potentiellement plus marquée pour les spécificités Databricks |
|
Visualisation de données |
Support natif limité |
Support intégré à l’environnement du notebook |
|
Gestion des clusters |
Gestion manuelle des sessions Spark et des dépendances |
Gestion et mise à l’échelle automatiques par la plateforme Databricks |
|
Cas d’usage |
Polyvalents pour de nombreuses tâches data science |
Spécialisés pour l’analytique big data collaborative au sein de Databricks |
Au final, ces avantages se révèlent surtout dans certains contextes. Si vous explorez un CSV avec pandas sur votre ordinateur portable, Jupyter fera très bien l’affaire.
En revanche, pour des applications au niveau entreprise, Databricks, en tant que plateforme, peut s’avérer un meilleur choix.
L’ingestion de données correspond à l’import depuis diverses sources. Databricks prend en charge, entre autres :
etc.
Voyons maintenant comment charger certains types de données dans Databricks. Commençons par des fichiers locaux :
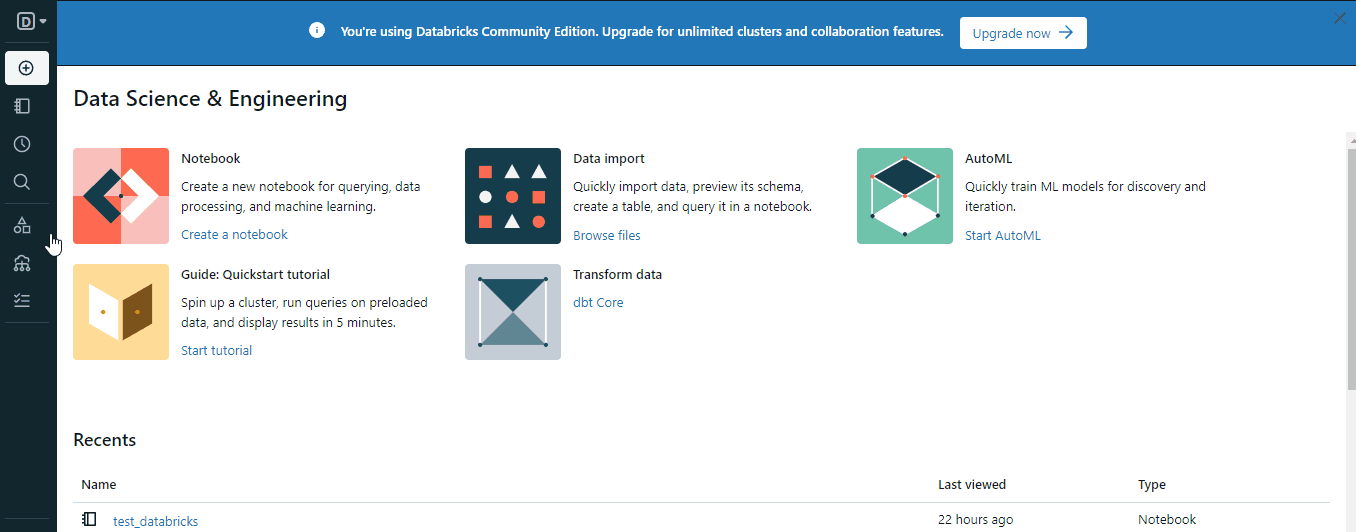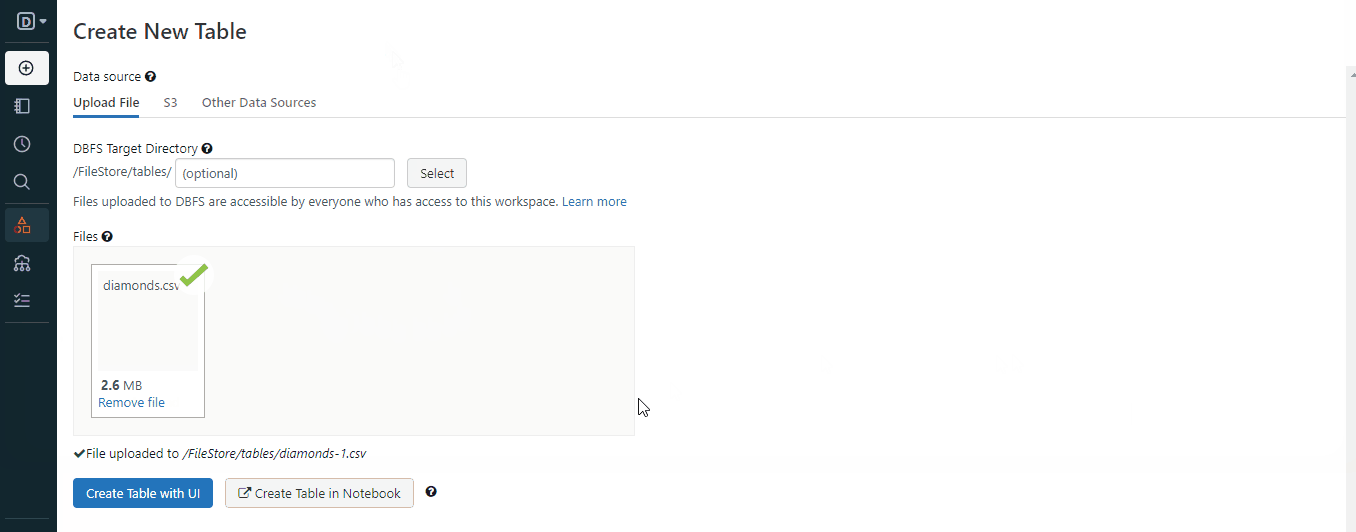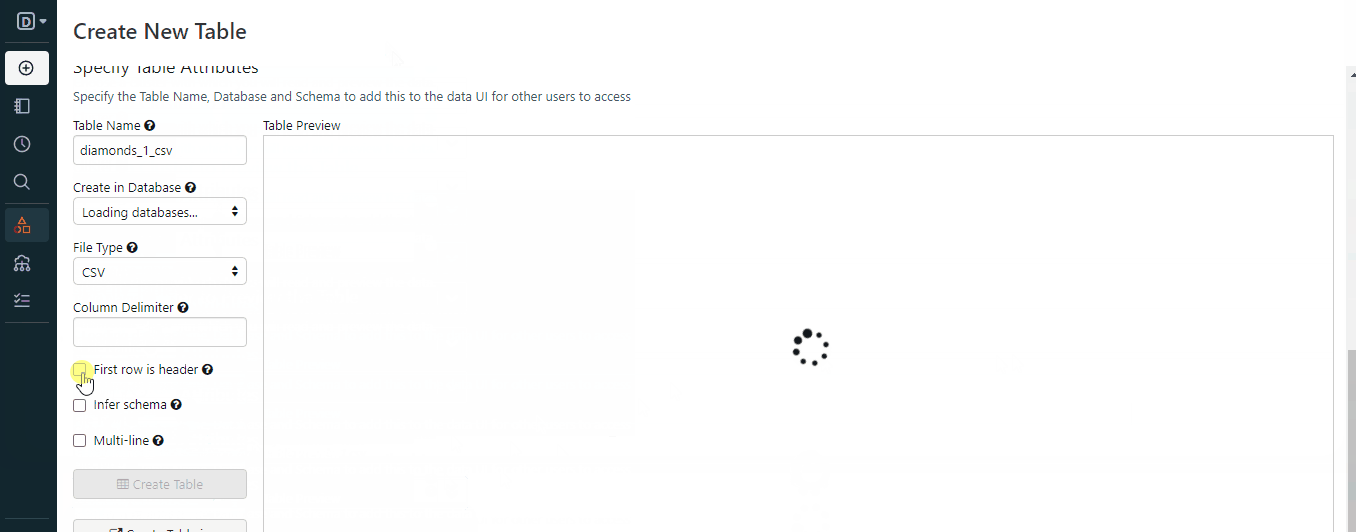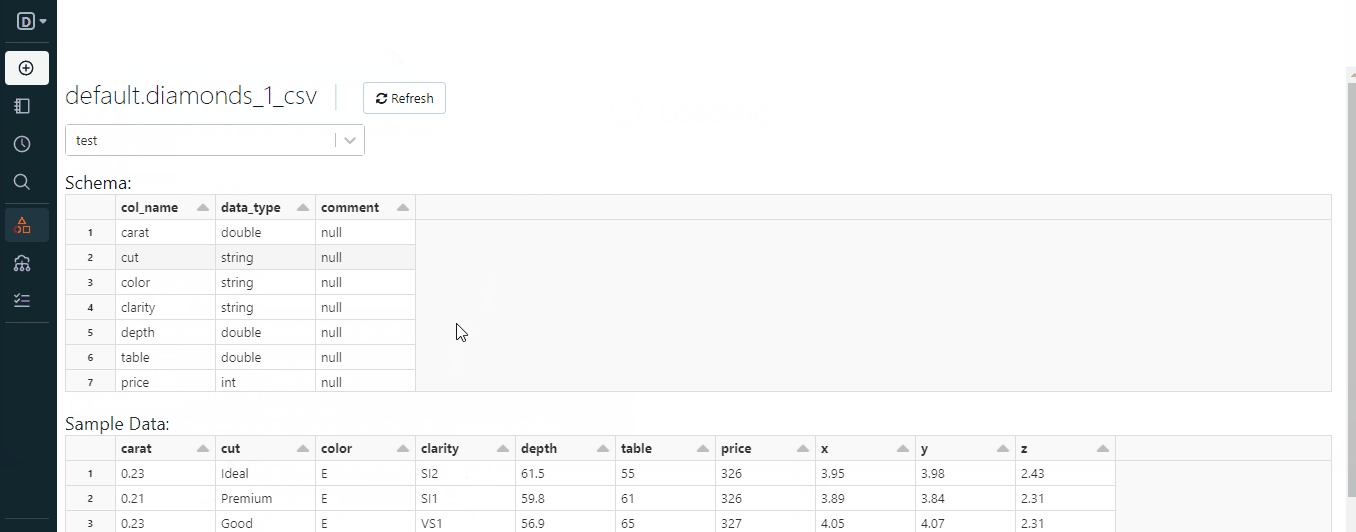
Après ces étapes (voir le GIF), votre fichier est stocké dans l’espace de travail. Voici comment le charger avec Spark :
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Notez le préfixe dbfs:. Tous les fichiers de l’espace de travail doivent l’inclure pour être chargés correctement avec Spark. DBFS signifie Databricks File System.
L’import depuis un bucket S3 est similaire (pour les comptes Enterprise) :
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Pour les autres types de données, consultez les sections Data engineering et Connect to data sources de la documentation Databricks.
Lorsque nous avons téléversé le fichier diamonds.csv, il est devenu une table Databricks dans une base appelée default :
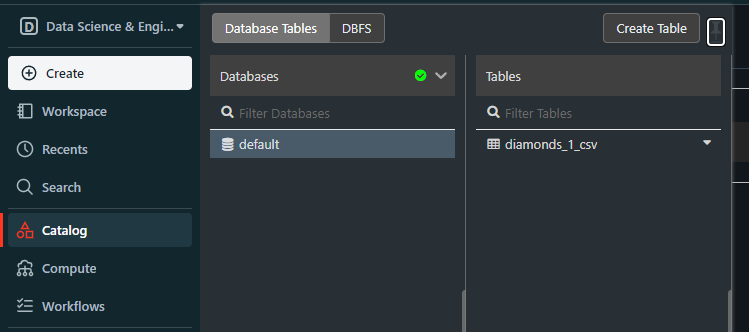
Cette base default est créée automatiquement quand on charge des fichiers structurés sans créer la base au préalable.
Qui dit base de données dit requêtes SQL, pas seulement via Spark. Pour cela, créez un nouveau notebook ou changez le langage du notebook courant en SQL. Puis essayez l’extrait suivant :
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
Vous devez obtenir les cinq premières lignes de la table diamonds :
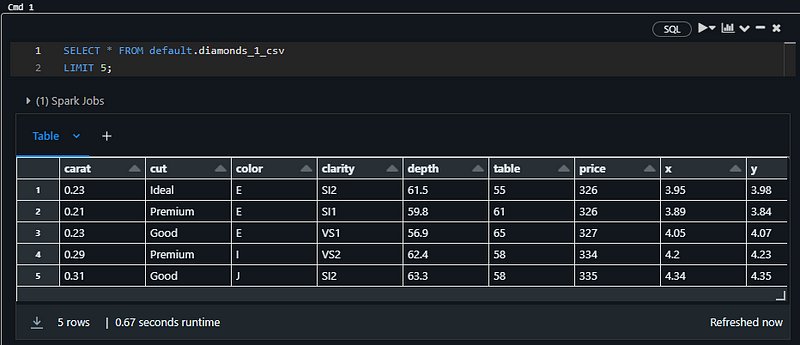
Remarque : j’utilise un notebook SQL pour l’extrait ci‑dessus
Vous pouvez aussi charger cette table dans pandas. Dans le même notebook, collez cet extrait :
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
Vous devriez voir l’aperçu de la table :
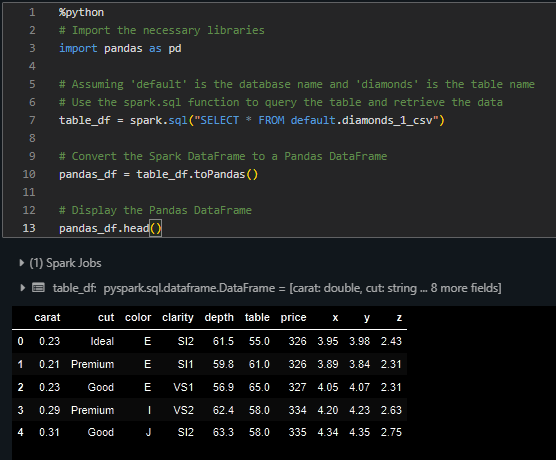
Vous pouvez désormais réaliser toute analyse de données classique sur la table, en SQL comme avec pandas.
Nous avons couvert beaucoup de terrain avec un compte Databricks Community Edition minimal. Pour continuer, commencez par profiter de l’essai gratuit de deux semaines proposé pour les comptes premium.
Ensuite, vous pourrez tirer pleinement parti du cours Introduction to Databricks proposé par DataCamp. Au‑delà de la configuration du compte, vous apprendrez et mettrez en pratique les fonctionnalités clés suivantes de Databricks :
Commencez votre aventure Databricks dès aujourd’hui !
Cours
Cursus
Cursus