
Kurs
Databricks-Konzepte
4 Std.
23.3K
Am Anfang gab es Data-Warehouses. Sie speicherten Daten in Zeilen und Spalten, weil Internet und Computer damals vor allem einfache Textinformationen verarbeiten konnten. Viel später kamen Data Lakes — sie konnten nahezu jede Art von Daten aufnehmen, die du sammeln konntest. Perfekt für das Social-Media- und YouTube-Zeitalter.
Beide hatten jedoch Nachteile — Data-Warehouses waren teuer und für moderne Data Science wenig geeignet, während Data Lakes unübersichtlich wurden und oft zu Data Swamps verkommen sind. Unternehmen betrieben daher zwei getrennte Tech-Stacks — Warehouses für BI und Analytics und Lakes für Machine Learning.
Die Pflege zweier unterschiedlicher Datenarchitekturen war jedoch so aufwendig, dass die Ergebnisse oft zu wünschen übrig ließen. Daraus entstand die Lakehouse-Architektur — genau dafür ist Databricks berühmt.
Databricks ist eine Cloud-Plattform, die es ermöglicht, den Mehrwert von Warehouses und Lakes in einer gemeinsamen Umgebung zu vereinen. Dieser Artikel bietet einen Überblick über die Plattform, zeigt die wichtigsten Features und wie du sie nutzt.
Databricks ist so umfangreich, dass allein die Dokumentation ein eigenes Buch füllen könnte. Ziel dieses Artikels ist daher, dir eine sinnvolle Begriffshierarchie zu geben — linear geordnete Erklärungen der Databricks-Features, mit denen du vom Einsteiger zur versierten Databricks-Anwenderin bzw. zum versierten Anwender wirst. Wenn du ganz neu bist, wirf auch einen Blick auf unseren Introduction to Databricks-Kurs.
Los geht’s!
Wenn du Databricks liest, denk an eine Plattform — nicht an ein Framework oder eine Python-Bibliothek. Plattformen bieten typischerweise einen großen Funktionsumfang, und Databricks ist da keine Ausnahme. Es ist eine der wenigen Plattformen, die jede Datenrolle abdeckt — von Data Engineers bis zu modernen Machine-Learning-Engineers (oder, wie die Presse heute sagt, KI-Programmierern).
Databricks umfasst diese Kernkomponenten:
Im Zusammenspiel erschließen diese Komponenten zahlreiche Vorteile:
Wenn dich das von der Bedeutung von Databricks in der Datenwelt überzeugt, machen wir dich jetzt startklar auf der Plattform.
Richte deinen Account unter https://www.databricks.com/try-databricks ein und registriere dich für die Community Edition.
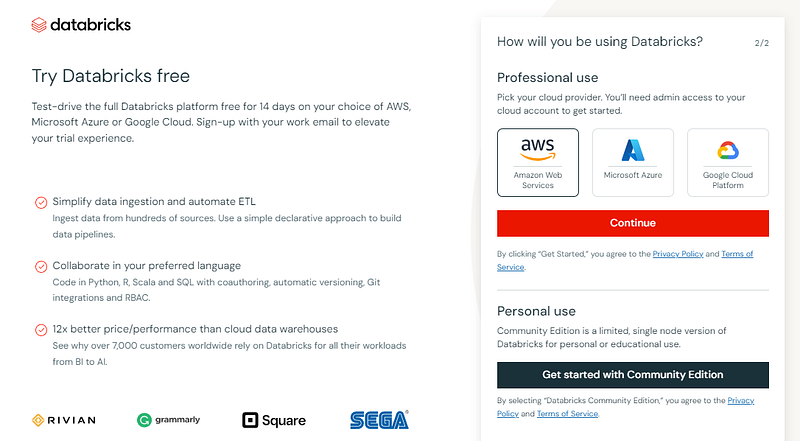
Die Community Edition bietet weniger Funktionen als die Enterprise-Version, benötigt aber keine Einrichtung beim Cloud-Anbieter — ideal für kleine Use Cases wie Tutorials.
Wenn du nach der E-Mail-Verifizierung diese Seite siehst, kannst du loslegen:
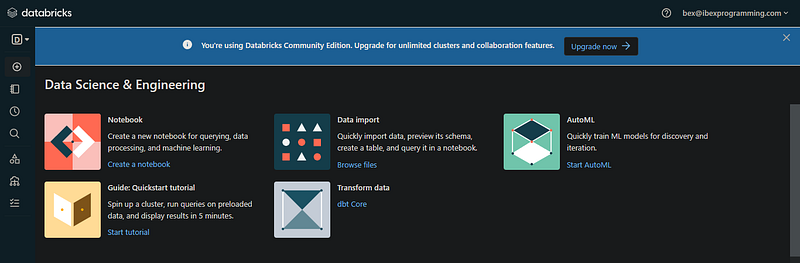
Die Oberfläche, die du siehst, ist der Workspace für deine E-Mail-Adresse (den Community-Edition-Workspace findest du leicht). In Unternehmen legt in der Regel ein Account-Admin einen zentralen Databricks-Account an und verwaltet die Zugriffe auf den Workspace.
Schauen wir uns jetzt das UI der Plattform an. Links findest du das Menü für die verschiedenen Komponenten von Databricks. Die Enterprise-Version hat noch mehr Optionen:
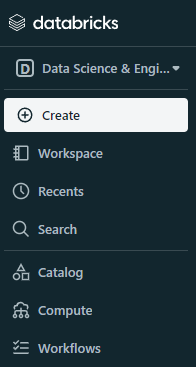
Die erste Option im Menü ist der Workspace-Typ, standardmäßig auf Data Science and Engineering gesetzt. Wenn du auf Machine Learning wechselst, erscheint die neue Option Experiments:
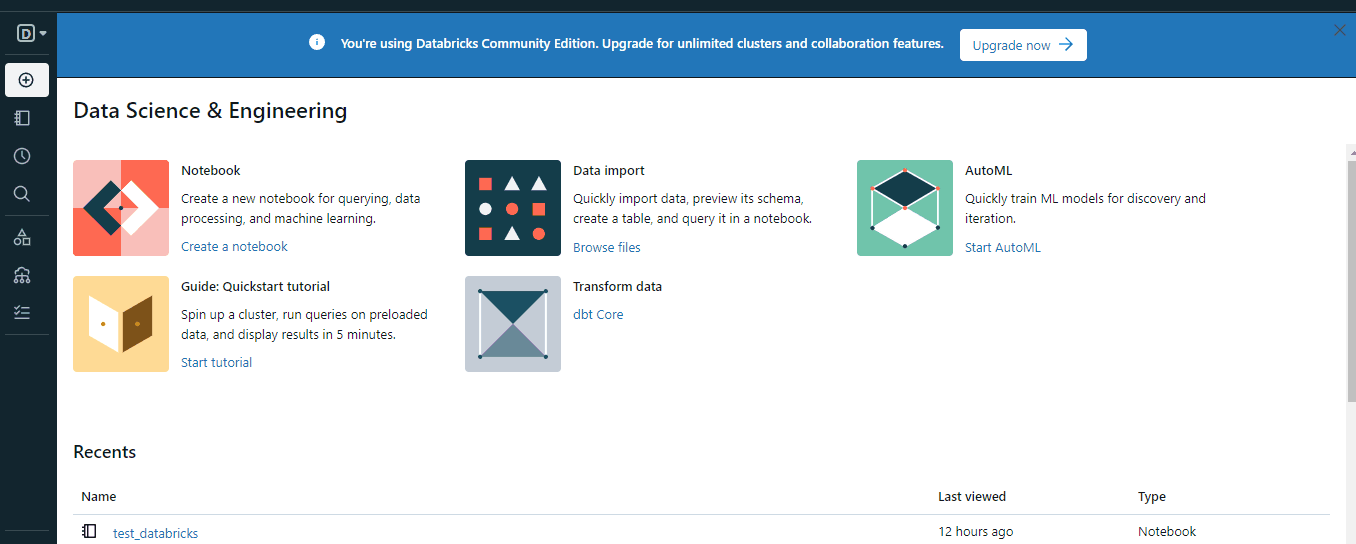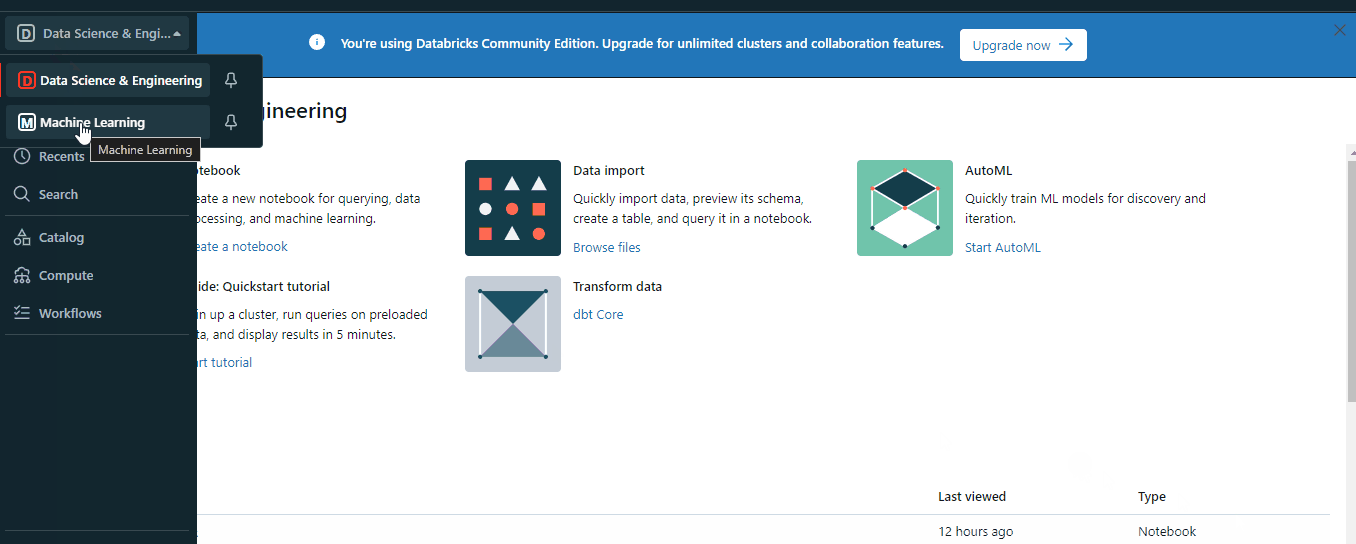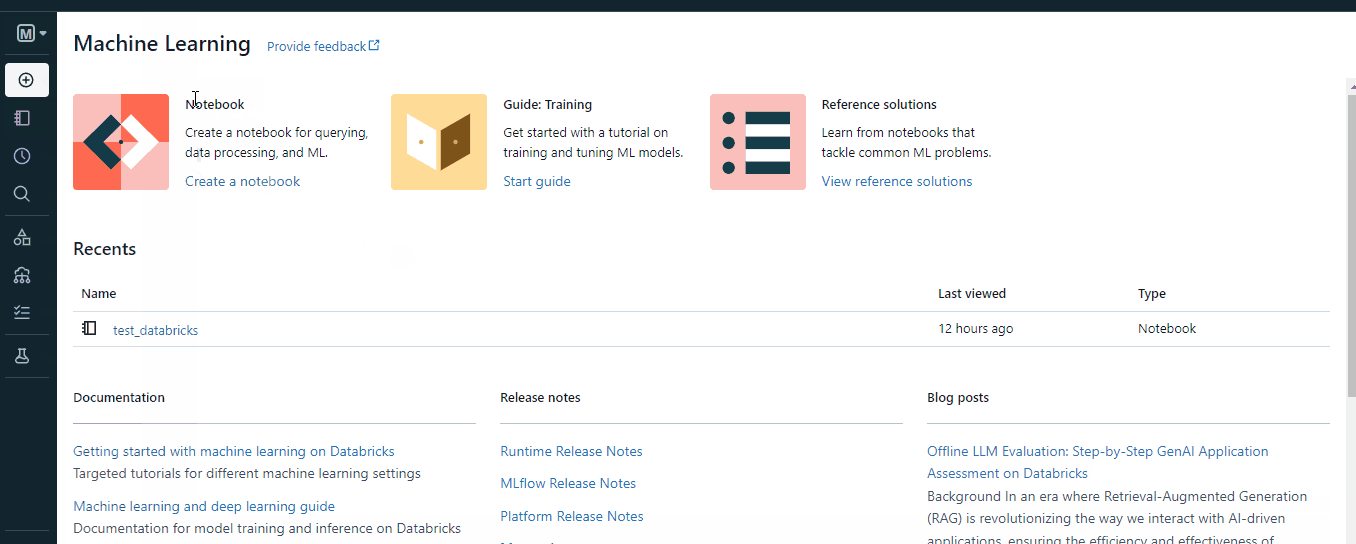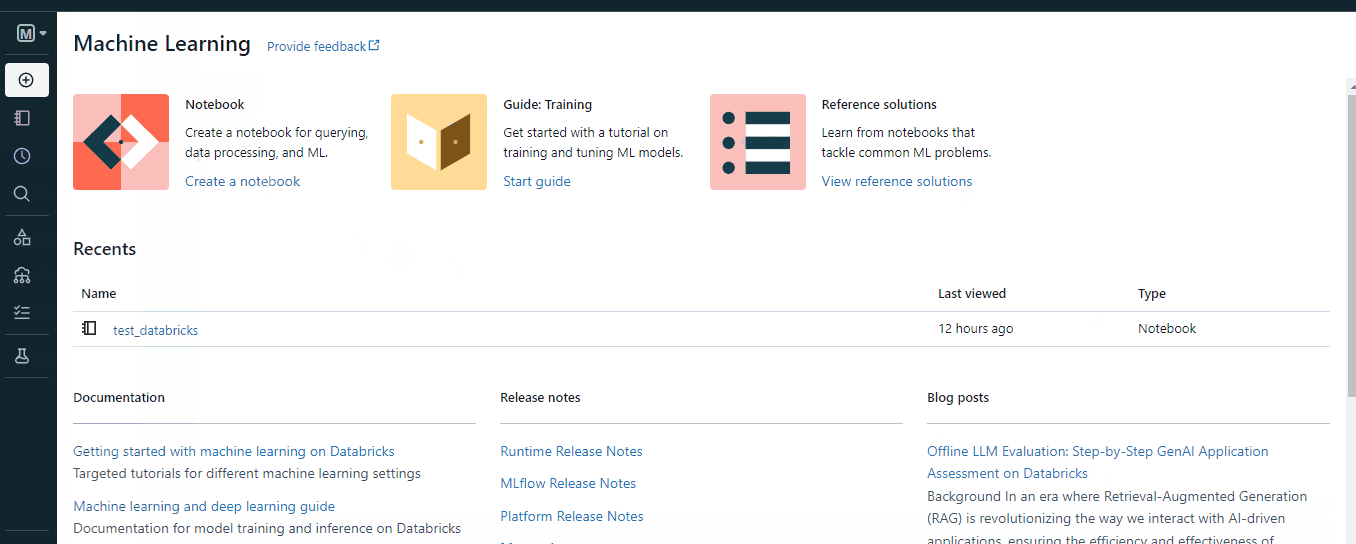
Auf den ersten Blick wirkt das unspektakulär, doch mit einem Upgrade und etwas Hands-on fallen schnell die Stärken der Plattform auf:
und vieles mehr.
Sehen wir uns einige dieser Komponenten genauer an.
Cluster in Databricks sind die Rechenressourcen, mit denen Datenverarbeitungsaufgaben ausgeführt werden. In der Regel stellt dein gewählter Cloud-Anbieter die Cluster bei der Accounterstellung bereit.
In der Community Edition sind RAM und CPU begrenzt, GPUs sind nicht enthalten. Premium-Nutzende können jedoch häufig Folgendes sehr bequem umsetzen:
Um einen Cluster zu erstellen, nutze den Button „Create“ oder den Menüpunkt „Compute“:
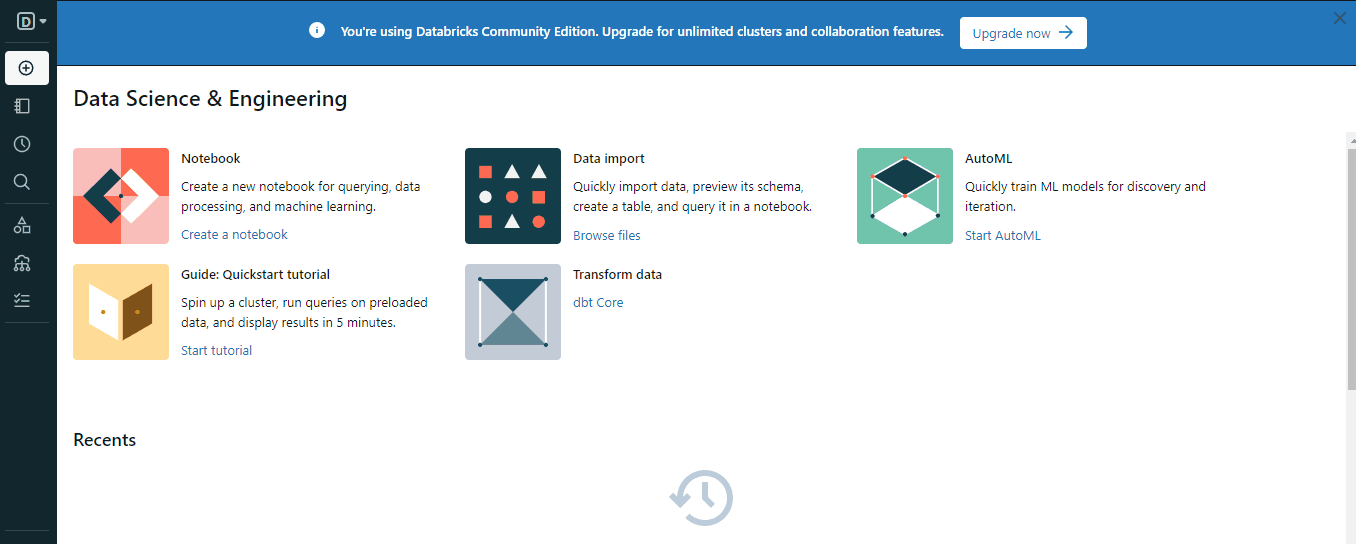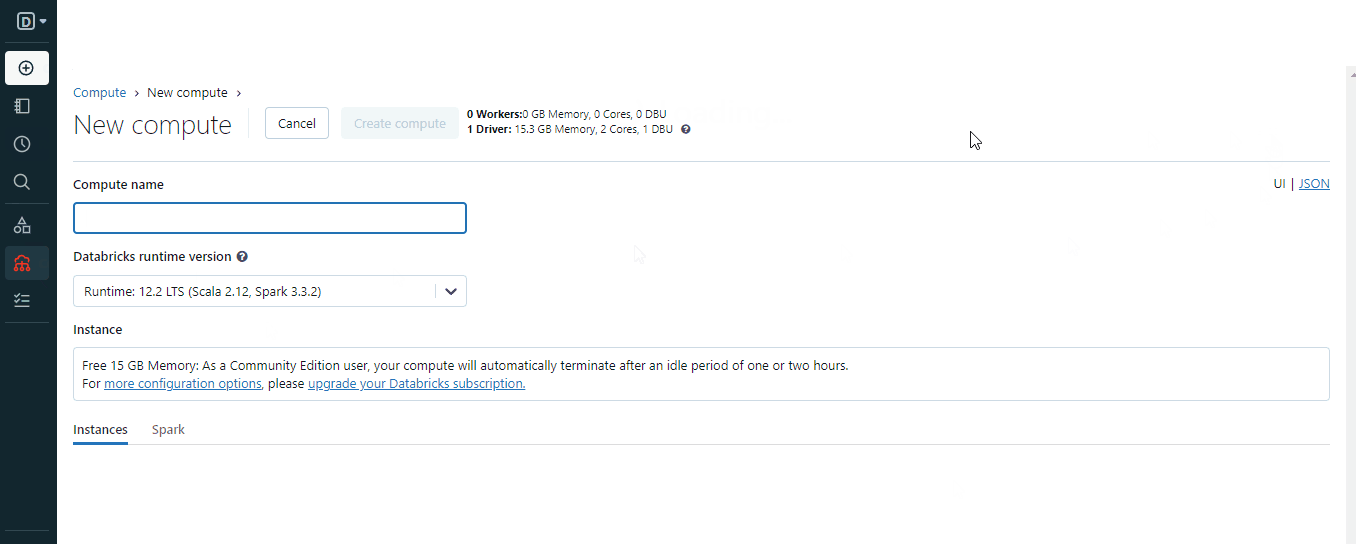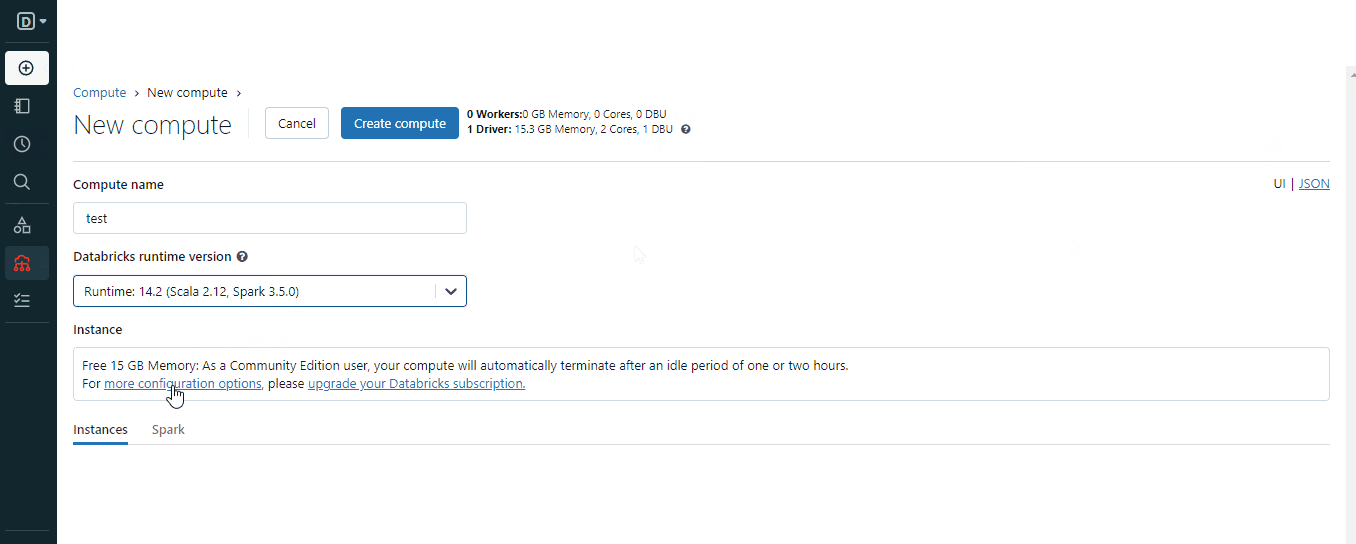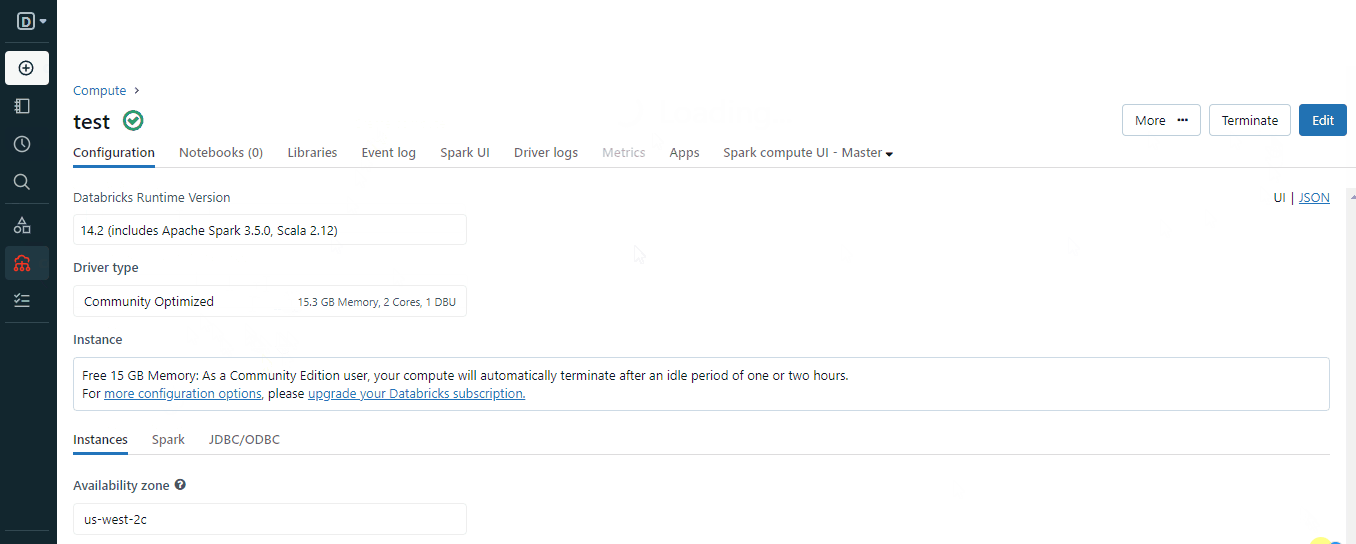
Wähle bei der Erstellung eine passende Spark-Version für deine Umgebung und warte ein paar Minuten, bis der Cluster einsatzbereit ist.
Sobald dein Cluster läuft, kannst du Notebooks anlegen. Wenn du mit Jupyter, Colab oder den DataCamp Workspaces gearbeitet hast, kommt dir vieles vertraut vor:
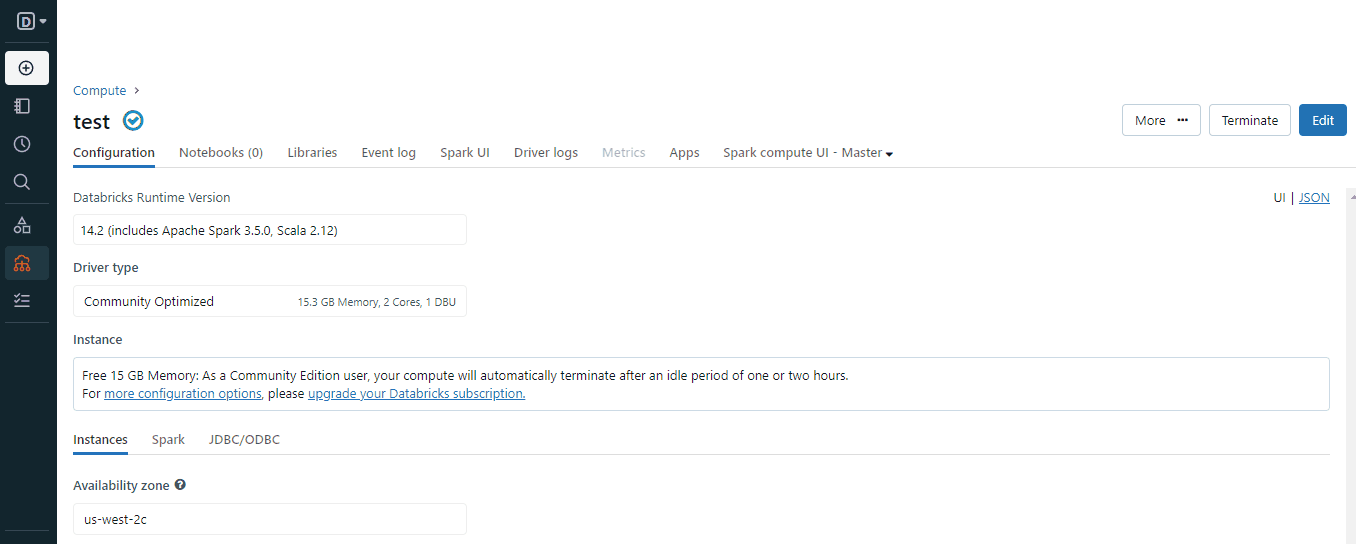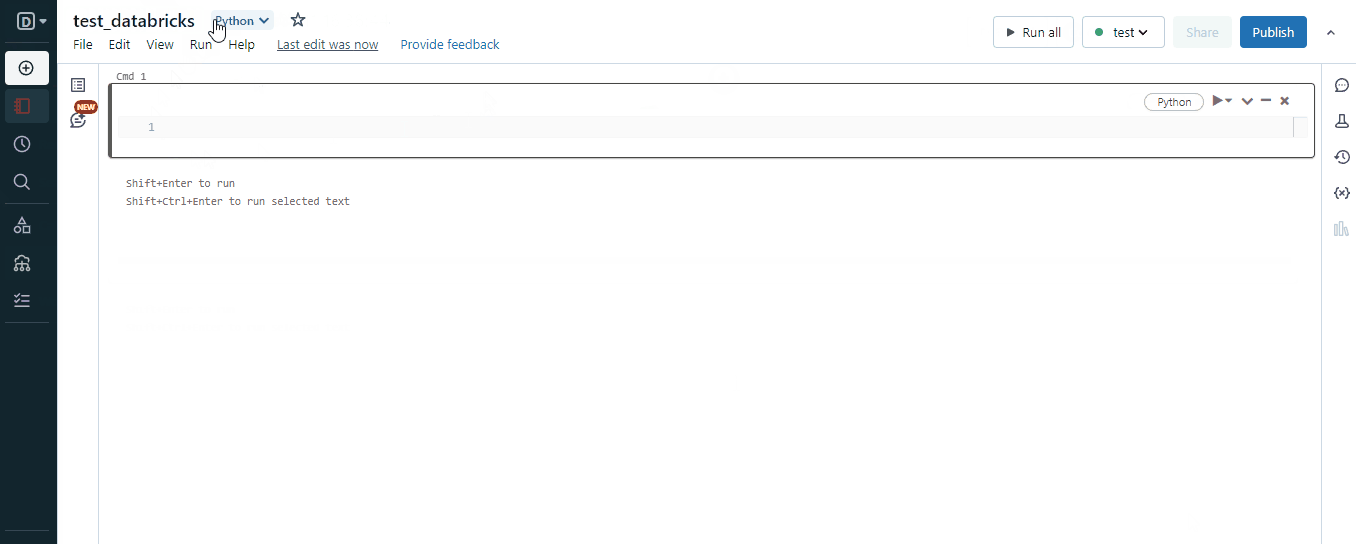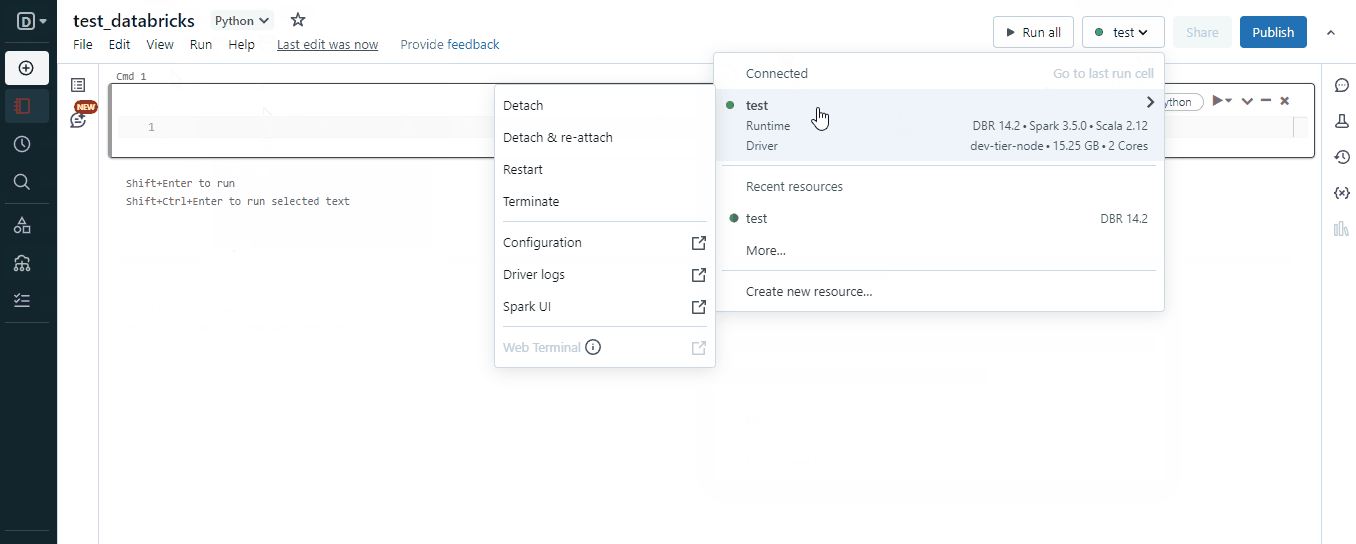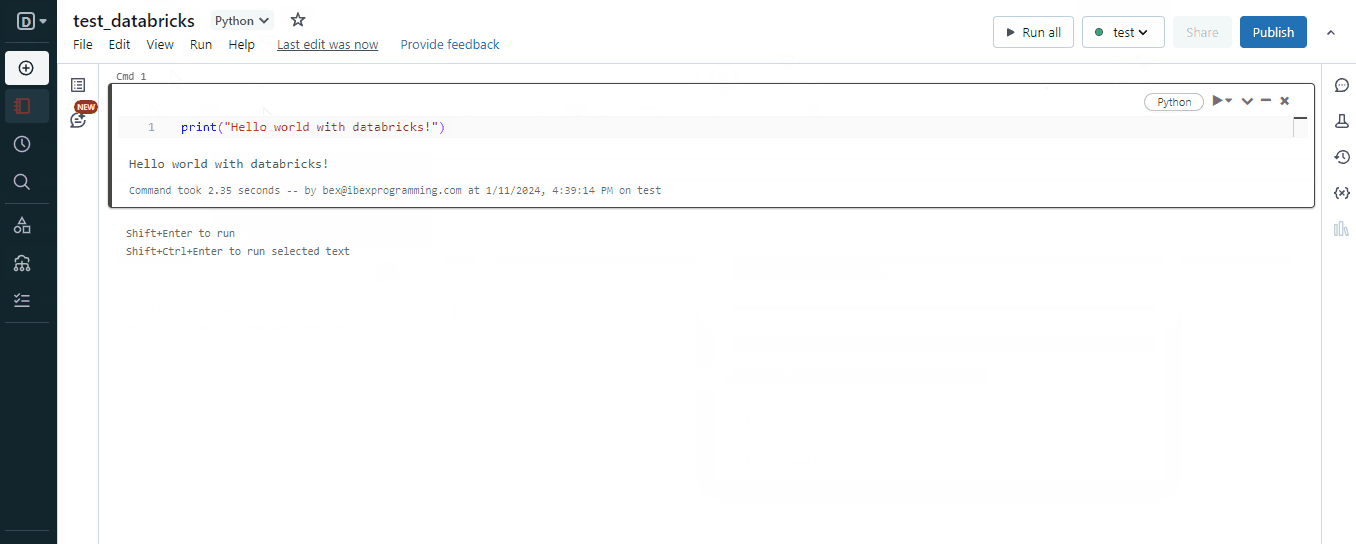
Warum aber „Jupyter-ähnlich“ nutzen, wenn es echtes Jupyter gibt? Nun, Databricks-Notebooks haben gegenüber Jupyter diese Vorteile:
Es gibt noch viele weitere Vorteile. Hier eine Tabelle mit den wichtigsten Unterschieden:
|
Feature |
Jupyter Notebooks |
Databricks Notebooks |
|
Plattform |
Open Source, lokal oder in der Cloud |
Exklusiv auf der Databricks-Plattform |
|
Zusammenarbeit & Teilen |
Begrenzte Kollaboration, manuelles Teilen |
Integrierte Kollaboration, gleichzeitiges Echtzeit-Editing |
|
Ausführung |
Lokal oder auf externen Servern |
Ausführung auf Databricks-Clustern |
|
Big-Data-Integration |
Mit Spark integrierbar, zusätzliche Konfiguration nötig |
Native Apache-Spark-Integration, für Big Data optimiert |
|
Eingebaute Features |
Externe Tools/Erweiterungen für Versionskontrolle, Kollaboration, Visualisierung |
Integration mit Databricks-Features wie Delta Lake, eingebaute Kollaboration und Analytics-Tools |
|
Kosten & Skalierung |
Lokal oft kostenlos, Cloud-Varianten können kostenpflichtig sein |
Kostenpflichtiger Dienst, nutzungsabhängige Kosten, nahtlose Skalierung mit Clustern |
|
Benutzerfreundlichkeit |
Vertraut und weit verbreitet in der Data-Science-Community |
Für Big-Data-Analytics zugeschnitten, ggf. steilere Lernkurve bei Databricks-spezifischen Features |
|
Datenvisualisierung |
Begrenzte integrierte Visualisierung |
Eingebaute Visualisierung im Notebook |
|
Clustermanagement |
Spark-Sessions und Abhängigkeiten manuell verwalten |
Automatisches Clustermanagement und -skalierung durch die Plattform |
|
Anwendungsfälle |
Vielseitig für diverse Data-Science-Aufgaben |
Spezialisiert für kollaborative Big-Data-Analytics auf Databricks |
Am Ende zählen die Vorteile der Databricks-Notebooks vor allem in bestimmten Use Cases. Wenn du lokal mit einem CSV und Pandas spielst, ist Jupyter die bessere Wahl.
Für Enterprise-Anwendungen kann Databricks als Plattform jedoch die stärkere Option sein.
Dateningestion beschreibt das Importieren von Daten aus diversen Quellen. Databricks unterstützt unter anderem:
und mehr.
Schauen wir uns an, wie du verschiedene Datentypen in Databricks lädst. Starten wir mit lokalen Dateien:
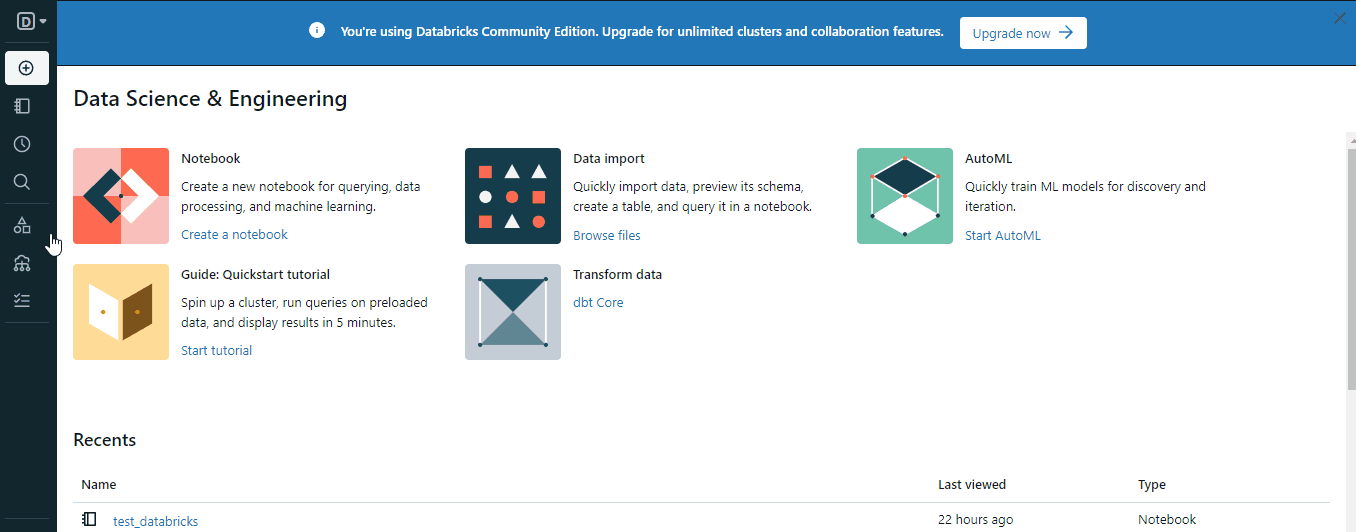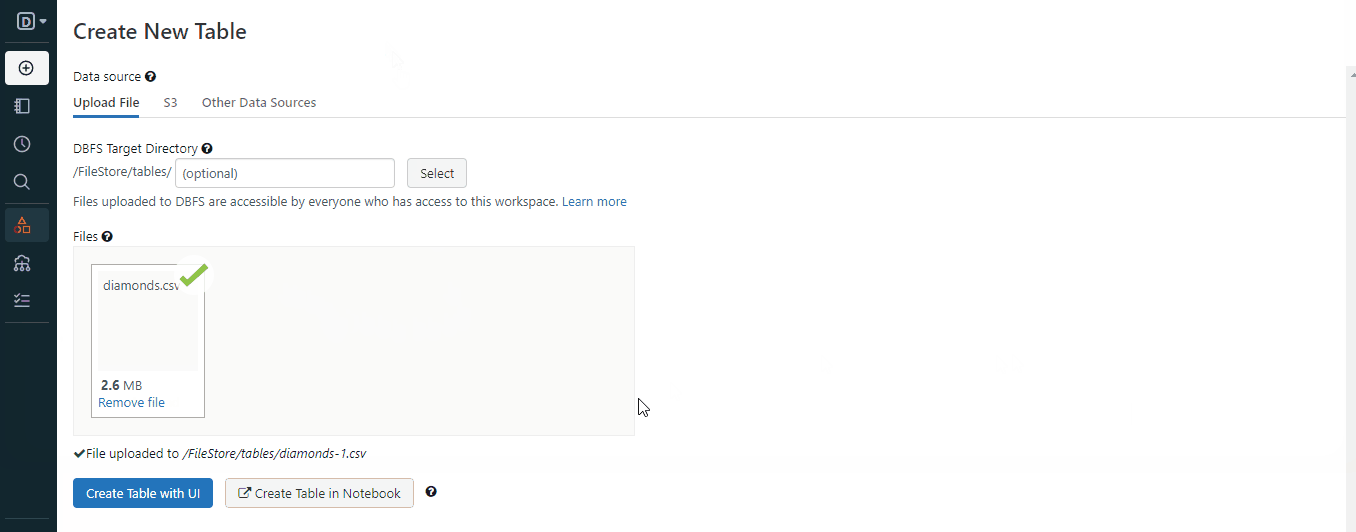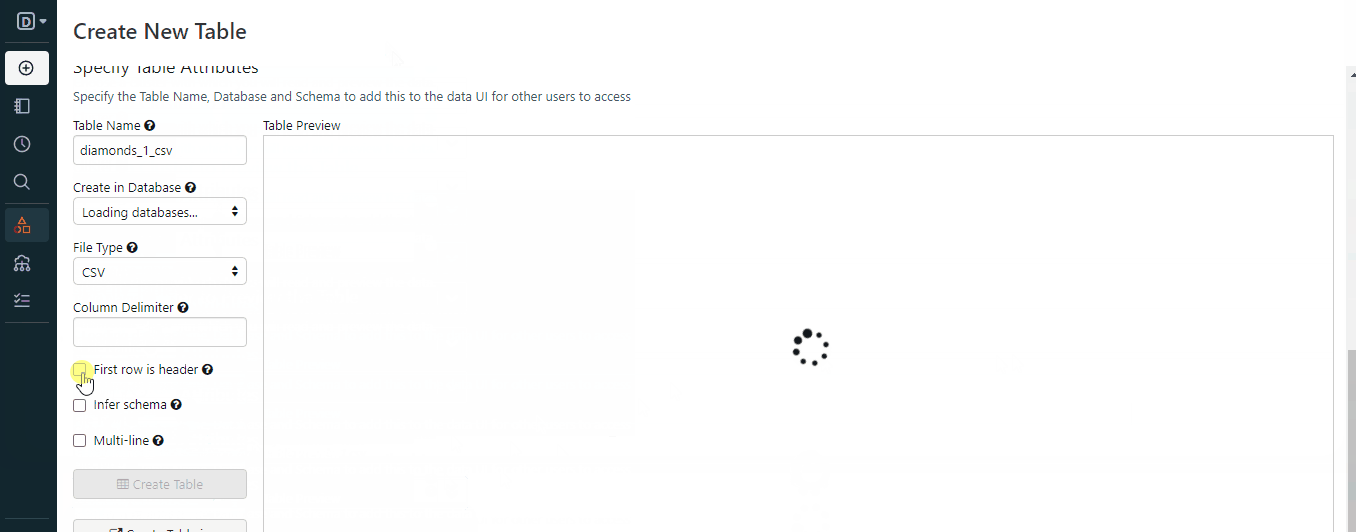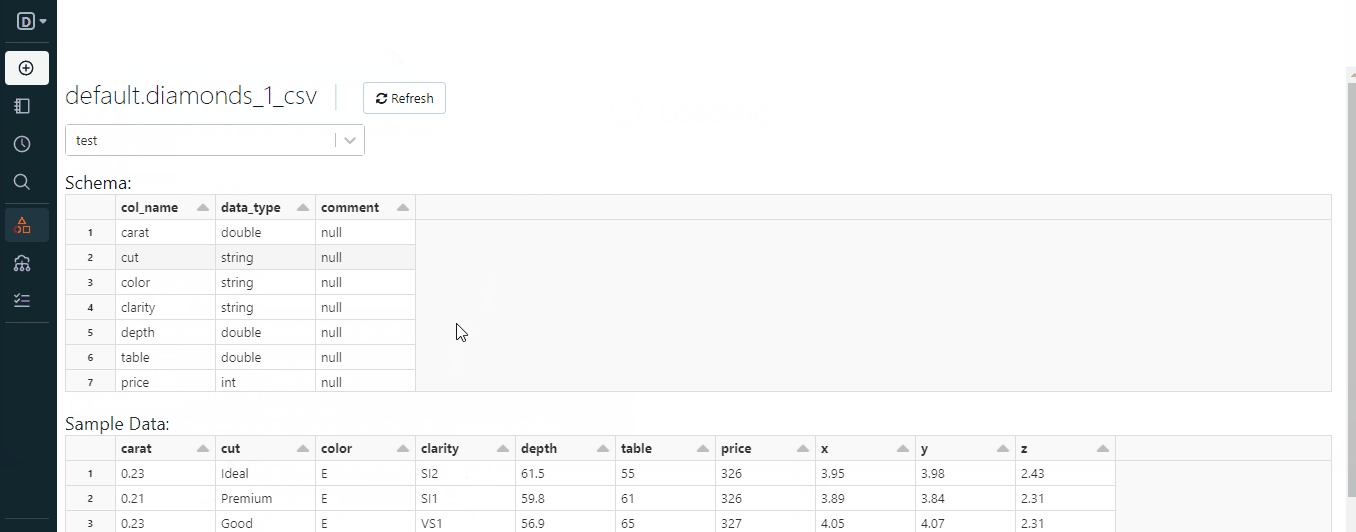
Befolgst du die Schritte im GIF, liegt die Datei im Workspace. So lädst du sie mit Spark:
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the CSV path to the data
path = "dbfs:/FileStore/tables/diamonds.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Achte auf das Präfix dbfs:. Alle Workspace-Dateien benötigen es, damit Spark die Datei korrekt lädt. DBFS steht für Databricks File System.
Der Import aus einem S3-Bucket ist ähnlich (bei Enterprise-Accounts):
# Importing necessary libraries
from pyspark.sql import SparkSession

# Creating a Spark session
spark = SparkSession.builder.appName("S3ImportExample").getOrCreate()

# Defining the S3 path to the data
s3_path = "s3://your-bucket/your-data.csv"

# Reading data from S3 into a DataFrame
data_from_s3 = spark.read.csv(s3_path, header=True, inferSchema=True)

# Displaying the imported data
data_from_s3.show()
Für weitere Datentypen findest du Infos in den Bereichen Data Engineering und Connect to data sources der Databricks-Dokumentation.
Beim Upload der Datei diamonds.csv wurde daraus eine Databricks-Tabelle in einer Datenbank namens default:
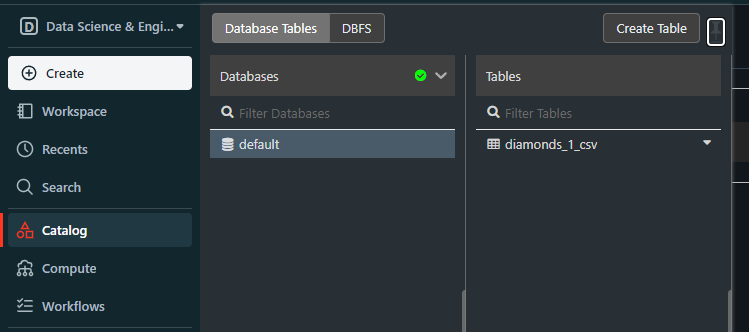
Diese Datenbank default wird erstellt, wenn wir strukturierte Dateien laden, ohne zuvor eine Datenbank anzulegen.
Wenn es eine Datenbank gibt, können wir sie auch mit SQL abfragen, nicht nur mit Spark. Erstelle dazu ein neues Notebook oder wechsele die Sprache des aktuellen Notebooks auf SQL. Dann probiere diesen Snippet:
SELECT * FROM default.diamonds_1_csv
LIMIT 5;
Du solltest die ersten fünf Zeilen der Diamonds-Tabelle erhalten:
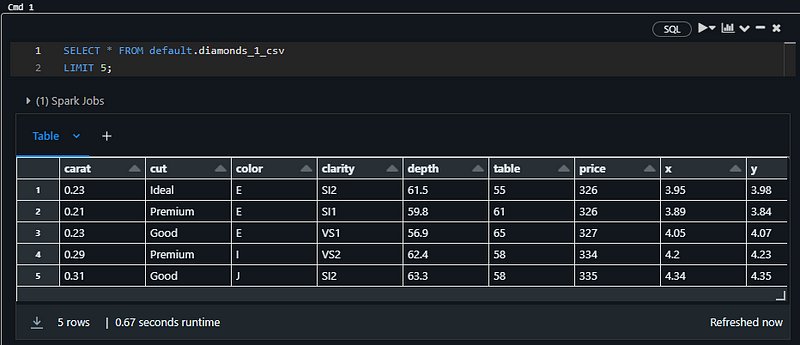
Hinweis: Ich verwende für den obigen Snippet ein SQL-Notebook.
Du kannst diese Tabelle auch in Pandas laden. Füge im selben Notebook diesen Snippet ein:
%python
# Import the necessary libraries
import pandas as pd

# Assuming 'default' is the database name and 'diamonds' is the table name
# Use the spark.sql function to query the table and retrieve the data
table_df = spark.sql("SELECT * FROM default.diamonds_1_csv")

# Convert the Spark DataFrame to a Pandas DataFrame
pandas_df = table_df.toPandas()

# Display the Pandas DataFrame
pandas_df.head()
Das gibt den Kopf der Tabelle aus:
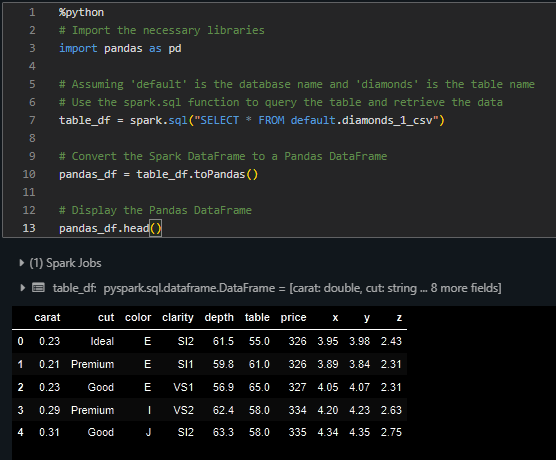
Jetzt kannst du mit SQL und Pandas alle üblichen Analyseschritte auf der Tabelle ausführen.
Mit dem schlanken Community-Edition-Account haben wir schon viel gelernt und ausprobiert. Um weiter einzusteigen, nutze zuerst die zweiwöchige kostenlose Testphase für Premium-Accounts bei Databricks.
Anschließend holst du das Maximum aus dem Kurs Introduction to Databricks von DataCamp. Neben dem Account-Setup lernst du dort diese Kernfunktionen von Databricks kennen und übst sie:
Starte heute deine Databricks-Reise!
Kurs
Lernpfad
Lernpfad