
{count, plural, one {Program} other {Program}}
Pengembangan Model Bahasa Besar
{hours} jam
Sebuah model open-source mengungguli GPT-5 dan Claude Sonnet 4.5 pada benchmark utama dengan biaya yang jauh lebih rendah. Model itu adalah Kimi K2 Thinking, varian penalaran dari Moonshot AI, dirilis pada November 2025.
Kimi K2 Thinking dapat mengeksekusi 200–300 pemanggilan tool berurutan secara otonom, menjadikannya ideal untuk alur kerja agen kompleks. Ia juga menampilkan proses penalarannya melalui field API khusus, sehingga Anda dapat melihat persis bagaimana ia menalar suatu masalah.
Tutorial ini menunjukkan cara menggunakan API Kimi K2 Thinking untuk tugas penalaran. Anda akan mengimplementasikan alur kerja pemanggilan tool, membangun aplikasi chat perbandingan untuk menguji K2 melawan GPT-5 dan Claude, serta mempelajari kapan kekuatan K2 menjadikannya pilihan yang lebih baik. Jika Anda ingin mempelajari lebih jauh tentang membangun aplikasi dengan LLM, saya merekomendasikan kursus Developing LLM Applications with LangChain. Anda juga bisa melihat proyek kami lainnya tentang GPT-5.1-Codex dan Qwen3-Max-Thinking. Saya juga merekomendasikan panduan kami untuk Kimi K2.5 dengan Agent Swarm.
Berikut adalah pratinjau aplikasinya:
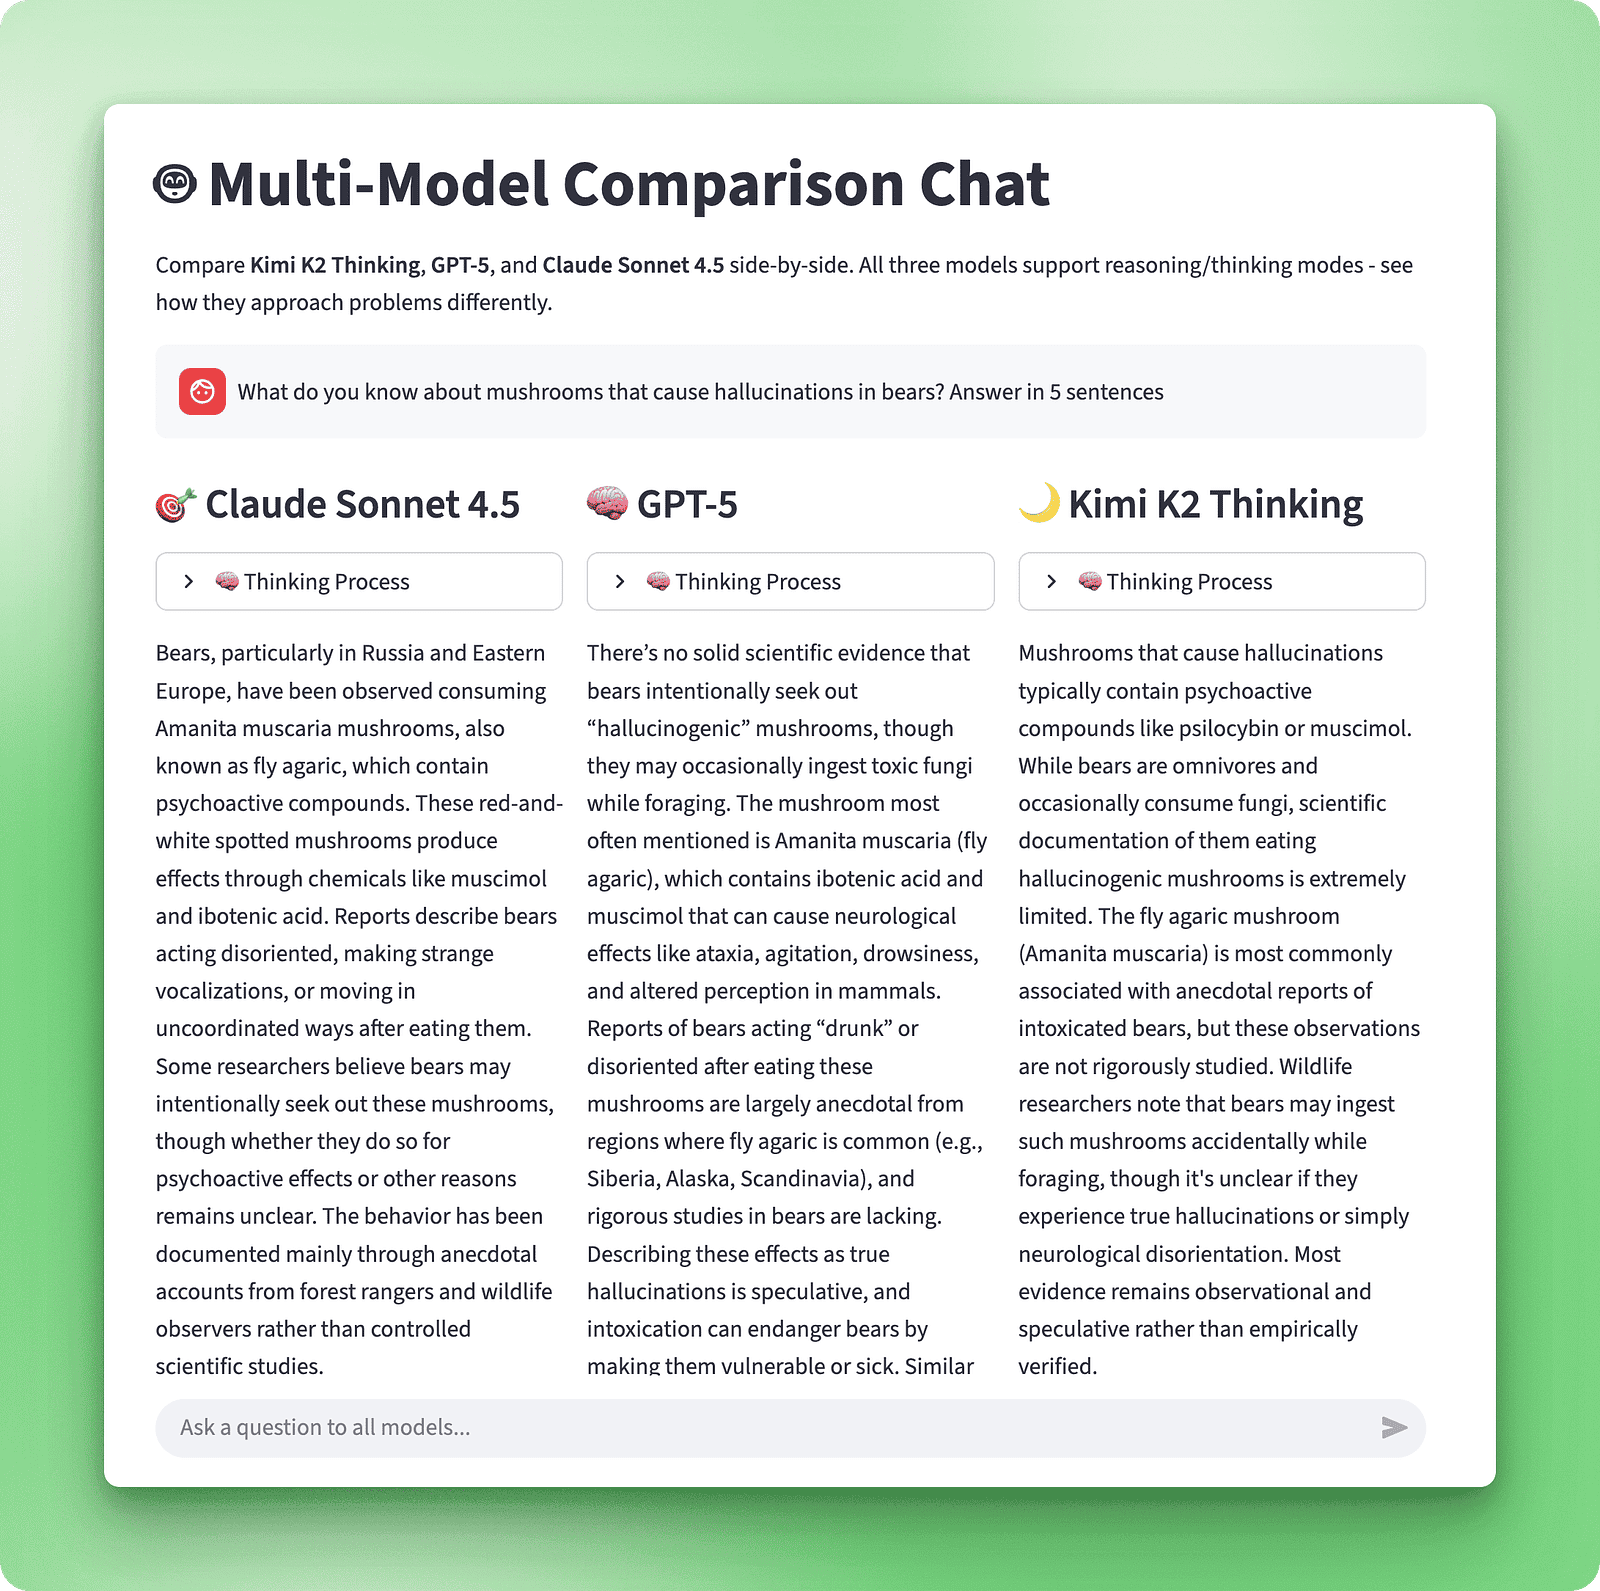
Sebelum masuk ke praktik, mari pahami apa yang membuat K2 Thinking berbeda dari model bahasa tradisional.
Kebanyakan model bahasa langsung menghasilkan respons. K2 Thinking bekerja secara berbeda. Ia dibangun untuk masalah multi-langkah di mana model perlu merencanakan, menalar, dan bertindak sendiri.
Model ini menggunakan arsitektur Mixture-of-Experts (MoE) dengan total 1 triliun parameter. Hanya 32 miliar yang aktif untuk setiap input. Ini memberi K2 kekuatan model besar tanpa biaya inferensi tinggi. Jendela konteks 256.000 token berarti Anda dapat memasukkan seluruh basis kode, dokumen panjang, atau riwayat percakapan ekstensif tanpa melakukan chunking.
Moonshot AI merilis dua versi. K2 Instruct menangani tugas langsung seperti pembuatan teks, klasifikasi, dan tanya jawab sederhana, di mana kecepatan penting. K2 Thinking ditujukan untuk tugas penalaran kompleks.
Fitur utama pertama K2 Thinking adalah penalaran yang transparan. Anda dapat melihat bagaimana ia memecah masalah, mengevaluasi opsi, dan sampai pada kesimpulan.
Yang kedua adalah orkestrasi tool. K2 menangani pemanggilan tool berurutan yang luas, jauh melampaui kebanyakan model. Ia memutuskan tool mana yang digunakan, kapan digunakan, dan bagaimana menggabungkan hasilnya tanpa Anda turun tangan di setiap tahap.
K2 mencakup fitur untuk kebutuhan deployment yang berbeda. Untuk skenario produksi di mana akurasi kritis, Heavy Mode menjalankan delapan jalur penalaran secara paralel dan memilih jawaban terbaik, meski dengan biaya komputasi lebih tinggi.
Untuk aplikasi sensitif latensi, kuantisasi INT4 menggandakan kecepatan inferensi dengan kehilangan akurasi minimal, sehingga praktis untuk lingkungan ber-throughput tinggi.
Berikut perbandingan K2 dengan GPT-5, Claude Sonnet 4.5, dan DeepSeek V3.2.
|
Metrik |
Kimi K2 Thinking |
GPT-5 (Tinggi) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (dgn tools) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (dgn python) |
99.1 % |
99.6 % |
100 % |
58.1 % |
|
GPQA |
84.5 |
85.7 |
83.4 |
79.9 |
|
BrowseComp |
60.2 |
54.9 |
24.1 |
40.1 |
|
Frames |
87 |
86 |
85 |
80.2 |
|
SWE-bench Verified |
71.3 % |
74.9 % |
77.2 % |
67.8 % |
|
LiveCodeBench |
83.1 % |
87.0 % |
64.0 % |
74.1 % |
|
Jendela konteks |
256 k token |
400 k token |
200 k token |
128 k token |
|
Harga input |
$0.60 / 1 M |
$1.25 / 1 M |
$3.00 / 1 M |
$0.55 / 1 M |
|
Harga output |
$2.50 / 1 M |
$10.00 / 1 M |
$15.00 / 1 M |
$2.19 / 1 M |
|
Maks pemanggilan tool |
200–300 |
Puluhan + |
Puluhan + |
Tidak ditentukan |
Definisi benchmark cepat: HLE menguji pengetahuan tingkat pascasarjana, AIME25 menggunakan soal matematika kompetisi, BrowseComp dan Frames menguji navigasi web dan sintesis, SWE-bench Verified mengukur perbaikan bug pada kode open-source, LiveCodeBench menguji pembuatan kode, dan GPQA mencakup pertanyaan sains tingkat pascasarjana.
Pelatihan tool K2 tampak paling jelas pada benchmark agen. Heavy Mode mengungguli GPT-5 sebesar 9 poin pada HLE karena menjalankan delapan jalur penalaran secara paralel. Pelatihan kode Claude memberinya keunggulan pada SWE-bench Verified, menjadikannya pilihan utama untuk proyek rekayasa perangkat lunak.
Pada tugas penalaran murni, ketiga model berperforma kurang lebih sama. Perbedaan muncul ketika tool terlibat. Kapasitas 200–300 pemanggilan tool pada K2 memungkinkannya menangani alur kerja riset otonom, pipeline debugging, dan analisis data multi-langkah tanpa Anda turun tangan di setiap tahap.
Anda memiliki dua opsi untuk mengakses K2 Thinking: langsung melalui platform.moonshot.ai milik Moonshot AI, atau melalui OpenRouter, gerbang API terpadu. Kita akan menggunakan OpenRouter karena menyediakan akses ke K2, GPT-5, Claude, dan puluhan model lain dengan satu kunci API. Akses terpadu ini menjadi penting nanti saat Anda membangun aplikasi chat perbandingan. OpenRouter juga menangani rate limiting dan failover secara otomatis, sehingga Anda tidak perlu mengelola banyak akun penyedia.
Pertama, kunjungi openrouter.ai dan buat akun. Anda bisa mendaftar dengan Google atau GitHub. Setelah masuk, buka bagian “Keys” di dasbor dan buat kunci API baru.
OpenRouter menawarkan kredit gratis $5 saat Anda mendaftar, cukup untuk menguji K2 Thinking pada beberapa kueri. Jika Anda membutuhkan lebih banyak kredit, Anda dapat menambahkan metode pembayaran di bagian “Credits”.
Salin kunci API Anda dan simpan di tempat aman. Anda akan membutuhkannya sebentar lagi. Jangan commit kunci ini ke version control atau membagikannya secara publik, karena siapa pun yang memiliki kunci Anda dapat melakukan panggilan API pada akun Anda.
Sekarang mari siapkan lingkungan Python Anda. Anda memerlukan OpenAI Python SDK, yang bekerja dengan API OpenRouter karena mereka mempertahankan kompatibilitas OpenAI. Anda juga memerlukan python-dotenv untuk mengelola kunci API secara aman. Instal kedua paket tersebut:
!pip install openai python-dotenvBuat file .env di direktori proyek Anda dan tambahkan kunci API OpenRouter Anda:
OPENROUTER_API_KEY=your_key_hereJika Anda menggunakan git, tambahkan .env ke file .gitignore agar Anda tidak secara tidak sengaja meng-commit kredensial Anda.
Berikut uji cepat untuk memverifikasi semuanya berfungsi:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
Keluaran:
15 * 24 = **360**Jika Anda melihat jawabannya, semuanya sudah siap.
Sebelumnya, kita menyebutkan penalaran transparan K2. Sekarang mari lihat secara tepat cara mengakses dan menggunakannya di kode Anda. K2 Thinking secara otomatis menampilkan proses penalarannya melalui field API khusus.
Tidak seperti beberapa model lain, di mana Anda perlu mengaktifkan thinking mode secara manual, K2 menyertakan konten penalaran di setiap respons secara default.
Saat Anda melakukan panggilan API ke K2 Thinking, respons berisi dua field. Field content berisi jawaban akhir, dan field reasoning menunjukkan proses penalaran langkah demi langkah. Berikut contoh praktis dengan perhitungan diskon yang memerlukan beberapa langkah:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)Keluaran:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
Proses penalaran (dipotong untuk keterbacaan):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
Field content memberi Anda jawaban bersih yang dilihat pengguna. Field reasoning menunjukkan bagaimana K2 mengerjakan masalah tersebut, yang membantu Anda memahami apakah model benar-benar menalar dengan benar atau hanya kebetulan.
K2 menghasilkan token penalaran selama inferensi, bukan setelahnya. Ini berarti model memikirkan masalah sebelum memberikan jawaban, mirip dengan bagaimana Anda mengerjakan soal matematika di kertas coret-coret sebelum menulis jawaban akhir. Penalaran terjadi secara real-time sebagai bagian dari proses generasi.
Atur temperature=1.0 saat menggunakan K2 Thinking. Suhu yang lebih rendah membatasi eksplorasi penalaran model, yang mengalahkan tujuan Thinking mode. Anda juga menginginkan max_tokens=4096 atau lebih tinggi karena rantai penalaran memakan token sebelum jawaban akhir bahkan dimulai.
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
Sekarang setelah Anda memahami thinking mode, mari jelajahi kemampuan kunci K2 lainnya: pemanggilan tool. Meski banyak model mendukung penggunaan tool dasar, pendekatan K2 berbeda dalam skala dan otonomi.
Pemanggilan tool memungkinkan K2 mengeksekusi fungsi selama penalaran. Anda mendefinisikan tool sebagai skema JSON yang menjelaskan apa yang dilakukan setiap fungsi dan parameter apa yang dibutuhkan. Saat K2 memerlukan data atau komputasi eksternal, ia memanggil tool yang tepat dan menunggu hasil.
Ini menciptakan loop bolak-balik: K2 membaca prompt Anda dan menalarnya. Jika ia membutuhkan tool, ia mengembalikan finish_reason: "tool_calls". Anda mengeksekusi fungsi, mengirim kembali hasil dengan role: "tool", dan K2 melanjutkan. Ini berulang hingga K2 mengembalikan finish_reason: "stop" dengan jawaban akhir.
Skemanya mengikuti format OpenAI dengan nama, deskripsi, dan parameter. K2 membaca ini untuk memahami kapan harus menggunakan setiap tool. Deskripsi yang jelas penting karena membimbing keputusan model.
Mari bangun tool praktis yang menganalisis file CSV, tugas umum data science. Tool ini membaca CSV, mengekstrak informasi kolom, dan mengembalikan statistik ringkas. Ini menunjukkan bagaimana K2 dapat mengakses data eksternal selama penalaran, yang penting untuk aplikasi berbasis data.
Berikut implementasi lengkapnya:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
Skema mendefinisikan sebuah function tool mengikuti format OpenAI. Field description memberi tahu K2 apa yang dilakukan tool dan membimbing keputusannya kapan menggunakannya.
Objek parameters menentukan input: filepath wajib, sementara num_rows opsional dengan nilai default 10. Deskripsi yang jelas membantu K2 memahami kapan tool ini sesuai dengan kebutuhan pengguna.
Implementasinya menangani pemrosesan file sebenarnya:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
Fungsi memvalidasi path file, lalu menggunakan csv.DictReader untuk mengurai data CSV menjadi dictionary dengan nama kolom sebagai kunci. Fungsi membaca num_rows entri pertama, mereset pointer file dengan seek(0), dan menghitung total baris.
Dictionary keluaran mencakup nama kolom, data contoh, jumlah baris, dan ukuran file dalam kilobyte. Penanganan error memastikan tool mengembalikan umpan balik yang berguna jika sesuatu gagal.
Dengan tool yang sudah didefinisikan dan diimplementasikan, Anda memerlukan loop yang menangani percakapan antara K2 dan fungsi Anda. Pemanggilan tool bukan operasi satu kali. K2 mungkin memerlukan beberapa iterasi: memanggil tool, menganalisis hasil, memutuskan apakah tool lain diperlukan, dan mengulang. Ini memerlukan loop yang menangani percakapan bolak-balik hingga K2 mencapai jawaban akhir.
Berikut implementasi lengkapnya dengan contoh nyata:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
Ini menginisialisasi klien OpenAI yang dikonfigurasi untuk API OpenRouter dan membuat daftar pesan awal dengan kueri pengguna tentang analisis gaji karyawan.
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
Loop utama mengirim riwayat percakapan ke K2 beserta tool yang tersedia. Setelah mengekstrak respons asisten dan alasan penyelesaian, tambahkan ke riwayat pesan untuk mempertahankan konteks percakapan.
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
Saat K2 meminta pemanggilan tool, kita mengeksekusi setiap fungsi dengan argumen yang diberikan dan menambahkan hasil kembali ke percakapan dengan nilai tool_call_id yang sesuai. Saat K2 menyelesaikan penalaran dan mengembalikan "stop", kita mencetak jawaban akhir dan keluar dari loop.
Untuk contoh ini, buat file sample_employees.csv dengan data karyawan termasuk kolom nama, departemen, dan gaji. Gunakan sekitar 12 karyawan di departemen Engineering, Marketing, Sales, dan HR untuk pengujian. Saat Anda menjalankan kode ini, K2 biasanya memanggil analyze_csv() dengan num_rows diatur ke 12 atau lebih tinggi untuk memastikan cakupan data lengkap, lalu mengidentifikasi karyawan Engineering dan menghitung gaji rata-rata mereka.
Keluaran:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.
Field tool_call_id pada setiap respons menautkan hasil kembali ke pemanggilan fungsinya. K2 bisa meminta beberapa tool dalam satu respons, jadi masing-masing memerlukan ID untuk pencocokan yang benar. Mempertahankan seluruh riwayat percakapan memberi K2 konteks yang dibutuhkan untuk penalaran yang koheren di seluruh pemanggilan tool.
Setelah Anda nyaman dengan pemanggilan tool dasar, kekuatan nyata K2 menjadi jelas: orkestrasi diperluas. K2 dilatih untuk orkestrasi tool sejak awal, bukan sebagai tambahan. Ini mengubah cara ia menangani tugas multi-langkah. Kebanyakan model mengelola 20–50 pemanggilan tool berurutan sebelum performa menurun. K2 menangani 200–300 sambil mempertahankan penalaran yang koheren.
Kapasitas ini penting untuk alur kerja mandiri di mana model memutuskan, mengumpulkan informasi, memvalidasi hasil, dan beriterasi hingga masalah terpecahkan. Pertimbangkan tugas riset di mana K2 menelusuri basis data, menyilang-rujuk temuan, mengidentifikasi celah, menyempurnakan kueri, dan mensintesis semuanya. Atau pipeline data yang memerlukan validasi di setiap langkah. Atau alur debugging yang menguji beberapa hipotesis.
Jika kasus penggunaan Anda adalah “lakukan tindakan tunggal ini,” kebanyakan model baik-baik saja. Jika “terus bekerja sampai ini terselesaikan,” kapasitas tool K2 yang diperluas menjadi faktor penentu.
Anda telah melihat bagaimana K2 Thinking menangani tugas individual dengan pemanggilan tool dan penalaran transparan. Sekarang mari uji melawan para kompetitornya. Anda akan membangun aplikasi Streamlit yang mengirim kueri ke Kimi K2 Thinking, GPT-5, dan Claude Sonnet 4.5 dengan prompt yang sama sekaligus. Antarmuka menampilkan ketiga respons berdampingan sehingga Anda dapat melihat bagaimana masing-masing model menyelesaikan masalah yang sama.
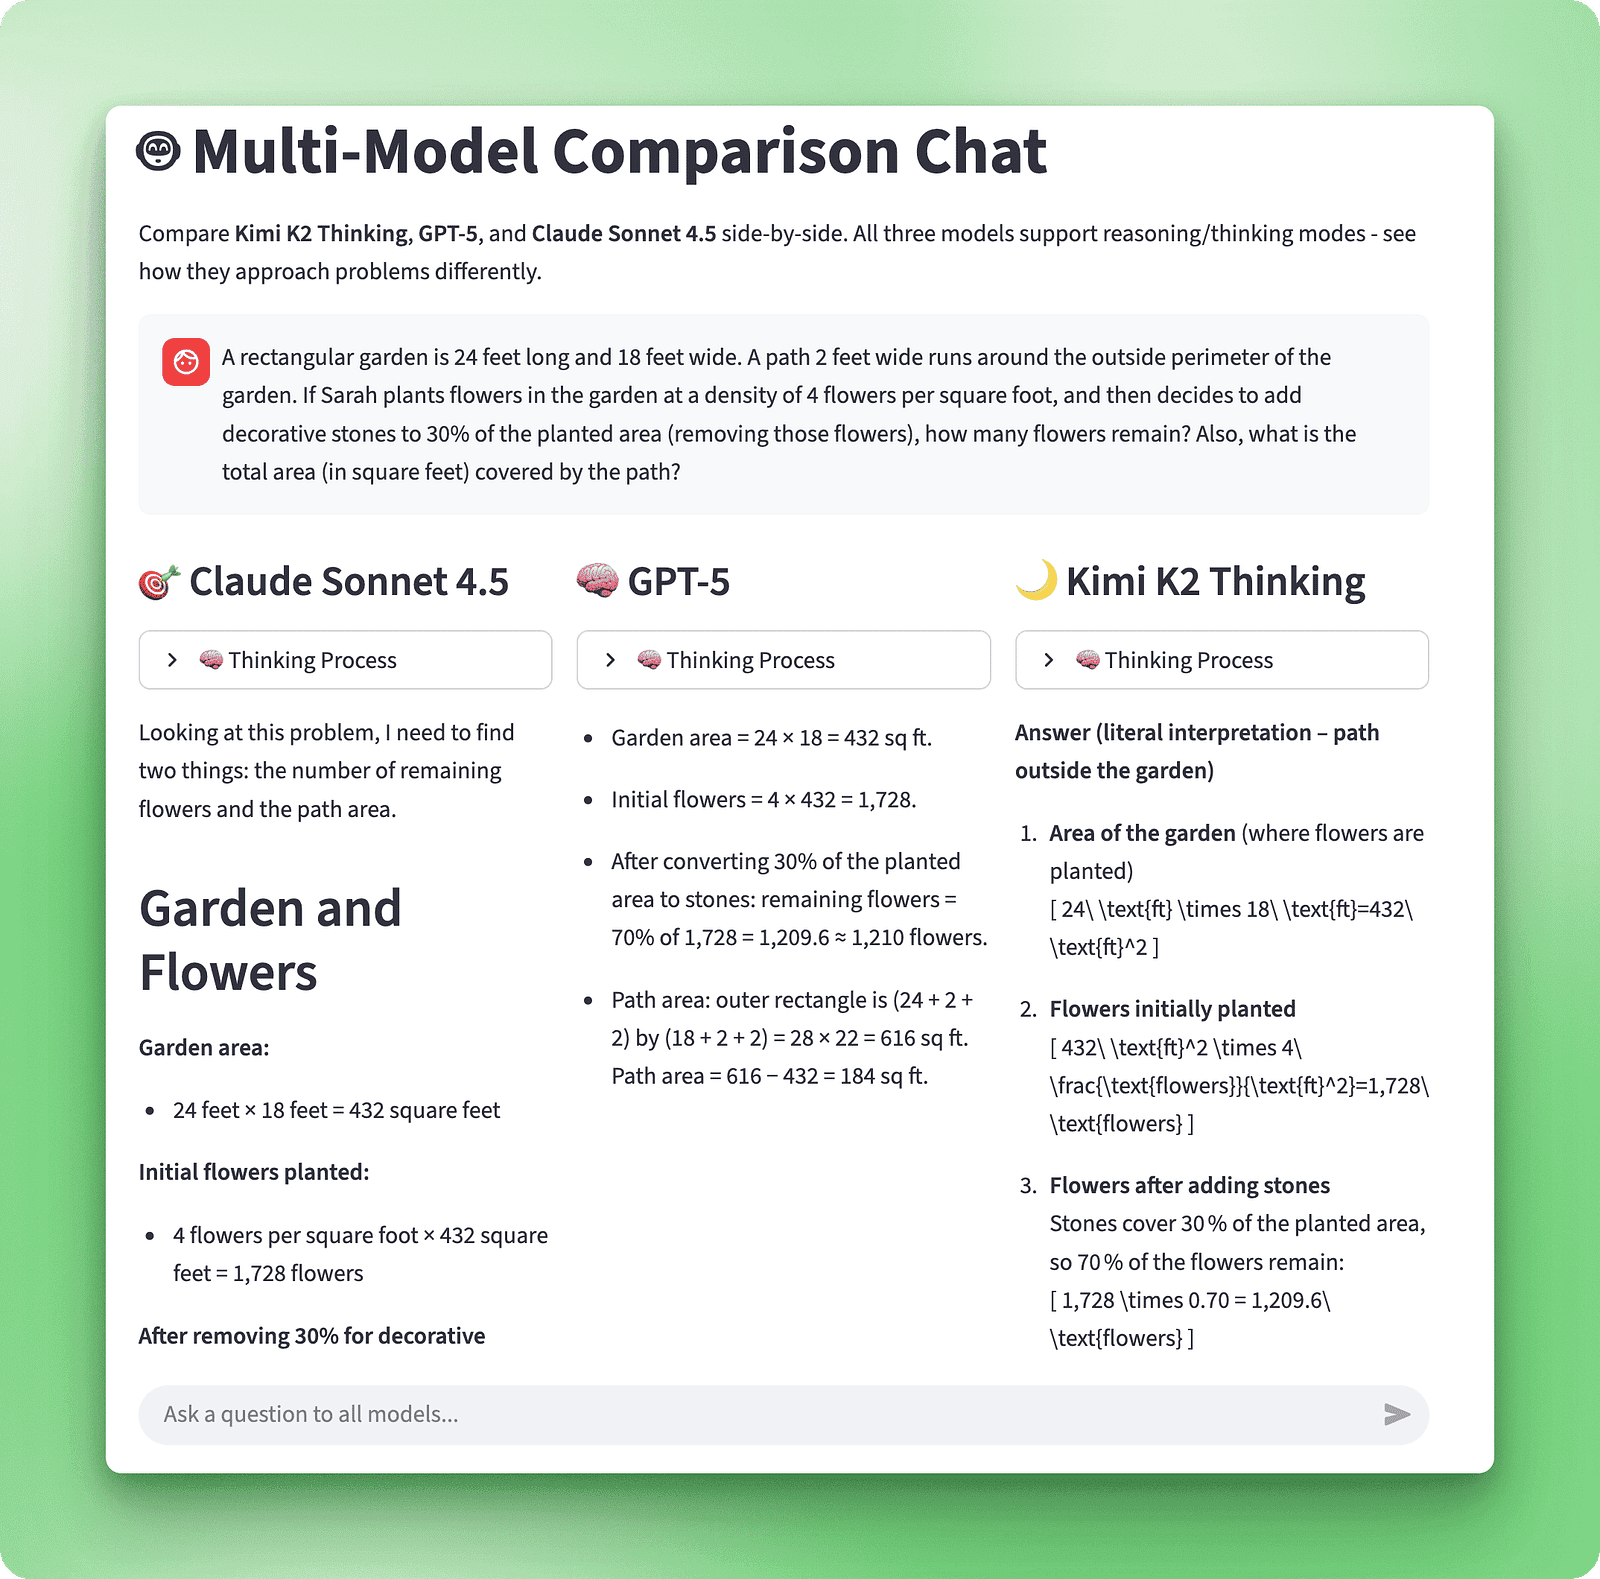
Aplikasi perbandingan ini memerlukan akses API ke ketiga model. Anda memerlukan akun OpenRouter (sudah disiapkan dengan kredit gratis $5), dan opsional kunci API OpenAI dan Anthropic. Kredit $5 di OpenRouter seharusnya cukup untuk menguji ketiga model pada beberapa kueri. Jika Anda hanya memiliki akses OpenRouter, Anda tetap bisa membandingkan K2 dengan model lain yang tersedia melalui OpenRouter.
Instal Streamlit untuk antarmuka web dan SDK Anthropic untuk akses Claude:
pip install streamlit anthropicBuat file bernama model_comparison_chat.py. Seluruh aplikasi berada dalam satu file ini. Mulai dengan impor berikut:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()Anda sudah memiliki OPENROUTER_API_KEY di file .env Anda. Tambahkan kunci untuk GPT-5 dan Claude:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
Dapatkan kunci API OpenAI Anda dari platform.openai.com dan kunci Anthropic dari console.anthropic.com. Untuk detail lebih lanjut tentang penyiapan GPT-5, lihat panduan GPT-5. Untuk Claude Sonnet 4.5, lihat ikhtisar Claude Sonnet 4.5.
Inisialisasi ketiga klien:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))Buat satu fungsi terpadu yang merutekan ke model yang benar berdasarkan nama. Ini membuat kode Anda tetap rapi dan memudahkan menambahkan model lain nanti.
Mulai dengan pemanggilan Kimi K2:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5 menggunakan pendekatan berbeda dengan endpoint responses dan upaya penalaran yang dapat dikonfigurasi:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5 menawarkan empat tingkat upaya penalaran: minimal, rendah, sedang, dan tinggi. Struktur respons memisahkan penalaran ke dalam blok ringkasan dan konten ke dalam blok pesan, yang Anda uraikan secara terpisah sebelum mengembalikan format dictionary standar yang sama seperti Kimi K2.
Claude Sonnet 4.5 mengimplementasikan extended thinking mode dengan pendekatan anggaran token:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude mengalokasikan anggaran token untuk penalaran internal sebelum menghasilkan jawaban akhir. Respons berisi beberapa blok konten yang Anda iterasi, memisahkan blok thinking dari blok teks. Penanganan error di akhir mengembalikan struktur dictionary standar yang sama dengan pesan error, memastikan panggilan API yang gagal tidak merusak antarmuka.
Dengan lapisan API siap, Anda dapat membangun antarmuka web. Konfigurasikan halaman Streamlit terlebih dahulu:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
Tata letak lebar menciptakan ruang untuk tiga kolom berdampingan. Session state mempertahankan riwayat percakapan dan respons model saat Streamlit menjalankan ulang skrip.
Tambahkan judul halaman dan kontrol sidebar:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
Sidebar memberi pengguna kontrol atas thinking mode. Kimi K2 dan Claude memiliki toggle biner. GPT-5 menyediakan empat tingkat penalaran karena API-nya mengekspos kontrol granular ini.
Di bawah kontrol thinking, tambahkan indikator status API agar pengguna tahu layanan mana yang tersambung:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
Tanda centang muncul saat variabel lingkungan disetel. Tanda X merah berarti Anda perlu menambahkan kunci terkait ke file .env Anda.
Sekarang inti fungsionalitasnya. Saat pengguna mengirim pesan, Anda akan memanggil ketiga model secara paralel dan menampilkan hasilnya berdampingan.
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
Fungsi ini mengirim tiga panggilan API sekaligus dan mengumpulkan hasil saat selesai. Panggilan berurutan akan memakan waktu 15–30 detik. Eksekusi paralel memotongnya menjadi 5–10 detik karena Anda hanya menunggu model yang paling lambat alih-alih jumlah dari ketiganya.
Integrasikan eksekusi paralel ke antarmuka chat:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
Ini membuat tiga kolom dan menampilkan respons masing-masing model di kolomnya sendiri. Proses thinking awalnya disembunyikan agar pengguna melihat jawaban akhir terlebih dahulu. Mereka dapat membuka bagian thinking saat ingin memeriksa penalaran.
Jalankan aplikasinya dengan:
streamlit run model_comparison_chat.pyMulai dengan uji dasar untuk mengonfirmasi semuanya berfungsi:
What is 2+2?Ketiga model seharusnya merespons dalam hitungan detik. Ini memverifikasi koneksi API Anda dan memastikan eksekusi paralel berfungsi. Aplikasi berjalan secara lokal, memberi Anda kontrol penuh kapan API dipanggil. Setiap kueri menimbulkan biaya API (sekitar $0,01–0,05 per perbandingan tiga model tergantung panjang respons), tetapi menjalankan secara lokal berarti Anda yang memutuskan kapan mengeluarkan biaya.
Anda telah membangun aplikasi perbandingan dan melihatnya bekerja dengan pertanyaan sederhana. Namun perbedaan nyata antara model-model ini muncul saat Anda mendorong mereka lebih jauh. Untuk menunjukkan perbedaan ini, saya menguji ketiga model dengan prompt kompleks. Anda dapat menjalankan tes yang sama di aplikasi Anda untuk melihat hasilnya secara langsung. Berikut wawasan utama dari pengujian tersebut.
Kami memilih tiga tantangan berbeda untuk menguji kemampuan penalaran yang berbeda.
Sebuah taman berbentuk persegi panjang panjangnya 24 kaki dan lebarnya 18 kaki. Sebuah jalur selebar 2 kaki mengelilingi perimeter luar taman. Jika Sarah menanam bunga di taman dengan kepadatan 4 bunga per kaki persegi, lalu memutuskan menambahkan batu dekoratif pada 30% area yang ditanami (menghapus bunga-bunga tersebut), berapa banyak bunga yang tersisa? Juga, berapa luas total (dalam kaki persegi) yang ditutupi oleh jalur?
Empat teman - Alice, Bob, Carol, dan David - harus mengatur diri mereka dalam satu baris untuk foto. Aturan berikut harus diikuti:
1. Alice harus berdiri di sebelah Bob
2. Carol tidak boleh berdiri di salah satu ujung
3. David harus berdiri di sebelah kiri Alice
Daftarkan semua susunan valid dari kiri ke kanan.
Tulis fungsi Python yang memeriksa apakah sebuah string adalah alamat IPv4 yang valid, dengan persyaratan berikut:
1. Harus memvalidasi format (empat oktet dipisahkan oleh titik)
2. Setiap oktet harus 0-255 (tanpa nol depan kecuali "0" itu sendiri)
3. Harus menolak format tidak valid (string kosong, terlalu banyak/sedikit oktet, karakter non-numerik)
4. Kompleksitas waktu harus O(n) di mana n adalah panjang string
5. Sertakan docstring lengkap dengan contoh
6. Tambahkan type hints untuk semua parameter dan nilai kembalian
7. Tangani kasus tepi (string kosong, None, karakter khusus)
Juga jelaskan pendekatan validasi Anda dan mengapa O(n).
Ketiga model menyelesaikan setiap masalah dengan benar. Namun mereka menempuh jalur yang sangat berbeda untuk mencapainya. Berikut uraian performanya:
|
Tes |
Model |
Waktu (dtk) |
Token |
Hasil |
|
Masalah Taman |
Kimi K2 |
28.5 |
3,420 |
✓ Benar (1.209,6 bunga, 184 ft²) |
|
GPT-5 |
44.6 |
1,476 |
✓ Benar (1.209,6 bunga, 184 ft²) |
|
|
Claude |
19.7 |
1,386 |
✓ Benar (1.210 bunga, 184 ft²) |
|
|
Susunan Foto |
Kimi K2 |
50.5 |
6,249 |
✓ Menemukan semua 2 susunan valid |
|
GPT-5 |
39.4 |
1,914 |
✓ Menemukan semua 2 susunan valid |
|
|
Claude |
31.3 |
2,310 |
✓ Menemukan semua 2 susunan valid |
|
|
Validator IPv4 |
Kimi K2 |
192.6 |
5,245 |
✓ Solusi O(n) yang berfungsi |
|
GPT-5 |
73.7 |
4,233 |
✓ Solusi O(n) yang berfungsi |
|
|
Claude |
43.1 |
3,330 |
✓ Solusi O(n) yang berfungsi |
Berikut apa yang sebenarnya dilakukan masing-masing model selama waktu tersebut.
Model ini terus mengeksplorasi dan mempertanyakan dirinya. Pada masalah taman, ia memvisualisasikan skenario, mengerjakan matematika, lalu berhenti untuk berkata “Tunggu, biarkan saya memeriksa ulang…” sebelum melanjutkan. Untuk susunan foto, ia menguji setiap batasan satu per satu, menunjukkan pekerjaannya untuk setiap kemungkinan.
Validator IPv4 memakan waktu lebih dari 3 menit karena mempertimbangkan kasus tepi satu per satu, menelusuri bukti kompleksitas O(n), dan memverifikasi logika berkali-kali. Anda seolah menonton seseorang berpikir keras, menangkap kesalahan sendiri, dan memverifikasi penalaran di setiap langkah.
Model ini metodis dan terstruktur. Ia memecah masalah taman menjadi bagian-bagian jelas, menomori langkah-langkahnya, dan mengerjakannya berurutan. Susunan foto mendapat penjelasan terstruktur di mana ia menempatkan orang per posisi sambil memeriksa aturan.
Kodenya hadir dengan penjelasan jelas dan dokumentasi yang tertata. Ia tidak terlalu meragukan diri seperti K2, dan tidak terburu-buru seperti Claude. Anda mendapat gambaran penalaran yang seimbang tanpa detail berlebihan.
Model ini bergerak cepat. Ia dengan cepat mengidentifikasi jalur solusi pada setiap tes dan mengeksekusinya dengan bersih. Untuk masalah foto, ia mengorganisasi berdasarkan kasus dan mengerjakan masing-masing tanpa berlama-lama. Kode IPv4 bersih dan terdokumentasi baik, tetapi langsung ke intinya.
Claude menunjukkan penalarannya tetapi tidak berlarut pada langkah verifikasi. Kecepatan berasal dari keyakinan pada pendekatan dan minimnya backtracking.
Pendekatan yang berbeda ini menciptakan pola trade-off yang jelas. Pilih K2 saat Anda memerlukan penalaran terperinci untuk pembelajaran, debugging, atau kebutuhan audit. Pilih Claude saat kecepatan penting dan Anda mempercayai hasil tanpa memeriksa rantai penalaran. Pilih GPT-5 saat Anda menginginkan performa seimbang antara keluwesan K2 dan kecepatan Claude.
Catatan: Ambil hasil uji ini dengan sedikit skeptis karena tidak dapat secara realistis menguji kemampuan ketiga model secara menyeluruh.
Anda telah menyiapkan Kimi K2 Thinking melalui OpenRouter, mengeksplorasi kemampuan penalarannya, membangun alur kerja pemanggilan tool, dan membuat aplikasi perbandingan untuk mengujinya melawan GPT-5 dan Claude. Kekuatan K2 adalah orkestrasi tool mandiri dan penalaran transparan, menjadikannya cocok untuk alur kerja kompleks di mana Anda perlu memverifikasi keputusan model.
Kapasitas dan keterjangkauan K2 membuat ini praktis. Ia dapat mengeksekusi pemanggilan tool berurutan yang ekstensif dibandingkan hanya beberapa lusin pada kebanyakan pesaing, dan field reasoning_content menampilkan setiap langkah pemikiran. Dengan biaya sekitar 1/4 dari GPT-5 dan 1/6 dari Claude untuk token output, Anda dapat menjalankan eksperimen ekstensif tanpa khawatir anggaran.
Aplikasi perbandingan yang Anda bangun memberi bukti langsung mengenai trade-off ini. Uji dengan masalah dan alur kerja Anda sendiri untuk mengembangkan intuisi apakah penalaran terperinci K2 membenarkan waktu respons yang lebih lama. Pengujian dunia nyata pada kasus penggunaan spesifik Anda akan mengungkap pola yang tidak dapat ditangkap oleh benchmark generik.
Untuk memperluas konsep ini, lihat tutorial OpenRouter dari DataCamp untuk mengelola banyak penyedia LLM, panduan GPT-5 untuk tingkat upaya penalaran, dan panduan Claude Sonnet 4 untuk extended thinking mode.
Kursus Teratas DataCamp
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt



