50 % de descuento en DataCamp Premium. Más de 700 cursos a mitad de precio. Empieza a aprender hoy.
Un modelo de código abierto supera a GPT-5 y Claude Sonnet 4.5 en los principales benchmarks por una fracción del coste. Ese modelo es Kimi K2 Thinking, la variante de razonamiento de Moonshot AI, lanzada en noviembre de 2025.
Kimi K2 Thinking puede ejecutar de 200 a 300 llamadas a herramientas de forma secuencial y autónoma, lo que lo hace ideal para flujos de trabajo agentivos complejos. Además, expone su proceso de razonamiento mediante un campo específico de la API, para que puedas ver exactamente cómo llega a las soluciones.
Este tutorial te muestra cómo usar la API de Kimi K2 Thinking para tareas de razonamiento. Implementarás flujos con llamadas a herramientas, crearás una app de chat comparativa para probar K2 frente a GPT-5 y Claude, y aprenderás cuándo las fortalezas de K2 lo convierten en la mejor opción. Si te interesa seguir aprendiendo a crear apps con LLMs, te recomiendo el curso Developing LLM Applications with LangChain. También puedes echar un vistazo a otros proyectos sobre GPT-5.1-Codex y Qwen3-Max-Thinking. Además, te recomendamos nuestra guía del nuevo Kimi K2.5 con Agent Swarm.
Aquí tienes una vista previa de la app:
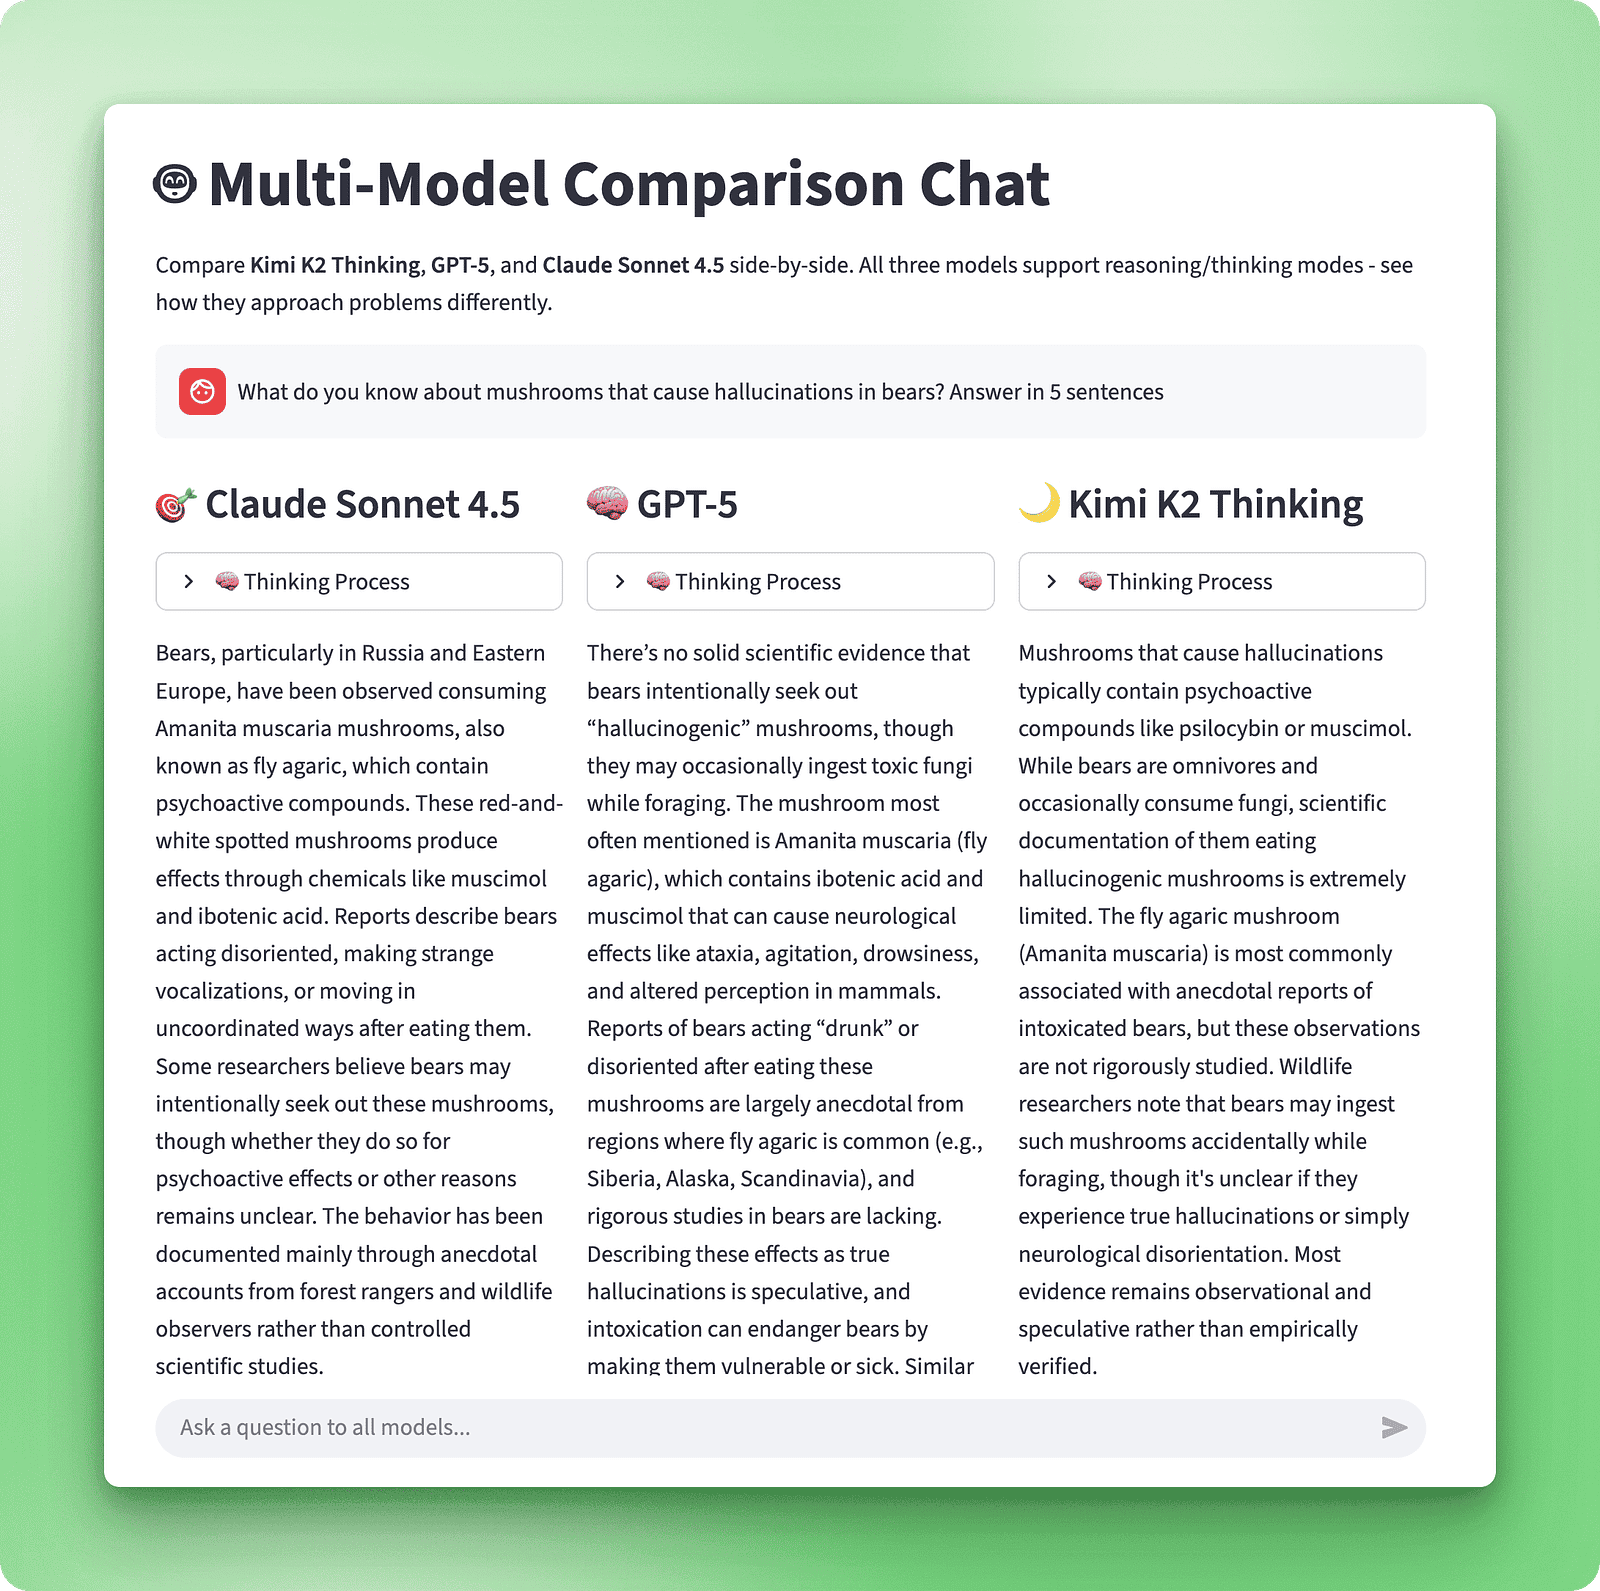
Antes de ponernos manos a la obra, veamos qué hace diferente a K2 Thinking frente a los modelos de lenguaje tradicionales.
La mayoría de modelos generan respuestas al instante. K2 Thinking funciona de otra manera. Está diseñado para problemas de varios pasos en los que el modelo necesita planificar, razonar y actuar por su cuenta.
El modelo utiliza una arquitectura Mixture-of-Experts (MoE) con 1 billón de parámetros totales. Solo 32.000 millones se activan para cualquier entrada. Así, K2 obtiene la potencia de un modelo masivo sin los altos costes de inferencia. Su ventana de contexto de 256.000 tokens te permite pasarle bases de código completas, documentos largos o historiales de conversación extensos sin tener que fragmentarlos.
Moonshot AI publicó dos versiones. K2 Instruct se ocupa de tareas directas como generación de texto, clasificación y preguntas y respuestas sencillas, donde prima la velocidad. K2 Thinking está pensado para tareas de razonamiento complejas.
La primera gran función de K2 Thinking es el razonamiento transparente. Puedes ver cómo descompone problemas, evalúa opciones y llega a conclusiones.
La segunda es la orquestación de herramientas. K2 gestiona llamadas secuenciales a herramientas a gran escala, mucho más allá de lo que suele manejar la mayoría de modelos. Decide qué herramientas usar, cuándo usarlas y cómo combinar los resultados sin que tengas que intervenir en cada paso.
K2 incorpora opciones para distintos despliegues. En producción, cuando la precisión es crítica, Heavy Mode ejecuta ocho rutas de razonamiento en paralelo y selecciona la mejor respuesta, aunque con un mayor coste computacional.
Para aplicaciones sensibles a la latencia, la cuantización INT4 duplica la velocidad de inferencia con una pérdida mínima de precisión, lo que la hace práctica en entornos de alto rendimiento.
Así se compara K2 con GPT-5, Claude Sonnet 4.5 y DeepSeek V3.2.
|
Métrica |
Kimi K2 Thinking |
GPT-5 (High) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (c/ herramientas) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (c/ python) |
99.1 % |
99.6 % |
100 % |
58.1 % |
|
GPQA |
84.5 |
85.7 |
83.4 |
79.9 |
|
BrowseComp |
60.2 |
54.9 |
24.1 |
40.1 |
|
Frames |
87 |
86 |
85 |
80.2 |
|
SWE-bench Verified |
71.3 % |
74.9 % |
77.2 % |
67.8 % |
|
LiveCodeBench |
83.1 % |
87.0 % |
64.0 % |
74.1 % |
|
Ventana de contexto |
256 k tokens |
400 k tokens |
200 k tokens |
128 k tokens |
|
Precio de entrada |
$0.60 / 1 M |
$1.25 / 1 M |
$3.00 / 1 M |
$0.55 / 1 M |
|
Precio de salida |
$2.50 / 1 M |
$10.00 / 1 M |
$15.00 / 1 M |
$2.19 / 1 M |
|
Llamadas máximas a herramientas |
200–300 |
Decenas + |
Decenas + |
No especificado |
Definiciones rápidas de benchmarks: HLE evalúa conocimientos de posgrado; AIME25 usa problemas de matemáticas de competición; BrowseComp y Frames prueban navegación web y síntesis; SWE-bench Verified mide corrección de bugs en código open source; LiveCodeBench evalúa generación de código; y GPQA cubre preguntas científicas de posgrado.
La formación de K2 en uso de herramientas destaca sobre todo en benchmarks agentivos. Heavy Mode supera a GPT-5 en 9 puntos en HLE porque ejecuta ocho rutas de razonamiento en paralelo. El entrenamiento de Claude en código le da ventaja en SWE-bench Verified, siendo la mejor opción para proyectos de ingeniería de software.
En tareas de razonamiento puro, los tres modelos rinden de forma similar. Las diferencias aparecen cuando entran en juego las herramientas. La capacidad de K2 para hacer 200–300 llamadas le permite encargarse de investigaciones autónomas, pipelines de depuración y análisis de datos de múltiples pasos sin que tengas que intervenir en cada fase.
Tienes dos opciones para acceder a K2 Thinking: directamente a través de la platform.moonshot.ai de Moonshot AI, o mediante OpenRouter, una pasarela de API unificada. Usaremos OpenRouter porque te da acceso a K2, GPT-5, Claude y decenas de modelos más con una sola clave de API. Este acceso unificado será clave más adelante cuando construyas la app comparativa. OpenRouter también gestiona automáticamente el rate limiting y el failover, así que no tendrás que manejar múltiples cuentas de proveedores.
Primero, entra en openrouter.ai y crea una cuenta. Puedes registrarte con Google o GitHub. Una vez dentro, ve a la sección “Keys” del panel y genera una nueva clave de API.
OpenRouter ofrece 5 $ en créditos gratuitos al registrarte, suficiente para probar K2 Thinking con varias consultas. Si necesitas más créditos, puedes añadir un método de pago en la sección “Credits”.
Copia tu clave de API y guárdala en un lugar seguro. La necesitarás enseguida. No subas esta clave al control de versiones ni la compartas públicamente, ya que cualquiera con tu clave podría hacer llamadas a la API con tu cuenta.
Ahora configuremos tu entorno de Python. Necesitarás el SDK de Python de OpenAI, que es compatible con la API de OpenRouter porque mantienen compatibilidad con OpenAI. También querrás python-dotenv para gestionar tu clave de API de forma segura. Instala ambos paquetes:
!pip install openai python-dotenvCrea un archivo .env en el directorio de tu proyecto y añade tu clave de API de OpenRouter:
OPENROUTER_API_KEY=your_key_hereSi usas git, añade .env a tu archivo .gitignore para no subir por accidente tus credenciales.
Aquí tienes una prueba rápida para verificar que todo funciona:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
Salida:
15 * 24 = **360**Si ves la respuesta, ya lo tienes listo.
Antes mencionamos el razonamiento transparente de K2. Ahora veamos exactamente cómo acceder a él y usarlo en tu código. K2 Thinking expone automáticamente su proceso de razonamiento mediante un campo específico de la API.
A diferencia de otros modelos, en los que hay que activar el modo de razonamiento manualmente, K2 incluye el contenido de razonamiento en todas sus respuestas por defecto.
Cuando haces una llamada a la API de K2 Thinking, la respuesta contiene dos campos. El campo content contiene la respuesta final, y el campo reasoning muestra el proceso de pensamiento paso a paso. Aquí tienes un ejemplo práctico con un cálculo de descuento que requiere varios pasos:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)Salida:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
Proceso de razonamiento (truncado por legibilidad):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
El campo content te da la respuesta limpia que verán tus usuarios. El campo reasoning muestra cómo K2 trabajó el problema, lo que te ayuda a entender si realmente razonó bien o simplemente acertó por casualidad.
K2 genera los tokens de razonamiento durante la inferencia, no después. Esto significa que el modelo piensa el problema antes de comprometer una respuesta, igual que harías tú con una operación en un papel antes de escribir el resultado final. El razonamiento ocurre en tiempo real como parte del proceso de generación.
Usa temperature=1.0 con K2 Thinking. Temperaturas más bajas restringen la exploración de razonamiento del modelo, lo que va en contra del objetivo del modo Thinking. También conviene max_tokens=4096 o más, ya que las cadenas de razonamiento consumen tokens antes incluso de empezar la respuesta final.
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
Ahora que entiendes el modo de razonamiento, veamos la otra capacidad clave de K2: las llamadas a herramientas. Aunque muchos modelos admiten el uso básico de herramientas, el enfoque de K2 destaca por su escala y autonomía.
Las llamadas a herramientas permiten a K2 ejecutar funciones durante el razonamiento. Defines herramientas como esquemas JSON que describen qué hace cada función y qué parámetros necesita. Cuando K2 requiere datos o cálculos externos, invoca la herramienta adecuada y espera los resultados.
Esto crea un bucle de ida y vuelta: K2 lee tu prompt y razona sobre él. Si necesita una herramienta, devuelve finish_reason: "tool_calls". Tú ejecutas la función, envías los resultados con role: "tool", y K2 continúa. Esto se repite hasta que K2 devuelve finish_reason: "stop" con la respuesta final.
El esquema sigue el formato de OpenAI con nombre, descripción y parámetros. K2 los lee para entender cuándo usar cada herramienta. Las descripciones claras importan porque guían las decisiones del modelo.
Construyamos una herramienta práctica que analice archivos CSV, una tarea común en ciencia de datos. Esta herramienta lee un CSV, extrae información de columnas y devuelve estadísticas resumidas. Demuestra cómo K2 puede acceder a datos externos durante el razonamiento, algo esencial para aplicaciones basadas en datos.
Aquí tienes la implementación completa:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
El esquema define una herramienta de tipo función siguiendo el formato de OpenAI. El campo description le indica a K2 qué hace la herramienta y guía su decisión de cuándo usarla.
El objeto parameters especifica las entradas: filepath es obligatoria, mientras que num_rows es opcional con valor por defecto 10. Descripciones claras ayudan a K2 a entender cuándo esta herramienta encaja con lo que pide el usuario.
La implementación se encarga del procesado real del archivo:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
La función valida la ruta del archivo y usa csv.DictReader para convertir el CSV en diccionarios donde las claves son los nombres de columna. Lee las primeras num_rows filas, reinicia el puntero con seek(0) y cuenta las filas totales.
El diccionario de retorno incluye nombres de columnas, datos de muestra, recuento de filas y tamaño del archivo en kilobytes. El control de errores garantiza que la herramienta devuelva información útil si algo falla.
Con tu herramienta definida e implementada, necesitas un bucle que gestione la conversación entre K2 y tus funciones. Las llamadas a herramientas no son de un solo disparo. K2 puede necesitar varias iteraciones: llamar a una herramienta, analizar resultados, decidir si hace falta otra, y repetir. Esto requiere un bucle que gestione el ida y vuelta hasta que K2 llegue a su respuesta final.
Aquí tienes la implementación completa con un ejemplo real:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
Esto inicializa el cliente de OpenAI configurado para la API de OpenRouter y crea la lista de mensajes inicial con la consulta del usuario sobre el análisis de salarios.
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
El bucle principal envía el historial de la conversación a K2 junto a las herramientas disponibles. Tras extraer la respuesta del asistente y la razón de finalización, la añadimos al historial para mantener el contexto.
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
Cuando K2 solicita llamadas a herramientas, ejecutamos cada función con los argumentos proporcionados y devolvemos los resultados a la conversación con los valores tool_call_id correspondientes. Cuando K2 termina de razonar y devuelve "stop", imprimimos la respuesta final y salimos del bucle.
Para este ejemplo, crea un archivo sample_employees.csv con datos de empleados incluyendo nombre, departamento y salario. Usa unas 12 personas en los departamentos de Engineering, Marketing, Sales y HR para las pruebas. Al ejecutar el código, K2 suele llamar a analyze_csv() con num_rows establecido en 12 o más para cubrir todos los datos, luego identifica a los empleados de Engineering y calcula su salario medio.
Salida:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.
El tool_call_id de cada respuesta vincula los resultados a sus llamadas de función. K2 puede solicitar varias herramientas en una misma respuesta, así que cada una necesita su ID para emparejarse correctamente. Mantener el historial completo de la conversación le da a K2 el contexto que necesita para razonar con coherencia a lo largo de las llamadas.
Una vez domines el uso básico de herramientas, se aprecia la verdadera fortaleza de K2: la orquestación extendida. K2 se entrenó desde el principio para orquestar herramientas, no como un añadido. Esto cambia cómo gestiona tareas de múltiples pasos. La mayoría de modelos manejan 20–50 llamadas secuenciales antes de degradarse. K2 maneja 200–300 manteniendo un razonamiento coherente.
Esta capacidad importa en flujos independientes donde el modelo decide, recopila información, valida resultados e itera hasta resolver el problema. Piensa en tareas de investigación donde K2 busca en bases de datos, coteja hallazgos, identifica lagunas, refina consultas y sintetiza todo. O en pipelines de datos que necesitan validación en cada paso. O en flujos de depuración que prueban múltiples hipótesis.
Si tu caso de uso es “haz esta única acción”, la mayoría de modelos sirven. Si es “sigue trabajando hasta resolver esto”, la capacidad extendida de K2 para usar herramientas es el factor decisivo.
Ya has visto cómo K2 Thinking gestiona tareas individuales con llamadas a herramientas y razonamiento transparente. Ahora pongámoslo a prueba frente a sus competidores. Construirás una app con Streamlit que consulte a Kimi K2 Thinking, GPT-5 y Claude Sonnet 4.5 con el mismo prompt a la vez. La interfaz muestra las tres respuestas en paralelo para comparar cómo aborda cada modelo el mismo problema.
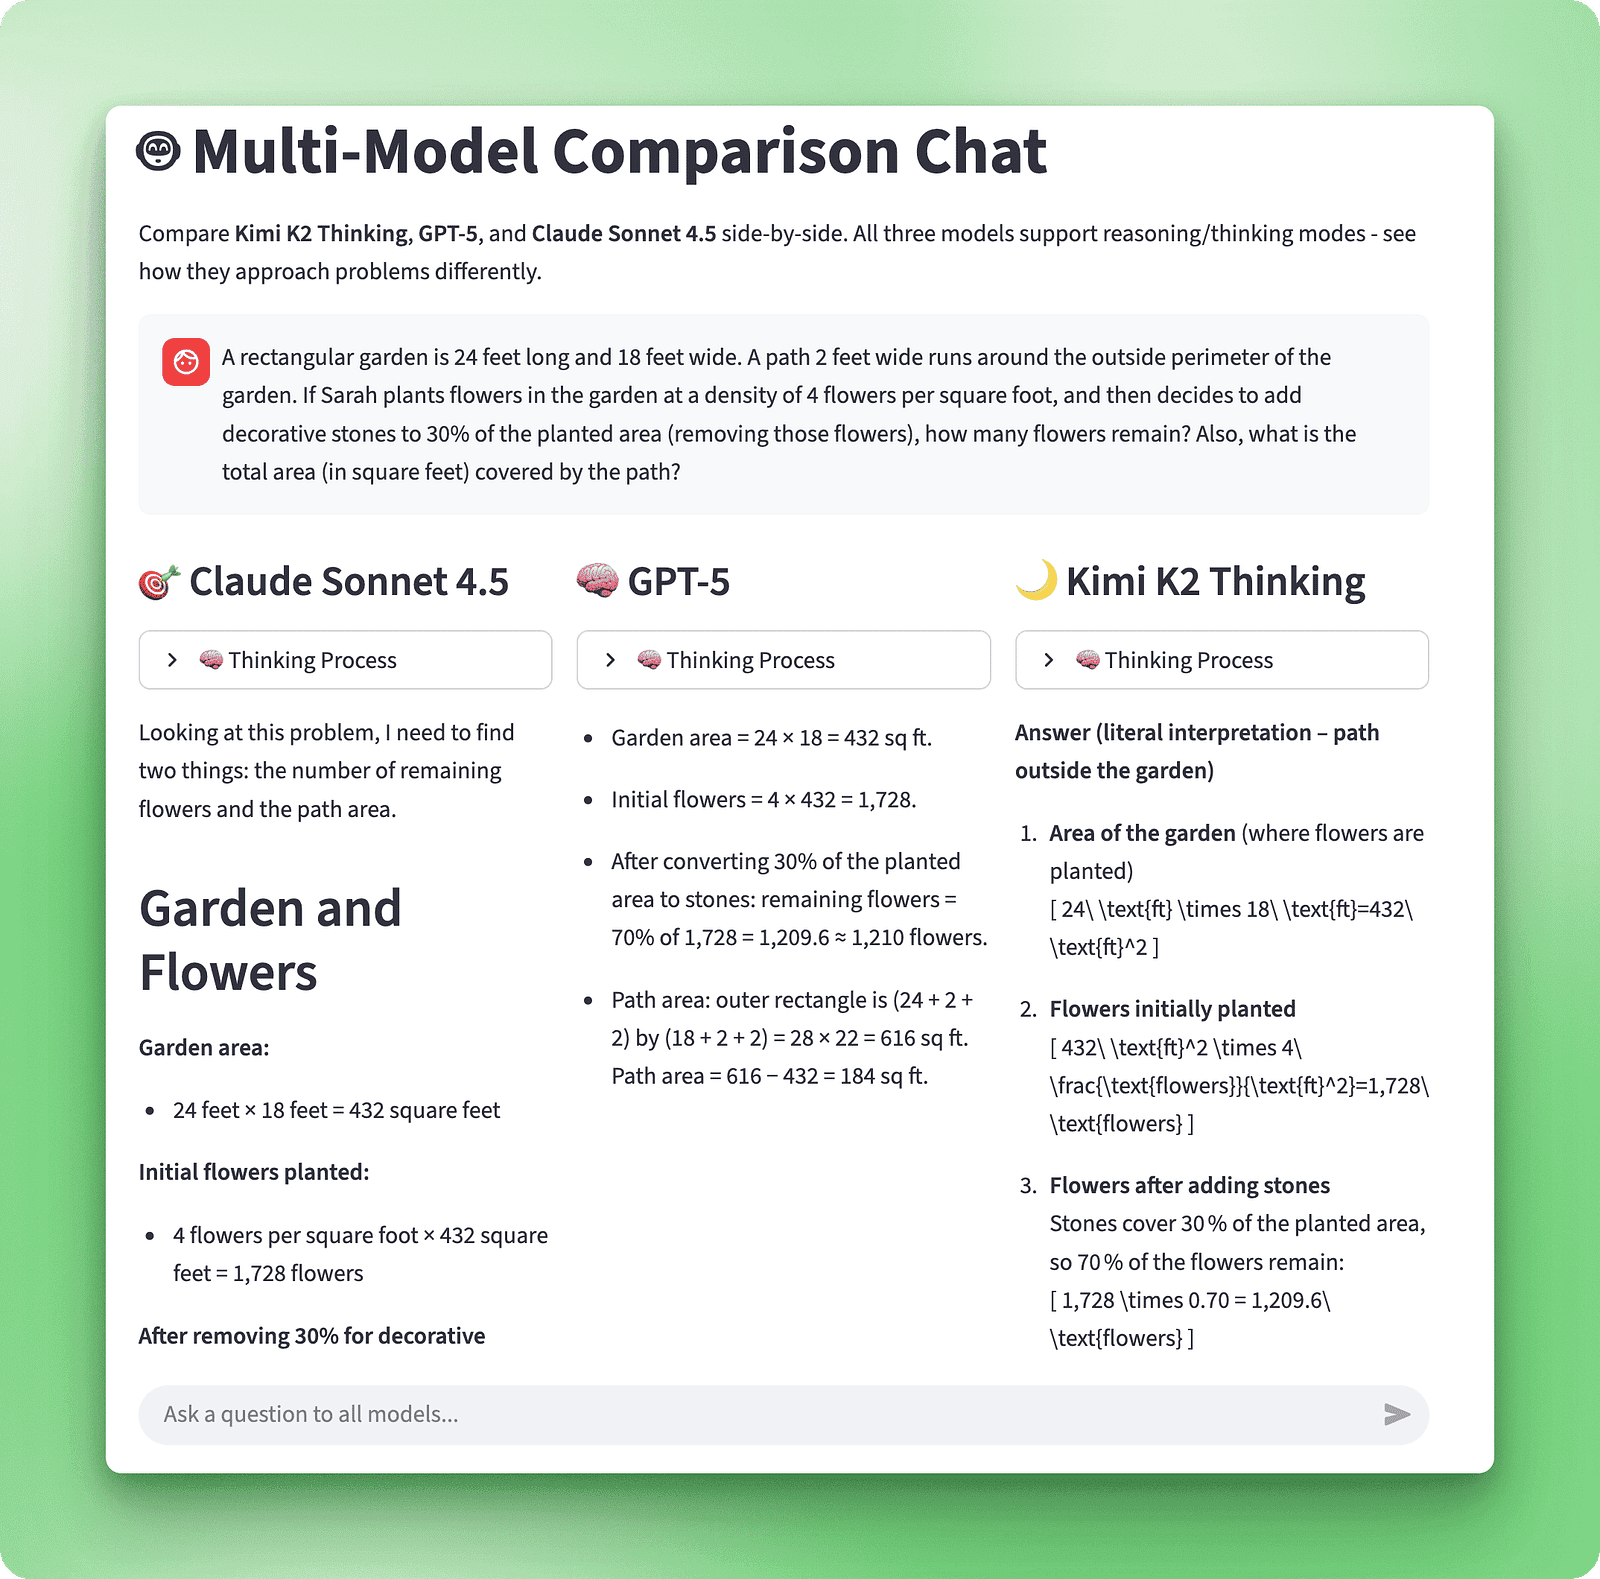
Esta app comparativa requiere acceso por API a los tres modelos. Necesitarás tu cuenta de OpenRouter (ya configurada con 5 $ de crédito gratuito) y, opcionalmente, claves de API de OpenAI y Anthropic. Los 5 $ de OpenRouter deberían bastar para probar los tres modelos con varias consultas. Si solo tienes acceso por OpenRouter, aún puedes comparar K2 con otros modelos disponibles ahí.
Instala Streamlit para la interfaz web y el SDK de Anthropic para acceder a Claude:
pip install streamlit anthropicCrea un archivo llamado model_comparison_chat.py. Toda la aplicación vive en este único archivo. Empieza con los imports:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()Ya tienes OPENROUTER_API_KEY en tu archivo .env. Añade las claves para GPT-5 y Claude:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
Consigue tu clave de OpenAI en platform.openai.com y tu clave de Anthropic en console.anthropic.com. Para más detalles sobre la configuración de GPT-5, consulta la guía de GPT-5. Para Claude Sonnet 4.5, revisa el resumen de Claude Sonnet 4.5.
Inicializa los tres clientes:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))Crea una función unificada que enrute al modelo correcto según el nombre. Mantiene el código limpio y te permite añadir más modelos fácilmente.
Empieza con la llamada a Kimi K2:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5 emplea otro enfoque con un endpoint de responses y esfuerzo de razonamiento configurable:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5 ofrece cuatro niveles de esfuerzo de razonamiento: minimal, low, medium y high. La respuesta separa el razonamiento en bloques de resumen y el contenido en bloques de mensaje, que analizas por separado antes de devolver el mismo diccionario estandarizado que con Kimi K2.
Claude Sonnet 4.5 implementa thinking extendido con un enfoque de presupuesto de tokens:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude asigna un presupuesto de tokens para el razonamiento interno antes de generar la respuesta final. La respuesta contiene múltiples bloques de contenido que recorres separando los bloques de thinking de los de texto. El control de errores al final devuelve la misma estructura estandarizada con un mensaje, asegurando que los fallos de API no rompan la interfaz.
Con la capa de API lista, puedes crear la interfaz web. Configura primero la página de Streamlit:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
El layout «wide» crea espacio para tres columnas en paralelo. El estado de sesión preserva el historial de conversación y las respuestas cuando Streamlit reejecuta el script.
Añade el título y los controles de la barra lateral:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
La barra lateral ofrece control sobre los modos de razonamiento. Kimi K2 y Claude tienen interruptores binarios. GPT-5 ofrece cuatro niveles porque su API permite ese ajuste fino.
Debajo, añade un indicador de estado de API para mostrar qué servicios están conectados:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
Las marcas de verificación aparecen cuando existen las variables de entorno. Las X rojas indican que debes añadir la clave correspondiente al .env.
Aquí viene lo central. Cuando el usuario envíe un mensaje, llamarás a los tres modelos en paralelo y mostrarás los resultados en columnas.
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
Esta función lanza tres llamadas a la API a la vez y recoge los resultados en cuanto terminan. Secuencialmente tardarían 15–30 segundos. En paralelo baja a 5–10 segundos porque solo esperas al modelo más lento.
Integra la ejecución paralela en la interfaz de chat:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
Se crean tres columnas y se muestra cada respuesta en su columna. El razonamiento se despliega colapsado por defecto para priorizar las respuestas finales.
Ejecuta la app con:
streamlit run model_comparison_chat.pyEmpieza con una prueba básica para confirmar que todo funciona:
What is 2+2?Los tres modelos deberían responder en segundos. Esto verifica la conexión a las APIs y confirma que la ejecución en paralelo funciona. La app se ejecuta localmente, dándote control total sobre cuándo llamar a las APIs. Cada consulta implica costes (aprox. $0.01–0.05 por comparación de tres modelos según la longitud), pero al ejecutarla localmente decides cuándo gastar.
Has construido la app comparativa y la has visto funcionar con preguntas simples. Pero las verdaderas diferencias aparecen cuando subes el nivel. Para demostrarlo, probé los tres modelos con prompts complejos. Puedes ejecutar estas mismas pruebas en tu app para ver los resultados de primera mano. Aquí van las conclusiones clave.
Elegimos tres retos distintos para evaluar capacidades de razonamiento diferentes.
Un jardín rectangular mide 24 pies de largo y 18 de ancho. Un camino de 2 pies de ancho rodea el perímetro exterior del jardín. Si Sarah planta flores en el jardín a una densidad de 4 flores por pie cuadrado, y luego decide añadir piedras decorativas en el 30% del área plantada (eliminando esas flores), ¿cuántas flores quedan? Además, ¿cuál es el área total (en pies cuadrados) que cubre el camino?
Cuatro amigos —Alice, Bob, Carol y David— deben colocarse en fila para una foto. Deben cumplirse estas reglas:
1. Alice debe estar junto a Bob
2. Carol no puede estar en ninguno de los extremos
3. David debe estar a la izquierda de Alice
Enumera todas las disposiciones válidas de izquierda a derecha.
Escribe una función en Python que compruebe si una cadena es una dirección IPv4 válida, con estos requisitos:
1. Debe validar el formato (cuatro octetos separados por puntos)
2. Cada octeto debe estar entre 0 y 255 (sin ceros a la izquierda salvo "0" en sí)
3. Debe rechazar formatos no válidos (cadenas vacías, demasiados/pocos octetos, caracteres no numéricos)
4. La complejidad temporal debe ser O(n), donde n es la longitud de la cadena
5. Incluye un docstring completo con ejemplos
6. Añade type hints para todos los parámetros y el valor de retorno
7. Gestiona casos límite (cadena vacía, None, caracteres especiales)
Además, explica tu enfoque de validación y por qué es O(n).
Los tres modelos resolvieron todos los problemas correctamente, pero siguieron caminos muy distintos. Este es el desglose del rendimiento:
|
Prueba |
Modelo |
Tiempo (s) |
Tokens |
Resultado |
|
Problema del jardín |
Kimi K2 |
28.5 |
3,420 |
✓ Correcto (1,209.6 flores, 184 ft²) |
|
GPT-5 |
44.6 |
1,476 |
✓ Correcto (1,209.6 flores, 184 ft²) |
|
|
Claude |
19.7 |
1,386 |
✓ Correcto (1,210 flores, 184 ft²) |
|
|
Colocación para la foto |
Kimi K2 |
50.5 |
6,249 |
✓ Encontró las 2 disposiciones válidas |
|
GPT-5 |
39.4 |
1,914 |
✓ Encontró las 2 disposiciones válidas |
|
|
Claude |
31.3 |
2,310 |
✓ Encontró las 2 disposiciones válidas |
|
|
Validador IPv4 |
Kimi K2 |
192.6 |
5,245 |
✓ Solución O(n) funcional |
|
GPT-5 |
73.7 |
4,233 |
✓ Solución O(n) funcional |
|
|
Claude |
43.1 |
3,330 |
✓ Solución O(n) funcional |
Esto es lo que hace cada modelo durante ese tiempo.
Explora y se cuestiona constantemente. En el problema del jardín, visualizó la situación, resolvió las cuentas y luego se detuvo para decir “Espera, voy a comprobarlo…” antes de seguir. Para la foto, fue probando cada restricción una a una, mostrando su trabajo en cada posibilidad.
El validador IPv4 tardó más de 3 minutos porque consideró los casos límite uno por uno, recorrió la demostración de complejidad O(n) y verificó la lógica varias veces. Es como ver a alguien pensar en voz alta, corregirse y verificar cada paso.
Es metódico y ordenado. Dividió el problema del jardín en secciones claras, numeró los pasos y los siguió en orden. La colocación para la foto recibió un recorrido estructurado, colocando a las personas posición por posición mientras comprobaba las reglas.
El código vino con explicaciones claras y documentación bien organizada. No se autocuestiona tanto como K2 ni corre como Claude. Te da un equilibrio entre detalle y concisión.
Se mueve rápido. Identificó la vía de solución enseguida en cada prueba y la ejecutó con limpieza. Para la foto, organizó por casos y los resolvió sin entretenerse. El código IPv4 fue limpio y bien documentado, pero fue al grano.
Claude muestra su razonamiento, pero no se recrea en las verificaciones. Su velocidad viene de la confianza en el enfoque y un retroceso mínimo.
Estas diferencias generan un patrón claro de trade-offs. Elige K2 cuando necesites razonamientos detallados para aprender, depurar o auditar. Elige Claude cuando importe la velocidad y confíes en los resultados sin inspeccionar cadenas de razonamiento. Elige GPT-5 cuando quieras un equilibrio entre la verbosidad de K2 y la rapidez de Claude.
Nota: Toma estos resultados con cautela, ya que no pueden evaluar de forma exhaustiva todas las capacidades de los tres modelos.
Has configurado Kimi K2 Thinking con OpenRouter, explorado sus capacidades de razonamiento, creado flujos con llamadas a herramientas y construido una app comparativa para probarlo frente a GPT-5 y Claude. Las fortalezas de K2 son la orquestación independiente de herramientas y el razonamiento transparente, lo que lo hace idóneo para flujos complejos donde necesitas verificar sus decisiones.
La capacidad y el coste de K2 lo hacen práctico. Puede ejecutar largas secuencias de llamadas a herramientas frente a las pocas decenas de la competencia, y el campo reasoning_content expone cada paso de pensamiento. Con un coste aproximado de 1/4 del de GPT-5 y 1/6 del de Claude para tokens de salida, puedes hacer pruebas extensas sin apuros de presupuesto.
La app comparativa que has construido te da evidencia directa de estos trade-offs. Pruébala con tus propios problemas y flujos para desarrollar intuición sobre si el razonamiento detallado de K2 compensa tiempos de respuesta más largos. Las pruebas reales con tus casos de uso revelarán patrones que los benchmarks genéricos no captan.
Para profundizar en estos conceptos, consulta el tutorial de OpenRouter de DataCamp para gestionar múltiples proveedores de LLMs, la guía de GPT-5 sobre niveles de esfuerzo de razonamiento, y la guía de Claude Sonnet 4 sobre el modo de razonamiento extendido.
Los mejores cursos de DataCamp
{count, plural, one {Programa} other {Programas}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
9 min
{count, plural, one {blog} other {blogs}}
Stanislav Karzhev
9 min
{count, plural, one {Tutorial} other {Tutoriales}}
Abid Ali Awan
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Josep Ferrer
11 min
{count, plural, one {Tutorial} other {Tutoriales}}
Dimitri Didmanidze
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Moez Ali
12 min