
Program
Büyük Dil Modelleri Geliştirme
16 sa
Açık kaynaklı bir model, ana kıyaslamalarda GPT-5 ve Claude Sonnet 4.5’i çok daha düşük maliyetle geride bırakıyor. Bu model, Kasım 2025’te yayımlanan Moonshot AI’ın akıl yürütme varyantı Kimi K2 Thinking.
Kimi K2 Thinking, 200–300 ardışık araç çağrısını otonom şekilde çalıştırabiliyor; bu da onu karmaşık ajan temelli iş akışları için ideal kılıyor. Ayrıca özel bir API alanı üzerinden akıl yürütme sürecini ortaya koyuyor; böylece sorunları nasıl düşündüğünü tam olarak görebilirsiniz.
Bu eğitim, akıl yürütme görevleri için Kimi K2 Thinking API’sinin nasıl kullanılacağını gösterir. Araç çağırma iş akışlarını uygulayacak, K2’yi GPT-5 ve Claude ile karşılaştırmak için bir sohbet uygulaması geliştirecek ve K2’nin güçlü yönlerinin onu ne zaman daha iyi bir seçenek yaptığını öğreneceksiniz. LLM’lerle uygulama geliştirme hakkında daha fazla öğrenmek istiyorsanız, LangChain ile LLM Uygulamaları Geliştirme kursunu öneririm. Ayrıca GPT-5.1-Codex ve Qwen3-Max-Thinking üzerine diğer projelerimize de göz atabilirsiniz. Yeni Agent Swarm’lı Kimi K2.5 rehberimizi de öneririm.
Uygulamanın ön izlemesi şöyle:
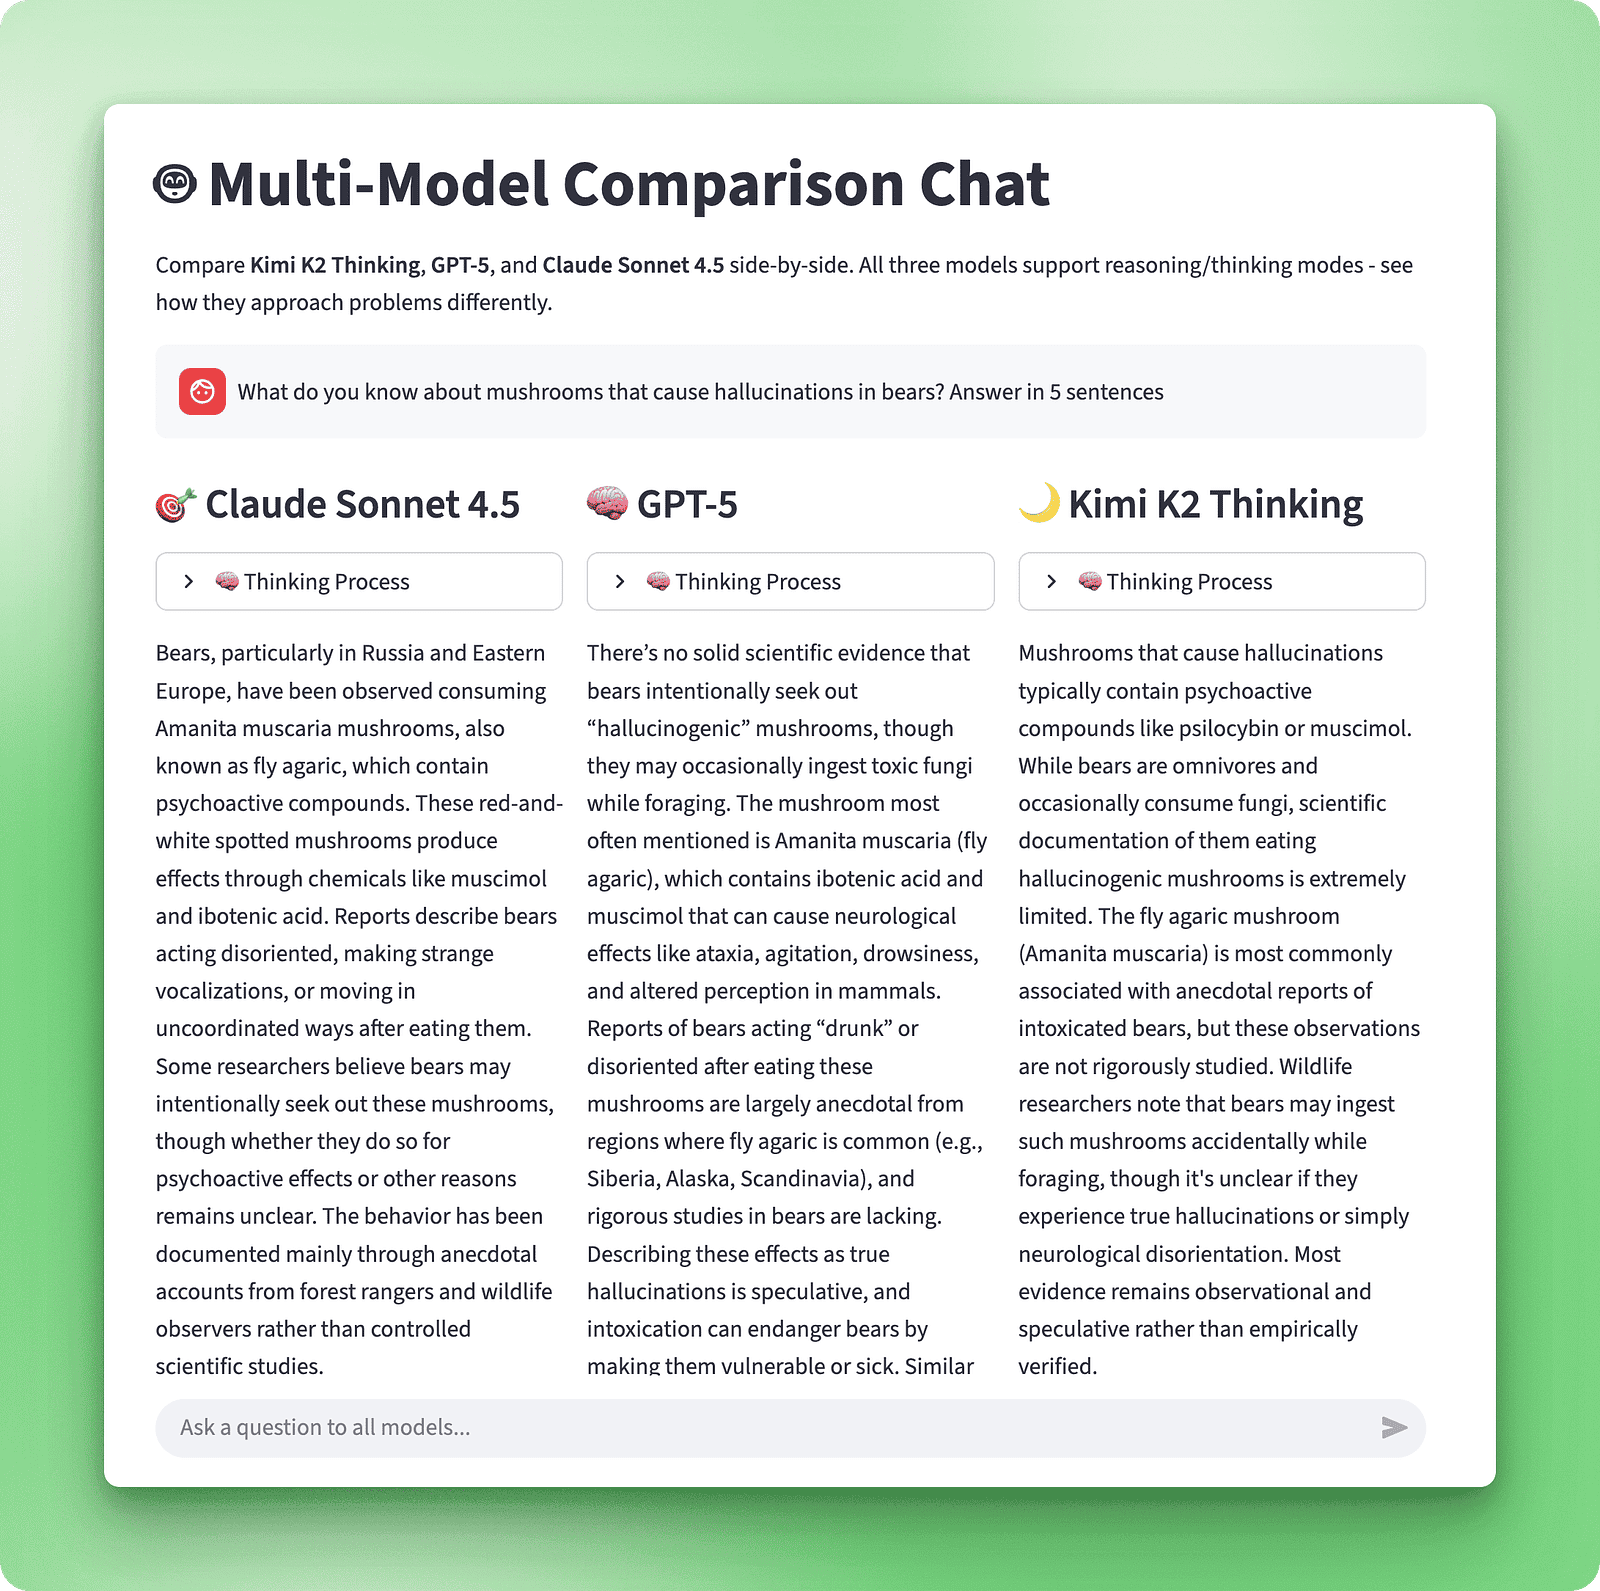
Uygulamalı kısma dalmadan önce, K2 Thinking’i geleneksel dil modellerinden farklı kılan şeyleri anlayalım.
Çoğu dil modeli yanıtları hemen üretir. K2 Thinking farklı çalışır. Modelin kendi başına planlama, mantık yürütme ve eyleme geçmesi gereken çok adımlı sorunlar için tasarlanmıştır.
Model, toplam 1 trilyon parametreli bir Mixture-of-Experts (MoE) mimarisi kullanır. Her bir girdi için yalnızca 32 milyarı etkinleşir. Bu da K2’ye yüksek çıkarım maliyetleri olmadan devasa bir modelin gücünü verir. 256.000 tokenlık bağlam penceresi, tüm kod tabanlarını, uzun dokümanları veya kapsamlı sohbet geçmişlerini parçalara bölmeden beslemenize olanak tanır.
Moonshot AI iki sürüm yayımladı. K2 Instruct; hızın önemli olduğu metin üretimi, sınıflandırma ve basit S&C gibi doğrudan görevleri ele alır. K2 Thinking ise karmaşık akıl yürütme görevleri içindir.
K2 Thinking’in ilk büyük özelliği şeffaf akıl yürütmedir. Sorunları nasıl parçalara ayırdığını, seçenekleri nasıl değerlendirdiğini ve sonuçlara nasıl vardığını görebilirsiniz.
İkincisi araç orkestrasyonudur. K2, çoğu modelin başa çıkabildiğinin çok ötesinde kapsamlı ardışık araç çağırmayı yönetir. Hangi araçların ne zaman kullanılacağına ve sonuçların nasıl birleştirileceğine, her aşamada sizin müdahaleniz olmadan karar verir.
K2, farklı dağıtım ihtiyaçları için özellikler içerir. Doğruluğun kritik olduğu üretim senaryolarında Heavy Mode sekiz akıl yürütme yolunu paralel çalıştırır ve en iyi yanıtı seçer; ancak daha yüksek hesaplama maliyetiyle.
Gecikmeye duyarlı uygulamalar için INT4 quantization, çok az doğruluk kaybıyla çıkarım hızını iki katına çıkarır ve yüksek verimli ortamlarda pratik hale getirir.
K2’nin GPT-5, Claude Sonnet 4.5 ve DeepSeek V3.2 ile karşılaştırması şöyle.
|
Metrek |
Kimi K2 Thinking |
GPT-5 (Yüksek) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (araçlarla) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (python ile) |
99.1 % |
99.6 % |
100 % |
58.1 % |
|
GPQA |
84.5 |
85.7 |
83.4 |
79.9 |
|
BrowseComp |
60.2 |
54.9 |
24.1 |
40.1 |
|
Frames |
87 |
86 |
85 |
80.2 |
|
SWE-bench Verified |
71.3 % |
74.9 % |
77.2 % |
67.8 % |
|
LiveCodeBench |
83.1 % |
87.0 % |
64.0 % |
74.1 % |
|
Bağlam penceresi |
256 k token |
400 k token |
200 k token |
128 k token |
|
Girdi fiyatlandırması |
$0.60 / 1 M |
$1.25 / 1 M |
$3.00 / 1 M |
$0.55 / 1 M |
|
Çıktı fiyatlandırması |
$2.50 / 1 M |
$10.00 / 1 M |
$15.00 / 1 M |
$2.19 / 1 M |
|
Maks. araç çağrısı |
200–300 |
Düzineler + |
Düzineler + |
Belirtilmemiş |
Hızlı kıyaslama tanımları: HLE lisansüstü düzeyde bilgi test eder, AIME25 yarışma matematik sorularını kullanır, BrowseComp ve Frames web gezintisini ve sentezini test eder, SWE-bench Verified açık kaynak kodda hata düzeltmeyi ölçer, LiveCodeBench kod üretimini test eder ve GPQA lisansüstü bilim sorularını kapsar.
K2’nin araç eğitimi, ajan temelli kıyaslamalarda en net şekilde ortaya çıkar. Heavy Mode, sekiz akıl yürütme yolunu paralel çalıştırdığı için HLE’de GPT-5’i 9 puanla geride bırakır. Claude’un kod eğitimi, SWE-bench Verified’da ona üstünlük sağlar ve yazılım mühendisliği projeleri için en iyi tercih haline getirir.
Saf akıl yürütme görevlerinde üç model de yaklaşık olarak aynı performansı gösterir. Farklar araçlar işin içine girdiğinde ortaya çıkar. K2’nin 200–300 araç çağrısı kapasitesi, her aşamada sizin müdahaleniz olmadan otonom araştırma iş akışlarını, hata ayıklama hatlarını ve çok adımlı veri analizlerini yönetmesini sağlar.
K2 Thinking’e erişmek için iki seçeneğiniz var: doğrudan Moonshot AI’ın platform.moonshot.ai üzerinden ya da birleşik bir API ağ geçidi olan OpenRouter üzerinden. Biz OpenRouter kullanacağız; çünkü tek bir API anahtarıyla K2, GPT-5, Claude ve onlarca başka modele erişim sağlar. Bu birleşik erişim, karşılaştırma sohbet uygulamasını kurduğunuzda kritik hale gelir. OpenRouter ayrıca hız sınırlamayı ve failover’ı otomatik olarak yönetir; böylece birden fazla sağlayıcı hesabını yönetmeniz gerekmez.
İlk olarak openrouter.ai adresine gidip bir hesap oluşturun. Google veya GitHub ile kaydolabilirsiniz. Giriş yaptıktan sonra, panodaki “Keys” bölümüne gidin ve yeni bir API anahtarı oluşturun.
OpenRouter, kaydolduğunuzda 5 $ ücretsiz kredi sunar; bu, K2 Thinking’i birkaç sorguda test etmek için yeterlidir. Daha fazla krediye ihtiyaç duyarsanız, “Credits” bölümüne bir ödeme yöntemi ekleyebilirsiniz.
API anahtarınızı kopyalayın ve güvenli bir yerde saklayın. Birazdan buna ihtiyacınız olacak. Bu anahtarı sürüm kontrolüne göndermeyin veya herkese açık şekilde paylaşmayın; çünkü anahtarınızı alan herkes hesabınız üzerinden API çağrıları yapabilir.
Şimdi Python ortamınızı kuralım. OpenRouter’ın API’siyle çalışan, OpenAI uyumluluğunu sürdüren OpenAI Python SDK’sına ihtiyacınız olacak. API anahtarınızı güvenle yönetmek için python-dotenv de isteyeceksiniz. Her iki paketi kurun:
!pip install openai python-dotenv.env dosyasını proje dizininizde oluşturun ve OpenRouter API anahtarınızı ekleyin:
OPENROUTER_API_KEY=your_key_hereGit kullanıyorsanız, kimlik bilgilerinizi yanlışlıkla göndermemek için .env dosyasını .gitignore dosyanıza ekleyin.
Her şeyin çalıştığını doğrulamak için hızlı bir test:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
Çıktı:
15 * 24 = **360**Yanıtı görüyorsanız, hazırsınız.
Önceden K2’nin şeffaf akıl yürütmesinden bahsetmiştik. Şimdi bunu kodunuzda tam olarak nasıl erişip kullanacağınızı görelim. K2 Thinking, akıl yürütme sürecini özel bir API alanı üzerinden otomatik olarak sunar.
Bazı diğer modellerin aksine, düşünme modunu elle etkinleştirmeniz gerekmez; K2 her yanıtta varsayılan olarak akıl yürütme içeriği üretir.
K2 Thinking’e bir API çağrısı yaptığınızda, yanıt iki alan içerir. content alanı nihai yanıtı tutar, reasoning alanı ise adım adım düşünme sürecini gösterir. İşte birden fazla adım gerektiren bir indirim hesabına dair pratik bir örnek:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)Çıktı:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
Akıl yürütme süreci (okunabilirlik için kısaltıldı):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
content alanı, kullanıcıların gördüğü temiz yanıtı verir. reasoning alanı ise K2’nin sorunu nasıl çözdüğünü gösterir; bu da modelin gerçekten doğru akıl yürütüp yürütmediğini anlamanıza yardımcı olur, şans eseri mi doğruyu buldu yoksa gerçekten çözdü mü.
K2, akıl yürütme tokenlarını çıkarım sırasında üretir, sonradan değil. Bu, modelin nihai yanıta geçmeden önce sorunu düşünmesi anlamına gelir; tıpkı siz de bir matematik problemini önce taslak kâğıtta çözüp sonra nihai yanıtı yazdığınız gibi. Akıl yürütme, üretim sürecinin bir parçası olarak gerçek zamanlı gerçekleşir.
temperature=1.0 değerini K2 Thinking kullanırken ayarlayın. Daha düşük sıcaklıklar modelin akıl yürütme keşfini kısıtlar; bu da Thinking modunun amacına ters düşer. Ayrıca max_tokens=4096 veya daha yüksek bir değer de ister; çünkü akıl yürütme zincirleri, nihai yanıt başlamadan önce token tüketir.
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
Artık düşünme modunu anladığınıza göre, K2’nin diğer temel yeteneğini keşfedelim: araç çağırma. Birçok model temel araç kullanımını desteklerken, K2’nin yaklaşımı ölçek ve otonomi açısından farklıdır.
Araç çağırma, K2’nin akıl yürütme sırasında fonksiyonlar yürütmesini sağlar. Araçları, her fonksiyonun ne yaptığını ve hangi parametrelere ihtiyaç duyduğunu tanımlayan JSON şemaları olarak belirlersiniz. K2 dış veri veya hesaplama gerektiğinde doğru aracı çağırır ve sonuçları bekler.
Bu bir ileri-geri döngüsü oluşturur: K2 isteminizi okur ve üzerinde akıl yürütür. Bir araca ihtiyaç duyarsa finish_reason: "tool_calls" döner. Siz fonksiyonu yürütür, sonuçları role: "tool" ile geri gönderirsiniz ve K2 devam eder. K2 finish_reason: "stop" ile nihai yanıtı verene kadar bu tekrar eder.
Şema; ad, açıklama ve parametrelerle OpenAI formatını takip eder. K2, her aracı ne zaman kullanacağını anlamak için bunları okur. Açıklamaların net olması önemlidir; çünkü modelin kararlarını yönlendirir.
Veri bilimi açısından yaygın bir görev olan CSV dosyalarını analiz eden pratik bir araç oluşturalım. Bu araç bir CSV’yi okur, sütun bilgilerini çıkarır ve özet istatistikler döndürür. K2’nin akıl yürütme sırasında harici verilere nasıl erişebildiğini gösterir; bu da veri odaklı uygulamalar için esastır.
İşte tam uygulama:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
Şema, OpenAI formatını takip eden bir fonksiyon aracını tanımlar. description alanı K2’ye aracın ne yaptığını söyler ve ne zaman kullanacağına dair kararını yönlendirir.
parameters nesnesi girdileri belirtir: filepath zorunludur; num_rows ise varsayılanı 10 olan isteğe bağlıdır. Net açıklamalar, bu aracın kullanıcının ihtiyacına ne zaman uyduğunu K2’nin anlamasına yardımcı olur.
Uygulama, gerçek dosya işlemeyi gerçekleştirir:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
Fonksiyon dosya yolunu doğrular, ardından anahtarların sütun adları olduğu sözlükler halinde CSV verilerini ayrıştırmak için csv.DictReader kullanır. İlk num_rows girdileri okur, seek(0) ile dosya imlecini sıfırlar ve toplam satırları sayar.
Döndürülen sözlük, sütun adlarını, örnek verileri, satır sayısını ve dosya boyutunu kilobayt cinsinden içerir. Hata yönetimi, bir şeyler ters giderse aracın faydalı geri bildirim döndürmesini sağlar.
Aracınızı tanımlayıp uyguladıktan sonra, K2 ile fonksiyonlarınız arasındaki diyaloğu yöneten bir döngüye ihtiyacınız var. Araç çağırma tek atışlık bir işlem değildir. K2 birden çok yinelemeye ihtiyaç duyabilir: bir aracı çağırır, sonuçları analiz eder, başka bir araca gerek olup olmadığına karar verir ve tekrarlar. Bu da K2 nihai cevaba ulaşana kadar ileri-geri konuşmayı yönetecek bir döngü gerektirir.
İşte gerçek bir örnekle tam uygulama:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
Bu, OpenRouter’ın API’si için yapılandırılmış OpenAI istemcisini başlatır ve çalışan maaşlarını analiz etme konusunda kullanıcının sorgusuyla ilk mesaj listesini oluşturur.
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
Ana döngü, konuşma geçmişini K2’ye mevcut araçlarla birlikte gönderir. Asistanın yanıtını ve bitiş nedenini çıkardıktan sonra, konuşma bağlamını korumak için bunu mesaj geçmişine ekleyin.
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
K2 araç çağrıları istediğinde, sağlanan argümanlarla her fonksiyonu yürütür ve sonuçları eşleşen tool_call_id değerleriyle konuşmaya geri eklersiniz. K2 akıl yürütmeyi bitirip "stop" döndürdüğünde, nihai yanıtı yazdırır ve döngüden çıkarsınız.
Bu örnek için, ad, departman ve maaş sütunlarını içeren çalışan verileriyle bir sample_employees.csv dosyası oluşturun. Test için Mühendislik, Pazarlama, Satış ve İK departmanlarında yaklaşık 12 çalışan kullanın. Bu kodu çalıştırdığınızda K2 genellikle tam veri kapsamını sağlamak için num_rows değerini 12 veya daha yüksek ayarlayarak analyze_csv() çağrısını yapar; ardından Mühendislik çalışanlarını belirler ve ortalama maaşlarını hesaplar.
Çıktı:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.tool_call_id, her yanıttaki sonuçları fonksiyon çağrılarına geri bağlar. K2 tek bir yanıtta birden fazla araç isteyebilir; bu nedenle her biri doğru eşleme için kendi kimliğine ihtiyaç duyar. Tam konuşma geçmişini korumak, K2’ye araç çağrıları boyunca tutarlı akıl yürütme için gereken bağlamı verir.
Temel araç çağırmaya alıştıktan sonra, K2’nin asıl gücü belirginleşir: genişletilmiş orkestrasyon. K2, baştan beri araç orkestrasyonu için eğitildi; sonradan eklenmiş bir özellik değildir. Bu, çok adımlı görevleri ele alış biçimini değiştirir. Çoğu model 20–50 ardışık araç çağrısından sonra performans kaybeder. K2, tutarlı akıl yürütmeyi koruyarak 200–300 çağrıyı yönetir.
Bu kapasite, modelin karar verip bilgi topladığı, sonuçları doğruladığı ve problemi çözene kadar yinelediği bağımsız iş akışları için önemlidir. K2’nin veritabanlarını aradığı, bulguları çapraz referansladığı, boşlukları belirlediği, sorguları iyileştirdiği ve her şeyi sentezlediği araştırma görevlerini düşünün. Ya da her adımda doğrulama gerektiren veri hatlarını. Ya da birden fazla hipotezi test eden hata ayıklama iş akışlarını.
Kullanım durumunuz “şu tek işlemi yap” ise çoğu model iş görür. “Bunu çözene kadar çalışmaya devam et” ise K2’nin genişletilmiş araç kapasitesi belirleyici faktör olur.
K2 Thinking’in araç çağırma ve şeffaf akıl yürütmeyle tekil görevleri nasıl ele aldığını gördünüz. Şimdi onu rakiplerine karşı test edelim. Aynı istemi eşzamanlı olarak Kimi K2 Thinking, GPT-5 ve Claude Sonnet 4.5’e gönderen bir Streamlit uygulaması oluşturacaksınız. Arayüz, üç yanıtı yan yana gösterir; böylece her modelin aynı problemi nasıl ele aldığını görebilirsiniz.
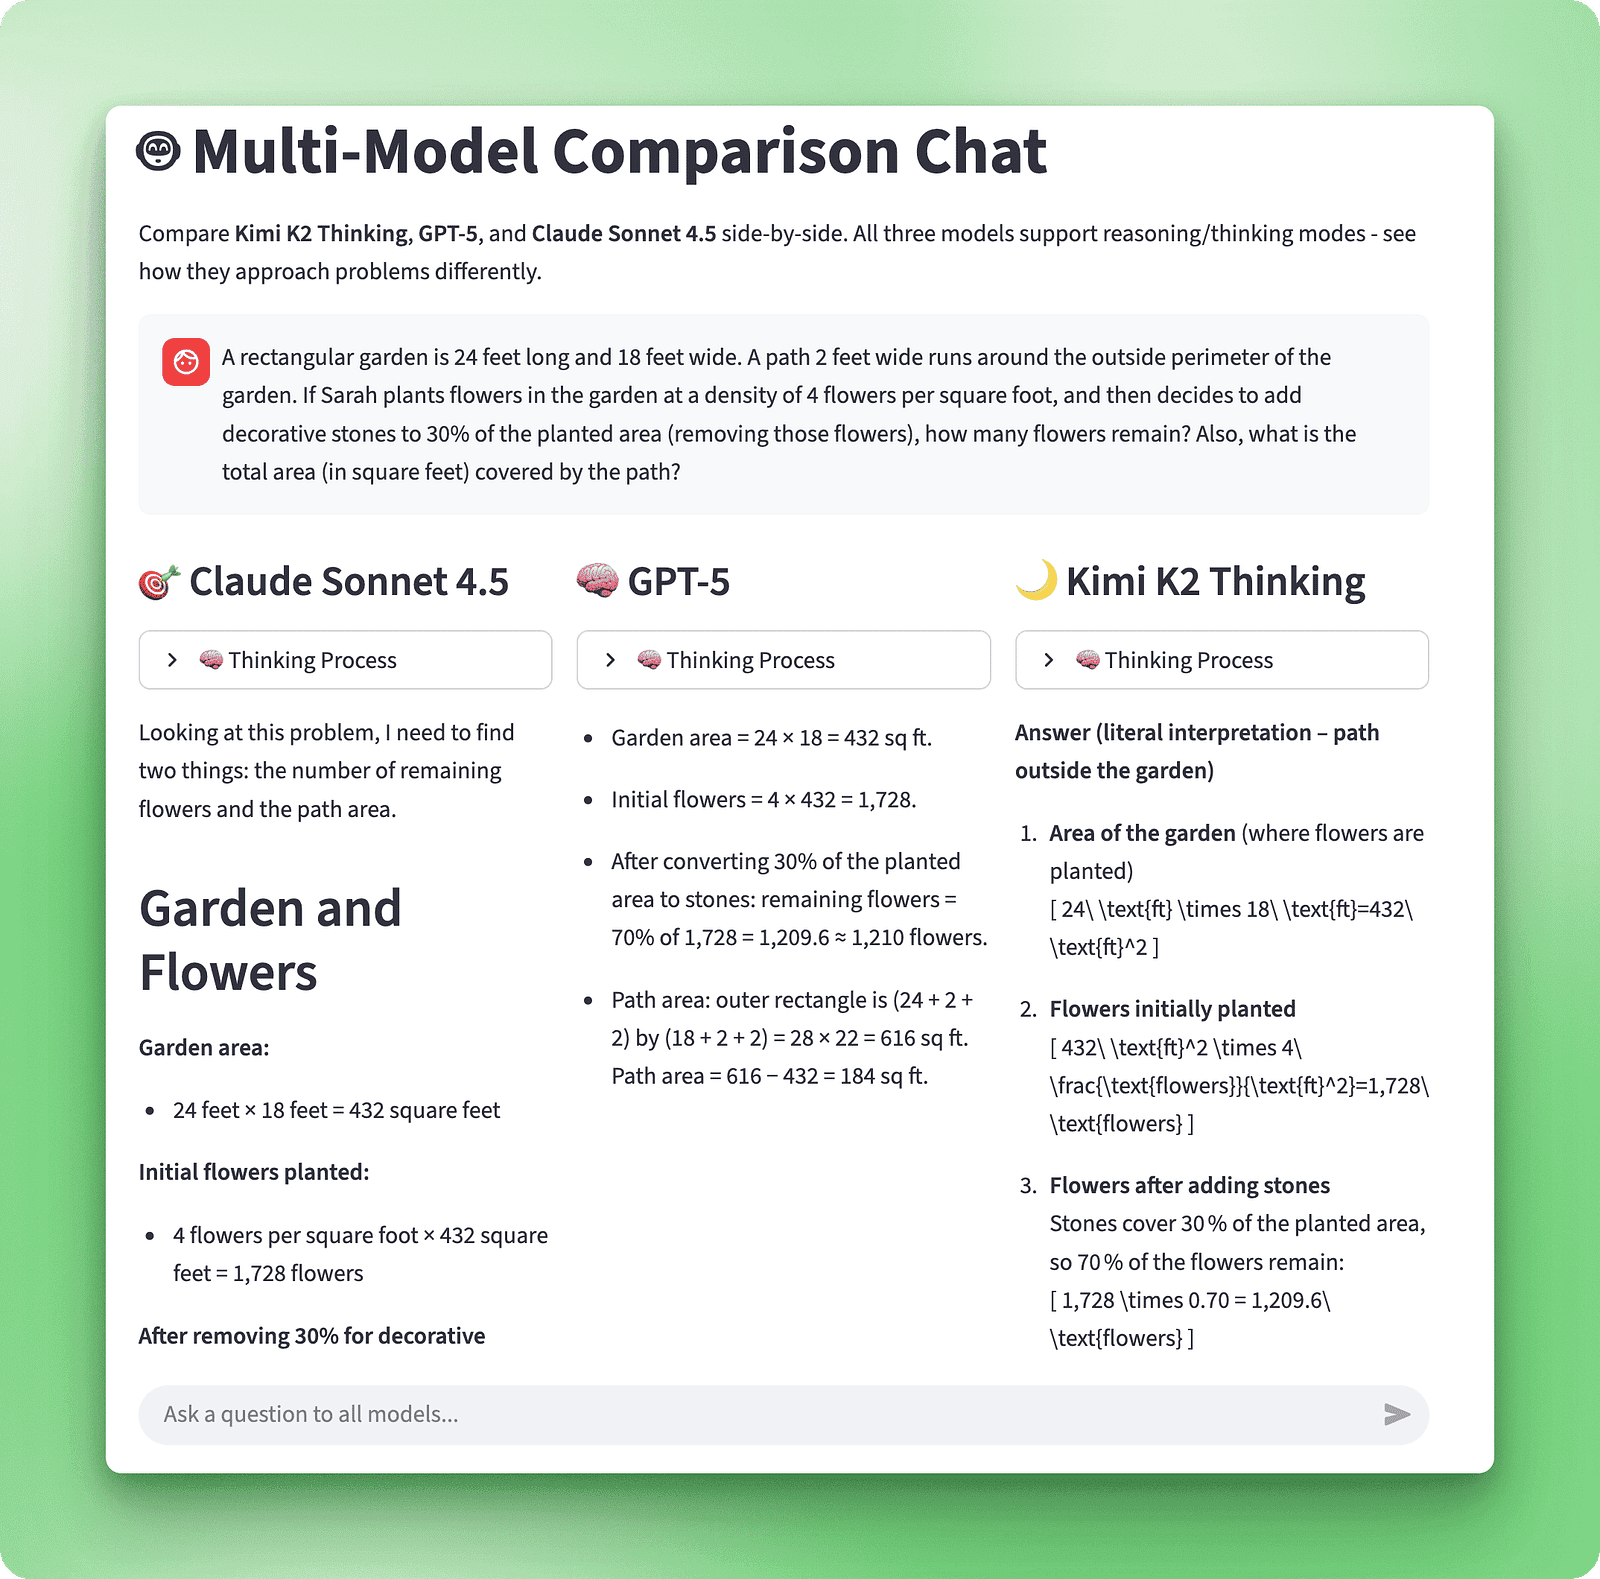
Bu karşılaştırma uygulaması, üç modelin API erişimini gerektirir. OpenRouter hesabınıza (zaten 5 $ ücretsiz krediyle kurulu) ve isteğe bağlı olarak OpenAI ve Anthropic API anahtarlarına ihtiyacınız olacak. OpenRouter’daki 5 $ kredi, üç modeli birden çok sorguda test etmek için yeterli olmalıdır. Yalnızca OpenRouter erişiminiz varsa, OpenRouter üzerinden erişilebilen diğer modellerle K2’yi yine karşılaştırabilirsiniz.
Web arayüzü için Streamlit’i ve Claude erişimi için Anthropic’in SDK’sını kurun:
pip install streamlit anthropicmodel_comparison_chat.py adlı bir dosya oluşturun. Tüm uygulama bu tek dosyada yer alır. İçe aktarmalarla başlayın:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()Zaten .env dosyanızda OPENROUTER_API_KEY var. GPT-5 ve Claude için anahtarlar ekleyin:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
platform.openai.com üzerinden OpenAI API anahtarınızı ve console.anthropic.com üzerinden Anthropic anahtarınızı alın. GPT-5 kurulumu hakkında daha fazla ayrıntı için GPT-5 rehberine bakın. Claude Sonnet 4.5 için Claude Sonnet 4.5 genel bakışını inceleyin.
Üç istemciyi başlatın:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))Ada göre doğru modele yönlendiren birleşik bir fonksiyon oluşturun. Bu, kodunuzu temiz tutar ve ileride daha fazla model eklemeyi kolaylaştırır.
Kimi K2 çağrısıyla başlayın:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5, yanıtlar uç noktası ve yapılandırılabilir akıl yürütme çabasıyla farklı bir yaklaşım benimser:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5, dört akıl yürütme çabası seviyesi sunar: minimal, low, medium ve high. Yanıt yapısı akıl yürütmeyi özet bloklarda, içeriği ise mesaj bloklarında ayırır; Kimi K2 ile aynı standart sözlük formatında döndürmeden önce bunları ayrı ayrı ayrıştırırsınız.
Claude Sonnet 4.5, token bütçesi yaklaşımıyla genişletilmiş düşünme modunu uygular:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude, nihai yanıtı üretmeden önce iç akıl yürütme için bir token bütçesi ayırır. Yanıt, üzerinden geçtiğiniz birden çok içerik bloğu içerir; düşünme bloklarını metin bloklarından ayırırsınız. Sondaki hata yönetimi, başarısız API çağrılarının arayüzü bozmamasını sağlayarak aynı standart sözlük yapısını bir hata mesajıyla döndürür.
API katmanı hazır olduğuna göre web arayüzünü oluşturabilirsiniz. Önce Streamlit sayfasını yapılandırın:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
Geniş düzen, yan yana üç sütun için alan yaratır. Oturum durumu, Streamlit betiği yeniden çalıştığında konuşma geçmişini ve model yanıtlarını korur.
Sayfa başlığını ve kenar çubuğu kontrollerini ekleyin:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
Kenar çubuğu, kullanıcıların düşünme modları üzerinde kontrol sahibi olmasını sağlar. Kimi K2 ve Claude için ikili anahtarlar vardır. GPT-5, API’si bu ayrıntılı denetimi sunduğu için dört akıl yürütme seviyesi sağlar.
Düşünme kontrollerinin altına, hangi hizmetlerin bağlı olduğunu gösteren bir API durum göstergesi ekleyin:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
Ortam değişkenleri ayarlandığında onay işaretleri görünür. Kırmızı X işaretleri, ilgili anahtarı .env dosyanıza eklemeniz gerektiği anlamına gelir.
Şimdi temel işlevsellik geliyor. Kullanıcılar bir mesaj gönderdiğinde, üç modeli de paralel olarak çağıracak ve sonuçları yan yana göstereceksiniz.
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
Bu fonksiyon üç API çağrısını aynı anda gönderir ve tamamlandıkça sonuçları toplar. Sıralı çağrılar 15–30 saniye sürerdi. Paralel yürütme, üçü yerine yalnızca en yavaşı beklendiği için bunu 5–10 saniyeye düşürür.
Paralel yürütmeyi sohbet arayüzüne entegre edin:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
Bu, üç sütun oluşturur ve her modelin yanıtını kendi sütununda gösterir. Düşünme süreci, kullanıcıların önce nihai yanıtları görmesi için başlangıçta daraltılmıştır. Akıl yürütmeyi incelemek istediklerinde düşünme bölümünü genişletebilirler.
Uygulamayı şu komutla çalıştırın:
streamlit run model_comparison_chat.pyHer şeyin çalıştığını doğrulamak için basit bir testle başlayın:
What is 2+2?Üç model de birkaç saniye içinde yanıt vermelidir. Bu, API bağlantılarınızı doğrular ve paralel yürütmenin çalıştığını teyit eder. Uygulama yerelde çalışır; bu da API’lerin ne zaman çağrılacağı üzerinde tam kontrol sağlar. Her sorgu API maliyeti doğurur (yanıt uzunluğuna bağlı olarak üç model karşılaştırması başına yaklaşık $0.01–0.05), ancak yerelde çalıştırmak tam olarak ne zaman harcama yapacağınıza sizin karar vermeniz demektir.
Karşılaştırma uygulamasını oluşturdunuz ve basit sorularda çalıştığını gördünüz. Ancak bu modeller arasındaki gerçek farklar onları daha zorladığınızda ortaya çıkar. Bu farkları göstermek için üç modeli karmaşık istemlerle test ettim. Aynı testleri uygulamanızda çalıştırarak sonuçları ilk elden görebilirsiniz. İşte o testlerden elde edilen temel içgörüler.
Farklı akıl yürütme yetilerini sınamak için üç ayrı meydan okuma seçtik.
Dikdörtgen bir bahçe 24 fit uzunluğunda ve 18 fit genişliğinde. Bahçenin dış çevresi boyunca 2 fit genişliğinde bir yol bulunuyor. Sarah, bahçeye kare fit başına 4 çiçek yoğunluğunda çiçek ekiyor ve ardından ekili alanın %30’una dekoratif taş eklemeye (o çiçekleri kaldırarak) karar veriyor. Kaç çiçek kalır? Ayrıca, yolun kapladığı toplam alan (kare fit cinsinden) nedir?
Dört arkadaş - Alice, Bob, Carol ve David - bir fotoğraf için sıraya dizilmelidir. Şu kurallar izlenmelidir:
1. Alice, Bob’un yanında durmalıdır
2. Carol uçlarda duramaz
3. David, Alice’in solunda durmalıdır
Soldan sağa tüm geçerli dizilimleri listeleyin.
Aşağıdaki gereksinimlerle bir dizgenin geçerli bir IPv4 adresi olup olmadığını denetleyen bir Python fonksiyonu yazın:
1. Biçimi doğrulamalıdır (noktalardan ayrılmış dört oktet)
2. Her oktet 0-255 aralığında olmalıdır ("0"’ın kendisi dışında başta sıfır olmaz)
3. Geçersiz biçimleri reddetmelidir (boş dizgeler, çok fazla/az oktet, sayısal olmayan karakterler)
4. Zaman karmaşıklığı n dizge uzunluğu olmak üzere O(n) olmalıdır
5. Örnekler içeren eksiksiz docstring ekleyin
6. Tüm parametreler ve dönüş değerleri için tür ipuçları ekleyin
7. Köşe durumlarını ele alın (boş dizge, None, özel karakterler)
Ayrıca doğrulama yaklaşımınızı ve neden O(n) olduğunu açıklayın.
Üç model de her sorunu doğru çözdü. Ancak oraya giden yolları oldukça farklıydı. İşte performans dökümü:
|
Test |
Model |
Süre (sn) |
Token |
Sonuç |
|
Bahçe Problemi |
Kimi K2 |
28.5 |
3,420 |
✓ Doğru (1,209.6 çiçek, 184 kare fit) |
|
GPT-5 |
44.6 |
1,476 |
✓ Doğru (1,209.6 çiçek, 184 kare fit) |
|
|
Claude |
19.7 |
1,386 |
✓ Doğru (1,210 çiçek, 184 kare fit) |
|
|
Fotoğraf Dizilimi |
Kimi K2 |
50.5 |
6,249 |
✓ 2 geçerli dizilimin tamamını buldu |
|
GPT-5 |
39.4 |
1,914 |
✓ 2 geçerli dizilimin tamamını buldu |
|
|
Claude |
31.3 |
2,310 |
✓ 2 geçerli dizilimin tamamını buldu |
|
|
IPv4 Doğrulayıcı |
Kimi K2 |
192.6 |
5,245 |
✓ Çalışan O(n) çözüm |
|
GPT-5 |
73.7 |
4,233 |
✓ Çalışan O(n) çözüm |
|
|
Claude |
43.1 |
3,330 |
✓ Çalışan O(n) çözüm |
Bu süre zarfında her modelin aslında ne yaptığına bakalım.
Sürekli keşfeder ve kendini sorgular. Bahçe probleminde kurulumu görselleştirdi, matematiği yaptı, sonra “Bir dur, bunu tekrar kontrol edeyim…” diyerek devam etmeden önce durdu. Fotoğraf diziliminde ise her olasılık için tek tek çalışmalarını göstererek kısıtları birer birer test etti.
IPv4 doğrulayıcı 3 dakikadan fazla sürdü; çünkü uç durumları tek tek düşündü, O(n) karmaşıklık ispatını yürüdü ve mantığı birden çok kez doğruladı. Yüksek sesle düşünen, kendini yakalayan ve her adımda akıl yürütmesini doğrulayan birini izliyorsunuz.
Yöntemli ve düzenlidir. Bahçe problemini net bölümlere ayırdı, adımları numaraladı ve sırayla ilerledi. Fotoğraf dizilimi, insanları kuralları kontrol ederken konum konum yerleştirdiği yapılandırılmış bir yürüyüş aldı.
Kod, net açıklamalar ve iyi düzenlenmiş dokümantasyonla birlikte geldi. K2 kadar kendinden şüphe etmiyor ve Claude kadar acele etmiyor. Aşırı detaya kaçmadan dengeli bir düşünme görünümü elde ediyorsunuz.
Hızlı hareket eder. Her testte çözüm yolunu hızla belirledi ve temiz şekilde uyguladı. Fotoğraf probleminde vakit kaybetmeden durumlara göre organize oldu ve her birini çözdü. IPv4 kodu temiz ve iyi belgeliydi; ancak daha hızlı sonuca vardı.
Claude düşüncesini gösterir; ancak doğrulama adımlarında oyalanmaz. Hız, yaklaşıma olan güvenden ve minimum geri dönüşten gelir.
Bu farklı yaklaşımlar net bir ödünleşim deseni oluşturur. Öğrenme, hata ayıklama veya denetim gereksinimleri için ayrıntılı akıl yürütmeye ihtiyaç duyduğunuzda K2’yi seçin. Hız önemliyse ve akıl yürütme zincirlerini incelemeden sonuçlara güveniyorsanız Claude’u seçin. K2’nin ayrıntıcılığı ile Claude’un hızının arasında dengeli performans istediğinizde GPT-5’i seçin.
Not: Bu testin sonuçlarını bir miktar temkinle değerlendirin; zira üç modelin yetilerini tam anlamıyla ve kapsamlı biçimde test etmek gerçekçi değildir.
Kimi K2 Thinking’i OpenRouter üzerinden kurdunuz, akıl yürütme yeteneklerini keşfettiniz, araç çağırma iş akışları oluşturdunuz ve onu GPT-5 ve Claude’a karşı test etmek için bir karşılaştırma uygulaması geliştirdiniz. K2’nin güçlü yönleri, bağımsız araç orkestrasyonu ve şeffaf akıl yürütmedir; bu da modelin kararlarını doğrulamanız gereken karmaşık iş akışları için onu uygun kılar.
K2’nin kapasitesi ve erişilebilir maliyeti bunu pratik kılar. Çoğu rakibin birkaç düzine ile sınırlı kaldığı yerde kapsamlı ardışık araç çağrılarını yürütebilir ve reasoning_content alanı her düşünme adımını ortaya koyar. Çıktı tokenları için yaklaşık GPT-5’in 1/4’ü ve Claude’un 1/6’sı maliyetle, bütçe endişesi olmadan kapsamlı deneyler yapabilirsiniz.
Oluşturduğunuz karşılaştırma uygulaması, bu ödünleşimlere dair doğrudan kanıt sunar. K2’nin ayrıntılı akıl yürütmesinin daha uzun yanıt sürelerini haklı çıkarıp çıkarmadığına dair sezgi geliştirmek için onu kendi problemleriniz ve iş akışlarınızla test edin. Özgül kullanım durumlarınıza yönelik gerçek dünya testleri, genel kıyaslamaların yakalayamayacağı örüntüleri ortaya çıkaracaktır.
Bu kavramları genişletmek için, birden çok LLM sağlayıcısını yönetmeye yönelik DataCamp’in OpenRouter eğitimini, akıl yürütme çabası seviyeleri için GPT-5 rehberini ve genişletilmiş düşünme modu için Claude Sonnet 4 rehberini inceleyin.
En Popüler DataCamp Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



