
{count, plural, one {Programma} other {Programmi}}
Sviluppare modelli linguistici di grandi dimensioni
{hours} ore
Un modello open-source batte GPT-5 e Claude Sonnet 4.5 sui principali benchmark a una frazione del costo. Quel modello è Kimi K2 Thinking, la variante di ragionamento di Moonshot AI, rilasciata a novembre 2025.
Kimi K2 Thinking può eseguire autonomamente 200–300 chiamate sequenziali agli strumenti, il che lo rende ideale per workflow agentici complessi. Inoltre espone il proprio processo di ragionamento tramite un campo API dedicato, così puoi vedere esattamente come affronta i problemi.
Questo tutorial ti mostra come usare l’API di Kimi K2 Thinking per compiti di ragionamento. Implementerai workflow con chiamata agli strumenti, costruirai un’app di chat comparativa per testare K2 contro GPT-5 e Claude, e imparerai quando i punti di forza di K2 lo rendono la scelta migliore. Se vuoi approfondire lo sviluppo di app con LLM, ti consiglio il corso Developing LLM Applications with LangChain. Puoi anche dare un’occhiata ai nostri altri progetti su GPT-5.1-Codex e Qwen3-Max-Thinking. Consiglio anche la nostra guida al nuovo Kimi K2.5 con Agent Swarm.
Ecco l’anteprima dell’app:
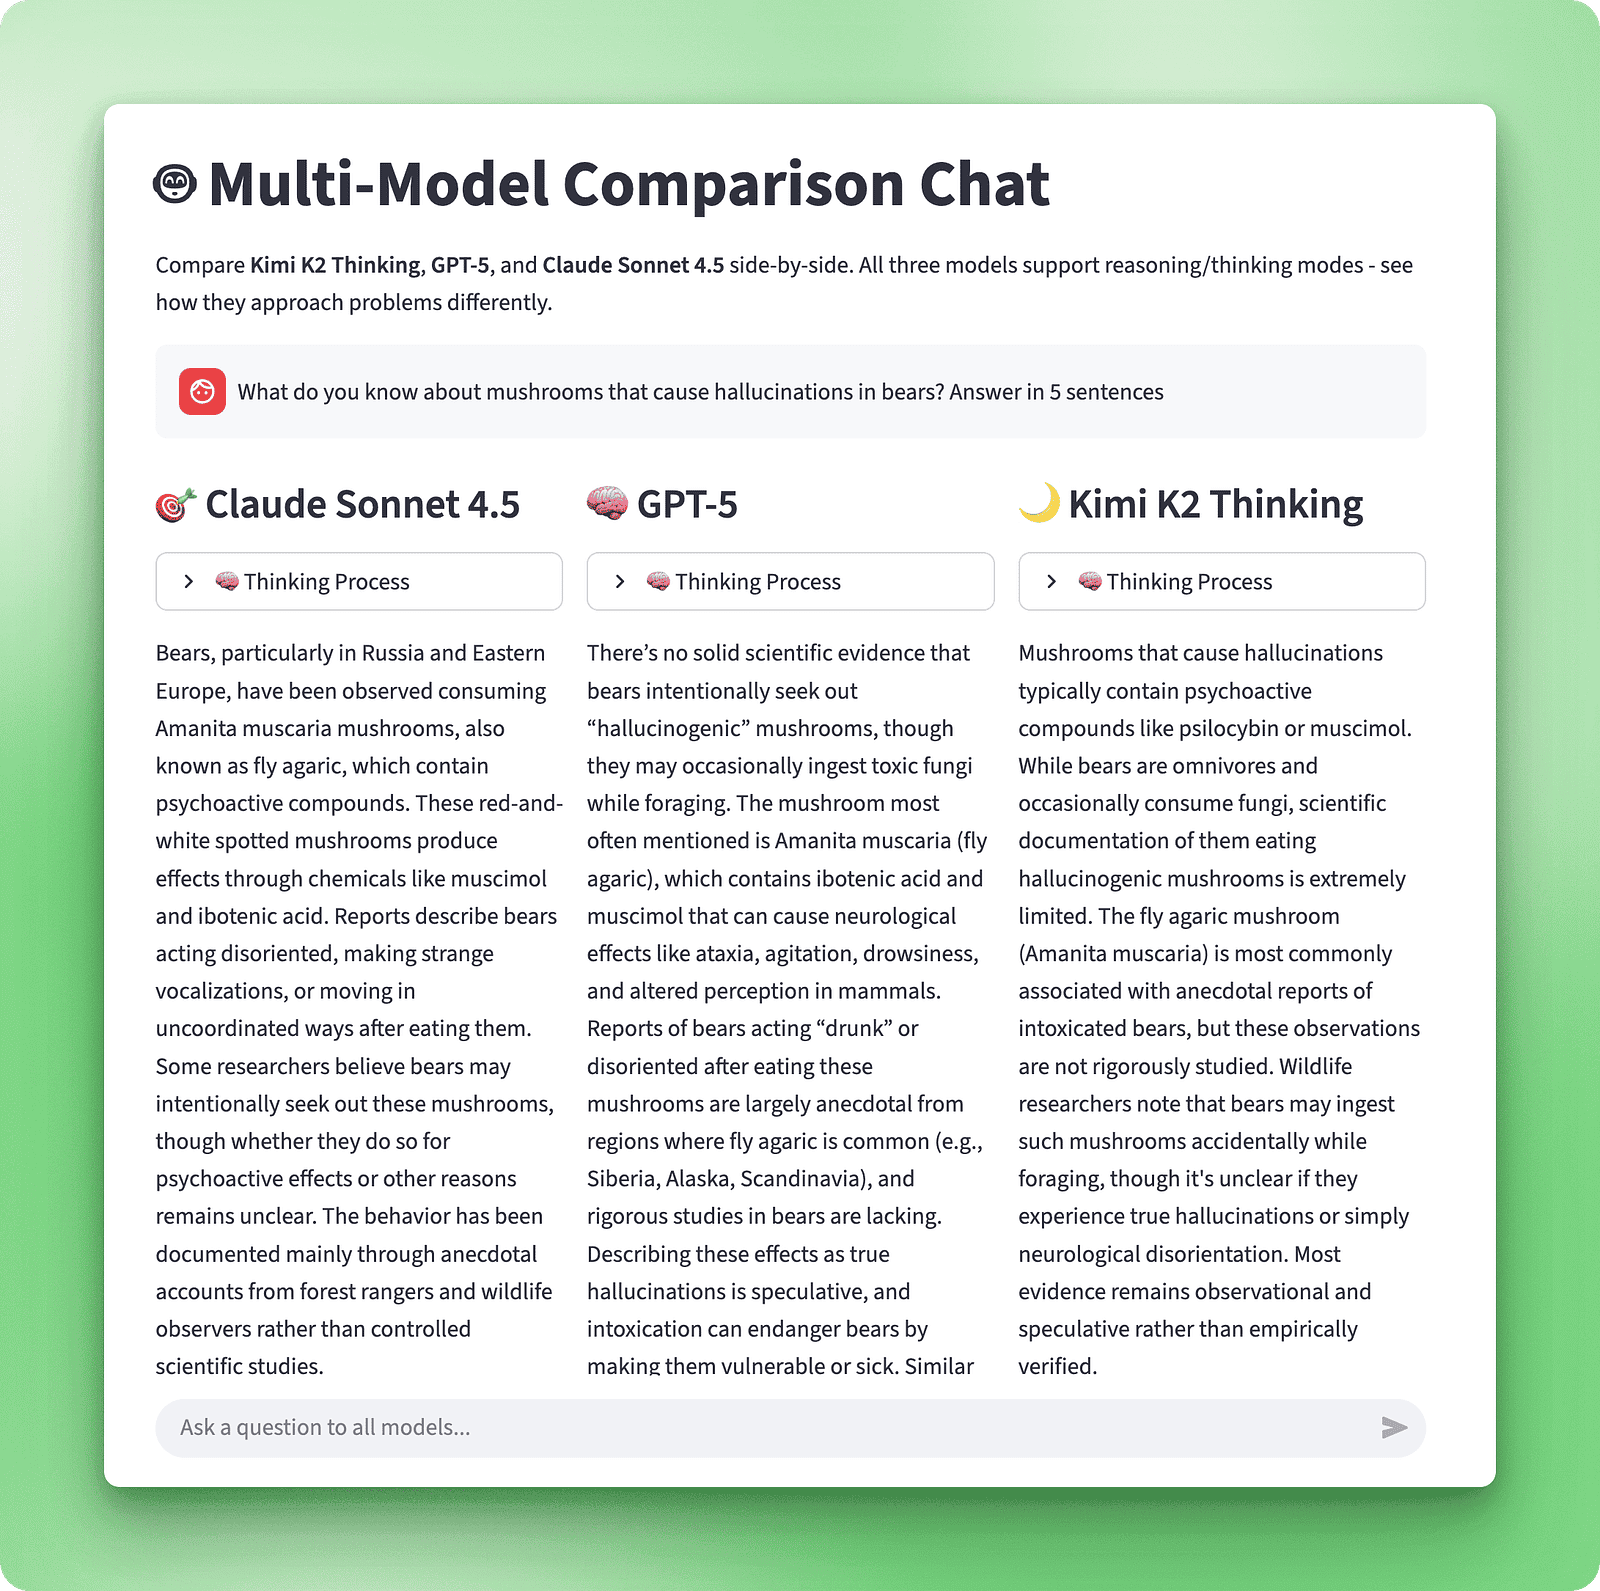
Prima di passare alla pratica, vediamo cosa rende K2 Thinking diverso dai tradizionali modelli linguistici.
La maggior parte dei modelli linguistici genera risposte subito. K2 Thinking funziona in modo diverso. È progettato per problemi a più passi, in cui il modello deve pianificare, ragionare e agire in autonomia.
Il modello usa un’architettura Mixture-of-Experts (MoE) con 1 trilione di parametri totali. Solo 32 miliardi si attivano per un dato input. Questo dà a K2 la potenza di un modello enorme senza gli alti costi di inferenza. La finestra di contesto da 256.000 token significa che puoi fornirgli interi codebase, documenti lunghi o cronologie di conversazione estese senza suddividerli.
Moonshot AI ha rilasciato due versioni. K2 Instruct gestisce compiti lineari come generazione di testo, classificazione e semplici Q&A, dove conta la velocità. K2 Thinking è per compiti di ragionamento complessi.
La prima grande caratteristica di K2 Thinking è il ragionamento trasparente. Puoi vedere come scompone i problemi, valuta le opzioni e arriva alle conclusioni.
La seconda è l’orchestrazione degli strumenti. K2 gestisce un uso esteso e sequenziale degli strumenti, ben oltre ciò che la maggior parte dei modelli riesce a fare. Decide quali strumenti usare, quando usarli e come combinare i risultati senza che tu debba intervenire a ogni passaggio.
K2 include funzionalità per diverse esigenze di deployment. Per scenari in produzione in cui l’accuratezza è critica, la Heavy Mode esegue otto percorsi di ragionamento in parallelo e seleziona la risposta migliore, sebbene con un costo computazionale più alto.
Per applicazioni sensibili alla latenza, la quantizzazione INT4 raddoppia la velocità di inferenza con una perdita minima di accuratezza, rendendola pratica per ambienti ad alto throughput.
Ecco come K2 si confronta con GPT-5, Claude Sonnet 4.5 e DeepSeek V3.2.
|
Metrica |
Kimi K2 Thinking |
GPT-5 (High) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (con strumenti) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (con python) |
99.1 % |
99.6 % |
100 % |
58.1 % |
|
GPQA |
84.5 |
85.7 |
83.4 |
79.9 |
|
BrowseComp |
60.2 |
54.9 |
24.1 |
40.1 |
|
Frames |
87 |
86 |
85 |
80.2 |
|
SWE-bench Verified |
71.3 % |
74.9 % |
77.2 % |
67.8 % |
|
LiveCodeBench |
83.1 % |
87.0 % |
64.0 % |
74.1 % |
|
Finestra di contesto |
256 k token |
400 k token |
200 k token |
128 k token |
|
Prezzo input |
$0.60 / 1 M |
$1.25 / 1 M |
$3.00 / 1 M |
$0.55 / 1 M |
|
Prezzo output |
$2.50 / 1 M |
$10.00 / 1 M |
$15.00 / 1 M |
$2.19 / 1 M |
|
Max chiamate strumenti |
200–300 |
Decine + |
Decine + |
Non specificato |
Definizioni rapide dei benchmark: HLE testa conoscenze a livello graduate, AIME25 usa problemi di matematica da competizione, BrowseComp e Frames testano navigazione web e sintesi, SWE-bench Verified misura la correzione di bug in codice open-source, LiveCodeBench testa la generazione di codice e GPQA copre domande scientifiche a livello graduate.
L’addestramento di K2 sugli strumenti emerge con più chiarezza nei benchmark agentici. La Heavy Mode batte GPT-5 di 9 punti su HLE perché esegue otto percorsi di ragionamento in parallelo. L’addestramento al codice di Claude gli dà un vantaggio su SWE-bench Verified, rendendolo la scelta top per progetti di ingegneria del software.
Sui compiti di puro ragionamento, tutti e tre i modelli rendono più o meno allo stesso modo. Le differenze emergono quando entrano in gioco gli strumenti. La capacità di 200–300 chiamate agli strumenti di K2 gli consente di gestire workflow di ricerca autonoma, pipeline di debugging e analisi dati multi-step senza che tu intervenga a ogni fase.
Hai due opzioni per accedere a K2 Thinking: direttamente tramite il platform.moonshot.ai di Moonshot AI, oppure tramite OpenRouter, un gateway API unificato. Useremo OpenRouter perché fornisce accesso a K2, GPT-5, Claude e decine di altri modelli con una singola chiave API. Questo accesso unificato diventa essenziale più avanti quando costruirai l’app comparativa. OpenRouter gestisce anche rate limiting e failover automaticamente, quindi non devi occuparti di più account di provider.
Per prima cosa, vai su openrouter.ai e crea un account. Puoi iscriverti con Google o GitHub. Una volta dentro, vai alla sezione “Keys” nella dashboard e genera una nuova chiave API.
OpenRouter offre 5 $ di crediti gratuiti al momento dell’iscrizione, sufficienti per testare K2 Thinking su diverse query. Se ti servono più crediti, puoi aggiungere un metodo di pagamento nella sezione “Credits”.
Copia la tua chiave API e conservala in un posto sicuro. Ti servirà tra poco. Non fare commit di questa chiave nel controllo versione e non condividerla pubblicamente, perché chiunque la possieda può effettuare chiamate API sul tuo account.
Ora configuriamo l’ambiente Python. Ti serve l’SDK Python di OpenAI, che funziona con l’API di OpenRouter dato che mantiene la compatibilità con OpenAI. Ti servirà anche python-dotenv per gestire in sicurezza la chiave API. Installa entrambi i pacchetti:
!pip install openai python-dotenvCrea un file .env nella cartella del progetto e aggiungi la tua chiave API di OpenRouter:
OPENROUTER_API_KEY=your_key_hereSe usi git, aggiungi .env al file .gitignore per non fare accidentalmente commit delle tue credenziali.
Ecco un test rapido per verificare che tutto funzioni:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
Output:
15 * 24 = **360**Se vedi la risposta, sei a posto.
In precedenza abbiamo menzionato il ragionamento trasparente di K2. Ora vediamo esattamente come accedervi e usarlo nel tuo codice. K2 Thinking espone automaticamente il proprio processo di ragionamento tramite un campo API dedicato.
A differenza di altri modelli, dove devi abilitare manualmente la thinking mode, K2 include il contenuto di ragionamento in ogni risposta per impostazione predefinita.
Quando effettui una chiamata API a K2 Thinking, la risposta contiene due campi. Il campo content contiene la risposta finale, e il campo reasoning mostra il processo di pensiero passo dopo passo. Ecco un esempio pratico con un calcolo di sconto che richiede più passaggi:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)Output:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
Processo di ragionamento (troncato per leggibilità):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
Il campo content ti dà la risposta pulita che vedranno gli utenti. Il campo reasoning mostra come K2 ha lavorato sul problema, il che ti aiuta a capire se il modello ha davvero ragionato correttamente o è solo stato fortunato.
K2 genera token di ragionamento durante l’inferenza, non dopo. Questo significa che il modello pensa al problema prima di impegnarsi con una risposta, proprio come potresti fare tu risolvendo un problema di matematica su un foglio di brutta prima di scrivere la risposta finale. Il ragionamento avviene in tempo reale come parte del processo di generazione.
Imposta temperature=1.0 quando usi K2 Thinking. Temperature più basse limitano l’esplorazione del ragionamento del modello, vanificando lo scopo della Thinking mode. Inoltre imposta max_tokens=4096 o superiore, perché le catene di ragionamento consumano token prima ancora che inizi la risposta finale.
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
Ora che hai capito la thinking mode, esploriamo l’altra capacità chiave di K2: la chiamata agli strumenti. Sebbene molti modelli supportino un uso basilare degli strumenti, l’approccio di K2 è diverso per scala e autonomia.
La chiamata agli strumenti consente a K2 di eseguire funzioni durante il ragionamento. Definisci gli strumenti come schemi JSON che descrivono cosa fa ogni funzione e quali parametri richiede. Quando K2 ha bisogno di dati o calcoli esterni, chiama lo strumento giusto e attende i risultati.
Questo crea un ciclo di andata e ritorno: K2 legge il tuo prompt e ragiona su di esso. Se ha bisogno di uno strumento, restituisce finish_reason: "tool_calls". Tu esegui la funzione, invii i risultati indietro con role: "tool", e K2 prosegue. Questo si ripete finché K2 non restituisce finish_reason: "stop" con la risposta finale.
Lo schema segue il formato di OpenAI con nome, descrizione e parametri. K2 usa queste informazioni per capire quando usare ciascuno strumento. Descrizioni chiare sono importanti perché guidano le decisioni del modello.
Costruiamo uno strumento pratico che analizzi file CSV, un compito comune nella data science. Questo strumento legge un CSV, estrae informazioni sulle colonne e restituisce statistiche di riepilogo. Mostra come K2 possa accedere a dati esterni durante il ragionamento, essenziale per applicazioni data-driven.
Ecco l’implementazione completa:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
Lo schema definisce uno strumento di tipo funzione seguendo il formato OpenAI. Il campo description dice a K2 cosa fa lo strumento e ne guida la decisione su quando usarlo.
L’oggetto parameters specifica gli input: filepath è obbligatorio, mentre num_rows è opzionale con valore predefinito 10. Descrizioni chiare aiutano K2 a capire quando questo strumento corrisponde alle esigenze dell’utente.
L’implementazione gestisce l’elaborazione effettiva del file:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
La funzione valida il percorso del file, quindi usa csv.DictReader per analizzare i dati CSV in dizionari in cui le chiavi sono i nomi delle colonne. Legge le prime num_rows righe, reimposta il puntatore del file con seek(0) e conta il totale delle righe.
Il dizionario di ritorno include i nomi delle colonne, i dati di esempio, il conteggio delle righe e la dimensione del file in kilobyte. La gestione degli errori garantisce che lo strumento restituisca feedback utili se qualcosa va storto.
Definito e implementato lo strumento, ti serve un loop che gestisca la conversazione tra K2 e le tue funzioni. La chiamata agli strumenti non è un’operazione one-shot. K2 potrebbe aver bisogno di più iterazioni: chiamare uno strumento, analizzare i risultati, decidere se serve un altro strumento e ripetere. Serve quindi un loop che gestisca il botta e risposta finché K2 non arriva alla risposta finale.
Ecco l’implementazione completa con un esempio reale:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
Questo inizializza il client OpenAI configurato per l’API di OpenRouter e crea la lista iniziale dei messaggi con la richiesta dell’utente sull’analisi degli stipendi dei dipendenti.
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
Il loop principale invia a K2 la cronologia della conversazione insieme agli strumenti disponibili. Dopo aver estratto la risposta dell’assistente e la finish reason, la aggiunge alla cronologia per mantenere il contesto.
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
Quando K2 richiede chiamate agli strumenti, eseguiamo ogni funzione con gli argomenti forniti e aggiungiamo i risultati alla conversazione con i rispettivi tool_call_id. Quando K2 termina il ragionamento e restituisce "stop", stampiamo la risposta finale e usciamo dal loop.
Per questo esempio, crea un file sample_employees.csv con dati sui dipendenti che includano nome, reparto e stipendio. Usa circa 12 dipendenti distribuiti tra i reparti Engineering, Marketing, Sales e HR per i test. Quando esegui il codice, K2 in genere chiama analyze_csv() con num_rows impostato a 12 o più per coprire tutti i dati, quindi identifica i dipendenti Engineering e calcola il loro stipendio medio.
Output:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.
Il tool_call_id in ogni risposta collega i risultati alle rispettive chiamate di funzione. K2 potrebbe richiedere più strumenti in un’unica risposta, quindi ciascuno necessita del proprio ID per l’abbinamento corretto. Conservare l’intera cronologia della conversazione fornisce a K2 il contesto necessario per un ragionamento coerente tra le chiamate agli strumenti.
Una volta acquisita dimestichezza con la chiamata di base agli strumenti, diventa evidente il vero punto di forza di K2: l’orchestrazione estesa. K2 è stato addestrato all’orchestrazione degli strumenti fin dall’inizio, non come un’aggiunta successiva. Questo cambia il modo in cui gestisce i compiti multi-step. La maggior parte dei modelli riesce a gestire 20–50 chiamate sequenziali prima che le prestazioni calino. K2 gestisce 200–300 mantenendo un ragionamento coerente.
Questa capacità è cruciale per workflow indipendenti in cui il modello decide, raccoglie informazioni, valida i risultati e itera finché non risolve il problema. Pensa a compiti di ricerca in cui K2 interroga database, incrocia i risultati, identifica lacune, raffina le query e sintetizza tutto. O a pipeline di dati che richiedono validazione a ogni passaggio. O a workflow di debugging che testano ipotesi multiple.
Se il tuo caso d’uso è “esegui questa singola azione”, la maggior parte dei modelli va bene. Se è “continua finché non lo risolvi”, la capacità estesa di K2 sugli strumenti diventa il fattore decisivo.
Hai visto come K2 Thinking gestisce compiti individuali con chiamata agli strumenti e ragionamento trasparente. Ora mettiamolo alla prova contro i concorrenti. Costruirai un’app Streamlit che interroga contemporaneamente Kimi K2 Thinking, GPT-5 e Claude Sonnet 4.5 con lo stesso prompt. L’interfaccia mostra le tre risposte affiancate così puoi vedere come ciascun modello affronta lo stesso problema.
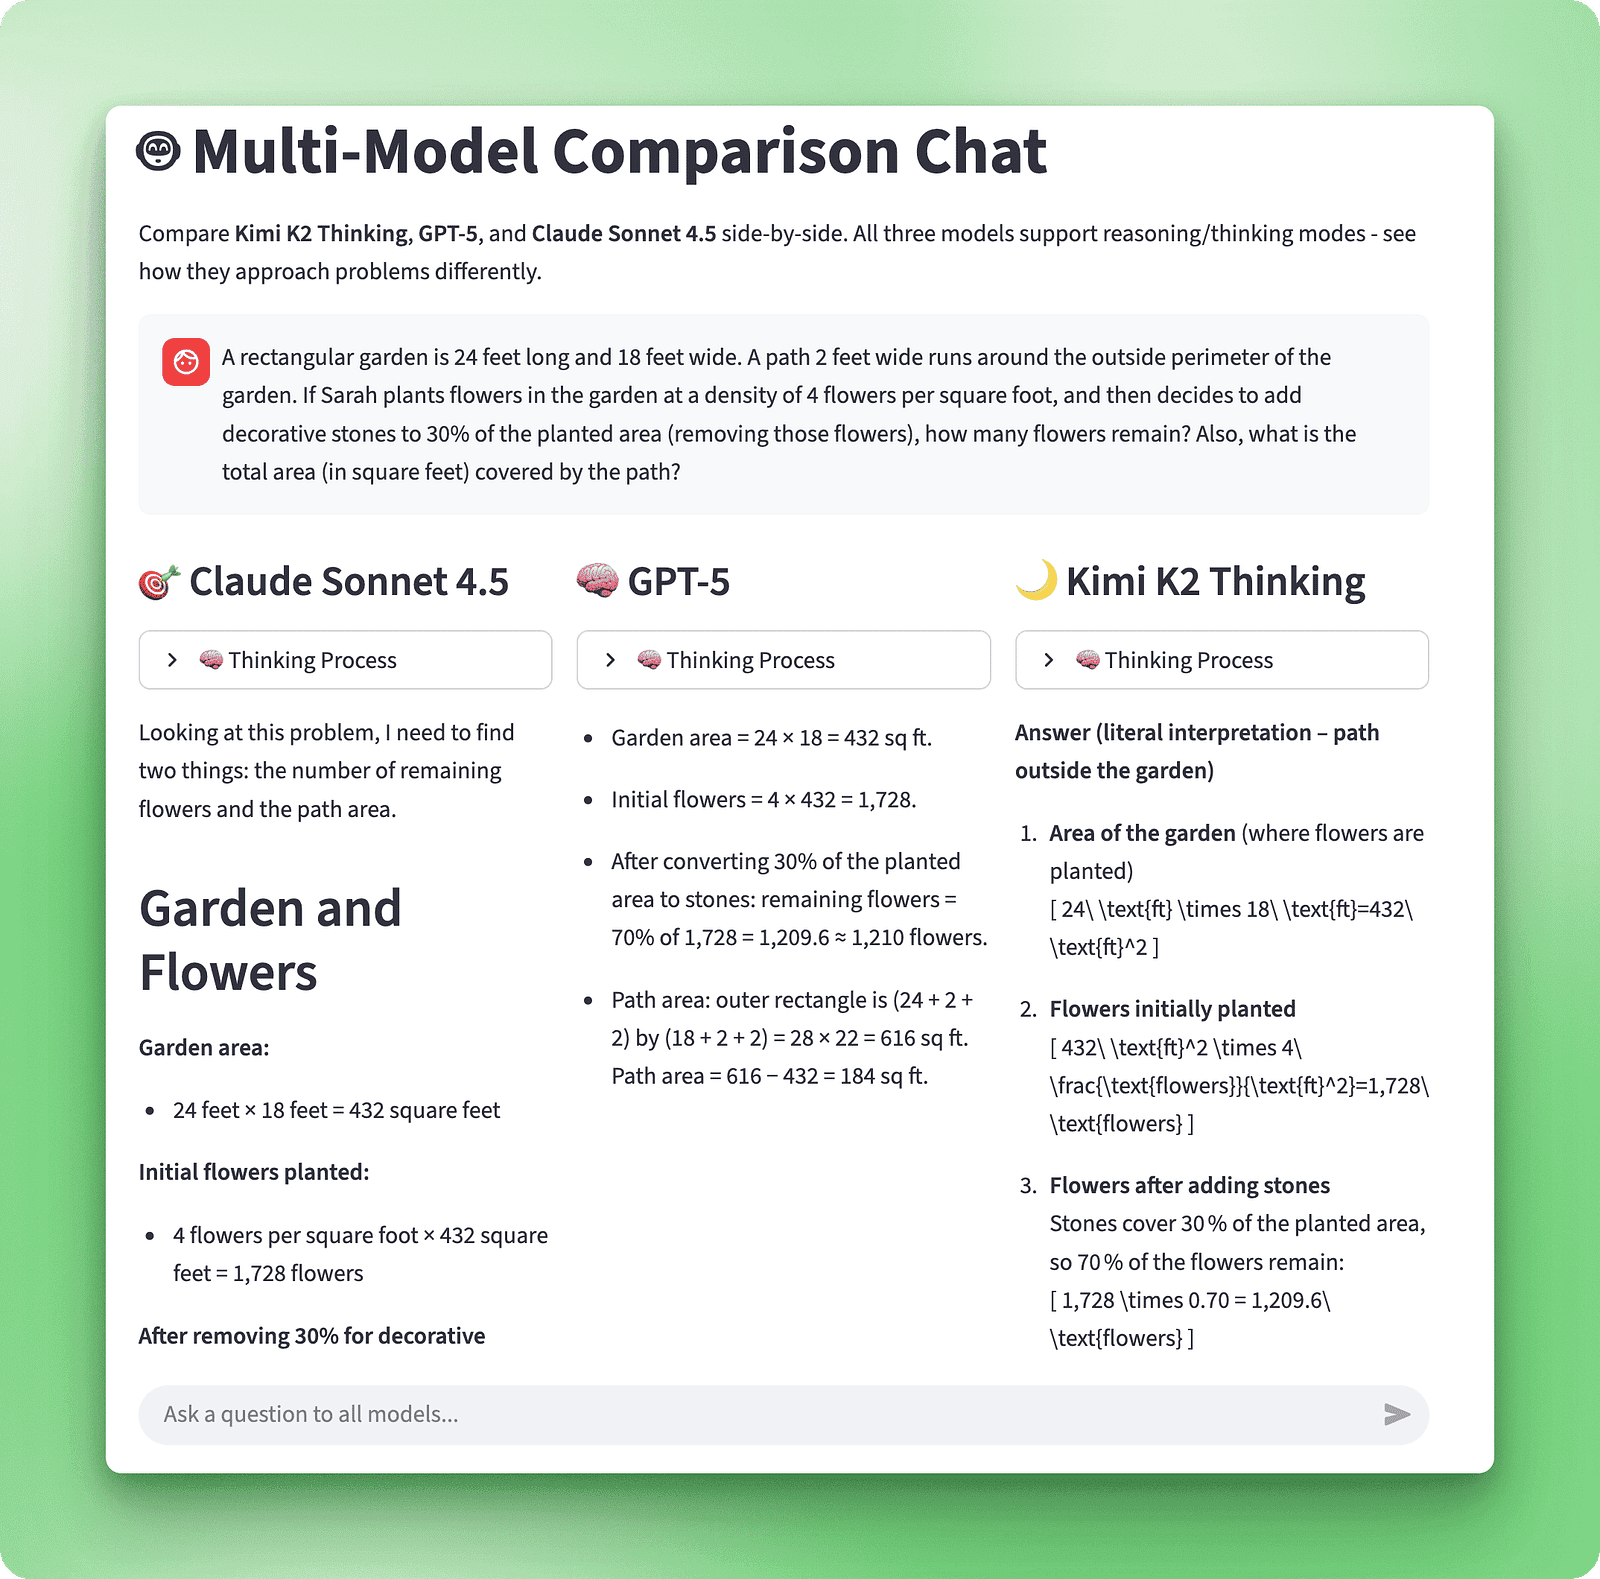
Questa app comparativa richiede accesso API a tutti e tre i modelli. Ti serve il tuo account OpenRouter (già configurato con 5 $ di crediti gratuiti) e, opzionalmente, le chiavi API di OpenAI e Anthropic. I 5 $ di crediti OpenRouter dovrebbero bastare per testare tutti e tre i modelli su più query. Se hai solo l’accesso OpenRouter, puoi comunque confrontare K2 con altri modelli disponibili tramite OpenRouter.
Installa Streamlit per l’interfaccia web e l’SDK di Anthropic per l’accesso a Claude:
pip install streamlit anthropicCrea un file chiamato model_comparison_chat.py. L’intera applicazione sta in questo singolo file. Inizia con gli import:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()Hai già OPENROUTER_API_KEY nel tuo file .env. Aggiungi le chiavi per GPT-5 e Claude:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
Ottieni la tua chiave API OpenAI da platform.openai.com e la chiave Anthropic da console.anthropic.com. Per maggiori dettagli sulla configurazione di GPT-5, vedi la guida a GPT-5. Per Claude Sonnet 4.5, consulta la panoramica di Claude Sonnet 4.5.
Inizializza i tre client:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))Costruisci un’unica funzione che instradi al modello corretto in base al nome. Mantiene il codice pulito e ti permette di aggiungere facilmente altri modelli in seguito.
Inizia con la chiamata a Kimi K2:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5 adotta un approccio diverso con un endpoint responses e sforzo di ragionamento configurabile:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5 offre quattro livelli di sforzo di ragionamento: minimal, low, medium e high. La struttura della risposta separa il ragionamento in blocchi di riepilogo e il contenuto in blocchi di messaggio, che analizzi separatamente prima di restituire lo stesso formato di dizionario standardizzato di Kimi K2.
Claude Sonnet 4.5 implementa una thinking mode estesa con un approccio a budget di token:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude assegna un budget di token al ragionamento interno prima di generare la risposta finale. La risposta contiene più blocchi di contenuto che iteri separando i blocchi di thinking da quelli di testo. La gestione degli errori alla fine restituisce la stessa struttura di dizionario standard con un messaggio di errore, assicurando che le chiamate API fallite non rompano l’interfaccia.
Con il livello API pronto, puoi costruire l’interfaccia web. Configura prima la pagina Streamlit:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
Il layout wide crea spazio per tre colonne affiancate. Lo stato di sessione preserva la cronologia delle conversazioni e le risposte dei modelli quando Streamlit riesegue lo script.
Aggiungi il titolo della pagina e i controlli della sidebar:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
La sidebar offre agli utenti il controllo sulle thinking mode. Kimi K2 e Claude hanno interruttori binari. GPT-5 fornisce quattro livelli di ragionamento perché la sua API espone questo controllo granulare.
Sotto i controlli di thinking, aggiungi un indicatore di stato delle API così gli utenti sanno quali servizi sono collegati:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
I segni di spunta compaiono quando le variabili d’ambiente sono impostate. Le X rosse significano che devi aggiungere la rispettiva chiave al tuo file .env.
Ora arriva la funzionalità core. Quando gli utenti inviano un messaggio, chiamerai tutti e tre i modelli in parallelo e mostrerai i risultati affiancati.
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
Questa funzione invia tre chiamate API contemporaneamente e raccoglie i risultati man mano che completano. Chiamate sequenziali richiederebbero 15–30 secondi. L’esecuzione in parallelo riduce a 5–10 secondi perché aspetti solo il modello più lento invece della somma dei tre.
Integra l’esecuzione parallela nell’interfaccia chat:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
Questo crea tre colonne e mostra la risposta di ciascun modello nella propria colonna. Il processo di thinking è inizialmente compresso così gli utenti vedono prima le risposte finali. Possono espanderlo quando vogliono esaminare il ragionamento.
Esegui l’app con:
streamlit run model_comparison_chat.pyInizia con un test di base per confermare che tutto funzioni:
What is 2+2?Tutti e tre i modelli dovrebbero rispondere in pochi secondi. Questo verifica le connessioni API e conferma che l’esecuzione in parallelo funziona. L’app gira in locale, dandoti pieno controllo su quando vengono effettuate le chiamate API. Ogni query comporta costi API (circa 0,01–0,05 $ per confronto tra tre modelli a seconda della lunghezza della risposta), ma eseguire in locale significa che decidi tu quando spendere.
Hai costruito l’app comparativa e l’hai vista funzionare con domande semplici. Ma le vere differenze tra questi modelli emergono quando li metti sotto pressione. Per dimostrare queste differenze, ho testato tutti e tre i modelli con prompt complessi. Puoi eseguire gli stessi test nella tua app per vedere i risultati in prima persona. Ecco gli insight principali emersi.
Abbiamo scelto tre sfide diverse per testare abilità di ragionamento distinte.
Un giardino rettangolare è lungo 24 piedi e largo 18 piedi. Un sentiero largo 2 piedi corre attorno al perimetro esterno del giardino. Se Sarah pianta fiori nel giardino a una densità di 4 fiori per piede quadrato, e poi decide di aggiungere pietre decorative al 30% dell’area piantata (rimuovendo quei fiori), quanti fiori rimangono? Inoltre, qual è l’area totale (in piedi quadrati) coperta dal sentiero?
Quattro amici - Alice, Bob, Carol e David - devono disporsi in fila per una foto. Devono essere rispettate le seguenti regole:
1. Alice deve stare accanto a Bob
2. Carol non può stare a nessuna delle due estremità
3. David deve stare alla sinistra di Alice
Elenca tutte le disposizioni valide da sinistra a destra.
Scrivi una funzione Python che verifichi se una stringa è un indirizzo IPv4 valido, con questi requisiti:
1. Deve validare il formato (quattro ottetti separati da punti)
2. Ogni ottetto deve essere 0-255 (niente zeri iniziali tranne "0" stesso)
3. Deve rifiutare formati non validi (stringhe vuote, troppi/pochi ottetti, caratteri non numerici)
4. La complessità temporale deve essere O(n) dove n è la lunghezza della stringa
5. Includi una docstring completa con esempi
6. Aggiungi type hint per tutti i parametri e il valore di ritorno
7. Gestisci i casi limite (stringa vuota, None, caratteri speciali)
Spiega anche il tuo approccio di validazione e perché è O(n).
Tutti e tre i modelli hanno risolto correttamente ogni problema. Ma hanno seguito percorsi molto diversi per arrivarci. Ecco il breakdown delle prestazioni:
|
Test |
Modello |
Tempo (sec) |
Token |
Risultato |
|
Problema del giardino |
Kimi K2 |
28.5 |
3,420 |
✓ Corretto (1.209,6 fiori, 184 sq ft) |
|
GPT-5 |
44.6 |
1,476 |
✓ Corretto (1.209,6 fiori, 184 sq ft) |
|
|
Claude |
19.7 |
1,386 |
✓ Corretto (1.210 fiori, 184 sq ft) |
|
|
Disposizione foto |
Kimi K2 |
50.5 |
6,249 |
✓ Trovate tutte le 2 disposizioni valide |
|
GPT-5 |
39.4 |
1,914 |
✓ Trovate tutte le 2 disposizioni valide |
|
|
Claude |
31.3 |
2,310 |
✓ Trovate tutte le 2 disposizioni valide |
|
|
Validatore IPv4 |
Kimi K2 |
192.6 |
5,245 |
✓ Soluzione O(n) funzionante |
|
GPT-5 |
73.7 |
4,233 |
✓ Soluzione O(n) funzionante |
|
|
Claude |
43.1 |
3,330 |
✓ Soluzione O(n) funzionante |
Ecco cosa fa in pratica ciascun modello in quel tempo.
Esplora e si mette continuamente in discussione. Sul problema del giardino, ha visualizzato la situazione, svolto i calcoli, poi si è fermato per dire “Aspetta, ricontrollo…” prima di continuare. Per la disposizione della foto, ha testato ogni vincolo uno per uno, mostrando il lavoro per ogni possibilità.
Il validatore IPv4 ha richiesto oltre 3 minuti perché ha considerato i casi limite uno per uno, ha illustrato la dimostrazione della complessità O(n) e ha verificato più volte la logica. È come osservare qualcuno pensare ad alta voce, correggersi e verificare il ragionamento a ogni passo.
È metodico e organizzato. Ha scomposto il problema del giardino in sezioni chiare, numerato i passaggi e li ha seguiti in ordine. La disposizione per la foto ha avuto una trattazione strutturata, posizionando le persone una alla volta mentre controllava le regole.
Il codice è arrivato con spiegazioni chiare e documentazione ben organizzata. Non si mette in dubbio quanto K2, e non corre come Claude. Ottieni una visione bilanciata del pensiero senza dettagli eccessivi.
Si muove veloce. Ha identificato rapidamente il percorso di soluzione in ogni test e l’ha eseguito con pulizia. Per il problema della foto, ha organizzato per casi e ha lavorato su ciascuno senza indugiare. Il codice IPv4 era pulito e ben documentato, ma è andato dritto al punto.
Claude mostra il suo pensiero ma non si sofferma sui passaggi di verifica. La velocità deriva dalla fiducia nell’approccio e da un backtracking minimo.
Questi approcci diversi creano un chiaro schema di trade-off. Scegli K2 quando ti servono ragionamenti dettagliati per apprendimento, debugging o requisiti di audit. Scegli Claude quando conta la velocità e ti fidi dei risultati senza ispezionare le catene di ragionamento. Scegli GPT-5 quando vuoi prestazioni bilanciate tra la verbosità di K2 e la velocità di Claude.
Nota: Prendi i risultati di questo test con le pinze, perché non possono realisticamente testare al massimo le capacità di tutti e tre i modelli.
Hai configurato Kimi K2 Thinking tramite OpenRouter, esplorato le sue capacità di ragionamento, costruito workflow con chiamata agli strumenti e creato un’app comparativa per testarlo contro GPT-5 e Claude. I punti di forza di K2 sono l’orchestrazione indipendente degli strumenti e il ragionamento trasparente, che lo rendono adatto a workflow complessi in cui devi verificare le decisioni del modello.
La capacità e la convenienza di K2 rendono tutto questo praticabile. Può eseguire molte chiamate sequenziali agli strumenti rispetto alle poche decine della maggior parte dei concorrenti, e il campo reasoning_content espone ogni passaggio del pensiero. A circa 1/4 del costo di GPT-5 e 1/6 del costo di Claude per i token di output, puoi eseguire esperimenti estesi senza preoccupazioni di budget.
L’app comparativa che hai costruito ti dà prove dirette di questi trade-off. Testala con i tuoi problemi e workflow per sviluppare l’intuizione su quando il ragionamento dettagliato di K2 giustifica i tempi di risposta più lunghi. I test nel mondo reale sui tuoi casi d’uso specifici riveleranno pattern che i benchmark generici non possono catturare.
Per approfondire questi concetti, consulta l’ OpenRouter tutorial di DataCamp per gestire più provider LLM, la guida a GPT-5 per i livelli di sforzo di ragionamento, e la guida a Claude Sonnet 4 per la thinking mode estesa.
I migliori corsi DataCamp
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



