
Leerpad
Grote taalmodellen ontwikkelen
16 uur
Een open-sourcemodel verslaat GPT-5 en Claude Sonnet 4.5 op belangrijke benchmarks voor een fractie van de kosten. Dat model is Kimi K2 Thinking, Moonshot AI’s redeneervariant, uitgebracht in november 2025.
Kimi K2 Thinking kan autonoom 200–300 opeenvolgende tool-calls uitvoeren, waardoor het ideaal is voor complexe agentische workflows. Het legt zijn redeneerproces ook bloot via een speciaal API-veld, zodat je precies kunt zien hoe het problemen aanpakt.
Deze tutorial laat je zien hoe je de Kimi K2 Thinking API gebruikt voor redeneertaken. Je implementeert tool-calling-workflows, bouwt een vergelijkings-chatapp om K2 te testen tegenover GPT-5 en Claude, en leert wanneer de sterke punten van K2 het de betere keuze maken. Wil je meer leren over het bouwen van apps met LLM’s, dan raad ik de Developing LLM Applications with LangChain-cursus aan. Bekijk ook onze andere projecten over GPT-5.1-Codex en Qwen3-Max-Thinking. Ik raad ook onze gids aan voor de nieuwe Kimi K2.5 met Agent Swarm.
Hier is een preview van de app:
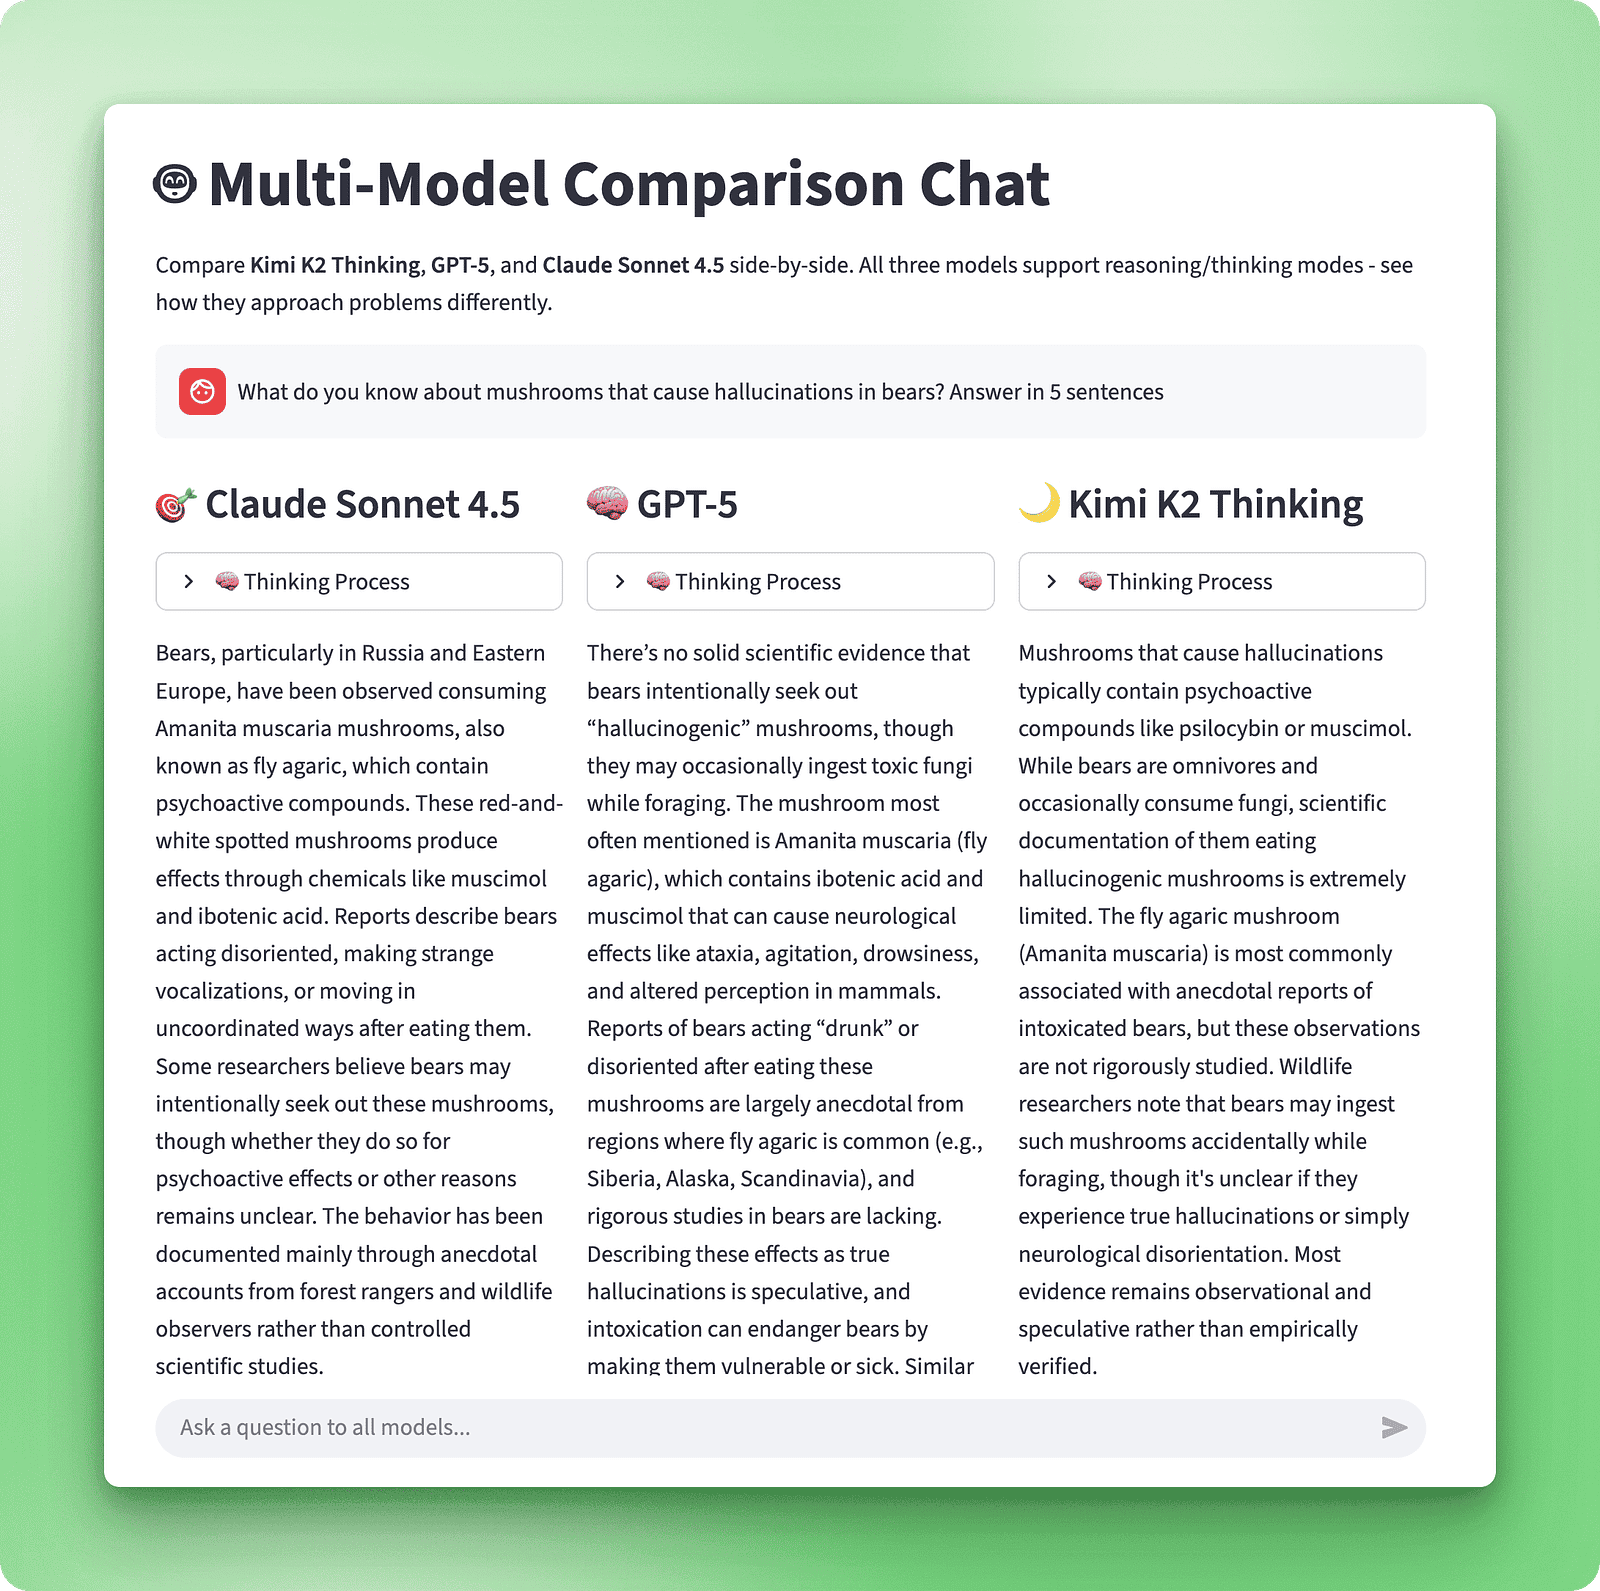
Voordat we met het praktische werk beginnen, kijken we wat K2 Thinking anders maakt dan traditionele taalmodellen.
De meeste taalmodellen genereren direct een reactie. K2 Thinking werkt anders. Het is gebouwd voor meerstapsproblemen waarbij het model zelf moet plannen, redeneren en handelen.
Het model gebruikt een Mixture-of-Experts (MoE)-architectuur met in totaal 1 biljoen parameters. Slechts 32 miljard worden geactiveerd voor een gegeven input. Zo krijgt K2 de kracht van een gigantisch model zonder hoge inferentiekosten. Het contextvenster van 256.000 tokens betekent dat je volledige codebases, lange documenten of uitgebreide gesprekshistorie kunt invoeren zonder te chunkeren.
Moonshot AI bracht twee versies uit. K2 Instruct handelt rechttoe-rechtaan taken af zoals tekstgeneratie, classificatie en simpele Q&A, waar snelheid telt. K2 Thinking is voor complexe redeneertaken.
De eerste grote feature van K2 Thinking is transparant redeneren. Je ziet hoe het problemen opdeelt, opties beoordeelt en tot conclusies komt.
De tweede is tool-orkestratie. K2 beheert uitgebreide opeenvolgende tool-calls, veel verder dan de meeste modellen. Het beslist welke tools te gebruiken, wanneer, en hoe resultaten te combineren zonder dat jij in elke stap hoeft in te grijpen.
K2 bevat features voor verschillende deploybehoeften. Voor productie-scenario’s waar nauwkeurigheid cruciaal is, draait Heavy Mode acht redeneerpaden parallel en kiest het beste antwoord, wel tegen hogere rekenkosten.
Voor latency-gevoelige applicaties verdubbelt INT4-kwantisatie de inferentiesnelheid met minimale nauwkeurigheidsverlies, waardoor het praktisch is voor omgevingen met hoge doorvoer.
Zo verhoudt K2 zich tot GPT-5, Claude Sonnet 4.5 en DeepSeek V3.2.
|
Metriek |
Kimi K2 Thinking |
GPT-5 (High) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (m/ tools) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (m/ python) |
99,1 % |
99,6 % |
100 % |
58,1 % |
|
GPQA |
84,5 |
85,7 |
83,4 |
79,9 |
|
BrowseComp |
60,2 |
54,9 |
24,1 |
40,1 |
|
Frames |
87 |
86 |
85 |
80,2 |
|
SWE-bench Verified |
71,3 % |
74,9 % |
77,2 % |
67,8 % |
|
LiveCodeBench |
83,1 % |
87,0 % |
64,0 % |
74,1 % |
|
Contextvenster |
256 k tokens |
400 k tokens |
200 k tokens |
128 k tokens |
|
Inputkosten |
$0,60 / 1 M |
$1,25 / 1 M |
$3,00 / 1 M |
$0,55 / 1 M |
|
Outputkosten |
$2,50 / 1 M |
$10,00 / 1 M |
$15,00 / 1 M |
$2,19 / 1 M |
|
Max tool-calls |
200–300 |
Tientallen + |
Tientallen + |
Niet gespecificeerd |
Snelle benchmarkdefinities: HLE test kennis op masterniveau, AIME25 gebruikt wiskundeopgaven uit competities, BrowseComp en Frames testen webnavigatie en synthese, SWE-bench Verified meet bugfixing in open-sourcecode, LiveCodeBench test codegeneratie en GPQA betreft wetenschapsvragen op masterniveau.
K2’s tooltraining komt het duidelijkst naar voren op agentische benchmarks. Heavy Mode verslaat GPT-5 met 9 punten op HLE omdat het acht redeneerpaden parallel draait. Claude’s codetraining geeft het de voorsprong op SWE-bench Verified, waardoor het de beste keuze is voor software-engineeringprojecten.
Bij puur redeneren presteren alle drie de modellen ongeveer gelijk. De verschillen ontstaan wanneer tools in het spel komen. K2’s capaciteit van 200–300 tool-calls laat het autonome onderzoeksworkflows, debugpipelines en meerstaps data-analyse afhandelen zonder dat jij in elke fase hoeft in te grijpen.
Je hebt twee opties om K2 Thinking te gebruiken: direct via Moonshot AI’s platform.moonshot.ai, of via OpenRouter, een uniforme API-gateway. We gebruiken OpenRouter omdat het met één API-sleutel toegang biedt tot K2, GPT-5, Claude en tientallen andere modellen. Die uniforme toegang is later essentieel wanneer je de vergelijkings-chatapp bouwt. OpenRouter regelt ook rate limiting en failover automatisch, zodat je geen meerdere provideraccounts hoeft te beheren.
Ga eerst naar openrouter.ai en maak een account aan. Je kunt je aanmelden met Google of GitHub. Ga daarna naar de sectie “Keys” in het dashboard en genereer een nieuwe API-sleutel.
OpenRouter biedt $5 aan gratis tegoed bij aanmelding, genoeg om K2 Thinking op meerdere queries te testen. Heb je meer tegoed nodig, voeg dan een betaalmethode toe in de sectie “Credits”.
Kopieer je API-sleutel en bewaar hem veilig. Je hebt hem zo nodig. Commit deze sleutel niet naar versiebeheer en deel hem niet openbaar, want iedereen met jouw sleutel kan API-calls op jouw account doen.
Laten we nu je Python-omgeving instellen. Je hebt de OpenAI Python SDK nodig, die werkt met de API van OpenRouter omdat ze OpenAI-compatibiliteit aanhouden. Je wilt ook python-dotenv om je API-sleutel veilig te beheren. Installeer beide pakketten:
!pip install openai python-dotenvMaak een .env-bestand in je projectmap en voeg je OpenRouter API-sleutel toe:
OPENROUTER_API_KEY=your_key_hereAls je git gebruikt, voeg .env toe aan je .gitignore-bestand zodat je je credentials niet per ongeluk commit.
Hier is een snelle test om te controleren of alles werkt:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
Output:
15 * 24 = **360**Als je het antwoord ziet, ben je klaar om te gaan.
Eerder noemden we K2’s transparante redeneren. Nu laten we precies zien hoe je dit in je code benadert en gebruikt. K2 Thinking stelt zijn redeneerproces automatisch bloot via een speciaal API-veld.
In tegenstelling tot sommige andere modellen, waar je thinking mode handmatig moet inschakelen, bevat K2 standaard redeneerinhoud in elke reactie.
Wanneer je een API-call naar K2 Thinking doet, bevat de response twee velden. Het content-veld bevat het definitieve antwoord en het reasoning-veld toont het stapsgewijze denkproces. Hier is een praktisch voorbeeld met een kortingberekening die meerdere stappen vereist:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)Output:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
Reasoning process (ingekort voor leesbaarheid):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
Het content-veld geeft je het heldere antwoord dat je gebruikers zien. Het reasoning-veld laat zien hoe K2 het probleem heeft uitgewerkt, wat je helpt te begrijpen of het model daadwerkelijk correct heeft geredeneerd of gewoon geluk had.
K2 genereert redeneertokens tijdens inferentie, niet erna. Dat betekent dat het model het probleem doordenkt vóórdat het zich vastlegt op een antwoord, net zoals jij een wiskundeprobleem eerst op kladpapier zou uitwerken. Het redeneren gebeurt realtime als onderdeel van het generatieproces.
Zet temperature=1.0 wanneer je K2 Thinking gebruikt. Lagere temperaturen beperken de verkenning van het redeneren door het model, wat het doel van Thinking mode ondermijnt. Je wilt ook max_tokens=4096 of hoger omdat redeneerketens tokens innemen vóórdat het definitieve antwoord überhaupt begint.
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
Nu je thinking mode begrijpt, bekijken we K2’s andere kerncapaciteit: tool-calling. Hoewel veel modellen basis-toolgebruik ondersteunen, is K2’s aanpak anders in schaal en autonomie.
Met tool-calling kan K2 functies uitvoeren tijdens het redeneren. Je definieert tools als JSON-schema’s die beschrijven wat elke functie doet en welke parameters nodig zijn. Wanneer K2 externe data of berekening nodig heeft, roept het de juiste tool aan en wacht op resultaten.
Dit creëert een heen-en-weerloop: K2 leest je prompt en redeneert erover. Als er een tool nodig is, retourneert het finish_reason: "tool_calls". Jij voert de functie uit, stuurt de resultaten terug met role: "tool", en K2 gaat verder. Dit herhaalt zich totdat K2 finish_reason: "stop" retourneert met het definitieve antwoord.
Het schema volgt het OpenAI-formaat met een naam, beschrijving en parameters. K2 leest deze om te begrijpen wanneer elke tool te gebruiken. Duidelijke beschrijvingen zijn belangrijk omdat ze de beslissingen van het model sturen.
Laten we een praktische tool bouwen die CSV-bestanden analyseert, een veelvoorkomende datasciencetaak. Deze tool leest een CSV, haalt kolominformatie op en retourneert samenvattende statistieken. Dit laat zien hoe K2 tijdens het redeneren toegang krijgt tot externe data, wat essentieel is voor datagedreven applicaties.
Hier is de volledige implementatie:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
Het schema definieert een functietool volgens het OpenAI-formaat. Het description-veld vertelt K2 wat de tool doet en helpt bepalen wanneer deze te gebruiken.
Het parameters-object specificeert de inputs: filepath is verplicht, terwijl num_rows optioneel is met een standaardwaarde van 10. Duidelijke beschrijvingen helpen K2 begrijpen wanneer deze tool past bij de behoefte van de gebruiker.
De implementatie verzorgt de daadwerkelijke bestandsverwerking:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
De functie valideert het bestandspad en gebruikt vervolgens csv.DictReader om CSV-data te parsen naar dictionaries waarbij sleutels kolomnamen zijn. Het leest de eerste num_rows entries, reset de filepointer met seek(0) en telt het totale aantal rijen.
De geretourneerde dictionary bevat kolomnamen, voorbeelddata, rijenaantal en bestandsgrootte in kilobytes. Foutafhandeling zorgt voor bruikbare feedback als er iets misgaat.
Met je tool gedefinieerd en geïmplementeerd, heb je een lus nodig die het gesprek tussen K2 en je functies afhandelt. Tool-calling is geen one-shot-operatie. K2 kan meerdere iteraties nodig hebben: een tool aanroepen, resultaten analyseren, beslissen of een andere tool nodig is, en herhalen. Dit vereist een lus die het heen-en-weer-gesprek afhandelt totdat K2 zijn definitieve antwoord bereikt.
Hier is de volledige implementatie met een echt voorbeeld:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
Dit initialiseert de OpenAI-client geconfigureerd voor de API van OpenRouter en maakt de initiële berichtenlijst met de vraag van de gebruiker over het analyseren van salarissen van medewerkers.
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
De hoofdlus stuurt de gesprekshistorie naar K2 samen met beschikbare tools. Na het extraheren van de reactie van de assistant en de finish reason, voeg je deze toe aan de berichtenhistorie om de context te behouden.
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
Wanneer K2 tool-calls aanvraagt, voeren we elke functie uit met de meegegeven argumenten en voegen de resultaten terug aan het gesprek toe met bijpassende tool_call_id-waarden. Wanneer K2 klaar is met redeneren en "stop" retourneert, printen we het definitieve antwoord en verlaten de lus.
Maak voor dit voorbeeld een bestand sample_employees.csv met medewerkersdata inclusief kolommen voor naam, afdeling en salaris. Gebruik ongeveer 12 medewerkers verdeeld over de afdelingen Engineering, Marketing, Sales en HR om te testen. Wanneer je deze code draait, roept K2 doorgaans analyze_csv() aan met num_rows op 12 of hoger om volledige dekking te garanderen, identificeert vervolgens Engineering-medewerkers en berekent hun gemiddelde salaris.
Output:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.
De tool_call_id in elke response koppelt resultaten terug aan hun functiecalls. K2 kan meerdere tools in één response aanvragen, dus elk heeft zijn ID nodig voor correcte matching. Het behouden van de volledige gesprekshistorie geeft K2 de context die nodig is voor coherent redeneren over tool-calls heen.
Zodra je je comfortabel voelt met basis-tool-calling, wordt K2’s echte kracht duidelijk: uitgebreide orkestratie. K2 is vanaf het begin getraind op tool-orkestratie, niet als een add-on. Dat verandert hoe het meerstapstaken aanpakt. De meeste modellen redden 20–50 opeenvolgende tool-calls voordat de prestaties afnemen. K2 verwerkt 200–300 terwijl het coherent blijft redeneren.
Die capaciteit is belangrijk voor onafhankelijke workflows waarin het model beslist, informatie verzamelt, resultaten valideert en iteratief werkt tot het probleem is opgelost. Denk aan onderzoekstaken waar K2 databanken doorzoekt, bevindingen kruist, hiaten identificeert, zoekopdrachten verfijnt en alles syntheseert. Of datapijplijnen die op elke stap validatie vereisen. Of debugworkflows die meerdere hypothesen testen.
Is je usecase “voer deze enkele actie uit”, dan werken de meeste modellen prima. Is het “blijf werken tot je dit oplost”, dan wordt K2’s uitgebreide toolcapaciteit de beslissende factor.
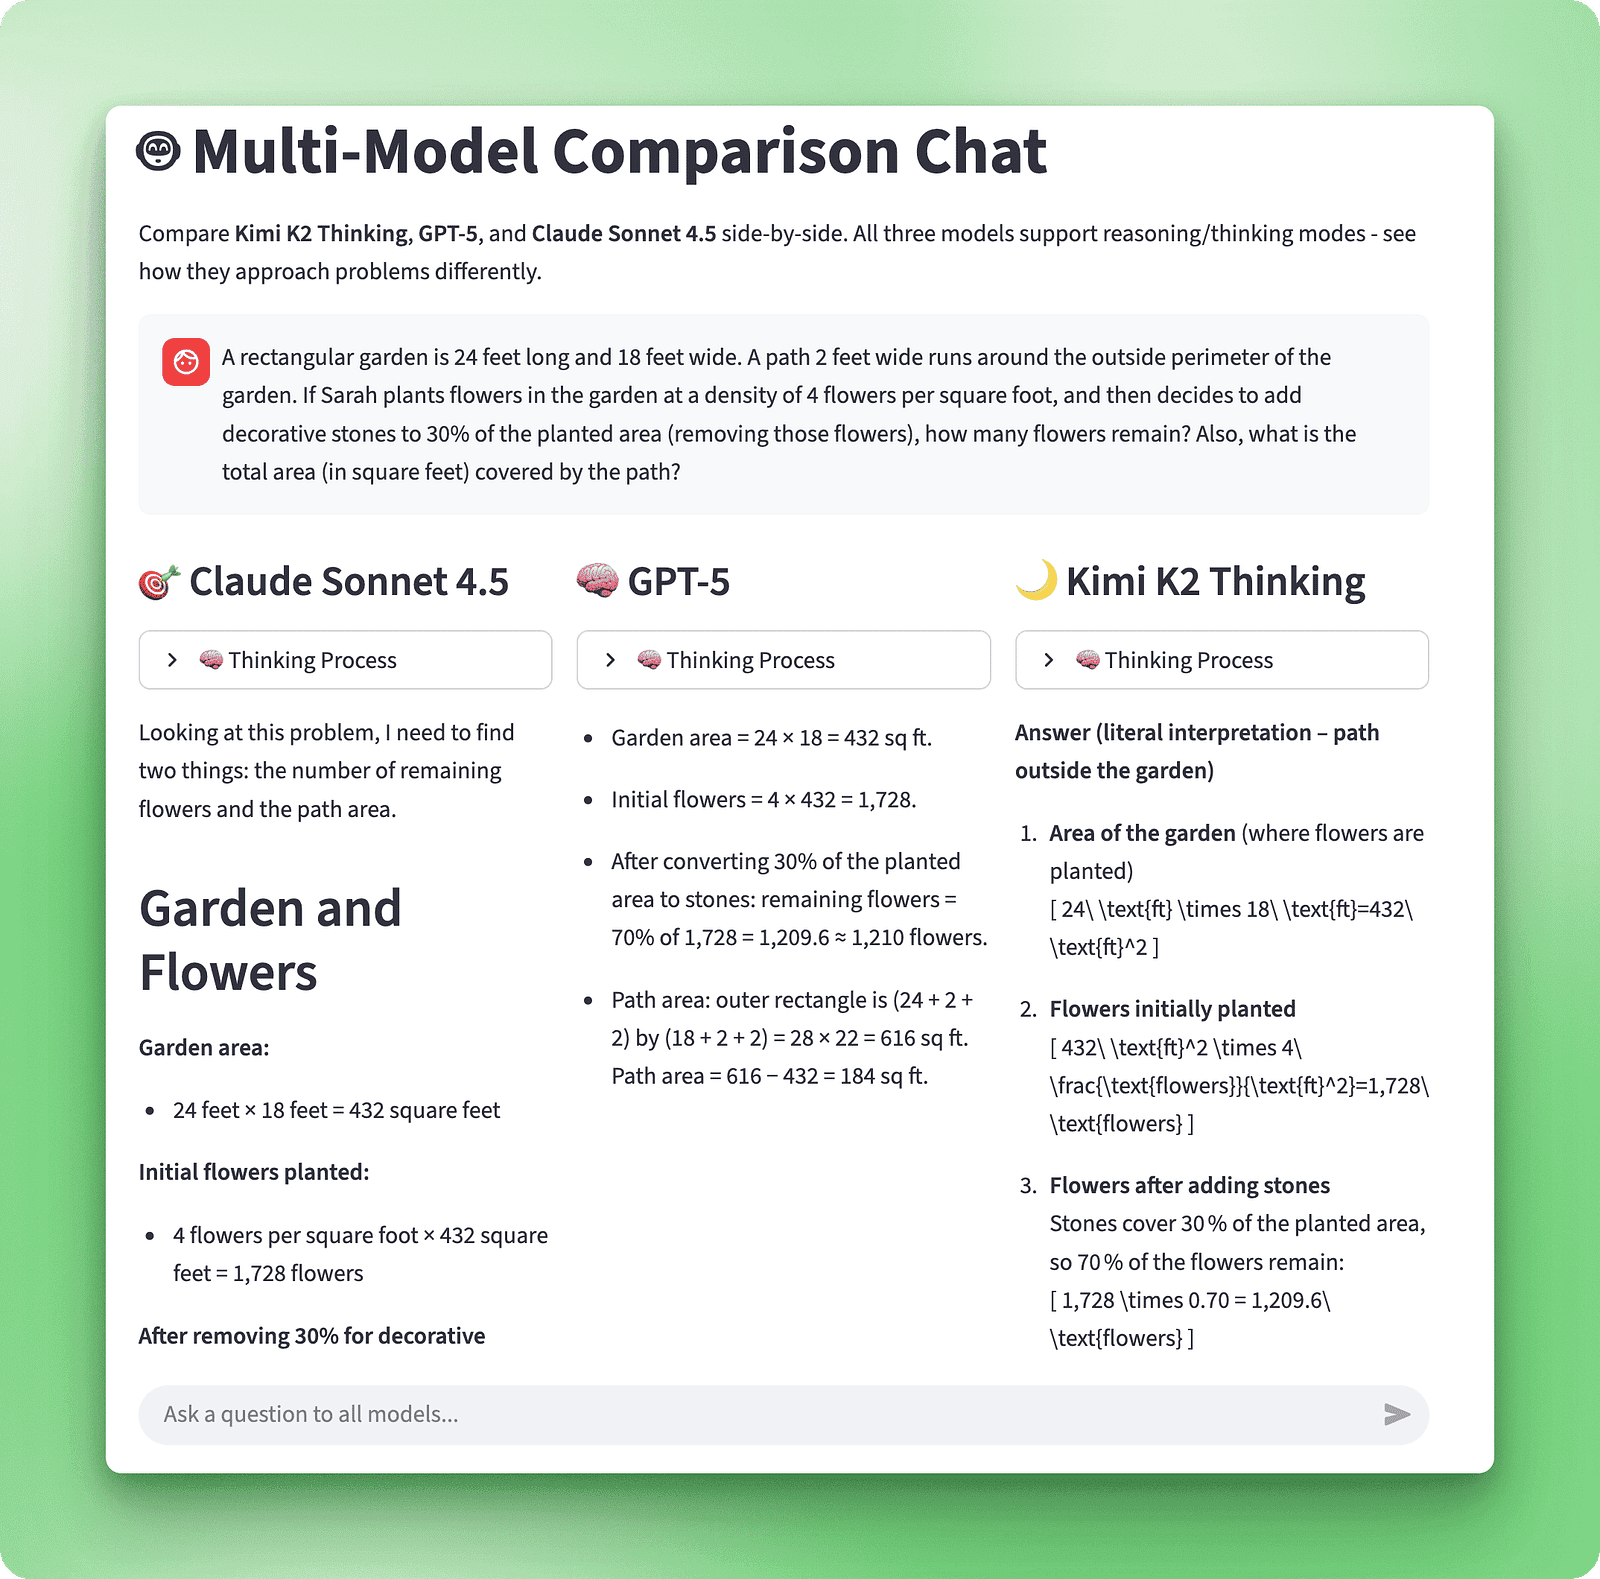
Je hebt gezien hoe K2 Thinking individuele taken aanpakt met tool-calling en transparant redeneren. Nu testen we het tegenover zijn concurrenten. Je bouwt een Streamlit-app die Kimi K2 Thinking, GPT-5 en Claude Sonnet 4.5 tegelijk met dezelfde prompt bevraagt. De interface toont alle drie de reacties naast elkaar zodat je ziet hoe elk model hetzelfde probleem benadert.
Deze vergelijkingsapp vereist API-toegang tot alle drie de modellen. Je hebt je OpenRouter-account nodig (al ingesteld met $5 gratis tegoed), en optioneel OpenAI- en Anthropic-API-sleutels. Het $5-tegoed van OpenRouter zou genoeg moeten zijn om alle drie de modellen op meerdere queries te testen. Heb je alleen OpenRouter-toegang, dan kun je K2 nog steeds vergelijken met andere via OpenRouter beschikbare modellen.
Installeer Streamlit voor de webinterface en de SDK van Anthropic voor toegang tot Claude:
pip install streamlit anthropicMaak een bestand met de naam model_comparison_chat.py. De hele applicatie staat in dit ene bestand. Begin met de imports:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()Je hebt OPENROUTER_API_KEY al in je .env-bestand. Voeg sleutels toe voor GPT-5 en Claude:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
Haal je OpenAI API-sleutel op via platform.openai.com en je Anthropic-sleutel via console.anthropic.com. Voor meer details over de GPT-5-setup, zie de GPT-5-gids. Voor Claude Sonnet 4.5, bekijk het overzicht van Claude Sonnet 4.5.
Initialiseer de drie clients:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))Bouw één uniforme functie die routeert naar het juiste model op basis van de naam. Zo blijft je code overzichtelijk en kun je later makkelijk modellen toevoegen.
Begin met de Kimi K2-call:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5 pakt het anders aan met een responses-endpoint en instelbare reasoning effort:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5 biedt vier niveaus van reasoning effort: minimal, low, medium en high. De responsstructuur scheidt redeneren in samenvattingsblokken en content in message-blokken, die je afzonderlijk parseert voordat je hetzelfde gestandaardiseerde dictionaryformaat retourneert als bij Kimi K2.
Claude Sonnet 4.5 implementeert extended thinking mode met een tokenbudget-aanpak:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude reserveert een tokenbudget voor intern redeneren voordat het het definitieve antwoord genereert. De response bevat meerdere contentblokken waar je doorheen itereert, waarbij je thinking-blokken scheidt van text-blokken. De foutafhandeling aan het eind retourneert dezelfde gestandaardiseerde dictionarystructuur met een foutmelding, zodat mislukte API-calls de interface niet breken.
Met de API-laag klaar, kun je de webinterface bouwen. Configureer eerst de Streamlit-pagina:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
De brede layout creëert ruimte voor drie kolommen naast elkaar. Session state bewaart gesprekshistorie en modelreacties wanneer Streamlit het script opnieuw uitvoert.
Voeg de paginatitel en zijbalkinstellingen toe:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
De zijbalk geeft gebruikers controle over thinking modes. Kimi K2 en Claude hebben binaire toggles. GPT-5 biedt vier redeneringsniveaus omdat de API die fijnmazige controle ondersteunt.
Onder de thinking-instellingen voeg je een API-statusindicator toe zodat gebruikers weten welke services verbonden zijn:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
De vinkjes verschijnen wanneer omgevingsvariabelen zijn gezet. Rode kruisjes betekenen dat je de betreffende sleutel aan je .env-bestand moet toevoegen.
Nu komt de kernfunctionaliteit. Wanneer gebruikers een bericht indienen, roep je alle drie de modellen parallel aan en toon je de resultaten naast elkaar.
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
Deze functie stuurt drie API-calls tegelijk en verzamelt resultaten zodra ze klaar zijn. Sequentiële calls zouden 15–30 seconden duren. Parallelle uitvoering brengt dit terug naar 5–10 seconden omdat je alleen wacht op het langzaamste model in plaats van de som van alle drie.
Integreer parallelle uitvoering in de chatinterface:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
Dit maakt drie kolommen en toont de reactie van elk model in een eigen kolom. Het denkproces start ingeklapt zodat gebruikers eerst de definitieve antwoorden zien. Ze kunnen het denken uitklappen wanneer ze de redenering willen bekijken.
Run de app met:
streamlit run model_comparison_chat.pyBegin met een basistest om te bevestigen dat alles werkt:
What is 2+2?Alle drie de modellen zouden binnen enkele seconden moeten reageren. Dit verifieert je API-verbindingen en bevestigt dat parallelle uitvoering werkt. De app draait lokaal, waardoor jij volledige controle hebt over wanneer API’s worden aangeroepen. Elke query brengt API-kosten met zich mee (ongeveer $0,01–0,05 per drie-modelvergelijking, afhankelijk van de lengte van de reactie), maar lokaal draaien betekent dat jij precies beslist wanneer je uitgeeft.
Je hebt de vergelijkingsapp gebouwd en hem zien werken met simpele vragen. Maar de echte verschillen tussen deze modellen komen naar voren wanneer je ze zwaarder belast. Om deze verschillen te laten zien, testte ik alle drie de modellen met complexe prompts. Je kunt dezelfde tests in je app uitvoeren om de resultaten zelf te zien. Dit zijn de belangrijkste inzichten uit die tests.
We kozen drie verschillende uitdagingen om uiteenlopende redeneervaardigheden te testen.
Een rechthoekige tuin is 24 voet lang en 18 voet breed. Een pad van 2 voet breed loopt rond de buitenomtrek van de tuin. Als Sarah bloemen plant in de tuin met een dichtheid van 4 bloemen per vierkante voet, en vervolgens besluit decoratieve stenen toe te voegen aan 30% van het beplante gebied (waarbij die bloemen worden verwijderd), hoeveel bloemen blijven er over? Wat is bovendien de totale oppervlakte (in vierkante voet) van het pad?
Vier vrienden – Alice, Bob, Carol en David – moeten zich opstellen in een rij voor een foto. De volgende regels gelden:
1. Alice moet naast Bob staan
2. Carol mag niet aan een van beide uiteinden staan
3. David moet links van Alice staan
Som alle geldige opstellingen op van links naar rechts.
Schrijf een Python-functie die controleert of een string een geldig IPv4-adres is, met deze vereisten:
1. Moet het formaat valideren (vier octetten gescheiden door punten)
2. Elk octet moet 0–255 zijn (geen leidende nullen behalve bij "0" zelf)
3. Moet ongeldige formaten afwijzen (lege strings, te veel/te weinig octetten, niet-numerieke tekens)
4. Tijdcomplexiteit moet O(n) zijn waarbij n de stringlengte is
5. Inclusief volledige docstring met voorbeelden
6. Voeg type hints toe voor alle parameters en returnwaarden
7. Behandel randgevallen (lege string, None, speciale tekens)
Leg ook je validatieaanpak uit en waarom deze O(n) is.
Alle drie de modellen losten elk probleem correct op. Maar ze kozen heel verschillende paden. Hier is de prestatie-uitdunning:
|
Test |
Model |
Tijd (sec) |
Tokens |
Resultaat |
|
Tuinprobleem |
Kimi K2 |
28,5 |
3.420 |
✓ Correct (1.209,6 bloemen, 184 sq ft) |
|
GPT-5 |
44,6 |
1.476 |
✓ Correct (1.209,6 bloemen, 184 sq ft) |
|
|
Claude |
19,7 |
1.386 |
✓ Correct (1.210 bloemen, 184 sq ft) |
|
|
Foto-opstelling |
Kimi K2 |
50,5 |
6.249 |
✓ Vond alle 2 geldige opstellingen |
|
GPT-5 |
39,4 |
1.914 |
✓ Vond alle 2 geldige opstellingen |
|
|
Claude |
31,3 |
2.310 |
✓ Vond alle 2 geldige opstellingen |
|
|
IPv4-validator |
Kimi K2 |
192,6 |
5.245 |
✓ Werkende O(n)-oplossing |
|
GPT-5 |
73,7 |
4.233 |
✓ Werkende O(n)-oplossing |
|
|
Claude |
43,1 |
3.330 |
✓ Werkende O(n)-oplossing |
Dit is wat elk model daadwerkelijk doet in die tijd.
Het verkent en stelt zichzelf constant vragen. Bij het tuinprobleem visualiseerde het de opzet, werkte de sommen uit en stopte toen om te zeggen “Wacht, laat me dat even dubbelchecken…” voordat het verderging. Voor de foto-opstelling testte het elke voorwaarde één voor één en liet het zijn werk voor elke mogelijkheid zien.
De IPv4-validator duurde meer dan 3 minuten omdat het randgevallen één voor één overwoog, door het O(n)-complexiteitsbewijs liep en de logica meerdere keren verifieerde. Je kijkt iemand live horen denken, zichzelf corrigeren en de redenering in elke stap checken.
Het is methodisch en georganiseerd. Het brak het tuinprobleem op in duidelijke secties, nummerde de stappen en werkte die op volgorde af. De foto-opstelling kreeg een gestructureerde walkthrough waarin het mensen positie voor positie plaatste met check van de regels.
De code kwam met duidelijke uitleg en goed georganiseerde documentatie. Het twijfelt minder aan zichzelf dan K2, en het haast zich niet zoals Claude. Je krijgt een gebalanceerd beeld van het denken zonder overbodige details.
Het gaat snel. Het identificeerde het oplossingspad snel bij elke test en voerde het netjes uit. Voor het fotoprobleem organiseerde het per geval en werkte elk geval af zonder te blijven hangen. De IPv4-code was schoon en goed gedocumenteerd, maar kwam sneller tot de kern.
Claude toont zijn denken maar blijft niet hangen in verificatiestappen. Snelheid komt uit vertrouwen in de aanpak en minimale terugkoppeling.
Deze verschillende aanpakken creëren een duidelijk trade-offpatroon. Kies K2 wanneer je gedetailleerd redeneren nodig hebt voor leren, debugging of auditvereisten. Kies Claude wanneer snelheid telt en je de resultaten vertrouwt zonder redeneerketens te inspecteren. Kies GPT-5 wanneer je gebalanceerde prestaties wilt tussen de breedsprakigheid van K2 en de snelheid van Claude.
Let op: neem de resultaten van deze test met een korrel zout, want ze kunnen onmogelijk alle capaciteiten van de drie modellen volledig testen.
Je hebt Kimi K2 Thinking ingesteld via OpenRouter, zijn redeneervermogen verkend, tool-calling-workflows gebouwd en een vergelijkingsapp gemaakt om het te testen tegen GPT-5 en Claude. K2’s sterke punten zijn onafhankelijke tool-orkestratie en transparant redeneren, waardoor het goed past bij complexe workflows waarin je beslissingen van het model moet kunnen verifiëren.
K2’s capaciteit en betaalbaarheid maken dit praktisch. Het kan uitgebreide opeenvolgende tool-calls uitvoeren vergeleken met enkele tientallen bij de meeste concurrenten, en het reasoning_content-veld laat elke denkstap zien. Met ongeveer 1/4 van de kosten van GPT-5 en 1/6 van de kosten van Claude voor outputtokens kun je uitgebreide experimenten draaien zonder budgetzorgen.
De vergelijkingsapp die je bouwde geeft je direct bewijs van deze trade-offs. Test hem met je eigen problemen en workflows om gevoel te krijgen of K2’s gedetailleerde redenering de langere reactietijden rechtvaardigt. Tests in de echte wereld met jouw specifieke usecases zullen patronen onthullen die generieke benchmarks niet vangen.
Wil je deze concepten verder uitdiepen, bekijk dan DataCamp’s OpenRouter-tutorial voor het beheren van meerdere LLM-providers, GPT-5-gids voor reasoning effort-niveaus, en Claude Sonnet 4-gids voor extended thinking mode.
Topcursussen op DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

