
लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
एक ओपन‑सोर्स मॉडल मुख्य बेंचमार्क्स पर GPT-5 और Claude Sonnet 4.5 को बहुत कम लागत पर पछाड़ता है। यह मॉडल Kimi K2 Thinking है, Moonshot AI का रीजनिंग वेरिएंट, जो नवंबर 2025 में जारी हुआ।
Kimi K2 Thinking स्वायत्त रूप से 200–300 क्रमिक टूल कॉल्स चला सकता है, जो इसे जटिल एजेंटिक वर्कफ़्लोज़ के लिए आदर्श बनाता है। यह एक समर्पित API फ़ील्ड के माध्यम से अपना विचार‑प्रक्रिया भी दिखाता है, ताकि आप देख सकें कि वह समस्याओं पर कैसे सोचता है।
यह ट्यूटोरियल रीजनिंग कार्यों के लिए Kimi K2 Thinking API का उपयोग करना सिखाता है। आप टूल‑कॉलिंग वर्कफ़्लो लागू करेंगे, K2 की GPT-5 और Claude से तुलना करने के लिए एक चैट ऐप बनाएंगे, और सीखेंगे कि कब K2 की खूबियां उसे बेहतर विकल्प बनाती हैं। यदि आप LLMs के साथ ऐप्स बनाना और सीखना चाहते हैं, तो मैं Developing LLM Applications with LangChain कोर्स की सलाह देता/देती हूं। आप हमारे अन्य प्रोजेक्ट भी देख सकते हैं: GPT-5.1-Codex और Qwen3-Max-Thinking। साथ ही हमारे नए Kimi K2.5 with Agent Swarm गाइड की भी सिफारिश करता/करती हूं।
यह ऐप का प्रीव्यू है:
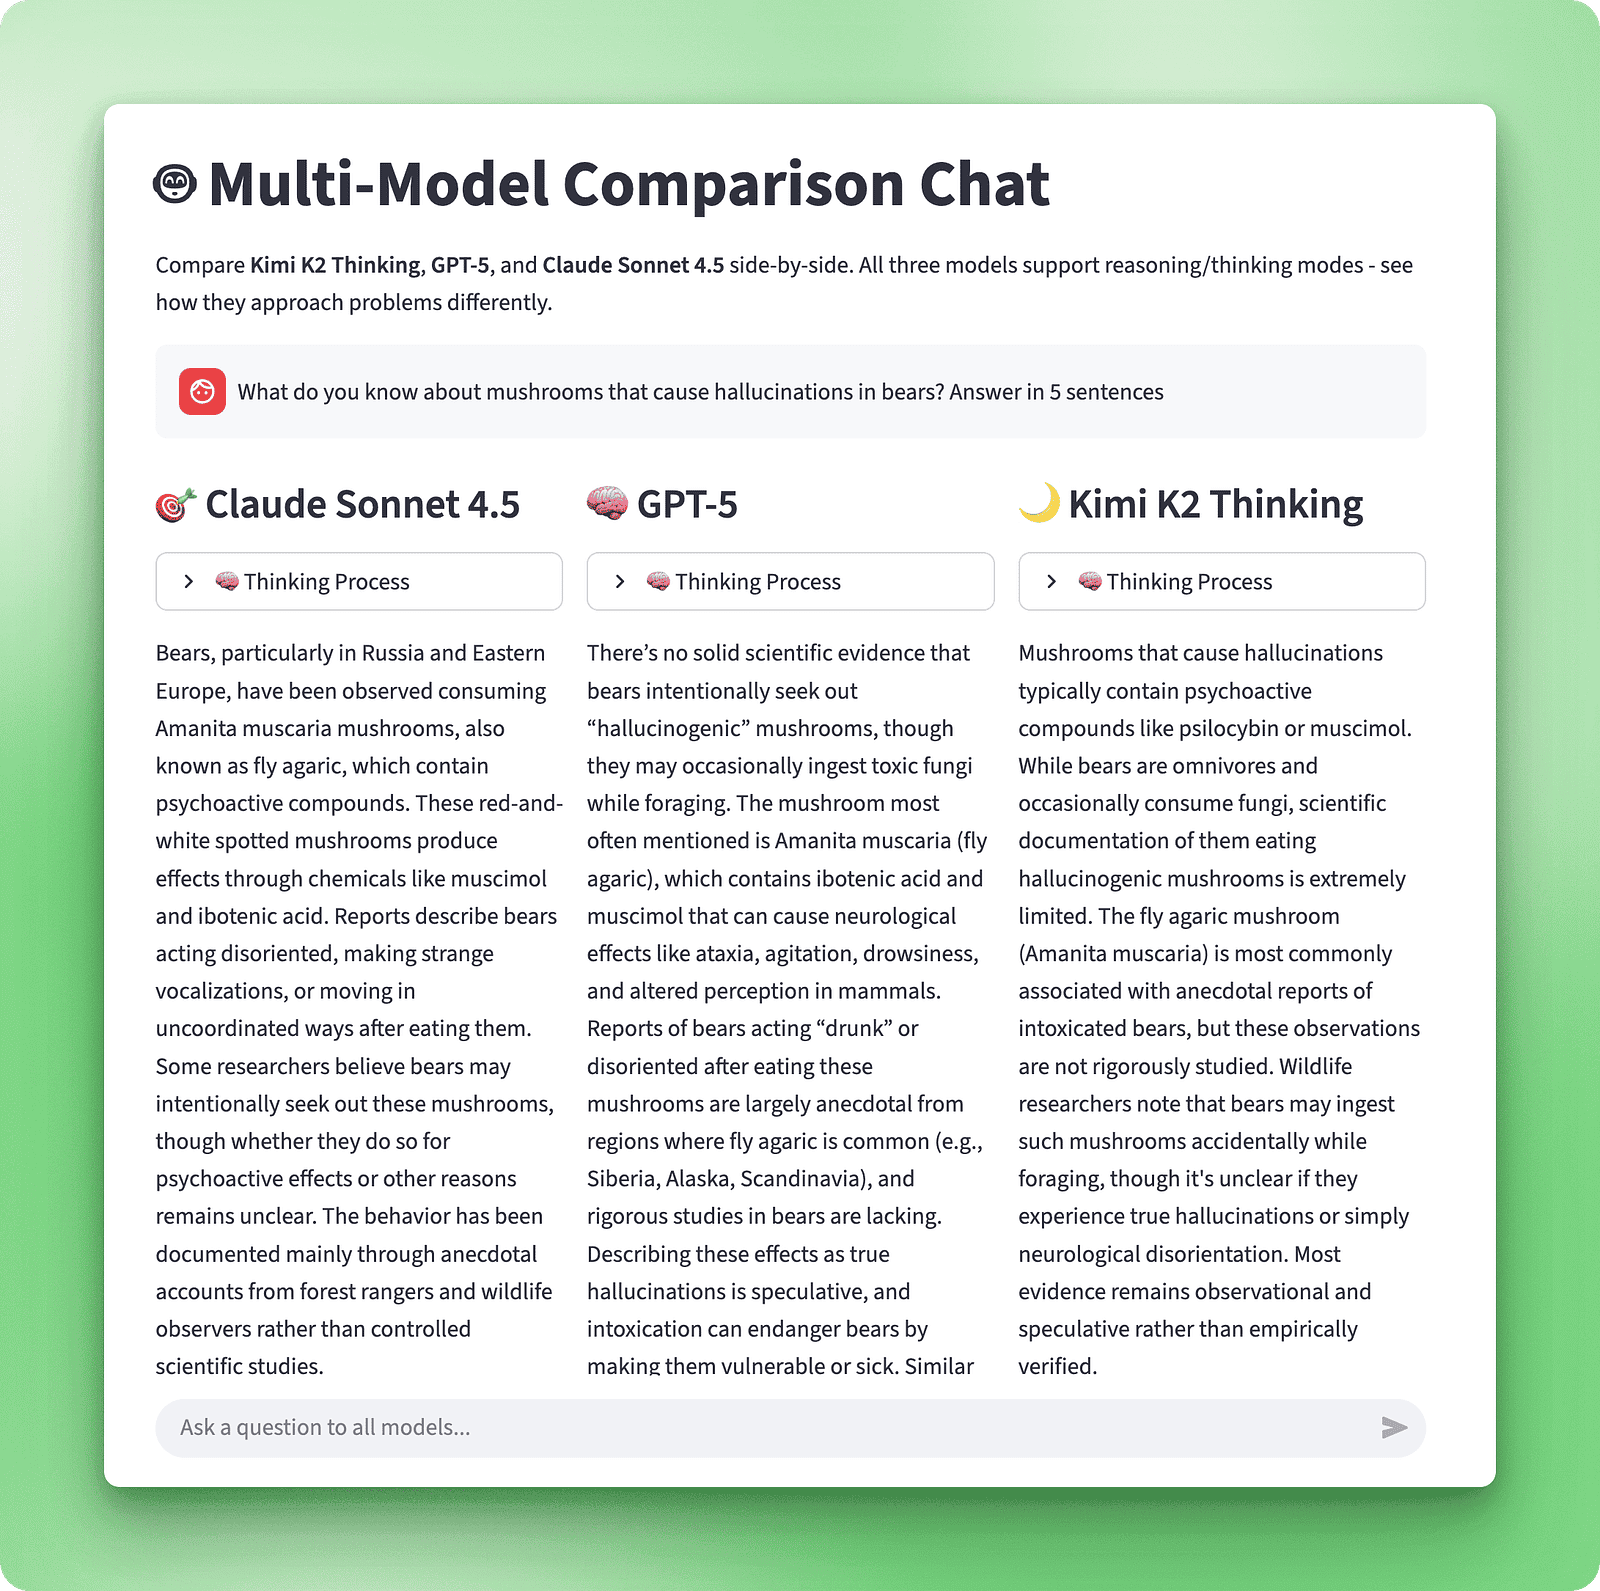
हैंड्स‑ऑन शुरू करने से पहले, समझते हैं कि K2 Thinking पारंपरिक भाषा मॉडलों से अलग कैसे है।
अधिकांश भाषा मॉडल तुरंत उत्तर जनरेट कर देते हैं। K2 Thinking अलग ढंग से काम करता है। यह बहु‑चरणीय समस्याओं के लिए बना है, जहां मॉडल को स्वयं योजना बनानी, तर्क करना और कार्रवाई करनी होती है।
मॉडल Mixture-of-Experts (MoE) आर्किटेक्चर का उपयोग करता है जिसमें 1 ट्रिलियन कुल पैरामीटर हैं। किसी भी इनपुट पर केवल 32 बिलियन सक्रिय होते हैं। इससे K2 को बड़े मॉडल की शक्ति मिलती है, बिना उच्च इन्फ़रेंस लागत के। 256,000‑टोकन कॉन्टेक्स्ट विंडो का मतलब है कि आप पूरे कोडबेस, लंबे दस्तावेज़ या विस्तृत बातचीत इतिहास बिना चंकिंग के दे सकते हैं।
Moonshot AI ने दो संस्करण जारी किए। K2 Instruct तेज़ी मायने रखने वाले सीधे‑सादे कार्य जैसे टेक्स्ट जनरेशन, क्लासिफ़िकेशन और सरल प्रश्न‑उत्तर संभालता है। K2 Thinking जटिल रीजनिंग कार्यों के लिए है।
K2 Thinking की पहली बड़ी विशेषता है पारदर्शी रीजनिंग। आप देख सकते हैं कि यह समस्याओं को कैसे तोड़ता है, विकल्पों का मूल्यांकन करता है और निष्कर्ष तक पहुंचता है।
दूसरी है टूल ऑर्केस्ट्रेशन। K2 व्यापक क्रमिक टूल कॉलिंग संभालता है—जो अधिकांश मॉडलों से कहीं आगे है। यह तय करता है कि कौन सा टूल कब और कैसे उपयोग करना है, और हर चरण पर आपके हस्तक्षेप के बिना परिणामों को संयोजित करता है।
K2 विभिन्न डिप्लॉयमेंट ज़रूरतों के लिए फीचर्स देता है। प्रोडक्शन परिदृश्यों में जहां सटीकता अहम है, Heavy Mode समानांतर में आठ रीजनिंग पाथ चलाता है और सर्वश्रेष्ठ उत्तर चुनता है, हालांकि इसका कम्प्यूटेशनल खर्च ज़्यादा है।
लो‑लेटेंसी ऐप्लिकेशनों के लिए, INT4 क्वांटाइज़ेशन न्यूनतम सटीकता हानि के साथ इन्फ़रेंस गति दोगुनी करता है, जिससे यह हाई‑थ्रूपुट वातावरणों के लिए व्यावहारिक बनता है।
यहाँ K2 की तुलना GPT-5, Claude Sonnet 4.5, और DeepSeek V3.2 से है।
|
मेट्रिक |
Kimi K2 Thinking |
GPT-5 (High) |
Claude Sonnet 4.5 |
DeepSeek-V3.2 |
|
HLE (टूल्स सहित) |
44.9 |
41.7 |
32 |
20.3 |
|
HLE Heavy Mode |
51 |
42 |
— |
— |
|
AIME25 (पाइथन सहित) |
99.1 % |
99.6 % |
100 % |
58.1 % |
|
GPQA |
84.5 |
85.7 |
83.4 |
79.9 |
|
BrowseComp |
60.2 |
54.9 |
24.1 |
40.1 |
|
Frames |
87 |
86 |
85 |
80.2 |
|
SWE-bench Verified |
71.3 % |
74.9 % |
77.2 % |
67.8 % |
|
LiveCodeBench |
83.1 % |
87.0 % |
64.0 % |
74.1 % |
|
कॉन्टेक्स्ट विंडो |
256 k tokens |
400 k tokens |
200 k tokens |
128 k tokens |
|
इनपुट प्राइसिंग |
$0.60 / 1 M |
$1.25 / 1 M |
$3.00 / 1 M |
$0.55 / 1 M |
|
आउटपुट प्राइसिंग |
$2.50 / 1 M |
$10.00 / 1 M |
$15.00 / 1 M |
$2.19 / 1 M |
|
अधिकतम टूल कॉल्स |
200–300 |
दर्जनों + |
दर्जनों + |
निर्दिष्ट नहीं |
त्वरित बेंचमार्क परिभाषाएँ: HLE स्नातकोत्तर‑स्तरीय ज्ञान परखता है, AIME25 प्रतियोगी गणित समस्याओं का उपयोग करता है, BrowseComp और Frames वेब नेविगेशन व सिन्थेसिस जाँचते हैं, SWE-bench Verified ओपन‑सोर्स कोड में बग‑फ़िक्सिंग मापता है, LiveCodeBench कोड जनरेशन परखता है, और GPQA स्नातकोत्तर विज्ञान प्रश्न कवर करता है।
एजेंटिक बेंचमार्क्स पर K2 का टूल प्रशिक्षण सबसे साफ दिखता है। Heavy Mode HLE पर GPT-5 से 9 अंक बेहतर है क्योंकि यह समानांतर में आठ रीजनिंग पाथ चलाता है। SWE-bench Verified पर Claude का कोड प्रशिक्षण उसे बढ़त देता है, जिससे वह सॉफ़्टवेयर इंजीनियरिंग प्रोजेक्ट्स के लिए शीर्ष पसंद बनता है।
शुद्ध रीजनिंग कार्यों में, तीनों मॉडल लगभग समान प्रदर्शन करते हैं। फर्क तब दिखता है जब टूल शामिल होते हैं। K2 की 200–300 टूल कॉल क्षमता उसे स्वायत्त रिसर्च वर्कफ़्लो, डिबगिंग पाइपलाइंस और बहु‑चरणीय डेटा विश्लेषण संभालने देती है, बिना आपके हर चरण पर दखल दिए।
K2 Thinking तक पहुँचने के दो तरीके हैं: सीधे Moonshot AI के platform.moonshot.ai के जरिए, या OpenRouter, जो एकीकृत API गेटवे है, के जरिए। हम OpenRouter का उपयोग करेंगे क्योंकि यह एक ही API कुंजी से K2, GPT-5, Claude और दर्जनों अन्य मॉडलों तक पहुँच देता है। जब आप तुलना‑चैट ऐप बनाएँगे, तो यह एकीकृत पहुँच आवश्यक हो जाएगी। OpenRouter अपने‑आप रेट लिमिटिंग और फ़ेलओवर संभालता है, इसलिए आपको कई प्रदाता खातों को मैनेज नहीं करना पड़ेगा।
पहले openrouter.ai पर जाएँ और एक खाता बनाएँ। आप Google या GitHub से साइन अप कर सकते हैं। लॉग‑इन होने के बाद, डैशबोर्ड के “Keys” सेक्शन में जाएँ और नई API कुंजी जनरेट करें।
OpenRouter साइन‑अप पर $5 के मुफ़्त क्रेडिट देता है, जो K2 Thinking को कई क्वेरीज़ पर टेस्ट करने के लिए काफ़ी है। और क्रेडिट चाहिए हों तो “Credits” सेक्शन में भुगतान विधि जोड़ सकते हैं।
अपनी API कुंजी कॉपी करें और सुरक्षित रखें। आपको यह तुरंत चाहिए होगी। इस कुंजी को वर्शन कंट्रोल में कमिट न करें या सार्वजनिक रूप से साझा न करें, क्योंकि जिसके पास भी यह कुंजी होगी वह आपके खाते से API कॉल कर सकेगा।
अब अपना Python वातावरण सेट करें। आपको OpenAI Python SDK चाहिए, जो OpenRouter की API के साथ काम करता है क्योंकि वे OpenAI कम्पैटिबिलिटी बनाए रखते हैं। API कुंजी को सुरक्षित रूप से मैनेज करने के लिए python-dotenv भी चाहिए होगा। दोनों पैकेज इंस्टॉल करें:
!pip install openai python-dotenvअपने प्रोजेक्ट डायरेक्टरी में .env फ़ाइल बनाएँ और अपनी OpenRouter API कुंजी जोड़ें:
OPENROUTER_API_KEY=your_key_hereयदि आप git का उपयोग कर रहे हैं, तो अपनी .gitignore फ़ाइल में .env जोड़ें ताकि आप गलती से अपने क्रेडेंशियल्स कमिट न कर दें।
यहाँ एक त्वरित टेस्ट है यह सत्यापित करने के लिए कि सब कुछ काम कर रहा है:
import os
from openai import OpenAI
from dotenv import load_dotenv

# Load API key from .env file
load_dotenv()

# Configure client for OpenRouter
client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

# Test call to K2 Thinking
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "What is 15 * 24?"}
   ]
)

print(response.choices[0].message.content)
आउटपुट:
15 * 24 = **360**यदि आप उत्तर देख रहे हैं, तो सब सेट है।
पहले हमने K2 की पारदर्शी रीजनिंग का उल्लेख किया था। अब देखते हैं कि अपने कोड में इसे ठीक‑ठीक कैसे ऐक्सेस और उपयोग करें। K2 Thinking अपने विचार‑प्रक्रिया को एक समर्पित API फ़ील्ड के जरिए अपने‑आप एक्सपोज़ करता है।
कुछ अन्य मॉडलों के विपरीत, जहाँ आपको सोचने का मोड मैन्युअली सक्षम करना पड़ता है, K2 हर उत्तर में डिफ़ॉल्ट रूप से रीजनिंग सामग्री शामिल करता है।
जब आप K2 Thinking को API कॉल करते हैं, तो रिस्पॉन्स में दो फ़ील्ड होते हैं। content फ़ील्ड में अंतिम उत्तर होता है, और reasoning फ़ील्ड चरण‑दर‑चरण सोचने की प्रक्रिया दिखाता है। यहाँ बहु‑चरणों की ज़रूरत वाली एक डिस्काउंट गणना का व्यावहारिक उदाहरण है:
import os
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[
       {"role": "user", "content": "A laptop costs $850. There's a 20% discount today, then 8% sales tax applies to the discounted price. What's the final amount I pay?"}
   ],
   temperature=1.0
)

print("Final answer:")
print(response.choices[0].message.content)
print("\nReasoning process:")
print(response.choices[0].message.reasoning)आउटपुट:
Final answer:
The final amount you pay is **$734.40**.

Here's the breakdown:

1. **Discount:** 20% of $850 = $170
2. **Discounted price:** $850 - $170 = $680
3. **Sales tax:** 8% of $680 = $54.40
4. **Final amount:** $680 + $54.40 = **$734.40**
रीजनिंग प्रक्रिया (पठनीयता के लिए ट्रंकेटेड):
The user wants to know the final amount they will pay for a laptop with a discount and then sales tax applied.

Step 1: Calculate the discount amount.
Discount amount = $850 * 0.20 = $170

Step 2: Calculate the discounted price.
Discounted price = $850 - $170 = $680

Step 3: Calculate the sales tax amount.
Sales tax amount = $680 * 0.08 = $54.40

Step 4: Calculate the final amount to pay.
Final amount = $680 + $54.40 = $734.40

Let me double-check the calculations...
[verification steps omitted]

The final amount is $734.40
content फ़ील्ड वह साफ उत्तर देता है जो आपके उपयोगकर्ता देखते हैं। reasoning फ़ील्ड दिखाता है कि K2 समस्या पर कैसे काम करता गया—जो यह समझने में मदद करता है कि मॉडल ने सच‑मुच सही तर्क किया या बस किस्मत से सही पहुँच गया।
K2 इन्फ़रेंस के दौरान ही रीजनिंग टोकन जनरेट करता है, बाद में नहीं। यानी मॉडल अंतिम उत्तर देने से पहले समस्या पर सोचता है—जैसे आप अंतिम उत्तर लिखने से पहले रफ़ कागज़ पर गणना करते हैं। रीजनिंग रीयल‑टाइम में जनरेशन प्रक्रिया का हिस्सा होती है।
temperature=1.0 सेट करें। कम तापमान मॉडल की एक्सप्लोरेटरी रीजनिंग को सीमित करता है, जो Thinking मोड के उद्देश्य के विपरीत है। साथ ही max_tokens=4096 या उससे अधिक रखें क्योंकि अंतिम उत्तर शुरू होने से पहले ही रीजनिंग चेन टोकन ले लेती हैं।
response = client.chat.completions.create(
   model="moonshotai/kimi-k2-thinking",
   messages=[{"role": "user", "content": "Your question here"}],
   temperature=1.0,
   max_tokens=4096
)
अब जब आप Thinking मोड समझ गए हैं, तो K2 की दूसरी मुख्य क्षमता—टूल कॉलिंग—देखते हैं। कई मॉडल बुनियादी टूल उपयोग सपोर्ट करते हैं, पर K2 का पैमाना और स्वायत्तता अलग है।
टूल कॉलिंग K2 को रीजनिंग के दौरान फ़ंक्शनों को निष्पादित करने देती है। आप टूल्स को JSON स्कीमा के रूप में परिभाषित करते हैं—वे क्या करते हैं और किन पैरामीटर्स की ज़रूरत है। जब K2 को बाहरी डेटा या कंप्यूटेशन चाहिए होता है, वह सही टूल कॉल करता है और परिणाम का इंतज़ार करता है।
इससे आगे‑पीछे का लूप बनता है: K2 आपका प्रॉम्प्ट पढ़ता और उस पर तर्क करता है। यदि उसे टूल चाहिए, तो वह finish_reason: "tool_calls" लौटाता है। आप फ़ंक्शन चलाते हैं, role: "tool" के साथ परिणाम वापस भेजते हैं, और K2 जारी रखता है। यह तब तक दोहरता है जब तक K2 finish_reason: "stop" के साथ अंतिम उत्तर नहीं देता।
स्कीमा OpenAI के फ़ॉर्मेट का अनुसरण करता है—नाम, विवरण और पैरामीटर्स। K2 इन्हें पढ़कर समझता है कि किस टूल का उपयोग कब करना है। साफ विवरण इसलिए अहम हैं क्योंकि वे मॉडल के निर्णयों को गाइड करते हैं।
आइए एक व्यावहारिक टूल बनाते हैं जो CSV फ़ाइलों का विश्लेषण करता है—यह डेटा साइंस में सामान्य कार्य है। यह टूल CSV पढ़ता है, कॉलम जानकारी निकालता है और सारांश आँकड़े लौटाता है। यह दिखाता है कि K2 रीजनिंग के दौरान बाहरी डेटा तक कैसे पहुँच सकता है—जो डेटा‑संचालित ऐप्लिकेशनों के लिए आवश्यक है।
यह रहा पूरा इम्प्लीमेंटेशन:
import csv
import os
import json

# Define the tool schema
tools = [
   {
       "type": "function",
       "function": {
           "name": "analyze_csv",
           "description": "Read and analyze the first few rows of a CSV file. Returns columns, sample rows, total row count, and file size.",
           "parameters": {
               "type": "object",
               "properties": {
                   "filepath": {
                       "type": "string",
                       "description": "Path to the CSV file"
                   },
                   "num_rows": {
                       "type": "integer",
                       "description": "Number of rows to read",
                       "default": 10
                   }
               },
               "required": ["filepath"]
           }
       }
   }
]
स्कीमा OpenAI फ़ॉर्मेट के अनुरूप एक फ़ंक्शन टूल परिभाषित करता है। description फ़ील्ड K2 को बताता है कि टूल क्या करता है और कब इसका उपयोग करना है।
parameters ऑब्जेक्ट इनपुट्स निर्दिष्ट करता है: filepath आवश्यक है, जबकि num_rows वैकल्पिक है और डिफ़ॉल्ट मान 10 है। साफ विवरण K2 को समझने में मदद करते हैं कि कब यह टूल उपयोगकर्ता की ज़रूरतों से मेल खाता है।
इम्प्लीमेंटेशन वास्तविक फ़ाइल प्रोसेसिंग संभालता है:
# Implement the function
def analyze_csv(filepath: str, num_rows: int = 10) -> dict:
   if not os.path.exists(filepath):
       return {"error": f"File not found: {filepath}"}

   try:
       with open(filepath, 'r') as f:
           reader = csv.DictReader(f)
           columns = reader.fieldnames
           sample_rows = [dict(row) for i, row in enumerate(reader) if i < num_rows]
           f.seek(0)
           total_rows = sum(1 for _ in f) - 1

       return {
           "columns": list(columns),
           "sample_rows": sample_rows,
           "total_rows": total_rows,
           "file_size_kb": round(os.path.getsize(filepath) / 1024, 2)
       }
   except Exception as e:
       return {"error": str(e)}
फ़ंक्शन फ़ाइल पाथ को वैलिडेट करता है, फिर csv.DictReader से CSV डेटा पार्स करता है जहाँ कीज़ कॉलम नाम होते हैं। यह पहले num_rows एंट्री पढ़ता है, seek(0) से फ़ाइल पॉइंटर रीसेट करता है और कुल पंक्तियाँ गिनता है।
रिटर्न डिक्शनरी में कॉलम नाम, सैंपल डेटा, रो काउंट और फ़ाइल साइज़ (KB में) शामिल हैं। एरर हैंडलिंग असफलता पर उपयोगी फीडबैक सुनिश्चित करती है।
टूल परिभाषित और इम्प्लीमेंट करने के बाद, आपको एक लूप चाहिए जो K2 और आपके फ़ंक्शनों के बीच बातचीत को संभाले। टूल कॉलिंग एक वन‑शॉट ऑपरेशन नहीं है। K2 को कई इटरेशन चाहिए हो सकते हैं: टूल कॉल करना, परिणामों का विश्लेषण, ज़रूरत पड़े तो दूसरा टूल चुनना, और दोहराना। इसके लिए एक लूप चाहिए जो आगे‑पीछे की बातचीत संभाले, जब तक K2 अंतिम उत्तर तक न पहुँच जाए।
यह रहा वास्तविक उदाहरण के साथ पूरा इम्प्लीमेंटेशन:
from openai import OpenAI

client = OpenAI(
   base_url="https://openrouter.ai/api/v1",
   api_key=os.getenv("OPENROUTER_API_KEY")
)

messages = [
   {"role": "user", "content": "Analyze sample_employees.csv and tell me the average salary for Engineering department employees."}
]
यह OpenRouter की API के लिए कॉन्फ़िगर्ड OpenAI क्लाइंट इनिशियलाइज़ करता है और कर्मचारी वेतन विश्लेषण के उपयोगकर्ता क्वेरी के साथ शुरुआती मैसेज सूची बनाता है।
while True:
   response = client.chat.completions.create(
       model="moonshotai/kimi-k2-thinking",
       messages=messages,
       tools=tools,
       temperature=1.0
   )

   message = response.choices[0].message
   finish_reason = response.choices[0].finish_reason

   messages.append({
       "role": "assistant",
       "content": message.content,
       "tool_calls": message.tool_calls
   })
मुख्य लूप बातचीत इतिहास और उपलब्ध टूल्स के साथ K2 को भेजता है। असिस्टेंट का उत्तर और फ़िनिश रीजन निकालने के बाद, संदर्भ बनाए रखने के लिए उसे इतिहास में जोड़ते हैं।
  if finish_reason == "tool_calls":
       for tool_call in message.tool_calls:
           function_name = tool_call.function.name
           arguments = json.loads(tool_call.function.arguments)

           if function_name == "analyze_csv":
               result = analyze_csv(**arguments)

           messages.append({
               "role": "tool",
               "content": json.dumps(result),
               "tool_call_id": tool_call.id
           })

   elif finish_reason == "stop":
       print(message.content)
       break
जब K2 टूल कॉल्स का अनुरोध करता है, हम दिए गए आर्ग्युमेंट्स के साथ हर फ़ंक्शन चलाते हैं और मेल खाते tool_call_id के साथ परिणाम बातचीत में जोड़ते हैं। जब K2 "stop" लौटाता है, हम अंतिम उत्तर प्रिंट करते हैं और लूप से बाहर निकलते हैं।
इस उदाहरण के लिए, sample_employees.csv फ़ाइल बनाएँ जिसमें नाम, डिपार्टमेंट और सैलरी कॉलम हों। Engineering, Marketing, Sales और HR के लगभग 12 कर्मचारियों का डेटा रखें। कोड चलाने पर, K2 आमतौर पर num_rows 12 या उससे अधिक के साथ analyze_csv() कॉल करता है ताकि पूरा डेटा आ जाए, फिर Engineering कर्मचारियों की पहचान कर उनका औसत वेतन निकालता है।
आउटपुट:
Based on the CSV data, I found 5 Engineering employees in the sample:
- Alice Johnson: $95,000
- Carol White: $110,000
- Eve Davis: $88,000
- Iris Martinez: $102,000
- Kate Thomas: $92,000

The average salary for Engineering department employees is $97,400.
tool_call_id हर रिस्पॉन्स में परिणामों को उनकी फ़ंक्शन कॉल्स से जोड़ता है। K2 एक ही रिस्पॉन्स में कई टूल्स का अनुरोध कर सकता है, इसलिए सही मिलान के लिए हर एक का ID चाहिए। पूरी बातचीत का इतिहास सुरक्षित रखने से K2 को टूल कॉल्स के पार सुसंगत रीजनिंग के लिए ज़रूरी संदर्भ मिलता है।
बुनियादी टूल कॉलिंग में सहज होने के बाद, K2 की असली ताकत स्पष्ट होती है: विस्तारित ऑर्केस्ट्रेशन। K2 को शुरुआत से ही टूल ऑर्केस्ट्रेशन के लिए प्रशिक्षित किया गया है, किसी ऐड‑ऑन की तरह नहीं। इससे यह मल्टी‑स्टेप टास्क्स को अलग तरह से संभालता है। अधिकांश मॉडल 20–50 क्रमिक टूल कॉल्स तक संभालते हैं, उसके बाद प्रदर्शन गिरता है। K2 200–300 कॉल्स तक सुसंगत रीजनिंग बनाए रखता है।
यह क्षमता उन स्वतंत्र वर्कफ़्लोज़ के लिए मायने रखती है जहाँ मॉडल निर्णय करता है, जानकारी जुटाता है, परिणामों को वैलिडेट करता है और समस्या सुलझने तक इटरेट करता है। सोचिए रिसर्च टास्क्स जहाँ K2 डेटाबेस खोजता है, निष्कर्षों का क्रॉस‑रेफ़रेंस करता है, गैप्स पहचानता है, क्वेरीज़ परिष्कृत करता है और सब कुछ सिंथेसाइज़ करता है। या डेटा पाइपलाइंस जिन्हें हर चरण में वैलिडेशन चाहिए। या डिबगिंग वर्कफ़्लोज़ जो कई परिकल्पनाएँ जाँचते हैं।
यदि आपका उपयोग‑मामला है “यह एकल कार्रवाई करो,” तो अधिकांश मॉडल ठीक हैं। यदि यह है “हल होने तक काम करते रहो,” तो K2 की विस्तारित टूल क्षमता निर्णायक बन जाती है।
आपने देखा कि K2 Thinking टूल कॉलिंग और पारदर्शी रीजनिंग के साथ व्यक्तिगत कार्य कैसे संभालता है। अब इसे उसके प्रतिस्पर्धियों के खिलाफ परखते हैं। आप एक Streamlit ऐप बनाएँगे जो एक ही प्रॉम्प्ट से Kimi K2 Thinking, GPT-5 और Claude Sonnet 4.5 को साथ‑साथ क्वेरी करता है। इंटरफ़ेस तीनों उत्तरों को साथ‑साथ दिखाता है ताकि आप देखें कि हर मॉडल एक ही समस्या को कैसे हल करता है।
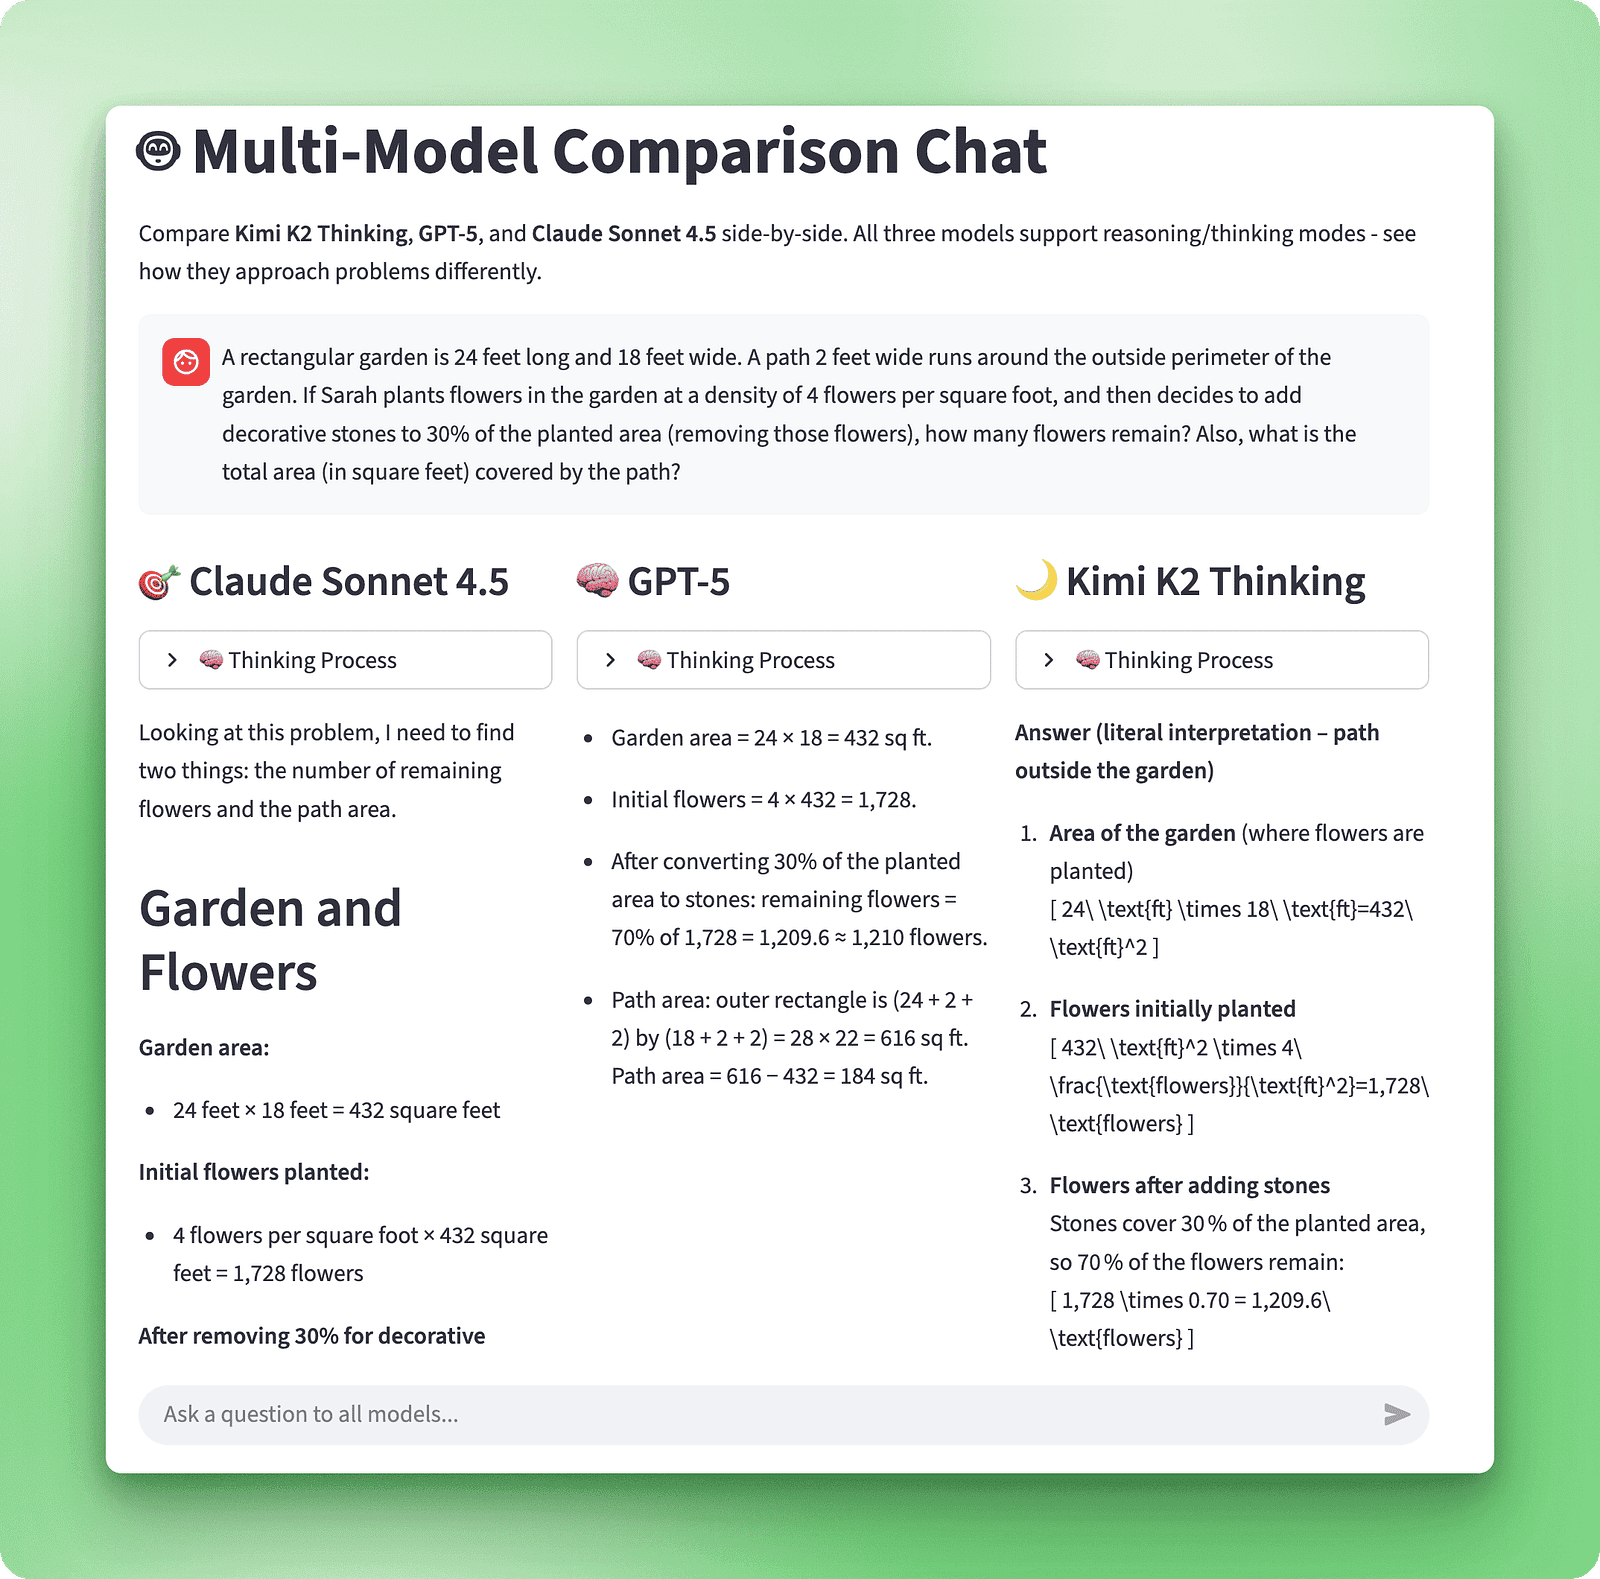
इस तुलना ऐप के लिए तीनों मॉडलों की API पहुँच चाहिए। आपको अपना OpenRouter खाता (पहले से $5 मुफ़्त क्रेडिट के साथ), और वैकल्पिक रूप से OpenAI और Anthropic API कुंजियाँ चाहिए होंगी। OpenRouter के $5 क्रेडिट कई क्वेरीज़ पर तीनों मॉडलों को टेस्ट करने के लिए काफ़ी हैं। यदि आपके पास केवल OpenRouter है, तब भी आप K2 की उन अन्य मॉडलों से तुलना कर सकते हैं जो OpenRouter पर उपलब्ध हैं।
वेब इंटरफ़ेस के लिए Streamlit और Claude ऐक्सेस के लिए Anthropic का SDK इंस्टॉल करें:
pip install streamlit anthropicएक फ़ाइल बनाएँ जिसका नाम हो model_comparison_chat.py। पूरा ऐप इसी एक फ़ाइल में रहेगा। इम्पोर्ट्स से शुरू करें:
import os
import time
from typing import Dict, List
from concurrent.futures import ThreadPoolExecutor, as_completed
from dotenv import load_dotenv
import streamlit as st
from openai import OpenAI
from anthropic import Anthropic

load_dotenv()आपके पास .env में पहले से OPENROUTER_API_KEY है। GPT-5 और Claude के लिए कुंजियाँ जोड़ें:
OPENROUTER_API_KEY=your_openrouter_key  # Already set up
OPENAI_API_KEY=your_openai_key           # Add this
ANTHROPIC_API_KEY=your_anthropic_key     # Add this
अपनी OpenAI API कुंजी platform.openai.com से और Anthropic कुंजी console.anthropic.com से लें। GPT-5 सेटअप पर और विवरण के लिए GPT-5 गाइड देखें। Claude Sonnet 4.5 के लिए Claude Sonnet 4.5 ओवरव्यू देखें।
तीनों क्लाइंट इनिशियलाइज़ करें:
KIMI_CLIENT = OpenAI(
   api_key=os.getenv("OPENROUTER_API_KEY"),
   base_url="https://openrouter.ai/api/v1"
)
GPT_CLIENT = OpenAI(api_key=os.getenv("OPENAI_API_KEY"))
CLAUDE_CLIENT = Anthropic(api_key=os.getenv("ANTHROPIC_API_KEY"))एक एकीकृत फ़ंक्शन बनाएँ जो नाम के आधार पर सही मॉडल को रूट करता है। इससे कोड साफ रहता है और बाद में और मॉडल जोड़ना आसान होता है।
Kimi K2 कॉल से शुरू करें:
def call_model(model_name: str, messages: List[Dict], **kwargs) -> Dict:
   """Call any model with unified interface."""
   try:
       start_time = time.time()

       if model_name == "Kimi K2 Thinking":
           enable_thinking = kwargs.get("enable_thinking", True)

           completion = KIMI_CLIENT.chat.completions.create(
               model="moonshotai/kimi-k2-thinking",
               messages=messages,
               temperature=1.0,
               extra_body={"include_reasoning": True}
           )

           message = completion.choices[0].message
           content = message.content

           # Extract reasoning from the dedicated field
           reasoning_content = None
           if enable_thinking and hasattr(message, 'reasoning') and message.reasoning:
               reasoning_content = message.reasoning

           return {
               "content": content,
               "reasoning_content": reasoning_content,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": completion.usage.prompt_tokens,
                   "output": completion.usage.completion_tokens,
                   "total": completion.usage.total_tokens
               },
               "error": None
           }
GPT-5 एक अलग अप्रोच लेता है—responses endpoint और कॉन्फ़िगरेबल रीजनिंग effort के साथ:
      elif model_name == "GPT-5":
           reasoning_effort = kwargs.get("reasoning_effort", "medium")
           input_messages = [
               {"role": m["role"], "content": m["content"]}
               for m in messages
           ]

           response = GPT_CLIENT.responses.create(
               model="gpt-5",
               input=input_messages,
               reasoning={
                   "effort": reasoning_effort,
                   "summary": "auto"
               }
           )

           # Parse response structure
           reasoning_text = None
           content_text = ""

           for item in response.output:
               if item.type == "reasoning" and hasattr(item, "summary"):
                   summaries = [s.text for s in item.summary if hasattr(s, "text")]
                   reasoning_text = "\n\n".join(summaries) if summaries else None
               elif item.type == "message" and hasattr(item, "content"):
                   content_text += "".join(c.text for c in item.content if hasattr(c, "text"))

           return {
               "content": content_text,
               "reasoning_content": reasoning_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": getattr(response.usage, "input_tokens", 0),
                   "output": getattr(response.usage, "output_tokens", 0),
                   "total": getattr(response.usage, "total_tokens", 0)
               },
               "error": None
           }
GPT-5 चार रीजनिंग effort स्तर देता है: minimal, low, medium, और high। रिस्पॉन्स स्ट्रक्चर रीजनिंग को समरी ब्लॉक्स में और कंटेंट को मैसेज ब्लॉक्स में अलग करता है—इन्हें अलग‑अलग पार्स कर, Kimi K2 जैसा ही मानकीकृत डिक्शनरी फ़ॉर्मेट लौटाते हैं।
Claude Sonnet 4.5 टोकन बजट अप्रोच के साथ एक्सटेंडेड थिंकिंग मोड लागू करता है:
    else:  # Claude Sonnet 4.5
           enable_thinking = kwargs.get("enable_thinking", True)
           params = {
               "model": "claude-sonnet-4-5",
               "max_tokens": 10000,
               "messages": messages
           }
           if enable_thinking:
               params["thinking"] = {
                   "type": "enabled",
                   "budget_tokens": 5000
               }

           message = CLAUDE_CLIENT.messages.create(**params)

           # Extract content and thinking blocks
           content_text = ""
           thinking_text = None

           for block in message.content:
               if block.type == "thinking":
                   thinking_text = block.thinking
               elif block.type == "text":
                   content_text += block.text

           return {
               "content": content_text,
               "reasoning_content": thinking_text,
               "response_time": time.time() - start_time,
               "tokens_used": {
                   "input": message.usage.input_tokens,
                   "output": message.usage.output_tokens,
                   "total": message.usage.input_tokens + message.usage.output_tokens
               },
               "error": None
           }

   except Exception as e:
       return {
           "content": None,
           "reasoning_content": None,
           "response_time": 0,
           "tokens_used": {"input": 0, "output": 0, "total": 0},
           "error": f"{model_name} Error: {str(e)}"
       }
Claude अंतिम उत्तर जनरेट करने से पहले आंतरिक रीजनिंग के लिए टोकन बजट आवंटित करता है। रिस्पॉन्स में कई कंटेंट ब्लॉक्स होते हैं—आप थिंकिंग ब्लॉक्स और टेक्स्ट ब्लॉक्स अलग‑अलग निकालते हैं। अंत का एरर हैंडलिंग उसी मानकीकृत डिक्शनरी स्ट्रक्चर में एरर संदेश लौटाता है, ताकि असफल API कॉल्स इंटरफ़ेस को न तोड़ें।
API लेयर तैयार होने के बाद, आप वेब इंटरफ़ेस बना सकते हैं। पहले Streamlit पेज कॉन्फ़िगर करें:
def main():
   st.set_page_config(
       page_title="Multi-Model Comparison Chat",
       page_icon="🤖",
       layout="wide",
       initial_sidebar_state="expanded"
   )

   st.session_state.setdefault("messages", [])
   st.session_state.setdefault("model_responses", [])
वाइड लेआउट तीन कॉलम्स के लिए जगह बनाता है। सेशन स्टेट Streamlit के रीरन होने पर भी बातचीत इतिहास और मॉडल उत्तरों को बचाए रखता है।
पेज शीर्षक और साइडबार कंट्रोल जोड़ें:
st.title("🤖 Multi-Model Comparison Chat")
   st.markdown("""
   Compare **Kimi K2 Thinking**, **GPT-5**, and **Claude Sonnet 4.5** side-by-side.
   All three models support reasoning modes - see how they approach problems differently.
   """)

   with st.sidebar:
       st.header("⚙️ Settings")

       st.subheader("Thinking Mode")
       kimi_thinking = st.checkbox("Enable Kimi K2 Thinking", value=True)
       gpt5_reasoning = st.selectbox(
           "GPT-5 Reasoning Effort",
           options=["minimal", "low", "medium", "high"],
           index=2
       )
       claude_thinking = st.checkbox("Enable Claude Thinking", value=True)
साइडबार उपयोगकर्ताओं को थिंकिंग मोड्स पर नियंत्रण देता है। Kimi K2 और Claude के लिए बाइनरी टॉगल है। GPT-5 चार स्तर देता है क्योंकि उसकी API यह सूक्ष्म नियंत्रण उपलब्ध कराती है।
थिंकिंग कंट्रोल्स के नीचे एक API स्टेटस इंडिकेटर जोड़ें ताकि उपयोगकर्ता जान सकें कि कौन सी सेवाएँ कनेक्टेड हैं:
st.subheader("API Status")
       st.markdown(f"""
       - Kimi K2: {"✅" if os.getenv("OPENROUTER_API_KEY") else "❌"}
       - GPT-5: {"✅" if os.getenv("OPENAI_API_KEY") else "❌"}
       - Claude: {"✅" if os.getenv("ANTHROPIC_API_KEY") else "❌"}
       """)
एंवायरनमेंट वेरिएबल सेट होने पर चेकमार्क दिखते हैं। लाल X का मतलब है कि संबंधित कुंजी .env में जोड़नी होगी।
अब मुख्य फ़ंक्शनलिटी आती है। जब उपयोगकर्ता कोई संदेश सबमिट करते हैं, तो आप तीनों मॉडलों को समानांतर में कॉल करेंगे और परिणाम साथ‑साथ दिखाएँगे।
def call_models_parallel(messages: List[Dict], selected_models: List[str],
                       kimi_thinking: bool, gpt5_reasoning: str,
                       claude_thinking: bool) -> Dict[str, Dict]:
   """Call multiple models in parallel."""
   model_kwargs = {
       "Kimi K2 Thinking": {"enable_thinking": kimi_thinking},
       "GPT-5": {"reasoning_effort": gpt5_reasoning},
       "Claude Sonnet 4.5": {"enable_thinking": claude_thinking}
   }

   with ThreadPoolExecutor(max_workers=3) as executor:
       futures = {
           executor.submit(call_model, m, messages, **model_kwargs[m]): m
           for m in selected_models if m in model_kwargs
       }
       return {futures[f]: f.result() for f in as_completed(futures)}
यह फ़ंक्शन एक साथ तीन API कॉल सबमिट करता है और जैसे‑जैसे पूरी होती हैं, परिणाम एकत्र करता है। क्रमिक कॉल्स में 15–30 सेकंड लग सकते हैं। समानांतर एग्ज़ीक्यूशन इसे 5–10 सेकंड तक घटा देता है क्योंकि आप तीनों के योग की जगह सबसे धीमे मॉडल का इंतज़ार कर रहे होते हैं।
समानांतर एग्ज़ीक्यूशन को चैट इंटरफ़ेस में जोड़ें:
   if prompt := st.chat_input("Ask a question to all models..."):
       st.session_state.messages.append({"role": "user", "content": prompt})

       with st.chat_message("user"):
           st.markdown(prompt)

       api_messages = [
           {"role": m["role"], "content": m["content"]}
           for m in st.session_state.messages
       ]

       with st.spinner("🤔 Models are thinking..."):
           responses = call_models_parallel(
               api_messages,
               ["Kimi K2 Thinking", "GPT-5", "Claude Sonnet 4.5"],
               kimi_thinking,
               gpt5_reasoning,
               claude_thinking
           )

       cols = st.columns(3)
       for idx, (model_name, response_data) in enumerate(responses.items()):
           with cols[idx]:
               st.markdown(f"### {model_name}")
               if response_data["reasoning_content"]:
                   with st.expander("🧠 Thinking Process", expanded=False):
                       st.markdown(response_data["reasoning_content"])
               st.markdown(response_data["content"])
यह तीन कॉलम बनाता है और हर मॉडल का उत्तर अलग कॉलम में दिखाता है। सोचने की प्रक्रिया डिफ़ॉल्ट रूप से संकुचित रहती है ताकि उपयोगकर्ता पहले अंतिम उत्तर देखें। जब चाहें वे इसे विस्तारित कर तर्क प्रक्रिया देख सकते हैं।
ऐप चलाएँ:
streamlit run model_comparison_chat.pyएक बुनियादी टेस्ट से शुरू करें:
What is 2+2?तीनों मॉडल कुछ सेकंड में उत्तर देने चाहिए। इससे आपकी API कनेक्टिविटी और समानांतर एग्ज़ीक्यूशन का काम करना सत्यापित होता है। ऐप लोकली चलता है, जिससे आपके पास यह नियंत्रण रहता है कि APIs कब कॉल हों। हर क्वेरी पर API लागत आती है (लगभग $0.01–0.05 प्रति तीन‑मॉडल तुलना, उत्तर की लंबाई पर निर्भर), लेकिन लोकली चलाने का मतलब है आप तय करते हैं कि कब खर्च करना है।
आपने तुलना ऐप बनाया और सरल प्रश्नों पर इसे चलते देखा। पर असली अंतर तब दिखते हैं जब आप मॉडलों को ज़्यादा चुनौती देते हैं। इन अंतरों को दिखाने के लिए, मैंने तीनों मॉडलों को जटिल प्रॉम्प्ट्स पर टेस्ट किया। आप भी अपने ऐप में यही टेस्ट चलाकर प्रत्यक्ष परिणाम देख सकते हैं। यहाँ उन परीक्षणों से मुख्य अंतर्दृष्टियाँ हैं।
हमने अलग‑अलग रीजनिंग क्षमताएँ जाँचने के लिए तीन चुनौतियाँ चुनीं।
एक आयताकार बगीचा 24 फीट लंबा और 18 फीट चौड़ा है। बगीचे की बाहरी परिधि के चारों ओर 2 फीट चौड़ा रास्ता है। यदि Sarah बगीचे में 4 फूल प्रति वर्ग फुट की घनत्व से फूल लगाती है, और फिर लगाए गए क्षेत्र के 30% पर सजावटी पत्थर जोड़ने का निर्णय लेती है (उन फूलों को हटाकर), तो कितने फूल शेष रहेंगे? साथ ही, रास्ते से ढका कुल क्षेत्रफल (वर्ग फुट में) कितना है?
चार दोस्त—Alice, Bob, Carol, और David—को फोटो के लिए एक पंक्ति में लगना है। निम्नलिखित नियमों का पालन करना है:
1. Alice को Bob के साथ खड़ा होना चाहिए
2. Carol पंक्ति के किसी भी सिरे पर नहीं खड़ी हो सकती
3. David को Alice के बाईं ओर खड़ा होना चाहिए
बाएँ से दाएँ सभी मान्य व्यवस्थाएँ सूचीबद्ध करें।
एक Python फ़ंक्शन लिखें जो जाँचता है कि कोई स्ट्रिंग वैध IPv4 पता है या नहीं, इन आवश्यकताओं के साथ:
1. फ़ॉर्मेट वैलिडेट होना चाहिए (डॉट्स से अलग चार ऑक्टेट)
2. प्रत्येक ऑक्टेट 0-255 के बीच (लीडिंग ज़ीरो नहीं, सिवाय "0" के)
3. अवैध फ़ॉर्मेट (खाली स्ट्रिंग, बहुत अधिक/कम ऑक्टेट, गैर‑संख्यात्मक अक्षर) अस्वीकृत हों
4. टाइम कॉम्प्लेक्सिटी O(n) हो जहाँ n स्ट्रिंग की लंबाई है
5. उदाहरणों सहित पूर्ण डॉकस्ट्रिंग जोड़ें
6. सभी पैरामीटर्स और रिटर्न वैल्यू के लिए टाइप हिंट्स दें
7. एज केस संभालें (खाली स्ट्रिंग, None, विशेष अक्षर)
साथ ही अपने वैलिडेशन अप्रोच को समझाएँ और बताएँ कि यह O(n) क्यों है।
तीनों मॉडलों ने हर समस्या सही हल की। पर वहाँ तक पहुँचने के उनके रास्ते बहुत अलग थे। प्रदर्शन का ब्रेकडाउन यह है:
|
टेस्ट |
मॉडल |
समय (से.) |
टोकन |
परिणाम |
|
बगीचा समस्या |
Kimi K2 |
28.5 |
3,420 |
✓ सही (1,209.6 फूल, 184 वर्ग फुट) |
|
GPT-5 |
44.6 |
1,476 |
✓ सही (1,209.6 फूल, 184 वर्ग फुट) |
|
|
Claude |
19.7 |
1,386 |
✓ सही (1,210 फूल, 184 वर्ग फुट) |
|
|
फोटो व्यवस्था |
Kimi K2 |
50.5 |
6,249 |
✓ सभी 2 मान्य व्यवस्थाएँ मिलीं |
|
GPT-5 |
39.4 |
1,914 |
✓ सभी 2 मान्य व्यवस्थाएँ मिलीं |
|
|
Claude |
31.3 |
2,310 |
✓ सभी 2 मान्य व्यवस्थाएँ मिलीं |
|
|
IPv4 वैलिडेटर |
Kimi K2 |
192.6 |
5,245 |
✓ कार्यशील O(n) समाधान |
|
GPT-5 |
73.7 |
4,233 |
✓ कार्यशील O(n) समाधान |
|
|
Claude |
43.1 |
3,330 |
✓ कार्यशील O(n) समाधान |
यहाँ देखें कि उस समय में हर मॉडल वास्तव में क्या करता है।
यह लगातार खोजता और खुद से पूछताछ करता है। बगीचा समस्या पर इसने सेटअप का विज़ुअलाइज़ेशन किया, गणित किया, फिर रुका और कहा “रुकिए, मुझे दोबारा जाँचने दें…” और फिर आगे बढ़ा। फोटो व्यवस्था में इसने हर बाधा एक‑एक करके परखी और हर संभावना के लिए अपना काम दिखाया।
IPv4 वैलिडेटर में 3 मिनट से ज़्यादा लगे क्योंकि इसने एज केस एक‑एक कर सोचे, O(n) कॉम्प्लेक्सिटी का सबूत चला और लॉजिक को बार‑बार वेरिफ़ाइ किया। आप मानो किसी को ज़ोर से सोचते, खुद को पकड़ते और हर चरण पर अपनी तर्क प्रक्रिया जाँचते देखते हैं।
यह व्यवस्थित और संगठित है। इसने बगीचा समस्या को साफ सेक्शनों में तोड़ा, चरणों को क्रमांकित किया और क्रम से चला। फोटो व्यवस्था में इसने पोज़िशन‑दर‑पोज़िशन लोगों को रखते हुए नियम जाँचे।
कोड स्पष्ट व्याख्याओं और अच्छी डॉक्यूमेंटेशन के साथ आया। यह K2 जितना स्वयं‑संदेह नहीं करता, और Claude जितना जल्दबाज़ी भी नहीं करता। आपको बिना अतिशय विवरण के संतुलित थिंकिंग दिखती है।
यह तेज़ चलता है। हर टेस्ट पर समाधान पथ जल्दी पहचाना और साफ़‑सुथरे ढंग से क्रियान्वित किया। फोटो समस्या में इसने केस के आधार पर व्यवस्थित किया और बिना रुके हर केस पर काम किया। IPv4 का कोड साफ और अच्छी तरह से प्रलेखित था, पर जल्दी मुद्दे पर पहुँचा।
Claude अपनी थिंकिंग दिखाता है पर वेरिफ़िकेशन चरणों पर ठहरता नहीं। गति अप्रोच पर भरोसे और न्यूनतम बैक‑ट्रैकिंग से आती है।
ये अलग‑अलग अप्रोच साफ़ ट्रेड‑ऑफ़ पैटर्न बनाते हैं। सीखने, डिबगिंग या ऑडिट आवश्यकताओं के लिए विस्तृत रीजनिंग चाहिए हो तो K2 चुनें। गति अहम हो और आप बिना रीजनिंग चेन्स जाँचे परिणामों पर भरोसा करते हों तो Claude चुनें। K2 की वर्बोसिटी और Claude की स्पीड के बीच संतुलन चाहिए हो तो GPT-5 चुनें।
नोट: इन परिणामों को थोड़ी सावधानी से लें क्योंकि ये तीनों मॉडलों की क्षमताओं का पूर्ण परीक्षण यथार्थ रूप से नहीं कर सकते।
आपने OpenRouter के जरिए Kimi K2 Thinking सेट किया, उसकी रीजनिंग क्षमताएँ खोजीं, टूल‑कॉलिंग वर्कफ़्लो बनाए, और GPT-5 व Claude के खिलाफ तुलना ऐप बनाया। K2 की ताकतें हैं स्वतंत्र टूल ऑर्केस्ट्रेशन और पारदर्शी रीजनिंग—जो उन जटिल वर्कफ़्लोज़ के लिए उपयुक्त हैं जहाँ आपको मॉडल के निर्णयों को वेरिफ़ाई करना पड़ता है।
K2 की क्षमता और वहनीयता इसे व्यवहारिक बनाती हैं। यह अधिकांश प्रतिस्पर्धियों के “कुछ दर्जन” की तुलना में व्यापक क्रमिक टूल कॉल्स चला सकता है, और reasoning_content फ़ील्ड हर सोचने का चरण उजागर करता है। आउटपुट टोकन्स के लिए GPT-5 की लगभग 1/4 और Claude की 1/6 लागत पर, आप बिना बजट चिंता के व्यापक प्रयोग चला सकते हैं।
आपने जो तुलना ऐप बनाया, वह आपको इन ट्रेड‑ऑफ़्स का प्रत्यक्ष प्रमाण देता है। इसे अपनी समस्याओं और वर्कफ़्लोज़ पर टेस्ट करें ताकि आपको यह अंतर्ज्ञान बने कि क्या K2 की विस्तृत रीजनिंग लंबे उत्तर समय को न्यायोचित ठहराती है। आपके विशिष्ट उपयोग‑मामलों पर वास्तविक‑दुनिया टेस्ट वे पैटर्न दिखाएँगे जिन्हें सामान्य बेंचमार्क पकड़ नहीं पाते।
इन अवधारणाओं को आगे बढ़ाने के लिए, DataCamp का OpenRouter ट्यूटोरियल देखें—मल्टीपल LLM प्रदाताओं को मैनेज करने के लिए, GPT-5 गाइड—रीजनिंग effort स्तरों के लिए, और Claude Sonnet 4 गाइड—एक्सटेंडेड थिंकिंग मोड के लिए।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स